面向Linux内核开发知识的大模型问答能力评测法 | jos佳文
CodeWisdom 2026-10-26 22:42 上海
欧闻毅, 吴毅坚, 黄宸一, 彭鑫:面向Linux内核开发知识的大模型问答能力评测法《软件学报》
文章题目: 面向Linux内核开发知识的大模型问答能力评测
全部作者: 欧闻毅, 吴毅坚, 黄宸一, 彭鑫
第一单位: 复旦大学 计算与智能创新学院
出版时间: 2026, 37(8): 3116–3143
摘
/
要
ABSTRACT
ABSTRACT
大语言模型(large language model, LLM, 也称大模型)在软件开发技术问答任务中展现出强大潜力, 为代码知识获取和理解提供了新途径. 然而, 在以Linux内核为代表的复杂系统软件领域, LLM在代码实现、关键机制理解、演化历史追溯及设计决策分析等方面的真实能力仍缺乏系统验证. 现有评测基准多针对通用任务, 存在领域深度不足、难度逐渐饱和及评测问题与工程实践存在偏差等局限, 难以保障特定领域开发知识问答的客观性、准确性和全面性. 为客观评估LLM在复杂系统软件中的知识问答能力, 研究提出一种LLM问答能力评测基准数据集构建方法, 并构建面向Linux内核的高质量问答评测基准LKQABench, 同时设计一种多裁判协同的代码知识问答评测方法MJ-CCE. LKQABench基于开发者社区的真实技术问答数据, 经过语义分析和人工审核修订, 构建202个标准问答对, 覆盖Linux内核主要模块和不同认知维度. MJ-CCE方法定义多个裁判大模型的协同评分与投票机制, 从关键知识点覆盖度、事实正确性与表达清晰度等维度对回答进行多维度评估. 在LKQABench上对主流大模型的实证研究表明, 当前大模型能较好地回答内核实现的单点知识问题, 但在涉及跨主题知识整合、深度推理及版本演化关联的问题中, 存在知识点遗漏、逻辑链条不完整等不足. 研究不仅揭示了大模型在软件开发知识问答中的能力边界, 也为其在该领域的持续优化提供了实证数据支撑.

扫码阅读全文
视
/
频
/
速
/
览
VIDEO
VIDEO
内
/
容
/
精
/
选
CONTENT
CONTENT
1 方法概述
(1) 大模型问答能力评测基准数据集构建方法
LKQABench方法具体包括: 通过“数据采集与过滤”来保证原始语料的质量与相关性、通过“标准问答构建”获得结构化的评测样本、通过“问题分类”为样本打上标签用于评测分析、通过“审核与修订”保证评测样本的正确性, 如
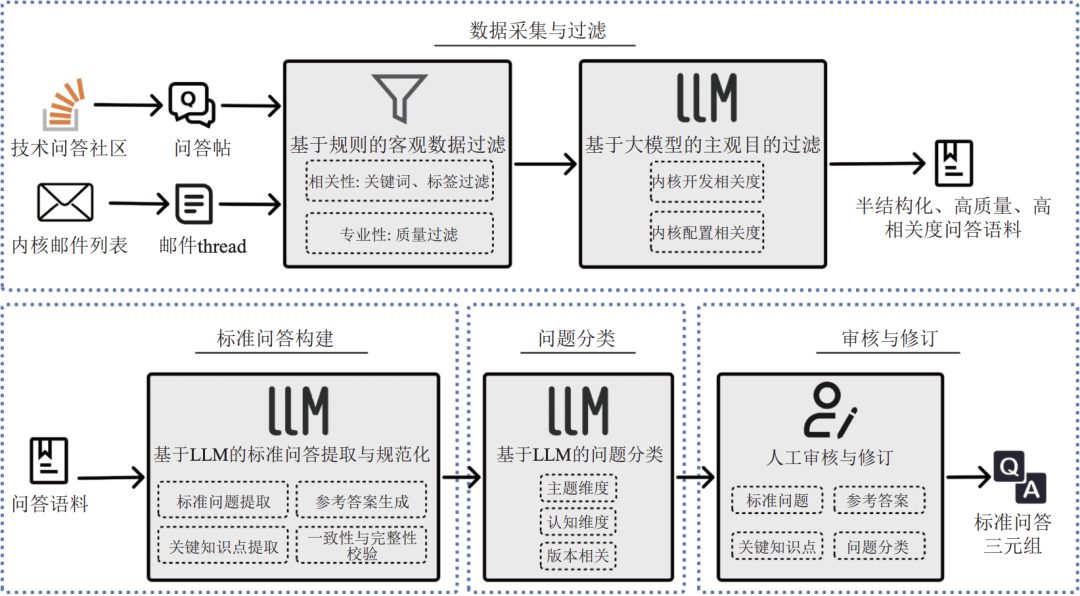
图1 大模型问答能力评测基准数据集构建方法
针对两类来源的不同特性, 本文分别设计了对应的采集与过滤方法, 如
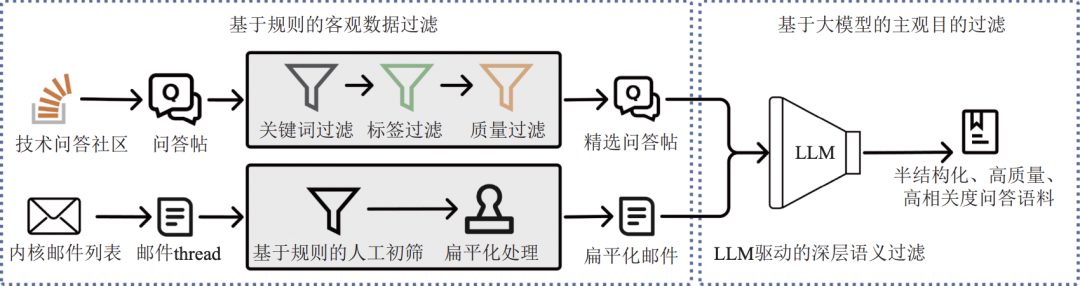
图2 数据采集与过滤方法
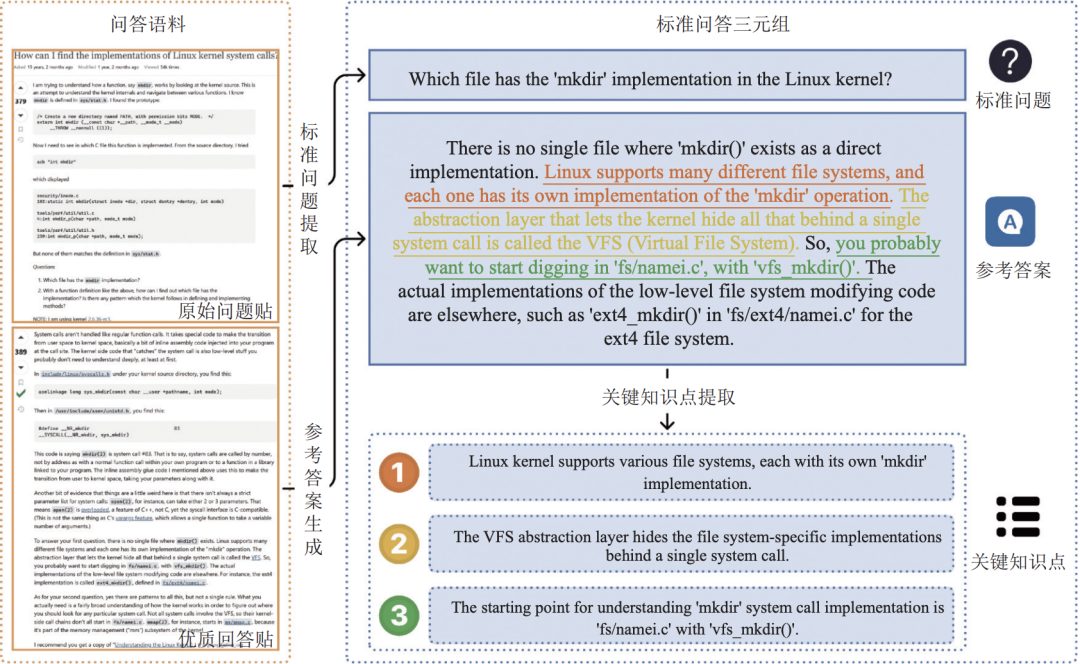 图3 标准问答三元组构建示例
(2) 多裁判协同的代码知识问答评测方法
① 多裁判大模型的结构化评估 (Judge)
为系统评估大模型在Linux内核领域的问答能力, 本文基于人工评估经验, 设计并实现了多裁判协同的代码知识问答评测方法(MJ-CCE). 该方法以自动化、稳健性、可追溯性与可解释性为核心目标:
支持在大规模场景下自动评测主观性较强的回答质量;
通过多裁判协同降低单一裁判偶发波动对结果的影响;
确保评测结果能明确对应回答中的具体内容并保留必要中间信息, 以便复核;
在输出判定结果的同时提供简要理由, 解释评估依据.
围绕上述目标, MJ-CCE设计了响应获取(Fetch)、裁判评估(Judge)、结果融合(Fusion)与量化评分(Score)这4个阶段, 如
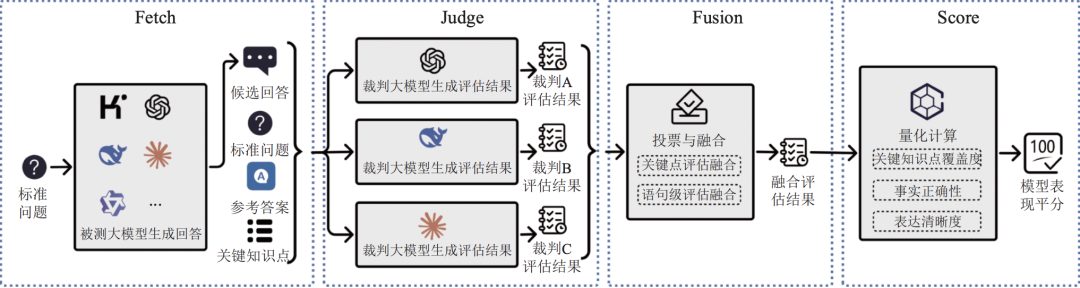
图4 MJ-CCE方法示意图
总体上依据3个维度设计, 包括关键知识点覆盖度、事实正确性与表达清晰度, 力求最大程度地贴近人工专家的判断逻辑.
②裁判结果的共识融合 (Fusion)
关键点评估融合采用基于阈值投票的方式来整合多个裁判的评估结果, 生成更具稳定性与代表性的最终分类. 具体而言, 需要先对多个裁判的分类结果进行统计, 再进行融合. 具体示例如图5所示.
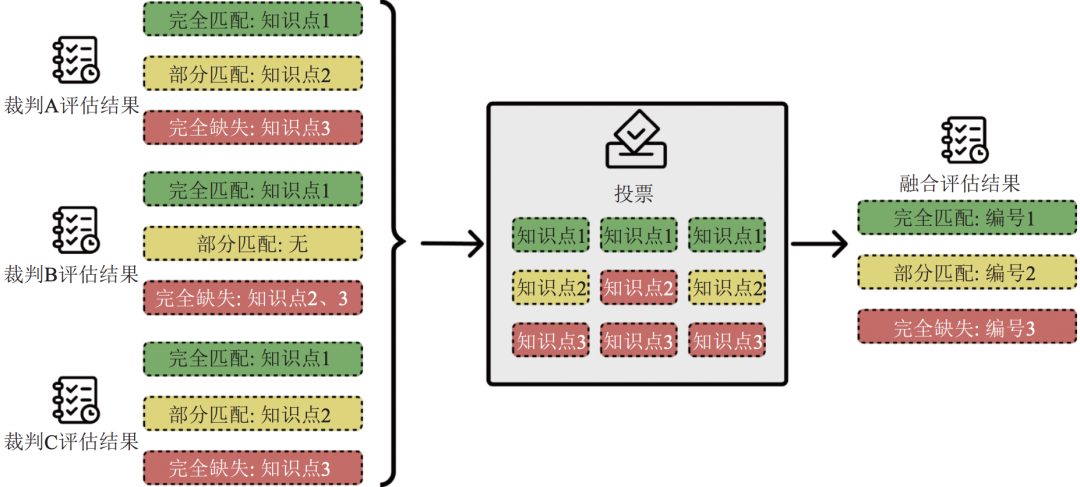
图5 Fusion阶段关键点评估融合示例
语句级评估融合整合多个裁判对问题语句的标注(存在问题的候选回答语句+问题类型), 以获得共识结果. 首先需在候选回答中验证语句, 再基于投票形成融合结果. 具体示例如图6所示.
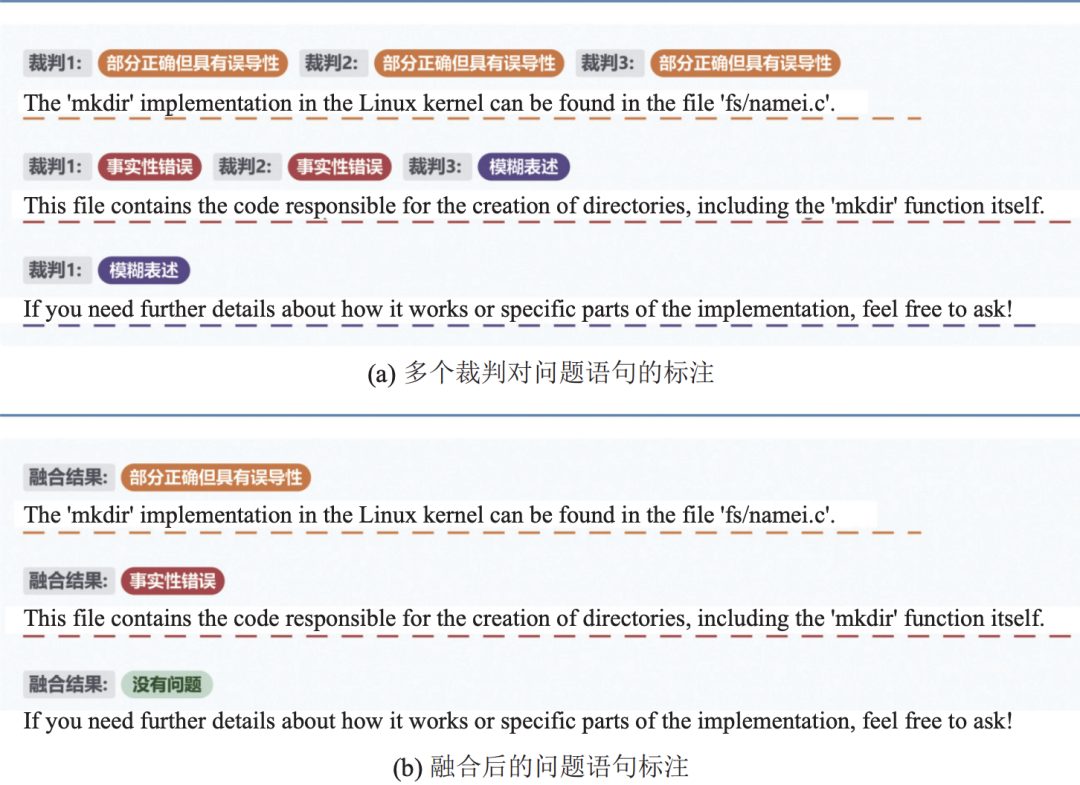
图6 语句级评估融合示例
③ 多维度量化评分 (Score)
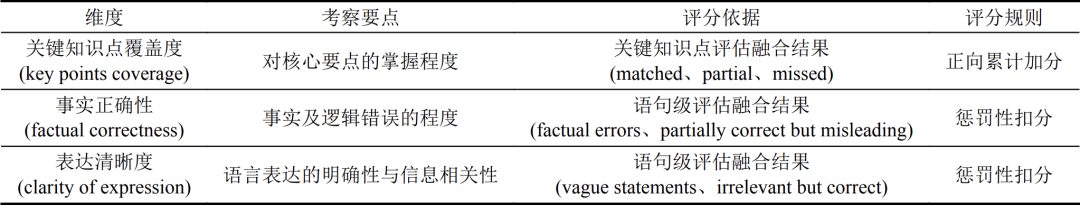
本文的评分由3个维度构成, 如表1所示.
表1 多维度量化评分
④ MJ-CCE方法的有效性验证
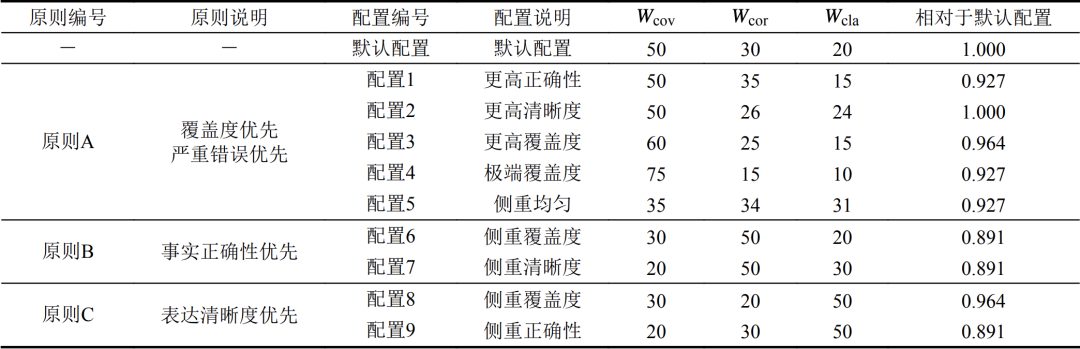
为了验证MJ-CCE方法在Score阶段权重配置的合理性与鲁棒性, 本文设计并实施权重敏感性实验. 计算这些模型的排名, 并使用肯德尔等级相关系数来衡量新排名与基准排名之间的一致性. 具体结果如
表2 不同配置下的权重敏感性分析
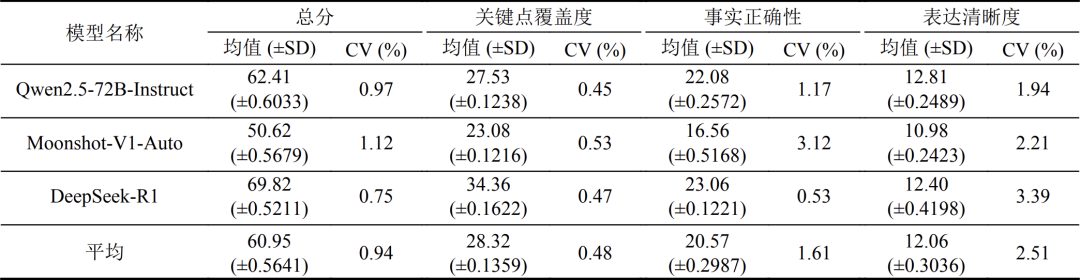
为检验MJ-CCE在重复评估中的一致性与可复现性, 本文开展了稳定性实验: 以GPT-4o、Claude 3.5 Sonnet与DeepSeek-R1为裁判模型, 对在LKQABench上表现具有代表性的3款被测模型, DeepSeek-R1 (表现较好)、Qwen2.5-72B-Instruct (表现适中)、Moonshot-V1-Auto (表现较差), 分别独立运行3次完整评估流程(Judge、Fusion、Score). 实验结果如
表3 多次评估中MJ-CCE方法的稳定性分析
2 实验分析
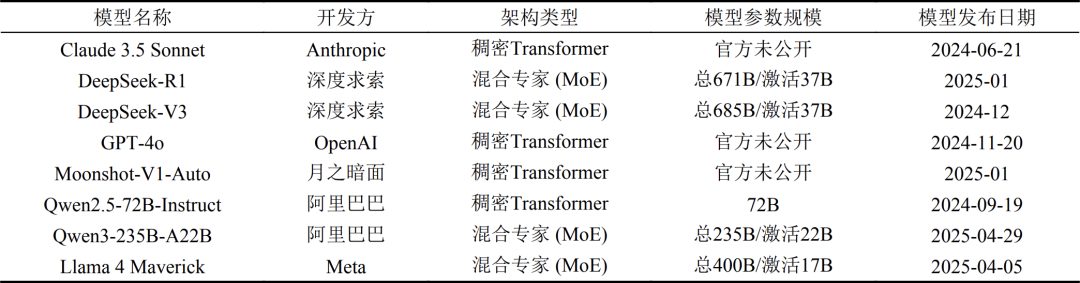
为确保评测结果的代表性与广泛适用性, 本文选取多款表现突出的主流大语言模型, 兼顾 技术路线、参数规模及地域背景的多样性, 并分为两组进行实验.
一组用于整体评估, 共选取8款主流大模型, 如
表4 8款主流大模型整体表现评估
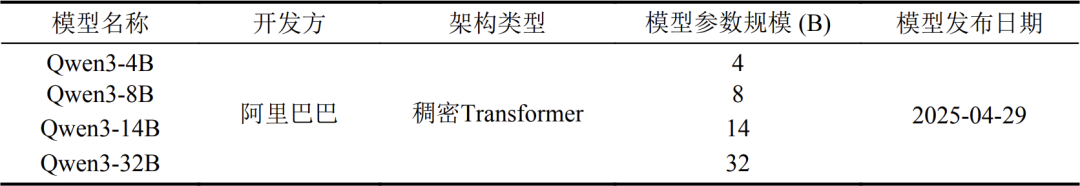
另一组用于探讨参数规模对模型表现的影响, 共选取Qwen3系列的4款模型, 如表5所示.
表5 Qwen3系列模型参数规模对比
RQ1: 大模型的整体表现分析
表6 8款主流模型的平均得分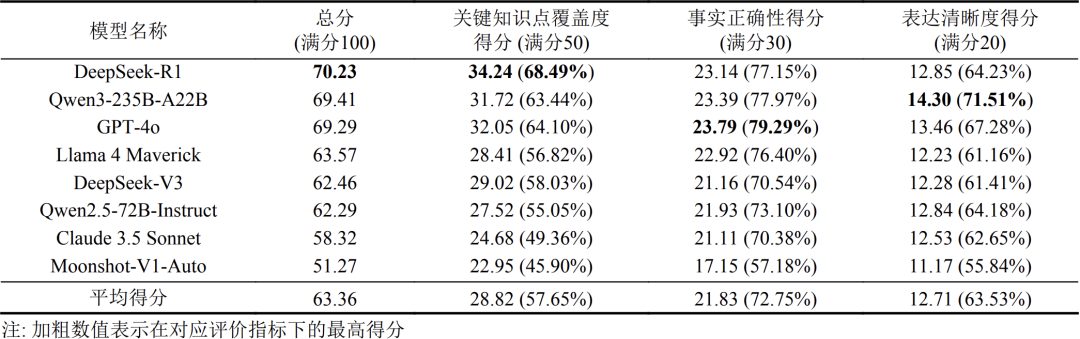
RQ2: 问题特性对大模型表现的影响分析
本文对大模型在LKQABench涵盖的14个核心技术主题上的表现进行了分析, 如图7所示, 不同主题间模型的平均得分差异显著, 反映出Linux内核各子系统对大模型能力构成了不同程度的挑战.
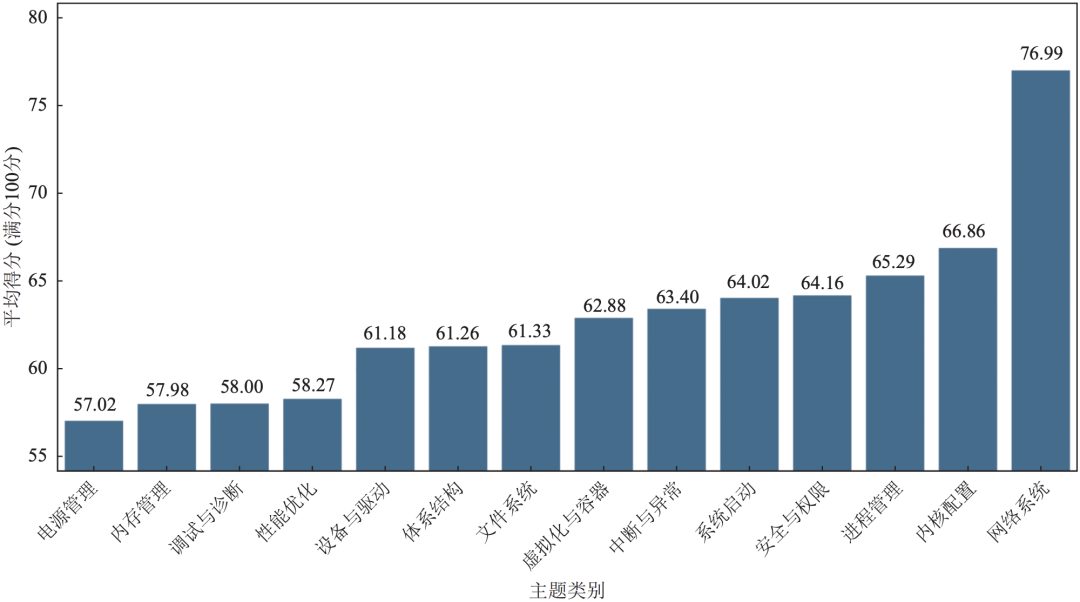
图7 各主题上主流模型的平均得分
主题样本数量与评测得分之间不存在显著相关性, 如图8所示, 黑框标注了表现不佳的主题, 它们包含较高比例的机制理解(C2)与开发与调试(C3)类问题, 进一步印证了其复杂性与挑战性.
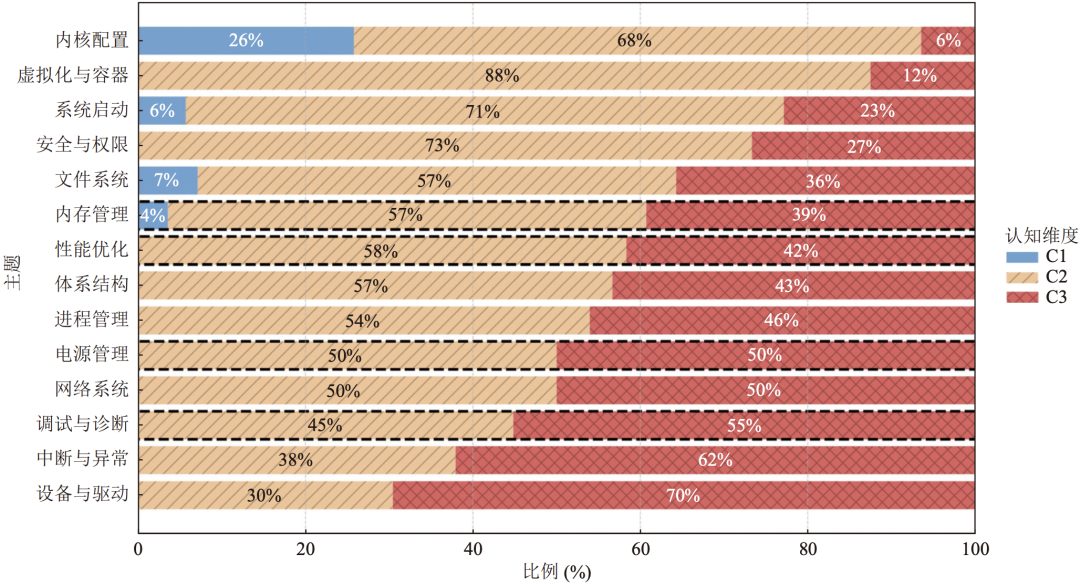
图3 各主题中的认知维度比例分布
大模型在Linux内核问答任务中的表现并非稳定一致, 而是系统性地受到问题内在特性的深刻影响, 这揭示了其在应对复杂性时的共性短板: 它们在处理孤立、静态、事实性的知识点时表现尚可, 但一旦问题引入了跨主题的整合、认知深度的推理或动态演进的上下文, 其表现便会显著下滑.
RQ3: 大模型自身特性对其表现的影响分析
为隔离参数规模这一变量, 本文选取了Qwen3系列的4款稠密Transformer架构模型(4B、8B、14B、32B) 进行对比分析, 实验结果如表7所示.
表7 不同参数规模模型的平均得分
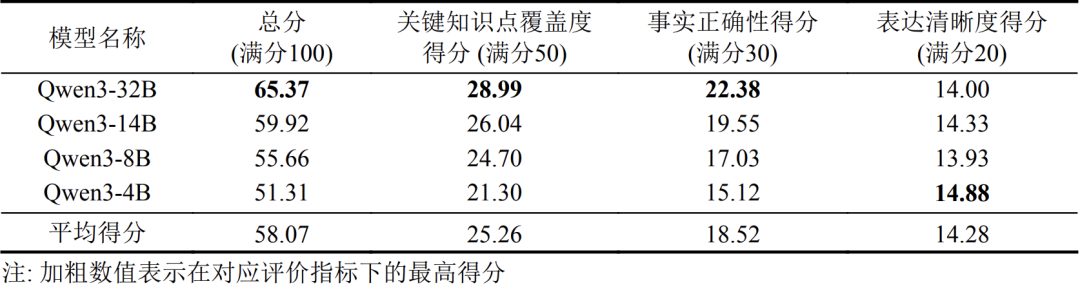
表8揭示了一个具有代表性的发现: 启用“思考模式”并未带来整体表现的稳定提升, 而是体现出模型在“关键点覆盖度”与“表达清晰度”之间存在的权衡关系.
表8 不同“思考模式”下模型的平均得分
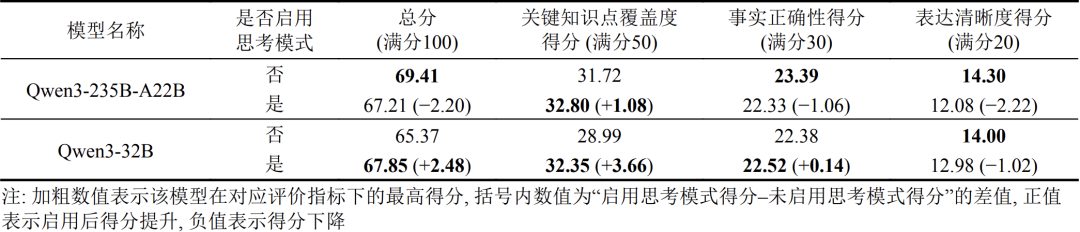
大模型自身的特性, 包括参数规模、架构设计与运行模式, 与其在Linux内核问答任务中的表现存在深刻且复杂的关联. 一方面, 参数规模是决定模型知识容量与事实正确性的基础性因素, 更大的模型在该领域具备天然优势, 但简单地扩大模型规模可能无法继续提升模型在该领域的表现. 另一方面, MoE架构在应对多主题复合问题时展现出强大的知识整合潜力, 但其优势可能并非必然, 而是高度依赖于“专家”能力的有效培养与路由机制的精确优化. 而特定的运行模式, 如“思考模式”是一把双刃剑, 它在提升知识覆盖度的同时, 可能会以牺牲表达清晰度为代价.
3 总结与展望
本研究围绕Linux内核场景下的大模型评估任务, 提出了系统性解决方案, 包括可推广的评测基准构建方法论、多裁判协同的代码知识问答评测方法MJ-CCE, 以及Linux领域首个高质量问答评测基准LKQABench. 通过对8款主流大模型的实证研究, 本文发现: 现有大模型虽能生成语言流畅的回答, 但因缺乏对系统隐性知识的深层理解, 在关键知识点的覆盖方面存在明显不足, 尚不能作为可靠的专业知识来源.
进一步分析表明, 这一核心瓶颈既源于问题特性, 也受模型自身影响. 在问题层面, 模型在应对跨主题知识整合、深度推理及动态演进知识等复杂问题时表现明显下降; 在模型层面, 更大的参数规模和更先进的架构(如MoE)虽有助于提升性能, 但难以根本解决知识鸿沟. 同时, “思考模式”的启用在提升关键知识覆盖度的同时, 往往会影响表达清晰度, 体现出模型能力的内在权衡.
单纯扩大模型规模难以弥合大模型在复杂系统理解上的深度知识鸿沟. 未来研究可尝试转变范式: 从修补模型自身能力的局限, 转向构建与代码共同演进、涵盖设计原理与演化历史的结构化知识体系, 为模型提供深度知识支撑. 面向企业级软件开发场景, 可以通过构建高质量领域知识库来初步实现这一范式, 帮助提升大模型在专业技术问答任务中的精准性与可靠性.
展望未来, 本文将持续扩展LKQABench, 纳入官方文档、技术规范及邮件列表等高价值知识源, 使其成为反映内核演进的动态“活数据集”, 并深化模型评测, 覆盖更多最新开源与闭源模型, 系统比较“代码模型”与“通用模型”的能力差异. 同时, 为攻克模型在隐性及动态知识处理上的短板, 本文将探索结合检索增强生成(RAG)与领域微调的技术路径, 以期为大模型在复杂系统理解与智能开发支持方面的持续进步贡献力量.
作
/
者
/
简
/
介
AUTHOR
AUTHOR
欧闻毅, 博士生, CCF学生会员, 主要研究领域为软件演化分析
吴毅坚, 博士, 副教授, 博士生导师, CCF专业会员, 主要研究领域为软件工程, 软件演化分析.
黄宸一, 本科生, 主要研究领域为软件工程.
彭鑫, 博士, 教授, 博士生导师, CCF杰出会员, 主要研究领域为软件智能化开发, 云原生与智能化运维, 泛在计算软件系统, 智能网联汽车基础软件.
本文转载自微信公众号「CodeWisdom」,查看原文。版权归原作者所有,如有侵权请联系删除。