数据安全来自好用,而不是层层设卡 —— DsphereAI Browser Agent 的数据安全与隐私设计
原创 Janky 2026-10-28 14:37 浙江
数据安全不是靠把人拦在门外换来的,而是让安全的做法足够顺手,顺手到你不会想绕开它。自动化不应只属于会写代码的人,也不必用账号安全去交换。让每个人都享受自动化,这是 DsphereAI 的出发点。
01
层层设卡的本质:责任稀释与安全空转
我先明确地把本文话题的语境,限定在企业内部数据安全治理的范畴,而非扩充到整个网络安全领域,以将可能的观念冲突降到尽量可控之地步。
初级,或职场胆量较小的数据安全从业者,通常秉持纯粹的(不容易有争议、不会惹麻烦的)防御性思维,即在企业/组织内采用“层层设卡”的防护思路:
从网络边界到系统入口,从权限审批到数据流转,每一环节都设置审批、校验与阻断机制,试图以尽可能多的关卡把风险挡在门外。
然而,这种思路存在一个深层悖论 —— 关卡越多,责任越分散;审批越繁,实质判断越稀薄。当安全体系被简化为一道道流程闸口时,真正的问题往往不是“安全是否到位”,而是“出了事由谁负责”。
层层设卡的本质,恰恰是把安全的责任从组织内部的技术判断与治理能力,转交给事后的司法裁判。
更为重要的是,当层层关卡无限增加用户自由之成本后,得到的一定是激发全体(企业员工)专研奇淫巧技的格局。大家一起想办法如何绕过规则,实际/潜在的安全风险,恐怕比不采取安全措施还甚,因为大量原本的“好人”也被逼“反”了。
了解我过往文章的读者,一定对这样的概念不陌生,因为我一直在试图传递这样的理念。也在一直努力去找到一个解决方案,一个让企业里的每个个体都用得更爽、更方便的数据安全产品,而不是过往那种人人喊打、谈之色变的安全“怪物”。
02
我的答案还是「浏览器」,更自动化的浏览器
浏览器,依然是企业内最为依赖的办公应用,这就是我选择一定要攻克他最朴素的理由。
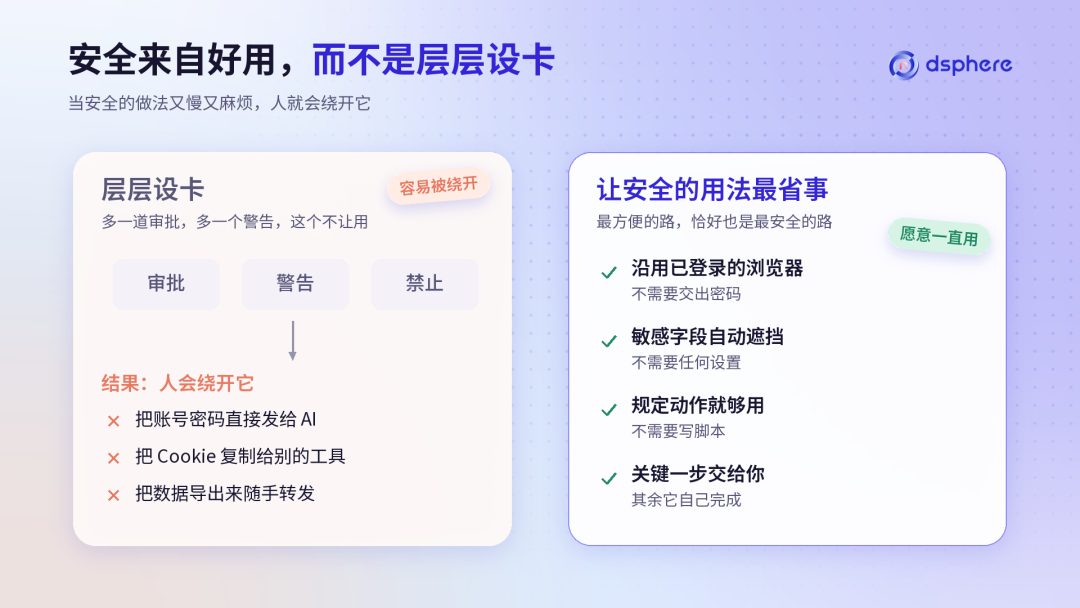
当安全的做法又慢又麻烦,人就会绕开它:把账号密码直接发给 AI,把 Cookie 复制出来交给别的工具,把数据导到随便哪个表格里再转发。最危险的数据泄露,常常不是被攻击出来的,而是在「图省事」的时候发生的。
所以我们的思路是反过来:能自动化的就自动化,让安全的用法,本身就是最省事的用法。
不用交出密码,因为根本不需要。 智能体就在你已经登录的浏览器里工作,沿用你的登录状态。最方便的路径,恰好不需要把账号交给任何人。
不用记着打码,因为它自动完成。 密码、验证码、银行卡字段,在模型看到页面之前就已经遮挡好了,你不需要做任何设置,也不需要提醒自己「这页别让 AI 看」。
不用自己写脚本,因为规定动作就够用。 点击、输入、选择、翻页、读取,都有现成的动作可调。智能体用起来顺手,也就没有理由去要一个「执行任意代码」的口子。
不用在安全和效率之间二选一。 登录、付款这类真正需要你的环节,它会停下来通知你,你处理完它接着干;其余的事它自己完成,数据直接进本地数据表,可以导出为 CSV、JSON 或 XLSX。
拦截只能挡住一部分风险,好用的安全设计,才能让人愿意一直这样用。
03
浏览器自动化,似乎已经烂大街了,但是真的适合企业办公的,也许才真正出现
今天大多数办公工作都发生在浏览器里:电商后台、CRM、广告平台、内容平台、各种 SaaS 系统。一个员工每天在这些页面之间搜索、筛选、复制、粘贴、汇总,花掉的时间相当可观。把这些重复的网页操作交给智能体,是组织提升员工效率最直接的方式之一,不需要改造原有系统,也不需要等每个平台都开放接口。
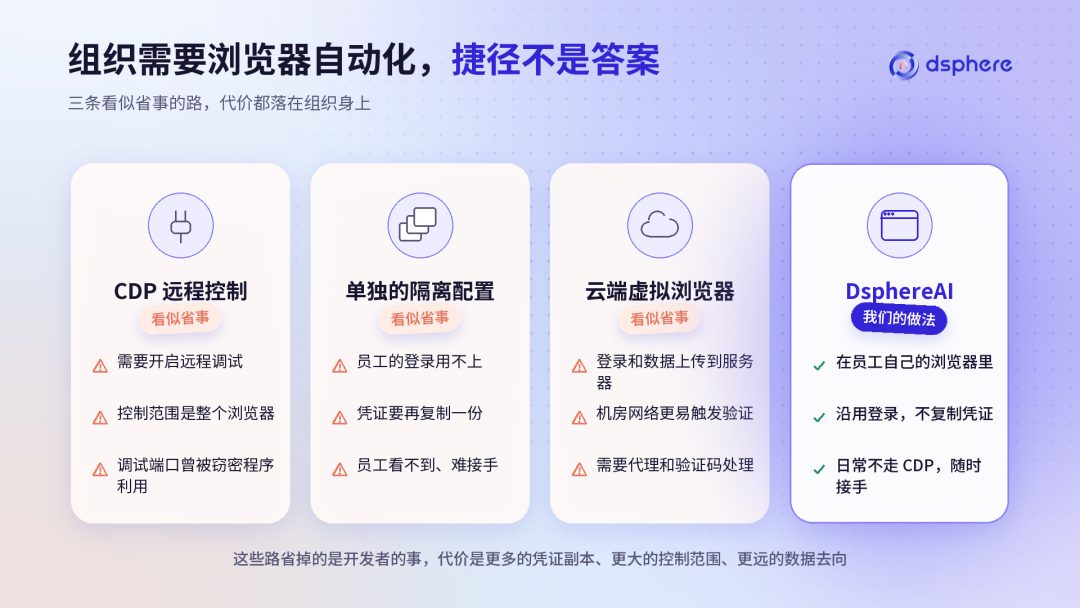
问题在于怎么做。行业里有三条常见的路,看起来都很省事,但放到一个真实的组织里,各有代价:
用 CDP 远程控制浏览器。 这是开发者最熟悉的办法:用调试协议接管整个浏览器。可它要求浏览器开启远程调试,控制范围是整个浏览器,而不只是某个页面。Chrome 136 起,默认配置文件不再响应远程调试端口参数,原因正是有窃密程序利用它从用户的真实浏览器里取走 Cookie。在员工电脑上开着这样一个端口,IT 部门很难放心。
为自动化单独开一套隔离的浏览器配置。 机器人用自己的配置文件,和员工的浏览器分开,看起来干净。可这样一来,员工已经登录的账号,机器人一个也用不上:要么让它重新登录,要么把账号密码、Cookie 复制一份给它。每多一个机器人配置,就多一份散落在外的登录凭证;员工也看不到它在做什么,出了问题很难接手。
把浏览器搬到云端的虚拟机上。 云端浏览器方便扩容,但员工的登录状态、业务数据都要跟着上传到服务商的服务器。对网站来说,这是一个来自机房网络的新设备,更容易触发登录验证,于是又需要代理和验证码处理来应对,这和网站规则往往是冲突的。
这些路省掉的是开发者的事,因为这些是最简单的技术手段,没有什么技术门槛,但代价落在了组织身上:更多的凭证副本、更大的控制范围、更远的数据去向。
我们选的是另一条路:智能体就在专有的的办公浏览器里工作。 它沿用员工已经登录的账号,不复制凭证;它由扩展在页面里操作,日常不走 CDP、不开调试端口;它和员工在同一个浏览器里工作,员工随时能看到它在做什么,也可以随时让它停下、自己接手。效率来自员工本来的工作环境,安全也一样。
最重要的是,它可以被任何第三方 AGENT 和模型驱动,但 AGENT 和模型,都看不到真实的敏感的数据,更拿不走。
下面几节,就是这些想法在产品里的具体做法。
04
浏览器在自己电脑里
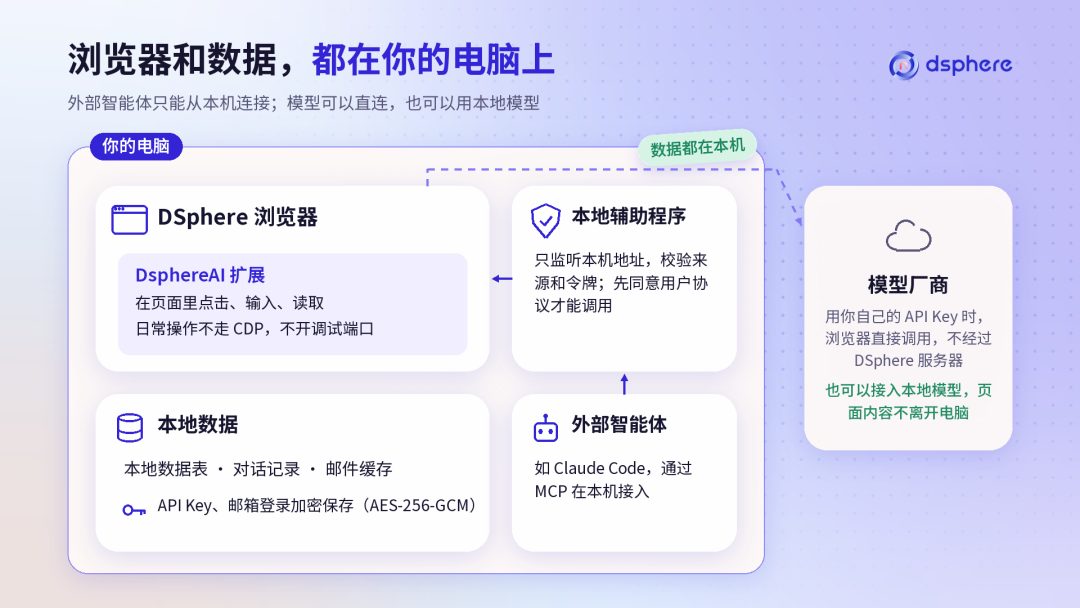
日常操作不走 CDP。 点击、输入、滚动、读取,都由浏览器自己完成,不开启远程调试端口。
三方 Agent 只能从本机连接。 Workbuddy、Claude Code 这类智能体通过 MCP 接入时,连接只在本机进行:浏览器通过本地消息通道启动辅助程序,它只监听本机回环地址,并校验来源和令牌。首次使用前,你需要在浏览器里同意用户协议,否则所有调用都会被拒绝。
本地的数据留在本地。 本地数据表、对话记录、邮件缓存都存放在你电脑上的本地数据库里。你自己配置的模型 API Key、邮箱登录信息,都经过 AES-256-GCM 加密后保存。
06
模型看到的,是脱敏后的页面
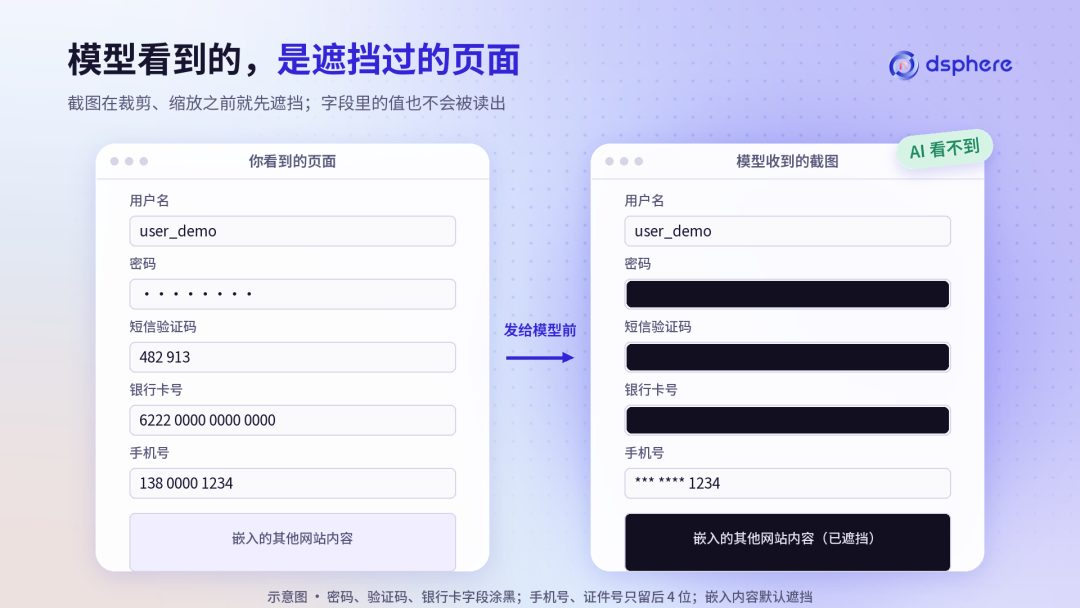
示意图:发给模型之前,敏感字段先被遮挡
智能体要理解页面,就得把页面内容发给模型。DsphereAI 在发出之前先做遮挡:
密码、验证码、银行卡字段: 截图在裁剪和缩放之前,就先在原始分辨率上把这些区域涂黑;这些字段里的值也不会被读出。
你在表单里输入的内容: 默认不离开页面。
手机号、证件号: 在返回给模型的结果里只显示后 4 位。
页面里嵌入的其他网站内容(iframe): 默认整块遮挡。
每次截图的结果里都会注明是否做了遮挡、遮挡了几处。模型的调用路径也可以由你选择:
用你自己的 API Key: 扩展直接从浏览器调用模型厂商,不经过 DSphere 的服务器。
用平台提供的模型: 请求经 DSphere 服务器转发。服务端的用量记录只保存哈希和用量,不保存提示词和回复的正文。
通过 MCP 接入外部智能体: 页面信息交给你自己的智能体和它所用的模型。
用本地模型: 接入在你自己电脑上运行的模型服务,页面内容不离开本机。
07
AGENT 只能做「规定动作」
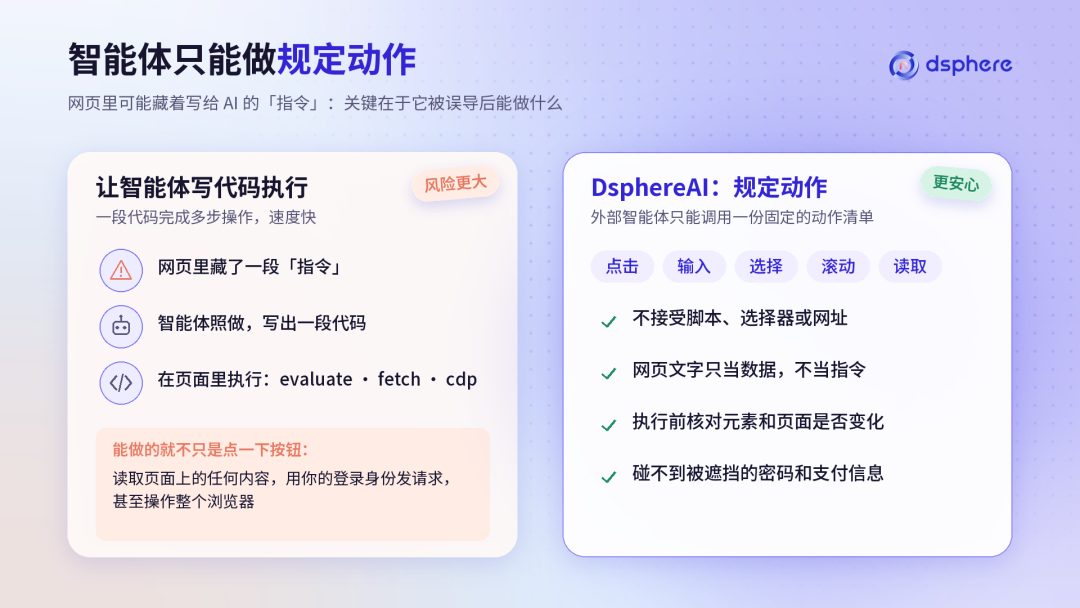
如今几乎所有的浏览器 AGENT 类产品,都通过 CDP 进行浏览器操控,其影响范围并不限于某个浏览器页面。AGENT 的工作区和你自己的标签页共用同一个 Cookie 存储,一条清除命令就能清空整个配置文件的 Cookie。
风险在于,网页内容本身是不可信的。如果某个页面藏了一段专门写给 AI 的「指令」(即提示词注入),而智能体照做了,那么它能执行的就不只是点一下按钮,而是任意代码:读取页面上的任何内容,用你的登录身份发请求,甚至操作整个浏览器。
DsphereAI 选了另一条路:
只接受规定动作。 外部智能体只能调用一份固定清单里的动作(点击、输入、选择、滚动、读取等),对象是浏览器分配的元素编号。它不接受智能体写的脚本、选择器或网址,也没有「在页面里执行任意代码」的接口。
页面文字只当数据。 无论通过 MCP 还是内置对话,网页上读到的文字都只当作数据,不当作指令;内置对话的系统提示里也不放入页面文字。
动作前先核对。 每个动作执行前,都会核对元素是否还是刚才看到的那个,页面是否已经变化;页面变了就拒绝执行,要求重新观察。
这样,即使智能体被误导,它能做的也只是规定动作,而且碰不到被遮挡的密码和支付信息。
08
关键操作,交换给人操作
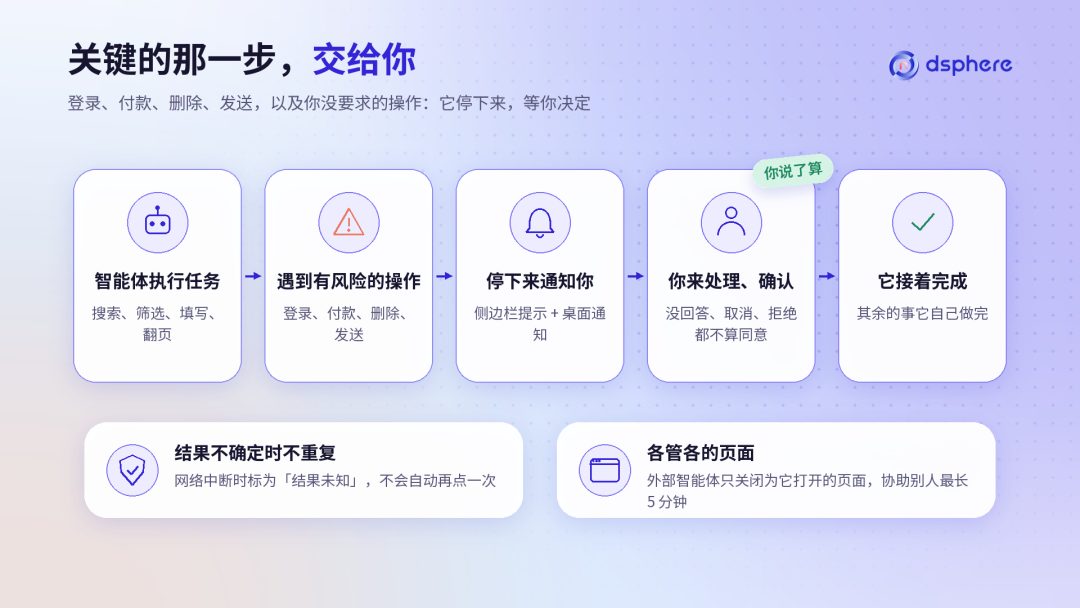
登录、付款等关键环节,停下来交给你
登录交给你。 遇到登录墙,智能体会停下:除了关闭弹窗、滚动这类不影响账号的操作,其他动作一律拒绝执行,并通过侧边栏和桌面通知请你来处理。智能体不会替你输入密码。
有风险的操作,都先问你。 付款、删除、发送、发布这类有风险的操作,以及你没有要求的操作,智能体都要先询问你,得到明确同意才继续;没有回答、取消或拒绝,都不算同意。
结果不确定时不重复。 每个有影响的动作都带唯一编号。如果网络中断、不知道动作是否已经生效,系统会如实标为「结果未知」,不会自动再点一次,避免重复下单、重复发布。
各管各的页面。 外部智能体只能关闭为它打开的页面。要协助操作别人正在用的页面,需要临时授权,最长 5 分钟,并且你可以随时关闭这项功能。
09
数据,都留在本地
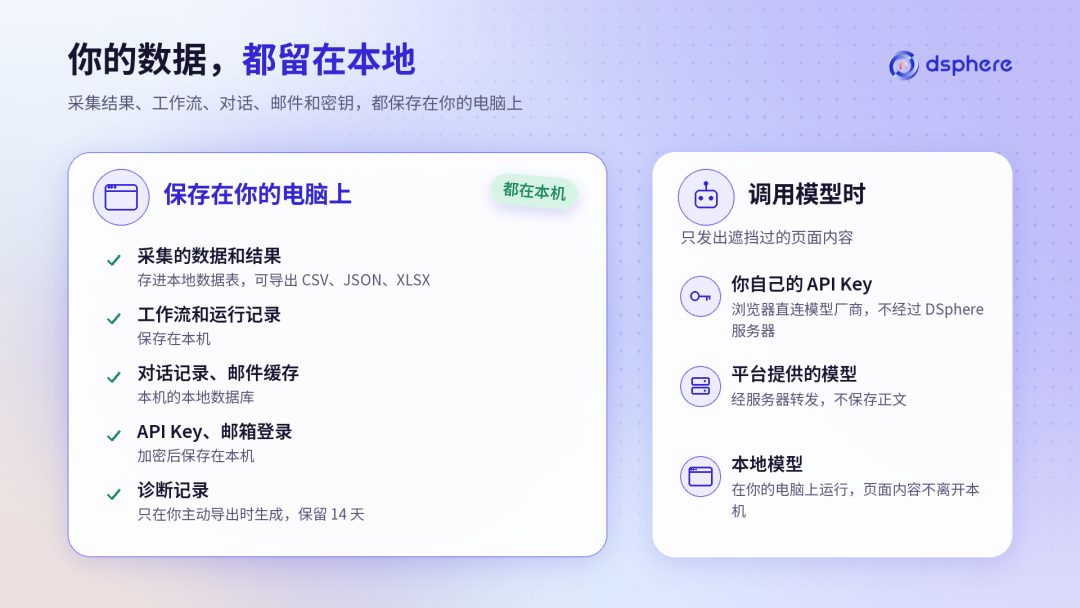
所有数据都留在你的电脑上
在 DsphereAI 里,你的数据都保存在你自己的电脑上:
采集的数据和运行结果: 存进本地数据表,可以导出为 CSV、JSON 或 XLSX。
工作流和运行记录: 保存在本机。
对话记录、邮件缓存: 保存在本机的本地数据库里。
你的 API Key、邮箱登录信息: 加密后保存在本机。
唯一可能离开电脑的,是调用模型时发出的页面内容,而且是遮挡过的版本:用你自己的 API Key 时,浏览器直接发给模型厂商;用平台提供的模型时,请求经 DSphere 服务器转发,不保存正文;用本地模型时,这部分也留在你的电脑上。
10
结语
我们相信,数据安全不是靠把人拦在门外换来的,而是让安全的做法足够顺手,顺手到你不会想绕开它。自动化不应只属于会写代码的人,也不必用账号安全去交换。让每个人都享受自动化,这是 DsphereAI 的出发点。
使用任何浏览器自动化工具时,都请用自己的账号、按正常的节奏操作,并遵守各网站的服务条款和数据规则。
本文转载自微信公众号「连续创业的Janky」,查看原文。版权归原作者所有,如有侵权请联系删除。