HybridCUA:让电脑智能体学会“何时点鼠标、何时敲命令”
52CV 2026-10-28 12:30 江苏
近年来,基于多模态大模型的电脑操作智能体(Computer-Use Agent,CUA)发展迅速,已经能够像人一样观察屏幕、点击按钮、输入文字,完成办公、编程、系统设置等真实数字任务。
然而,“像人一样点鼠标”并不一定是最高效的方式。
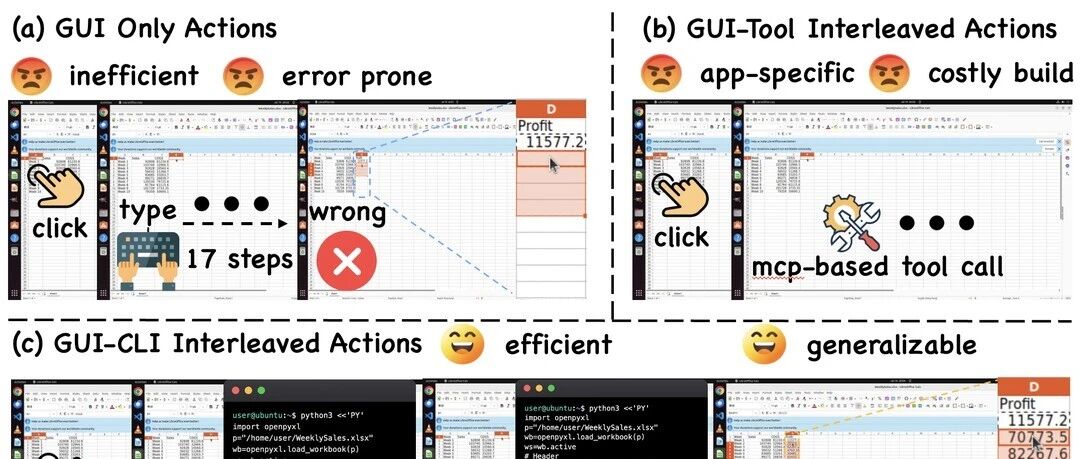
以表格计算为例:在 LibreOffice Calc 里新增一列“利润”,纯 GUI 智能体需要逐格点击、输入,往往要十几步,中间任何一步点偏都会导致任务失败;而如果借助一段几行的 Python 脚本,同样的工作一次就能完成。
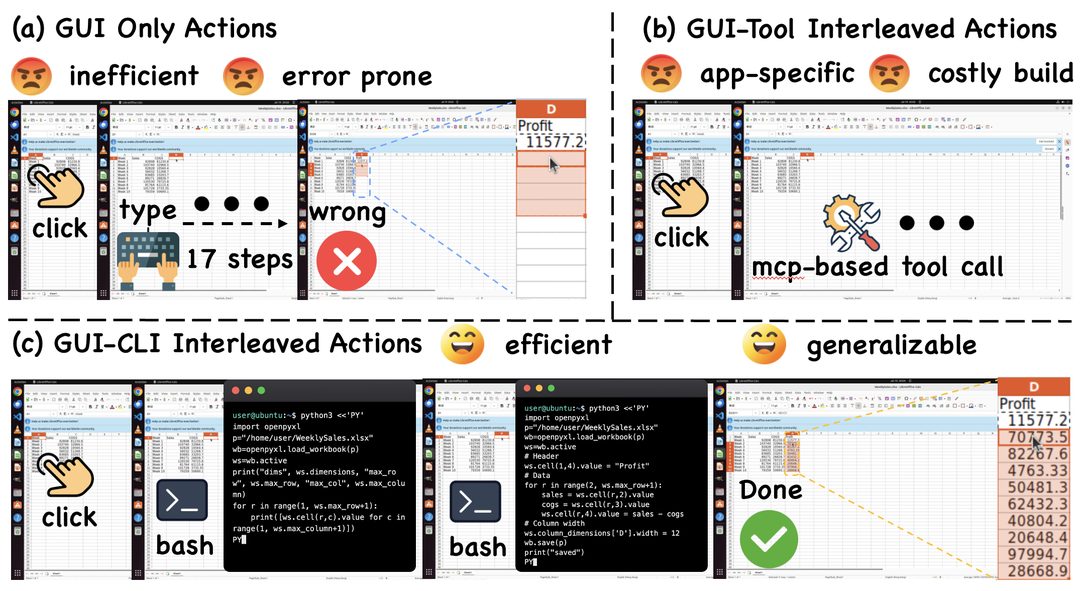
图 1:三种交互范式对比。(a)纯 GUI 低效且易错;(b)GUI+专用工具依赖逐个应用开发接口;(c)GUI+CLI 混合交互兼顾效率与通用性
Claude Code、Codex 等编程智能体的流行,让命令行(CLI)重新回到视野中心:Shell 由操作系统原生提供,无需为每个应用单独开发接口,一条命令就能替代一长串 GUI 操作。那么,只要给 CUA 开放一个终端,问题就解决了吗?
答案出人意料:不仅没有变好,反而变差了。
针对这一问题,研究团队提出 HybridCUA,一个让 CUA 学会编排 GUI 与 CLI 的数据与训练框架。该方法构建了覆盖纯 GUI、纯 CLI 与 GUI–CLI 交错三类执行模式的数据集 HybridCUA-8K,并通过“SFT + CLI 感知强化学习”两阶段训练,分别教会模型何时使用命令行、如何正确使用命令行。
实验表明,HybridCUA-9B 在 OSWorld 上达到 53.6% 的准确率,相比基座模型提升 14.8 个百分点,平均步数从 31.6 降至 14.0,在同尺寸模型中取得最佳成绩;在跨操作系统的 WindowsAgentArena 上同样提升 4.0 个百分点。
论文标题: HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
机构单位: 浙江大学,北京大学,清华大学
模型与数据:https://huggingface.co/collections/077lukamagic/hybridcua
1. 问题背景
当前 CUA 主要沿两条路线发展:
纯 GUI 路线: 通过点击、滚动、键盘输入等原子动作操作界面。这种方式足够通用,但速度慢,长序列中的一步失误就可能导致整个任务失败。
GUI + API/工具路线: 为应用接入结构化 API 或 MCP 工具来提升效率。但这些接口是应用专属的,往往不完整、不稳定,且需要为每个新应用单独构建,难以扩展。
研究团队认为,下一代 CUA 应当是混合式的:用 GUI 负责视觉交互,用 Shell 负责可编程操作。二者单独都不够,结合起来才能同时获得 GUI 的通用性与代码的效率。
2. 为什么“给模型一个终端”反而更差?
2.1 开放 CLI 后,强模型集体掉点
研究团队在 OSWorld 上测试了四个代表性智能体,分别在“纯 GUI”与“GUI + CLI”两种动作空间下评测。
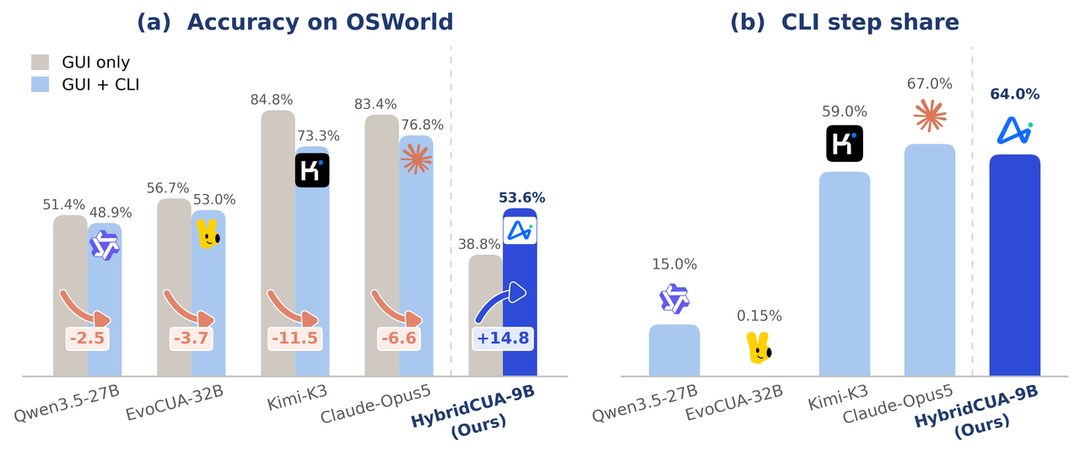
图 2:(a)开放 CLI 后,四个代表性模型在 OSWorld 上均出现下降,而 HybridCUA-9B 提升 14.8 个点;(b)不同模型的 CLI 步数占比差异巨大
结果显示:
开放 CLI 后,四个模型的准确率全部下降,降幅在 2.5 到 11.5 个百分点之间;
一些模型不知道何时用:Qwen3.5-27B 和 EvoCUA-32B 仅有 15.0% 和 0.15% 的步骤使用 CLI,仍在用冗长的 GUI 序列完成本可一条命令解决的任务;
另一些模型不知道如何用:Kimi-K3、Claude-Opus5 的 CLI 占比高达 59.0% 和 67.0%,但准确率同样下降。
对于 9B 基座模型 Qwen3.5-9B,问题更加明显:开放 CLI 后准确率从 38.8% 骤降至 18.4%。步数虽然减少,但那只是“更早失败”,而非“更高效”。
换句话说,瓶颈不在于能否访问 Shell,而在于知道何时、如何使用它。
2.2 两个根源:数据缺位与监督盲区
研究团队将这一能力缺陷归结为当前 CUA 训练中的两个缺口:
第一,数据从未展示过“混合行为”长什么样。 GUI、Shell、代码语料各自丰富,但彼此割裂:CUA 数据集几乎只包含 GUI 动作,而终端与代码数据又缺少命令被执行时所处的 GUI 上下文。
第二,监督信号对“接口选择”视而不见。 逐步模仿学习只偏好局部合理的动作,结果奖励只检查任务是否完成。无论模型是选对了接口,还是绕了远路,只要最终成功,得到的奖励都一样。
3. HybridCUA:数据与训练双管齐下
针对上述两个缺口,HybridCUA 从数据构造和训练目标两个方向同时入手。
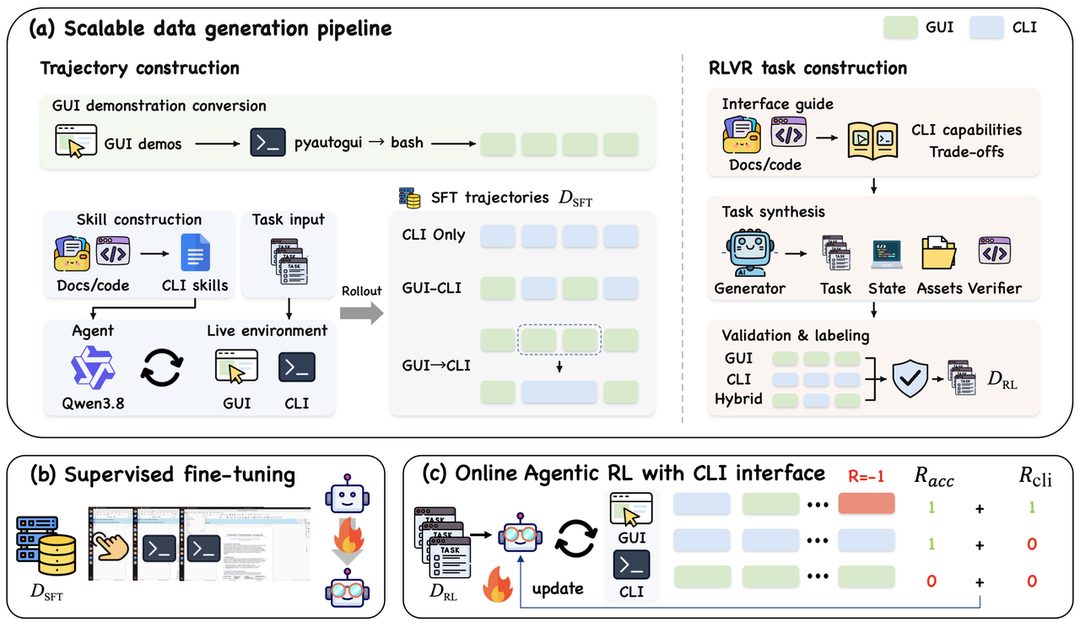
图 3:HybridCUA 整体框架。(a)可扩展的混合数据生成流程;(b)监督微调;(c)带 CLI 感知奖励的在线智能体强化学习
3.1 统一的 GUI–CLI 动作空间
HybridCUA 没有为 GUI 和 CLI 分别设计两套工具,而是将所有可执行交互统一为同一个 bash 动作:
CLI 操作: 直接写 Shell 命令,如
ls、sed、python3脚本等;GUI 操作: 在 Python heredoc 中调用
pyautogui,完成点击、拖拽、输入等动作。
每一步,模型都会接收当前截图以及上一条命令的 stdout/stderr。这种统一的“动作语法”让两种接口能够在同一步中自然衔接。消融实验显示,统一 bash 动作比“GUI、CLI 分开两个工具”的设计高出 7.2 个百分点(46.0% vs. 38.8%)。
3.2 三类执行模式的轨迹构造
研究团队的一个关键观察是:混合监督并不需要从零采集,因为许多 GUI 操作序列本身就存在等价的 Shell 命令。基于这一点,HybridCUA 构建了覆盖三类执行模式的可扩展数据流程:
纯 GUI 轨迹: 将开源 UI-MOPD 轨迹中的每个 GUI 动作改写为等价的
pyautogui代码,统一到bash动作格式中;纯 CLI 轨迹: 从应用文档和参考代码中提炼出各应用的 CLI 技能说明,让 Qwen3.8-27B 借助这些技能和 Claude Code 执行框架,在 CUA-Gym 任务上仅用 CLI 求解,并保留成功轨迹;
GUI–CLI 交错轨迹: 一方面让模型在执行中自由切换两种接口;另一方面将 GUI 轨迹中“在终端里逐字敲命令”的片段还原为完整命令并改写为 CLI 动作,再回放验证,只保留成功的轨迹。
最终得到 5,023 条 SFT 轨迹,覆盖 11 个应用领域,其中纯 GUI 870 条、纯 CLI 3,155 条、交错轨迹 998 条。
3.3 带“CLI 优势标签”的 RLVR 任务
在 CUA-Gym 流程基础上,研究团队为每个应用编写接口指南,列出 CLI 更高效或更可靠的操作,以及必须或更适合用 GUI 完成的操作,让任务生成器能够定位两种接口的能力边界,合成需要混合操作的任务。每个任务都配有初始环境、所需素材和可执行的验证器,最终保留 3,000 个可验证任务。
更重要的是,每个任务都带有一个 CLI 优势标签:对每个任务,分别在纯 GUI、纯 CLI、GUI–CLI 三种模式下各采样 16 条轨迹,按成功率排序,成功率接近时再比较步数。若 CLI 模式明显占优,则 ,否则 。
3.4 两阶段训练:先学会“怎么做”,再学会“怎么选”
阶段一:监督微调。 将三类轨迹混合训练,让模型掌握统一动作格式下的 GUI 控制、Shell 命令执行和接口切换。
阶段二:CLI 感知的在线强化学习。 模型在真实的 GUI–CLI 双接口环境中交互,并用 GRPO 优化。为了弥补结果奖励的“监督盲区”,HybridCUA 设计了两个粒度互补的奖励信号:
任务级奖励 :教模型“何时”用 CLI。 只有当轨迹成功、且是否使用 CLI 与任务标签一致时,才给予额外奖励:
步骤级奖励 :教模型“如何”用好 CLI。 利用终端反馈,对出现 Shell 执行失败的命令给予 的惩罚,并且只施加在对应动作的 token 上:
这样,即使任务最终成功,中途写错的命令也不会被“一笔勾销”。前者在轨迹层面决定接口策略,后者在动作层面提升命令可靠性。
4. 实验结果
HybridCUA-9B 以 Qwen3.5-9B 为基座进行训练,主要在 OSWorld 的全部 361 个任务上评测,每个任务最多 50 步;并在 OSWorld-MCP 与 WindowsAgentArena 上测试泛化能力。
4.1 主实验:同尺寸最佳,步数大幅缩短
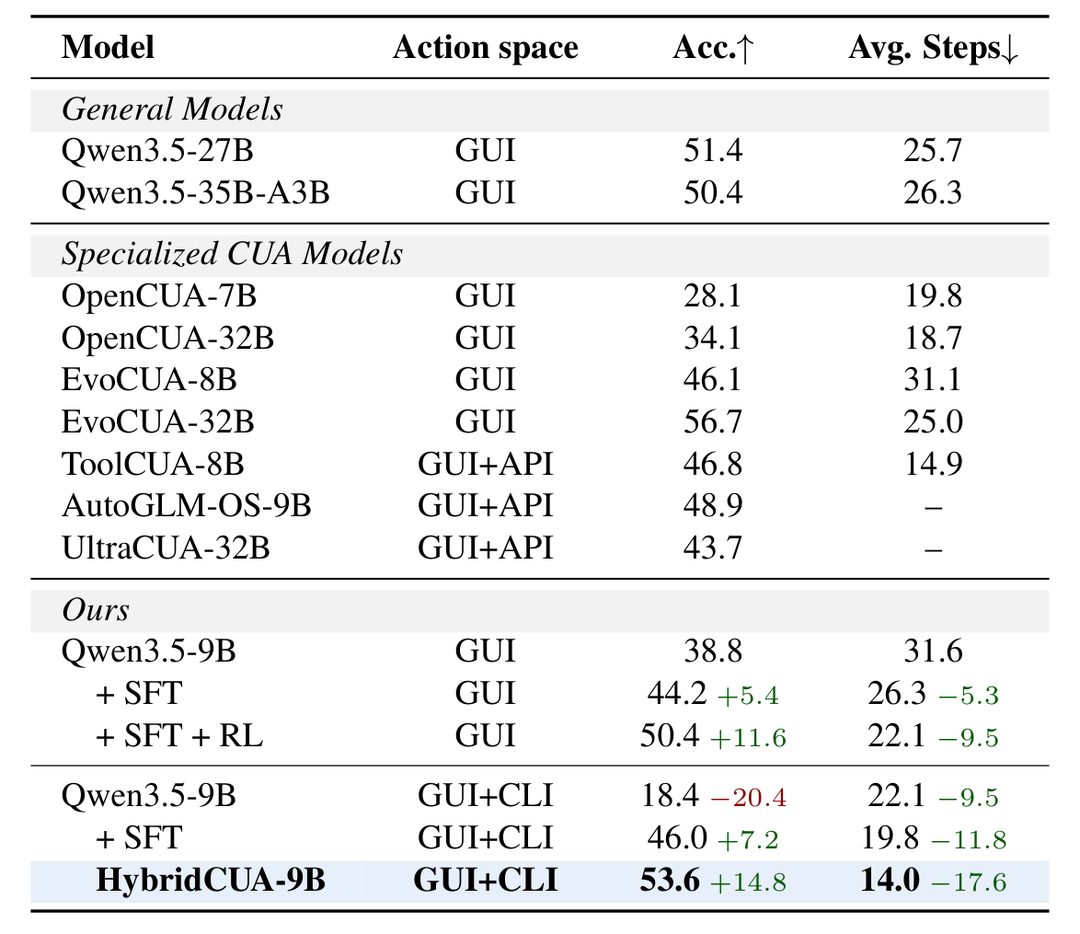
表 1:OSWorld 主实验结果。HybridCUA-9B 以 53.6% 的准确率和 14.0 的平均步数在同尺寸模型中双双领先
GUI+CLI vs. 纯 GUI。 为了公平比较,研究团队在相同基座、相近规模的 SFT 数据、相同 RL 任务和训练步数下,同时训练了一个纯 GUI 版本。结果显示,第二种接口在两个阶段都带来收益:
SFT 后:46.0% vs. 44.2%,平均步数 19.8 vs. 26.3;
RL 后:53.6% vs. 50.4%,平均步数 14.0 vs. 22.1。
GUI+CLI vs. GUI+API。 HybridCUA-9B 分别超过 AutoGLM-OS-9B 4.7 个点、ToolCUA-8B 6.8 个点,并超过参数量约为其 4 倍的 UltraCUA-32B 9.9 个点。值得注意的是,这三个方法都依赖应用专属 API,而 Shell 无需为每个应用单独构建。
4.2 消融实验:两个奖励各司其职
SFT 数据配比。 混合三类轨迹训练达到 46.0%,分别比只用纯 GUI、纯 CLI、交错轨迹训练高出 2.8、14.3 和 5.0 个百分点。即使只用交错轨迹也不如混合数据,说明单接口示范与混合轨迹提供了互补的监督信号。
RL 的作用。 在 SFT 基础上,RL 将准确率从 46.0% 提升至 53.6%,平均步数从 19.8 降至 14.0,减少 29.3%。
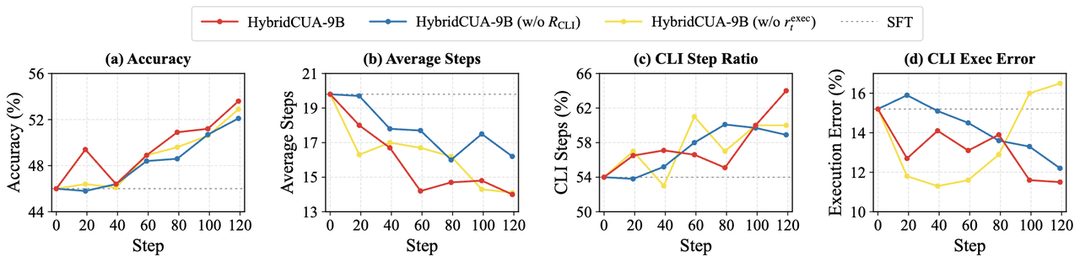
图 4:RL 训练过程中准确率、平均步数、CLI 步数占比与 CLI 执行错误率的变化
进一步拆解两个 CLI 感知奖励:
去掉 : 准确率损失不大,但效率提升停滞,CLI 占比只能达到 58.9%(完整模型为 64.0%),步数仅缩短 18.2%(完整模型为 29.3%);
去掉 : 准确率和步数基本不变,但 CLI 执行错误率在训练后期回升至 16.5%,甚至高于 SFT 水平;完整模型则稳定在 11.5%。
由此可见,任务级奖励决定“何时”用 CLI,步骤级奖励决定命令执行得“多可靠”。
4.3 泛化实验:跨环境、跨操作系统均有效
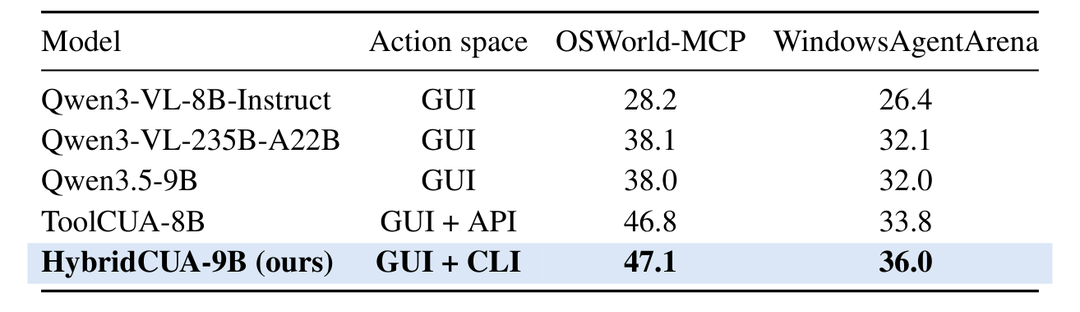
表 2:OSWorld-MCP 与 WindowsAgentArena 上的泛化结果
OSWorld-MCP: HybridCUA-9B 达到 47.1%,比 Qwen3.5-9B 高 9.1 个点,与依赖专属 API 的 ToolCUA-8B 相当;
WindowsAgentArena: HybridCUA-9B 达到 36.0%,分别超过 Qwen3.5-9B 和 ToolCUA-8B 4.0 和 2.2 个点。
一个有趣的现象是:模型只在 Linux Shell 上训练,却能在 Windows 上自发使用 PowerShell 命令。 这说明它迁移的不是死记硬背的命令,而是“什么时候该把任务交给 Shell”的判断能力。
4.4 模型学到了什么?按需选择接口
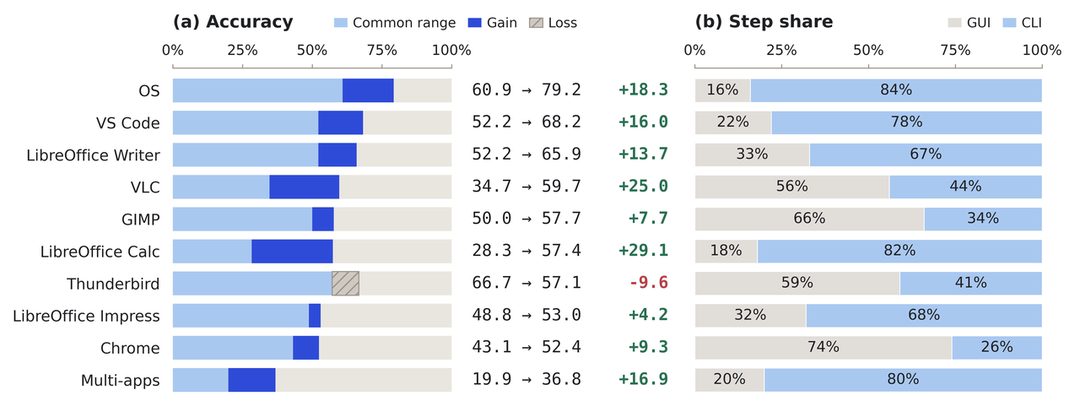
图 5:OSWorld 各领域的准确率与 GUI/CLI 步数占比
HybridCUA 并不是一味地多用命令行,而是会根据领域特点选择接口:
在 OS 类任务中,CLI 占比高达 84%,因为 Shell 可以直接访问文件和系统设置;
在 Chrome 类任务中,GUI 占比达到 74%,因为交互主要围绕网页展开。
按操作类型看,内容编辑(85.8%)和结果校验(98.4%)主要由 CLI 完成,适合直接操作数据和检查状态;而空间调整则更偏向 GUI(58.4%),因为位置和布局需要视觉反馈来引导。
下面是一个论文写作格式调整的真实案例:
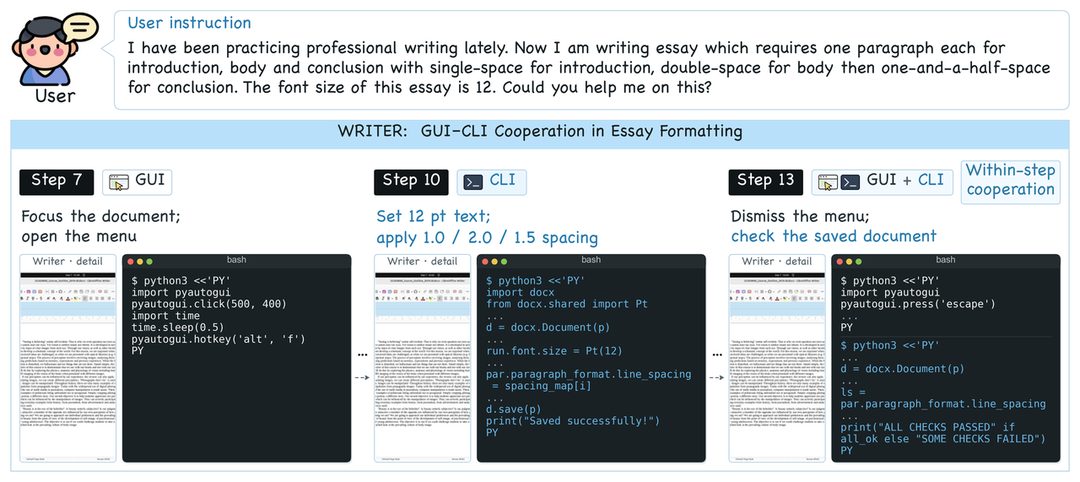
图 6:Writer 中的文章格式调整任务,展示了跨步骤与单步内两个层次的 GUI–CLI 协作
跨步骤协作: 第 7 步用 GUI 聚焦 Writer 窗口并打开菜单;第 10 步用 CLI 调用 python-docx,将全文设为 12 号字,并分别为引言、正文、结论设置 1 倍、2 倍和 1.5 倍行距;
单步内协作: 第 13 步在同一个
bash调用中,先用pyautogui关闭菜单,再通过 CLI 重新读取已保存的文件,逐项校验字号和行距。
5. 总结与思考
这项研究从“接口选择”的视角重新审视了电脑操作智能体的能力边界。分析表明,简单地给强模型开放命令行不仅不会带来收益,反而会造成明显下降。真正的瓶颈不在于能否访问 Shell,而在于何时以及如何使用它。
为此,HybridCUA 从数据和训练两侧同时补齐短板:用可扩展的数据流程构造三类执行模式的轨迹,让模型“见过”混合行为;再用任务级 和步骤级 两个 CLI 感知奖励,把接口选择和命令可靠性变成显式的训练信号。
多个基准的结果指向同一个结论:更好的电脑智能体,不是更多地使用命令行,而是在合适的时候选对接口。 GUI 与 CLI 的能力是互补的,学会编排二者,是通往准确、高效、可泛化的电脑智能体的一条有前景的路径。
当然,这一方向仍有探索空间。HybridCUA 的收益依赖于命令行接口的可用性与稳定性;对于没有可用 CLI 的应用、受限 Shell 环境,或命令语义差异更大的操作系统,可能需要不同的接口选择策略。此外,当前数据构造主要围绕 OSWorld 中的应用展开,未来可以将数据流程扩展到更多专业领域应用和分布外环境,进一步提升对未见应用与工作流的泛化能力。
研究团队将开源全部轨迹数据、RLVR 任务、数据生成与训练流程,以及 HybridCUA-9B 模型。

本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。