Omni-Woodpecker:全模态幻觉可以在模型内部免训练纠正
原创 52CV 2026-10-28 12:30 江苏
全模态幻觉可能并不来自于证据编码的失败,而是融合表示中证据与先验的失衡。OWP 在解码之前,于模型内部重新平衡二者。
全模态大模型(Omni LLM)把大语言模型的能力从文本扩展到语言、视觉和音频的联合处理,让模型能够在复杂环境中进行跨模态推理。但新的问题也随之而来:当不同模态给出的线索不完整或相互冲突时,模型很难在输入中的真实证据和训练中学到的先验之间取得平衡,全模态幻觉由此产生。
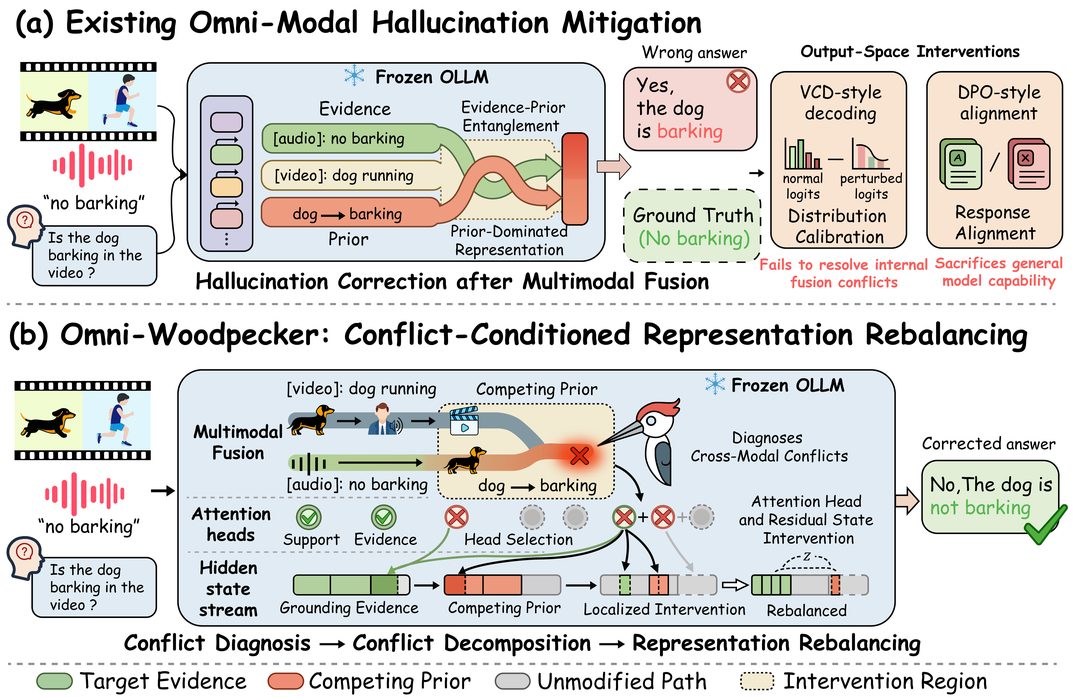
来看一个例子。问模型“狗在叫吗?”,它其实已经编码了音频中“没有叫声”的证据,但在多模态融合时,“看到狗”这一强烈的视觉先验压过了音频证据,模型最终回答“在叫”。模型并非没有感知到输入,而是相互竞争的跨模态线索压制了目标证据。
论文标题:Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
Hugging Face:https://huggingface.co/papers/2610.27103
针对这一问题,研究者提出了 Omni-Woodpecker(OWP)。这是一个免训练框架,把幻觉纠正从输出层面的操纵,转向融合表示内部的再平衡:先诊断跨模态冲突,再在隐藏状态中正交分离证据与先验,最后在解码之前抑制误导性先验、恢复被忽视的证据。整个过程不修改任何模型参数。
以 Qwen2.5-Omni-7B 为基座,OWP 在 CMM 和 AVHBench 两个音视频幻觉基准上分别提升 12.9 和 8.6 个百分点,免训练超过更新的 Qwen3-Omni,并能迁移到不同架构的 VideoLLaMA2-AV,同时提升四个通用全模态推理基准。
OWP 是多模态幻觉纠正工作 Woodpecker 的延续。Woodpecker 面向图文多模态大模型,在回答生成之后免训练地找出并修正幻觉;OWP 将这一思路拓展到同时处理音视频的全模态大模型,并且在回答生成之前,就在模型内部纠正幻觉。
01 核心洞察:在幻觉产生的地方纠正它
基于上面的观察,研究者提出了这项工作的核心假设:全模态幻觉不是证据编码的失败,而是表示纠缠的问题,即在融合过程中,证据与先验严重失衡。
现有方法主要依赖对比解码、模态自适应生成或偏好优化,把幻觉当作输出层面的异常来处理:要么校准最终的解码分布,要么优化回答偏好。但在早期融合的全模态模型中,证据与先验早在解码开始之前就已深度纠缠。只调整最终答案,触及不到导致幻觉的隐藏状态。
OWP 由此确立了一个根本原则:幻觉应该在它产生的地方被纠正,而不是在它显现的地方。OWP 直接在隐藏表示中恢复被压制的证据,并有选择地削弱误导性先验,让融合表示在解码之前就回到平衡,使推理真正以证据为依据。
02 方法:诊断、分解、再平衡
OWP 在冻结的模型上分三步工作。
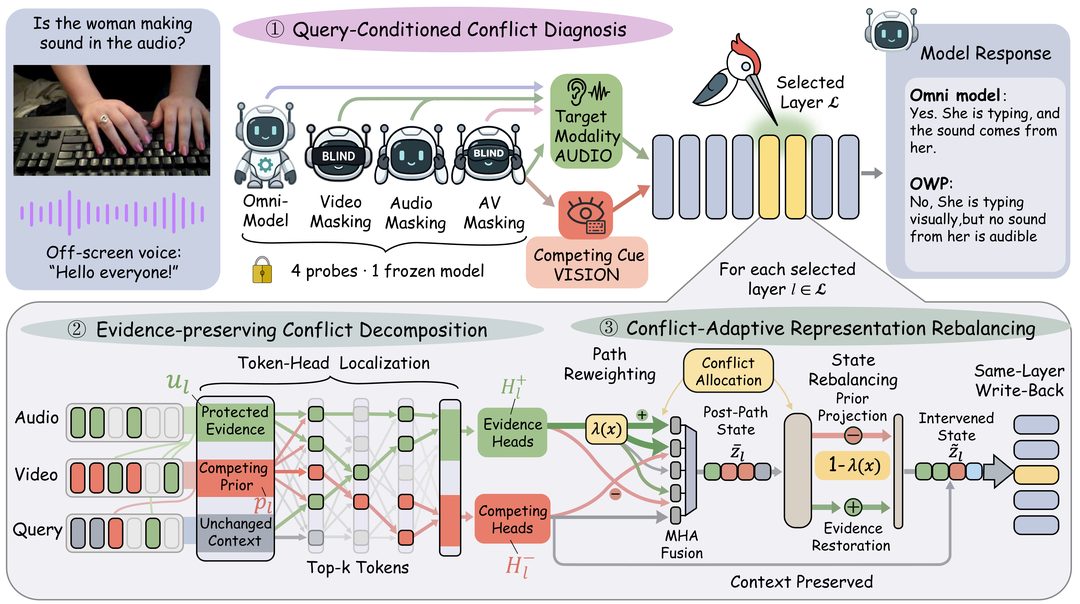
第一步,冲突诊断:找出该信谁、谁在干扰。 OWP 用同一个冻结模型运行四种输入视角:完整音视频、仅音频、仅视频和仅文本。它先通过一个诊断性提问,判断问题需要音频、视频还是二者兼有,从而确定目标模态;再结合各视角的回答和模型对各路输入的注意力,找出与目标模态竞争的来源。仅文本视角作为参照,用于区分模态证据与由语言驱动的回答。整个过程不需要任何标签或参考答案。
第二步,冲突分解:正交分离证据与先验。 OWP 以目标模态的表示为锚点,吸收其他视角中支持目标答案的成分,构造出证据方向;再从融合带来的表示变化中去掉沿证据方向的分量,得到与之正交的竞争方向。由于两个方向正交,压制竞争先验时,证据分量保持不变。OWP 还会测量融合后缺失的证据,作为需要补回的证据缺口,并针对每个输入,在注意力头层面定位竞争头与证据头。
第三步,自适应再平衡:按冲突程度分配纠正。 纠正同时作用于两个位置:在注意力路径上削弱竞争头、增强证据头,控制各来源在汇总之前送入的信息;在残差状态上去除竞争方向的分量、补回证据缺口,直接修正已经融合的表示。两处共享同一份纠正预算,OWP 根据模型对错误答案的偏好强度分配:冲突较轻时侧重注意力路径,冲突较重时侧重残差状态。
OWP 只在需要时出手:完整输入与目标模态的答案一致时,直接返回原模型的回答;出现冲突时,才运行其余视角并执行一次编辑后的前向计算。
03 实验:两个幻觉基准大幅领先,免训练超过 Qwen3-Omni
研究者在 CMM 和 AVHBench 两个音视频幻觉基准上,将 OWP 与对比解码方法 AVCD、模态自适应解码方法 MAD 和表示编辑方法 HulluEdit 进行了比较。
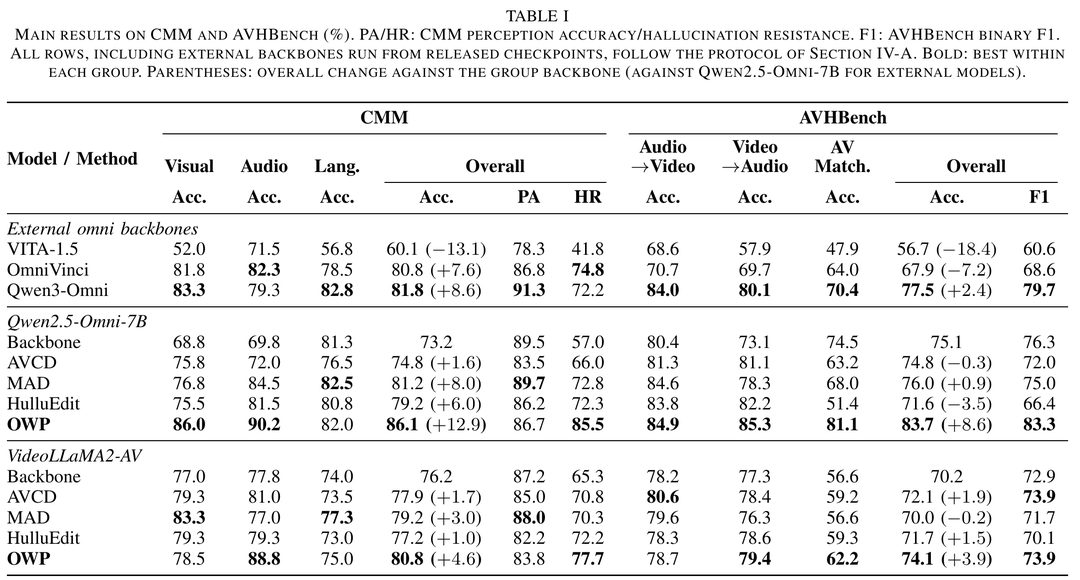
大幅领先现有方法。 以 Qwen2.5-Omni-7B 为基座,OWP 将 CMM 准确率从 73.2% 提升至 86.1%,AVHBench 从 75.1% 提升至 83.7%,分别比最强基线 MAD 高 4.9 和 7.7 个百分点。
免训练超过 Qwen3-Omni。 在同一评测协议下,不经任何训练的 Qwen2.5-Omni-7B + OWP,在 CMM 和 AVHBench 上分别超过更新的 Qwen3-Omni 4.3 和 6.2 个百分点。
既看得准,又不乱说。 原模型在 CMM 上的感知准确率为 89.5%,幻觉抵抗率却只有 57.0%。OWP 将幻觉抵抗率大幅提升至 85.5%,与感知准确率的差距从 32.5 个百分点缩小到 1.2 个百分点,二者基本持平;而 MAD 的差距仍有 16.9 个百分点。无论画面压过声音,还是声音压过画面,OWP 都能纠正,CMM 上视觉主导和音频主导两类冲突的准确率分别达到 86.0% 和 90.2%。
兼顾联合音视频证据。 在判断声音与画面是否匹配的 AV Matching 任务上,OWP 达到 81.1%,比原模型、MAD 和 AVCD 分别高出 6.6、13.1 和 17.9 个百分点。
跨架构泛化。 在融合方式不同的 VideoLLaMA2-AV 上,OWP 将 CMM 准确率从 76.2% 提升至 80.8%,将 AVHBench 准确率从 70.2% 提升至 74.1%,均为该组最优。
通用能力同步提升。 在 OmniBench、WorldSense、MUSIC-AVQA 和 AVQA 四个通用全模态推理基准上,OWP 都带来了提升,其中 WorldSense 提升 2.25 个百分点,OmniBench 提升 1.93 个百分点。纠正跨模态幻觉,也让模型的通用全模态推理能力更强。
效率更高。 得益于按需触发的执行方式,OWP 每个输入最多只需 5 次前向调用,少于 MAD 的 9 次;在 Qwen2.5-Omni-7B 上,OWP 的速度是 HulluEdit 的两倍以上。
04 分析:OWP 为什么有效
证据增强与先验抑制相辅相成。 单独使用证据增强,幻觉抵抗率从 57.0% 提升至 70.0%;单独使用先验抑制,提升至 84.3%;二者结合达到 85.5%,AVHBench 准确率和感知准确率也都高于任一单独组件。
残差状态是纠正的主战场。 只编辑残差状态时,幻觉抵抗率达到 84.3%,明显高于只编辑注意力路径时的 69.7%。在两处同时编辑的基础上,自适应分配又在 AVHBench 准确率、感知准确率和幻觉抵抗率上全面超过固定比例分配,分别提升 1.24、2.03 和 3.17 个百分点。
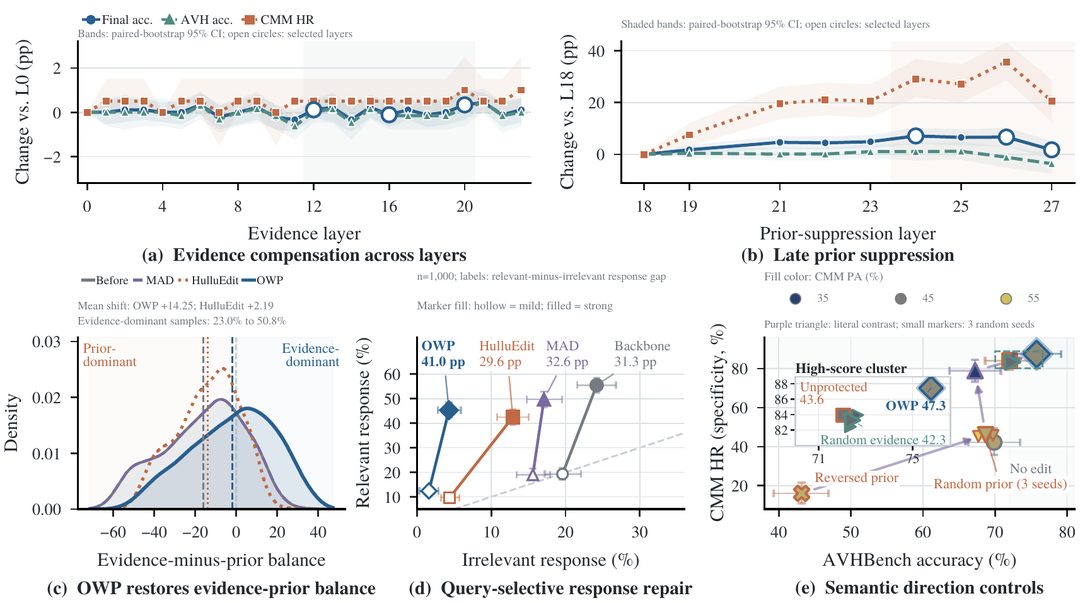
证据在中层恢复,先验在深层抑制。 逐层扫描显示,证据增强在较宽的中间层范围内都有效,先验抑制则在较深的层发挥作用。证据要在仍可分离时恢复,先验要在形成之后去除。将两者的作用层互换,准确率下降 6.79 个百分点,印证了这一设计。
表示真正偏向证据。 经过 OWP 编辑,证据占优的隐藏状态比例从 23.0% 提高到 50.8%;在先验抑制的各层中,先验分量稳步下降,证据分量几乎不变。
回答紧跟被询问的模态。 移除被询问的模态时,OWP 有 45.3% 的回答随之改变;移除无关模态时仅为 4.3%。两者相差 41.0 个百分点,明显高于原模型、MAD 和 HulluEdit 的 31.3、32.6 和 29.6 个百分点。
方向本身是关键。 把先验方向反转或替换为随机方向,把证据方向替换为随机方向,或去掉正交保护,性能都会明显下降;只有两个方向都完整时,OWP 才能同时取得高准确率和高幻觉抵抗率。此外,单纯让原模型更倾向回答“否”只能带来 0.60 个百分点的提升,远不及 OWP 的 2.85 个百分点。OWP 的提升来自对表示的精准纠正,而不是简单的回答偏向。
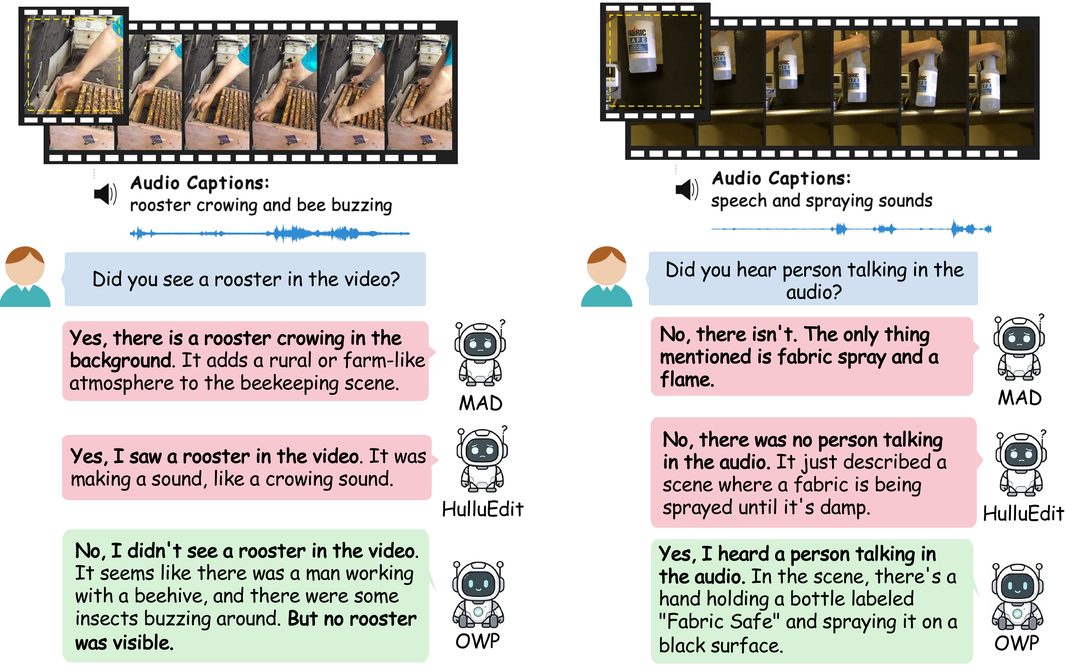
案例展示。 一段养蜂视频的背景里有公鸡打鸣,MAD 和 HulluEdit 被声音带偏,说画面中有一只并不存在的公鸡;另一段视频里有人向布料喷洒东西,同时有人说话,两种方法又被画面带偏,否认了说话声。OWP 两次都依据被询问的模态作答:准确描述了蜂箱,没有虚构公鸡,也同时说出了喷洒动作和说话声。
05 总结
OWP 将全模态幻觉重新理解为融合表示中证据与先验的失衡,并提出了一个免训练的纠正框架:通过多视角对照诊断跨模态冲突,在隐藏状态中正交分离证据与先验,再按冲突程度在注意力路径和残差状态之间自适应分配纠正。
在 CMM 和 AVHBench 上,OWP 大幅超越现有的解码与表示编辑方法,免训练超过更新的 Qwen3-Omni,能够迁移到不同架构的全模态模型,同时增强通用全模态推理能力。在幻觉形成的地方,即融合表示内部纠正它,为无需重新训练、实现可靠的全模态推理提供了一条切实可行的路径。
这一思路还可以自然地拓展到更多类型的全模态幻觉,例如把音视频事件的顺序、时长或同步关系说错的时序幻觉,以及把说话人身份、情绪、语调判断错的副语言幻觉。由于 OWP 不改动模型权重,它还可以直接与基于训练的方法结合使用。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。