首个Jev版OCR模型发布,最全教程来了!
原创 Datawhale 2026-10-28 22:00 浙江
Datawhale干货
教程:MiniCPM-OCR
文档解析进入大模型时代之后,在基准榜单上刷到 90 多分,早就不是新闻了。
但在财税、金融这类对准确率极度敏感的场景里,其实还不敢完全放开使用。因为模型能认对 95% 的内容,却没人说得清剩下的 5% 究竟错在哪里,还是需要人工复核。前端 AI 省下的录入时间,往往又被后端的人工校对消耗掉了。
今天凌晨,面壁智能开源了新一代 MiniCPM-OCR,带来了首个「Jev 版」OCR 架构。
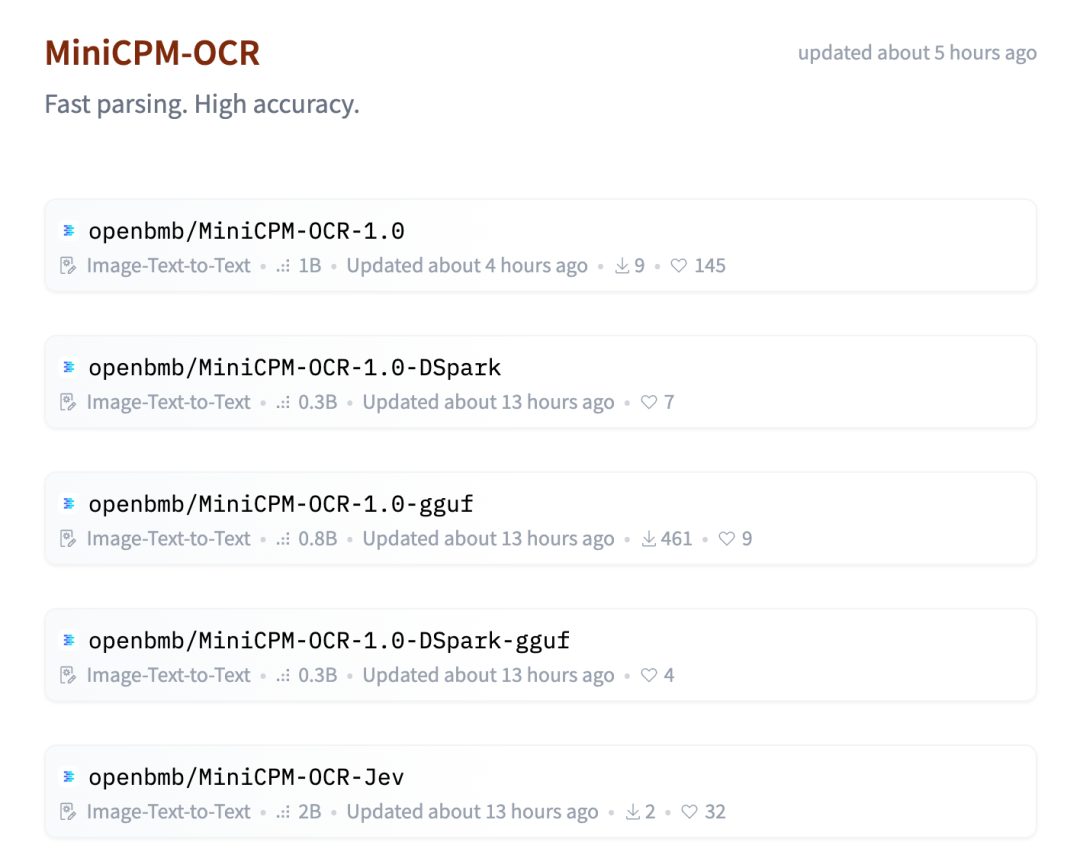
它的核心理念叫「可信 OCR」,不依赖单模型死磕参数,而是「读判分离」:前端用 1.3B 的 MiniCPM-OCR 1.0 负责读,后端用 2B 的 MiniCPM-OCR Jev 专门负责打可信分。只有系统能主动标出哪里可能认错,自动化入库才算真正的成功。
这篇文章,我们会带大家从核心源码入手,拆解模型的实现逻辑,再一步步完成本地部署,把模型跑起来。
一、OCR 模型如何实现「读判分离」
1. 负责读的模型,1.3B 端到端小体量
传统的文档解析流水线,通常由版面分析、文本行检测、单行字符识别、公式表格专用模型和阅读顺序拼接等多个模块串联而成。链路一长,前序切框的微小偏差就会往后传导,工程维护成本也很高。
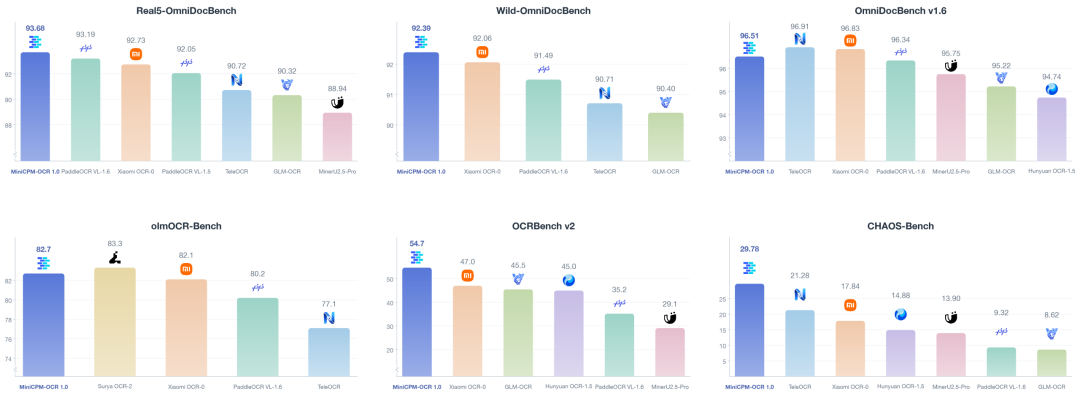
MiniCPM-OCR 1.0 采用 SigLIP 视觉底座配合 Qwen3.5 混合注意力语言主干,版面切块后,直接输出结构化的 Markdown 正文、LaTeX 公式、HTML 表格以及带坐标的阅读顺序。
2. 负责判的模型,只对结果打出可信度分数
解析模型刷到再高分,依然回答不了一个问题:输出一份看似规整的表格,业务系统如何判断是否出现了行列错位?
为什么不能让解析模型自己给自己打分?因为自回归生成模型在逐字解码时有很强的「语言先验」。哪怕它把票据里的数量少看了一个零,或者把公式里的上下标吞掉了,只要生成的文本在语法上通顺,模型内部的 Token 预测概率依然很高,很难靠自身的生成置信度抓出事实错误。
为此开源的 2B 结果决策模型 MiniCPM-OCR Jev,完全抛弃了文本生成,纯粹作为质检员运行,其底层设计有三个值得注意的技术细节。
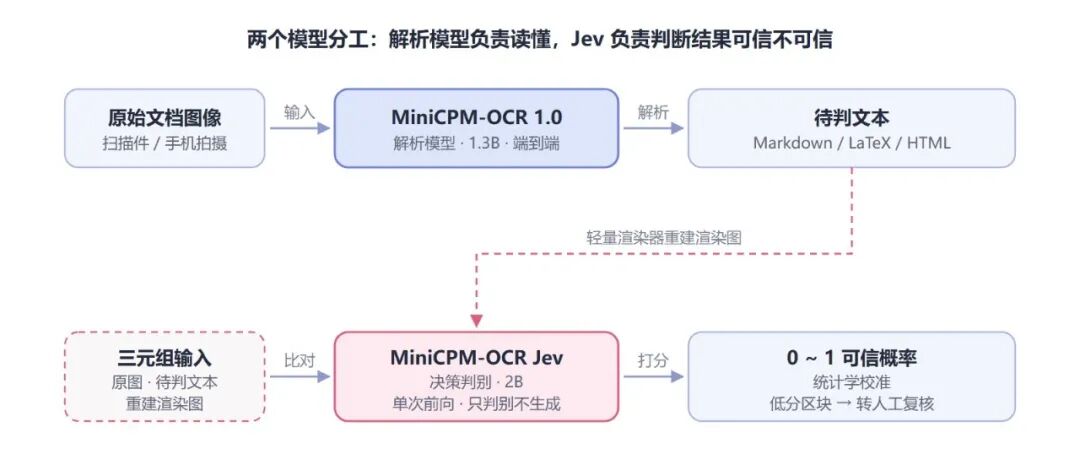
第一是输入形态。Jev 不需要人工标注的参考答案,它的输入是由「原图块、待判解析文本、文本重建渲染图」组成的三元组。模型把生成的代码重新渲染成图,在视觉空间比对版式结构,在跨模态空间比对字符语义。错列、漏行或角标退化,比对之下都会原形毕露。
第二是非自回归的单次前向判别架构。我们在服务器上解包 Jev 的权重时发现,它在 2B 的 Qwen3.5 主干之上直接挂了一个维度为 [2, 2048] 的二分类线性打分头(score.weight),权重文件里物理上没有语言生成头 lm_head。这意味着 Jev 从物理结构上就不会生成文本,也不会擅自改写识别结果。它只做一次前向计算,取出末尾位置的隐状态算出「一致」与「不一致」两个分值,避开了质检环节产生二次幻觉的风险,单块判别耗时也压在百毫秒级。
第三是判别能力与跨模型通用性。Jev 输出的 0 到 1 分数直观反映了可信度,得分越高,模型越倾向于判定结果正确,实际准确率也可在具体的业务数据上进一步验证。在官方 JevOCRBench 上其 AUROC 达到 93.6。即便上游换成 GLM-OCR 或 PaddleOCR-VL-1.6 的解析输出,Jev 的判别 AUROC 依然能稳定在 0.919 到 0.934 之间。
二、三类真实文档实测
为了看清这套双模型在非理想环境下的表现,我们找了三张具有代表性的真实文档图片来测,分别对应手写商贸送货单、手机倾斜拍摄的证券研究报告和手写高等数学公式笔记。测试在官方工作台(minicpm-ocr-stp,开启旋转自适应)和我们的本地 GPU 算力机上同步展开。
1. OCR模型实测
先看第一张手写送货单。这是一张字迹连笔较重的日常商贸单据,包含表头、10 行商品明细和底部的合计金额。
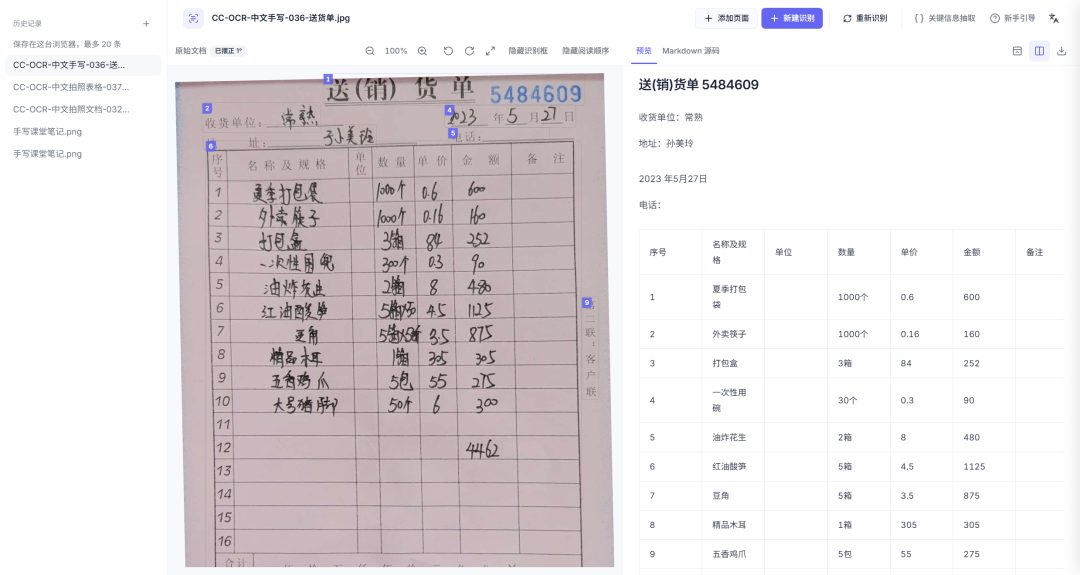
模型把整张单据的标题、日期、10 行商品明细和底部总额 4462 完整转成了可编辑表格。如果只扫一眼排版和总额,很容易觉得识别已经完全过关。
但逐行核对就会发现,第 4 行原图写的是「一次性围兜、数量 300 个、单价 0.3、金额 90」,模型输出变成了「一次性用碗、数量 30 个、单价 0.3、金额 90」。按输出的数字算,30 × 0.3 等于 9,跟同行的金额 90 直接矛盾。另外第 6、7 行原图数量写的是「5箱×50」,输出只保留了「5箱」,丢掉了后面的包装规格。
这恰恰是真实业务里最常见的情况,总额是对的,表格也是齐的,但部分行中的数量、单价与金额并不自洽
再看第二张手机倾斜拍摄的证券研究报告(兴业证券关于珠海冠宇的公开研报页),版面里混排了密集正文和两张跨列财务表格。
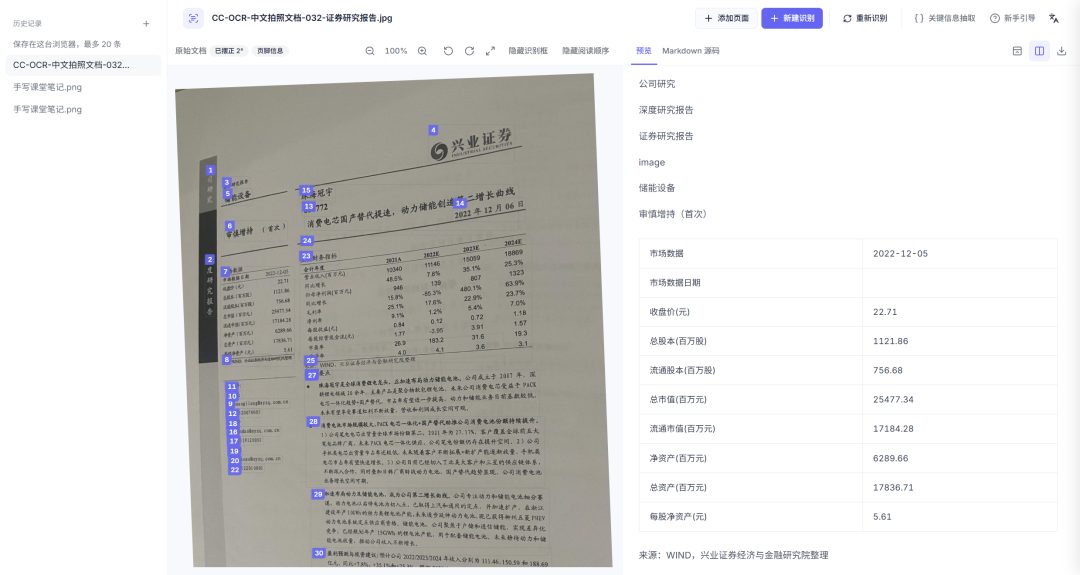
面对倾斜拍摄的纸面,MiniCPM-OCR 1.0 把正文和右侧的「主要财务指标」HTML 表格完整还原了出来,2021A 至 2024E 的营业收入(10340、11146、15059、18869 百万元)、归母净利润、毛利率、市盈率等核心财务数字全部准确。但在左侧窄栏里,三个分析师姓名都出现了形近字误识,而且「市场数据日期 2022-12-05」被错位塞进了上一行。我们用同一张图测了另一款主流开源视觉解析模型,后者读对了两个姓名和日期位置,但在其他样本上各有得失。数字读准了,字段对应关系依然可能出偏差。
第三张是一页网格纸手写高等数学公式笔记,包含围道积分、带约束极值、偏导数与分式等 5 组复杂公式。
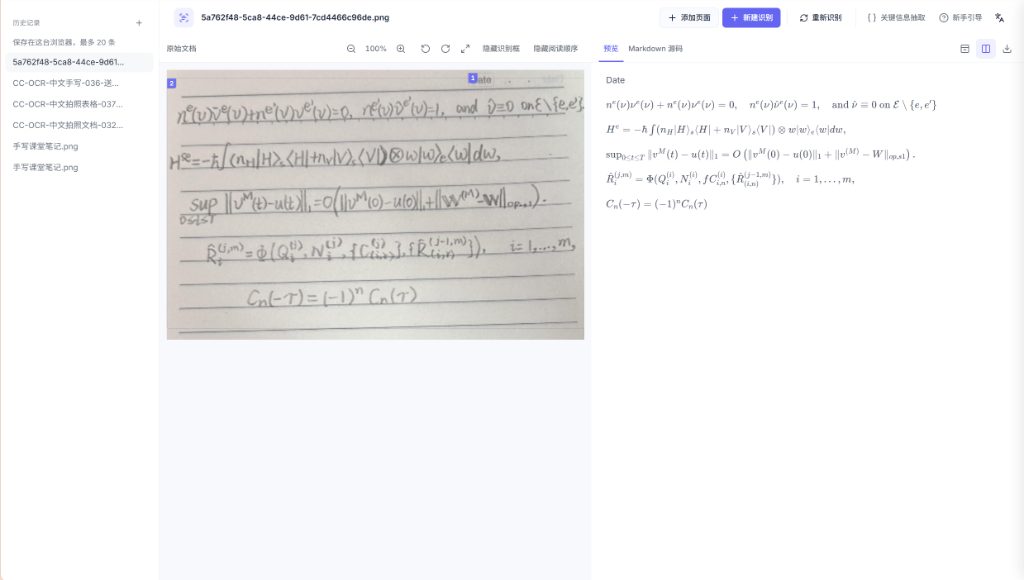
MiniCPM-OCR 1.0 直接从原图里把 5 组公式全部转成了标准 LaTeX 行间代码,其中 C_n(-\tau)=(-1)^nC_n(\tau) 逐符号完全一致,其余 4 组完整保留了积分号与多层分式结构,只在字母上方的横线(\bar{v})、撇号(e')和花体字母上出现了局部符号退化。
三张图测下来,模型已能完成大部分内容的自动转录,但局部的算术矛盾、字段错位或公式角标退化,单靠解析模型自己无法察觉。
2. Jev模型实测
这时候把结果交给后置的 MiniCPM-OCR Jev,它能给出多大的区分度?
我们在自有 GPU 算力机(NVIDIA GB10,aarch64 架构,128GB 统一内存)上把 MiniCPM-OCR 1.0 和 MiniCPM-OCR Jev 同时部署了起来,并用 OmniDocBench v1.6 里的 Putnam 数学竞赛证明段落块做真机闭环测试。
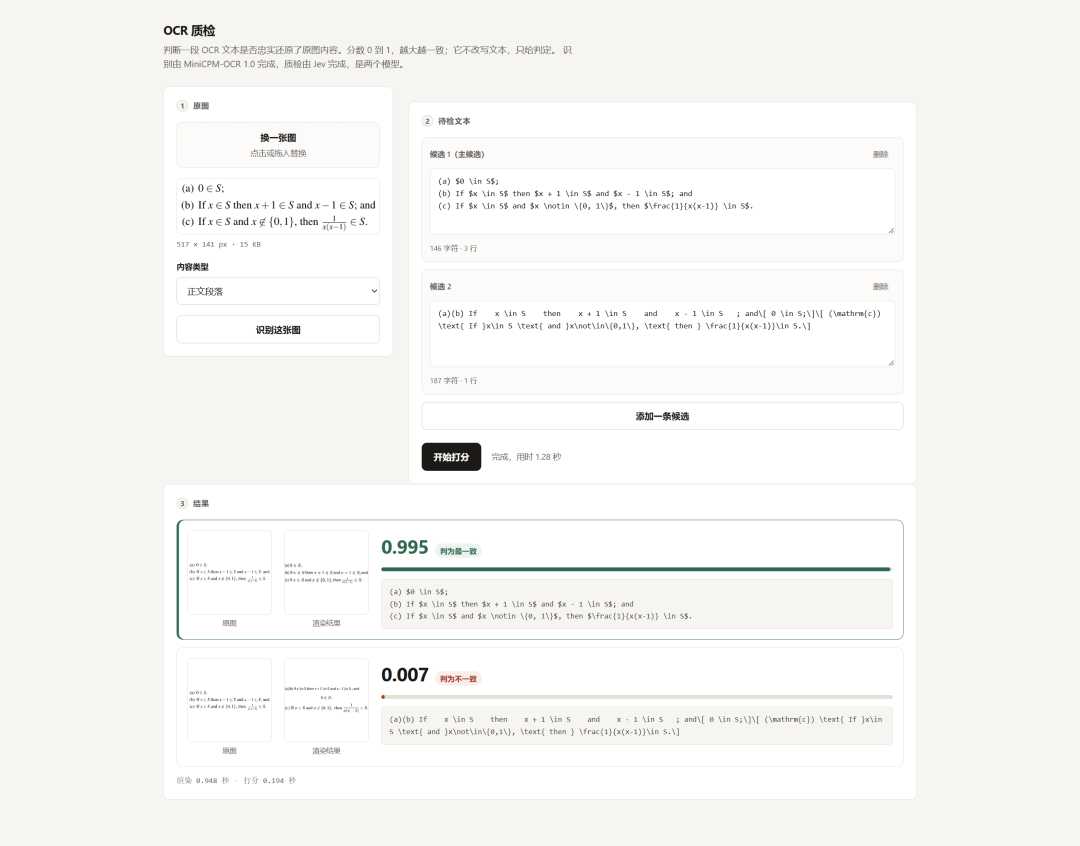
当输入人工确认的正确原文时,Jev 打出 0.99522 的高分(判定 PASS)。输入 MiniCPM-OCR 1.0 的实际识别结果时,Jev 同样打出 0.99505,与官方公布基准值偏差不超过 0.00021。
而当我们保持段落里的词汇几乎不变,仅仅把其中的证明逻辑顺序打乱,制造出一个看起来语法通顺的错误候选时,Jev 的打分瞬间跌到了 0.00707(判定 REJECT)。当我们人为删掉末尾一行制造漏行候选,Jev 的打分直接归零,变成 0.00000。
在 GB10 算力机上,Jev 单个候选块的前向判别耗时在 0.13 到 1.16 秒之间。跑完一次「1.0 识别图块、独立环境渲染成图、Jev 对三个候选打分排序择优」的完整闭环,端到端耗时只需要 2.5 秒。
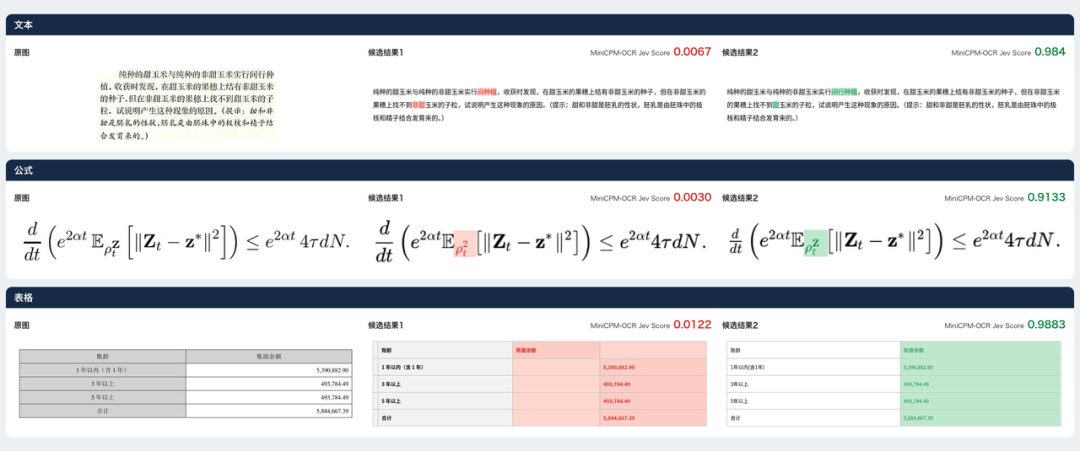
官方在多模态基准上的测试案例也呈现了同样的特性。无论是正文段落错序(0.984 对比 0.0067)、多行公式符号错漏(0.913 对比 0.003),还是无线表格的行列错位(0.988 对比 0.012),正确结果与瑕疵候选之间的分数都被拉得很开。业务系统既可以用它拦截低分异常块,也可以在多模型或多采样候选里自动挑出最高分的结果。
三、源码拆解与实验验证
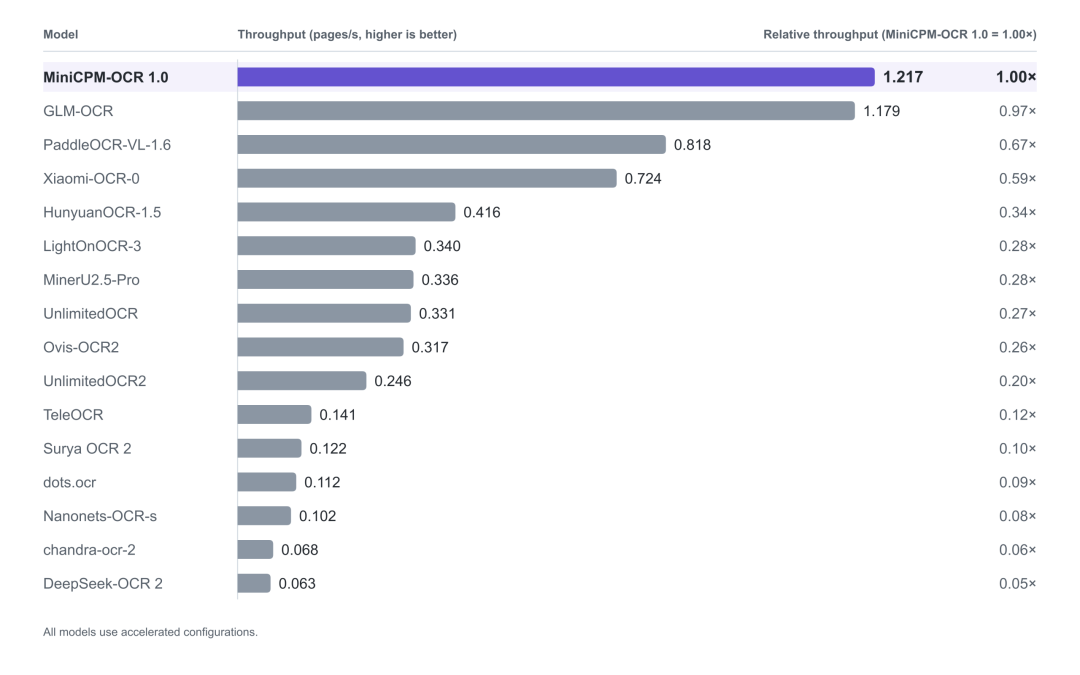
除了引入 Jev 解决结果可信度,MiniCPM-OCR 1.0 在推理速度上的提升同样明显。
1. 投机采样机制的优化策略
为什么一个端到端视觉语言模型能跑到每秒 1.2 页?翻看模型结构配置文件和源码,核心优化落在输入端的特征压缩和解码端的投机采样(Speculative Decoding)。
在输入端,高分辨率文档图像先经过自适应动态分片,通过早期 4 倍视觉词元压缩,把进入语言主干的序列长度砍掉了四分之三。同时,它的 24 层 Qwen3.5 语言主干采用了混合注意力设计,其中 18 层是 GatedDeltaNet 线性注意力,只有第 3、7、11、15、19、23 这 6 层保留了标准全注意力,长文档的显存和计算开销因此大幅下降。
在解码端,面壁同步开源了约 0.3B 参数的投机采样草稿模型 MiniCPM-OCR-1.0-DSpark。
文档解析的输出跟开放式闲聊不同,LaTeX 公式里的 \begin{aligned}、\frac 以及 HTML 表格里的 <tr><td> 标签有着很高的局部规律性。传统的自回归解码哪怕遇到固定标签,也得调动 1.3B 主模型一步一步跑满 24 层才能吐出一个 Token。
DSpark 只有 5 层解码器,它直接抽取主模型中间 5 个关键层的隐状态拼接降维,一次前向计算直接预测未来 15 个位置的草稿状态(block_size = 15)。接着通过一个秩为 256 的轻量级马尔可夫状态转移头校准相邻词元的转移概率,一次性交出 15 个候选词元给主模型并行核验。
这里两个配套模型的分工很清楚。DSpark 挂在主模型内部,负责让 OCR 主模型吐字更快,数学上保证输出逐字无损;Jev 独立运行在模型下游,负责在输出写完后进行独立判别打分。
2. 真机对比实验,前向计算减少 87%
为了验证 DSpark 在真实硬件上的提速幅度,我们在 NVIDIA GB10 算力机(aarch64,PyTorch 2.14.0+cu130,bfloat16)上拉取了权重,拿中文综合版面、数学竞赛证明正文、多行复杂数学公式和中文国标结构化表格 4 组真实样本(共生成 343 个词元),实测对比了标准贪婪解码基线与开启 DSpark 后的解码速度:
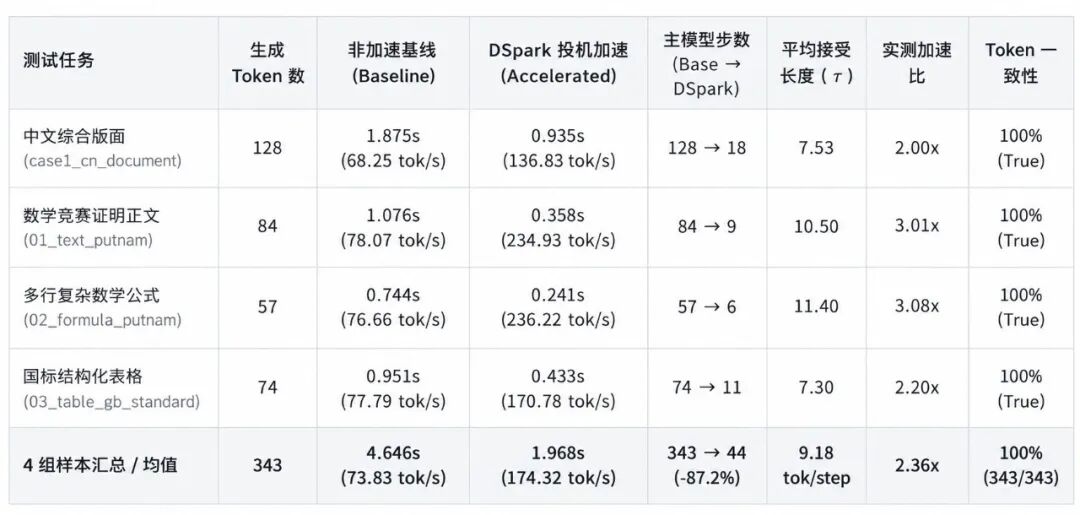
在标准基线下,生成这 343 个词元需要调用 1.3B 主模型前向计算 343 次,总耗时 4.646 秒,平均吞吐 73.83 tok/s。挂载 DSpark 之后,主模型的前向核验步数直接从 343 步降到了 44 步,前向调用次数减少了 87.2%,总解码耗时压到 1.968 秒,平均吞吐涨到 174.32 tok/s,整体跑出了 2.36 倍的解码加速。
在规律性最强的多行复杂数学公式场景(02_formula_putnam)上,DSpark 每次提出的 15 个草稿词元里,平均有 11.40 个被主模型一次通过。57 个公式词元只用了 6 次主模型前向就全部生成完毕,吞吐冲上 236.22 tok/s,单任务加速比达到 3.08 倍。
这 4 组任务生成的 343 个词元,与标准贪婪解码的结果逐位置比对,一致率是 100%。主模型加上 0.3B 草稿模型,运行时的显存峰值只有 4.33 GiB,比单跑主模型只多了约 0.53 GiB。
四、本地部署的踩坑与保姆教程
1. 轻量化部署,纯 PyTorch 跑通闭环
目前,面壁智能已经把 MiniCPM-OCR-1.0、MiniCPM-OCR-1.0-DSpark、MiniCPM-OCR-1.0-Jev 全系模型权重、微调框架和 JevOCRBench 评测集全部按 Apache-2.0 协议开源,原生支持 vLLM、SGLang、llama.cpp 和 Ollama 等常见推理后端。
我们在实际部署时遇到了一个很多开发者都会碰到的工程问题。官方文档的默认主路线依赖 vLLM 或 SGLang 加上 PaddlePaddle 版面检测,如果在 aarch64 架构机器(比如本次测试的 NVIDIA GB10)或者不方便编译重型依赖的环境里,这套默认依赖往往装不上。
为此,我们自己动手跑通了一条完全不依赖 vLLM、也不用编译 Paddle 的纯 transformers 轻量化部署路线。
解析与版面检测直接用 transformers 原生接口加载 MiniCPM-OCR-1.0,版面切块调用官方 SDK 内置的纯 PyTorch 权重(PP-DocLayoutV3_safetensors,仅 127MB),峰值显存只有 3.0 GiB。
Jev 质检服务同样基于 transformers 加载 Qwen3_5 主干,取出末尾位置的隐状态乘上 [2, 2048] 的打分矩阵直接输出校准概率。因为 Jev 的分数对渲染图的字体和行距敏感,我们把 playwright 1.62.0 与 Pillow 12.3.0 隔离在独立的渲染虚拟环境里,并给 Prompt 模板加上了 MD5 校验断言,防止依赖升级引起分数漂移。把 1.0 解析和 Jev 质检接成完整闭环,整套系统的峰值显存只有 5.18 GiB,单张消费级显卡就能塞下。
针对 MiniCPM-OCR-1.0 主干里的 18 层 Qwen3_5GatedDeltaNet 线性注意力在原生 transformers 下无法回退递归状态的问题,我们在核验窗口(1 < seq_len <= 16)内部加了一层逐位置递归状态快照与卷积窗口同步裁剪,不改动任何模型权重,就在纯 PyTorch 下跑通了 100% 无损的 DSpark 块投机加速。
2. 开源复现,几行命令直接跑起来
我们已经把这套轻量部署脚本、Jev 可视化打分网页以及 DSpark 基准测试代码全部整理开源到了 GitHub 仓库:
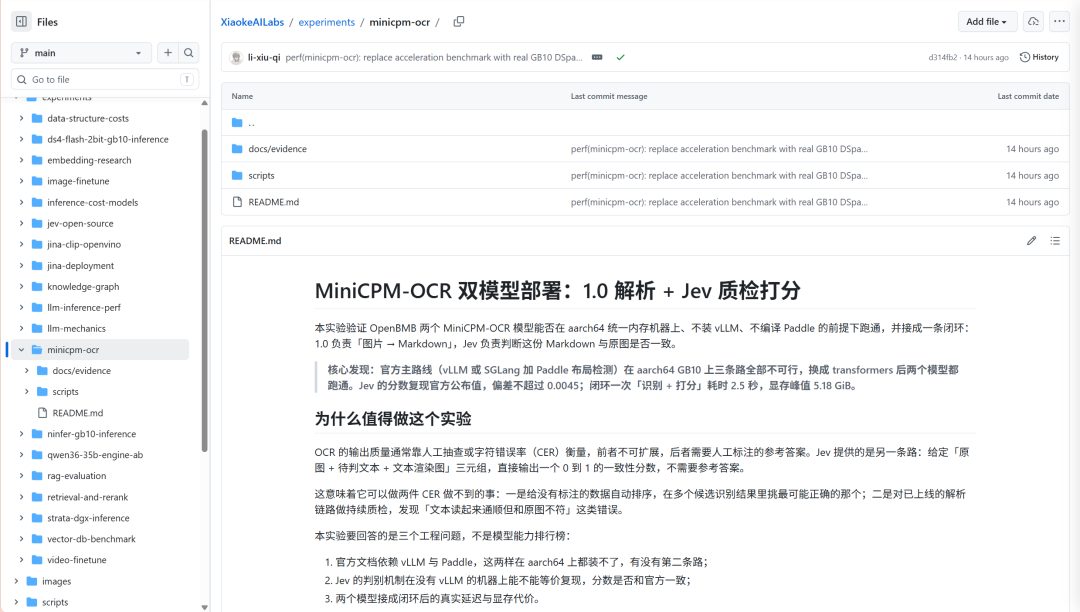
教程地址:https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/minicpm-ocr仓库里包含了三个可以直接运行的核心工具,scripts/benchmark_acceleration.py 用于一键跑通 DSpark 投机加速与非加速基线的吞吐及一致性对比,scripts/jev_server.py 与 jev_ui.html 提供纯 transformers 的 Jev 独立打分服务和并排比对网页,scripts/jev_loop_block.py 则用来跑通「1.0 识别图块、渲染、Jev 三候选打分排序」的完整闭环。
在自有 GPU 机器上,只需要三步就能拉起整套服务并复现加速测试:
git clone https://github.com/li-xiu-qi/XiaokeAILabs.gitcd XiaokeAILabs/experiments/minicpm-ocrbash scripts/01_download.shbash scripts/minicpm-ocr.sh start && bash scripts/jev_server.sh startbash scripts/run_acceleration_benchmark.sh
写在最后
回看过去几年 OCR 的演进,全行业基本都在卷识别率。
但当端到端大模型把识别率提高到 90% 以上, 继续往上提分的边际收益已经越来越低了。
如何让识别结果可信,成了 OCR 大规模落地必须回答的问题。
面壁智能这次把 MiniCPM-OCR 1.0、MiniCPM-OCR Jev、DSpark 一起开源,给工业界交出了一套兼顾速度与安全感的流水线方案。
随着这套双模型放出,面壁 MiniCPM-V/o 多模态系列在全球全平台的累计下载量也突破了 6500 万。如果你的团队正在搭建文档解析或 RAG 知识库入库流水线,不妨试试 MiniCPM-OCR。
官方在线体验工作台:https://platform.modelbest.cn/console/playground/document-parse官方 GitHub 开源仓库:https://github.com/OpenBMB/MiniCPM-OCRHugging Face 模型与评测集:https://huggingface.co/collections/openbmb/minicpm-ocr
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。