DualExam:AI能规划、会生成,为何仍完不成任务?
原创 52CV 2026-10-29 23:58 江苏
论文题目: Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
智能体越来越擅长理解指令、规划步骤,世界模型也能根据行动生成新的画面。在这样的交互系统中,两个部分需要持续配合:智能体决定下一步做什么,世界模型展示行动之后发生了什么,新的观察再成为下一次决策的依据。
但这套交互能否把任务真正做完,仍需要逐步验证。一个动作执行了,目标未必达成;模型说“完成了”,环境中的结果也未必支持这个判断。即使当前画面响应了指令,先前放好的物品、已经设置的条件,还可能在后续步骤中发生变化。
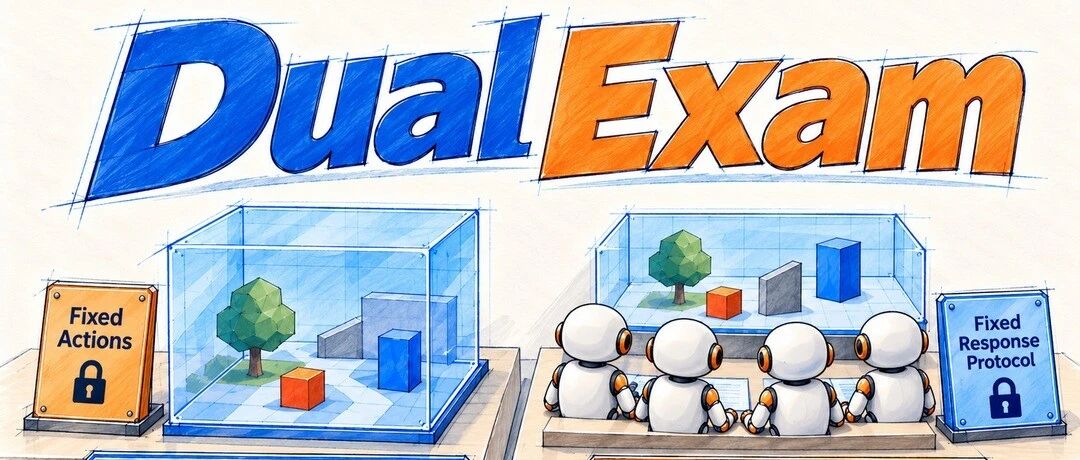
DualExam 将多模态智能体 (Multimodal Agent) 与世界模型 (World Model) 放进受控评测流程,分别检查行动选择与环境响应。研究覆盖物理、数字、社会和科学四个领域,既报告分项成绩,也回到执行记录,检查任务究竟在哪一步偏离要求。
一个装包任务可以说明其中的困难:护照、药品和充电器需要装进同一个蓝色背包,再带到门口检查。模型既要选对物品、执行操作,也要确认它们确实进入了原来的包。任务中的每一项条件,都要在后续交互中继续成立。
一个背包,暴露了哪些问题?
论文先开展了一组智能体与世界模型直接交互的试验。GPT-5.6 Sol 负责行动,Seedance 2.5 生成环境响应,共覆盖十种场景、150 个案例。每个案例只有一次尝试,最多执行二十步,没有整段任务重试;初始化和技术故障不计入该组评估。
在这组特定组合与协议下,严格任务成功率为 0%,世界状态一致性为 26.6%,智能体纠正响应为 9.2%。这些结果描述的是这次试验,不能推广为所有智能体和世界模型的共同水平。纠正响应也有特定含义:在可见异常出现后两个行动内采取针对性的动作,并不代表异常最终得到修复。
背包案例让这些指标有了具体含义。执行过程中,部分物品是否被成功拿起并未得到确认,智能体却继续推进装包计划;充电器后来变成了深色线缆,原来的背包也变成了较小的蓝色袋子。计划仍在继续,任务条件却已经不再成立。
执行记录还显示,四处涉及物品或背包身份的异常,都没有得到针对性响应。被计为纠正响应的两次行动,只是重新尝试导航到目标位置,并没有修复这些物体变化。发现异常、采取动作、成功修复和最终完成任务,需要分别记录,才能看清系统究竟做到了哪一步。
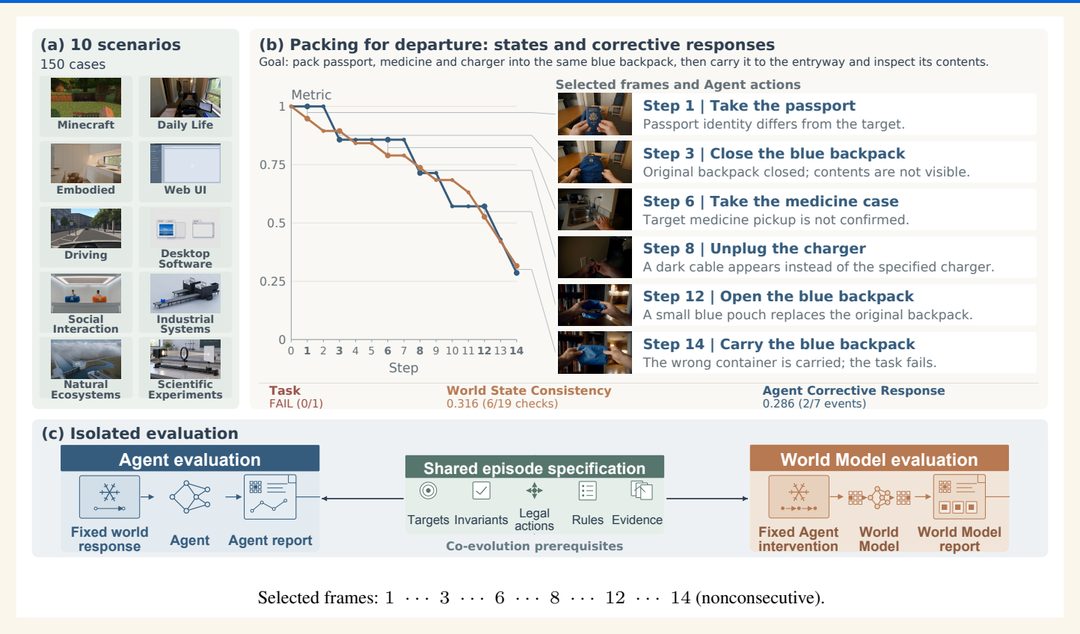
图中选取了第 1、3、6、8、12、14 步,并非连续视频帧。把这些观察与行动记录对照,就能发现一些单看某一帧不易察觉的问题:看似在正常推进的任务,可能早已失去最初的物品和状态。
把行动与环境响应分别检查
DualExam 的两条评测路径,各有一个明确的控制条件。
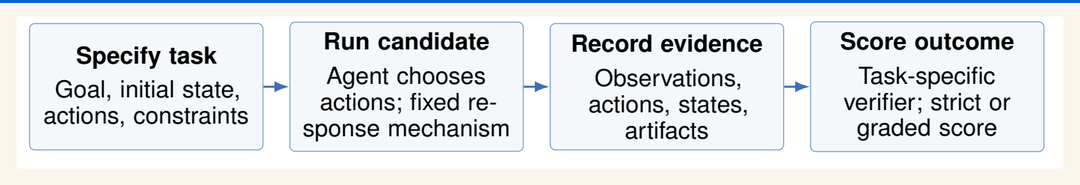
评估智能体时,环境响应机制保持固定,智能体根据任务和观察选择行动。这里固定的是机制,观察仍会随行动变化。评测据此检查目标是否完成、约束是否满足,以及执行记录是否支持最终结论。
评估世界模型时,行动干预序列保持固定。模型需要生成行动之后的场景,同时保留未被要求改变的物体、状态和规则。例如,移动一个杯子,应当改变杯子的位置,却不能顺带增加杯子数量或更换桌面。
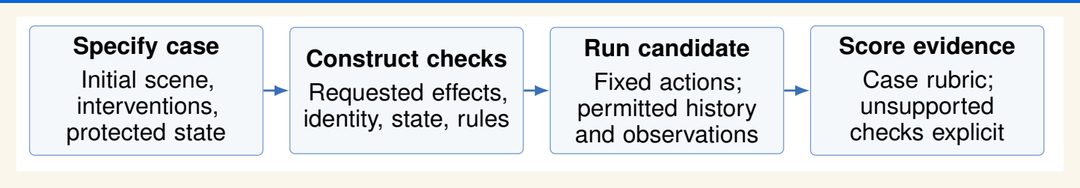
两条路径共享明确任务、约束与证据的设计原则,但使用各自的案例和评分流程,并非同一批任务的逐一配对。因此,两边的总分不能直接比较,也不能据此断定某次联合运行究竟由哪一个模型导致失败。
从网页操作到科学任务,考察实际执行
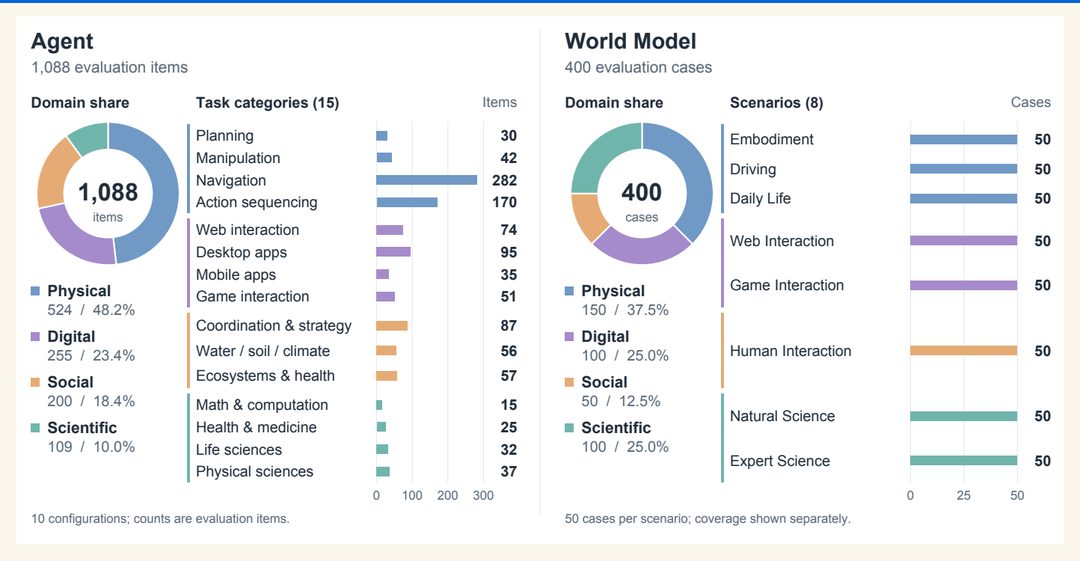
智能体部分包含 1,088 个评测条目,涉及物理、数字、社会和科学四个领域,按十五类报告结果。评测对象是十种模型与执行框架的配置,结果同时受到模型、接口和执行条件影响。
这些条目并不全是彼此独立的完整任务。科学领域的 109 个条目包含 99 个完整工作流和十个从相关流程中派生的工具选择检查点。十五类同样是结果的报告分组,不能直接等同于十五项独立的智能能力。
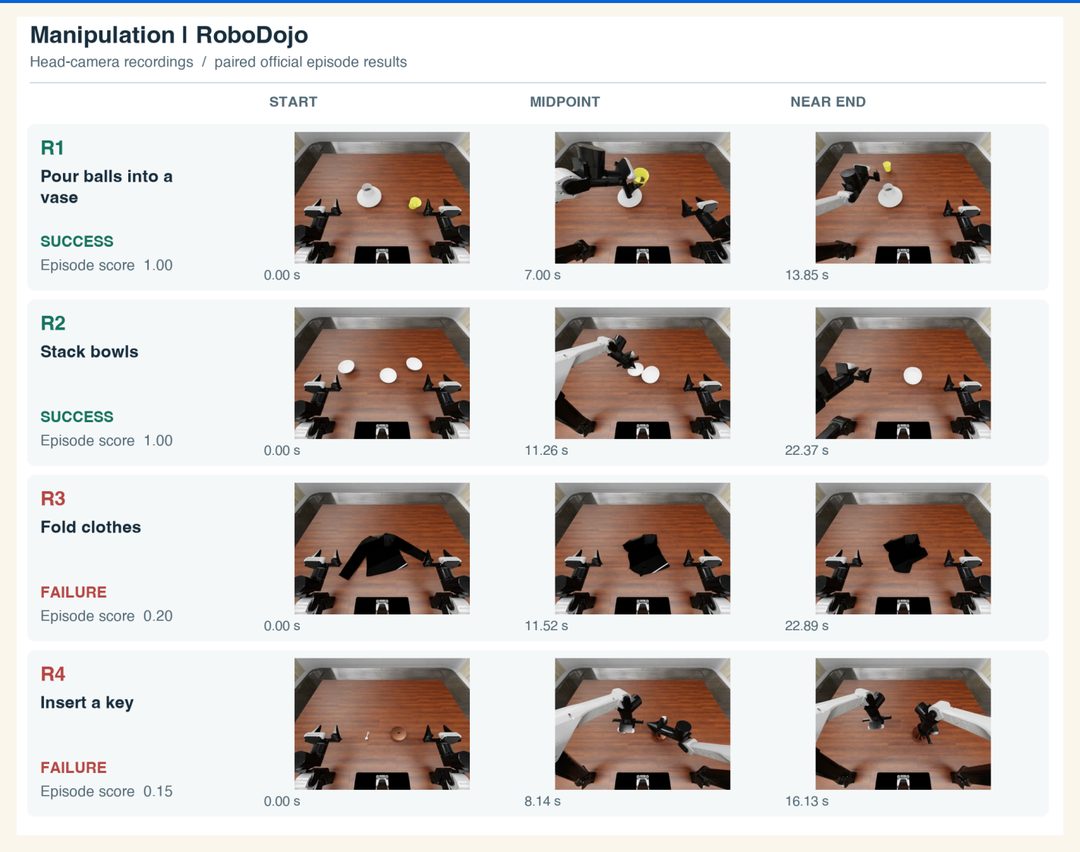
任务中的差异,在执行记录里尤其明显。机械臂能够把球倒进容器、叠放碗,并不意味着也能完成衣物折叠和钥匙插入。论文列出的操作案例中,后两项得到了部分分数,但官方任务结果仍为失败;衣物发生形变、夹爪接近目标,都不能自动视为目标已经达成。
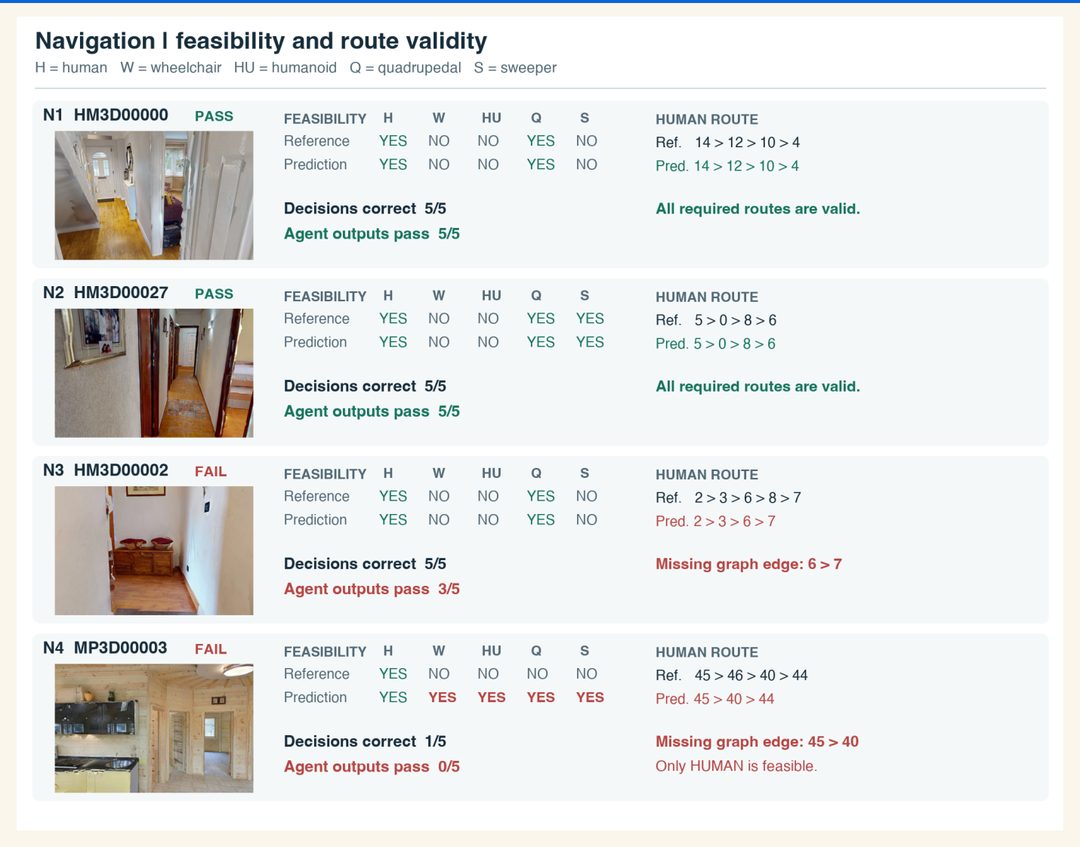
导航也有类似区别。一组案例中,模型对五种行动主体能否通行作出了正确判断,但输出的路线却包含地图上不存在的边。能够判断“可以到达”,与给出一条真正可执行的路线,是两个需要分别验证的要求。
综合领先,也需要看具体任务
在论文报告的智能体综合指标 Agent Index 中,GPT 6 Astra 得分 31.3,GPT 5.6 Sol 为 20.7,Gemini 3.6 Flash 为 20.1。该指标按条目数量加权,综合了严格成败与分级得分,不能读成统一的“任务成功率”。
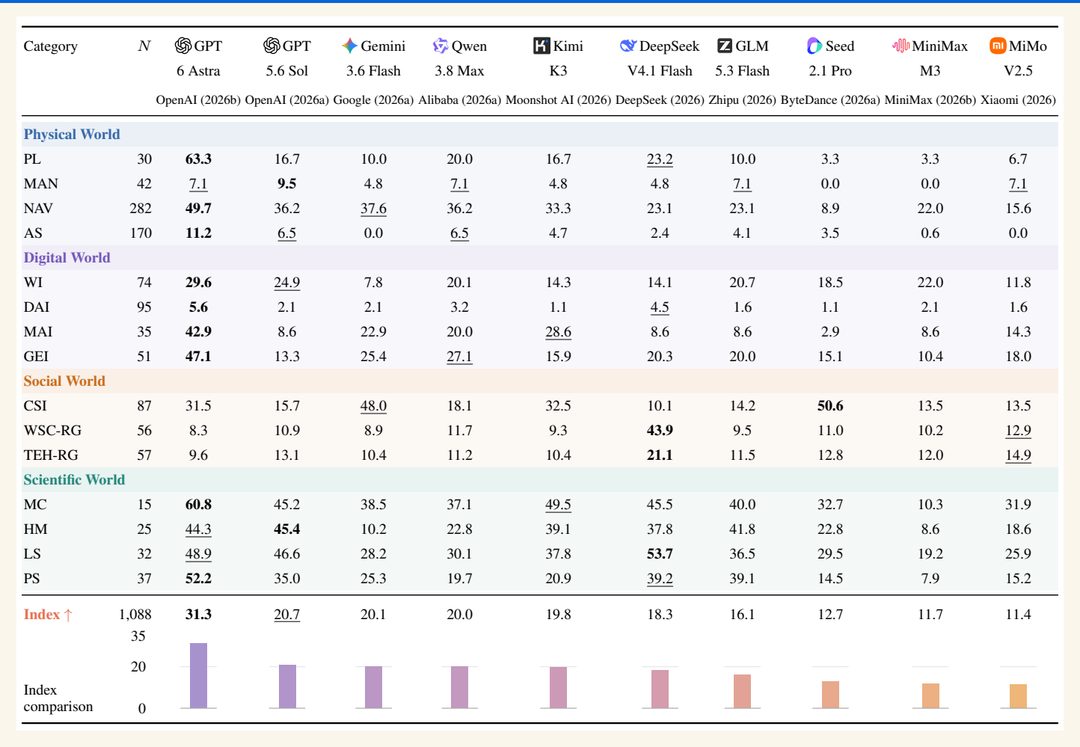
排名也不是每个任务上的同一个顺序。十种配置中,有四种至少在一个报告类别中取得最高展示分数,没有一种领先全部类别。更换应用场景时,需要查看对应任务、约束和执行证据,总榜只能提供其中一部分信息。
世界模型需要保留行动之外的内容
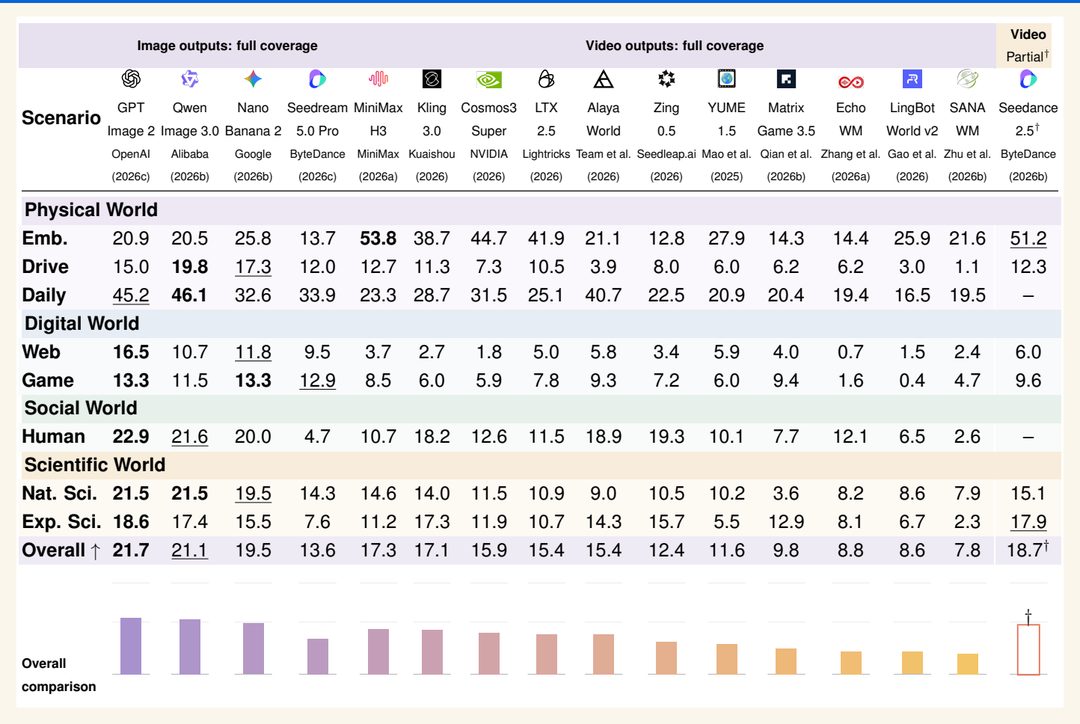
世界模型部分包含八类场景、400 个案例,每类五十个,涉及十六种配置。其中十五种覆盖全部案例;Seedance 2.5 因人脸生成限制,仅覆盖六类、300 个案例,其部分覆盖均分不能直接加入完整覆盖排名,缺失项也不能记作零分。
这条路径要求模型同时做到两件事:落实当前行动,保留累积状态。论文的双托盘案例中,一些输出增加了未被要求出现的托盘;在双臂杯子操作中,也出现了杯子数量变化。单张画面可以看起来合理,但原有任务条件已经被改变。
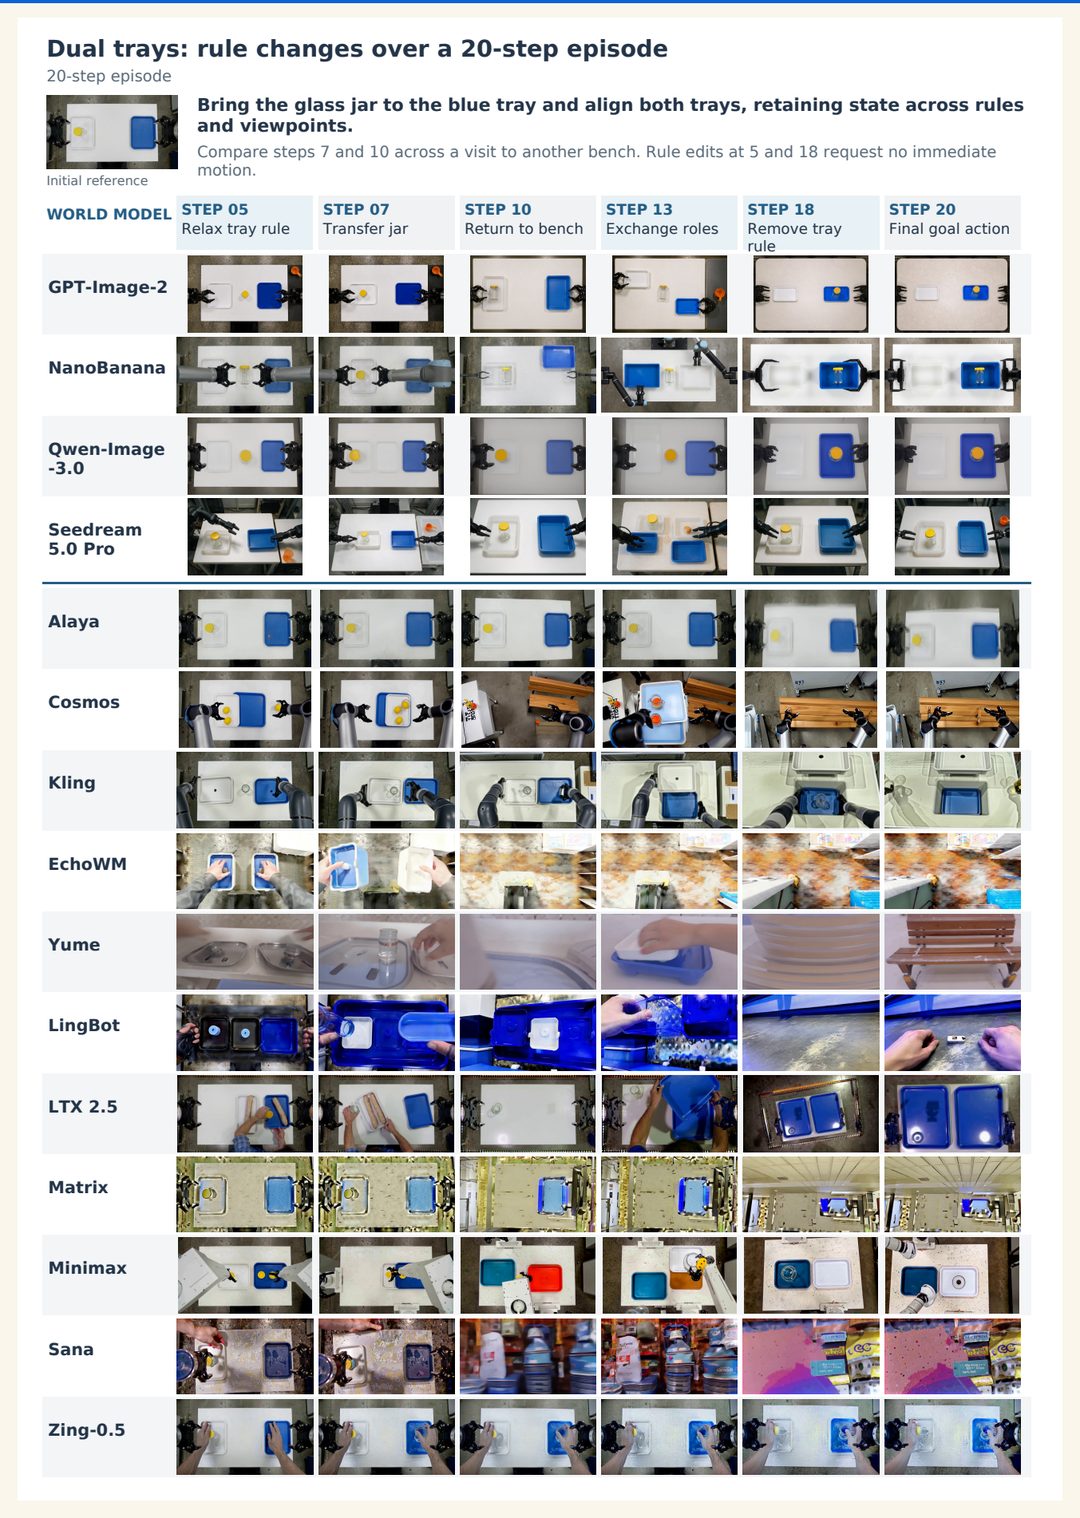
这些可视化来自论文中的具体运行记录,用于说明错误形态。它们的历史输入和展示条件存在差异,不能仅凭几行图片推断不同模型的总体错误率或排名。
两个榜单第一,能否组成最好的搭档?
从单项成绩出发挑选组件,是一个起点,却还不能回答它们是否适合一起工作。世界模型有没有生成智能体能够理解的反馈?场景出现异常时,智能体能否识别,并采取有效纠正?这些问题需要在同一任务条件和交互预算下,对不同组合进行实际测试。
论文中的一个对比说明了为什么应用场景不能省略:GPT-Image-2 的世界模型整体分数为 21.7,高于 MiniMax H3 的 17.3;换到具身场景,两者分别为 20.9 和 53.8,顺序发生了变化。平均成绩会掩盖场景差异,而分项领先也仍不能直接证明某个组合协作最好。
从发现问题,到验证怎样改进
DualExam 将一次笼统的“任务失败”,拆成了行动、状态和结果等可以核查的环节。这使改进方案有了更明确的实验对象:检查应该放在何时,检查什么,发现问题后是否采取了纠正,纠正是否奏效,以及最终目标是否达成。
项目文章进一步提出了几类待验证的方向。例如,在执行中检查物品身份和数量,是否有助于完成多步任务;在相同预算下改变核查时机,能否提高完成率;在社会交互任务中,调整推理预算会怎样影响决策。它们是下一步可开展的实验,效果仍需要验证。
当前评测也仍有需要补充的证据,包括世界模型输出评分的独立一致性复核,以及不同模型组合的重复运行。研究提供的是可继续检验的任务、指标和案例,还没有证明最佳搭配或共同提升已经实现。
回到最初的装包任务,检查的对象可以十分具体:物品是否进入原来的背包,背包是否带到门口,包内东西是否符合要求。能够把这些问题逐项回答清楚,才有依据判断任务完成,也才能进一步定位该改进行动决策,还是环境响应。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。