EMNLP 2026 | 中科大提出AtomMem,用原子事实重建Agent长期记忆
让你更懂AI的 2026-10-29 15:02 北京
几周前说过的话,AI还记得吗?
几周前告诉 AI 助手的偏好,它今天还能准确记得吗?
当用户状态发生变化时,助手能否在准确更新记忆的同时,保持记忆库的稳定性?面对需要综合多次对话才能回答的问题,它又能否找到并整合所需的证据?
当大语言模型从单轮问答走向长期交互,记忆的准确保存、稳定更新与有效利用,直接关系到 Agent 能否持续提供可靠的个性化服务。
完整保存原始对话,容易使检索与回答过程受到冗余内容的干扰;将对话压缩为摘要或组织成三元组等结构化关系表示,则可能在提炼信息的过程中损失关键细节与上下文。
保存了对话,不等于建立了可靠的记忆。
在本文中,我们提出 AtomMem:先将对话转化为高价值、能够独立理解的原子事实(Atomic Facts),再用事件组织相关经历、用时序画像追踪用户状态的变化,并通过关联图召回分散的证据。
我们以高质量的记忆表示为基础,协同设计记忆的组织、更新与检索机制,支持长期交互中的信息积累、状态维护与证据整合。
其中,一个值得关注的发现是:即使不使用复杂的层次结构和图关联召回,仅基于向量相似度直接检索原子事实,也能带来明显提升。
这一结果凸显了记忆表示的基础作用,也促使我们进一步思考:系统究竟应该记住什么,又应以何种形式保存这些信息?
论文标题:
AtomMem: Building Simple and Effective Memory System for LLM Agents via Atomic Facts
论文作者:
Yanyu Yao、Shangze Li、Zhi Zheng*、Hui Zheng、Qi Liu、Tong Xu*、Enhong Chen
作者单位:
中国科学技术大学、安徽大学
录用会议:
EMNLP 2026
论文地址:
http://arxiv.org/abs/2606.19847
项目地址:
https://github.com/MINE-USTC/AtomMem
问题:长期记忆到底难在哪里?
大语言模型已经展现出较强的语言理解、推理与生成能力,但当它们被用于跨越数周甚至数月的长期交互时,有限的上下文窗口便成为历史信息积累与复用的重要限制。
为了持续提供可靠的个性化服务,智能体需要借助外部记忆,保存和管理交互中的有效信息,并在后续任务中按需调用。
随着交互持续,用户的经历不断积累,偏好与目标也可能随时间变化。回答当前问题所需的证据,往往分散在不同会话中,并与大量无关内容交织。
系统需要从中提取并保留关键事实,在新信息到来时准确、稳定地维护已有记忆,还需要在回答问题时找回相关证据,理解并整合它们之间的联系。
如何将持续积累的对话转化为可靠、可用的长期记忆,是这一过程中的核心问题。
围绕这一问题,我们从记忆表示、记忆更新与记忆检索三个方面梳理现有方法面临的挑战。
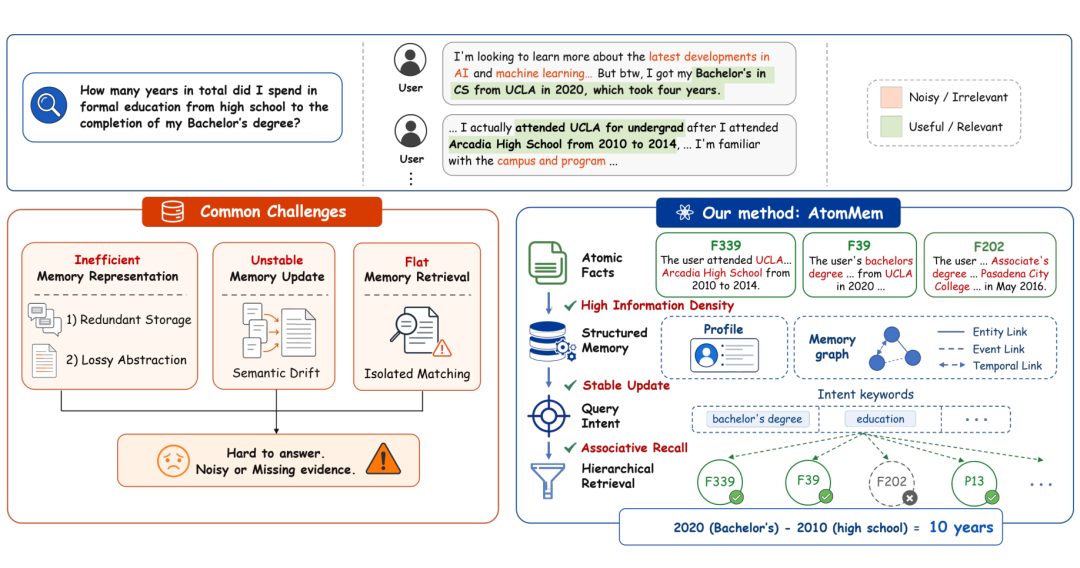
〓 AtomMem 的研究动机与方法概览
第一,记忆表示的两难。直接保存原始对话能够保留丰富的交互细节,却也保留了寒暄、重复等冗余内容,以及依赖上下文的表达。
当多个主题混合在同一记忆单元中时,关键信息的语义特征可能被弱化,影响检索的准确性;无关内容被召回后,还会占用有限的上下文空间,增加模型的处理负担。
另一方面,若将对话提炼为紧凑的记忆表示,却也可能在信息取舍中丢失细粒度信息。
因此,真正需要优化的,是有效信息的密度与保真度。
第二,记忆更新的稳定性挑战。用户状态随时间变化,记忆需要相应更新。现有方法通常依赖 LLM 改写已有条目以适应新信息,但缺乏约束的频繁重写可能在反复迭代中引发语义漂移,破坏原有记忆。
第三,记忆检索的关联性局限。有用的证据往往分散在不同会话中,回答一个问题可能需要依赖跨会话的多条信息。
只对孤立条目进行相似度排序,容易遗漏那些表面措辞不同,却属于同一经历或上下文的事实。
一个关键发现:高质量的记忆表示是系统能力的基础
为了检验记忆表示对长期记忆能力的贡献,我们构建了 AtomMem-Flat。
它不使用完整系统中的分层记忆结构与图关联检索,而是将原始对话转化为我们提出的原子事实(Atomic Facts),再通过向量相似度直接进行检索。
在统一的实验设置下,AtomMem-Flat 在 LoCoMo 的单跳、多跳、时间推理和开放域四类任务上,均显著优于直接使用原始对话的基线。
以多跳推理为例,其 F1 从 20.97 提升至 37.03,相对提升约 76.6%。
同时,AtomMem-Flat 仅使用约 72.3 万 Token(722.75K),在多项指标上取得了可与现有强记忆系统竞争的表现,展现了原子事实表示在长期记忆任务中的应用价值。
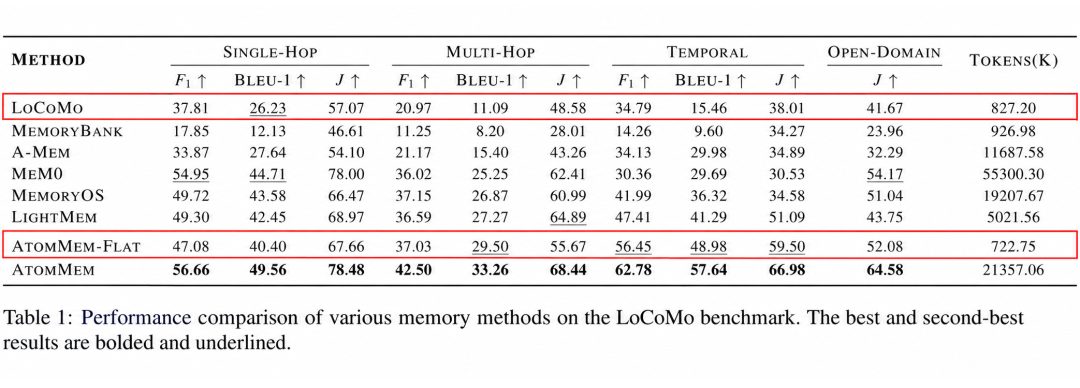
〓AtomMem-Flat 的对比实验
这些结果表明,仅依赖复杂的系统编排难以弥补底层记忆表示的缺陷。
相比包含冗余内容、主题混杂和上下文依赖表达的原始对话,Atomic Facts 为记忆的检索与使用提供了更可靠的基础。
核心表示:从原始对话到结构化原子事实
什么是“原子事实”?
我们将其定义为:表达单个语义完整命题的最小高价值信息单元,忠实于原始对话,并能脱离原始会话上下文独立理解和使用。
“原子化”并不意味着句子越短越好,它强调语义单一与信息完整:每条记忆聚焦一个明确的命题,同时保留理解该命题所需的必要信息,不再依赖缺失的上下文。
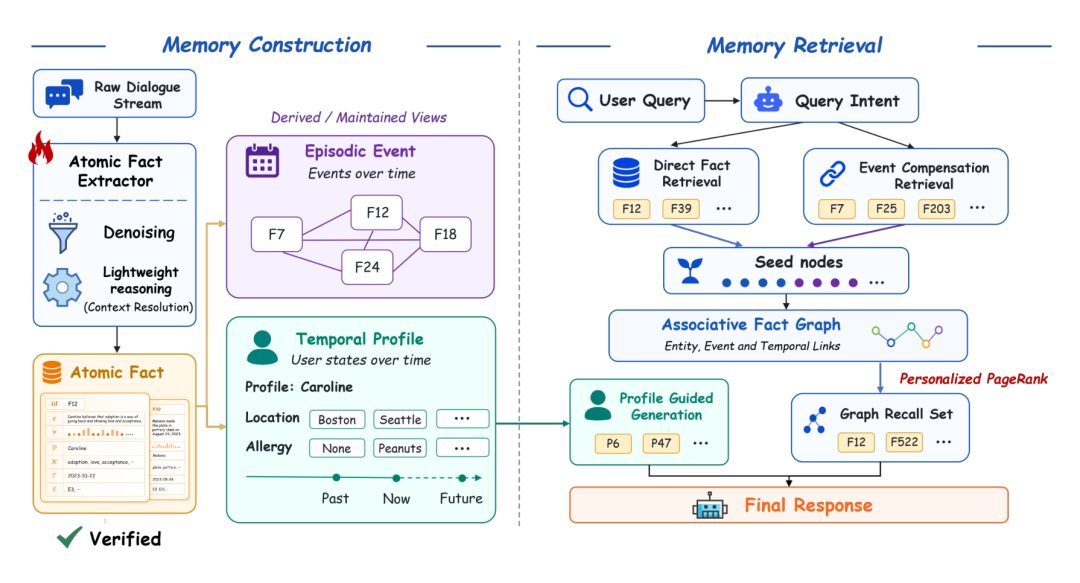
〓 AtomMem 总体框架
原始对话中经常出现“我”、“他”、“上周五”、“那件事”等依赖上下文的表达,一旦脱离原会话,其指代对象或具体含义就可能变得模糊。
为此,我们设计了基于监督微调(SFT)的原子事实提取器(Atomic Fact Extractor),在记忆构建阶段完成以下处理:
去噪:过滤问候、附和、重复和其他低价值内容;
上下文解析:解析代词、相对时间和隐含实体等上下文依赖,确保每一条事实都可以脱离上下文独立存在、被检索并被理解;
语义拆分:将包含多个主题的长对话片段拆成若干单一、语义完整的事实,同时避免过度推断。
在训练数据构建上,我们采用“教师模型初步提取—人工复核”的两阶段流程,共获得 4,352 条训练样本。
随后,我们基于这些样本,采用 LoRA 对 Qwen3-14B 进行监督微调,得到面向原子事实提取任务的专用模型。
在此基础上,我们进一步补充语义向量与结构化元数据,构建结构化原子事实:
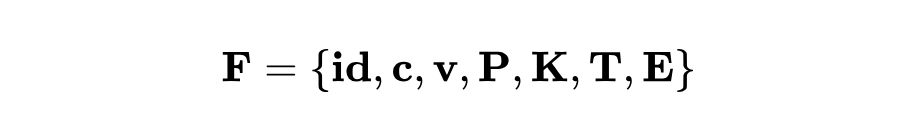
每条记录包含事实文本、向量表示、参与者、关键词、时间信息和所属事件等元数据。其中,关联事件列表初始为空,随后在事件组织过程中建立相应关联。
这种表示既支持语义检索,也支持基于元数据的符号过滤、时间约束,并为后续的事件组织与图关联召回提供基础。
记忆演化:在稳定更新中建模用户经历与状态
结构化原子事实为长期记忆提供了清晰的基本单元,但长期交互还需要回答两个问题:新信息如何进入记忆?分散的事实如何形成对用户的持续理解?
事实验证:保留新增信息,约束旧事实更新
在新事实存储前,我们先依据参与者、时间等元数据筛选候选记忆,再结合语义相似度与关键词重合度,检索相关旧事实,作为验证所需的上下文。
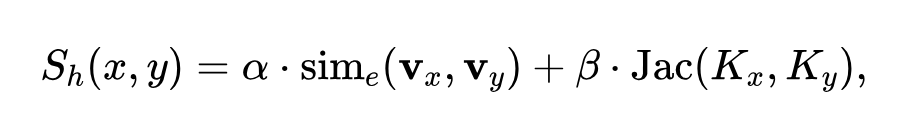
随后,由 LLM 比较新事实内容与已有记录,判断哪些信息已被覆盖、哪些属于新增内容,以及是否存在逻辑冲突。
对新事实的处理原则为:重复内容不再重复存储,尚未覆盖的信息作为新事实保存,只有检测到逻辑冲突时,才生成对旧事实的更新。
我们通过对比实验进一步考察这一设计。
实验以 AtomMem-Flat 为基础,使用相同的预抽取 LoCoMo 事实与仅基于向量相似度的检索流程。
其中,Same-Item Update 策略会在新信息涉及同一对象或事件,且改变或扩展已有内容时改写旧事实,而我们的 Fact Verification 则将旧事实的改写限制在检测到逻辑冲突的情况。
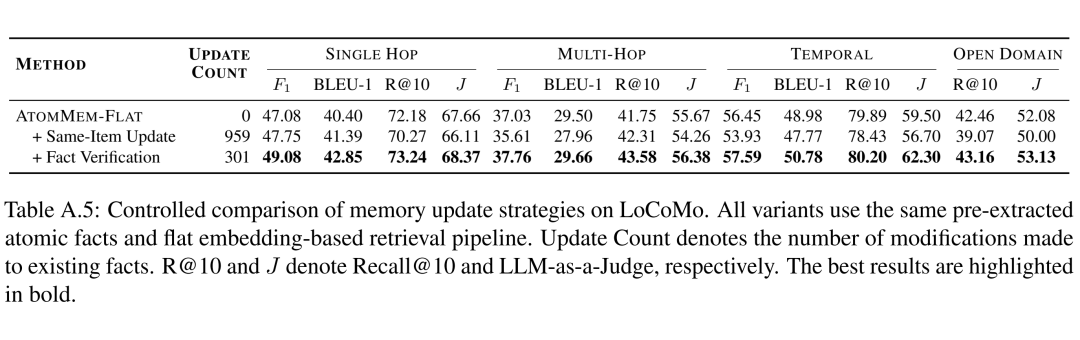
〓 记忆更新策略的对比实验
这一结果表明,扩大改写范围、增加改写次数,并不必然改善记忆质量。有针对性地减少不必要的修改,有助于保留有效信息,降低更新引发语义漂移的风险。
事件记忆:组织关联事实
单条事实能够记录具体细节,却未必能够呈现一段经历的连续性。因此,我们构建事件记忆(Event Memory),将逻辑相关的事实组织为连贯的情境单元,并保留与底层事实记忆的关联。
每个事件的结构定义为:
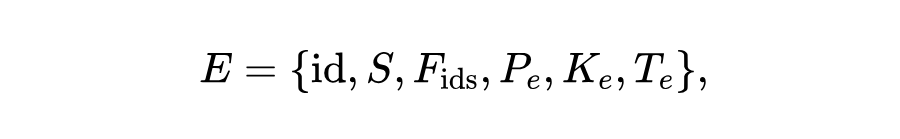
其中, 为事件编号, 为事件摘要, 为成员事实编号集合;、 和 分别记录事件的参与者、关键词和时间跨度。事件摘要用于概括经历,关联的原子事实则保留具体细节与证据。
事件随着事实的积累动态构建与更新。对于经过验证的新事实 ,这一过程包括以下三个步骤:
1. 候选生成:系统复用事实验证阶段检索得到的相关事实集合,将这些事实关联的已有事件汇集为候选事件,将尚未关联任何事件的事实保留为独立候选。
2. 语义路由:由 LLM 判断新事实与候选内容是否具有逻辑上的关联,据此确定它可以并入哪些已有事件,以及可以与哪些独立事实共同构成新事件。
模型可以选中多个候选,也可以不建立事件关联,继续作为独立事实保存。
3. 状态执行:对于匹配的已有事件,系统更新事件的成员事实、参与者和时间范围,并根据更新后的成员事实重新生成事件摘要与关键词;对于匹配的独立事实,则分别将每条事实与新事实组合,创建对应的新事件。
没有匹配时,新事实独立保存,不建立事件关联。
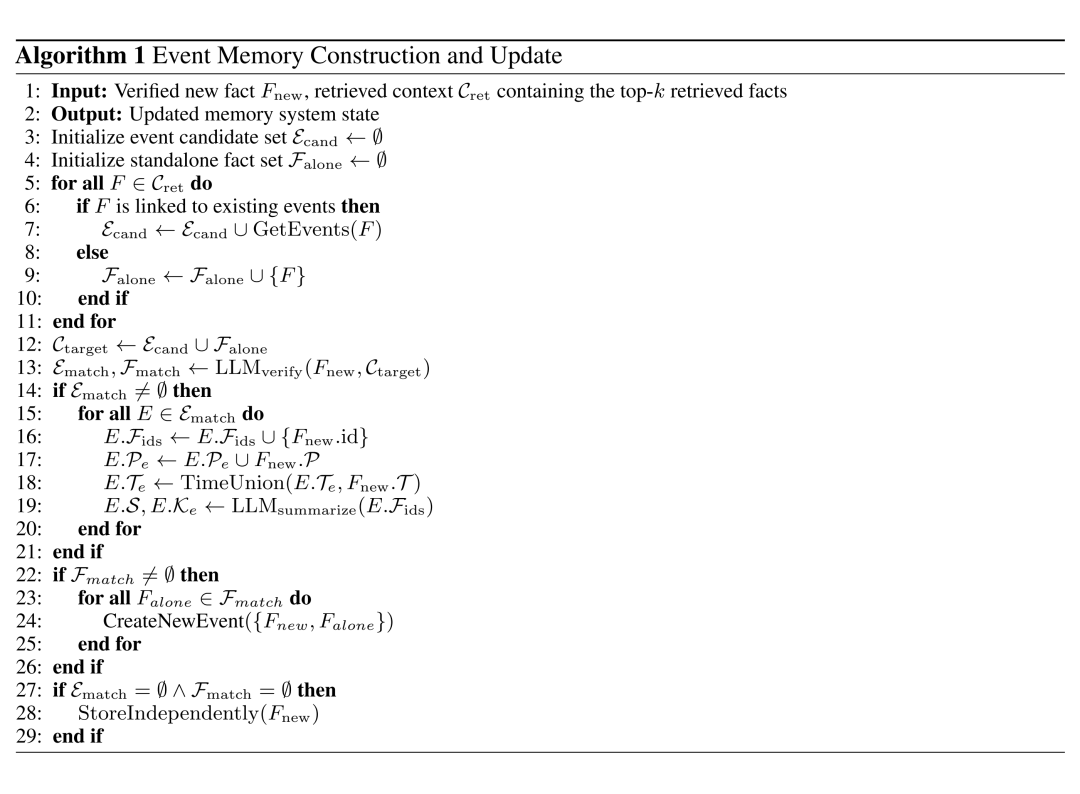
〓 事件记忆构建与更新算法
通过这一过程,事件层在保留底层事实的基础上,将分散的信息组织为连贯的经历脉络,为后续检索提供事件级上下文与关联线索。
新事实既可以并入已有事件,也可以与其他独立事实组合成新事件;暂时没有合适关联的事实,则可以独立保存。
事件层的作用是组织事实之间的联系,而不是用一段摘要替代所有底层细节。
时序画像:追踪用户状态
事件记忆关注具体经历,时序画像(Temporal Profile)则用于描述偏好、习惯和背景等相对持久、但可能随时间变化的用户属性。我们将一条画像记忆定义为:
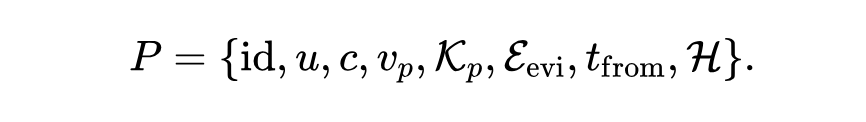
其中, 为画像编号, 表示所属用户, 描述用户属性, 和 分别表示画像内容的语义向量和关键词集合; 记录支持该画像的事实编号, 记录当前版本的生效时间, 保存历史版本。
通过这些字段,用户属性能够与相应的事实依据和时间信息保持关联。
用户画像采用会话级批量处理机制。系统先将可能反映长期特征的候选事实加入等待队列,在会话结束后统一处理。
当画像的当前状态发生变化时,系统将旧状态保存至历史记录 ,并记录其有效时间区间。
后续查询由此支持依据时间约束选择相应版本,从而追踪用户在不同阶段的状态。用户画像既保留当前属性,也保留支持这些属性的证据和历史变化。
由此,我们在高质量记忆表示的基础上,进一步支持信息的持续积累、关联组织与稳定更新:原子事实保留可追溯的具体证据,事件记忆组织情境经历,用户画像追踪用户状态。
记忆检索:查询感知的关联召回
高质量的记忆表示为检索提供了基础,而回答跨会话问题,还需要整合分散的事实与上下文。为此,我们设计了如下的分层检索流程。
查询解析
我们首先利用 LLM 解析查询中的参与者、关键词与时间范围(如有),并判断是否需要用户画像,形成结构化查询 ,用于后续检索。
分层混合检索
1. 直接召回:系统根据参与者和时间范围对全局事实进行元数据过滤,再结合向量语义相似度与关键词 Jaccard 相似度进行排序,召回与查询直接相关的原子事实。
2. 事件补偿:经元数据筛选后检索相关事件,再综合事件整体相关性与事实自身相关性进行排序,选出补充事实。两路结果共同构成种子集合。
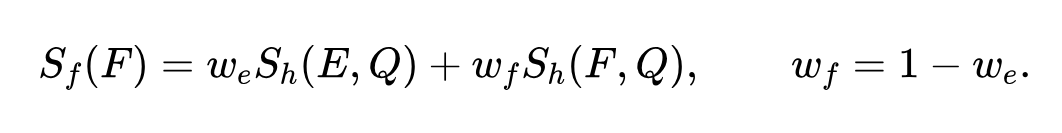
3. 关联召回:以种子事实为起点,在局部关联图上运行个性化 PageRank 发现隐含的跨会话证据,实现查询感知关联召回。
关联记忆图
关联图以原子事实为节点,构建三类关系边:
实体边:连接共享关键实体或主题的事实,并用查询感知的 IDF 权重压低高频噪声词;
事件边:连接属于同一事件的事实,同时对过大的事件进行惩罚;
时序边:连接同一会话中相邻的事实,并让边权随对话轮次距离衰减。
三类关系分别提供主题、事件与局部语境上的关联信号,使分散在不同会话中的事实能够通过多种线索相互连接。
图检索完成后,系统按需补充用户画像,并将最终召回的事实证据与画像共同用于回答生成。
实验
实验统一采用 GPT-4o-mini 作为骨干模型。我们根据任务类型报告 F1、BLEU-1 和 LLM-as-a-Judge(J),其中 J 由大模型评估答案的语义正确性。
LoCoMo 实验。在 LoCoMo 的四类任务上,AtomMem 在全部报告指标中均取得最佳结果,全流程 Token 消耗相比 Mem0 降低了 61.4%,在提高回答质量的同时保持了较低的计算成本。
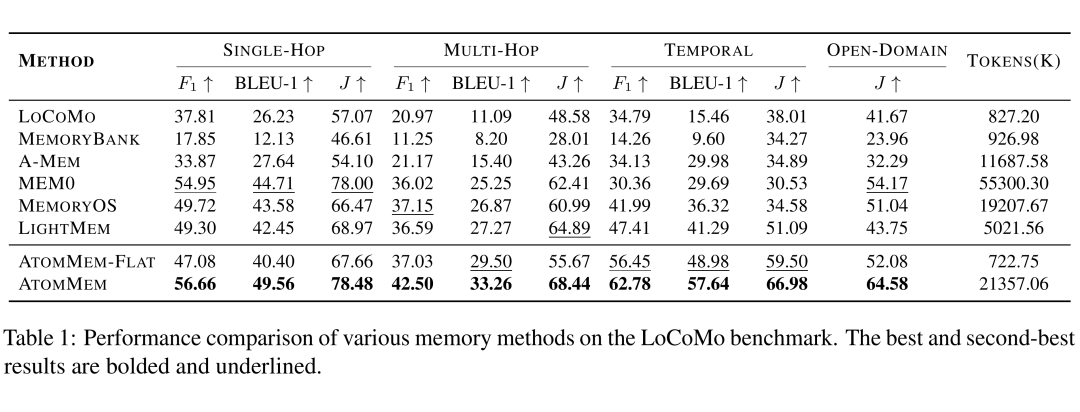
〓 LoCoMo 实验结果
模块消融实验。AtomMem-Flat 的实验结果表明,仅将原始对话转化为原子事实,就能显著改善后续检索与回答效果。
在此基础上,模块消融实验进一步显示:移除事件记忆、时序画像或关联图后,相关指标均出现不同程度的下降。
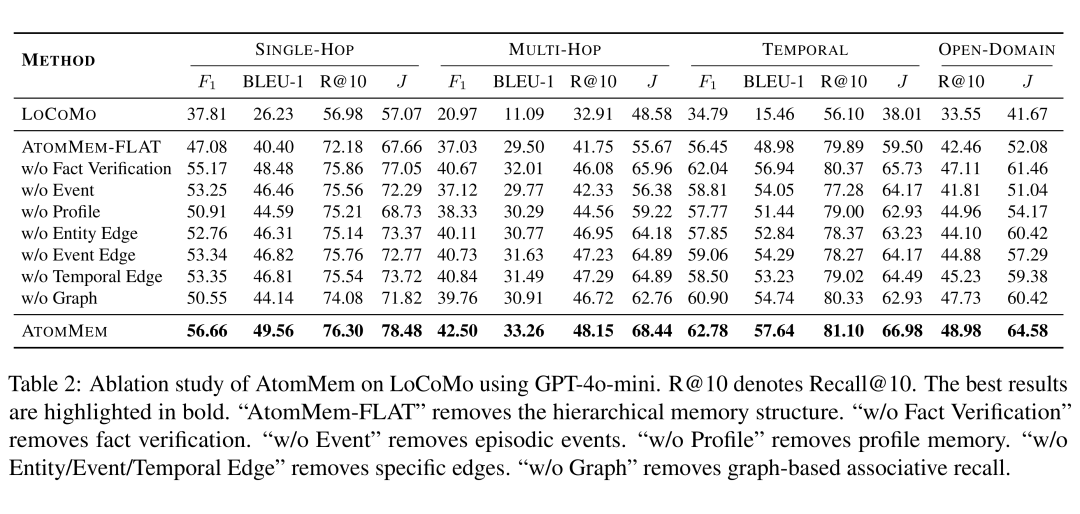
〓 AtomMem 模块消融实验
这些结果说明,不同模块承担着互补作用:原子事实改善基础表示,事件与画像补足不同层次的上下文,关联图进一步帮助找回间接证据。
跨模型评估。当骨干模型替换为 Qwen3.5-Flash 时,AtomMem 在 LoCoMo 四类任务的全部报告指标上仍取得最佳结果。
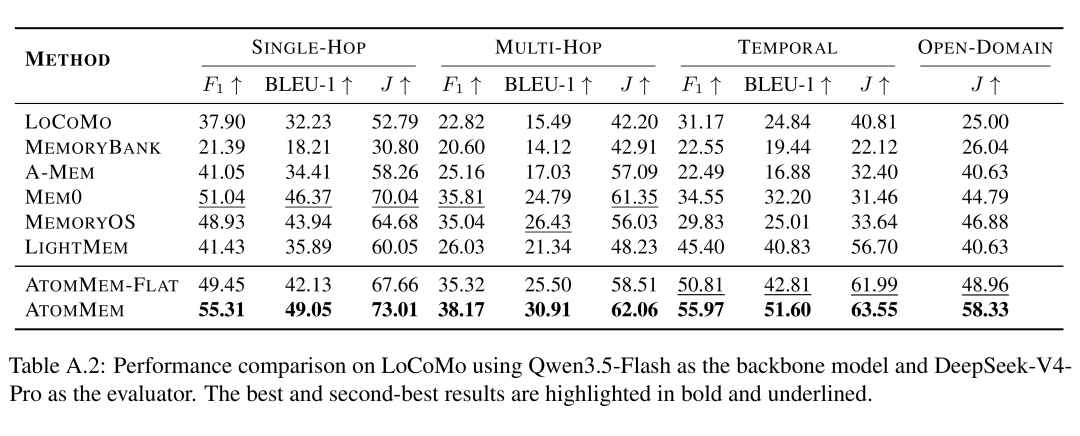
〓 LoCoMo 跨模型实验结果
跨基准评估。我们还在独立的 LongMemEval 基准上进行了补充实验。
与 LightMem 和 Mem0 相比,AtomMem 在该基准的六类长期记忆任务上均表现出更强的整体性能,进一步支持了方法在不同长期记忆任务中的有效性。
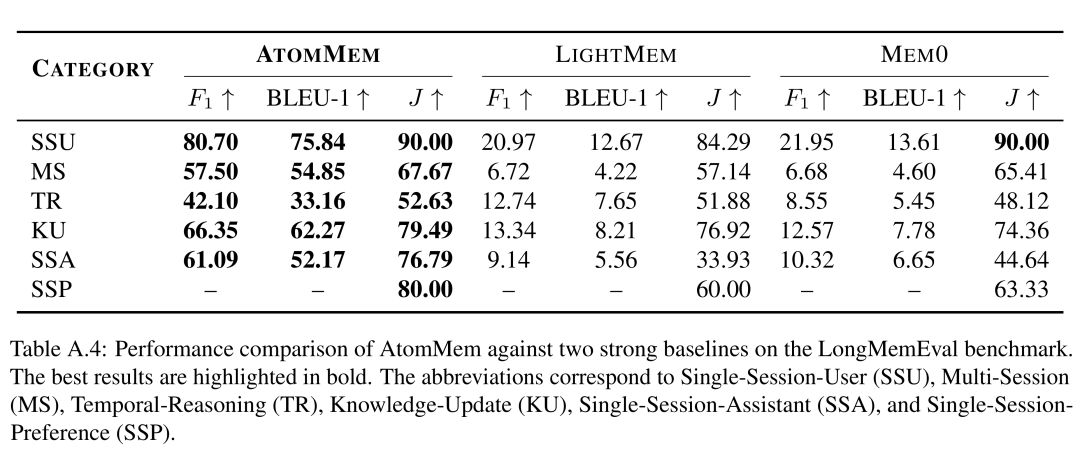
〓 LongMemEval 跨基准实验结果
检索容量分析。检索容量增大时,召回率与回答质量并不总是同步提升。召回事实过少可能遗漏必要证据,过多则可能引入无关上下文。
因此,检索过程需要在证据覆盖率与上下文噪声之间取得平衡。
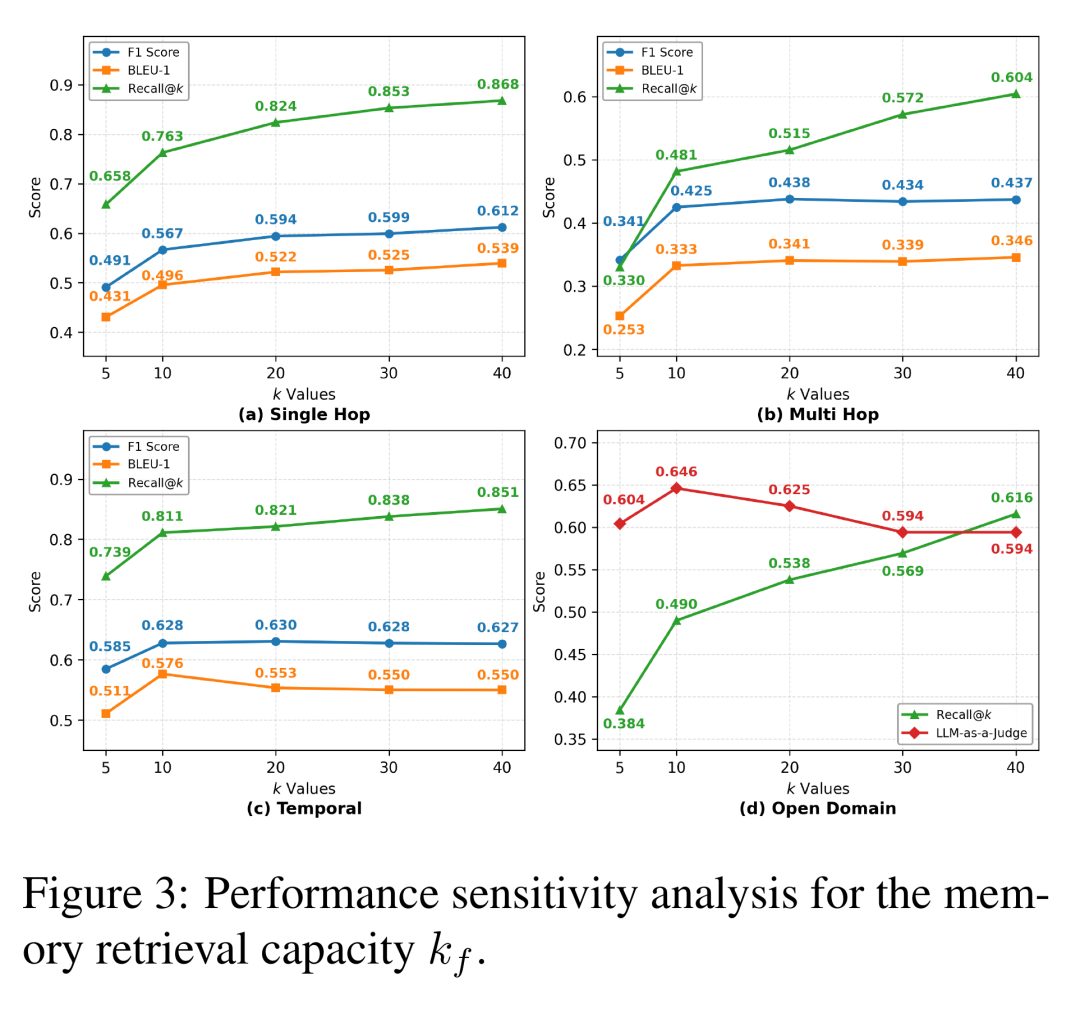
〓 检索容量k_f分析结果
在线延迟分析。我们在本地计算环境下,基于 1,540 个 LoCoMo 问题测试在线响应延迟。
完整在线响应平均耗时约 3.6 秒,主要来自依赖 LLM 调用的查询意图分析与答案生成,而记忆检索流程平均仅需 145.80 毫秒。
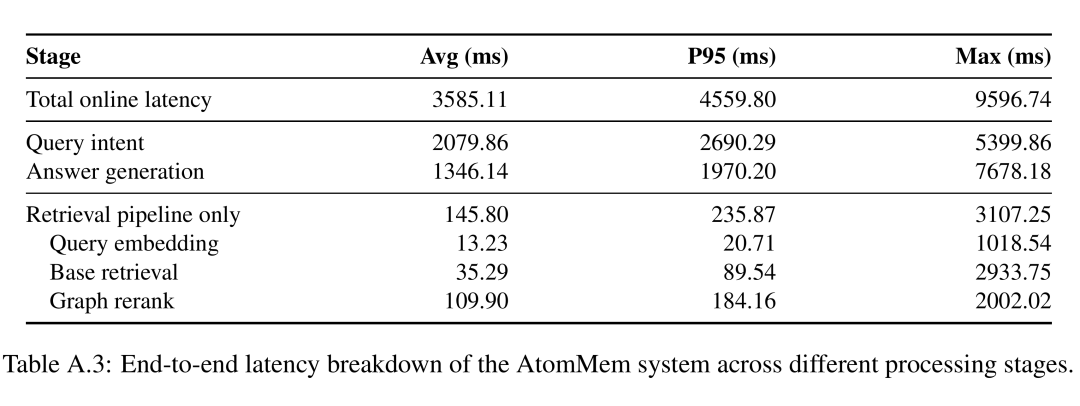
〓 AtomMem 在线响应延迟分解
小结
我们提出以结构化原子事实为核心的长期记忆框架 AtomMem,协同设计记忆表示、更新与检索机制。
通过事实验证维护记忆质量,以事件记忆组织经历脉络,以时序画像追踪用户状态,并利用关联图整合跨会话隐含证据,支持长期个性化交互中的信息积累与有效利用。
AtomMem 所展现的不止于提出一种新的记忆架构,更在于记忆表示的基础作用:当底层信息足够准确、清晰,简单检索也能有效。在此基础上引入结构化组织,才更容易转化为复杂任务中的收益。
当然,当前系统仍存在一定局限:系统主要处理文本交互,多个环节仍依赖基础模型的生成质量与输出一致性,整体 Token 效率也有进一步优化空间。
多模态扩展与更经济的记忆管理,是后续值得继续探索的方向。
Highlights
1. 好的记忆,始于好的表示。原子事实是表达单一、语义完整命题的最小高价值信息单元,忠实于原始对话,并能脱离原始上下文独立理解和使用。
2. 稳定演化,不在于频繁改写。事实验证保留新增信息,仅在检测到逻辑冲突时更新已有事实。时序画像依据事实证据追踪用户属性变化,兼顾当前状态维护与历史信息留存。
3. 有效召回,需要组织证据。事件补偿与图关联召回利用事实之间的联系,补充直接检索可能遗漏的证据;用户画像按需提供个性化依据,共同支持跨会话的信息整合与回答生成。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。