当paper通胀后,我们该怎么benchmark一个researcher?
原创 Jiacheng Dong 2026-10-29 15:02 北京
AI加速科研之后
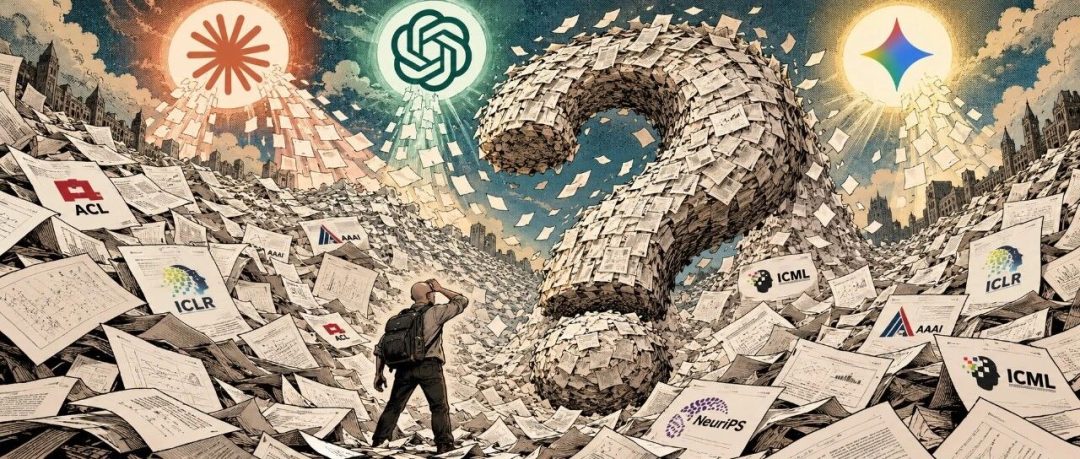
如果做出一篇论文比过去容易了,论文数量、顶会录用和引用次数,还能在多大程度上反映一个研究者的贡献?
©作者 |Jiacheng Dong
定义和共识
在讨论这个现象和它的影响之前,先约定几个定义和共识。
首先,哪些资源在这篇文章里被看作增长缓慢、相对有限的:
1. 计算资源
2. 人的注意力和精力:包括 researcher 推进工作的精力,也包括审稿人和读者理解、判断一项工作所需的注意力
3. 时间:实验迭代的时间,人理解问题、积累经验的时间
这些资源的增长速度,短期内远远赶不上 paper 的膨胀速度。
其次,评价一个 researcher 的核心 metric 是什么:他对整个领域的总 contribution。
也就是说,我们真正关心的是一个 researcher 推进了多少领域认识,而不是他一共发了多少篇 paper。
只是前者很难直接衡量,所以大家普遍拿后者当 proxy metric。
在此基础上,再定义什么是一篇好 paper:
1. 能带来结论。这里的结论指:可复现、能被实验证明、并且对领域有推进作用的观点。它是一篇文章的核心价值,也就是文章的 story 本身。
2. 需要消耗一定的计算资源做验证和消融。这件事有边际效益:有效实验越多,结论越 solid,但收益会逐渐递减。
3. 易于阅读。读者能在尽量短的时间内 get 到核心结论;精读之后,还能获得更深的 insight,比如实验设计或算法上的巧思。
接下来,我把对领域有正面影响的 paper 称为“好 paper”,把负面影响大于正面影响的称为“差 paper”。
这里的“差”,是说它带来的认识增量抵不过它消耗的阅读、评审和复现成本,也就是消耗的有限资源比它的贡献还多。
说白了,它会加大屎里淘金的难度,还会成为会议投稿的分母。后一点后面细说。
模型能带来什么?
然后看看现在的模型能给 research 带来什么:
Astra、Fable 这类模型的独立 research 能力,已经高于产出一篇 paper 的最低门槛。
理想情况下(researcher 能正确判断和使用模型的输出),一篇 paper 每个阶段的有效能力可以粗略理解为 max(researcher,模型)。
而模型在各阶段的能力加起来,已经满足: 模型 一坨东西被称为 paper 的最低 bar。
模型作为工具,能极大地加速 research,包括想 idea、写 code、写文章。
那么,这样产出的 paper 能达到上面定义的好 paper 吗?
1. 模型能加快得出结论的速度,但在 autoresearch 里,单靠模型暂时还做不出能推进整个领域的结论。
2. 无论是加速还是 autoresearch,都不能增加计算资源的总量。
3. 模型写文章和作图的能力目前还比较一般,只能起加速作用。一篇文章的写作上限,很大程度上仍然取决于 human in the loop 里那个 human 的上限。
4. 而人的能力上限,大部分要靠时间沉淀和打磨。
结论是:单靠模型做 autoresearch,下限还够不到好 paper 的 bar;想越过这条 bar,仍然要靠人的上限。
要产出好 paper,仍然需要 人 ,模型 好 paper 的 bar,而人的能力可以粗略写成人 :一条随投入时间慢慢上升的曲线。
由此可以推测:计算资源、人的精力和时间都有限,paper 数量却在暴涨,研究效率和人的能力又没有同比提升,那么必然会有大量 paper 达不到好 paper 的 bar。
paper 变多本身无所谓好坏。但如果 paper 变多只是因为“把一份工作做成 paper”变容易了,那就是一件坏事。
会议制度
再来看会议制度。
如果会议的接受率几乎不变,而差 paper 在投稿中的比例不断上升,那么会议实际的录用 bar 会逐渐掉到好 paper 的 bar 以下(可能现在已经掉下去了)。
假设一个会议有 N 篇投稿,接受率为 α,那么它要录用 αN 篇。
如果投稿里只有 G 篇好 paper,并且 G < αN,那么即使审稿人能完美识别每篇文章的质量,也不可能在维持接受率的同时只录用好 paper。
而现实中的评审不可能完美。投稿量一直在涨,审稿人的注意力和精力却有限,判断哪些文章真正有价值只会越来越难。
所以会议只有两条路:要么降低接受率,要么录用一部分低于好 paper bar 的文章。这就是前面说的,差 paper 成为投稿分母之后带来的后果。
那么,既然会议开始录用差 paper,它还能被当作一个合格的学术 metric 吗?
用会议 pub 衡量 researcher,本质上是在借助会议的筛选:我们并没有逐篇精读这个人的工作,而是相信会议已经替我们做了一定程度的质量判断。
那么这个信号会不会失效,取决于会议能不能把差 paper 挡在录用之外。
如果能,即使投稿数量暴涨,这个信号也未必会失效;但如果越来越多差 paper 进入最终录用结果,那么“这个人有一篇某某会议的 paper”所能说明的东西就会越来越少。
也就是说,当一个会议的录用下限低于好 paper 的 bar,且低于这个 bar 的录用文章越来越多时,这个会议的 pub 就越来越难直接作为衡量 researcher 的 metric。
这也能解释一种体感:几年前,学术会议的 pub 普遍还能作为衡量 researcher 的 metric;两年前,似乎只有所谓“三大会”(相对顶尖的那几个会)还能承担这个作用。
由此可以推测,在不久的将来,“三大会”的 pub 也将无法承担这个作用。
核心原因就是差 paper 太多了:当差 paper 越来越多地进入录用结果,顶会 pub 的评价体系就会崩溃。
关于 metric
那么,在这种情况下,我们到底需要一个什么样的 proxy metric 来衡量一个 researcher?
前段时间我和很多朋友聊过这个问题,大家的观点大致有三种:
1. 一作 paper 的总 citation
2. 代表作
3. reputation / credit / “大粉理论”
在逐个分析之前,先明确一下 metric 的作用对象。
一个 metric 同时影响两拨人:对被评价的 researcher 来说,metric 决定了大家的拟合方向和追求方向;对读者和评价者来说,metric 决定了是否要花时间去读一篇 paper。
首先是一作 paper 的总 citation。一作 paper 往往代表了一个 researcher 在一段时间内的主要投入方向,代表作一般也要求是本人一作,所以这是一个不错的起点。
但是 citation 会受很多与 paper 质量无关的因素影响,比如宣传、方向冷热、个人或团队本身的知名度。这些因素并不会影响 paper 本身的质量,却会影响 citation。
因此,一作总 citation 可以作为 metric,但需要结合这些因素打折看,并且排除两种特例:高频自引,以及靠大量 paper 对领域 DDoS。
其次是代表作。
相比于统计一个人发了多少篇 paper,代表作更接近直接看这个人到底做出了什么:这篇 paper 带来了什么结论,这些结论有没有被充分验证,以及其中哪些贡献是这个 researcher 做出的。
这个 metric 的优势在于,如果只允许提交少数几篇代表作,那么多产出低贡献的 paper 并不能提高评价,评价的重点也就从“总共做了多少篇”变成了“真正值得拿出来的工作是什么”。
对 researcher 而言,这意味着不需要把每个结果都尽快做成一篇 paper,把一个问题继续做深、把结论验证充分,同样是有价值的投入方向。
但是这个 metric 也有问题:代表作更接近一个 researcher 展示过的研究上限,而不是他的总 contribution。
一个人做出过一篇很好的 paper,说明他参与完成过这样的工作,但并不能说明他长期、持续地产生了多少贡献。
反过来,一系列不那么显眼、但是可靠且有用的工作,也可能积累出很大的总 contribution。
所以只看代表作,相当于放弃其他工作的信息,换取对少数工作的深入判断,这里存在一个 trade-off。
最后是 reputation / credit。
这里 reputation 的定义是:通过长期工作建立起来的研究信用。
假设我们读过某个 researcher 或某个组的几篇 paper,发现结论基本可靠、实验和结论能够对应上,而且确实帮我们理解或解决了一些问题,那么下次看到他们的工作,我们自然会更愿意花时间阅读。
也就是说,reputation 本质上是过去阅读、复现和使用经历积累下来的判断。它并不说明一篇新 paper 一定好,而是说明花时间去读这篇 paper 可能是值得的。
那么它就能缓解前面提到的读者注意力有限的问题:读者没有足够的时间从零判断所有工作,只能借助过去积累的信任,决定先把注意力投到哪里。
但它同样有问题。
一个刚开始做 research 的人,可能已经有不错的工作,只是还没有被足够多的人看到。没有建立起 reputation,不能等同于没有能力或没有贡献。
一个人过去的工作可靠,可以构成认真阅读他新工作的理由,但不能构成新工作不需要验证的理由。
另外,citation 和 reputation 不一定是两份独立的证据。
很多时候这两个 metric 都来自同一套知名度和传播优势,所以同时使用它们,很可能只是在重复计算同一个信号。
这点在最近很火的“大粉理论”上体现得很明显。“大粉理论”认为自媒体上的粉丝很重要,甚至比 citation 更重要。
这个说法当然有大家一起乐子串的成分,但是也能反映一些大家的看法:在一个 paper 过剩的时代,一个好的 personal brand 很重要。
为什么会有这种看法呢?
回到最开始对有限资源的定义:读者的注意力是有限的,而 paper 的数量在暴涨,每篇 paper 能分到的注意力只会越来越少。
在这种情况下,谁能吸引注意力,谁的工作就更容易被看到,而 personal brand 本质上就是一种获取注意力的能力。
也就是说大粉理论当然有合理的一面:personal brand 确实能让一项工作被更多人看到。
但是被看到并不等于有 contribution。
我的个人看法是,厉害的、真正有 contribution 的人,自然而然就会有很高的影响力和 personal brand;反过来却不成立,做得一般的人,也完全有可能有大量的粉丝。
也就是说,contribution 可以带来影响力,但影响力并不能说明有 contribution。
粉丝和 reputation 一样,衡量的是知名度和传播优势,而且比 reputation 离具体工作更远。
reputation 至少来自读者过去对工作本身的阅读和使用,而粉丝可能来自内容运营、热点解读,或者转述别人的工作(这部分没有影射任何人的意思,这句话是 Opus 写的)。
结论
以上分析的结论是:这三个 metric 都有用,但都不能单独等于一个 researcher 的总 contribution。
citation 反映的是传播,代表作反映的是上限,reputation 反映的是过去积累的信任。
而且仅仅更换 metric 并不能解决问题。
前面提到,metric 决定了被评价者的拟合方向:只看 pub,大家就会去拟合 pub 数量;只看 citation,就会转向更容易被引用的方向,或者在宣传上投入更多;只看 reputation 或者粉丝,经营知名度和自媒体就可能比工作本身更重要。
只要 metric 和我们真正想衡量的东西之间存在距离,它就一定会被拟合,也就不可能存在一个完美的 metric。
这里推荐一篇讲 benchmark 的 blog:
https://www.giovannidantonio.com/blog/science-of-benchmarking-part-1
因此,在 paper 通胀之后,并不存在一个能直接替代 pub 的简单 metric。citation、代表作和 reputation 都可以作为线索,但最终还是需要回到具体的工作本身做判断。
这当然比数 pub 麻烦,但原因前面已经分析过了:产生一篇 paper 的成本下降了,而理解和判断一篇 paper 的成本并没有下降。
以前这部分判断由会议替我们完成,现在会议标签所包含的信息越来越少,这部分判断就需要重新回到读者自己身上。
也就是说,回到最开始的定义,评价一个 researcher 的核心仍然是他对领域的总 contribution:从他的工作里,我们究竟多知道了什么,以及有哪些东西能够被后续的研究继续使用。
感谢和 Jiayi 的讨论,以及 Opus 5.5 的润色。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。