拿走 600 万!腾讯广告算法大赛所有获奖方案汇总!
原创 Datawhale 2026-10-29 22:00 浙江
Datawhale干货
获奖方案: 2026腾讯广告算法大赛
大模型圈「大力出奇迹」的经验,在推荐与广告系统里彻底失灵了。
在今年 KDD Cup 赛场上,拿到 Scaling Law 原创突破奖的 gg 队做了一组实验:保持输入特征不变,单纯把模型网络维度拉宽,结果从扩维第一步开始,指标 AUC 就在持续下滑。
“去年还能拿冠军的版本答案,今年已经失效了。”学术亚军「队名叫什么呢」队的队长,在赛后复盘时也有同感。
今年是腾讯广告算法大赛(TAAC)举办的第七年,也是这项赛事首次与国际顶会 ACM KDD 联合,以 KDD Cup 2026 的名义面向全球开赛。近 600 万元的奖金池,吸引了 52 个国家和地区的 13,913 名选手、5,746 支队伍参赛。
赛题直奔推荐系统二十年来的底层痛点:
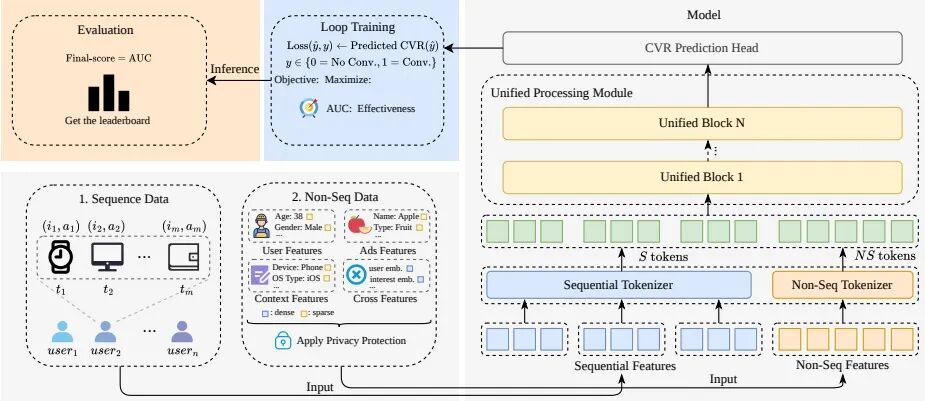
能否把多域动态行为序列特征,和多维静态属性与上下文特征,统一进同一个骨干网络里联合建模
很残酷的是,组委会今年全面禁止多模型集成刷分。
历经四个月实战,腾讯营销正式公开了官方综述论文。我们也邀请到工业赛道冠军队伍成员之一、目前位列 Kaggle 全球第一的「无敌叉烧包」,为这些方案提供自己的见解。
接下来,就带大家仔细拆解,这一全球最顶尖赛事之一的 8 套获奖方案。
一、两条老路已经走不通了
拿到官方统一的基线模型 HyFormer,手握数千万条样本和 7 张高性能显卡,不少队伍的第一反应,都是先沿着以前打比赛最管用的两套老路去试。
但很快,受控实验让大家齐刷刷碰了壁。
第一条走不通的老路是调参。 学术季军 utem 队把基线完整跑通后发现,官方给的默认配置已经调得非常充分,继续微调学习率或常规超参数,分数几乎纹丝不动。
第二条走不通的老路是硬堆规模。 既然调参没空间,那把网络加宽加深行不行?几百组实验跑下来,结果让所有人意外:
学术亚军「队名叫什么呢」队在海报上直接写下结论:More width or depth alone does not guarantee gains。
工业亚军 RClaw 队试着把稀疏 Embedding 表的容量翻了一倍,线上测试毫无增益,网络叠到 8 至 10 层时直接开始过拟合;
学术冠军 lozyyeah 队在负面实验记录里写明,单纯把前馈网络(FFN)做大或拉长训练轮数,带来的往往是零收益甚至负收益。
为什么在大语言模型上百试百灵的「Scaling」,到了推荐系统里不仅不涨分,甚至还会掉分?
一方面,是特征之间的严重失衡。 学术亚军「队名叫什么呢」队放了一组很说明问题的数据:光靠静态特征过一个 MLP,AUC 就能拿到 81.5%;这时候哪怕把四个业务域的几百条历史行为全拼上去,AUC 也只微弱涨到了 81.6%。静态特征的直接信号太强了,模型很容易偷懒,只靠静态字段就下结论。如果没有精细的结构设计,长序列信息根本使不上劲。
另一方面,是出现了「空闲宽度(Idle Width)」。 拿到创新奖的 gg 队在近千组实验后指出:大语言模型吃的是纯文本 Token,信息密度差不多;但推荐系统的特征五花八门。如果只把模型的隐藏层维度(d_model)拉宽,却没有同步喂给它更多有价值的特征信号,多出来的参数根本没东西可学,只能在训练里空转,甚至去死记硬背数据里的噪声。
与此同时,今年连「拼工程体力」的差距,已经被 AI 工具抹平了。
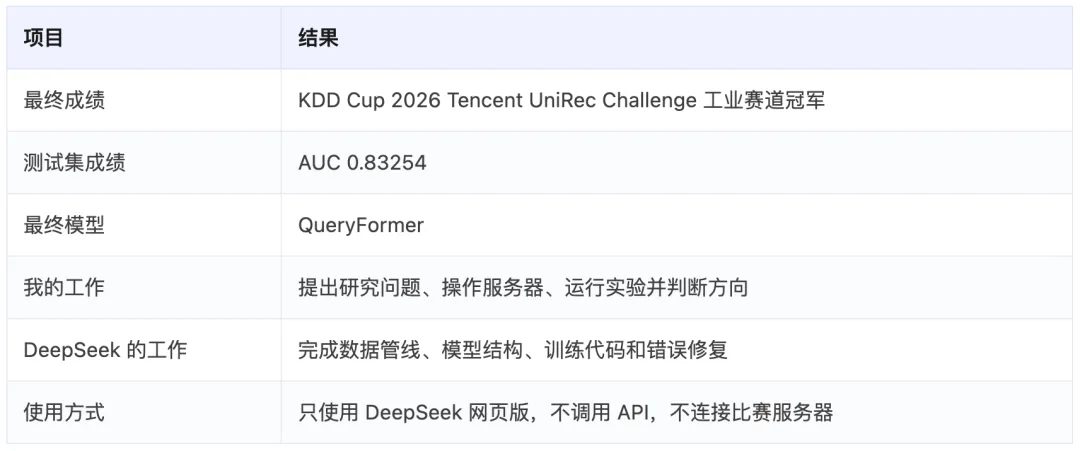
拿下工业赛道冠军的「日之光面」队,成员包括不到一年登顶 Kaggle 全球第一的选手和国内 15 次竞赛冠军得主。在整个比赛期间,全程只用免费的 DeepSeek 网页版对话,就写完了全部模型代码、多卡训练逻辑和几十组消融脚本。
冠军方案开源:我用 DeepSeek 网页版拿下 KDD Cup 冠军!
老路已经走不通,写代码的体力差距又被抹平,真正能带来质变的,往往就是那几项最核心的架构调整。
那么,这八套获奖方案到底把关键改动做在了哪里?
八套方案,四处关键架构改造
把今年拿奖的八套方案放在一起看,大家并没有去推翻基线重来。都是顺着一条数据从进入模型、逐层传递到最终输出预测分数的完整过程,在四个最容易卡壳的地方,各做了一次精准的改造。
官方综述论文:https://github.com/junwei-pan/junwei-pan.github.io/blob/main/paper/TAAC_2026.pdf中文深度技术解读:https://mp.weixin.qq.com/s/Unf7RyTnIwP2F8tPPfNrMg
1. 优化数据进入模型
在官方基线里,模型拿到用户的静态特征后,简单拼在一起过一层投影网络,就生成了初始的 Query,然后拿着这个 Query 去检索四个业务域的历史行为特征序列。
工业冠军「日之光面」、学术亚军「队名叫什么呢」和学术季军 utem 都觉得,这个入口处的 Query 生成得太草率了。如果「提问者」自己还没把当前用户和目标广告的特征看明白,去再长的历史记录里找线索也是白费力气。
「日之光面」队把核心思路定在「先把 Query 问明白」上。他们拆掉了原来那层简单的 MLP 投影,换成了一座查询生成桥:先用轻量网络筛选有效特征,再通过自注意力和交叉注意力,让用户与广告特征反复交互;等把当下的上下文理清楚了,再用交叉注意力去生成 Query,用于在四个业务域的行为特征序列中进行注意力交互与特征抽取。
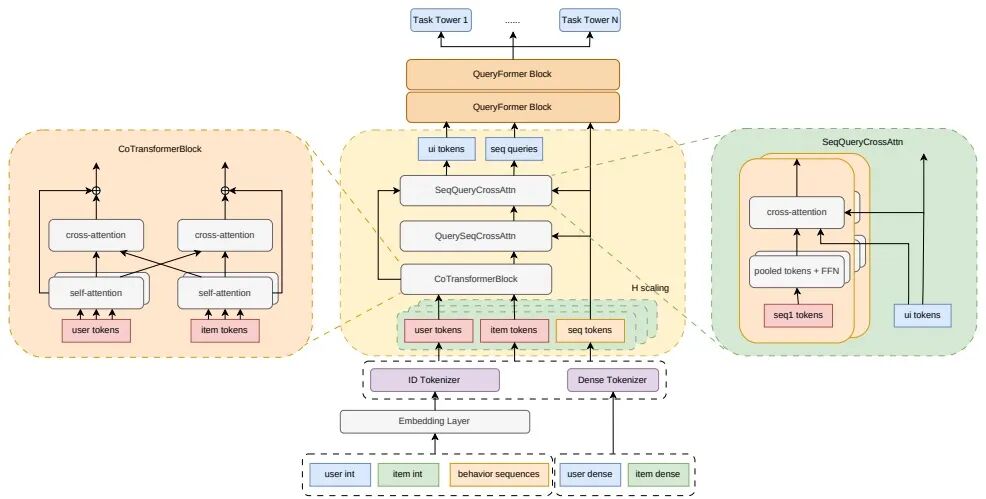
消融实验证明了这一步的效果:只要把这个注意力生成模块换回原来的简单 MLP,验证集 AUC 就会掉 0.00038,在所有单项改动里掉得最多。而且结构中包含的四个注意力子模块各司其职,单独拆掉任何一个都会掉分;把四个同时拆掉,掉的分数刚好等于它们各自掉分的总和(-0.00110)。
同样强化查询与解码的还有学术亚军「队名叫什么呢」队。他们采用双栈架构,在 Query 检索前先把多域历史收拾干净,抽出四个业务域的摘要互相交换证据,配合目标感知 Query 解码,把模型平稳扩到了 10 亿参数。
同样在入口处动脑筋的 utem 队,则重新规划了 Token 的分配方式。他们发现,过早把特征拆碎会破坏字段之间原有的关联,因此必须「在语义组内先交互,再切分 Token」;而在同样的稠密参数规模下,把更多 Token 预算分给候选广告侧(Item-side),效果明显好于分给用户侧。靠着向广告侧倾斜的分配策略,他们把一个单 Block 模型推到了 10.63 亿稠密参数。
2. 优化数据逐层传递
当信息进入模型并逐层往下传时,学术冠军 lozyyeah 队发现了一组值得注意的现象:随着模型层数加深,不同表征空间的变化并不一致。
他们用「有效秩」去测量 CRAFT 模型每一层实际承载的信息量,结果看到了一组反常的数据:当网络从 1 层叠到 6 层时,中间负责传话的查询载体(Query Carrier),有效秩从 70.4 涨到了 158.2,说明中间通道撑大了;但到了最后一层的最终输出,有效秩反而从 36.6 跌到了 27.7,序列摘要的有效秩也从 10.2 跌到了 7.9。
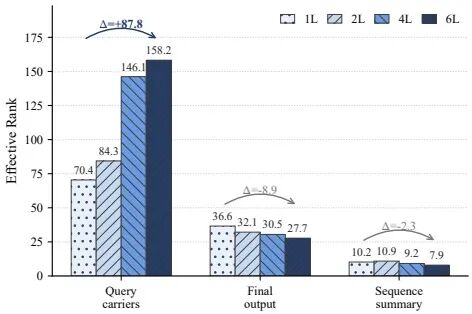
这意味着,模型中间通道越修越宽,但最终输出和序列摘要仍保持紧凑。论文据此认为,CRAFT 加深后主要扩展的是意图载体参与跨层传输的表征空间,而不是让所有表示空间一起膨胀。
沿着这个思路,lozyyeah 队把重心从「层内交互」改成了「跨层传输」。他们先让非序列特征聚合成一个稳定的上下文控制场,在每一层动态生成缩放、偏置和门控信号,护送着意图(Intent)和序列状态一层层往下走,同时始终留着一条通回初始信息的路。
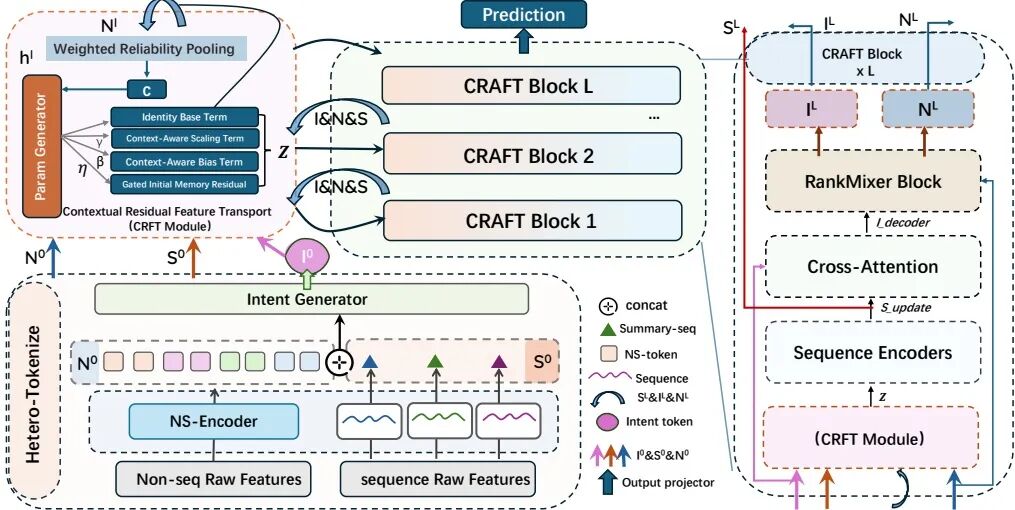
在论文里,他们非常坦诚地列出了从原始基线(0.832688)到最终夺冠(0.838090)的得分账本:先把工程基线做好(结构感知 Tokenization + 双优化器 + EMA),涨了 4.48‰;加上渐进式知识蒸馏,又涨了 0.82‰;在此基础上,CRAFT 架构本身不配蒸馏涨 0.07‰,配蒸馏涨 0.11‰。
单看架构的绝对分值增量并不夸张,但他们通过互信息热图证明,模型蒸馏改善的是监督信号,而 CRAFT 疏通的是跨层传递的通道,两边凑在一起完全没有冗余,并且新架构还把推理参数量从 3.35 亿降到了 3.09 亿。
3. 优化模型最终输出
顺着深层网络走到分类器末端,工业亚军 RClaw 队提了一个反向的问题:既然深层网络的非线性融合容易削弱部分直观的低阶信号,为什么不给经典算法修一条绕过主干网的直通道?
作者注意到,2010 年提出的因子分解机(FM)内积,跟现在 Transformer 注意力里的 Query·Key 打分,在数学底层其实是同一种点积运算。但在深层模型里,这种二阶内积信号如果跟着主干网一层层做非线性混合,走到最后早就被稀释了。
于是,他在每一层都把当前 Token 的二阶 FM 内积单独算出来,不经过后续复杂的非线性层,直接修了一条专属的高速通道(FM Highway)送到最末端的分类器。由于低阶交叉信号有了直达终点的保障,主干网就可以安心去做高阶的隐式混合。
作者在采访里说这个方法有点复古,只是把十几年前的东西跟现在的架构结合了一下。但在消融实验里,一旦拆掉这条复古的 FM Highway,留出集 AUC 就会掉 1.27‰,是全模型所有模块里掉分最多的一项。
这一项核心架构的改动,直接带来了全程超过六成的效果。
4. 优化模型全局
当不同来源的特征都被打包成 Token 放进同一个主干网时,最后两支队伍做的事情是给模型“减负”和“立规矩”。
拿到 Unified Block 原创突破奖的 T-Squared 队,由跨三个专业的本科生组成。第一次打搜广推比赛的他们发现,把所有特征放进一个 Transformer,不代表要让所有 Token 毫无限制地全连接交互,否则噪声很容易盖过有效信号。他们把大语言模型里的因果掩码改造成拓扑掩码(TopoMask),按 Token 的角色和行为域关系,明确规定谁能跟谁连、谁不能看谁,在测试集上比同管线基线提升了 9.7‰。
工业季军 load_state_dict 队则选择了“先压缩再混合(Compress before mixing)”。在进入主干网络前,他们先用候选广告特征把长长的历史行为序列压缩成固定数量(T=40)的意图 Token,然后再跟用户、广告字段一起放进残差流。保持混合阶段的 Token 数量少而固定,既压住了线上推理延迟,又利用固定的短长度起到了防过拟合的作用。
同样是把模型做大,为什么有人掉分、有人一直涨?
看完八支队伍对单模型结构的改造,一个更核心的工程问题也浮出了水面:在统一架构下,我们手里的算力和参数预算,到底该往哪里花才不会掉分?
赛场上有两组对照实验,把这条边界划得非常清楚。
第一组实验回答了“怎么把模型做大才有效”。
前面提到的 gg 队在跑了近千次实验后,在官方综述论文(§5.2)记录的实验里设计了一个九级语义 Token 阶梯,并拉出了三条对比曲线:
1. 只拉宽网络,不加新信息:保持现有的 Token 不变,单纯把表示维度放大。结果从扩容的第一步开始,分数就在往下掉。
2. 塞入“空 Token”:往模型里加一排可学习的空白参数槽位,容量变大了,但没有绑定新的外部特征。结果分数只在最开始微涨了一点点,随后很快掉头向下。
3. 语义协同扩展(Co-scaling):把每个 Token 的子空间维度固定住(d_sub=4),每往模型里增加一组 Token 容量,就同步喂进去一种新的预测信号(依次加入独立投影的预训练向量、用户与广告显式交叉、目标时间读出信号、多分辨率历史摘要),同时让共享主干网跟着一起变宽。
在这三条线里,只有第三条线随着模型规模放大,AUC 沿着九级台阶一路往上走;直到最后新加进来的 Token 家族开始出现信息重复,增长才平缓停下。
两个本科生在赛场上试出来的这条停止规则,恰好与腾讯营销此前在 RankUp 论文(arxiv.org/abs/2604.17878)里的研究相互印证:要想把推荐模型有效地做大,每增加一分参数容量,输入侧就必须有更丰富的新信息去填满它。
第二组实验回答了“算力不够时,什么能压缩,什么不能省”。
多支队伍的消融记录共同指向了一条按信息密度划分的红线:能大幅压缩的是用户行为序列,一点都不能省的是工业界预计算好的稠密特征(Dense Features)。
在行为序列一侧,T-Squared 队把长序列的记忆 Token 容量从 32/8 砍半到 16/4,再一路砍到四分之一的 8/2,测试集 AUC 只从 0.83464 微降到 0.83432,几乎没有损失;load_state_dict 队把长序列压到固定的 40 个 Token,信息同样没怎么丢。
但在稠密特征侧,谁敢粗暴压缩,分数立刻大幅下滑:
Unified Block 原创突破奖 T-Squared 队试着把多个稠密特征压成一个 Token,测试集 AUC 直接掉了 0.00917,是他们所有消融实验里掉分最重的一项;
学术季军 utem 队试着去掉稠密特征的预处理,直接掉了 4.73‰;
学术冠军 lozyyeah 队也专门记录,把结构化的稠密向量直接拍平投影,会明显削弱模型的扩容潜力。
背后的原因在于:工业系统传过来的稠密特征,往往是提前训好的 Embedding、对齐数组和多个独立子空间向量的集合,全是浓缩的高密度信号,一旦强行压平,就会把不同维度的关键线索混在一起。
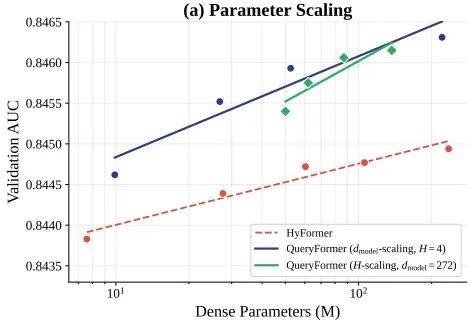
顺带给做工程的同学带来一个共识:今年前排队伍在训练配置上也高度默契,普遍采用「Adagrad(负责稀疏 Embedding)+ Muon 优化器(负责稠密主干)+ EMA 权重平滑」的组合。在 utem 队的消融表里,光是拿掉 Muon 或 EMA,就会直接损失 0.57‰ 到 3.50‰ 的精度。
把这几千次实验的正负结果合在一起,腾讯营销在官方论文里总结出了统一建模时代的三条扩容规律:
容量收益在不同模块间是不均匀的
能不能压缩取决于特征的信息密度
只有输入信息与模型容量同步增加(协同扩展),把模型做大才有意义。
几年前,Meta 用几千张 GPU 证明了推荐模型可以像大语言模型一样 Scale Up。而在这届 KDD Cup 上,五千多支队伍在受控算力下的密集试错,则替行业摸清了更落地的下半场问题:在算力和延迟受限的真实环境里,推荐系统的扩容正在从粗放的大力出奇迹,转向精细的聪明分配。
写在最后
回看推荐系统过去二十年的演进,序列建模和特征交叉各自发展出了庞大的模型家族。学术界与工业界都很清楚这两条路线终究要走向统一,但因为每家公司的业务场景、特征维度和线上延迟要求各不相同,不同论文提出的统一架构往往只在自己的数据集上有效。行业里一直缺少一把通用的尺子,去横向对比不同统一建模思路的真实得失。
这届 KDD Cup 相当于为社区立下了一个公开的参照系。
腾讯营销把每天支撑十亿级用户的真实工业难题拆解成标准赛题,以禁止集成的规则锁定单模型架构,让全球数千支队伍在同等硬件约束下进行极限测试。哪些注意力机制可以叠加,哪些跨层传递会丢信息,哪些特征一压就掉分,都在统一的基准下得到了清晰的对照。
比赛收官后,这套耗费巨大算力试出来的成果被完整保留了下来。脱敏后的多域公开数据集、基于 HyFormer 的标准评测基线,以及详尽对比了八套获奖方案与负面实验记录的官方综述论文(中文解读已发布于腾讯广告技术公众号,英文论文已上线 GitHub),都已经对外开放。
而这场比赛的价值,远不止于赛场之内。
赛场上跑出来的不少创新解法,正在直接反哺实际生产的多阶段排序链路;而从这里走出的选手,也成了业务一线的中坚力量——自大赛创办以来,已有近百位参赛选手通过比赛进入腾讯实习与正式入职。比如上届第七名、也是本届学术季军队长的选手 utem,今年 7 月就已经正式入职腾讯,从当年的刷榜学生变成了业务一线的研发成员。
对更广泛的研究者和工业界同行来说,在探索推荐模型如何统一与扩容的路上,终于有了一份具备横向对比价值的工业级参考底稿。
官方综述与获奖方案The Tencent Advertising Algorithm Challenge 2026:https://github.com/junwei-pan/junwei-pan.github.io/blob/main/paper/TAAC_2026.pdfFrom Feature Interaction to Feature Transport - A Unified Block for Scalable Recommendation Models:https://arxiv.org/abs/2609.01655QueryFormer: Winning Solution for KDD Cup 2026 Tencent UniRec Challenge:https://arxiv.org/abs/2609.16548,https://mp.weixin.qq.com/s/FNdUKN6dkCtIuufu4uQa3gUniDot: A Unified Network for Sequence Modeling and Feature Interaction in Large-scale Recommendation:https://arxiv.org/abs/2608.16797Topology-Masked Unified Backbone for Joint Feature Interaction and Multi-Domain Sequence Modeling:https://arxiv.org/abs/2608.27005其他 UniRec 方案Dense Feature Representation over Sequence Modeling: A Solution to the KDD Cup 2026 UniRec Challenge:https://arxiv.org/abs/2609.19787STAR: Structured Tokenization and Target-Aware Interest Representation for PCVR Prediction:https://arxiv.org/abs/2608.12986RoleMix: Unifying Sequential and Non-Sequential Features via Semantic Tokenization for Post-Click Conversion Rate Prediction:https://arxiv.org/abs/2607.22700Field-Aware RankMixer with Dual-Stream Bilinear Fusion for the Tencent UNI-REC Challenge:https://arxiv.org/abs/2607.15590上游研究RankUp: Towards High-rank Representations for Large Scale Advertising Recommender Systems:https://arxiv.org/abs/2604.17878TokenFormer: Unify the Multi-Field and Sequential Recommendation Worlds:https://arxiv.org/abs/2604.13737LONGER: Scaling Up Long Sequence Modeling in Industrial Recommenders:https://arxiv.org/abs/2505.04421RankMixer: Scaling Up Ranking Models in Industrial Recommenders:https://arxiv.org/abs/2507.15551
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。