照片删掉了,但现场还在!一张图如何暴露拍摄者的位置
原创 无名 2026-10-30 10:39 辽宁
一张照片究竟能泄露多少东西?
对于普通人来说,这个问题的答案通常很简单:照片里拍到了什么,就泄露什么。但在开源情报分析人员眼中,真正有价值的信息往往并不位于画面的主体,而隐藏在摄影者根本没有意识到自己拍进去的背景里。
一截道路、一排路灯、半块商店招牌、屋顶的坡度、远处山脊上一处不起眼的缺口、柏油路边缘一道特殊的标线、树木处于常绿还是落叶状态,甚至下午的阳光究竟从建筑哪一侧照来,都可能成为定位线索。
这些信息单独来看往往微不足道,但只要被放入同一个分析框架,它们就可能组成一套比手机GPS更难彻底“关闭”的地理指纹。
人可以删除照片的EXIF信息,可以关闭手机定位,可以裁掉门牌,可以把画面里的文字打上马赛克,也可以把社交媒体原帖删得干干净净,但他很难让一条山脉重新长一遍,更不可能要求太阳临时改变运行轨迹。
因此,在今天的开源情报调查中,一个最基础、同时也最容易被普通公众忽略的事实是:照片可以没有坐标,却很少真正没有地理信息。
2026年8月,路透社在介绍其视觉核验体系时明确提到,对于网络上出现的照片和视频,核验人员不仅会寻找原始发布者和检查元数据,还会把画面与卫星影像、街景、天气记录、阴影、官方资料、新闻报道以及其他目击者影像进行交叉比对。
只有当不同类型的证据能够彼此支撑,一段视觉材料才真正具备进入报道的资格。
这套方法真正值得研究的地方,并不只属于新闻业。它揭示的是现代情报活动正在发生的一种深刻变化:
过去,地理情报往往来自卫星、航拍、地图、侦察设备和专业数据库,而今天,大量地理情报实际上由普通人在日常生活中主动上传,而且往往高清、免费、连续更新。
换句话说,保密制度越来越严格,摄像头像素却越来越高。
真正的问题已经不再只是“有没有秘密文件被泄露”,而是无数原本看似普通的照片和视频,在被正确拼接之后,会不会自己生成新的情报。


很多人第一次接触图像地理定位,最容易犯的错误就是盯着照片凭感觉判断地点。
看到红瓦屋顶,觉得像南欧;看到平顶建筑,觉得像西亚;看到高纬度植被,又觉得像北欧。
这种判断不能说毫无价值,但它更多属于旅行经验,而不是情报分析。真正专业的地理定位,首先解决的并不是“这里究竟是哪儿”,而是“哪些地方不可能是这里”。
这两种提问方式看似只差几个字,背后的方法论却完全不同。前者依赖直觉,后者依赖排除。
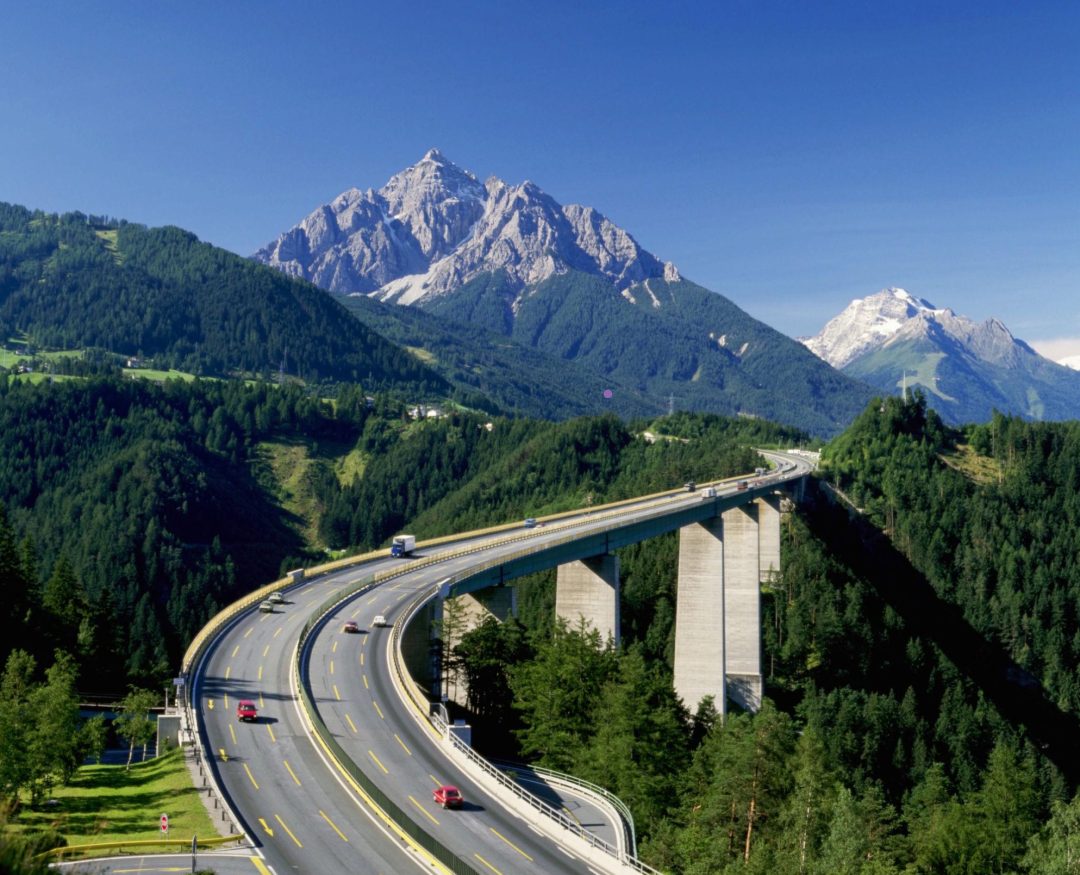
例如看到一条公路,专业分析员关心的并不是“这条路看着像哪个国家”,而是中央线是什么颜色、实线还是虚线、道路边缘有没有标线、车辆靠哪一侧行驶、路牌安装在左边还是右边、道路反光标采用什么结构、路缘石怎样处理、车道和路肩的比例是否符合某国工程规范。
原因并不复杂:交通设施不像建筑装修那样具有高度自由,它往往受到国家法律、工程标准和长期交通习惯的约束。
以美国为例,目前有效的《统一交通控制设施手册》是第11版修订1,该修订版本自2026年3月5日起生效,并继续对道路标线、交通标志和信号设施实行统一技术标准。
这意味着,一条不起眼的道路标线,实际上可能携带制度信息。建筑可以模仿,餐厅可以装修成法国风格,住宅可以修成地中海式,但一个国家数万公里道路上的标线体系、信号设施和交通工程标准,很难整体“演戏”。
在开源情报分析中,这类特征可以被理解为“制度性指纹”。它们通常不负责单独给出答案,却非常擅长帮助分析人员排除错误答案。
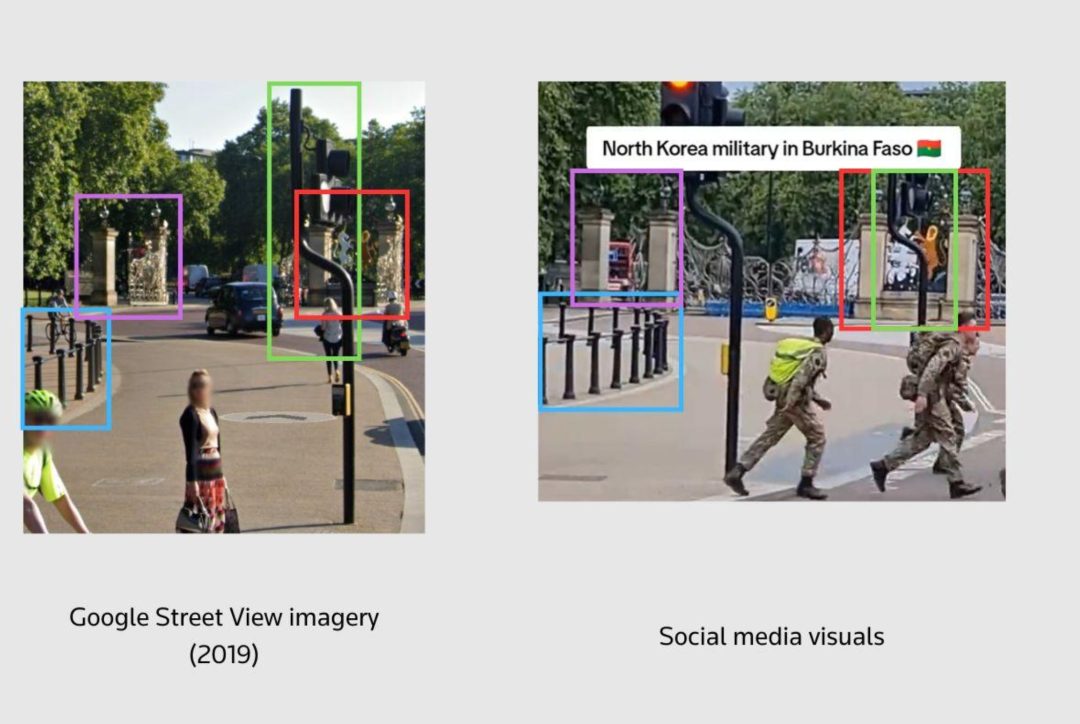
2026年7月,法国队在世界杯半决赛输给西班牙后,社交平台开始流传一段所谓“巴黎街头骚乱”的视频。
画面具有典型的高传播性:火光、人群、奔跑的身影、紧急车辆,再配上一段情绪强烈的文字,几乎把一个完整故事送到了观众面前。
问题在于,这段视频并不是世界杯半决赛之后拍摄的。
AFP事实核查通过反向搜索发现,相同视频早在2026年5月30日巴黎圣日耳曼夺得欧洲冠军联赛冠军后的骚乱中就已经出现。
调查人员进一步识别视频中的摄影者用户名,找到更早的发布记录,同时注意到画面里一家名为“Boucherie de la Porte de Saint-Cloud”的肉店。
随后,他们通过Google街景比较店铺门面和周边道路环境,确认拍摄地点位于巴黎穆拉大道一带。
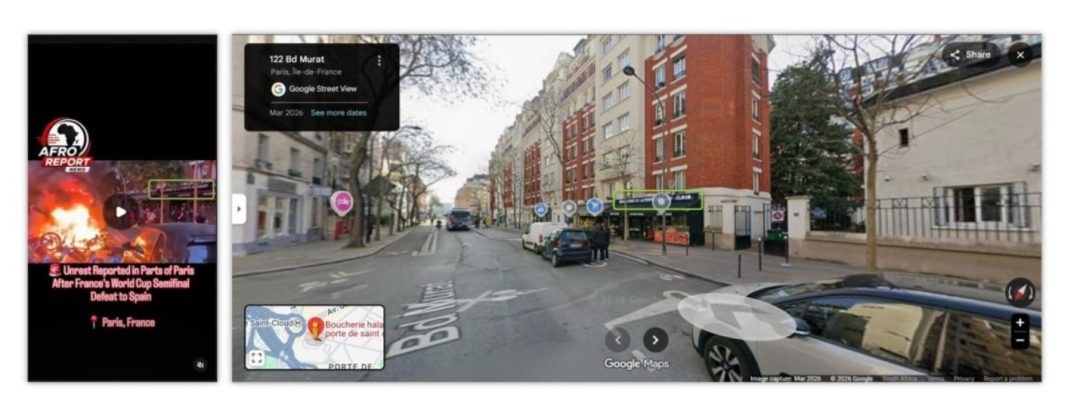
这个案例表面上是在讲“商店招牌定位”,实际上揭示了一条更重要的调查原则:在分析地点之前,先确认材料从哪里来。
很多初学者一看到地理定位任务,就急着打开地图搜索,但真正高效的调查流程往往先寻找最早出现的版本。
因为一旦发现同样的视频两个月前已经上传,所谓“今天发生”的叙事就已经被击穿。时间链一旦断裂,地点问题往往会迅速简化。
现代开源情报调查中,反向图像搜索之所以经常排在地图分析之前,并不是因为地图不重要,而是因为来源链本身就可能直接否定整个故事。
2026年8月,一段规模很大的摩托车车队航拍视频在社交平台传播,一些帖子声称,大批摩托车手正在前往美国密歇根州迪尔伯恩参加一场政治性K议。
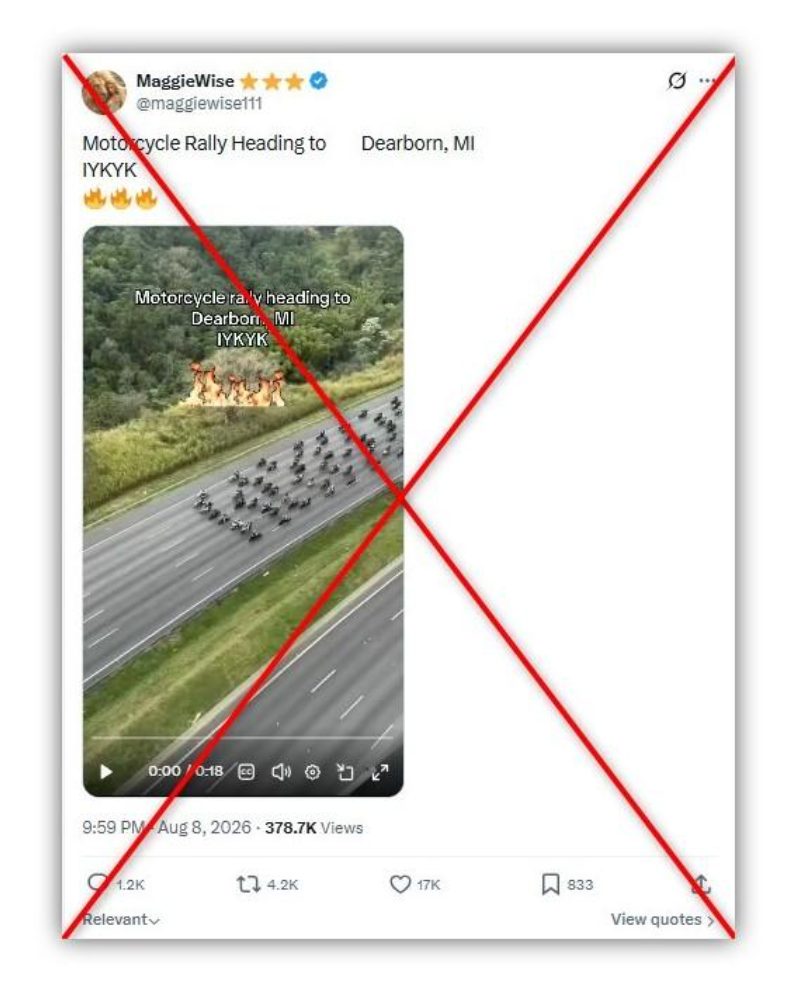
画面壮观、车队漫长,又高度符合当时美国国内政治争议的情绪环境,因此很容易被接受。但视频本身是真的,事件描述却是假的,更准确地说,是地点被重新包装了。
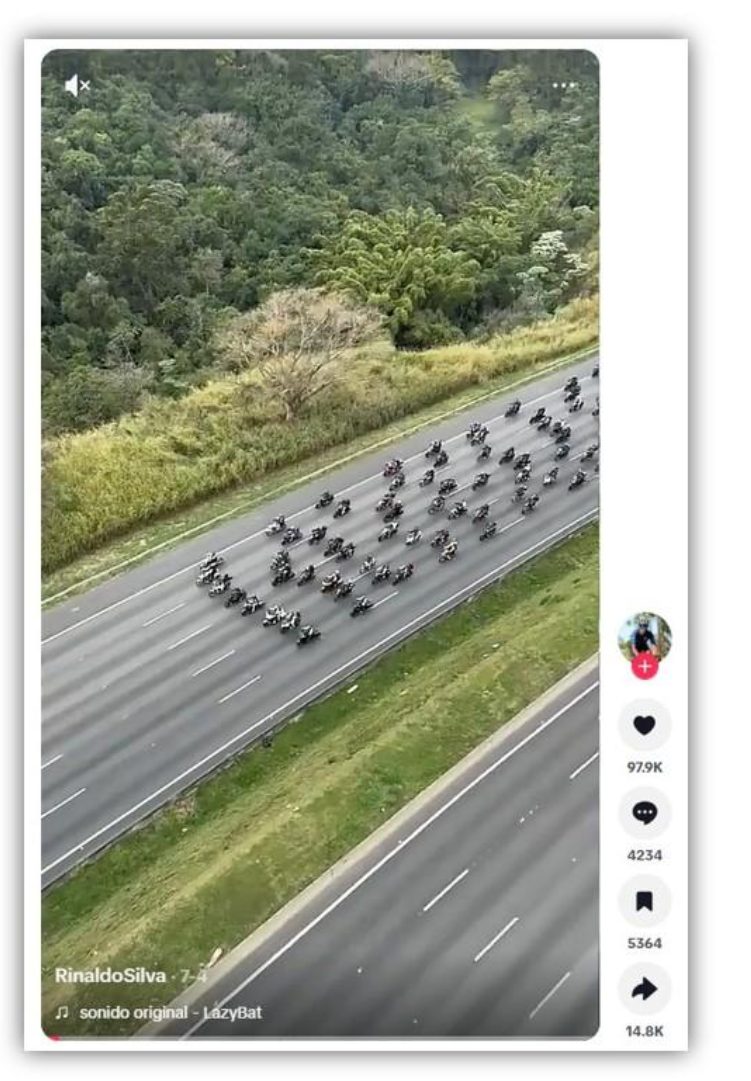
AFP通过反向搜索发现,这段视频至少在2026年7月初已经出现,发布者的其他内容显示,画面实际上与巴西摩托车组织Insanos MC在圣保罗州举行的活动有关。
但专业核验并没有停留在“发布者自己这样说”这一层面。调查人员继续寻找固定参照物,最终锁定了一座无线电塔和一座红色屋顶建筑,并利用Google街景沿巴西Rodovia dos Bandeirantes公路比对,完成了独立地点确认。
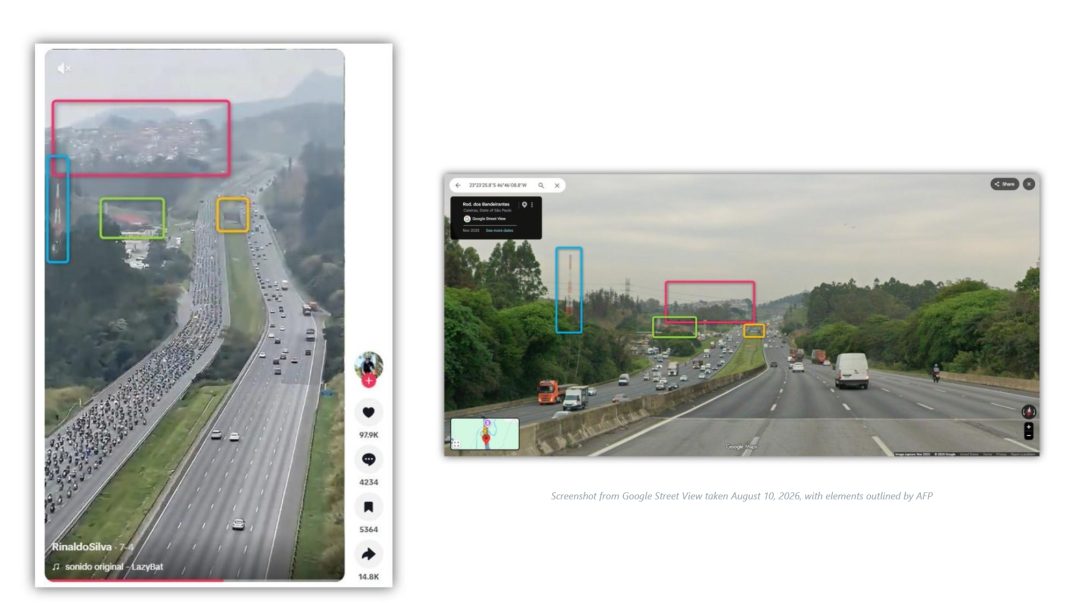
这个案例说明了图像定位中的一个核心优先级:移动物通常不如固定物有价值。
车辆会离开,人群会散去,广告牌会撤换,施工围挡可能几周后就不存在,但大型建筑、桥梁、无线电塔和道路几何不会轻易改变。
因此,画面中的物体通常可以分成三类:第一类是长期稳定物,例如山体、道路、桥梁和大型建筑;第二类是半稳定物,例如商店、路灯、公交站和围栏;第三类是临时物,例如车辆、行人和活动横幅。专业分析往往优先处理前两类,因为它们更容易在不同时期的卫星影像、街景和新闻图片中重复出现。
网络地理竞猜常常喜欢讨论建筑风格,例如红瓦屋顶意味着南欧、平屋顶意味着中东、木结构意味着北欧。
但在真正的开源情报分析中,建筑的核心价值并不是审美,而是几何。专业调查人员观察的不是“像不像某地”,而是建筑有多少层、屋顶是平顶还是坡顶、窗户横向有多少列、有没有连续阳台、附属建筑位于主体哪个方向、水塔和烟囱在什么位置、道路从建筑前方以什么角度穿过,以及从摄影者当前位置看,A建筑究竟挡住B建筑多少。
2026年3月,Bellingcat核验伊朗米纳卜学校及邻近设施遭袭公开视频时,就采用了这种思路。
调查人员并不是简单寻找“一所长得相似的学校”,而是把视频中的建筑、树木、水塔等多个固定参照物与卫星影像进行对应,并利用它们的相对方位推断拍摄区域。
更进一步,他们还结合太阳和阴影条件,对不同视频的拍摄时间进行比较,从而判断这些影像可能对应事件的不同阶段。
这正是专业分析和普通“看图猜地点”的区别。
普通判断会问“这栋楼像不像”,而专业分析真正关心的是“从这个位置观察时,这几栋楼之间的遮挡关系能否同时成立”。世界上长得相似的白色三层楼很多,但如果三栋建筑、一座水塔、一条道路和一排树以完全相同的空间关系出现,候选地点就会骤然减少。
一个单独物体只能算特征,多个物体之间稳定的相互位置,才真正构成空间结构,而情报分析最喜欢的,恰恰就是结构。
如果建筑是城市的脸,那么道路就是国家治理体系留下的指纹。
很多经验丰富的图像定位人员进入一张陌生街景后,第一眼并不是看楼,而是看地面。
原因很简单:车道怎么划、中心线用什么颜色、禁止超车区域如何表示、道路边缘是否画线、高速公路出口采用什么颜色、警示标志是三角形还是菱形、公交站怎样设置、路灯使用什么材质,这些设计往往不是随机产生,而是来自交通法规、工程标准、财政能力和长期历史传统。
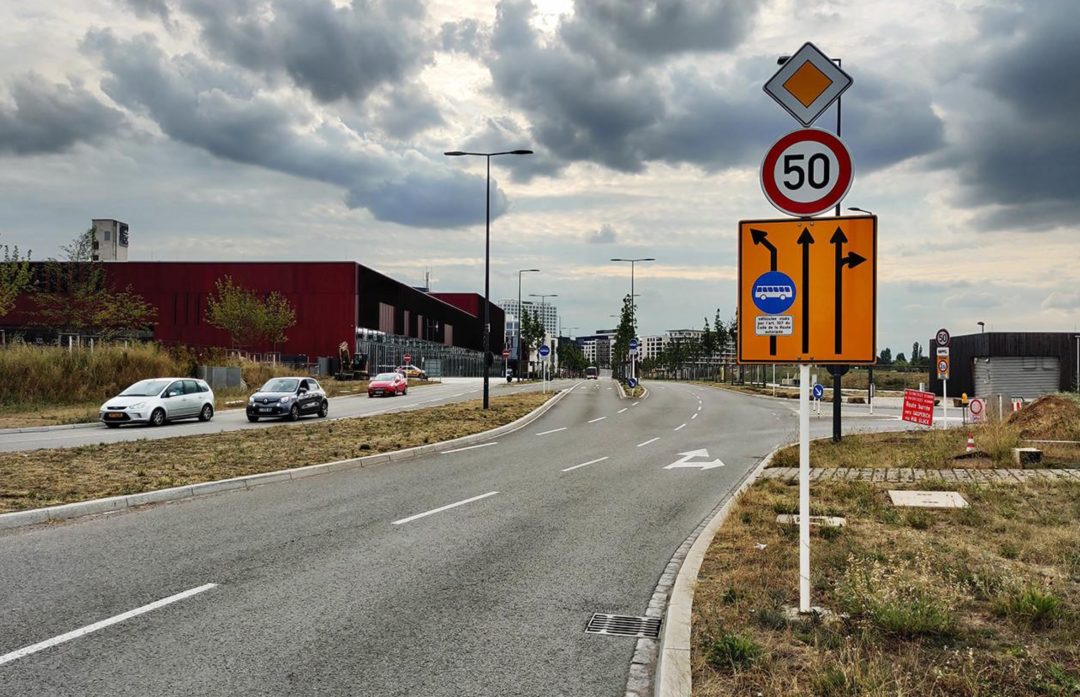
因此,道路设施可以被理解为一种国家级视觉语法。但必须强调,道路标线的正确用途主要是排除,而不是单独定案。
邻近国家可能采用类似规范,殖民历史也可能留下共同交通体系,私人园区甚至可以自行喷涂类似标线。专业报告绝不能因为看到一种黄色中央线,就立即写出“确认拍摄于某国”。
更严谨的表达应该是:“这一道路标线与某国现行交通工程规范相容,从而提高了该候选区域的可能性。”
看起来只少了几个绝对化的词,情报质量却完全不同。对于专业分析者来说,“确认”“高度可信”“可能”“不能排除”不是文学修辞,而是不同证据等级的表达。
当画面离开城市,进入山区、荒漠或者边远地区,商店、路牌和建筑迅速减少,真正可靠的参照物往往只剩地形。
山体地理定位的价值就在于,大型地貌在人类活动时间尺度上几乎不会改变。
主峰在哪里、副峰低多少、山脊有哪些明显缺口、几座山峰如何遮挡、前山和后山怎样重叠,这些都可能形成天然的几何特征。
但山体定位有一个极容易被忽略的问题,那就是透视。
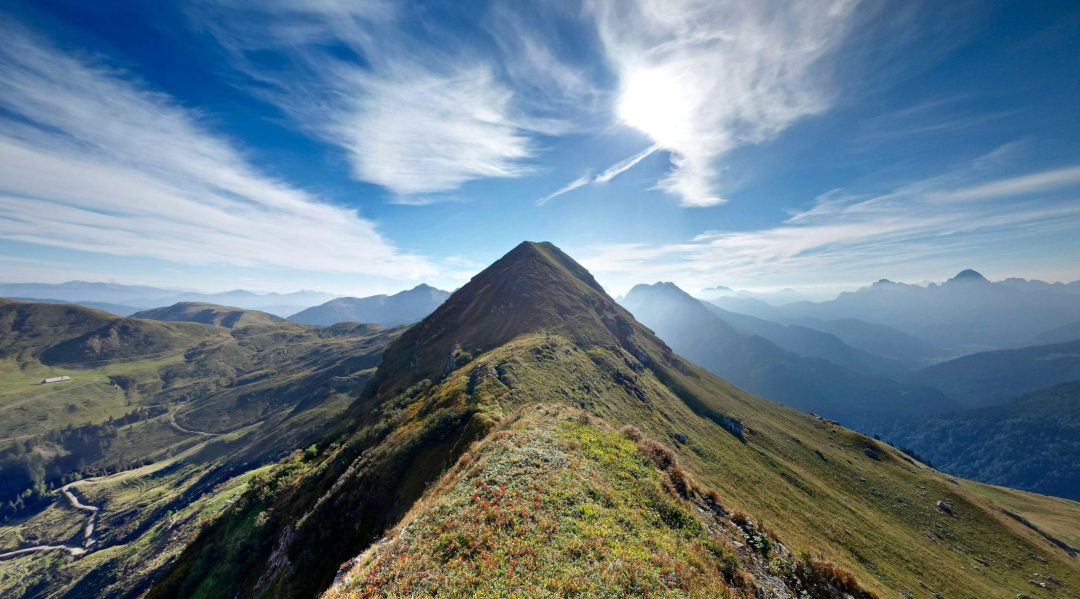
同一座山,从不同观察位置看,轮廓可能差别很大;拍摄位置横向移动几公里,峰与峰之间的遮挡关系就可能发生变化。长焦镜头还会带来明显的空间压缩,让远处山体看起来离前景更近。
因此,“山形很像”从来不能成为最终证据。真正的验证必须检查拍摄方位是否合理、候选地点的视线是否会被其他山体挡住,以及主峰、副峰和鞍部能否以正确顺序出现。
开源情报分析最危险的一句话之一就是“看上去完全一样”,因为人脑天然擅长寻找相似,尤其是在已经知道候选答案之后。专业调查必须故意反其道而行:不是不停寻找支持,而是主动寻找能够推翻当前判断的东西。
如果一张街景照片里出现商店招牌,调查难度通常会明显下降,因为文字本身是一种高度压缩的信息。
一个招牌可能同时包含语言、电话号码、域名、城市名称、区域代码、公司法律形式、连锁品牌甚至街道名称,这些信息都可能帮助缩小候选范围。
但招牌也存在一个极大的陷阱:同名。
全球有多少家“Central Hotel”、多少家“Grand Café”、多少家“Roma Restaurant”,很难统计。
如果只识别到一个常见店名,然后把搜索引擎第一条结果当成地点,得到的往往不是结论,而只是搜索排序。真正有价值的通常是低频信息,例如电话号码区号、一个地方化公司后缀、小语种中的特殊拼写、公交站编号,甚至招牌上只剩下三个可以辨认的字母。
前述巴黎案例之所以成立,并不是因为画面“看起来像巴黎”,而是因为具体商铺、道路结构和来源链能够相互对应。
视频在这一点上有时比单张照片更有优势。一帧里的招牌可能因为运动模糊无法读取,但前后几帧由于摄像机晃动、光线变化或者前景遮挡不同,可能露出新的字符。
因此,常常会把几十秒视频拆成大量关键帧逐一检查。外行看的是一段连续视频,调查员看到的是数百张潜在证据碎片。
植被是图像定位中最容易被高估的线索之一。看到棕榈树,可以判断环境与热带或亚热带相容;看到白桦,可以提示温带或寒温带环境,但这些判断距离具体国家仍然非常遥远。
植物并没有国籍,它只服从气候、土壤、海拔、降水以及人类栽培。因此,真正有价值的植物分析不是识别一棵树,而是观察植物组合:常绿还是落叶、自然植被还是城市绿化、不同植物是否同时出现、叶片状态是否符合季节、植被密度与候选海拔是否合理。
2026年10月,Bellingcat公布了一轮图像地理定位模型测试。研究人员使用52张此前没有在互联网上公开、并且已经去除元数据的照片测试多个模型,其中部分照片几乎没有明显地标,甚至只剩植被和很小一部分建筑。
结果显示,表现最好的模型已经能够迅速把相当一部分影像缩小到正确的大致区域,部分模型至少有10张照片进入真实地点1公里范围,领先模型则有超过一半测试图进入25公里范围。
但这项测试更重要的结论是,没有任何模型可靠到可以取消最后的人工验证。
人工智能非常擅长从全球范围迅速缩小到某个国家、地区甚至城市周边,但最后几公里、最后一个街区往往仍然最困难。
现实中的情报工作恰恰经常输赢就在最后一公里,因此植物和AI识别都应该被视为候选生成工具,而不能直接充当最终判决。
阴影是视觉调查中最漂亮的一类证据,因为其背后的物理规律高度稳定。如果已知拍摄日期,那么太阳在不同纬度、不同时刻的高度和方位都可以计算。
因此,影子通常可以回答两个问题:一个候选地点在特定时间是否可能,以及一段影像声称的拍摄时间是否合理。
但阴影分析的最大问题在于,数学可能很精确,输入条件却未必精确。物体真实高度是多少、地面有没有坡度、镜头是否倾斜、广角畸变有多严重、物体是不是严格垂直,这些都会改变结果。
因此,阴影更适合做验证工具,而不是所谓“万能定位仪”。如果分析员量了一根模糊电线杆的影子,然后给出精确到小数点后六位的经纬度,这并不代表技术高明,只说明误差被排版得很整齐。
天气是一种非常容易被低估的时间证据。一张普通街景实际上可能包含大量气象信息:地面是否湿润、车顶有没有雨水、路边有没有残雪、树枝朝哪个方向摆动、天空是什么云层、能见度如何、人物衣着与温度是否明显冲突,甚至道路积水是否像刚刚结束降雨。
这些信息很难单独证明地点,却非常适合用来检验一个已经提出的地点和时间。
例如有人声称某视频是“今天上午在某城市拍摄”,而当地可靠气象观测显示当天上午持续晴朗,视频里却出现明显持续降雨,那么这并不能立即告诉我们视频究竟来自哪里,却足以说明原始叙事存在问题。
美国NOAA的Integrated Surface Database整合了全球大量地面站逐小时和定时观测,可以提供风向风速、温度、露点、云量、气压、能见度、降水和积雪等信息,其公开资料显示可获得超过2万个站点的数据。
对于地面站稀疏地区,还可以利用ERA5等全球再分析数据帮助判断区域天气背景。ERA5目前提供自1940年以来的全球逐小时资料,其大气变量常用规则网格约为0.25度。
但必须强调,网格数据不是街角观测。0.25度的再分析资料适合判断区域尺度天气,却不能被写成“某个路口某一分钟一定下了多少毫米雨”。
开源情报报告里经常出现一种技术滥用,就是把模型精度写得比模型本身更高。数字越精确,看起来越像科学,但自然界并不知道你的表格保留了几位小数。
下一期我们接着聊!
本文转载自微信公众号「情报分析师」,查看原文。版权归原作者所有,如有侵权请联系删除。