让 AI 度量产品体验:UES-Assis 套件发布!
原创 阿里云设计中心 2026-10-30 15:45 四川
自 2019 年建立以来,阿里云 UES 持续积累和完善体验评估准则。此前,我们曾在《用 AI 开启体验度量新时代》、《AI 时代下 UES 体系的挑战与未来》、《以智能度量重构用户体验设计逻辑》等分享中,探讨体验度量的发展方向。
而随着 AI 加快产品开发的步伐,我们也在进一步探索:如何将这些专业经验融入日常开发,帮助团队发现问题、改进产品?
围绕AI 专家、虚拟用户与自适应度量,团队已在 CHI 2026、HCII 2026 发表三篇论文,探索 AI 参与体验评估的方法与效果。在这些研究与实践的基础上,我们推出了 UES-Assis 套件,将评估准则与执行流程接入 Agent,供设计师和开发者在日常项目中调用。
下面,我们回到这段探索的起点,看看套件是如何一步步构建起来的。
UES:历史积累 · 新版双钻评估架构 · 云栖大会现场
① 从研究出发,验证 AI 体验评估的潜力
2025 年,随着 AI 与 Agent 逐步应用于设计工作,我们开始探索如何让 AI 参与体验评估:既以专家视角检查界面,也模拟不同用户完成任务,比较它们发现问题的效率、有效性和视角差异。
*以下为早期研究结果,实验采用的模型版本截至 2025 年底。
AI 专家:更快发现有效问题
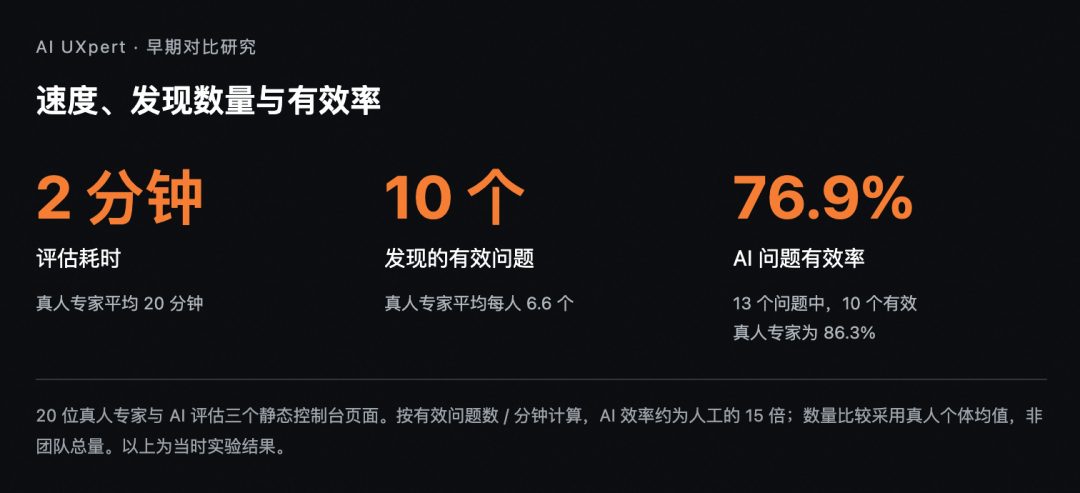
在三个静态控制台页面的对比实验中,AI 用更短时间发现了更多有效问题,还发现了 20 位专家均未指出的“破坏性操作保护不足”问题。
虚拟用户:让评估关注角色差异
专家视角之外,我们也希望了解:当 AI 带着不同用户的目标、能力和习惯完成任务时,能否发现另一类问题?
为此,我们采用七维构建法,从角色属性、技能能力、操作习惯、目标导向、情绪认知、反馈表达和行为随机性七个方面组织画像,并将这些设定转化为走查时的行为规则。
例如,为“首次部署模型的开发者”补充专业基础、预算目标、查阅文档的习惯,以及遇到报错时的反应。这样,AI 才能带着明确的角色约束检查任务,呈现不同用户可能遇到的卡点。
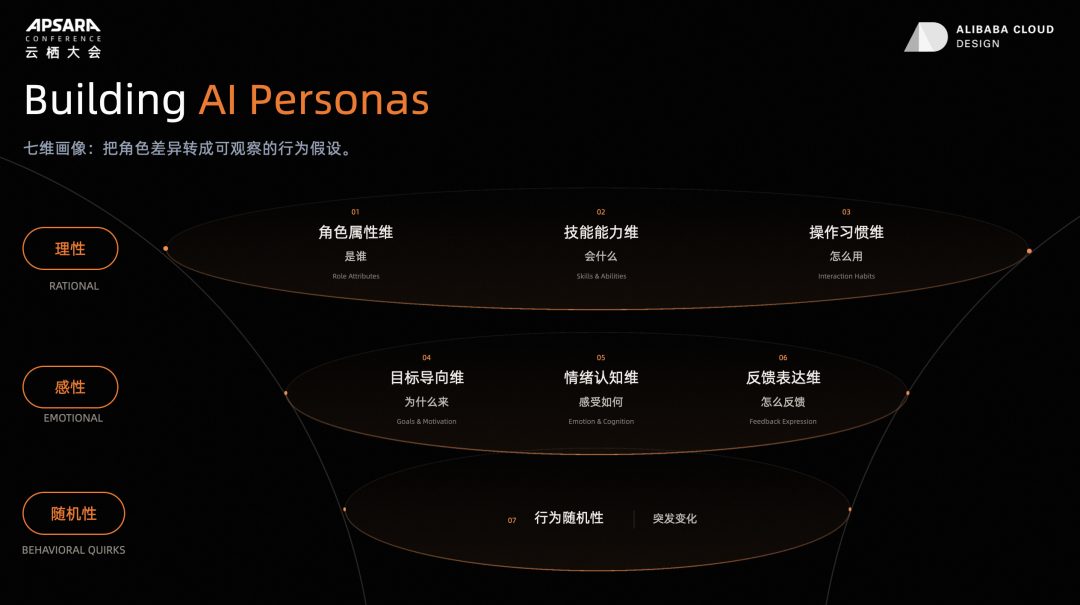
七维画像框架
在这项研究中,16 个个性化 AI 分身合计发现 69 个问题,16 位真人专家组成的团队发现 53 个,单个通用 AI 发现 14 个,展示了多角色走查拓展问题发现范围的潜力。
早期研究让我们逐渐形成了一个认识:AI 可以帮助提高评估效率,也可以通过不同角色补充问题发现的视角。但要将这些潜力应用到实际项目中,还需要进一步明确评估情境、检查依据和执行过程。
② 从研究经验到可调用的评估方法
随着 Agent 能力与应用场景不断拓展,我们也开始将关注点从实验中的表现,延伸到日常项目中的使用:如何让 AI 理解当前产品与任务,选择合适的评估准则,并让团队能够反复使用这些方法?
围绕这一目标,我们进一步整理研究与实践中的经验,从情境适配、知识提炼和专家打标三个方面,构建可供 AI 调用的评估方法。
情境适配:先明确评什么
同一条设计原则,在不同产品和任务中,关注的重点可能并不相同。因此,评估开始之前,需要先明确产品、目标用户、核心任务,以及有哪些证据可供判断。
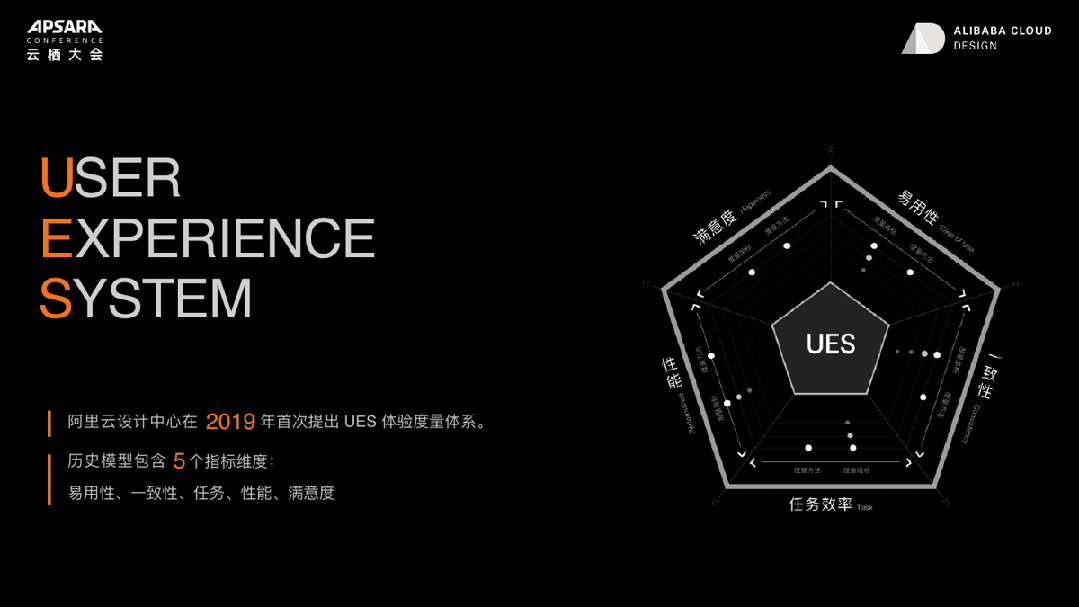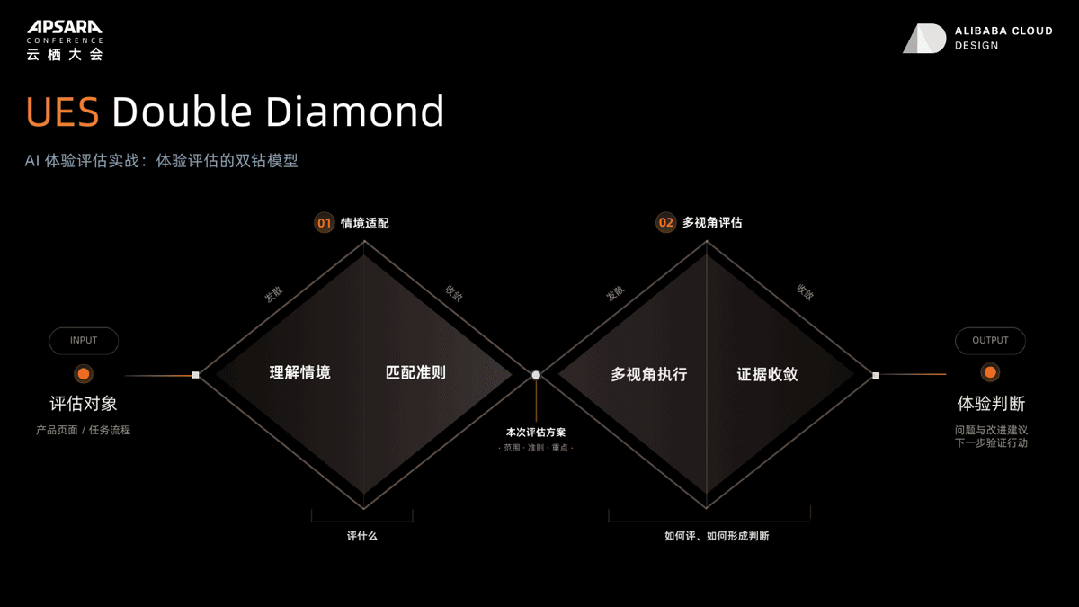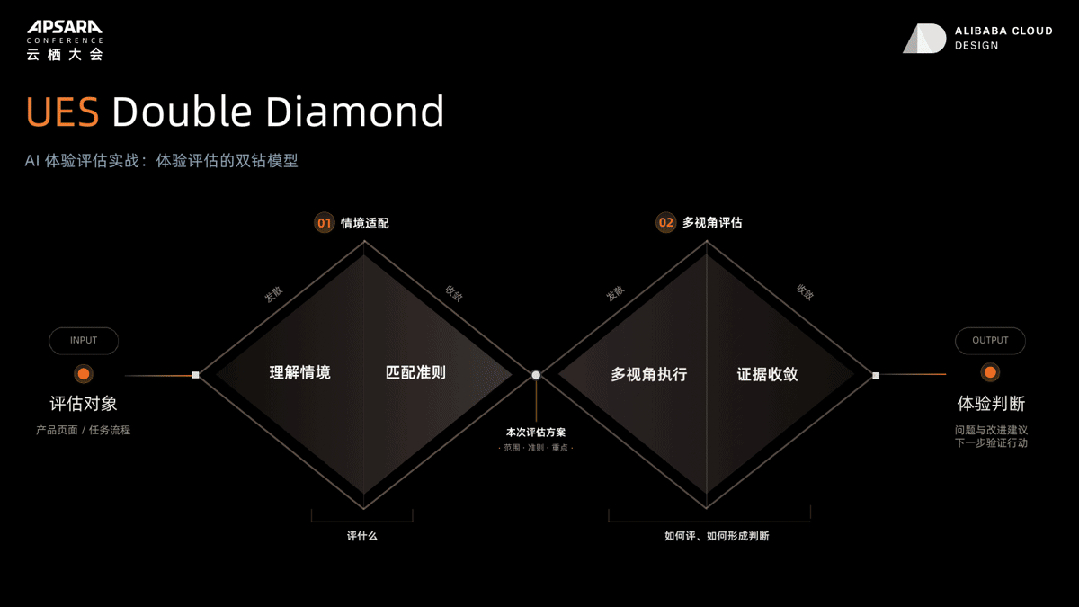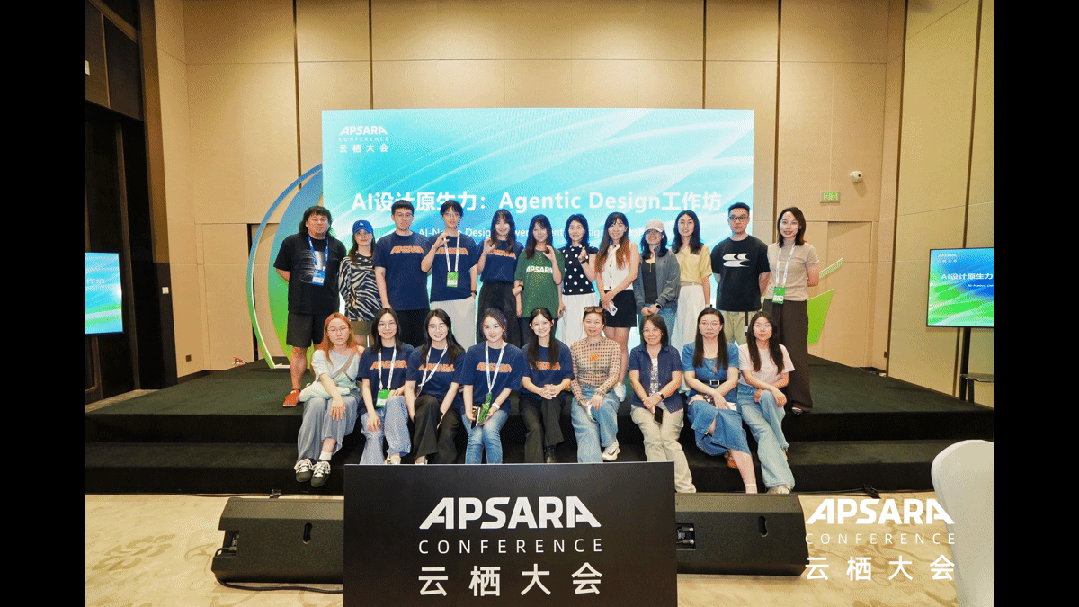
“体验评估双钻”将这一过程分为两步:先明确产品、用户、任务与证据范围,匹配适用准则;再从不同视角展开检查,复核证据,形成判断。
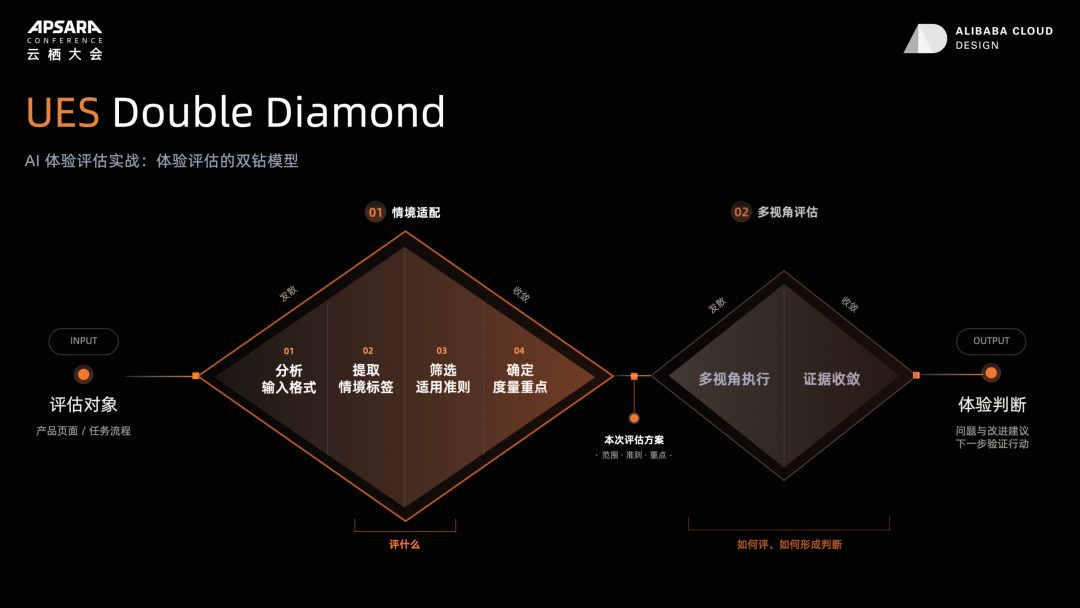
体验评估双钻
以 PAI 为例,官网帮助潜在用户了解产品、作出决策;控制台配置页则支持专业用户部署模型服务,更需要关注信息组织、填写效率与错误预防。即使是同一产品,评估重点也会随具体任务而变化。
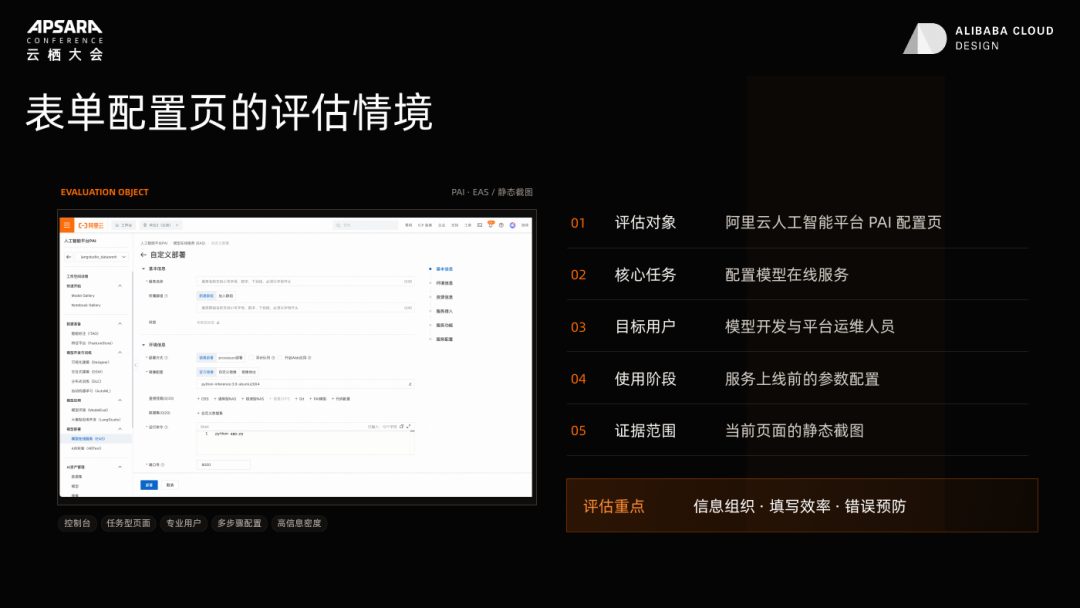
表单配置页的评估情境与重点
知识提炼:把抽象原则拆成具体检查
“信息清晰”“操作高效”提供了方向,用于实际评估时还需要进一步拆解。团队从八本设计书和 51 条已有度量准则中提炼候选规则,经专家复审,形成 AI 可执行的评估准则。
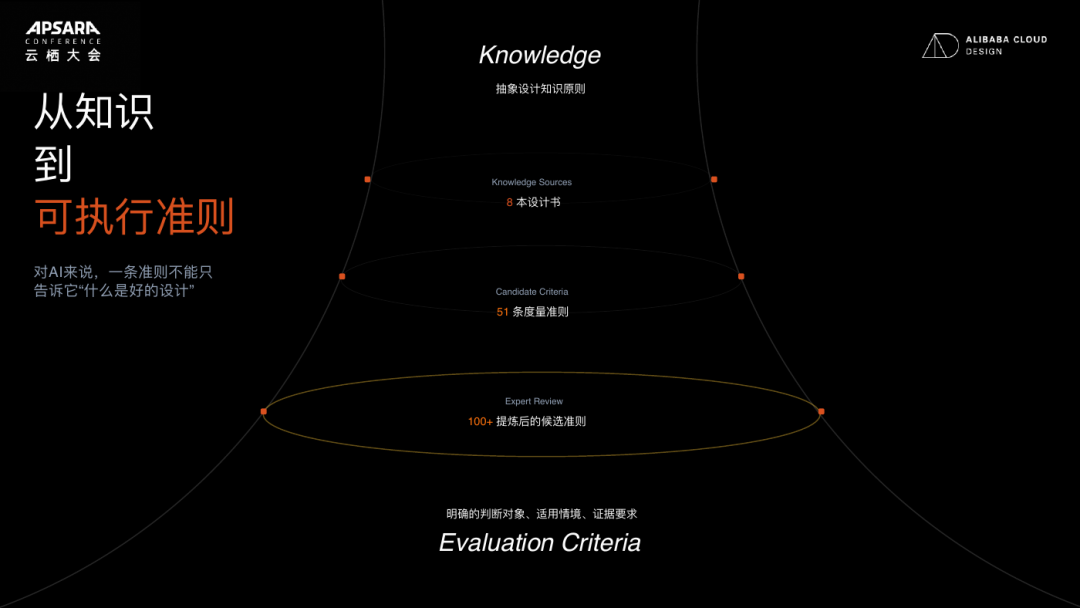
从设计知识到可执行准则
专家打标:明确何时调用、凭什么判断
有了具体准则,还需要明确它们的适用条件。
设计专家为准则补充适用对象、适用情境、证据要求和判断边界,让 AI 能根据当前任务与已有材料选择检查项。
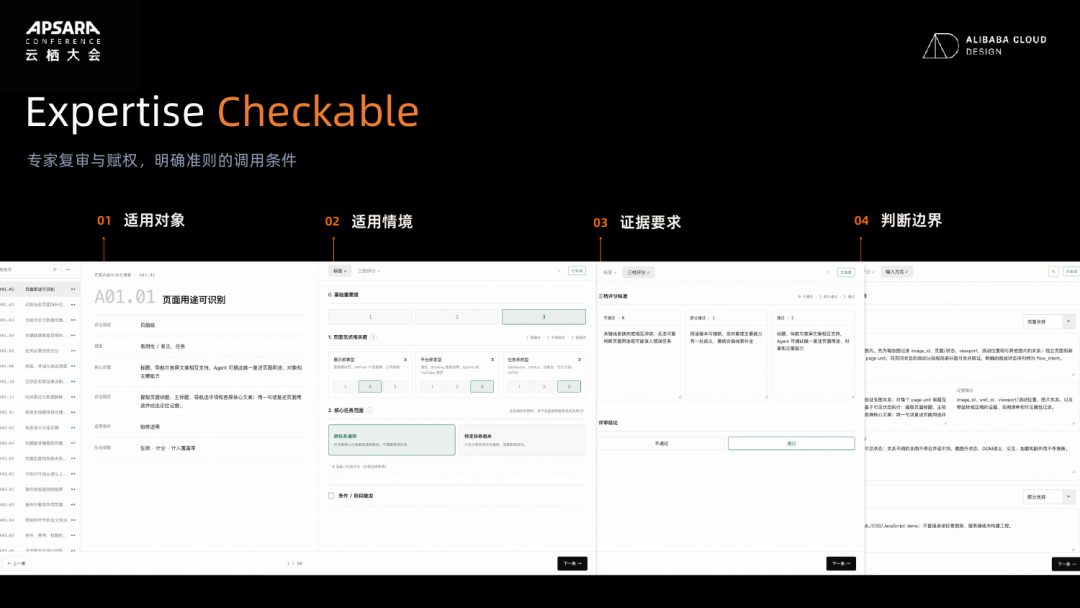
专家复审与打标
③ 工作流接入:让 Skill 进入日常评估
当评估情境、准则和执行过程逐步清晰后,下一步就是让团队能够在项目中方便地使用。
我们将这些评估准则与执行流程封装为 Skill,接入支持 Skill 的通用、编程或设计 Agent。设计师和开发者可以围绕当前页面与任务直接发起评估,让体验检查融入已有工作流。
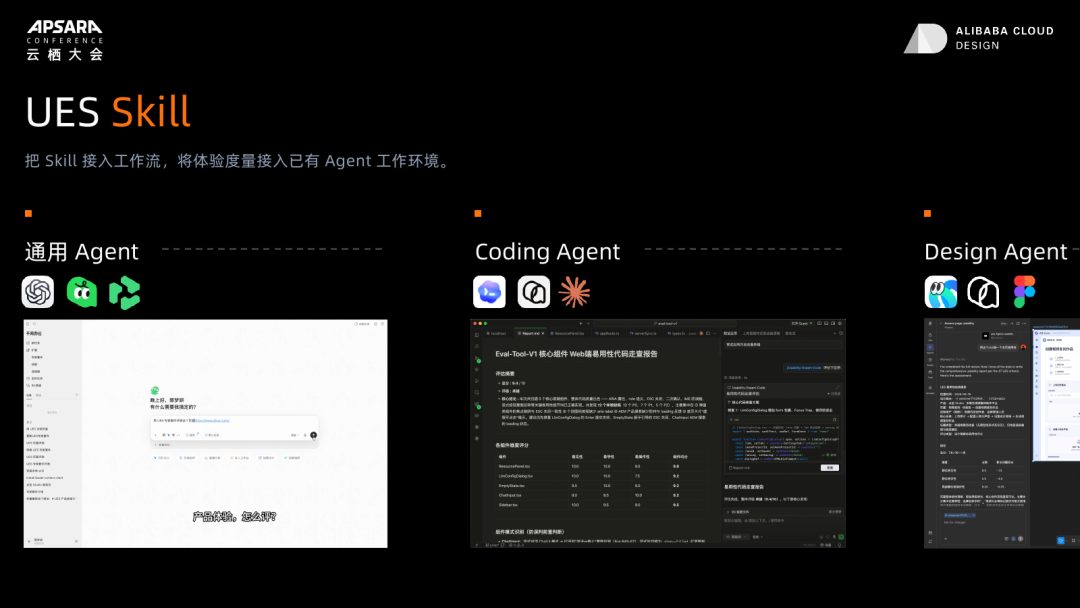
UES Skill 接入工作流
评估也可以随着产品迭代持续开展:在需求阶段,推演用户完成任务时可能遇到的风险;在设计阶段,检查信息是否易于理解、操作是否顺畅;在开发阶段,核对页面状态与异常处理;在预上线及上线后阶段,再结合实际运行证据补充验证。
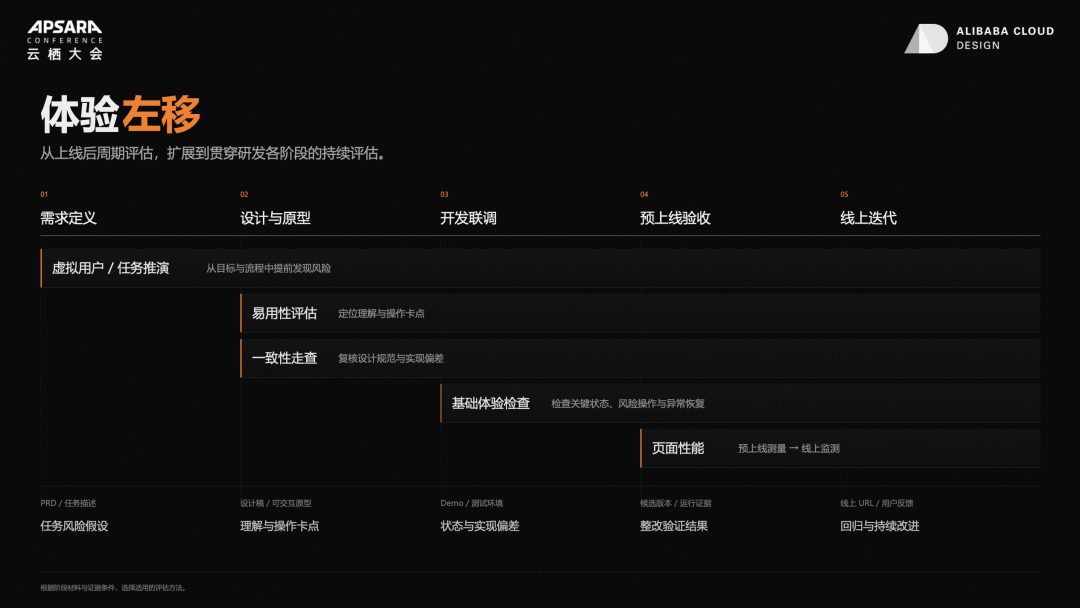
体验评估贯穿研发阶段
④ 把方法带到云栖工作坊
在 2026 年云栖大会上,讲师郭梦妍、林点雨分享了上述探索,并带领参与者围绕同一页面与任务,对比真人、通用 AI、UES 专家套件 Skill 和虚拟用户开展评估,再对比四种方式发现的问题,直观感受评估准则与角色视角如何影响结果。
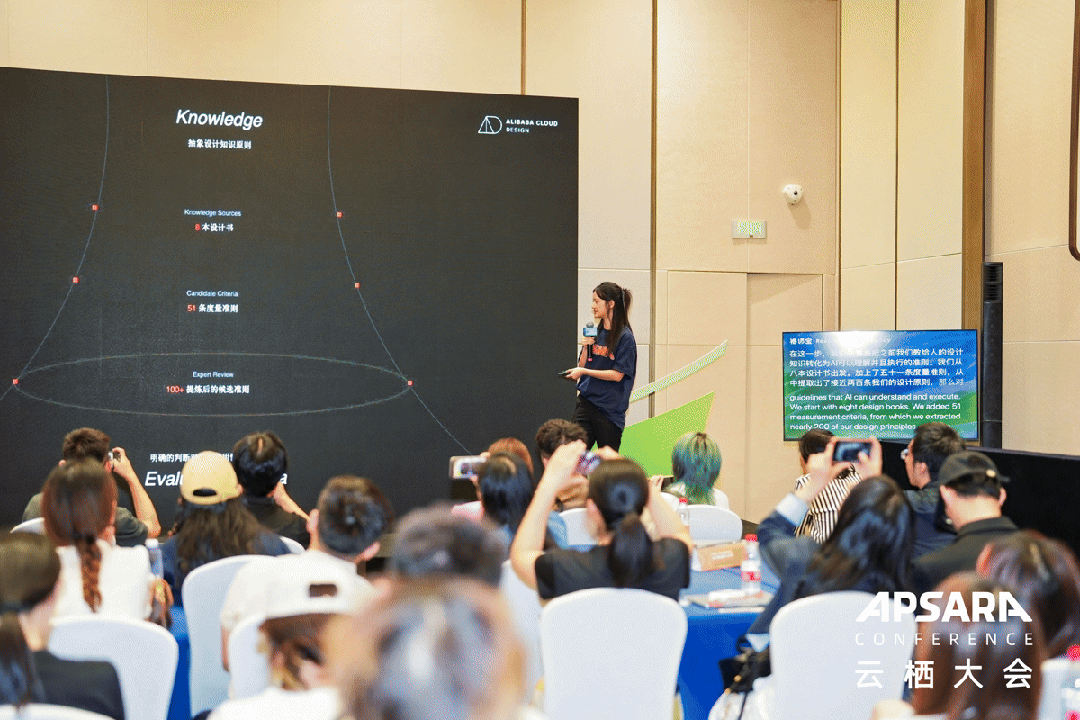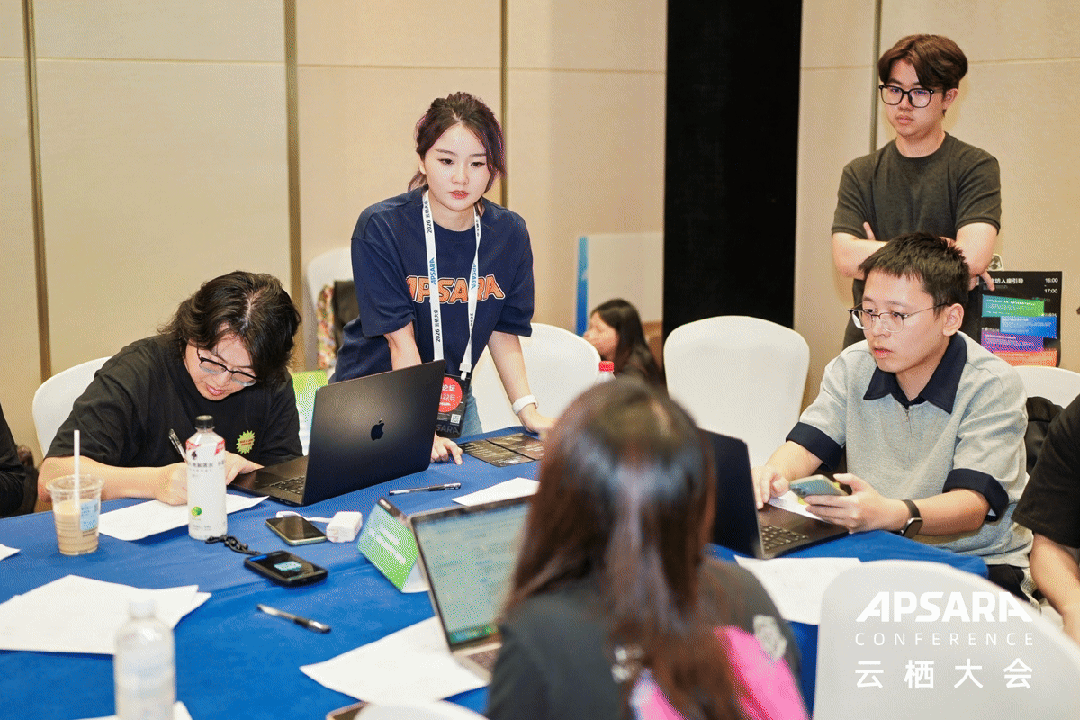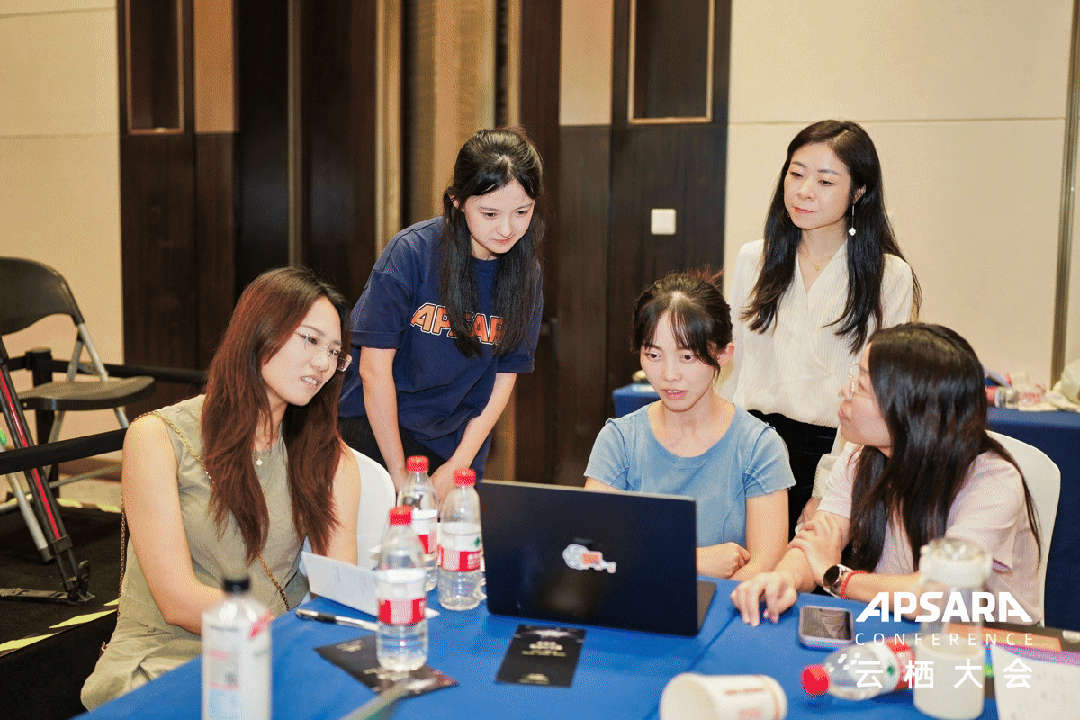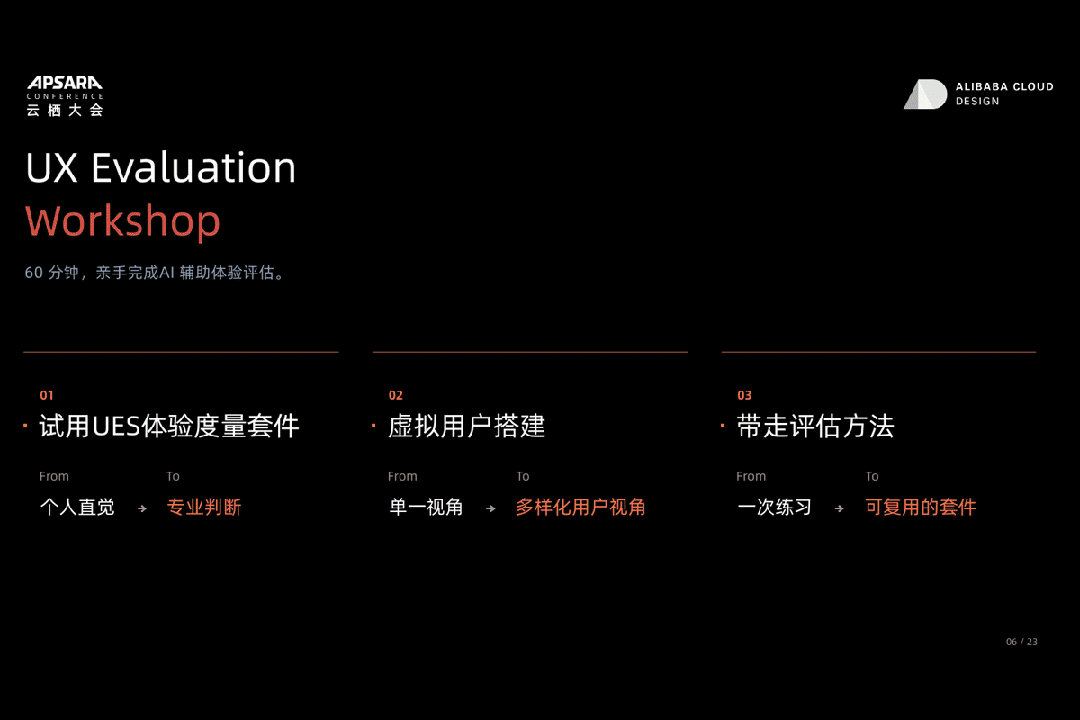
云栖大会 · 演讲、工作坊现场与实践安排
⑤ UES-Assis 套件正式上线
如今,这些评估准则与执行流程已经整理为 UES-Assis 套件,并在云栖大会上正式发布。
设计师和开发者可以将套件接入自己的 Agent,也可以在千问办公中直接使用,从当前项目的一个页面或一项任务开始,体验 AI 辅助评估的过程。
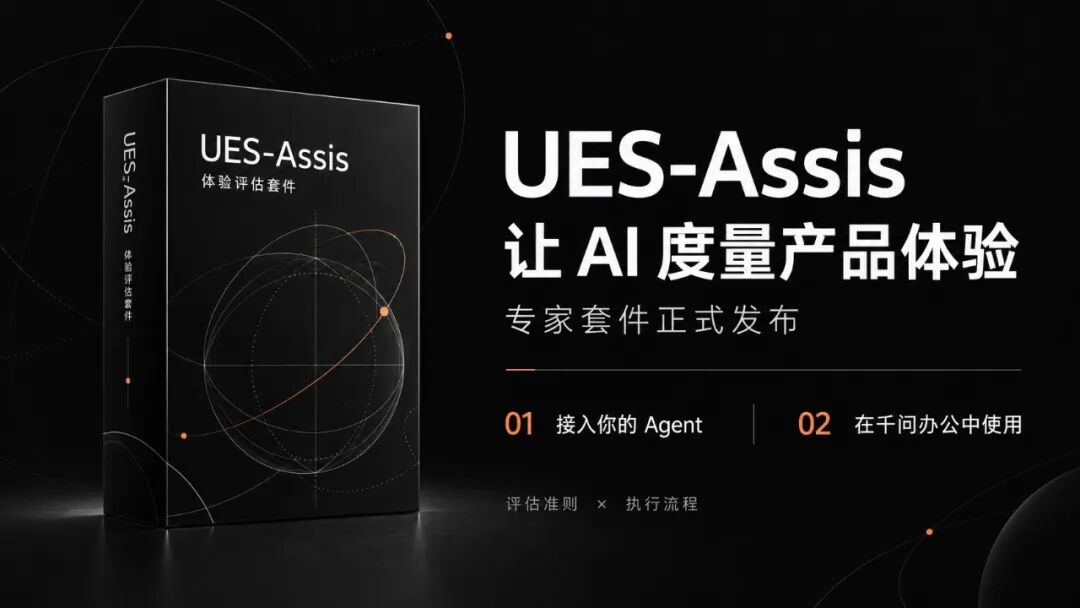
① 接入你的 Agent,在开发过程中调用评估 |GitHub · UES 专家套件
在支持 Skill 的 Agent 中安装套件,即可用网页、截图、设计稿或 Demo 发起评估。以 Codex 为例:
请安装这个 Skill:https://github.com/Alibaba-Cloud-Design/ues-evaluation-suite/tree/main/skills/ues-expert-suite
安装后新开对话,附上材料并说明任务:
请调用 $ues-expert-suite 评估这个 Demo,重点关注新用户完成首次配置的体验。② 在千问办公中,用自然语言发起体验评估
在千问办公的“扩展 → 专家套件”中搜索「UES 专项体验评测套件」,安装并启用。新建任务、附上材料后,Agent 会分析情境、用户与任务,形成评测方案,经你确认后开始走查。
/ues-expert-suite 帮我评估这个产品的注册流程,面向第一次使用的新用户。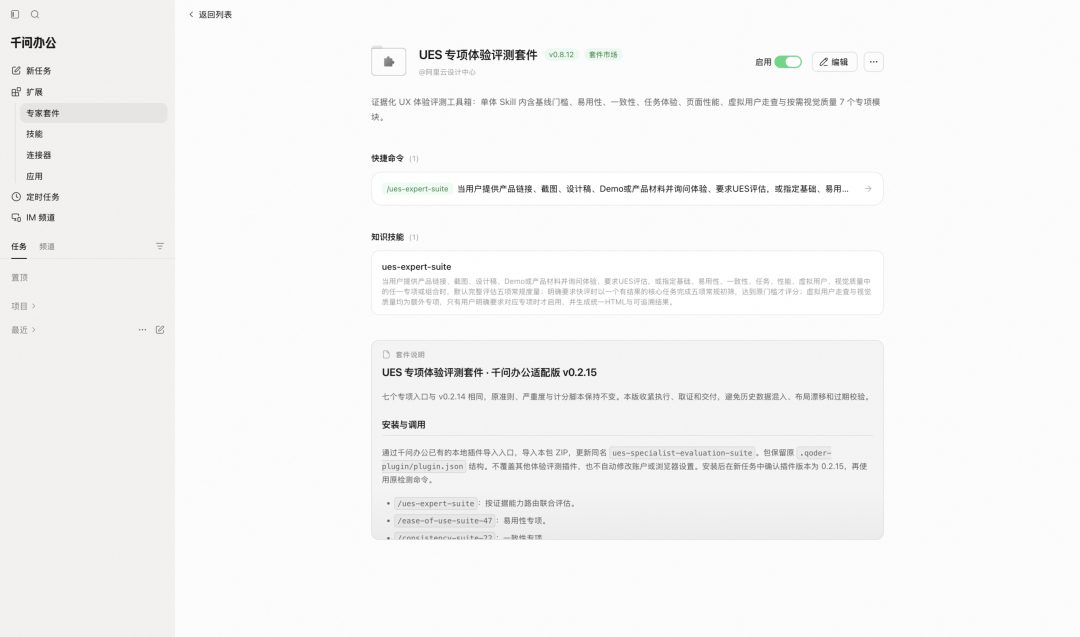
千问办公 · UES 专项体验评测套件
按需指定评估重点
除了完整评估,也可以只检查某个维度,或补充虚拟用户视角。例如:
易用性:“/ues-expert-suite 评估这个配置页面的易用性。”
一致性:“/ues-expert-suite 只检查这几个页面的一致性。”
虚拟用户:“/ues-expert-suite 用虚拟用户走查这个 Demo,分别模拟首次使用的开发者和有经验的运维人员,完成首次配置任务,比较各自的卡点。”
欢迎在公众号评论区分享使用场景、试用发现和改进建议,也欢迎通过邮箱 guomengyan.gmy@alibaba-inc.com 联系我们,一起探索 AI 体验度量的更多可能。
相关链接
CHI 2026 · AI 专家与真人专家对比:https://dl.acm.org/doi/10.1145/3772363.3798495
HCII 2026 · 任务与角色适配:https://link.springer.com/chapter/10.1007/978-3-032-30552-7_34
HCII 2026 · 自适应体验度量:https://link.springer.com/chapter/10.1007/978-3-032-30552-7_42
GitHub · UES 专家套件:https://github.com/Alibaba-Cloud-Design/ues-evaluation-suite
本文转载自微信公众号「阿里云设计中心」,查看原文。版权归原作者所有,如有侵权请联系删除。