SDC2026议题回顾 | Storm: AI审计时代下,Fuzzing还有用吗?
SDC2026 2026-10-30 17:59 上海
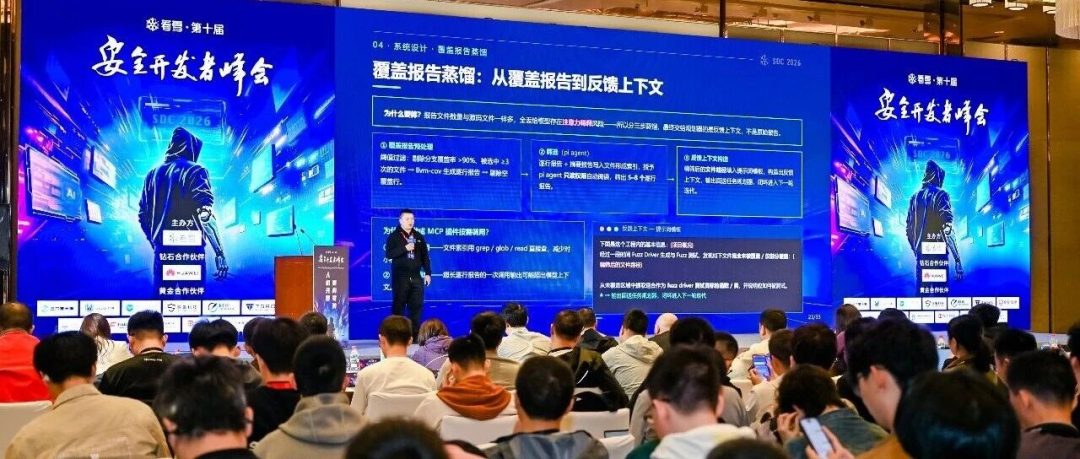
以覆盖反馈驱动模糊测试迭代,探索 AI 审计盲区。
SDC2026
议题回顾
随着 AI 代码审计能力不断提升,漏洞挖掘正在发生变化。但仅靠阅读源码和推理,真的能够发现所有漏洞吗?对于运行时才会出现的异常状态,以及尚未覆盖的代码路径,传统审计方式仍面临挑战。
在第十届安全开发者峰会上,奇安信星图实验室安全研究员——张兴,结合 LibRaw、OpenCV 等典型漏洞案例,分析 AI 审计难以发现的问题,并介绍基于 Fuzz Driver 的智能模糊测试框架 Storm,展示如何通过覆盖率反馈持续调整测试目标,实现自动化、迭代式的漏洞挖掘。
张兴
奇安信星图实验室安全研究员
*以下为整理后的速记
AI 会挖洞了,Fuzzing 还有用吗?
近年来,AI 漏洞挖掘相关的新闻不断出现,标题也越来越吸引眼球,仿佛漏洞挖掘已经被 AI 彻底解决。在一线团队中,Agent 已经能够自主阅读源码、调用 GDB 等动态调试工具验证猜想,并尝试生成 PoC,整个过程可以高度自动化,也确实取得了不少高价值成果。
因此,一个直接的问题摆在模糊测试团队面前:既然 Agent 已经能够审计代码、动态调试并确认漏洞,Fuzzing 还有什么用?
如果只站在攻击者的角度,判断标准似乎很简单:无论采用什么方法,只要能够挖到漏洞就够了。Fuzzing 往往需要较长时间运行,能否发现漏洞也存在不确定性,看起来似乎不如 AI Agent 直接。但对于开发者和防御方来说,问题并不止于“找到了几个漏洞”。他们还需要知道:目标代码究竟被测试到了什么程度?哪些地方仍然没有被测试?
AI 审计可以给出发现的问题,却未必能提供客观、可度量的测试证据。Fuzzing 则能够借助工具链生成覆盖率报告,说明哪些代码已经执行、哪些路径仍未覆盖。因此,从防御方的视角看,Fuzzing 不仅仍然有用,而且是建立可度量安全信心的重要手段。
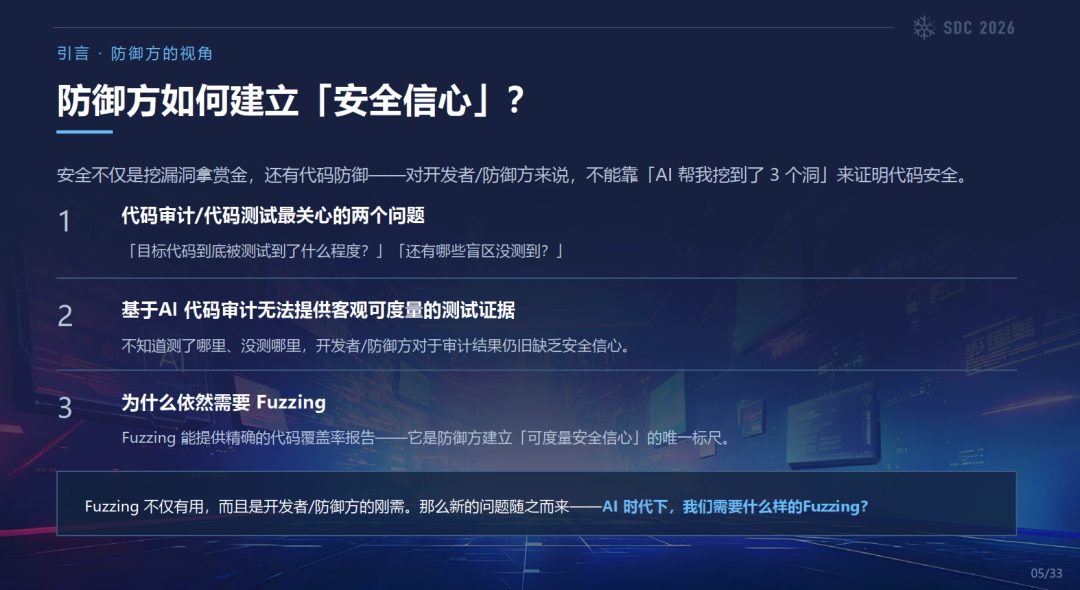
图 1|演讲提出的核心问题
AI 审计与 Fuzzing:两种不同的工作方式
演讲中,张兴将当前多数 AI 漏洞挖掘工具的工作方式概括为基于语义的静态分析:大语言模型阅读源码、理解语义、推理业务逻辑,并按需调用编译器、检索工具或调试器,尝试构造 PoC。Agent 的工具调用能力能够帮助验证猜想、降低误报,但在最初的代码分析阶段,目标程序可能并没有真正运行起来。
这种方式仍然面临两个问题。第一,静态分析缺少运行时信息,例如实际内存布局、并发时序和外部环境状态;有些危险状态很难仅凭阅读代码准确推导,因此可能漏报。第二,复杂业务逻辑和长依赖链的推理能力受模型能力影响,若依赖昂贵的头部模型,漏洞挖掘成本也会随之升高。
两种方法的起点不同:AI 审计先阅读代码、寻找可疑问题,再通过动态执行确认;Fuzzing 则先让代码运行起来,再观察运行过程是否出现异常。前者擅长理解语义和业务逻辑,后者能够探索运行时状态、发现内存安全等问题。它们各有优势,不能简单地相互替代。
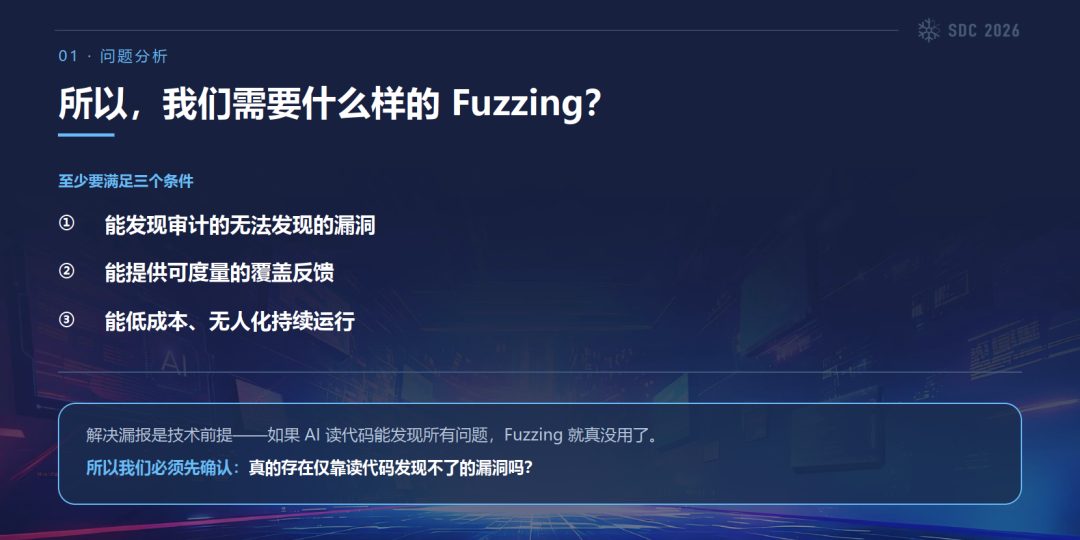
图 2|AI 审计与 Fuzzing 的工作方式和能力侧重点
两个案例:仅靠读代码不容易发现的漏洞
案例一:LibRaw 堆缓冲区溢出
LibRaw 是常用的 RAW 图像解码库。Storm 在测试其 VNG 去马赛克算法时,发现了一个堆缓冲区溢出问题。入口函数 open_bayer() 会检查图像宽高,但只拒绝小于 3 的宽度,宽度恰好为 3 的图像仍会通过校验。
后续进入 vng_interpolate() 后,代码在 memcpy() 中使用了与图像宽度相关的长度计算,其中包含 width - 4。当 width 为 3 时,该计算出现整数下溢,进而导致异常的大长度并触发堆缓冲区溢出。演讲中提到,构造一张宽度为 3 像素的特定格式图片即可触发问题。该漏洞已上报并由厂商修复。
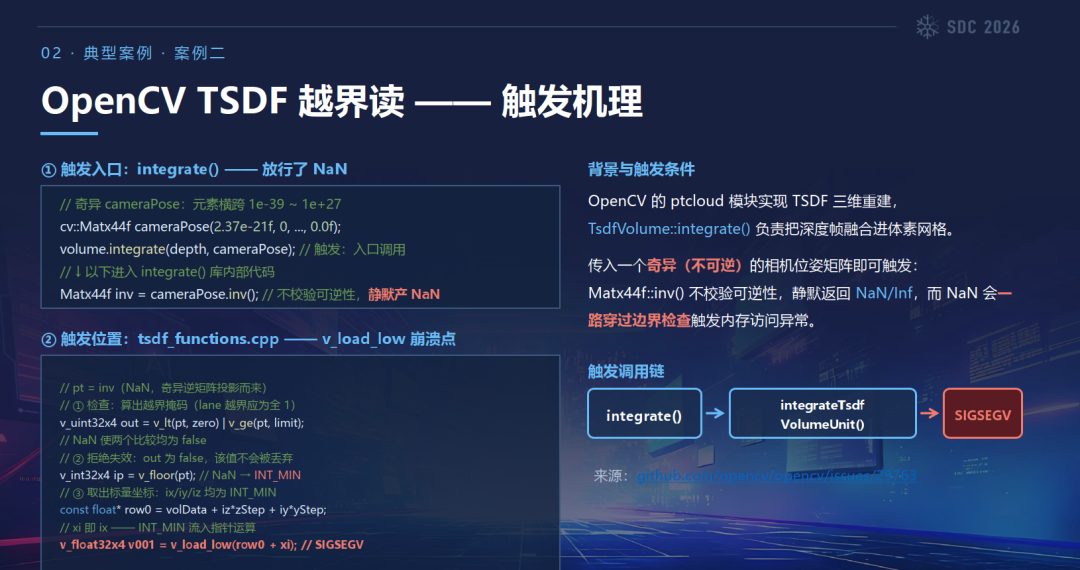
图 3|LibRaw 案例
案例二:OpenCV TSDF 越界读
第二个案例来自 OpenCV 的 ptcloud 模块。相关 TSDF 三维重建流程会接收相机位姿矩阵,并在内部求逆。若输入的是奇异矩阵,求逆运算可能产生 NaN 或 Inf;后续边界检查未能正确拦截 NaN,使其继续流入取整和索引计算。
演讲展示的触发链路中,NaN 经取整后变为 INT_MIN,随后作为坐标参与指针运算,最终在内存访问时触发异常。这个危险状态来自运行时矩阵与浮点数计算的组合,单纯阅读代码很难完整推演。该问题同样已上报官方并得到修复。
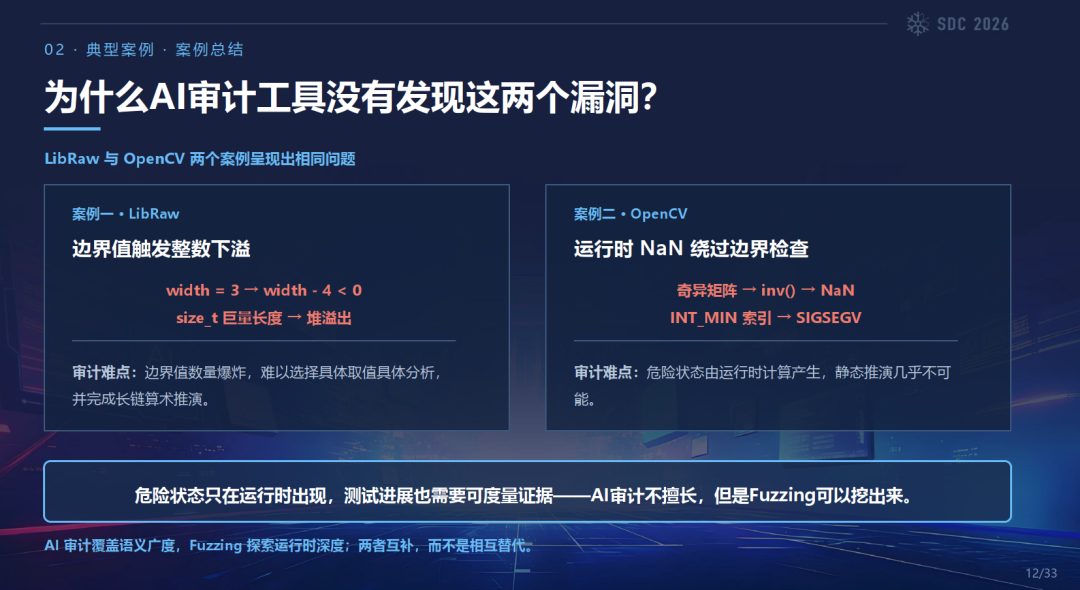
图 4|OpenCV 案例
案例小结:危险状态需要在运行时被探索
两个案例的共同点是:漏洞触发都依赖特定输入和运行时状态。LibRaw 案例涉及边界值与长链算术推演;OpenCV 案例则涉及矩阵求逆、浮点数行为和边界检查。演讲者表示,相关 AI 审计工具虽然分析到了部分函数,却没有得出漏洞结论。对于这类需要精确状态推演才能触发的问题,让程序实际运行并持续探索输入,更容易发现问题。
因此,AI 审计覆盖语义广度,Fuzzing 探索运行时深度,两者更适合互补。基于这一判断,演讲提出,AI 时代的 Fuzzing 至少要满足三个条件:能够发现 AI 审计未发现的漏洞;能够提供可度量的覆盖反馈;能够以较低成本自动化、持续运行。
Fuzz Driver 与覆盖反馈
Fuzz Driver(也常称为 harness)可以理解为一段最小化的目标调用代码:读取外部字节流、构造目标函数需要的数据结构,再调用目标函数。通过把完整程序拆分为多个可单独测试的功能入口,Fuzzing 可以围绕不同子功能开展探索。
测试结束后,可以借助 LLVM 工具链生成覆盖报告。摘要报告展示文件级的行覆盖率、分支覆盖率等指标,用于回答整体测试了多少;逐行报告则会标注每行代码的执行次数,未执行的代码能够被直接识别。覆盖报告不仅用于评估测试结果,也可以帮助确定下一步应该测试哪里。
图 5|覆盖报告的价值:既能查看整体覆盖情况,也能定位尚未执行的代码。
Storm:让覆盖报告反向指导下一轮测试
过去,Fuzz Driver 自动生成的研究主要关注如何生成质量更好的 Driver。以 Google 的 OSS-Fuzz 为例,它长期对主流开源项目开展持续测试,但 Driver 主要依赖人工编写和维护;OSS-Fuzz-Gen 则进一步尝试用大语言模型自动生成 Driver,并接入测试流程。演讲还提到,相关学术研究的重点也长期集中在 Driver 生成质量上。
但生成 Driver、执行测试并输出覆盖报告之后,流程往往就结束了,覆盖报告没有反过来指导下一轮目标选择。演讲引用 GitHub Security Lab 于 2025 年 12 月发布的观察:一些被持续 Fuzzing 多年的项目,仍会在此前未覆盖的代码中不断发现漏洞。这意味着,测试流程需要根据覆盖反馈继续选择目标,而不是停留在一次性的开环流程。
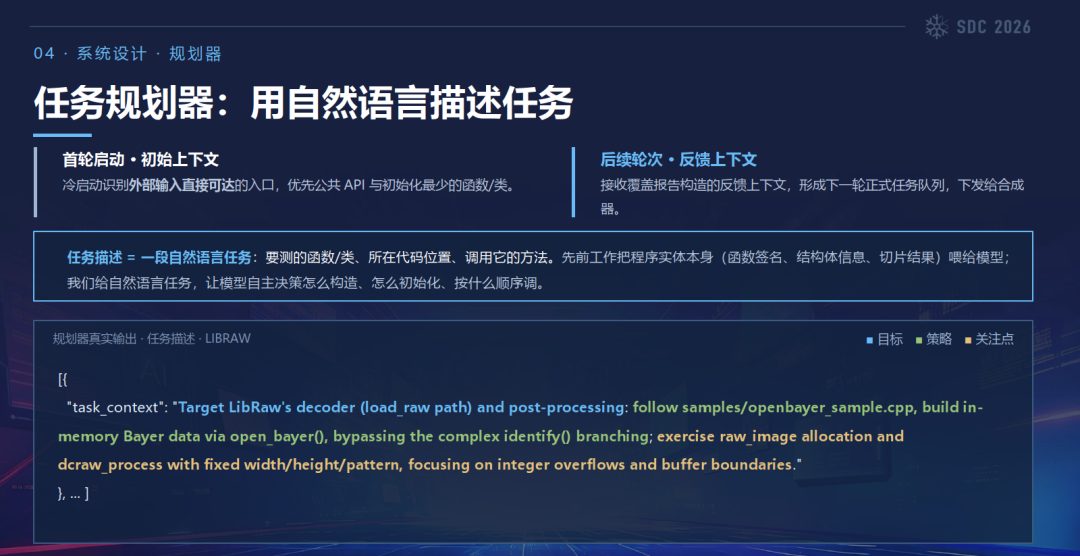
图 6|Storm 的核心思路:将覆盖报告反馈给任务规划器,形成持续迭代的闭环
Storm 的闭环架构
Storm 由四个主要模块组成:任务规划器、Fuzz Driver 合成器、模糊测试执行模块和覆盖报告筛选模块。四个模块持续循环工作,将覆盖报告转化为下一轮任务的反馈上下文。
1. 任务规划器:用自然语言描述测试目标
首次启动时,规划器从初始化上下文中识别外部输入可达的入口,优先考虑公共 API、初始化成本较低的函数或类,并生成第一批任务。后续轮次则根据覆盖反馈构造新的任务队列。任务并非只包含函数签名,而是通过自然语言描述测试对象、代码位置、调用方式和测试关注点,让生成器能够理解应当如何初始化和调用目标。
2. Fuzz Driver 合成:生成、验证、修复
生成器根据任务描述编写 Driver,并进行两个阶段的验证。第一阶段是编译检查:若编译失败,会根据报错区分编译选项或依赖配置问题与 Driver 代码问题,再进行修复。第二阶段是短时运行验证:使用 AFL++ LTO 模式运行约 3 分钟;如果 Driver 一启动就报错,或 edge 数量没有增加,就认为 Driver 可能存在缺陷,需要重新生成或修复。
3. 模糊测试执行:收集种子、覆盖报告和 Crash
通过验证的 Driver 进入正式 Fuzzing。Storm 使用 AFL++ LTO 模式进行探索;当覆盖边数量连续两个小时不再增长时,停止当前测试,以避免继续消耗算力。执行过程会收集能够触发新路径的种子,以及可能出现的 Crash。Crash 会交给结合 GDB 的 Agent 分析,以生成崩溃成因报告。随后,系统使用 LLVM 工具链重新编译 Driver,并重放 AFL++ 收集的种子,采集逐行覆盖数据。
4. 覆盖报告蒸馏:将报告转成下一轮反馈
原始覆盖报告可能非常长,如果全部交给模型,容易稀释注意力,甚至超过上下文长度。Storm 先对报告做预处理,例如过滤分支覆盖率较高或已多次被选中的文件,去除空覆盖行;再由 Agent 阅读摘要和逐行报告,筛选出约 5—8 个值得继续关注的文件。系统最终将这些文件路径与项目概况组织成反馈上下文,送回任务规划器,开启下一轮迭代。
这一设计也考虑了小模型的能力边界。Storm 将复杂的探索执行交给 Fuzzer,将代码理解、合成和错误修复等单一任务交给本地小模型,并通过固定程序逻辑维护全局状态、记忆和模块串联。演讲者将这一原则概括为:“One LLM Session, One Simple Task!”
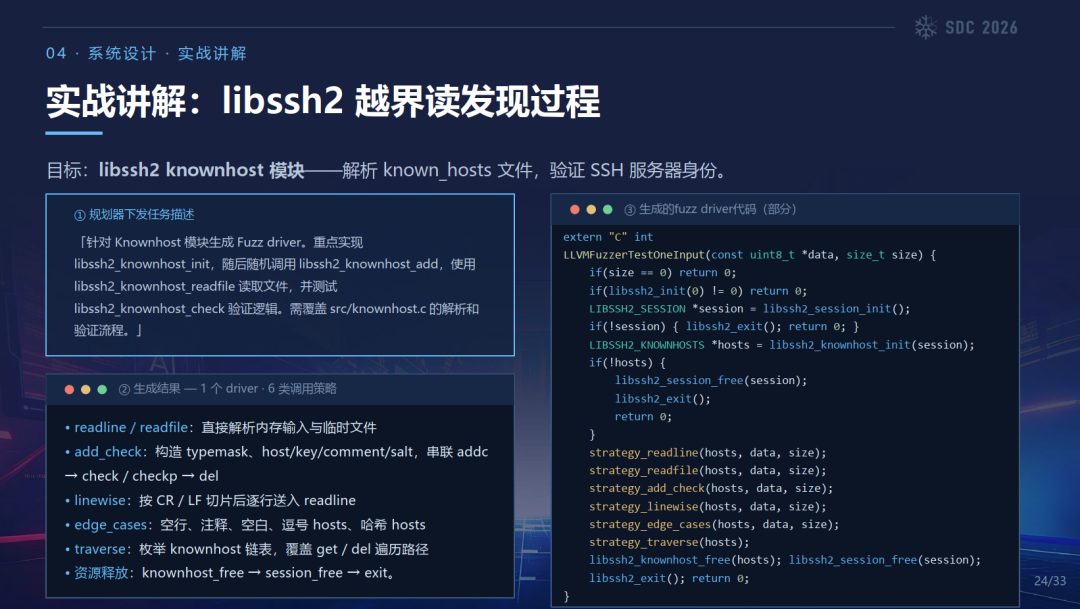
图 7|覆盖报告蒸馏流程:筛选重点文件,再构造反馈上下文
实战案例:libssh2 越界读的发现过程
演讲进一步以 libssh2 的 knownhost 模块说明 Storm 如何完成一次实际测试。该模块负责解析 known_hosts 文件并验证 SSH 服务器身份。规划器给出的任务要求覆盖 knownhost 的解析与验证流程;最终生成的一个 Driver 包含多类调用策略,例如通过 readline/readfile 解析输入、组合 add 与 check 操作、按 CR/LF 切分输入逐行处理、测试空行和注释等边界情况,以及遍历 knownhost 链表。
测试过程中,strategy_linewise 触发了 Crash。对照旧版 src/knownhost.c 后发现,在 libssh2_knownhost_readline() 的相关逻辑中,循环结束后 len 可能已经为 0,指针 cp 也已到达缓冲区末尾之后,但代码仍执行 *cp 来判断是否为换行符,造成 1 字节越界读。演讲展示的修复思路是增加 len 检查,或确认 cp 仍位于原始缓冲区范围内。演讲时该 off-by-one 问题已由官方合并 PR #2335 修复。
实验结果:覆盖能力与漏洞发现
1. 分支覆盖率对比
实验选取了 25 个主流 C/C++ 开源库,版本截止到 2026 年 7 月 1 日;统一采用 LLVM branch coverage 统计,测试后端均使用 AFL++ LTO 模式,每个生成的 Driver 最长运行 24 小时。对比对象包括 OSS-Fuzz-Gen、PromeFuzz(CCS’25)和 SynapseFlow(CCS’26)。
演讲给出的结果是:Storm 在 25 个目标项目上均取得最高的分支覆盖结果。整体对比中,Storm 的结果分别约为 OSS-Fuzz-Gen 的 2.7 倍、PromeFuzz 的 2.1 倍、SynapseFlow 的 1.8 倍。SynapseFlow 仅支持 C,因此在 C++ 目标上没有对应数据。
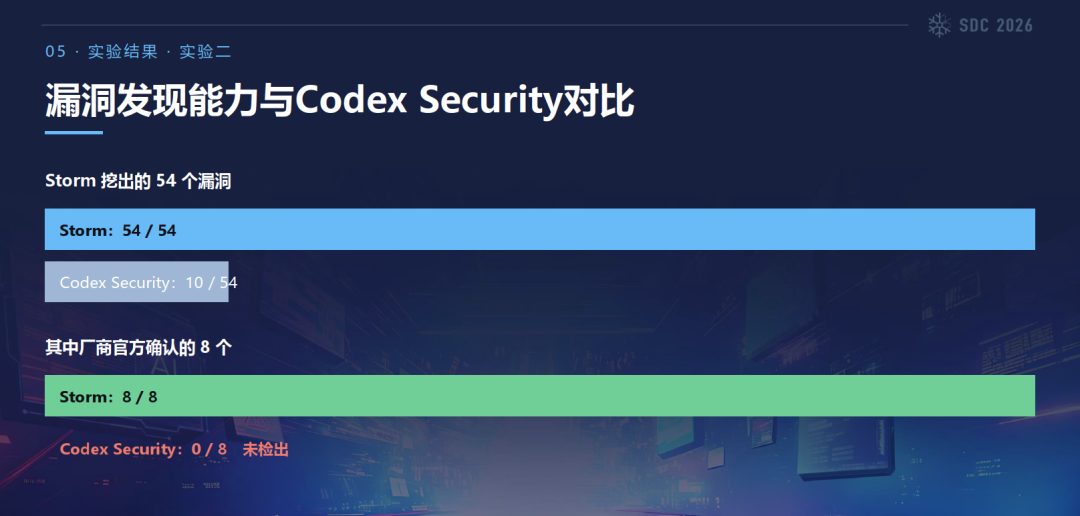
图 8|25 个开源库的分支覆盖实验结果
2. 漏洞发现结果
在漏洞发现实验中,Storm 共发现 54 个漏洞,全部经过人工复核确认并上报。与 Codex Security 对比,Storm 检出了这 54 个漏洞中的全部,而 Codex Security 检出 10 个。在其中 8 个已获厂商官方确认的漏洞中,Storm 检出 8 个,Codex Security 未检出。
按演讲中的统计,54 个漏洞分布在 15 个项目中,其中越界读 14 个、整数溢出或下溢 9 个、空指针解引用 8 个、越界写 6 个、除零 6 个、释放后使用 5 个,其他类型 6 个。内存破坏类漏洞合计 25 个,占近半。libssh2 与 OpenCV 各发现 8 个漏洞,且这两个项目都已接入 OSS-Fuzz 并持续测试了三到五年。
演讲列出的 8 个已获厂商确认并修复的漏洞涉及 LibRaw、OpenCV、OpenSSL、Exiv2 和 libarchive,包括堆缓冲区溢出、越界读、除零错误、拒绝服务和空指针解引用等类型。另有 libssh2 的 off-by-one 越界读在上报前已由官方合并修复。
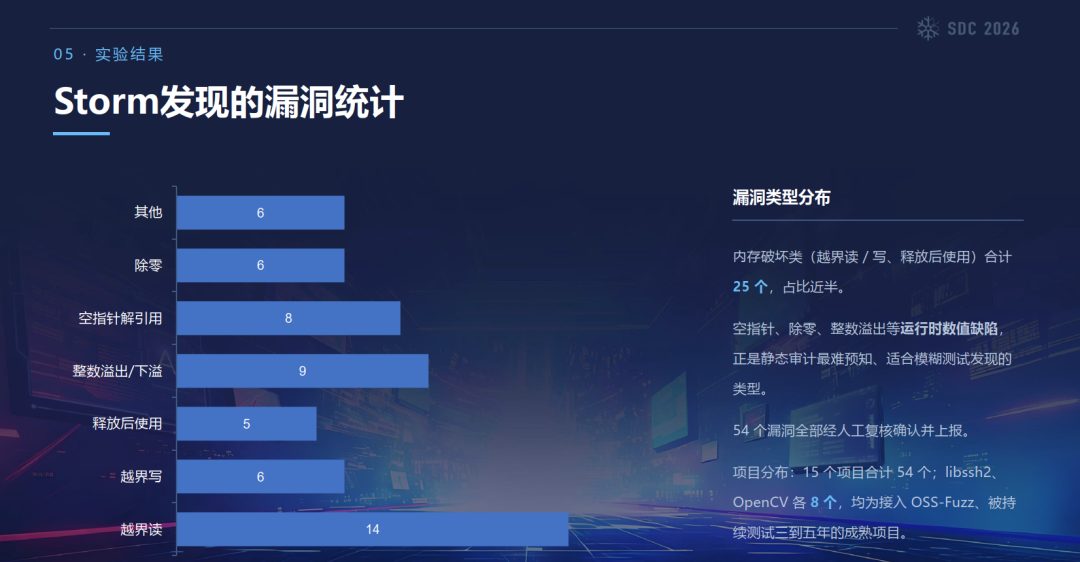
图 9|Storm 发现的漏洞类型分布与数量
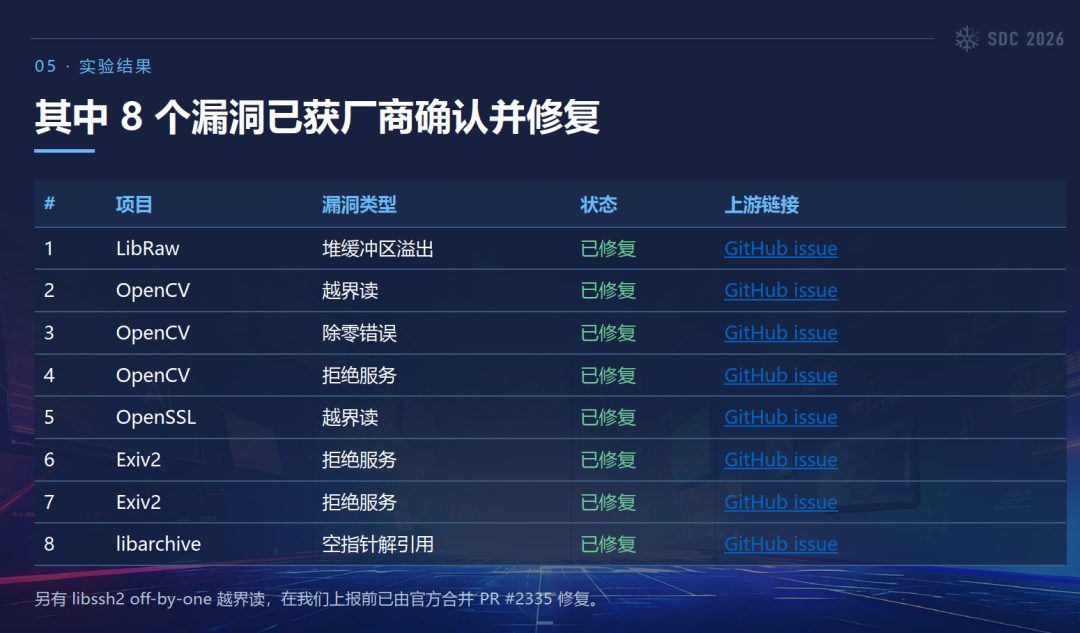
图 10|已获厂商确认并修复的 8 个漏洞
局限与展望
目前 Storm 最大的局限在于编译环境准备仍需要人工介入。测试流程中的规划、Driver 生成、执行和反馈已经自动化,但部分项目需要特殊的构建环境、第三方依赖、编译参数或系统权限。环境搭建环节因此仍采用半自动方式,需要用户操作和确认。
未来工作主要包括三个方向:一是从 C/C++ 扩展到 Java、Python、JavaScript、TypeScript、PHP、Rust、Go 等语言;演讲中提到,团队内部已经实现了对 Java 和 Python 的支持。二是将 Storm 的核心能力封装为标准化 Skill,接入现有 AI 审计工具,利用审计结果指导 Driver 生成方向,再通过覆盖反馈修正关注点。三是继续推动测试流程自动化,逐步减少编译准备环节的人工操作。
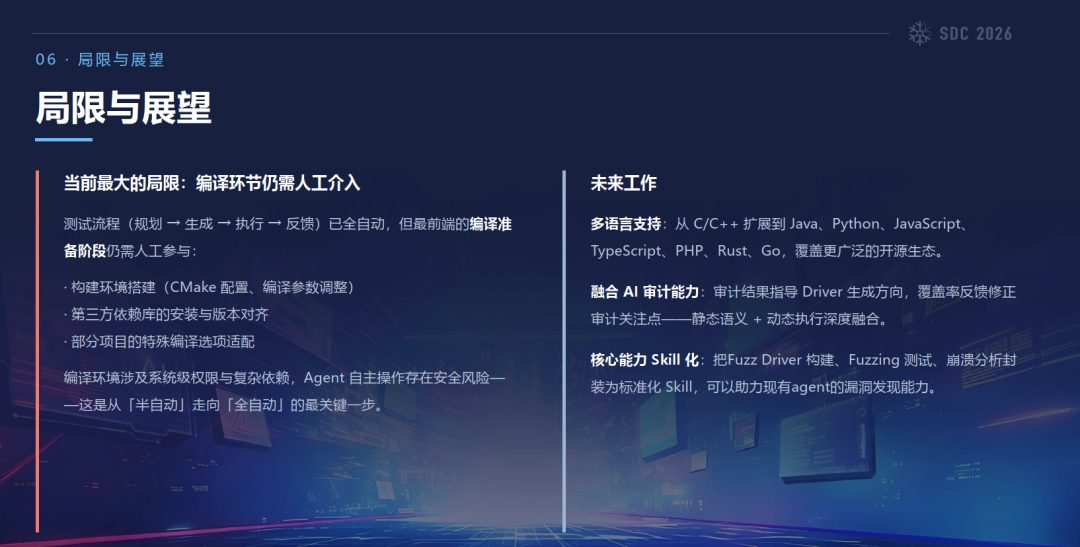
图 11|Storm 当前的局限与后续发展方向
AI 时代的 Fuzzing 仍有用武之地,但也必须进化。它需要结合 AI 的语义理解、代码合成和工具调用能力,将这些能力嵌入动态执行与覆盖反馈闭环中。AI 审计负责拓展语义探索的广度,Fuzzing 则通过持续运行探索更多运行时状态。让不同模块各司其职,才能形成更完整的漏洞发现流程。
往期议题回顾
峰会议题PPT及回放视频已上传至看雪课程-【看雪2026 SDC】:
https://www.kanxue.com/book-section_list-107.htm
【已购票的参会人员可免费获取】:我方已通过手机短信发送“兑换码”
免费获取方式:
1. 登录看雪账号,进入上述课程页面。
2. 点击“立即购买”
3. 输入大会于 2026年10月27日 通过手机短信发送的兑换码。
4. 提交订单后,即可免费开通课程查看权限,获取大会演讲PPT及视频。
*温馨提示:使用兑换码无需支付任何费用。
球分享
球点赞
球在看
本文转载自微信公众号「看雪学院」,查看原文。版权归原作者所有,如有侵权请联系删除。