弗吉尼亚理工大学 | 从“能力”到“性能”:LLM 渗透测试智能体的功能属性评测
原创 全诗轩 2026-10-30 18:30 四川
角色取决于任务,而不是取决于架构。低风险、结构化的任务可以自主;高风险、实时性强的任务必须退回人机协同
原文标题:From Capabilities to Performance: Evaluating Key Functional Properties of LLM Architectures in Penetration Testing
原文作者:Lanxiao Huang, Daksh Dave, Tyler Cody, Peter Beling, Ming Jin
原文链接:https://aclanthology.org/2025.emnlp-main.802/
发表会议:EMNLP 2025(pp. 15879–15905)
笔记作者:全诗轩@安全学术圈
主编:黄诚@安全学术圈
1. 背景介绍
渗透测试通常结合我们人类的专业知识、规则与框架(NIST SP800-115、MITRE ATT&CK等)进行实践。虽然机器学习和强化学习已经为渗透测试实现部分自动化,比如通过漏洞检测或利用漏洞进行预测,但是它们过于依赖标注数据集、刚性特征以及被明确定义的奖励机制的特点,限制了它们对于新威胁的适应性。
LLM 带来的是另一种可能:它能推理攻击路径、生成 payload、根据网络反馈临场调整,于是“自主侦察”“自适应利用”这些以前靠人的环节开始被自动化。但是灵活性也同样带来了 NLP 领域的问题:
命令里一个参数写错,整条攻击链就会断;
Nmap、Metasploit 这类工具需要精确语法,幻觉出一个 flag 就是致命的;
多步任务需要跨阶段的远程记忆和推理能力,而上下文窗口会漂移、遗忘。
本篇文章受这些考虑启发,于是围绕以下四个研究问题(RQs)构建研究:
RQ1(概念性):LLMs如何在功能上融入网络安全工作流?
RQ2(经验性):LLMs在渗透测试中的经验性能如何?
RQ3(分析性):基于LLM的PT智能体的主要失败模式是什么?
RQ4(架构性):有针对性的增强如何使模块化LLM智能体具备关键功能能力?
2. 网络安全中LLMs的功能分类(RQ1)
论文先把现有工作按“人和模型谁说了算”归成三类:
LLMs作为自主攻击者:独立的智能体,能在极少人工监督下发现漏洞、构造利用、提权。它可以是效率工具,但如果被恶意行为者滥用,就会成为被滥用的风险源。
LLMs作为增强助手:给人推荐命令、优化流程、辅助场景规划,但是关键决策仍留给安全专家。
LLMs作为混合模型:把多个 LLM(或 AI )组件拼成模块化框架,按功能角色拆成推理、解析、生成、修复等子代理,试图同时拿到“通用模型的适应性”和“结构化子代理的可靠性”。
3. LLMs在渗透测试中的实证性能(RQ2)
3.1基准测试环境
实验环境取自 HackTheBox、Metasploitable 与 VulnHub 的 14 台靶机,每台拆出 8~22 个子任务,覆盖侦察、凭据攻击、漏洞利用、后渗透、MITM、Web 利用、AD 攻击,并映射到 MITRE ATT&CK 的七类战术。
被测对象六个:单体智能体 GPT-4、Claude 3.5 Sonnet、Gemini 2.0 Flash;模块化智能体 PentestGPT、AutoAttacker 与 PenHeal
3.2评估指标
因为渗透测试是一个复杂的过程,光看最后有没有打进去是不够的。所以,作者设计了三个互补的指标,从不同维度来评估AI的表现。
子任务完成率(SCR):SCR= 总任务数/成功完成的任务数,例:一个任务有 4 步(侦察、破解、漏洞利用、提权),Agent 成功完成了前 3 步,SCR 就是 75%
错误率 (FR):FR= 总尝试次数/失败的尝试次数
易用性和用户交互指标:用来评估agent好不好用,需不需要频繁的人为干预为其兜底
3.3 任务完成性能
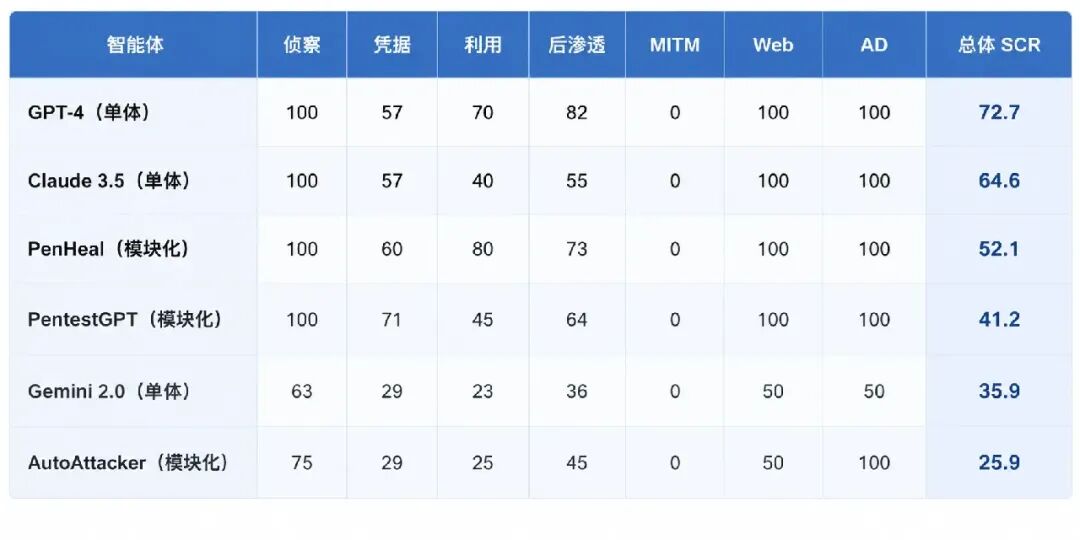
如表所示,LLM智能体在完成渗透测试任务的能力上差异很大。虽然单智能体模型(如GPT-4、Claude)在结构化、规则驱动的阶段表现良好,但模块化系统表现出更多方差,在某些子任务上较强,但受协调和记忆缺口阻碍。其中,PENHEAL在简单和复杂阶段都表现出色。
MITM局限性: 所有模型在实时中间人(MITM)攻击上均失败,凸显了实时动态响应能力的核心局限。尽管能够生成静态命令,智能体无法解释或响应瞬态网络条件。这种一致失败凸显了当前LLM系统的重要差距:缺乏运行时插桩和事件驱动适应。
复杂多步任务: 在多步工作流(如后渗透和Active Directory枚举)中性能急剧下降,尤其是Gemini和AUTOATTACKER。这些失败源于脆弱的规划和跨子任务有限的上下文重用。相比之下,PENHEAL、GPT-4和PENTESTGPT保持了更高的完成率,可能由于对战略规划与错误恢复以及跨阶段上下文支架的更强支持。
4. 失败模式与错误分析(RQ3)
作者把错误归成三类:
FM1:幻觉与语法错误:智能体总是生成拼写错误、参数写错,或者纯靠幻觉的命令
FM2:冗余循环与上下文丢失:环行为和任务重复在具有碎片化记忆或缺少模块间状态传播的系统中最为明显,智能体经常重新发出已完成的命令或重新尝试子任务,而不了解先前的结果
FM3:对复杂或实时任务适应不足 :网络环境是动态的,像MITM,需要毫秒级的反应,但大模型的推理需要相对较长的时间
这些失败凸显了当前LLM在需要与动态网络环境进行高保真实时交互的任务中的根本局限性。这些局限性源于三个核心问题:(i) 依赖网络状态的文本抽象,(ii) 缺乏直接的低层环境代理能力,(iii) 并行处理和亚秒级响应方面的挑战。
5. 实现核心能力:基于架构与干预的分析(RQ4)
论文据此提炼出五项关键功能属性,并各配一个针对性增强:
GCM(全局上下文记忆) → 上下文连贯与保持:通过共享记忆或持久规划器维持长时程状态,GCM缓解碎片化并提高智能体步骤间的一致性。
IAM(智能体间消息) → 跨组件协调与状态管理:把上游输出以结构化形式传给下游,避免侦察结果不进入利用环节。
CCI(条件触发调用) → 工具使用准确与选择性执行:用简单的门控挡掉已完成子任务和矛盾动作。
AP(自适应规划) → 多步规划与错误检测恢复:允许动态重排子目标、按反馈改道,替代脆弱的线性计划。
RTM(实时监控) → 实时动态响应:引入事件驱动轮询与轻量运行时钩子,这也是唯一能碰 MITM 的开关。
智能体 | 基线 | +GCM | +IAM | +CCI | +AP | +RTM |
|---|---|---|---|---|---|---|
AutoAttacker | 25.9 | 38.2 | 41.5 | 40.0 | 53.0 | 30.9 |
PentestGPT | 41.2 | 54.9 | 57.4 | 54.1 | 52.2 | 46.2 |
PenHeal | 52.1 | 56.3 | 63.9 | 58.7 | 72.4 | 57.1 |
(子任务完成率,单位 %。)
如图标所示,这些干预对症下药地搭建了功能模块,大大地提升了智能体的性能。
6. 结论与局限
论文最后回到了 RQ1,作者最终的结论是:角色取决于任务,而不是取决于架构。低风险、结构化的任务可以自主;高风险、实时性强的任务必须退回人机协同
局限说得也坦白:靶场只覆盖 HTB、Metasploitable 这类规模,未必代表大型企业网络;模型版本会持续更新,而结论有保鲜期;评测依赖文本层面的命令解析,没有直接接入网络监控与实时流量分析,这也是 MITM 全灭的原因之一。
作者团队介绍
论文第一作者为
弗吉尼亚理工大学电气与计算机工程系(Bradley Department)博士生Lanxiao Huang,研究方向覆盖 LLM 智能体、自动化渗透测试与网络攻防仿真。共同作者
Daksh Dave、Tyler Cody、Peter Beling均来自弗吉尼亚理工大学,分属 Bradley 电气与计算机工程系、National Security Institute 与工业与系统工程系。通讯作者
Ming Jin为弗吉尼亚理工大学电气与计算机工程系助理教授,主要研究 AI 安全、时序学习与智能体系统,相关工作获 NSF 等机构资助。
安全学术圈 | 投稿须知
有兴趣加入学术圈的请联系 secdr#qq.com
本文转载自微信公众号「安全学术圈」,查看原文。版权归原作者所有,如有侵权请联系删除。