反AI逆向方法论-LLVM-Pass落地
原创 矛和盾的故事 2026-10-31 17:00 北京
MCP 接口和 REA 等工具进入工作流后,这些操作开始被智能代理串起来:给出目标,代理查询函数与交叉引用,编写解码脚本;反编译走不通,就读机器码;静态推导代价太高,就用真机 trace 或在环境里仿真分析。最终交付的也可以是一份能运行的重建代码。
Android Native 逆向里,经常能看到这样的保护思路:隐藏符号、加一层控制流平坦化,再配上反调试检测。攻击者拿到 SO 后,需要找入口、追调用、还原表达式,最后写代码验证。保护的价值,很大一部分来自这些步骤消耗的时间。
MCP 接口和 REA 等工具进入工作流后,这些操作开始被智能代理串起来:给出目标,代理查询函数与交叉引用,编写解码脚本;反编译走不通,就读机器码;静态推导代价太高,就用真机 trace 或在环境里仿真分析。最终交付的也可以是一份能运行的重建代码。
这并不意味着任意保护都能被瞬间破解。真正发生变化的是:逆向不再完全依赖分析师逐个完成操作,一部分专业工具的使用与验证过程可以被持续自动化。 对保护方而言,藏掉函数名、把控制流图变复杂,或引入 VMP(代码虚拟化),已经不足以回答“业务是否更难恢复”。
本文研究的对象是一个明确的转换链:如何将 BLA 的分析预算干扰、证据干扰和运行时守卫适配到 Android Native,再通过 LLVM Pass 改写真实业务的数据流与执行表示?
攻击方持有发布后的 ELF,可进行静态解码;动态轨还允许在自有副本上仿真、patch 和读取状态。研究目标是提高独立功能重建的成本。对攻击者可控制的客户端执行环境,不假设本地检测返回值或混淆种子具有不可提取性。
下面先拆解智能逆向的工作链,再实现发布证据干扰、入口观察、表达式切片和整函数虚拟化。每种机制都说明它改变了哪一层表示、为什么可能有效,以及攻击者还能从哪里继续。最后用同一业务函数的隔离盲测检验这些判断。
一、背景:MCP、REA 与智能逆向的出现
1.1 从“模型解释代码”到“代理使用工具”
单独的语言模型只能根据收到的内容推断。它看不到二进制中的全部代码,也不会因为读了一段伪代码就自动拥有调试器的能力。
MCP(Model Context Protocol)提供了连接 AI 应用与外部工具、数据的标准接口。接入相应服务后,模型可以发出结构化调用,请工具执行操作,再根据返回结果继续决策。MCP 本身不是逆向算法,具体能力取决于服务暴露了什么工具。
REA将二进制、应用和运行行为分析组织成可供代理使用的工具入口。反编译、函数查询、字符串和引用分析可以成为代理的一步操作,而不是需要人工复制粘贴的一段上下文。
当工具入口与脚本环境结合,工作流就从“一问一答”变成了循环:
提出分析目标
    ↓
选择工具 → 获取证据 → 推导假设 → 编写脚本验证
    ↑                                ↓
    └──────── 失败后换路径 ────────────┘
                                     ↓
                            提交解释或独立实现
手机阅读时,代码块和宽表格可左右滑动;架构图可点击打开 SVG 原图,再用浏览器缩放查看。实测部分另提供逐例对照卡片。
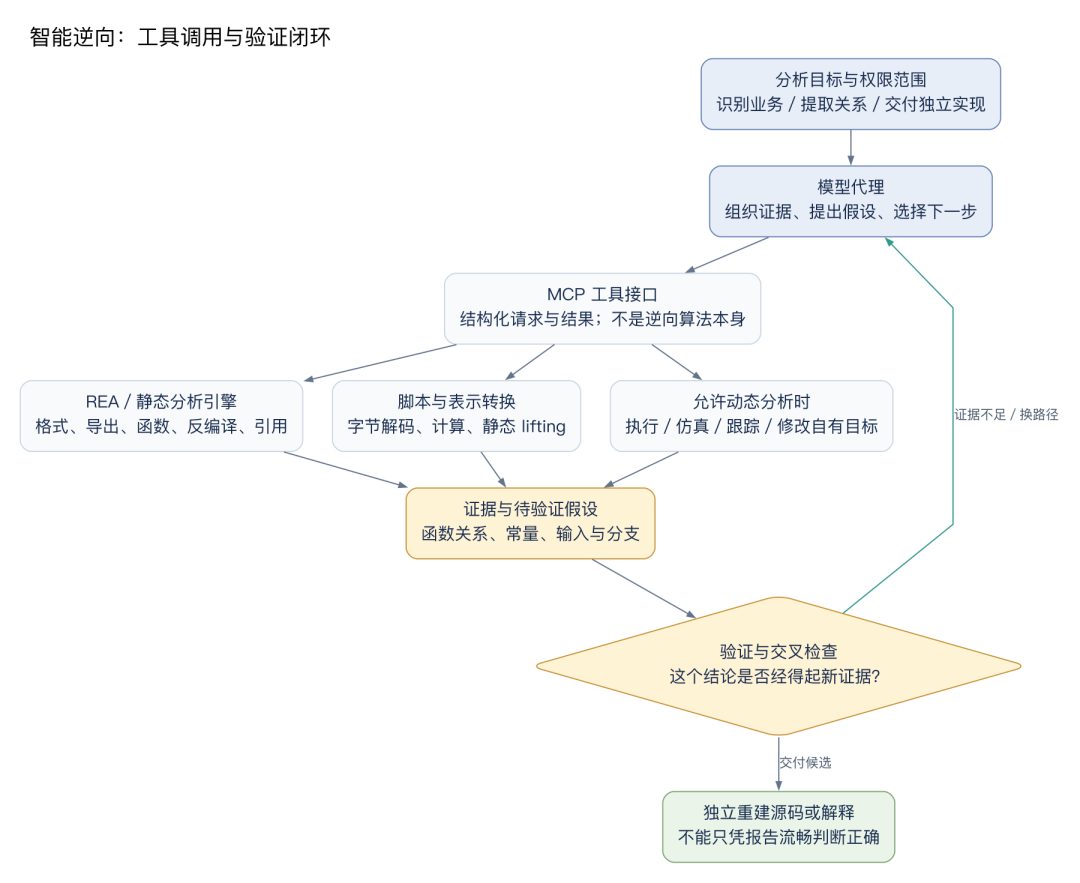
图 1:模型负责选择和组合操作,分析引擎提供证据,脚本与执行环境用来验证假设。
1.2 为什么核心逻辑更容易被持续分析
变化不只在模型“会读代码”,还在它能重复做过去昂贵、琐碎的操作:
- 扩展证据范围
:从一个导出函数追到辅助函数、常量表和调用者。
- 切换表示方式
:反编译失败后,继续读原始字节、解码指令或提升为中间表示。
- 批量试验
:生成输入、记录返回值、比较分支,逐步缩小算法假设。
- 跨过局部障碍
:静态分析代价太高时,尝试执行、仿真或修改自己的目标副本。
- 生成替代实现
:交付可运行程序,而不只是对伪代码的自然语言解释。
这些能力降低了部分分析工作的操作门槛,也使同一类保护被反复尝试的成本下降。但是否完整恢复,仍然受目标结构、工具能力、输入样本、预算和验证质量影响。
1.3 保护目标需要重新定义
对 Android SO,至少要区分三件事:
目标 | 应检查什么 |
|---|---|
隐藏实现细节 | 算法、控制流、关键常量是否容易被解释或提取 |
阻碍功能克隆 | 是否能生成不依赖原 SO 的独立实现 |
保持正常业务 | 加固后是否仍符合原有输入输出与环境约束 |
模型没有解释清楚算法,不代表它无法克隆行为;模型给出流畅报告,也不代表它的实现是正确的。本文把“独立重建通过隐藏输入测试”作为主要实验指标,同时单独观察关键材料泄露和执行成本。
二、原理:沿着智能逆向链路寻找防护位置
2.1 分析器、模型与执行环境各自承担什么
一条典型链路可以拆成三部分:
部分 | 提供的能力 | 保护方可以影响的位置 |
|---|---|---|
格式与分析引擎 | 识别文件、发现函数、提取字符串、反编译与交叉引用 | 证据数量、结构特征、函数边界与表示复杂度 |
模型推导 | 解释证据、提出假设、决定下一步工具调用 | 证据的一致性、真假路径、跨函数数据依赖 |
脚本与执行环境 | 批量计算、仿真、跟踪、patch 和差分验证 | 运行时观察面、数据出现的位置与执行路径 |
三者之间不是单向流水线。某个分析器返回 limited 后,代理仍可能换工具;某条伪代码太难理解,它可以把片段提升成脚本;遇到本地检测,它也可能直接修改返回值。
因此,“让一个入口失效”和“让任务无法完成”之间,还有很长的距离。
2.2 反 AI 防护的核心是改变完成任务的成本
保护不应该只增加代码长度,而要增加攻击者取得可信结果所需的工作:
让便宜的证据入口不再直接暴露关键关系。
增加真假路径判断与跨片段组合的成本。
降低单个 hook 点、解码器或纯函数接口的取证价值。
让独立重建必须处理真正的业务状态,而不只是绕过一个 wrapper。
这里既包含工具层面的干扰,也包含传统混淆的数据流、控制流和表示变换。它们对人和自动化代理的作用有重叠,不能仅因为目标是 AI,就认为旧的编译器语义问题不再重要。
2.3 正确性、攻击结果与成本必须分开
语义等价检查的是原始与保护后的产物;恢复正确率检查的是攻击者提交的重建;成本记录双方为此付出的资源。三者不能互相替代。
例如,保护后的 SO 在测试中与原版完全一致,但代理仍可能完整恢复;代理消耗更多 token 后提交错误程序,也不能证明它在剩余预算内绝无可能修正。评估必须保留这些区别。
2.4 形式化目标:正常路径语义保持与独立重建
设原业务函数为 F(x),其中 x 是四个 i32 参数;整函数转换后的真实业务为 V(x),影子业务为 H(x),入口观察结果为 g(e,c)。e 表示观察到的环境信息,c 表示调用计数与缓存状态。最终产物的抽象行为为:
P(x,e,c) = H(x),  if g(e,c) != 0
           V(x),  otherwise
正常路径正确性目标:V(x) = F(x),对受支持源 IR 的有定义执行成立。
带守卫的行为对照:g(e,c) = 0 时,P(x,e,c) = F(x)。
因此,“等价校验通过”需要说明环境前提。守卫命中后返回影子结果,是设计中的另一条行为,不属于正常路径等价承诺。当前有限测试为这些关系提供回归证据,没有构成全输入域的形式化证明。
攻击目标则是提交独立程序 R(x),在冻结的隐藏测试集 D 上满足 R(x)=F(x),并且不加载、委托原目标。代理可在多种路线中选择:反编译、字节解码、静态 lifting、运行时跟踪或复用目标解码器。单独提高一条路线的代价,不能推导出整体恢复成本的下界;只要另一条可行路线仍便宜,任务就可能完成。
三、防御理论:四个作用面与各自边界
这里将 BLA 的三层防御与本文实现逐项对应。本文仅适配适用于 Native 的机制,不声称完整移植,也不引用 BLA 的跨格式基准作为本实验成绩。
BLA 层 | Native 实现与代码位置 | 迁移边界 |
|---|---|---|
Exhaustion | generate_metadata.py 保留 68 条不同 Rust 风格路径,放入合法 | 没有迁移 JS getter、alias 扩展或 Electron Fuse 哨兵阈值 |
Deception | shadow.c的强连通调用簇、有界影子报价,与 48 份诱饵记录 | 没有接入 SourceMap;元数据不代表真实 TEE 能力 |
Runtime Guard | runtime.c 读取观察信号, | 使用 Android 观察面,不迁移 Electron Fuse 或 Node Inspector 机制 |
本文增加的业务变换 | AnalysisComplexity.cpp 做表达式切片; | 由本文实验实现,不归为 BLA 原有 LLVM 算法 |
前三项分别影响分析入口、语义归因和运行时路径;最后一项改变正常路径的真实计算表示。下文同时讨论各层的成本来源与可绕过边界。
3.1 预算干扰:影响证据提取的便宜入口
分析器通常会限制候选数量、递归深度和输出规模。研究这些限制,可以找到特定工具版本的低成本证据入口,并观察某种产物布局是否会让该入口降级。
一个具体例子是本地 REA 6.8.0 的 Rust 扫描模块:它包含 MAX_RUSTC_HASHES = 64。实验保留了 68 条不同的 Rust 风格构建路径,用来观察该入口的阈值行为。数据放在合法 ELF 只读节中,不靠损坏文件格式制造解析崩溃。
fromhashlibimportsha256# 研究特定扫描入口的受控元数据;不是业务秘密。
forindexinrange(68):
digest=sha256(f"omvll-bla-demo-rust-{index}".encode()).hexdigest()[:40]
path=f"/rustc/{digest}/library/core/src/quote_engine.rs"
该扫描器先合并只读节与 ELF 只读、非执行载入区的文件范围,再提取、去重 rustc 摘要;已有 64 项时,遇到第 65 个不同摘要即抛出资源上限异常。生成器为每条路径使用不同的 40 字符十六进制摘要,使其满足识别形态且不被简单去重合并;68 条不同路径为超过 64 项的限制提供候选,前提是它们位于该入口实际扫描的范围内。used 与 ELF 的 retain/链接保留规则负责让这些数据进入最终产物。
这项变换未增加认证公式的代数复杂度,而是争取让特定 provider 提前降级。某个 provider 返回 limited 后,代理仍可查询导出、读取字节或改用其他分析器。触发阈值与阻止恢复是两个需要分别测量的事件。
3.2 证据干扰与影子业务:增加真假路径的判断成本
字符串、符号、模块名和调用图,常常是代理建立初始假设的依据。可以构造一组内部自洽、但不代表真实业务的证据:虚构模块记录、诱饵调用簇,以及输入输出形态合理的影子状态机。
在 shadow.c 中,stage_0…stage_4 的潜在调用边构成强连通簇,在 depth 非零时,按更新后状态的最低位选择两个后继之一:
q_i = (s_i XOR K_stage) * 0x9e3779b9  mod 2^32
s_(i+1) = q_i XOR (q_i >> 13)
d_(i+1) = d_i - 1
每个 stage 先限制 depth、计算 q;depth 为 0 时返回 q,否则将下一状态与 depth−1 传给后继。入口 depth=4,因而最多经过 5 个 stage,再执行固定 6 步影子报价 switch。这是“静态调用关系复杂、实际执行有界”的结构。48 份诱饵记录则提供模块、接口和策略字段,与这条路径共同构成可解释的假业务。
这些都是本地数据与代码,不表示产物真的使用了 TEE、RSA 或 enclave。强连通结构也不意味着已经触发某个调用图预算;本次没有逐层消融来量化它的独立效果。
诱饵元数据影响的是“这个模块可能做什么”的初始判断;影子状态机则让错误路径确实能够运行,返回形态合理的结果。两者的作用不同:前者增加证据筛选成本,后者增加执行路径识别成本。它们都没有改变正常路径上的业务公式。
这类设计的收益取决于代理是否采信这些证据。一旦代理通过入口分支、正常输入或差分观察识别出真实路径,诱饵就可能被整体排除。后文的实验确实出现了这种绕过,因此不能把诱饵数量当作保护强度。
3.3 运行时守卫:增加观察成本,避免单点依赖
运行时层可以读取本地环境信号,例如 TracerPid 和 /proc/self/maps 中的部分工具特征,再决定是否走影子路径。当前实验在 Android ARM64 上用本地 syscall 读取这些信息,缓存结果,每 64 次调用重新观察一次。
// 插桩行为示意,具体类型和控制流由 LLVM Pass 生成。
if(observer_detected())
returnshadow_business(user,quantity,tier,token);
returnprotected_business(user,quantity,tier,token);
本地信号不构成信任根。允许仿真和 patch 的攻击者可以替换检测返回值、调整夹具,或者跳过分支。若后面的真实计算仍然很容易孤立求解,入口守卫只能增加一次定位和绕过的工作。
这里还有时序语义:原子计数器负责分配调用序号,ticket & 63 非零时读取缓存,否则刷新观察。relaxed 原子避免普通共享变量的数据竞争,但不保证所有并发调用都使用同一时刻的新环境快照。某个观测读取失败不会自行置位,但其他观测已发现的标记仍可保留。因此“返回 0”只能解释为当前探针未报告异常。
缓存会降低系统调用频率,同时产生观察窗口;真机上的误报、并发行为和窗口内的漏报都需要另测。本文没有用仿真结果替代这些验证。
3.4 业务语义混淆:保护要进入真实计算
只增加不可达分支或假函数,未必改变真实算法的恢复难度。保护还需要作用于认证关系、条件判断、常量传播和结果计算本身。
本文对照两类做法:
机制 | 如何改变真实业务 | 主要风险 |
|---|---|---|
表达式切片 | 把比较、算术依赖拆成编码的小函数,再组合结果 | 小而纯的函数边界也可能方便逐个恢复 |
整函数编码虚拟化 | 把业务转换为自定义指令和编码寄存器状态 | 通用解释器可能形成集中解码点,或被独立提升 |
编码、控制流平坦化与虚拟化都是表示变换。其安全收益要由攻击成本和恢复结果说明,不能由使用了多少种变换来推定。
3.5 不透明谓词必须尊重机器语义
例如 x² mod 8 == 3 在数学上恒假;平方的模 8 剩余只有 0、1、4。采用无符号 i32 回绕时,低三位关系仍然成立,可以用它保留一条正常情况下不会选择的路径。但简单关系也可能被代理直接证明,并不天然构成高强度障碍。
更要小心把整数证明直接搬进 LLVM。若先用 i32 计算 7*x*x-1,再求有符号余数,乘法已经可能回绕。例如 x=25,000 时,回绕值为 80,032,703,对 7 的余数为 2;整数域中“7 的倍数减 1”的证明不能原样套用。
Pass 还必须处理位宽、符号扩展、PHI 的并行语义,以及溢出标志和副作用摘要。语义保持首先是编译器正确性问题,不能用“死分支里不会执行”代替证明。
四、LLVM 落地:把分层保护接入 Android Native
4.1 为什么选择 LLVM IR
LLVM IR 保留了算术、比较、分支、调用与数据依赖,适合在生成机器码之前做结构变换。以 O-MVLL 为基础,可以把已有控制流混淆与自定义 Module Pass 组合,再生成 Android AArch64 ELF。
需要特别区分:本机运行的是 LLVM 21 插件,Android 产物使用 NDK 29 的 sysroot 与 linker。插件能否加载,取决于 Clang/LLVM 的 ABI 兼容性,不能假定任意 NDK Clang 都接受同一个插件二进制。
本文的具体机制、分层实现和源码关系如下:
层 | 实现 | 作用 |
|---|---|---|
控制流 | O-MVLL flatten 配置 | 改变真实函数的分派和基本块关系 |
发布证据 | 受控元数据生成器 | 生成阈值研究数据和诱饵记录 |
观察/影子 | 入口插桩与 native runtime | 根据观察状态选择真实或合成业务 |
数据流 | 纯算术表达式切片 | 外提并编码真实比较与计算 |
整函数表示 | BusinessVM 实验 Pass | 将整个受支持业务函数替换为编码程序与解释器 |
前面三层可以与后面两种业务表示方案分别组合,实验中保持这些外围层相同。下文的“切片分层保护”指 flatten、表达式切片、元数据、影子和守卫的组合;“整函数虚拟化保护”将其中的表达式切片替换为编码 VM。它们是机制名称,不代表某个商业保护产品的全部能力。
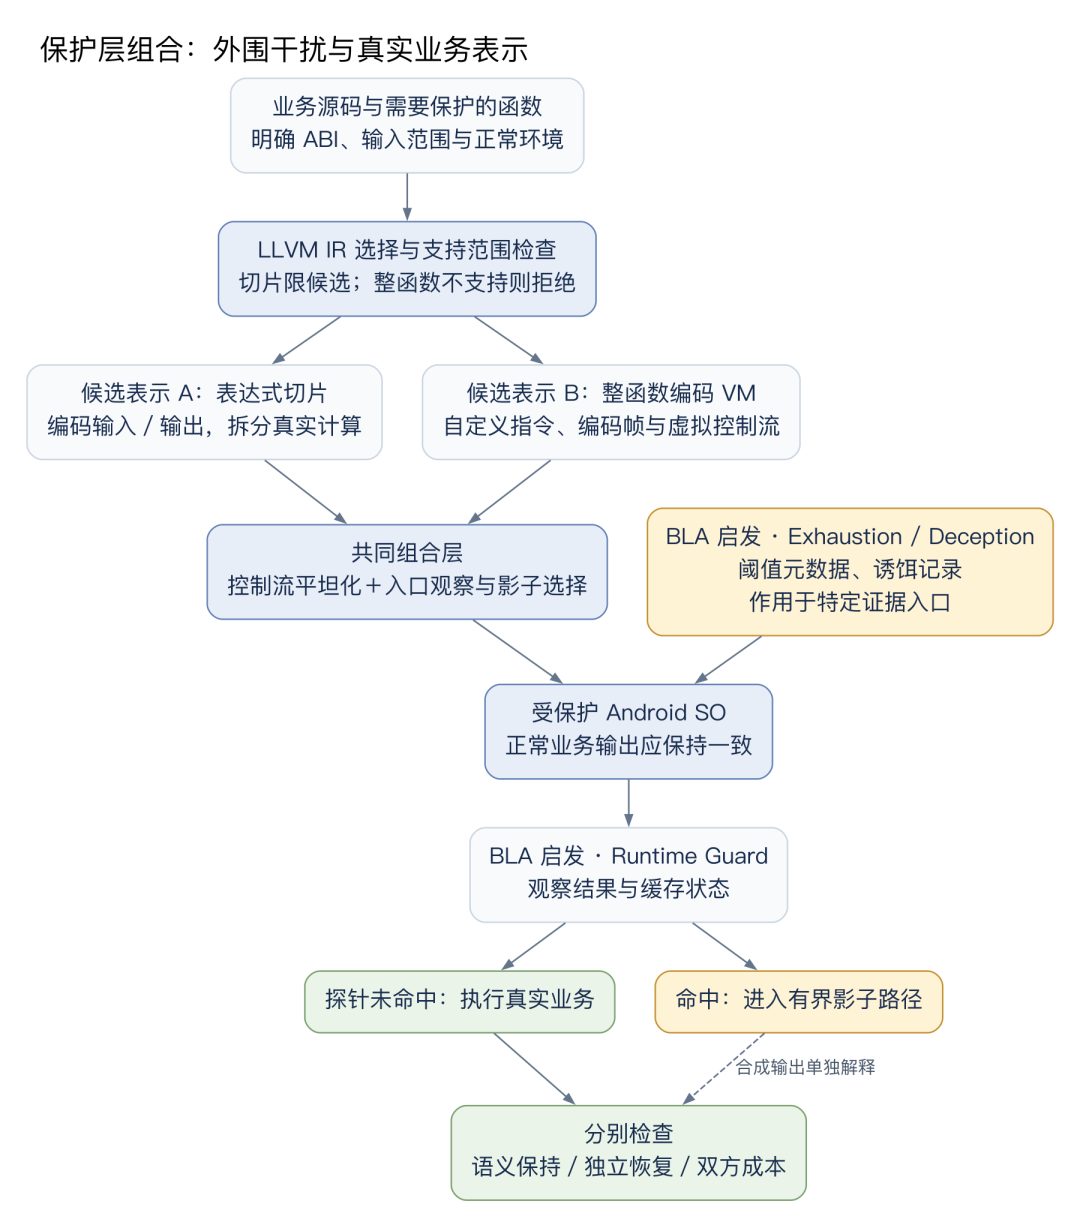
图 2:外围证据与影子路径提供干扰,真实业务本身还需要数据流或整函数表示变换。
4.2 选择与验证:先确定能转换,再改函数体
这次保护的业务入口为四参数纯整数函数。整函数方案用显式注解选择目标,避免误处理 JNI 桥接、系统库和解释器自己的 runtime:
#include<stdint.h>
__attribute__((annotate("omvll.business-vm")))
__attribute__((annotate("omvll.bla.shadow")))
__attribute__((annotate("omvll.bla.runtime")))
uint32_tdemo_evaluate(uint32_tuser,uint32_tquantity,
uint32_ttier,uint32_ttoken);
这三个字符串分别对应整函数转换、影子路径和运行时观察。切片配置将第一个标记换成 omvll.analysis-complexity;两个业务表示方案不会同时叠在同一个业务函数上。注解由 Clang 写入 llvm.global.annotations,Module Pass 读取其中的函数引用与字符串,再建立待处理列表。
当前整函数 Pass 只接受 i32(i32,i32,i32,i32) ABI、最多 128 个基本块,以及 1—32 位整数 SSA/CFG。白名单包括算术、位运算、比较、select、整数转换、PHI、分支与返回;源 IR 中的内存访问、函数调用、浮点、宽整数和 switch 均拒绝。
这里的限制发生在源业务 IR。Pass 随后生成的解释器本身会使用栈内存和 switch,两者并不矛盾。输入需要在优化后满足白名单,例如可被内联和消去的源码辅助调用,不一定在最终输入 IR 中仍然存在。
BusinessVM.cpp 的入口可以按下面的顺序阅读。代码仅整理排版、略去 seed 更新与已处理标记判断,保留“全部验证后再变换”的关键控制流:
// fs 已由注解筛选;seed 为本次构建种子。
for(Function*F:fs){
LowerProbe(*F,seed);
if(!Probe.validate())
report_fatal_error("business-vm: unsupported selected function; "
"refusing plaintext fallback");
}
for(Function*F:fs){
LowerL(*F,seed);
L.compile();// SSA/CFG → 虚拟寄存器与指令记录
L.materialize();// 编码程序 + 新解释器函数体
}
先验证整个选择集,是为了避免处理到一半才发现不支持,却留下部分函数仍为明文。这个行为是整函数 Pass 的约束。表达式切片采用有上限的候选选择,未选中的表达式可能保留,不能给它同样的“整个函数已转换”保证。
贯穿示例:从认证判断到折扣计算。
后面统一使用下面这个公开教学函数。它与实测样例具有“认证后计算报价”的相似结构,但常量和算法特意简化,不是隐藏测试目标,也不作为新的防护成绩。所有计算使用 uint32_t 回绕;这个认证关系仅用来说明转换,不是安全的认证设计。
uint32_tquote_demo(uint32_tuser,uint32_tquantity,
uint32_ttier,uint32_ttoken){
uint32_texpected=(user*17u+9u)^0x13579bdfu;// E1
if(token!=expected)return0;// E2
uint32_tgross=quantity*(100u+tier*5u);// E3
uint32_tdiscount=quantity>=10u?gross/10u:0u;
returngross-discount;// E4
}
E1 生成认证关系,E2 决定是否进入真实报价,E3 计算原价,E4 计算折扣并返回。四个位置也标在图 3 中:外围观察控制能否进入真实函数,切片与整函数 VM 则是两种替代的业务表示。
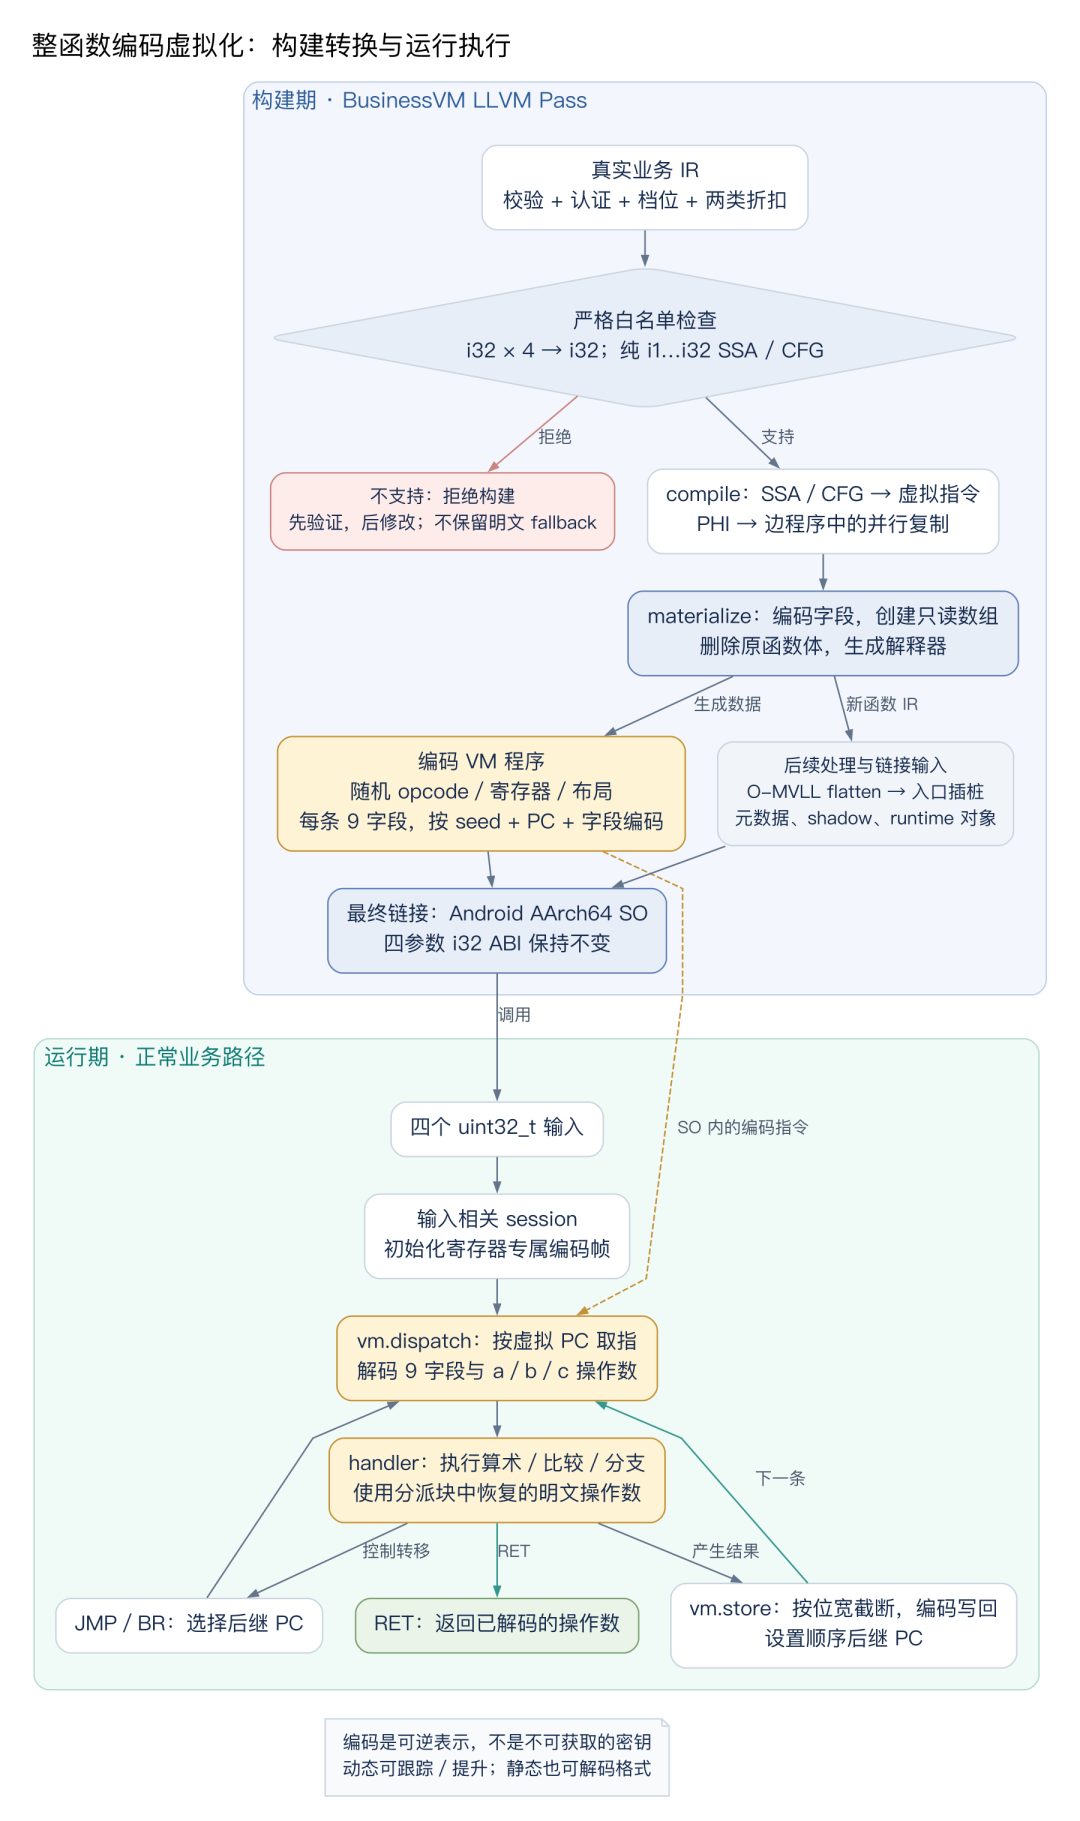
图 3:同一段 E1—E4 业务经过 C、LLVM IR 和两种保护表示;最终都应保持公开示例的输入输出。
用 LLVM 21 的 clang -O1 -S -emit-llvm 编译后,得到下面的实际指令结构。为便于对照,仅重命名 SSA 值和基本块、略去属性;完整文件见 quote.c 与 quote.ll。
definei32@quote_demo(i32%user,i32%quantity,i32%tier,i32%token){
entry:
%scaled=muli32%user,17
%sum=addi32%scaled,9
%mixed=xori32%token,%sum
%ok=icmpeqi32%mixed,324508639; E1/E2: 0x13579bdf
bri1%ok,label%price,label%exit
price:
%level=muli32%tier,5
%unit=addi32%level,100
%gross=muli32%unit,%quantity; E3
%bulk=icmpugti32%quantity,9
%tenth=udivi32%gross,10
%discount=selecti1%bulk,i32%tenth,i320
%net=subi32%gross,%discount; E4
brlabel%exit
exit:
%result=phii32[%net,%price],[0,%entry]
reti32%result
}
这里已经有一次值得注意的变化:编译器将 token == (sum XOR K) 改成了 (token XOR sum) == K,并将数量判断改成 ugt 9。Pass 面对的是优化后的 IR,不能依赖源码表达式的固定写法。
例如 user=7, quantity=12, tier=2, token=0x13579b5f 时,认证通过,unit=110、gross=1320、discount=132,返回 1188;仅把 token 改成 0,返回 0。这组公开数值贯穿后面的指令执行说明。
4.3 表达式切片:从真实依赖图中外提计算
① 找根节点,再向操作数回溯。
切片优先选择控制业务判断的 icmp,随后处理结果跨到不受支持操作或其他基本块的表达式边界。Slice::collect() 只在同一基本块里递归收集受支持的整数运算,先访问操作数、再把当前指令放入列表,因此克隆时依赖已经建立。
遇到参数、常量、其他基本块的值,或不适合搬移的指令,就把它当作叶子输入。load、store、call、PHI 都不随切片迁移。原型限制每函数最多 16 个切片位置、模块最多 128 个 helper,单片最多 24 个节点、32 个叶子,递归收集深度小于 16,以控制代码膨胀。
② 在调用边界编码,在 helper 内恢复原类型。
沿用 E1/E2。以 %ok 为根,切片会收集同一入口块里的乘、加、异或和比较;user、token 与常量成为叶子。转换后的意义可用下面的教学 C 表示。为突出调用边界,这里只画两个变量叶子;当前实现也为收集到的常量叶子建立编码参数,不能据此推断 helper 的固定 ABI。
// 示意,不是原 Pass 的逐字输出;掩码为公开教学值。
staticuint32_tauth_slice(uint32_teu,uint32_tet){
uint32_tu=eu^0x11111111u;
uint32_tt=et^0x22222223u;
uint32_tok=((t^(u*17u+9u))==0x13579bdfu);
returnok^0x33333333u;
}
uint32_tok=auth_slice(user^0x11111111u,token^0x22222223u)
^0x33333333u;
if(!ok)return0;// E2;通过后仍进入 E3/E4 的报价块
原 %ok 是 i1;调用边界使用 i32,返回解码后必须截回 i1,再供原 br 使用。同理,E3 的乘法和 E4 的结果边界可以形成其他切片,但跨块的返回 PHI 不会被搬进这个 helper。
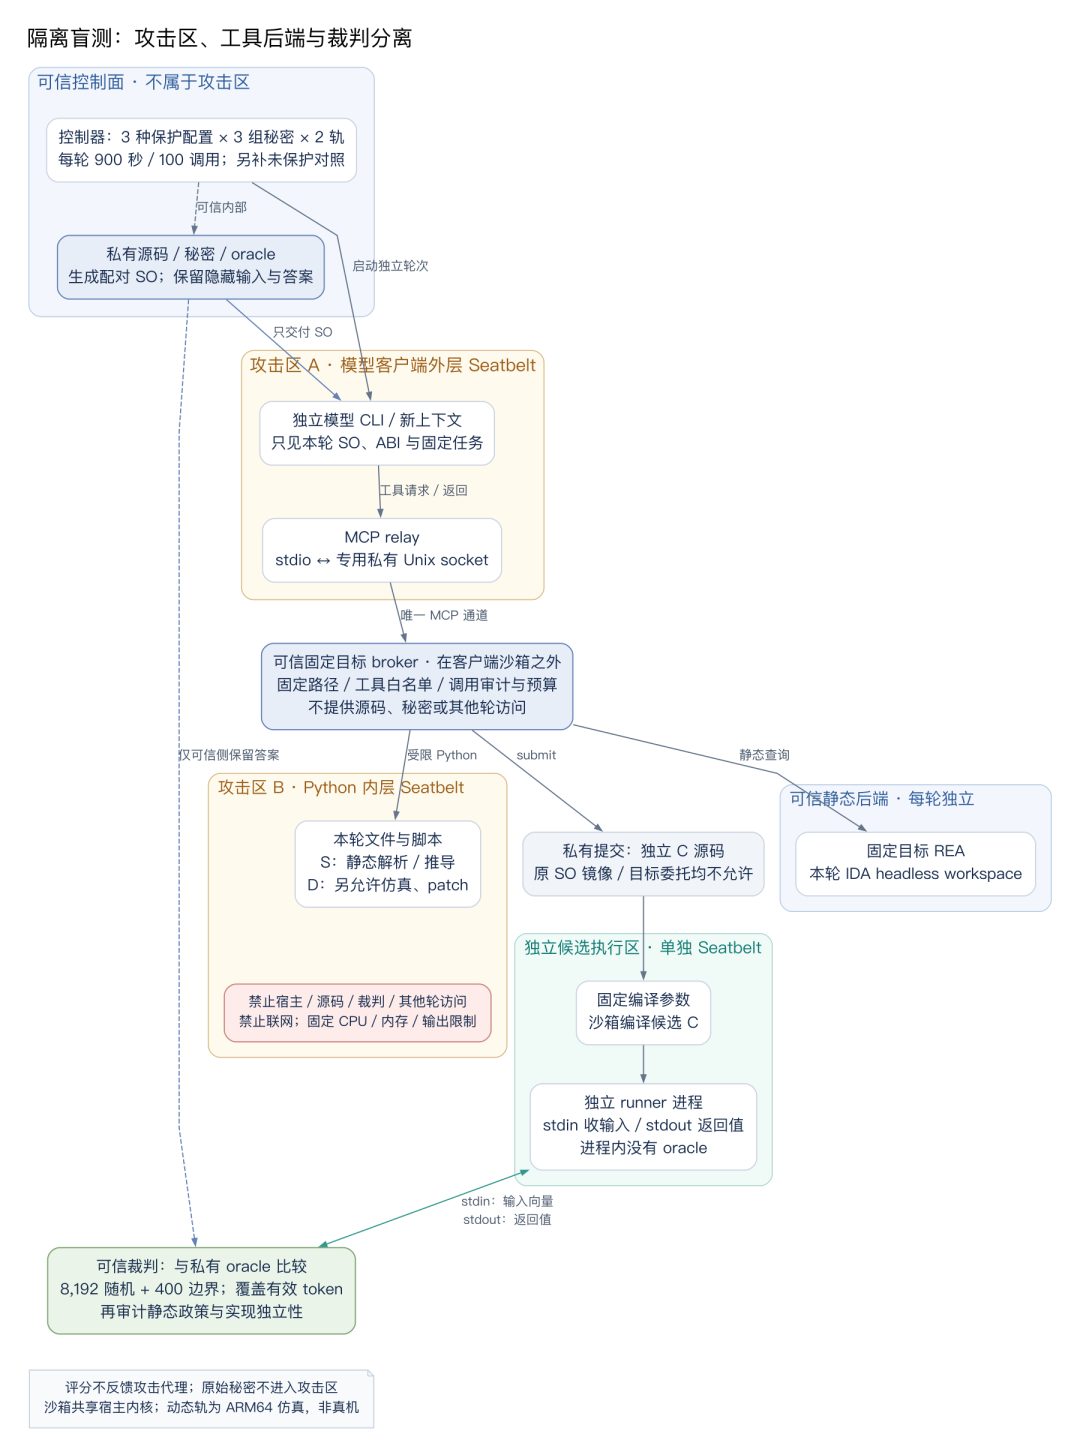
图 4:A 收集依赖,B 建立编码边界并克隆原运算,C 替换原使用点;旁边的真实业务分支继续使用恢复后的结果。
在实际 LLVM 实现中,输入统一转为 i32,解码后再截回叶子的原位宽。下面三个步骤对应图 4 的 A、B、C;摘取自 outlineSlice(),省略函数创建与循环上下文:
// A:收集同块纯整数依赖;Nodes 按依赖顺序保存。
S.collect(Root);
// B:调用方编码;helper 解码并恢复叶子原类型。
Args.push_back(CB.CreateXor(CB.CreateZExtOrTrunc(Leaf,I32),
CB.getInt32(Key)));
Value*Decoded=HB.CreateXor(H->getArg(I),HB.getInt32(Key));
Values[Leaf]=HB.CreateTruncOrBitCast(Decoded,Leaf->getType());
// 对每个 Nodes 中的指令 clone(),用 Values 映射重接操作数。
// clone 保留原指令的运算和相关标志。
Value*Result=HB.CreateZExtOrTrunc(Values.lookup(Root),I32);
HB.CreateRet(HB.CreateXor(Result,HB.getInt32(OutKey)));
// C:替换原表达式的使用;只删除已无使用者的旧计算。
Value*Call=CB.CreateCall(H,Args);
Value*Plain=CB.CreateXor(Call,CB.getInt32(OutKey));
Value*Replacement=CB.CreateTruncOrBitCast(Plain,Root->getType());
Root->replaceAllUsesWith(Replacement);
RecursivelyDeleteTriviallyDeadInstructions(Root);
③ 切片替换的不变量。
令原根表达式为 r=f(l0,…,ln),叶子位宽为 wi、结果位宽为 wr。实现将每个叶子的原位模式零扩展到 i32,再做异或编码;helper 解码后截回 wi。返回端同样先扩展、编码,再由调用方解码并截回 wr:
输入:arg_i = zext32(l_i) XOR k_i
恢复:l'_i  = trunc_wi(arg_i XOR k_i) = l_i
结果:r'    = trunc_wr((zext32(f(l'_0,…,l'_n)) XOR k_out) XOR k_out)
            = f(l_0,…,l_n)
这个关系依赖于三项实现条件:克隆保留原运算及其适用语义;叶子在新调用位置可用;被搬移的节点没有内存或其他副作用。同块回溯与白名单用于缩小需要证明的范围。边界上的 load 或 PHI 作为已计算的叶子传入,并不等于把它们重新执行到 helper 内。
replaceAllUsesWith() 只负责重接使用点;RecursivelyDeleteTriviallyDeadInstructions() 才清理无用旧表达式。共享子表达式仍被其他使用者需要时不能删除。因此需要核对最终 IR 的使用关系,不能把新增 helper 数量当作覆盖率。
④ 保留边界,并核对它是否值得保留。
helper 设置 noinline 与 optnone,保留调用边界并限制对 helper 函数体的常规优化;它只计算纯表达式,因此标记 memory(none)。这些属性不会阻止外部分析器做代数消元,也不保证最终每条指令与未优化 IR 一一对应。
这种转换把业务关系拆到多个调用里,增加跨函数重组步骤。但固定 XOR 满足 (x XOR k) XOR k = x,helper 又没有外部状态,静态展开可以消去掩码,动态观察可以直接记录参数与返回值。它改变了数据流的组织方式,同时也产生了可单独求解的小接口。失守复盘里会看到这条边界如何被利用。
4.4 入口观察与影子分支:插桩后必须更新属性
图 2 的“入口观察与影子选择”由 BlaNativeLayers.cpp 完成。它在原入口前增加 bla.gate,保留原业务入口,再新增 bla.synthetic:
bla.gate
  hit = ((user * user) & 7) == 3
  hit |= runtime_probe() != 0
  ├─ hit:bla.synthetic → shadow_eval(原四参数) → return
  └─ 否:原业务入口 → 切片业务或编码 VM → return
对应的 IRBuilder 核心操作如下。省略注解位判断与基本块创建,变量名与实现一致:
Value*Square=B.CreateMul(F->getArg(0),F->getArg(0));
Value*Hit=B.CreateICmpEQ(B.CreateAnd(Square,B.getInt32(7)),
B.getInt32(3));
Value*Reason=B.CreateCall(Runtime);
Hit=B.CreateOr(Hit,B.CreateICmpNE(Reason,B.getInt32(0)));
B.CreateCondBr(Hit,Synthetic,Original);
第一个谓词基于无符号回绕后仍成立的低三位关系,正常不会命中;真正可能改变执行路径的是 runtime 返回的观察结果。runtime.c 用位标记区分非零 TracerPid 与特定 maps 字符串,首次观察后每 64 次调用刷新一次,其他调用读取缓存。读取失败不会自行置异常位;若其他信号已命中,仍可走影子路径。缓存时序见第 3.3 节。
更容易漏掉的是插桩后的副作用摘要。原业务可能被优化器推断为 memory(none)、willreturn,调用者还可能保存返回值范围。加入读取 /proc 的调用和另一种返回路径后,这些结论需要重新审视。实现保守移除了相关函数、调用点上的 memory、返回 range 等推断,并清理 speculatable、nosync、nofree、willreturn 等属性。
如果只插入 call 而保留旧摘要,后续优化就可能基于过期前提重排或简化程序。这里要解决的是编译正确性,不能靠“反编译看起来有检测”判断完成。
4.5 整函数虚拟化:用一套指令承载完整业务
切片保留了小而纯的业务接口。整函数方案尝试移除这个接口:将输入校验、认证、价格与折扣全部降低成同一套虚拟程序,保持外部 ABI,删除原计算体,再生成解释器。
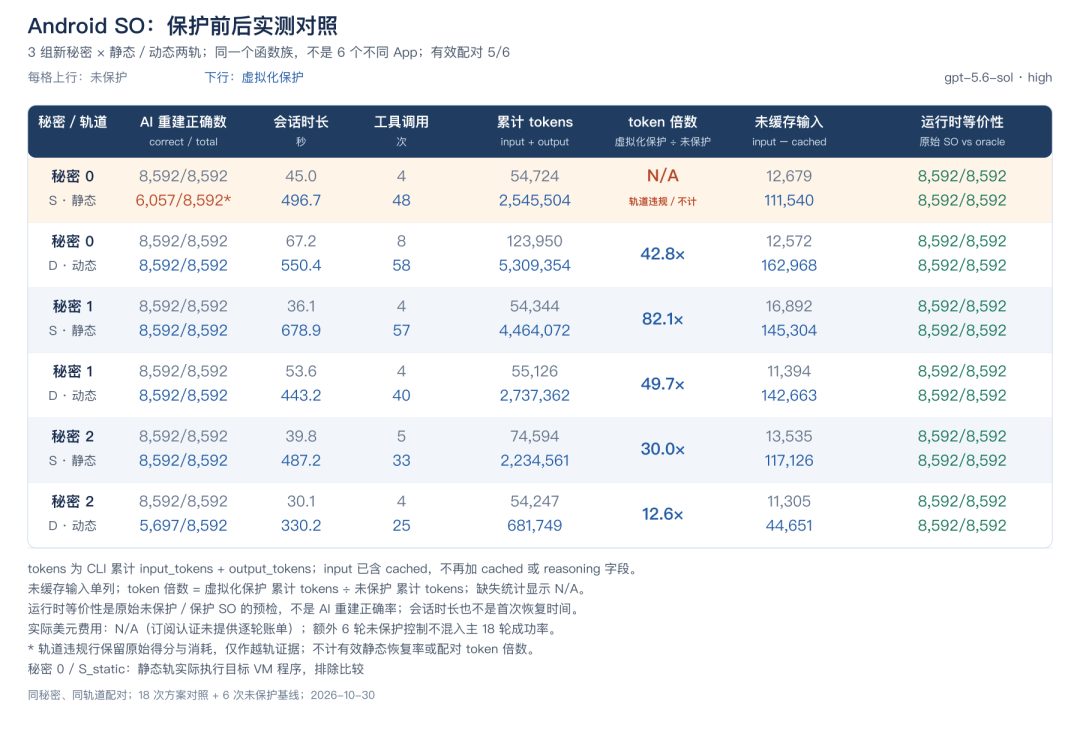
图 5:上半部分为构建期的 validate → compile → materialize,下半部分为生成函数的执行循环;字段和操作数的明文在分派块中出现。
① 从 SSA 值到虚拟寄存器。
LLVM 的 SSA 表示中,每个指令结果只定义一次;CFG 描述基本块之间的控制转移。Lower::compile() 为参数、指令结果和整数常量建立寄存器编号。常量用 MOVI 指令物化;算术生成对应 opcode,比较保存有符号/无符号谓词,分支转为虚拟跳转。构造 Lower 时生成随机 opcode 编号;compile() 随机化基本块/边程序布局,完成指令与后继解析后再置换完整寄存器空间。
一条指令固定包含九个 32 位字段,字段位置与源码 Ins::f 一致:
字段 | 含义 | 例子 |
|---|---|---|
f[0] | opcode | ADD、CMP、BR、RET 的构建期随机编号 |
f[1] | 目标寄存器 | 算术结果的写回位置 |
f[2..4] | 三个源寄存器 | 算术输入、select 条件与两个候选值 |
f[5] | 立即数或附加信息 | 常量、比较谓词、转换的源位宽 |
f[6] | 主要运算位宽 | 算术结果位宽;CMP 使用被比较操作数位宽 |
f[7..8] | 下一 PC/备用 PC | 顺序执行、条件分支后继 |
不是每种 opcode 都使用全部字段。固定布局便于构建,也意味着格式一旦恢复,就能批量读取整份程序。
沿用 E3 的 %gross = mul i32 %unit, %quantity。在取消编号随机化的教学记法下,它对应:
p: [ OP_MUL, rGross, rUnit, rQuantity, rUnused, 0, 32, p+1, 0 ]
f[0] f[1] f[2] f[3] f[4] f[5..8]这是一条字段对应示意,不是实际产物的 opcode 或寄存器编号。真实构建会重新编号,p+1 表示本例顺序后继。九字段里的常量字段也会编码;unit 的来源是前面的 MOVI、MUL 与 ADD,MUL 的源字段保存寄存器编号而非立即数。
② PHI 要拆成边程序,且必须并行复制。
PHI 的输入取决于来自哪个前驱块,所以它不是普通的顺序赋值。假设循环某条回边要交换两个值:
原语义:   a_next = b_old;b_next = a_old
错误复制: a = b;b = a          # 第二步读到的已是新 a
正确复制: t0 = b;t1 = a;a = t0;b = t1
实现为每条前驱→后继边生成程序,先把所有 incoming 值读到新临时寄存器,再写入所有 PHI 目标。下面是源码中的两阶段复制,排版略作展开:
std::vector<std::pair<PHINode*,unsigned>>copies;
for(auto&I:*to){
auto*P=dyn_cast<PHINode>(&I);
if(!P)break;
unsignedtemp=regs++;
emit(MOV,temp,reg(P->getIncomingValueForBlock(from)),
0,0,0,bits(P->getType()));
copies.emplace_back(P,temp);
}
for(auto[P,temp]:copies)
emit(MOV,reg(P),temp,0,0,0,bits(P->getType()));
emit(JMP,0,0,0,0,0,32,labels[to]);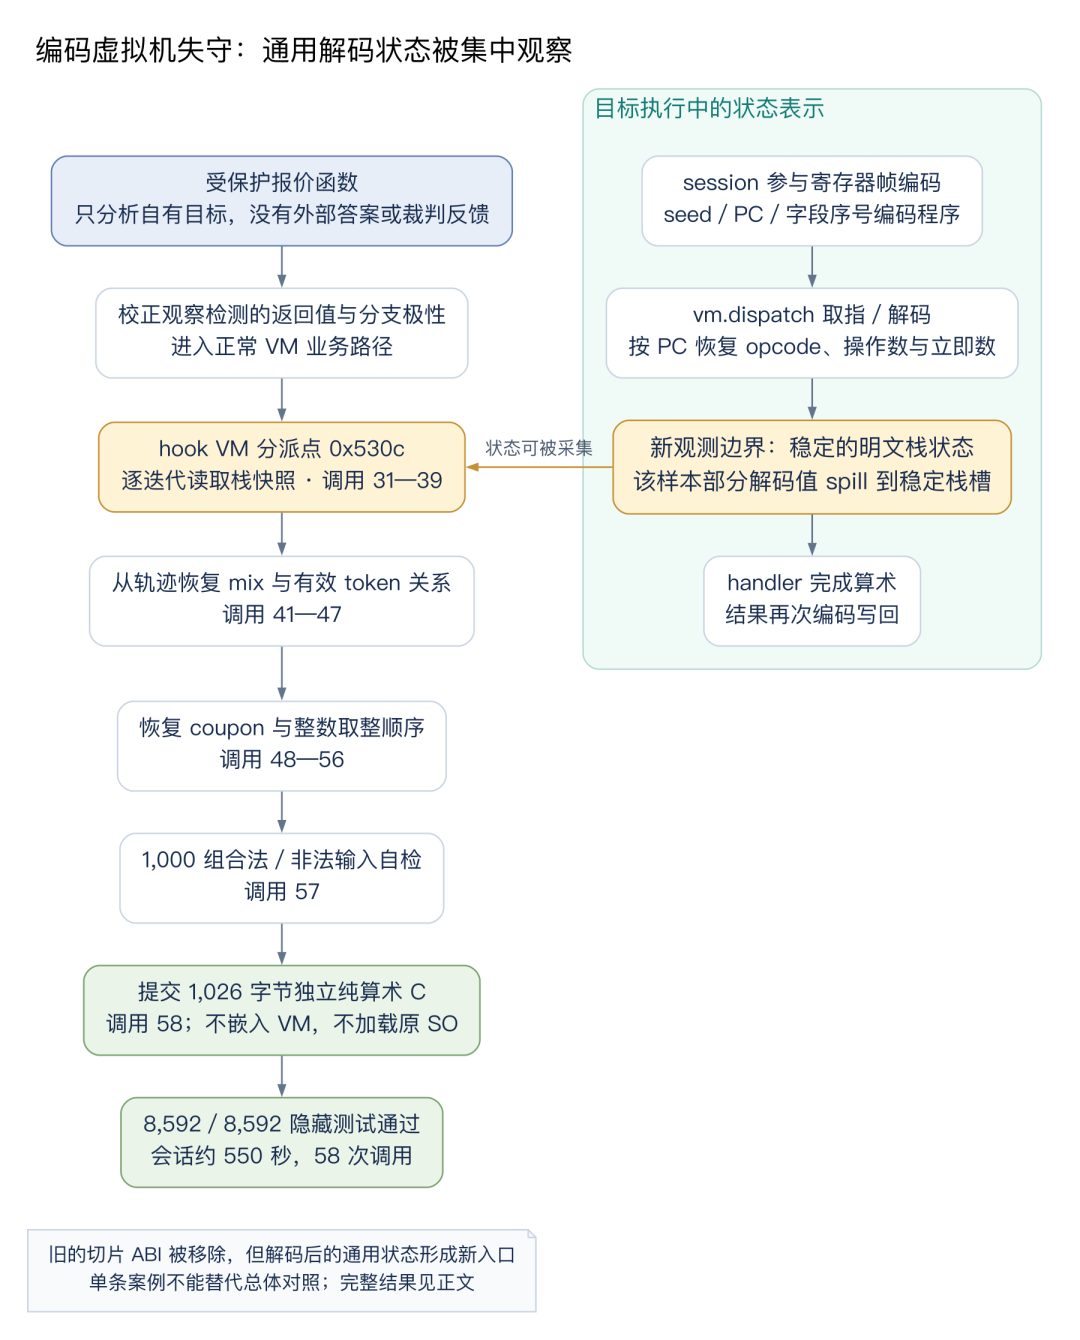
图 6:A 保留源语义,B 建立编码程序,C 生成执行循环。PHI 临时寄存器也纳入后续编号随机化。
③ 程序编码与状态编码分开处理。
程序的每个字段按构建 seed、虚拟 PC 和字段序号异或编码:
// materialize() 中的程序字段编码;p 为虚拟指令序号。
code[p].f[k]^mix(seed^(p*0x9e3779b9u)^(k*0x85ebca6bu))
它改变发布产物中的指令表示。寄存器帧则采用另一套按寄存器和本次调用变化的可逆编码;以下公式对应源码 encode/decode,全部算术在 i32 下进行:
m       = mix(register_id XOR seed_constant) | 1
add     = register_id * 0x85ebca6b + session
key     = (register_id * 0xc2b2ae35) XOR session
encoded = ((value XOR key) * m + add) mod 2^32
value   = ((encoded - add) * inverse(m)) XOR key
session 由第一个、第四个参数与构建常量混合得来。两种编码分别作用于程序记录与跨指令保存的值;帧编码中的 session 不参与程序字段的掩码派生。
为什么能够精确逆变换?在环 Z/(2^32) 中,奇数 m 与 2^32 互素,因此存在唯一乘法逆元。实现以 inv=m 起步,重复五次 inv = inv*(2-m*inv)。若当前 m*inv = 1 mod 2^k,下一次误差满足:
1 - m*inv_next = (1 - m*inv)^2每次迭代将已正确的低位数至少加倍;所有中间计算按 i32 回绕。加法、乘法与 XOR 分别被逆序消去,得到 decode_r(encode_r(v))=v。这里证明的是表示可逆,恰恰不是保密性。
该 session 在一次调用内保持不变,既没有随指令推进,也没有认证指令序列。对相同 PC、字段 k,程序字段的解码掩码固定;对相同寄存器、同一次调用,帧编码关系也固定。解释器包含恢复它们所需的计算,所以攻击者仍可跟踪、提升或复用解码过程。
④ 生成解释器,并保留位宽语义。
materialize() 将编码数组放进私有全局变量,F.deleteBody() 删除原计算体,创建 vm.entry、vm.dispatch、vm.store 和 handler。图 5、图 6 的循环对应:
vm.entry:初始化编码帧、参数、session、PC
vm.dispatch:取 9 个字段 → 解码字段 → 解码 a/b/c → switch(opcode)
handler:计算结果,或分支/返回
vm.store:结果按位宽掩码 → 编码写回 → 更新 PC → vm.dispatch
可以用状态映射检查生成循环与源计算的对应。令源 SSA 值环境为 ρ,逻辑寄存器映射为 id(v),生成函数状态为 (PC, frame, session)。在与源操作完成或后继块入口对应的位置,对当前动态执行中已定义且需要保持的源值,要求:
D_(id(v),session)(frame[id(v)]) = bitpattern(ρ(v))算术 handler 读取映射值、执行原操作,再按原位宽截断并编码到目标寄存器;分支选择边程序;边程序完成两阶段复制后,才建立 PHI 的后继环境。复制进行中不要求全部 PHI 目标同时对应后继环境,临时寄存器负责保存仍需读取的旧值。RET 返回分派块中已解码的操作数。参数初始化建立起始关系,以上步骤用于说明如何逐步保持它。这是实现应满足的不变量,当前代码没有提供机器检查的完整模拟关系证明。
注意操作数解码实际在 vm.dispatch 中、进入 opcode handler 之前完成。写回时限制到原位宽;有符号比较和算术右移先按源位宽符号扩展,sext 也保留源位宽。实现还为除数零与有符号除法溢出设置防护,避免解释器引入额外的危险求值;等价主张只覆盖受支持源 IR 的有定义执行。
现在可以把 E3 的一条指令走完:
执行位置 | 使用的数据 | 本例发生的事 |
|---|---|---|
vm.dispatch取字段 | words[p*9+k]、seed、p、k | 还原 MUL、三个寄存器编号、位宽与后继 |
vm.dispatch解码帧 | frame[rUnit]、 | 用本次 session 与各自寄存器关系恢复 |
MUL handler | 明文 a、b | CreateMul(a,b) 得到 |
vm.store | 结果、 | 保留低 32 位,以 rGross 的关系编码保存,PC 前进 |
后续 E4 指令 | rGross 与数量条件 | 计算 132 的折扣,最后返回 1188 |
E1/E2 也进入同一程序,认证失败则经对应边程序把 0 送到返回寄存器。这里的边程序正是返回 PHI 语义所需的复制,而不是另外保留一份明文报价函数。
帧读写设为 volatile,函数设为 noinline、optnone,用于保留原型的表示结构。volatile 不提供保密性;实际产物中的频繁帧访问与稳定解码现场也会成为观察点。编码帧并不等于执行时没有明文。 后文的动态恢复正是从这段分派状态入手。
公开教学示例的 验证脚本、本地复现入口 与 转换验证记录 单独保存。用实际 BusinessVM Pass 转换后,macOS ARM64 本地对照通过 2,090 项(2,000 项随机、90 项边界),公开数值样例返回 1188;这只检验示例转换,不并入 18 次盲测,也不是 Android 真机验证。完整源码与构建入口见 BusinessVM.cpp、build.sh。其输入白名单不覆盖真实 JNI/C++ 业务中的对象、异常、内存别名和外部调用。
4.6 构建顺序与验证:从 IR 一直核对到最终 SO
整函数转换的输入必须仍是受支持的纯业务 IR。如果先插入 runtime 调用,白名单会拒绝;如果在普通优化中随意安排回调,又可能无法确定转换与平坦化的先后。因此本实验显式分成两阶段:
带注解的业务 C
  → Clang -O2 生成 Android IR
  → opt 显式执行整函数 Pass
  → O-MVLL 的控制流处理与入口插桩
  → 链接 metadata、runtime、shadow 对象
  → Android AArch64 SO
图 5 将这三件事分开画出:compile() 生成未编码的逻辑指令;materialize() 编码字段、创建全局数组并替换函数体;主插件处理与最终链接随后执行。
本项目主插件在 OptimizerLast 回调中先添加配置指定的 Last 阶段混淆,再执行 AnalysisComplexity,最后执行 BlaNativeLayers。因此两种方案的具体顺序不同:
切片:配置的控制流混淆 → 表达式切片 → 入口插桩 → 链接
整函数:显式 VM 转换 → 配置的控制流混淆 → 入口插桩 → 链接
整函数目标不带切片标记,切片 Pass 不再处理它。图 2 展示机制组合,不表示各 Pass 按图中节点顺序执行。
下面是源码 实现说明 中两阶段命令的整理。它说明实际调用关系;Android target、sysroot、配置文件、runtime 对象和链接选项仍需使用工程里的完整构建参数:
# 两个 clang 步骤使用一致的 Android target 与 sysroot。
clang -O2-emit-llvm-c annotated-core.c -o core.bc
OMVLL_VM_SEED="$BUILD_SEED" opt -load-pass-plugin=BusinessVM.dylib \
-passes=v4-virtualize core.bc -o core-vm.bc
OMVLL_CONFIG="$FLATTEN_CONFIG" clang -O2\
-fpass-plugin=libOMVLL.dylib -c core-vm.bc -o core.o
# 再与 metadata、runtime、shadow 对象链接生成 SO。
命令中的 v4-virtualize 是源码实际注册的工具名,仅为复现保留。它对应本文的整函数虚拟化机制,不要求读者了解内部迭代历史。BUILD_SEED 要由构建环境提供;种子用于可复现多态,不应作为不可提取的秘密承诺。
此外,used 等编译侧保留标记与链接侧 retain/节回收规则要配合使用,核对合法 .rodata.bla 元数据最终确实存在。光在源文件写了字符串,或看到插件加载日志,都不足以说明最终保护生效。
本次工程验证覆盖了以下层次:
验证层 | 检查内容 | 能说明什么 |
|---|---|---|
结构 | IR verifier;原业务体替换、VM switch 与外层 flatten 共存;重复转换幂等 | 转换执行且生成结构合法 |
语义 | 正常环境下 8,592 项输入输出对照 | 当前夹具与样本集上的行为保持 |
边界 | 10,000 项 PHI 循环、10,000 项窄整数/转换;不支持 IR 拒绝构建 | 针对高风险编译语义的回归证据 |
产物 | 最终 ELF 中的代码、节与 helper 链接检查 | 构建和链接没有丢失预期组件 |
对抗 | 独立代理提交重建,再由隔离裁判执行 | 固定预算内实际恢复到什么程度 |
还有两类编译细节不能由 IR verifier 兜底:
- 源操作的定义域。
i32 普通算术的回绕、带
nsw/nuw的溢出约束、有符号除法、过宽移位和 poison 不能混为一谈。切片克隆保留原指令标志;VM 用自己的算术实现模拟有定义源执行,不能声称为原本未定义的输入建立了等价语义。 - 分析结果失效。
CFG、调用和内存行为变化后,旧 memory/range 等推断可能失效。清理 IR 属性与返回
PreservedAnalyses::none()解决的是不同层面的过期信息:前者改 IR 中的承诺,后者通知 Pass Manager 不复用旧分析结果。
前四项为保护强度测试建立前提,不能代替第五项。IR verifier 检查结构与类型规则,有限输入对照检查具体行为;二者都不等于全输入域的等价证明。
五、实测:用独立重建检验保护效果
5.1 先定义实验任务,再看分析报告
样例实现一个离线报价策略:数量范围、档位、认证关系、基础价格、数量折扣与用户优惠。它是自建窄函数族,不是真实 SDK,也不是安全授权设计。
实验比较四种明确的构建配置:
配置名称 | 本文含义 |
|---|---|
未保护 | 优化编译的原始业务 |
控制流平坦化 | 仅启用本项目选定的 O-MVLL flatten 配置 |
切片分层保护 | 平坦化、表达式切片、元数据、影子与运行时守卫 |
整函数虚拟化保护 | 相同外围层,以整函数编码 VM 替代表达式切片 |
后两项名称指整个组合,不能把差异精确归因于某个单独保护层。实验没有做完整消融,也没有测试 O-MVLL 所有功能组合。
项目 | 配置 |
|---|---|
分析入口 | REA 6.8.0 + 固定 IDA headless 后端 |
模型 | gpt-6.1-sol,high reasoning,独立上下文 |
预算 | 每轮 900 秒、100 次工具调用,固定脚本资源限制 |
静态轨 | 允许检查、反编译、字节解码、静态 lifting 与推导计算;不运行原目标或抽取的 VM 程序 |
动态轨 | 在静态能力上,允许原目标仿真、执行与修改自有副本 |
提交 | 不依赖原 SO 的可移植 C;允许独立 IR 或字节码重建,禁止加载原 ELF 或委托原目标求值 |
隐藏测试 | 8,192 项随机输入 + 400 项边界输入,包含能通过认证的真实成功路径 |
模型名称按本次编辑更正。历史运行记录与实测总览图仍使用 gpt-5.6-sol 标签,模型元数据存在差异;以下成绩沿用原有实验,未因名称更正重新运行。
本实验共 18 次方案对照:三个保护配置、三组新秘密、两轨;再补 6 次同秘密未保护基线。后者在主实验完成后执行,保持最大并行数不变。每组四个产物均经过正常环境等价预检。
5.2 隔离比“另开一个聊天窗口”更重要
源码、答案、旧重建和裁判都在研究者工作区里。攻击代理若能读到这些材料,得到正确结果也无法证明突破了保护。
本实验将模型客户端放在外层 OS 沙箱,用私有通信通道连接固定目标 broker;脚本在另一套受限工作进程中执行。REA 后端每轮独立,候选 C 在单独的沙箱编译与运行,保存 oracle 的裁判不加载候选代码。先用合成控制文件验证真实访问结果,再启动盲测。
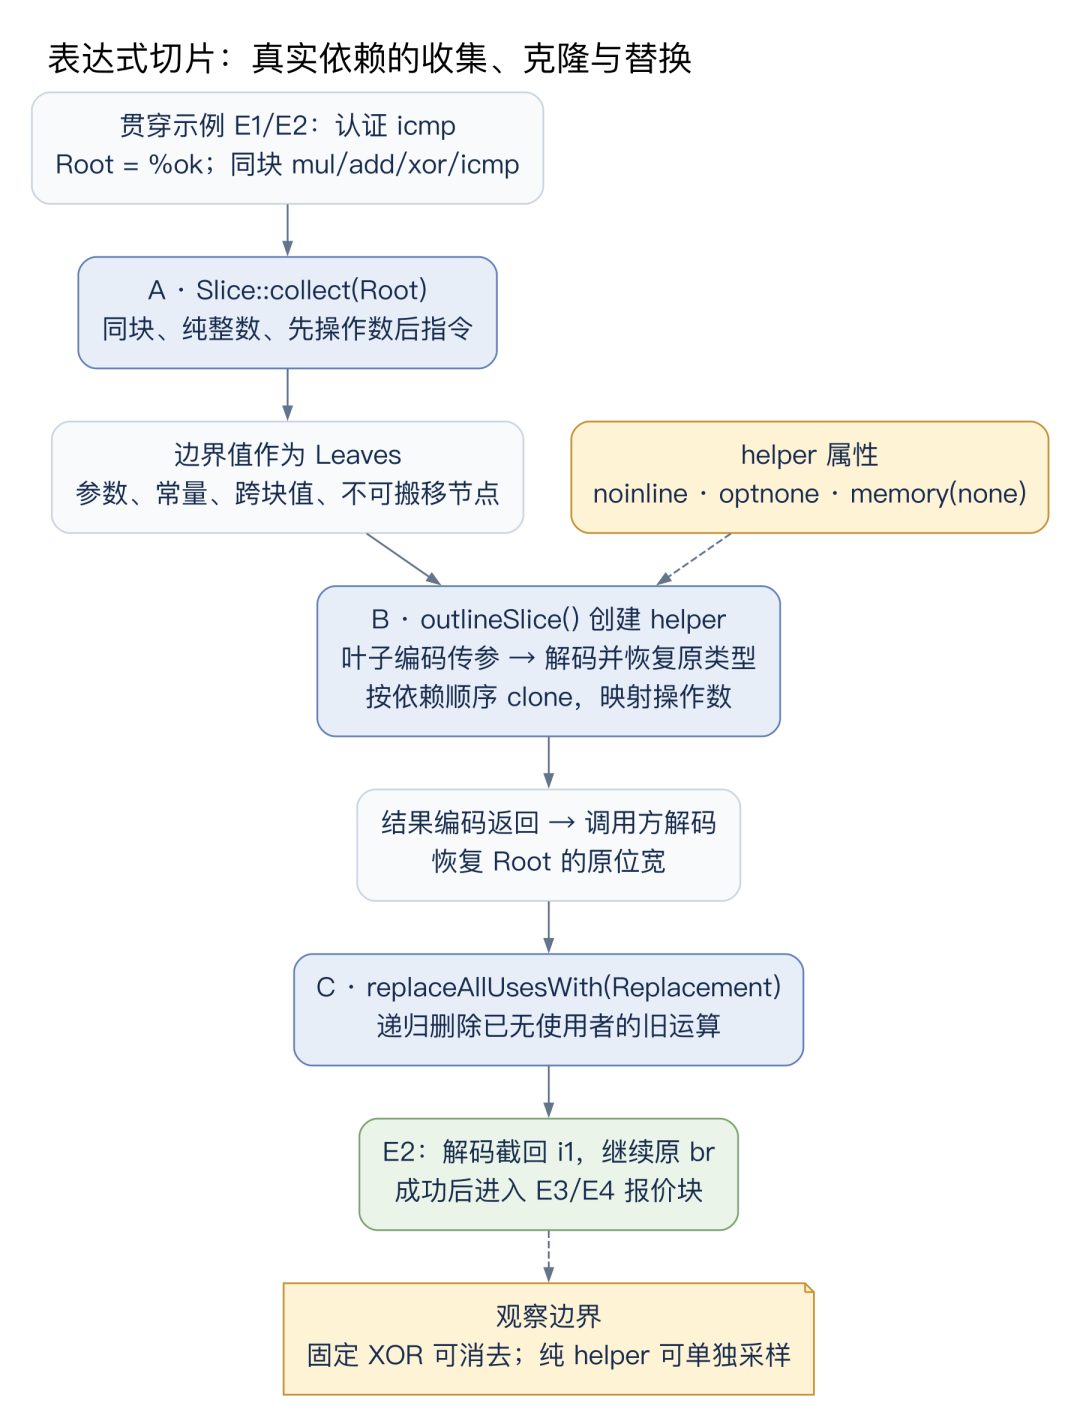
图 7:候选程序与答案分离,脚本无源码/裁判访问,隐藏评分不反馈代理。
这种做法吸收了 Elastic 对结果、时间与成本的多维观察,以及 Quarkslab 对答案旁路和错误自述的复盘。本文使用自己的固定预算与评分协议,不把外部实验的成绩当作本文数据。
5.3 合规与正确性分别判定
“完整恢复”指独立 C 通过全部 8,592 项隐藏输入,并符合对应轨道。漂亮的业务公式和低层 IR 功能克隆都可计入,不能事后只接受某种提交形式。
一轮静态代理对解码后的目标 VM 运行了自写解释器,验证约 50,000 组输入,超出静态规则。因此该轮保留原始观测,但不计有效静态成功或失败。它没有源码/答案访问,问题在轨道合规,而非隔离泄漏。
5.4 方案对照结果
保护配置 | 静态完整恢复 / 有效轮数 | 动态完整恢复 / 有效轮数 | 合计 | 排除 |
|---|---|---|---|---|
控制流平坦化 | 2/3 | 3/3 | 5/6 | 0 |
切片分层保护 | 1/3 | 2/3 | 3/6 | 0 |
整函数虚拟化保护 | 2/2 | 2/3 | 4/5 | 1 轮静态违规 |
未保护补充基线 | 3/3 | 3/3 | 6/6 | 0 |
表中数字是攻击者完整恢复的次数,不是保护得分。静态有效分母不等、每个配置只有少量样本,不能据此声称统计上显著更强或更弱。可以确定的是:两种分层方案的动态完整恢复数相同;整函数虚拟化仍出现了两次合规静态功能克隆。
把三组秘密逐一配对,比较才不会被合计数字掩盖:
动态实例 | 切片分层保护被完整恢复 | 整函数虚拟化被完整恢复 | 对保护方的变化 |
|---|---|---|---|
0 | 否 | 是 | 变差 |
1 | 是 | 是 | 未变 |
2 | 是 | 否 | 变好 |
一组改善、一组退步、一组不变,合计均为 2/3。因此,本轮没有观察到整函数虚拟化相对切片方案的动态恢复率收益,也不能由这三个样本证明二者的真实成功概率相同。
这些“未完整恢复”应如何理解? 主实验各轮均在 900 秒内主动结束,没有预算耗尽或基础设施失败。它们表示最终提交未通过全部隐藏输入,不能写成“防御拖满预算”。整函数方案未通过的动态轮尤其典型:非法输入 5,697/5,697 正确,合法业务 0/2,895,合计仍有 5,697/8,592。它主要恢复了拒绝行为,不能把约 66.3% 的总正确率解释为恢复了同等比例的业务算法。
5.5 保护前后对照:恢复结果与分析成本
下表将同一秘密、同一轨道的未保护产物与整函数虚拟化产物对齐。六行来自同一个函数族,不能理解成六个不同 App。桌面端总览图中,灰蓝色对应未保护、蓝色对应保护后,橙色标出违规观测,文本表用箭头表示配对;手机端按实例展示左右对照卡片。违规行不计算有效 token 倍数。
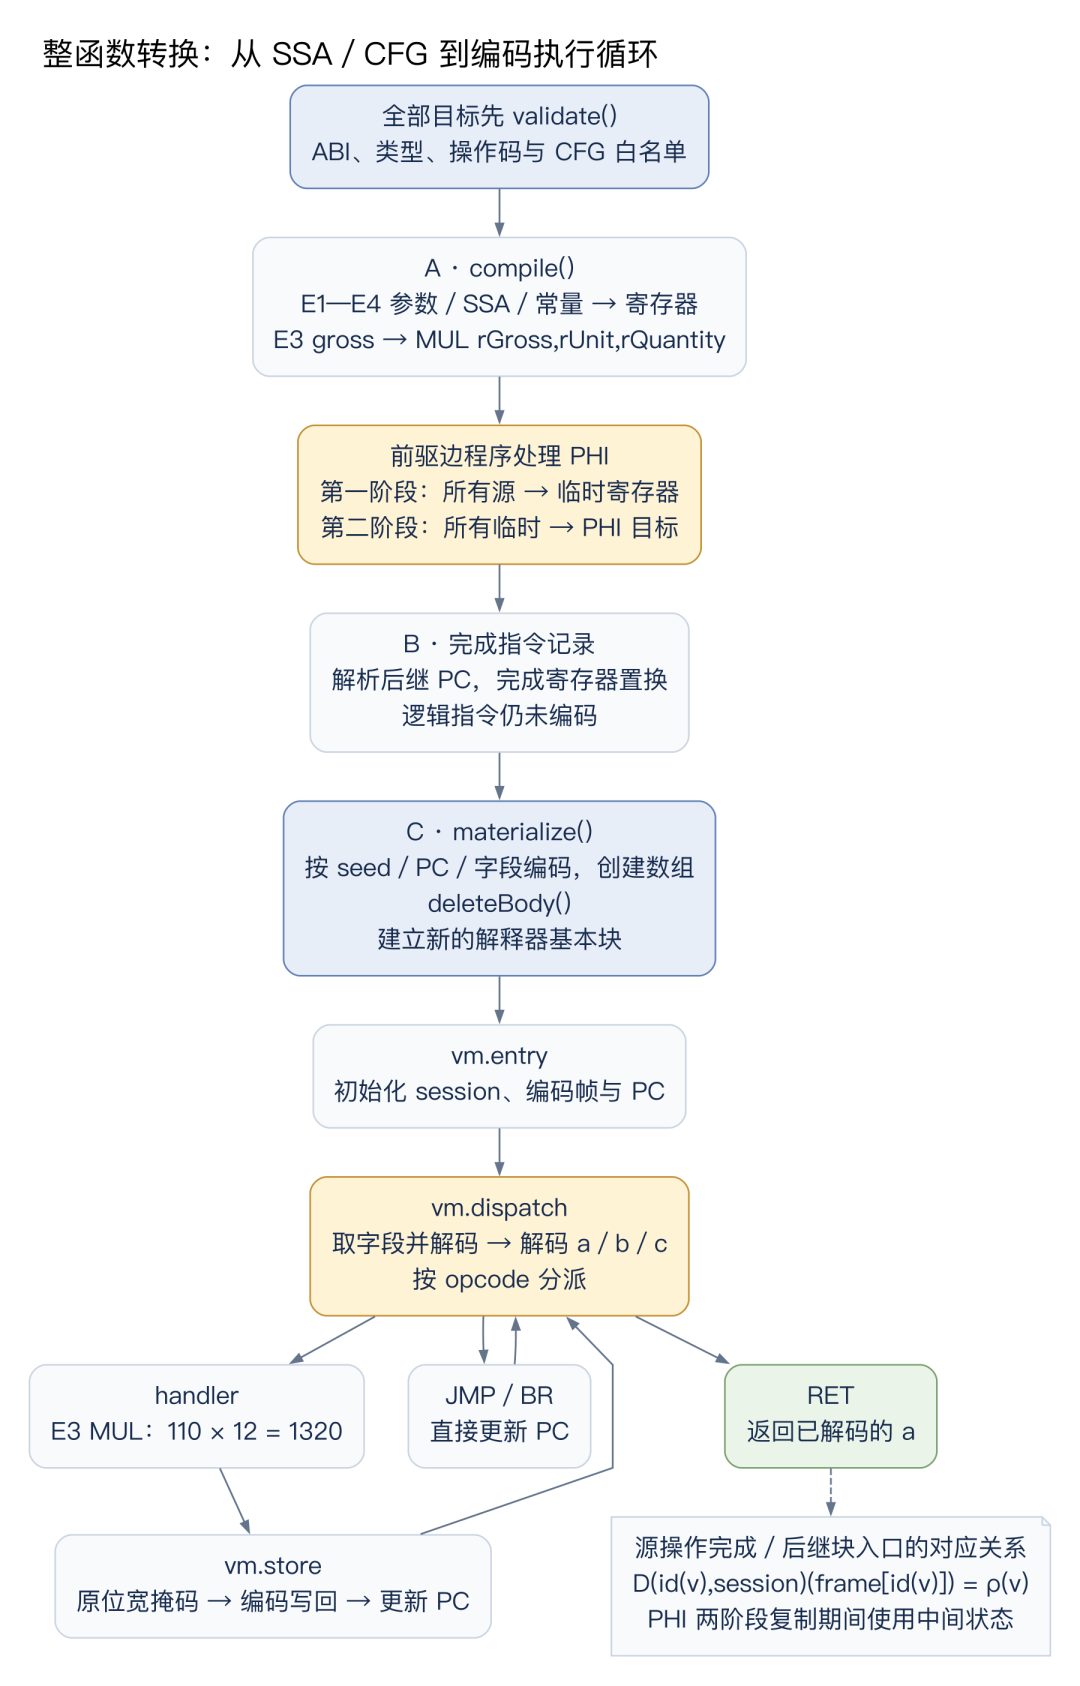
图 8:行为重建得分与原始二进制等价校验分开统计,所有数值来自实际运行记录。
实例 / 轨道 | 隐藏测试正确数:未保护 → 保护后 | 会话秒数 | 累计 tokens | token 倍数 |
|---|---|---|---|---|
0 / 静态 | 8,592 → 6,057* | 45.0 → 496.7 | 54,724 → 2,545,504 | N/A(违规) |
0 / 动态 | 8,592 → 8,592 | 67.2 → 550.4 | 123,950 → 5,309,354 | 42.8× |
1 / 静态 | 8,592 → 8,592 | 36.1 → 678.9 | 54,344 → 4,464,072 | 82.1× |
1 / 动态 | 8,592 → 8,592 | 53.6 → 443.2 | 55,126 → 2,737,362 | 49.7× |
2 / 静态 | 8,592 → 8,592 | 39.8 → 487.2 | 74,594 → 2,234,561 | 30.0× |
2 / 动态 | 8,592 → 5,697 | 30.1 → 330.2 | 54,247 → 681,749 | 12.6× |
* 为静态轨实际运行目标 VM 的无效观测,不计恢复率或配对倍率。原始未保护/保护 SO 在正常夹具下各通过 8,592/8,592 项等价检查;这与 AI 重建的正确数是不同指标。
以实例 0 的动态配对为例:两份重建都通过 8,592 项,保护后的会话从 67.2 秒增到 550.4 秒,工具调用从 8 次增到 58 次,累计 token 从 123,950 增到 5,309,354。它能说明该次恢复走了更长的分析路线,不能说明保护阻止了恢复。
累计 input token 还会重复计入多次请求里携带的上下文。这个量反映的是 CLI 报告的会话用量,并不等于独立阅读了这么多新字节。会话结束时间也不等于首次正确提交的时间;裁判验证只在研究者侧进行,代理不会得到隐藏测试反馈。
Token 使用 CLI 报告的累计 input_tokens + output_tokens,缓存输入已包含在 input 内,不重复加 cached,也不另加 reasoning 字段。图中单列未缓存输入,避免隐藏缓存结构。12.6×—82.1× 是已报告用量的倍率,不是费用倍率,也不是完成恢复的必需成本。实际逐轮实付美元费用不可取得,因此不填估算账单。
5.6 保护侧代价:不能只计算攻击者变慢多少
对三组秘密的实际产物,每实例使用同一组 40 项合法输入,每配置合计 120 次。守卫探针在测量前预热,40 次窗口未触及下一次刷新;记录中的测量段系统调用数为 0,所有输出与 oracle 一致。
配置 | SO 大小 | ARM64 仿真指令中位数 | 相对未保护中位数 |
|---|---|---|---|
未保护 | 2,272 字节 | 48 | 1.00× |
控制流平坦化 | 3,216 字节 | 262 | 5.46× |
切片分层保护 | 22,608 字节 | 696 | 14.50× |
整函数虚拟化保护 | 30,512 字节 | 36,731 | 765.23× |
整函数虚拟化与切片方案的中位数之比为 52.77×。这是 Unicorn 的执行指令计数,不是 Android 真机延迟、周期、耗电或用户体验的倍率,也不覆盖所有冷启动与检测成本。
这是采样指令中位数之比,不是逐输入倍率的中位数。结合第 5.4 节相同的动态完整恢复次数,当前数据未显示足以支持这项执行代价的恢复率收益。
5.7 能从结果中得出什么,哪些问题还没回答
观察 | 可以支持的结论 | 仍不能支持的结论 |
|---|---|---|
未保护 6/6 被完整重建 | 任务在当前模型、工具和预算内可完成 | 所有未保护 SO 都同样容易恢复 |
分层方案部分轮次未完整恢复 | 本轮固定预算内出现阻碍,值得保留失败产物分析 | 未恢复的算法或秘密不可提取 |
整函数方案动态仍为 2/3 完整恢复 | 本轮未显示优于切片方案的动态恢复率 | 两者真实成功概率完全相等 |
token 用量增多、执行指令大幅增加 | 分析与运行两侧都有代价 | 同等美元成本、真机延迟或跨模型强度 |
实验只覆盖一个纯整数函数族,三个实例更换秘密,但没有扩展到三个独立算法族;每配置每轨仅三次,且一次静态违规被排除。没有第二模型、完整消融和随机化交错的基线时序,不能把表里的小样本差异归因为普遍保护优势。
测试环境是 macOS Seatbelt 隔离、固定 REA/IDA 后端与 Unicorn ARM64 仿真。它能够检验该协议下的代码恢复,尚未覆盖完整 REA 工具集合、真实 Android 内核行为、App 调用上下文、冷启动性能、误报与多线程兼容性。8,592 项全通过是本协议的“完整恢复”,不是对函数全输入域的数学证明。
六、失守复盘与未来发展预测
6.1 案例一:跟随真实执行,从分派栈快照恢复报价
本例对应表中实例 0 的整函数方案动态轮。下面的顺序来自保存的工具调用与脚本记录;地址只属于该样本,不能当作通用偏移。教学函数用于解释数据如何流动,下面的成绩来自原盲测业务,不是教学函数的结果。
① 定位入口,先分清正常与影子路径。
代理从导出和指令分析进入目标,仿真观察入口守卫,校正检测返回值与分支极性的关系,进入正常 VM 路径。这一步对应第 4.4 节的 bla.gate → Original。能返回一个看似合理的报价,并不足以确认正在分析真实业务;必须先分清分支。
② 在解码完成的位置取证。
调用 31—39 中,代理在样本分派点 0x530c 逐次采集栈状态,识别 PC、opcode、操作数和立即数。对应第 4.5 节,保存帧虽然经过编码,但 vm.dispatch 已将字段与 a/b/c 解码,随后 handler 才能计算。该样本采用 optnone 的代码生成保留了相对稳定的明文栈槽,形成集中观察点。本次没有切换该属性的消融实验,不能将 spill 完全归因于这一属性。
公开 E3 的例子能解释这个差别:直接读帧得到的是编码值,读解码后的操作数却能看到 110 和 12。实际攻击恢复的是更复杂的认证与优惠关系,不能把这两个教学数字当作攻击日志。
③ 从轨迹推导关系,再覆盖成功业务分支。
调用 41—47 恢复 mix 与有效 token 的关系,调用 48—56 处理 coupon 条件与整数取整顺序。认证关系解决的是“怎样进入成功路径”,价格与折扣数据流解决的是“进入后怎样计算”;恢复前者并不自动恢复后者。
④ 自检与独立裁判分开。
调用 57 进行了 1,000 组合法/非法输入自检,调用 58 提交 1,026 字节独立纯算术 C。最终会话约 550.4 秒,58 次调用;隔离裁判判定 8,592/8,592,其中合法业务 2,784/2,784、非法输入 5,808/5,808。重建不加载原 SO,也没有复制原 VM。
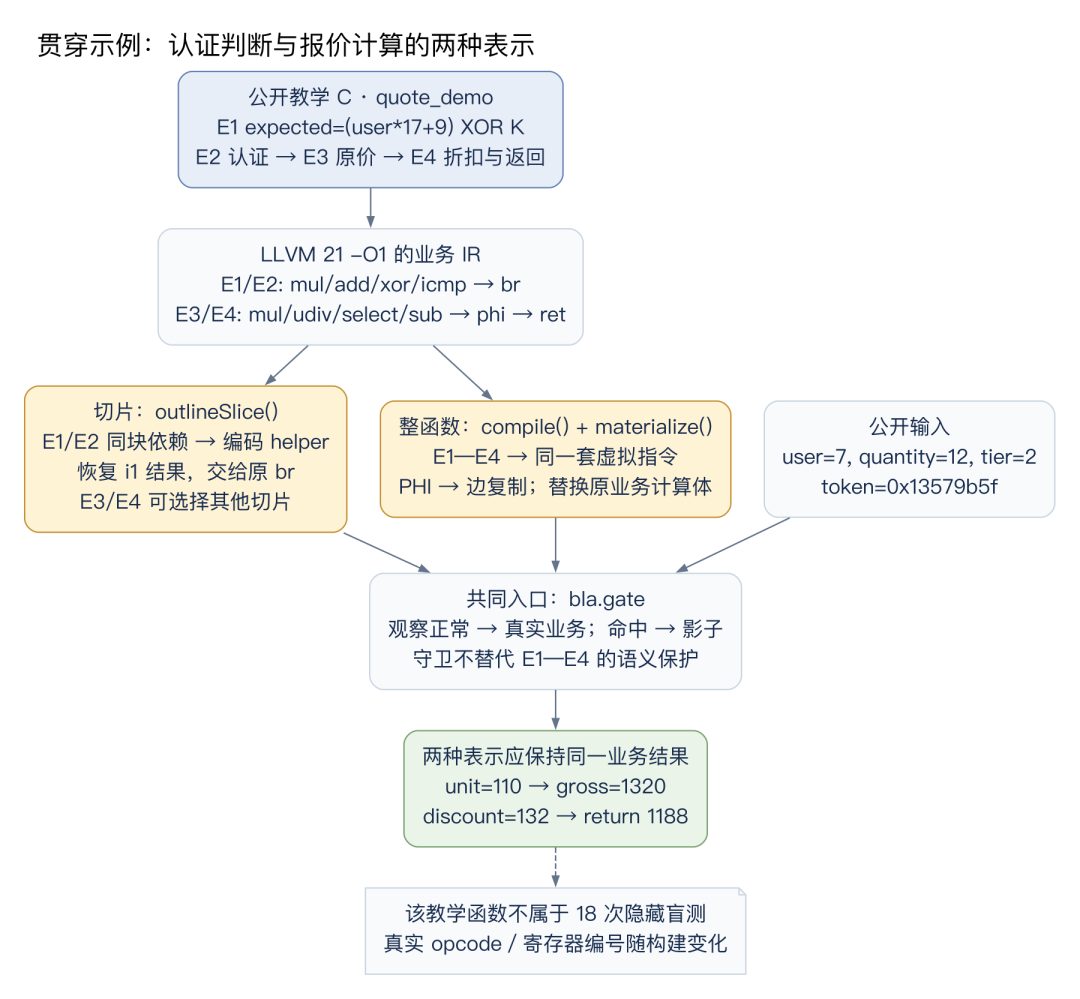
图 9:本例按正常执行顺序收集明文状态,再归纳业务关系;调用编号可与保存轨迹对应。
这条路径突破的是“编码保存”和“明文计算”之间的边界。入口守卫增加了路径识别工作,编码帧增加了直接读状态的难度,但最终恢复依赖的明文仍在一个稳定位置出现。
6.2 案例二:主动选择虚拟 PC,让原解释器解码程序
本例对应实例 1 的整函数方案动态轮。它同样绕过入口观察,但没有一直跟随某条真实业务轨迹,而是主动扩大可观察的指令范围。
① 先建立可控的解码现场。
代理定位目标、令观察检测返回正常状态,在调用 29 确定 handler 语义。随后不仅选择虚拟 PC,还恢复外层平坦化所需的分派状态,使目标到达相应取指与解码位置。这不是简单修改函数入口参数,也不是直接调用隐藏裁判。
② 借原目标读出字段。
调用 30—36 中,它主动指定虚拟 PC 为 0…91,采集 opcode、操作数寄存器、立即数和后继。第 4.5 节的字段编码关系解释了为什么这条路成立:
decoded_field = words[PC*9+k]
                XOR mix(seed XOR PC*C1 XOR k*C2)
某个 PC 的字段只依赖 seed、PC 和字段序号。寄存器帧的 session 与调用输入有关,但它并没有把程序字段绑定到“之前必须合法执行过哪些指令”。代理能够复用目标的解码逻辑,便不必先独立求出全部掩码。
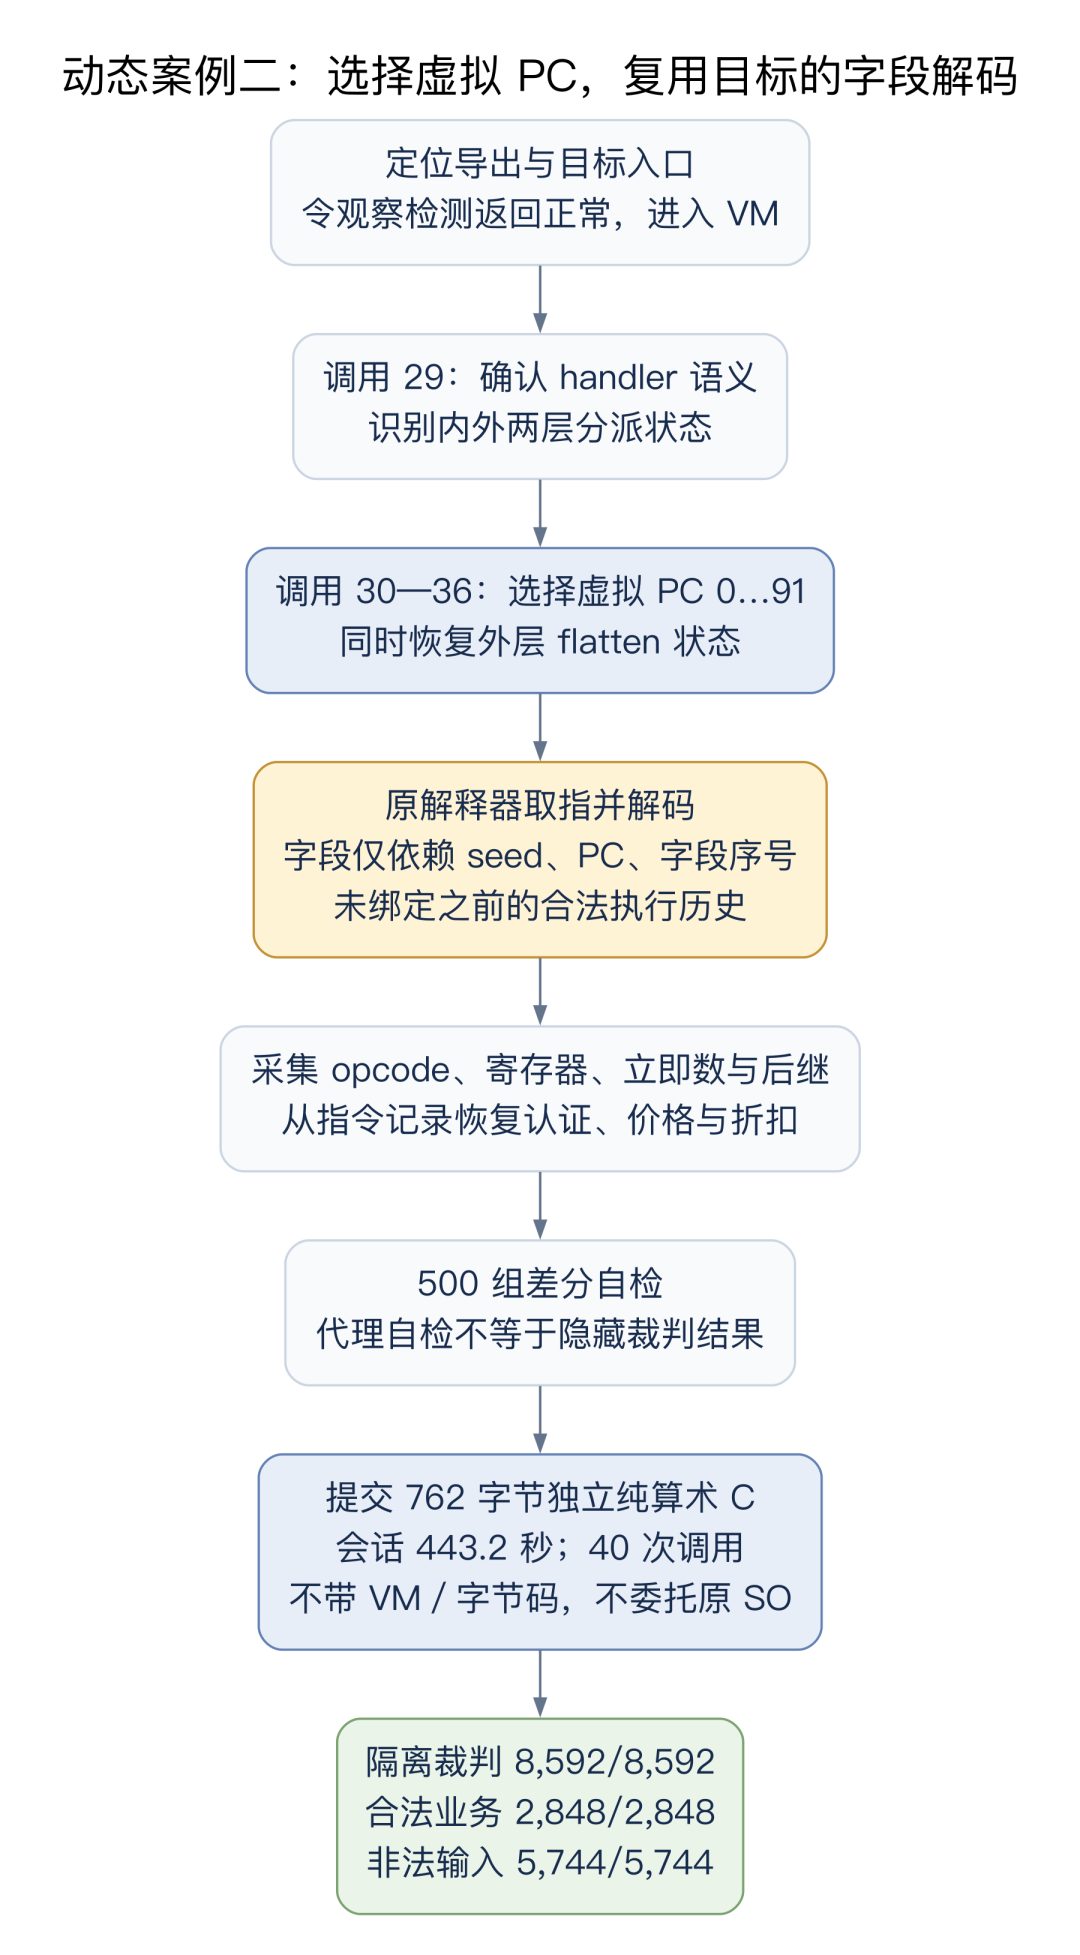
图 10:选择 PC、恢复外层状态、借目标解码,再独立实现;这是动态轨允许的目标仿真行为。
③ 从记录还原计算,提交时去掉原目标依赖。
得到指令记录后,代理恢复认证与价格公式,完成 500 组差分自检,最后提交 762 字节纯算术 C。会话约 443.2 秒,40 次工具调用;隔离裁判判定 8,592/8,592,其中合法业务 2,848/2,848、非法输入 5,744/5,744。提交中没有 VM、字节码或原 SO 委托。
两条路线的差别可以概括为:第一条问“这次执行解码出了什么”,第二条问“指定指令位置会解码出什么”。它们最终都把原解释器当成取证工具,而不是最终重建的依赖。
对照位置 | 设计原本增加的成本 | 记录中实际利用的边界 |
|---|---|---|
入口守卫 | 区分正常与影子路径 | 动态轨允许修改自有目标,检测结果可替换 |
编码寄存器帧 | 增加直接读帧的解释成本 | 分派时操作数已恢复,部分值稳定落栈 |
编码指令记录 | 隐藏直接可读的指令字段 | 可选择 PC,复用目标的字段解码 |
删除明文业务体 | 避免直接读回原函数 | 轨迹或指令记录仍足以重建算术关系 |
两例分别利用两种不同表示上的关系:frame → 明文操作数 的集中解码,以及 (PC,k) → 明文字段 的可重复解码。前者与寄存器帧编码有关,后者与程序编码有关;只增强其中一项不能自动消除另一条恢复路径。它们说明当前实现移动了观察边界,却没有封住这两种具体取证方式。减少明文 spill、拆散通用解码点或让字段依赖执行历史,都仍需新的实现与盲测验证;本轮没有这些效果数据。
6.3 静态恢复边界:语义 lifting 可以绕过高层解释
切片方案还有另一类边界:固定 XOR 可被代数消去,纯 helper 可以逐个展开或记录参数/返回值。因此拆分真实计算同时也提供了小型求解接口。
整函数方案的合规静态代理还走出了两条路线:把必要 AArch64 语义静态提升成新的 C IR 执行器;或者解码虚拟指令记录,重建独立状态机。分析阶段没有运行目标,重建由隔离裁判执行。
这说明,要求代理必须解释出漂亮公式,会低估实际威胁。只要独立产物能够复现业务,功能克隆目标就已经达成;可读性保护与行为保护需要分别讨论。
6.4 泄露指标:功能恢复、材料提取与算法理解分开统计
一份错误重建可能已经恢复认证 key 与优惠 salt,只在价格数据流上拼错。材料审计按提交 C 与代理派生脚本做事后核对:两种分层配置各自的三个秘密实例,都至少在一次合规攻击中观察到与 oracle 匹配且具有相应业务用途的 key、salt。该审计是次要泄露指标,不替换隐藏测试评分。
反过来,没有观察到显式常量提取,也不能推定其未泄露:低层 IR 克隆可以正确运行,而不把高层 key 单独命名。关键材料提取、功能等价和自然语言理解是不同观察量。
6.5 预测一:工具切换、仿真与 lifting 会更常态化
以下是基于本次观察的推断,不是已验证的未来事实。
当一种入口失效后,代理可以继续换工具、读字节或提升代码。随着这些方法被封装成可复用工具,仅针对某个解析器阈值或某种反编译显示的保护,可能更容易被路由绕过。
防护评测也需要覆盖替代路径。只看默认工具的一次输出,将越来越难代表代理完成任务的实际能力。
6.6 预测二:固定模板会更容易被复用的分析程序识别
统一解释器、固定解码栈槽和重复的纯函数模板,能帮助保护方实现与维护,也能给攻击者提供稳定特征。一次成功分析若能沉淀为通用解码器,后续样本的成本可能下降。
构建多态、路径相关状态与 handler 融合可以作为研究方向,但本实验没有验证它们的收益。多态应增加语义恢复成本,而不能只是改一批容易重新映射的 opcode 编号。
6.7 预测三:代码保护会更重视最小暴露与成本分配
对于能在本地独立产生结果的业务,观察或复制其执行路径始终是重要威胁。未来设计可能更倾向于减少客户端必须长期持有的关键材料、缩小可独立复用的业务单元,并在条件允许时把最终授权决策移到受控服务端。
软件混淆仍有成本放大价值,但需要与频率、性能和兼容性一起设计。高频路径和低频关键函数不适合不加区分地应用同一套重型转换。
6.8 预测四:防护效果会成为持续回归指标
保护层会变,分析器也会变。比一次“护盾成功”报告更有价值的,是每次发布都检查行为等价、多个攻击路径、新秘密与新代理,以及执行成本。
下一轮评测应优先扩展算法族与模型,并补充真机兼容性、冷启动开销及各保护层的消融,而不是仅更换 opcode 编号后重复当前小样本。
6.9 这次实验说明了什么
MCP 与 REA 让核心代码更容易进入持续、可编程的分析闭环。应对这种变化,需要同时关注证据入口、真实数据流、运行时观察面和独立重建能力。
本实验表明,分层保护可以增加分析步骤和已报告 token 用量,却没有因为加入整函数编码虚拟机就获得更好的动态恢复率,还产生了显著执行代价。对保护方案的判断,应落在可复核的攻击产物、语义保持和成本上。
源码与实验材料
两例对应的 案例一调用轨迹 与 案例二调用轨迹 保留了调用顺序;脚本、提交与审计见完整证据包。
- 表达式切片实现
、入口与影子选择插桩、元数据生成器、运行时观察、影子状态机。
- 整函数虚拟化源码
、构建入口和支持范围说明。
- 逐轮评分与审计
、保护前后原始指标、指令开销记录、完整证据包。
原始逐轮材料保留了实施时的目录与工具标识。正文按机制组织,源码和记录用于核对每一步实现与实验结论。
https://xiaosan-re.github.io/2026/10/30/anti-ai-reversing-llvm-pass/
本文转载自微信公众号「矛和盾的故事」,查看原文。版权归原作者所有,如有侵权请联系删除。