从数据治理到知识建设:企业Agent落地需要补哪些工程能力?
dbaplus社群 2026-11-02 07:15 广东
企业Agent知识建设四步法,让AI员工真正上岗
大模型越来越强,企业IT也在AI上投入了不少预算采购平台、搭建Agent,希望提高效率、改善业务结果。
但业务真正用起来,Agent还是会推荐错产品、遗漏客户信息,甚至给出前后矛盾的答案。员工需要反复核对、修改,业务团队也迟迟用不起来。最终,钱花了、人力投入了,业务结果却没有明显改善。
问题究竟出在哪里?
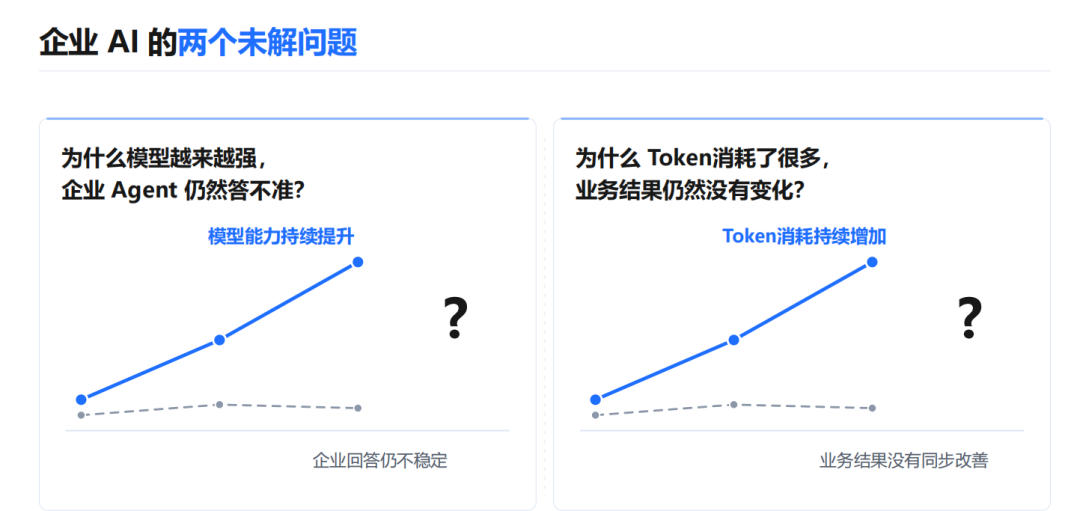
10月29日下午,在dbaplus社群联合瓴羊的直播中,瓴羊产品运营昭悦与瓴羊产品经理知毅,从一次客户增购方案的准备经历聊起,拆解企业Agent落地中容易被忽略的一环:如何把企业已有的数据、资料和经验,建设成AI能够理解、调用的业务知识,让投入真正体现在具体工作和业务效果上。
昭悦在直播中分享了一个场景:为了准备客户回访,她把客户上一笔订单、产品资料和历史方案PPT交给Agent,希望TA推荐适合客户的新功能模块,并生成沟通材料。
结果,Agent推荐的一个功能,客户早就买了;另一个功能,则属于另一款产品。已经喂了不少资料,为什么还是答不准?
上一笔订单,无法完整反映客户当前购买的全部功能;近期需求,可能藏在会议录音和客户沟通记录中;客户、产品、版本与功能之间的关系,也需要明确告诉Agent。人做方案时会自然补充这些背景,AI却未必拿得到。
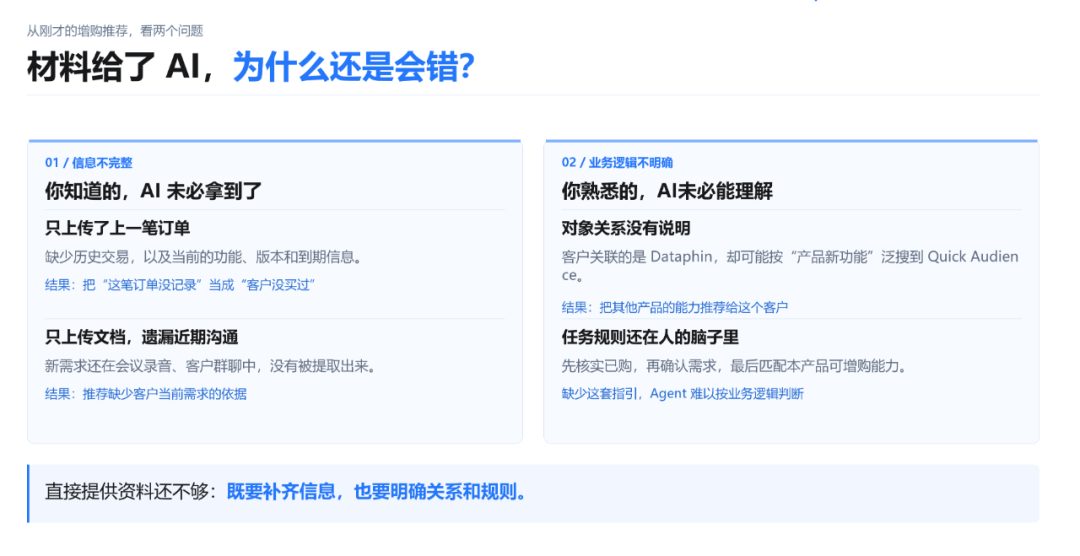
让Agent理解业务,需要把完成任务所需的事实、依据和判断规则一起准备好。
客户买过什么,是业务事实;客户最近关心什么,需要从沟通资料中提取;结合客户需求、已购功能和产品能力判断推荐方向,则涉及业务关系与岗位经验。
这也是本场直播讨论的核心:企业如何围绕具体工作,建立一套可用、可信、能够持续维护的知识体系。
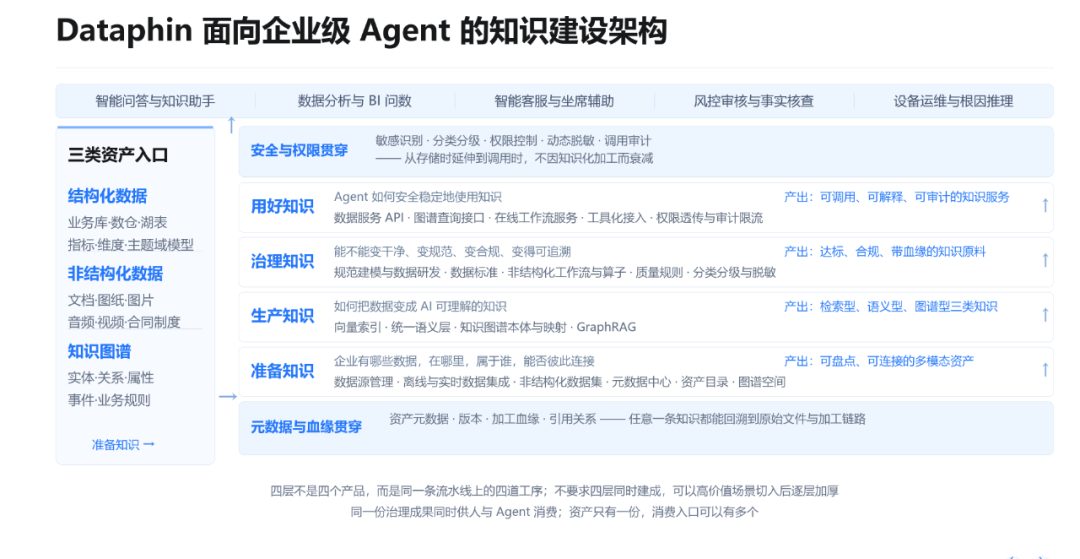
直播将建设过程归纳为四步:准备知识、生产知识、治理知识、用好知识。
起点是明确业务场景:AI员工要接住哪项工作,做到什么程度,结果由谁检验。随后围绕岗位任务梳理数据、资料和业务规则,明确来源、口径与责任人。
在知识准备环节,直播介绍了Dataphin的数据集能力,将文件存储系统与数据库关联起来,描述企业有哪些资料、资料在哪里,以及每个文件的相关信息。以合同PDF为例,文件存储提供原始地址,元数据表记录甲乙方、签约产品、项目名称、金额等信息,支持后续按业务场景进行分类、检索和管理。
针对“为什么要提前提取,不能等Agent用到时再读”的问题,直播给出了三个理由:避免不同用户、不同任务反复解析同一份文件;结合业务术语、领域知识和提取规则保留有价值的信息;提前开展质量检查、人工校正,并关联原文位置。
非结构化资料的处理,通过工作流组织起来。
直播展示的工作流覆盖通用、文本、文档、图片、音频、视频、向量化七类近50个算子,可以通过可视化配置组合处理流程。直播里举了两个例子:一个是最常见的文档处理,另一个是汽车销售录音。
比如合同解析工作流,一般包含以下步骤:解析Word、PDF文件,移除特殊字符,再通过大模型的多列输出提取所需信息。用户可以定义JSON,约束甲方、合同金额、签约产品名称、项目名称等输出字段。
汽车销售录音采用另一套处理流程:先判断音频质量,对低质量音频进行增强;随后通过ASR提取文本,对客户隐私信息进行打码;最后根据业务要求,提取竞品信息或开展SOP质检。
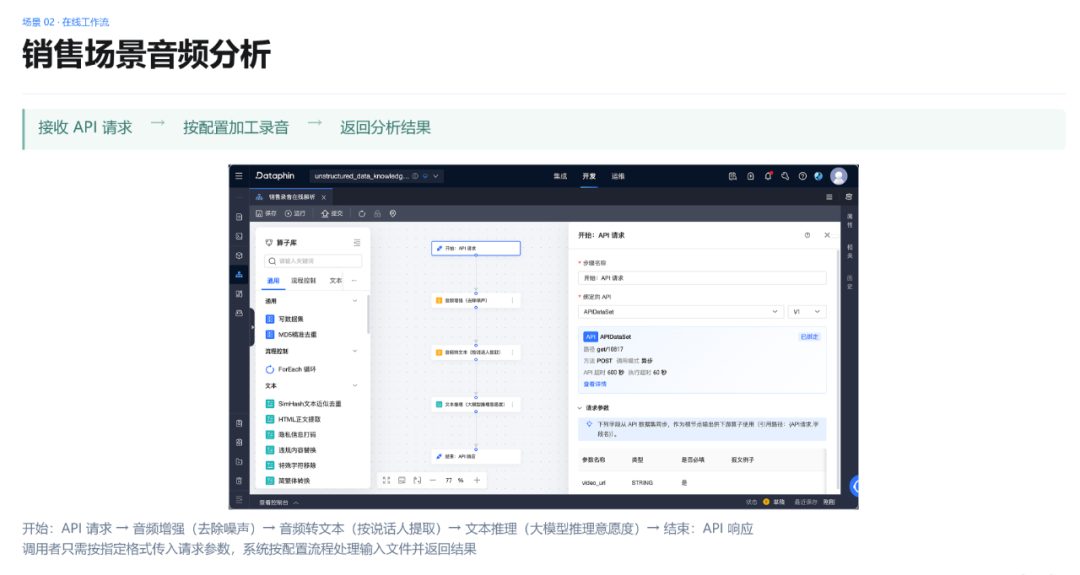
两个演示都围绕业务需要组织加工步骤:先明确希望从资料中获取什么,再配置对应的处理流程。
知识加工还需要跟随业务节奏持续运行。直播介绍了三种工作流形态:
工作流形态 | 运行方式 | 应用举例 |
离线工作流 | 定时批量运行 | 夜间处理销售录音,供主管第二天复盘 |
实时工作流 | 对接Kafka,由新数据触发 | 新录音产生后,自动分析客户需求、顾虑和竞品信息 |
在线工作流 | 通过API请求启动并返回结果 | 销售上传录音后,获取分析结果,为后续跟进做准备 |
直播同时介绍,工作流可以使用Dataphin已有的发布、运维、告警等能力,将知识加工纳入持续运行的工程流程。
内容提取之后,还要把业务对象之间的关系组织清楚。
汽车销售场景中,客户需求在录音里,车型、配置在产品资料里。Agent要使用这些信息,需要了解它们之间的关联。
直播通过汽车销售知识图谱,展示了汽车品牌、客户、购车需求、销售会话等实体及其关系。在“汽车品牌”实体中,则定义了品牌编码、品牌名称、品牌别名和简介等属性。
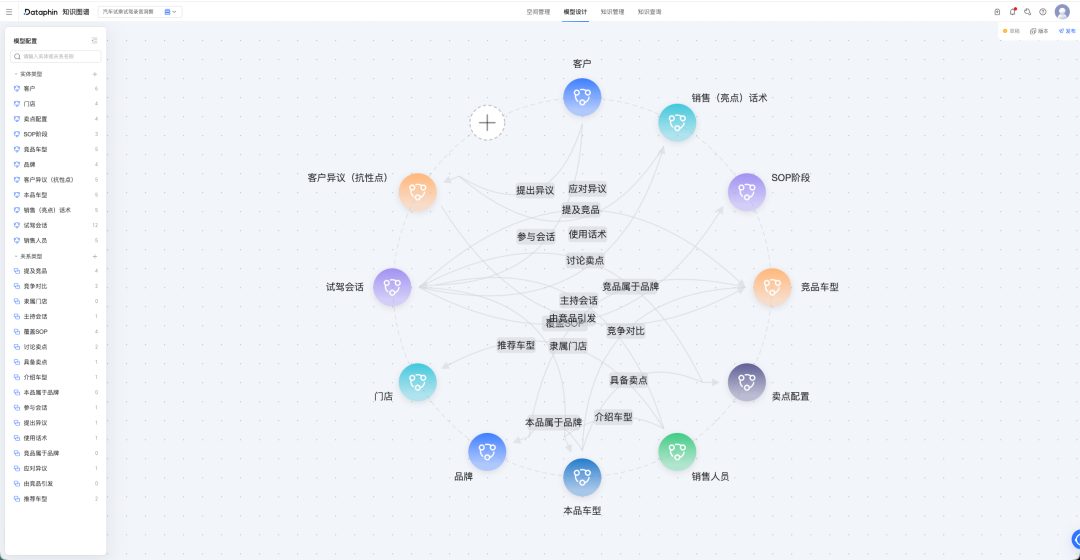
围绕图谱模型,Dataphin支持可视化的实体与关系管理、属性与约束配置,以及版本管理。直播还介绍,演示中的图谱模型通过大模型调用Dataphin提供的SKILL创建,Dataphin也提供了原生CLI接口。
图谱数据的获取有两条路径:通过工作流中的“知识图谱解析”算子,从非结构化资料中提取业务对象和关系;通过数据集成中的“知识图谱写入”组件,将结构化业务数据写入图谱。
针对同名、简称等歧义,直播展示了实体业务识别规则和人工审核页面:满足条件的数据自动写入,需要确认的结果保留为候选项,由业务人员审核。
这也明确了AI与业务专家的分工:AI参与重复性的提取和匹配,业务专家处理需要判断的对象匹配与歧义问题。
质量、血缘和权限,需要贯穿知识建设与调用。
AI参与知识加工之后,如何保障处理结果可信可用?
直播从三个方面介绍了治理工作:
质量治理:检查内容是否准确、完整、前后一致,发现链路中的异常问题。
血缘治理:记录知识来源和加工过程,资料变化时查清影响,答案出现问题时追溯原因。
安全合规:明确知识调用范围,做好敏感信息识别、授权和必要的脱敏。
知识需要持续更新和维护,这些治理工作也需要与生产、服务衔接起来。
加工好的知识,通过服务接口进入Agent的工作。
直播介绍了两类使用方式。
查找资料,可以使用数据集语义检索。用户在Dataphin数据服务中创建API,通过query参数传入查询信息,通过top_k参数限制返回结果数量。调用时,系统对输入问题进行向量化处理,执行语义相似度查询。
查询关系,可以使用知识图谱查询。用户输入实体信息,查询相关实体及其关系。相关功能开放了OpenAPI和CLI,供Agent开发时集成使用。
调用环节还需要配置身份。直播介绍了统一调用身份,以及传入Agent实际用户信息两种方式;后者按照用户权限返回数据,约束知识的使用范围。
在瓴羊企业级 Agent 平台 AgentOne 中,可以将Dataphin创建的数据集或图谱API直接引用为外部知识库,减少文档、数据表等内容的重复导入和配置。企业自研或其他厂商的Agent,也可以调用Dataphin提供的知识服务。
直播还介绍了本体逆向建模:从Dataphin中已经搭建的数据模型和主数据库表中提取语义关联,帮助企业更快地构建语义模型,减少从零开始梳理的工作。
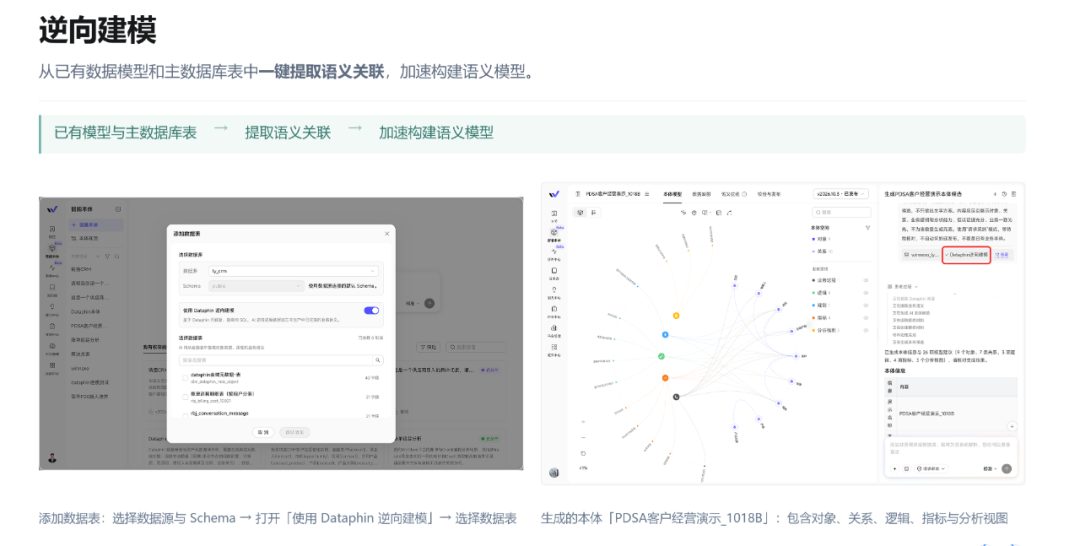
回到增购方案场景,Agent可以查询客户、合同、项目、产品等对象关系,获取已购功能、回访记录等结构化事实,再结合会议纪要、产品文档和案例库,组织方案内容。直播最后展示了AgentOne中AI销售生成的解决方案PPT,以及核对方案资料来源的方式。
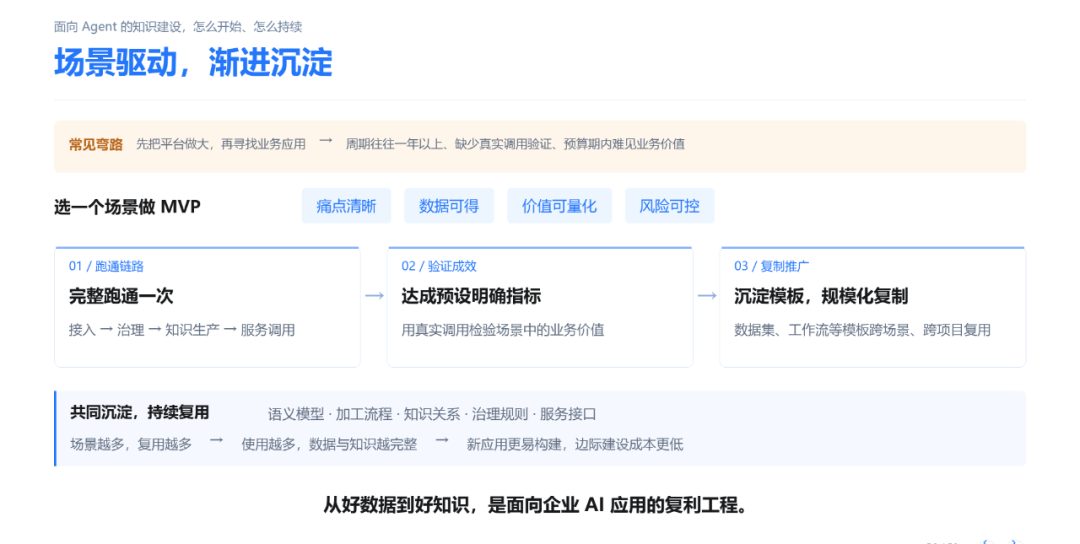
落地路径,仍然要回到具体场景和预先确定的目标。
直播结尾提醒,企业推进Agent容易走的一条弯路,是先扩大平台建设,再寻找业务应用,导致项目周期长、缺少真实调用验证,难以看到业务价值。
因此,直播建议选择一个痛点清晰、数据可得、价值可量化、风险可控的场景做MVP,跑通接入、治理、知识生产和服务调用,达到预先设定的明确指标,再利用沉淀的模板逐步复制。
在这一过程中,数据集、加工工作流、业务关系、治理规则和服务接口,也能成为后续场景继续复用的积累。
扫码添加企微,领取资料↓
本文转载自微信公众号「dbaplus社群」,查看原文。版权归原作者所有,如有侵权请联系删除。