LG AI Research | 只在模型没把握时才叫人来帮忙的多智能体推理
原创 肖瑾瑜 2026-11-03 18:30 四川
本文的处理是把两者当成对两种不同情形的描述:对称、同质、全连接时是中性;存在信息倾斜(比如有人给出了正确种子)时才会产生正向修正。于是问题从"辩论到底有没有用"改成"什么时候该辩论、辩论该怎么组织"。
原文标题:Efficient Multi-Agent Reasoning via Confidence-Guided Adaptive Debate
原文作者:Seungdong Yoa, Ye Seul Sim, Suhee Yoon, Sanghyu Yoon, Dongmin Kim, Soonyoung Lee, Bumsoo Kim, Junhyun Lee
原文链接:https://arxiv.org/pdf/2610.16343
发表会议:ICML 2026(PMLR 306)
笔记作者:肖瑾瑜
主编:黄诚@安全学术圈
1、背景介绍
多智能体辩论(multi-agent debate,MAD)的基本做法是:让多个 LLM 实例各自给出答案和推理过程,然后互相阅读、多轮修正,最后取共识或多数投票。这条路子在数学、常识推理任务上被反复报告有效,也慢慢变成"想提升效果就多跑几个 agent"的默认选择。
代价是 token 成倍增加。更麻烦的是效果并不稳定:近两年陆续有工作报告,传统辩论在不少任务上并不比简单投票好,甚至比单模型还差,却要多花十几倍的钱。
这篇文章的出发点是一对看起来互相打架的理论结论。
一份工作把辩论看成对"隐藏概念"的贝叶斯推断:agent 的回答由某个未观测的概念决定,给定这个概念后彼此条件独立。在这种建模下,只要群体里存在一个"答得对"的种子,互相交流就相当于后验更新,能够把正确答案放大,理论上可以严格超过多数投票。
另一份工作把每个 agent 的信念建模成 Dirichlet 分布,按邻居的回答计数做更新。结论是:当所有 agent 权重相等、信念等于邻居平均值时,这个更新过程是鞅,期望正确率不变。也就是说,平等互抄平均下来什么也换不到,不如省下钱直接投票。
一个说有用,一个说没用。本文的处理是把两者当成对两种不同情形的描述:对称、同质、全连接时是中性;存在信息倾斜(比如有人给出了正确种子)时才会产生正向修正。于是问题从"辩论到底有没有用"改成"什么时候该辩论、辩论该怎么组织"。
2、Motivation
作者认为现有框架的问题在于一视同仁:多数投票、传统辩论、Mixture-of-Agents 这类固定流水线,不管题目难易,都把所有 agent 全部调动一遍。
两个观察支撑这个判断。
第一,能触发增益的样本占比很小。本文实测下来,被判为"没把握"需要升级的样本大约两成,其余八成单模型直接输出就够了。为这八成的样本启动辩论,纯属白花钱。
第二,真正需要外部帮助的恰恰是"模型自己没把握"的那部分。作者做了校准分析,准确率与 token 级置信度高度相关:答案 token 的最小概率在 0.99 以上时准确率 85.5%,低于 0.50 时掉到 50.9%;答案位置的分布熵超过 1.0 时,准确率只有 30.4%。
据此,本文提出 LASE(Leader-Adaptive Structured Engagement):先让一个主模型自己答,只在置信度不达标时才按顺序叫辅助角色,而且每次最多叫一个。
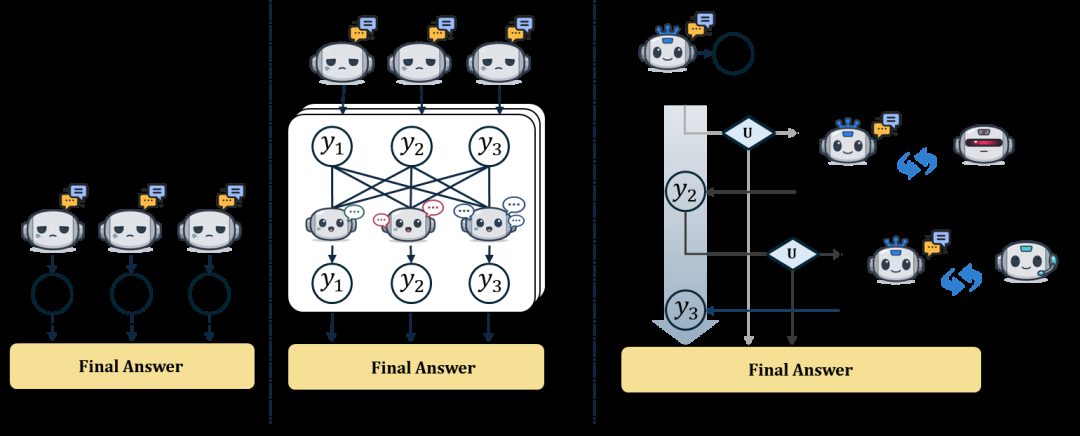
论文图 2 把三种架构并排画出:多数投票是各自独立生成再聚合;传统辩论是所有 agent 平等地互相看、多轮交互;LASE 是先单模型作答,只有触发条件成立时才沿星型结构逐个升级。
3、本文方法
3.1 怎么判断"没把握"
不看模型自述,而是从这一次生成里直接取两个统计量,都只算最终答案那几个 token:
最小 token log 概率:答案里最没把握的那个词的生成概率;
最大 token 熵:答案位置上候选分布的混乱程度。
任一越过阈值(log 概率过低,或熵过高),就判定为不确定,触发升级。整套机制只需要一次前向推理,不需要重复采样,也不需要模型额外输出置信度。
3.2 升级流程:一次只问一个人,问完就停
主模型单独作答,得到第一版结论;
若不确定,先做一次低成本的对抗检查,让"魔鬼代言人"去找逻辑漏洞;
主模型重写;若仍不确定,叫"合作者"给方向性提示;
再重写;仍不确定,叫"资深专家"指出缺失的关键概念;
任何一步之后置信度达标,立即停止并输出,后续步骤不再执行。
3.3 三个辅助角色的分工与禁区
四个角色用的是同一个模型,区别只在提示词。所以这里的"多智能体"指的是职责不同,不是模型不同。
角色 | 任务 | 硬性禁止 |
|---|---|---|
主模型 | 给出逐步推理和最终答案 | 无 |
魔鬼代言人 | 攻击现有解答:找弱点、设逻辑陷阱、要求逐步自证、挑战边界情况 | 不许说"看着没错",不许编造错误 |
合作者 | 给提示、替代视角、指出走偏的地方 | 不许直接解题,不许给最终答案 |
资深专家 | 指出漏掉的关键概念,解释当前推理为什么有问题 | 不许给最终答案,要求"让它自己解" |
所有辅助角色还被禁止使用最终答案的专用书写格式(\boxed{}),这个格式只留给主模型。
3.4 信息流向与理论
传统辩论是全连接:每个 agent 都能看到别人上一轮的全部内容,然后互相平均。LASE 改成星型:辅助角色的输出单向流入主模型,不回流、不互抄,主模型保留最终解释权。
作者据此论证,由于拓扑和触发条件都变了,前述"对称更新是鞅"的前提不成立,主模型的信念轨迹不再满足那个中性结论,从而可以产生朝正确方向的偏移。
成本上,全连接辩论的跨 agent 上下文包含次数随轮数和 agent 数的平方增长;星型每次只连一个 agent,包含次数只与轮数有关,与人数无关。作者还给出了一个选择性辩论的期望增益下界,以及一个 Pareto 改善的推论:只要存在一部分高置信样本,选择性辩论在同等预算下的精度就优于"总是辩论"。
4、评估
4.1 实验设置
模型:Gemini-2.0-Flash、GPT-4.1-mini 为主,另加 Llama-3-8B 验证开源模型上的表现。
数据集:数学推理用 MATH-500(500 题)、MATH-lv5(筛出最高难度的 1324 题)、GSM-Symbolic(500 题,用于检验是否死记硬背);知识与安全用 MMLU-Pro(504 题)、GPQA-Diamond(198 题)、TruthfulQA-MC(817 题)。
基线:单模型;多数投票(采 7 次独立作答再投票);传统辩论(3 个 agent、2 轮、最后投票)。
4.2 主结果
论文图 1 上半部分把四个方法在六个数据集上的相对表现画成雷达图(以 LASE 为 100%),下半部分是 token 开销倍数(以单模型为 1)。
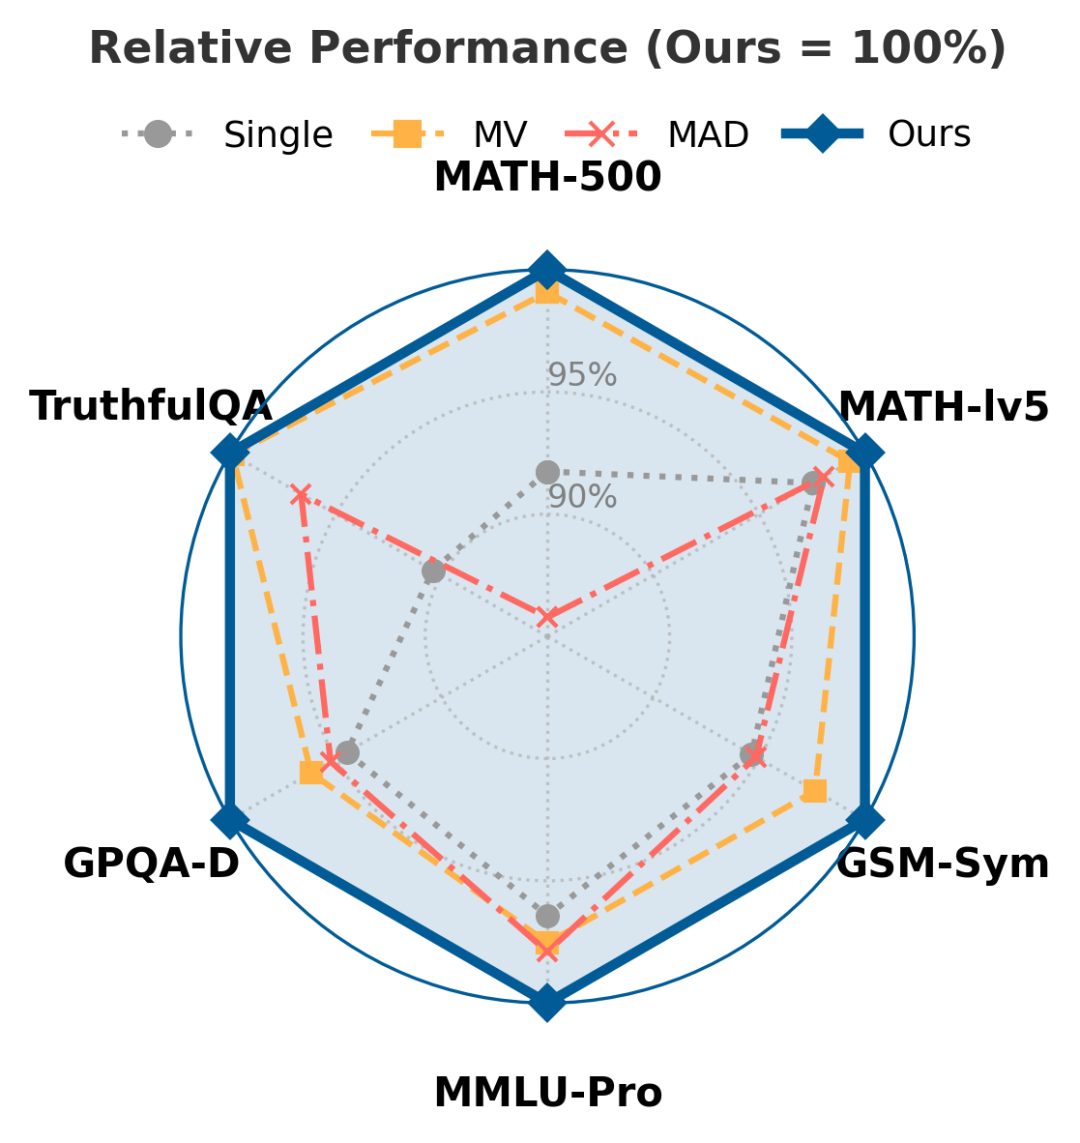
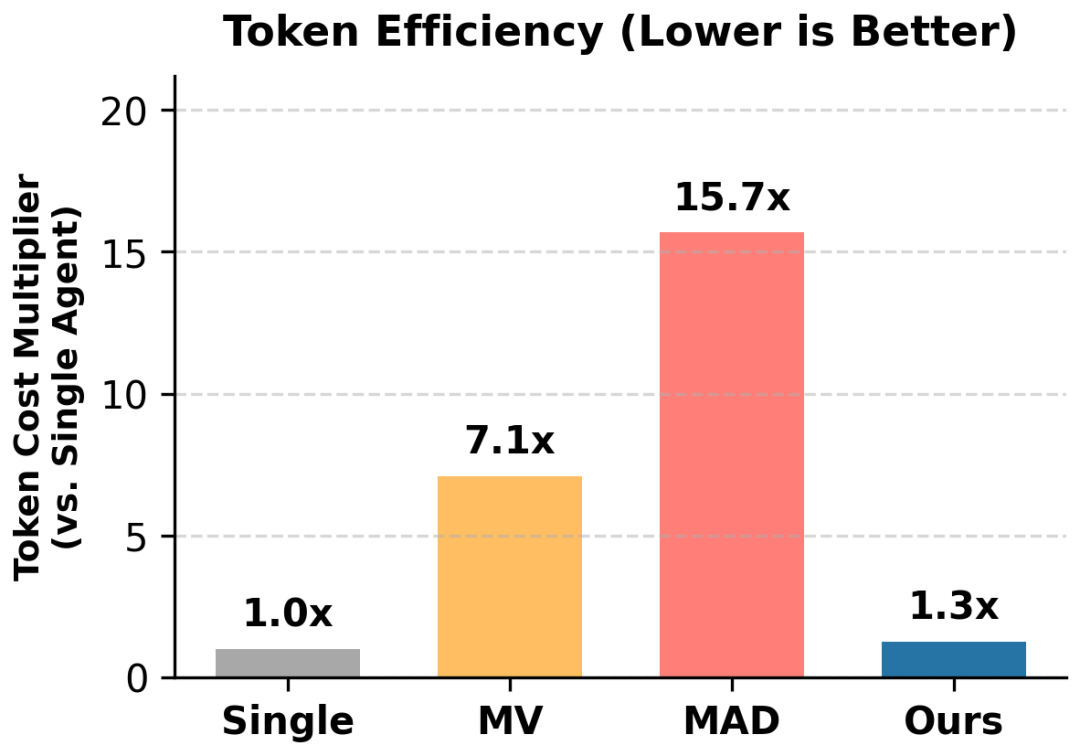
跨数据集平均下来,单模型 1.0 倍、多数投票 7.1 倍、传统辩论 15.7 倍、LASE 1.3 倍。
Gemini-2.0-Flash 上,各方法的准确率与单样本平均 token:
数据集 | 单模型 | 多数投票 | 传统辩论 | LASE | LASE 平均 token |
|---|---|---|---|---|---|
MATH-500 | 80.0 | 86.4 | 74.8 | 87.2 | 1.1k(辩论 11.8k) |
MATH-lv5 | 55.7 | 56.7 | 56.0 | 57.1 | 1.8k(辩论 20.3k) |
GSM-Symbolic | 88.4 | 91.2 | 88.6 | 93.4 | 0.4k(辩论 5.6k) |
MMLU-Pro | 78.4 | 79.3 | 79.6 | 81.3 | 0.8k(辩论 10.3k) |
GPQA-Diamond | 61.6 | 62.7 | 62.1 | 65.2 | 1.2k(辩论 17.2k) |
TruthfulQA | 72.6 | 80.2 | 77.6 | 80.3 | 0.4k(辩论 5.2k) |
GPT-4.1-mini 上趋势类似,MATH-500 为 73.0 / 73.8 / 73.8 / 74.2,token 1.0k / 7.3k / 16.1k / 1.8k。平均 token 相比传统辩论降了一个数量级以上,GSM-Symbolic 上是 0.4k 对 5.6k。
MATH-500 上传统辩论(74.8)比单模型(80.0)低 5.2 个点,在 GPT-4.1-mini 上却是 73.8 对 73.0,略高。同一方法在两个模型上方向相反。
MMLU-Pro 和 TruthfulQA 上 LASE 与多数投票基本持平(81.3 对 79.3、80.3 对 80.2),优势主要体现在 GPQA 这类高难题上。
4.3 与其他方案组合
作者强调 LASE 和多数投票不冲突,而是可以叠。MATH-500 上并行跑 5 条 LASE 再投票,准确率 88.0,比单条 LASE(87.2)高 0.8 个点;总 token 5.4k,和标准多数投票(N=7,5.2k)相当,但准确率高 1.6 个点。作者把这个现象称为"更好的投票者":每条轨迹内部先自我纠错,再去聚合,比直接聚合原始生成结果更稳。
与 Mixture-of-Agents 相比,MATH-500(GPT-4.1-mini)上 LASE 74.2 对 72.0,总 token 0.9M 对 3.6M,只用对方约四分之一。
Llama-3-8B 上,单模型 25.7%、多数投票 31.8%、传统辩论 24.1%(比单模型还低)、LASE 32.9%。LASE 的 token 是单模型的约 4.6 倍,而 GPT-4.1-mini 上只有约 1.8 倍。作者的解释是弱模型置信度天然偏低,触发更频繁,计算预算自动向不确定样本倾斜。
4.4 置信度校准与阈值敏感性
校准分析用了两个模型在 MATH-500 上各两次运行的合计 2000 个样本点:
最小 token 概率在 0.99 以上时准确率 85.5%,低于 0.50 时 50.9%;
答案位置熵超过 1.0 时准确率 30.4%。
作者把这两张图当作校准假设的实证检验,结论是不确定样本确实更容易出错,因此适合作为门控信号。
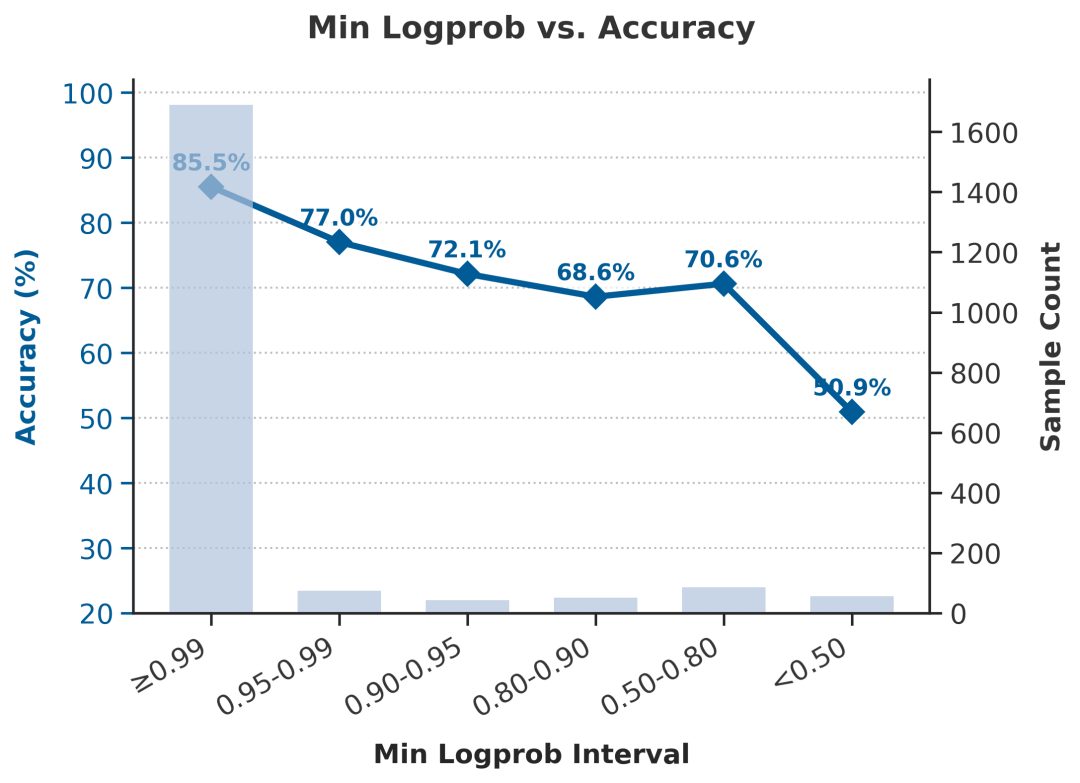
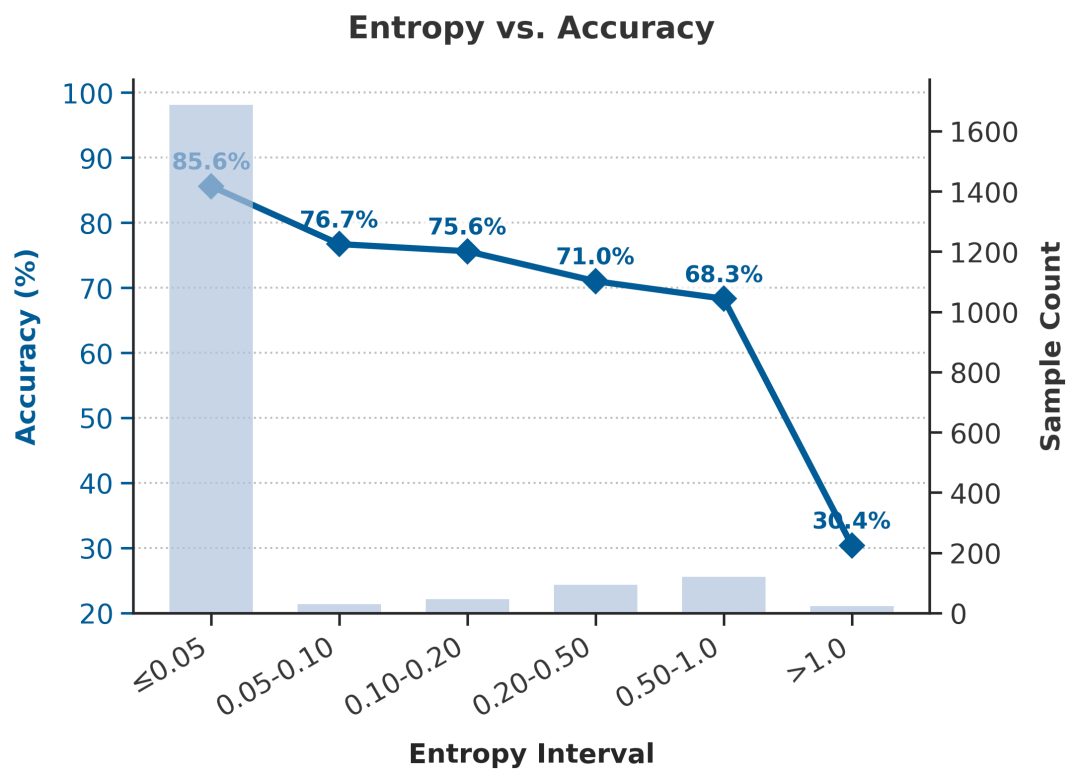
阈值扫描(GPT-4.1-mini,MATH-500,熵阈值固定 0.50):
log 概率阈值 | 准确率 | 平均 token | 触发比例 |
|---|---|---|---|
0.50 | 74.1 | 1.8k | 21.4% |
0.60 | 74.8 | 1.8k | 21.2% |
0.80 | 74.2 | 1.8k | 22.6% |
0.90 | 74.8 | 2.6k | 30.8% |
0.95 | 75.1 | 3.1k | 42.8% |
准确率始终在 74.1 到 75.1 之间,触发比例从 21.4% 涨到 42.8%。作者据此认为阈值是"预算旋钮"而不是"效果旋钮"。熵阈值在 0.2、0.5、0.8 之间切换时,准确率为 73.8、74.2、74.1,波动 0.4 个点。
另外把辅助角色的顺序随机打乱跑三次,准确率 86.9(标准差 0.31),与主实验的 87.2 相差 0.3 个点,说明结果不依赖固定顺序。
5、案例分析
这篇文章没有传统意义上的代码案例,作者用三组细分析代替。
高置信但答错。 门控的盲区是模型非常确信、推理却错了的样本。作者的态度是不去强制交互:一方面模型在自信时对外部反馈抵抗很强,另一方面当前实现用的是同质 agent,辅助方和主模型共享同样的能力上限和盲点,强行辩论往往只是让辅助方替主模型的幻觉背书,变成回音室。作者把"放掉这部分错误"明确定义为有意的精度-成本取舍,而不是门控机制的漏洞。
弱模型上的对称塌缩。 Llama-3-8B 上传统辩论 24.1% 低于单模型 25.7%。作者的解释是低能力模型往往不存在"正确种子",此时对称交互只会盲目放大幻觉和错误,而星型结构加单向信息流可以遏制这种塌缩。
阈值只换预算不换效果。 见 4.4 的扫描表。触发比例翻倍,准确率只动一个点,说明这套门控属于可以按预算调节的旋钮。
作者团队介绍
第一作者 Seungdong Yoa 及 Ye Seul Sim、Suhee Yoon、Sanghyu Yoon、Dongmin Kim、Soonyoung Lee 均来自 LG AI Research(首尔)。
通讯作者为中央大学计算机工程学院的 Bumsoo Kim 与韩国外国语大学计算机工程系的 Junhyun Lee,另有 Noah's Farm 参与。
作者个人履历在公开渠道信息有限,此处不作展开。
安全学术圈 | 投稿须知
有兴趣加入学术圈的请联系 secdr#qq.com
本文转载自微信公众号「安全学术圈」,查看原文。版权归原作者所有,如有侵权请联系删除。