入职第一天,被前同事写的SQL查询语句,吓到当场离职……
原创 Rohan Dutt 2026-11-04 07:15 广东
写得乱七八糟的SQL,根本不叫技术,纯粹是给别人挖坑!
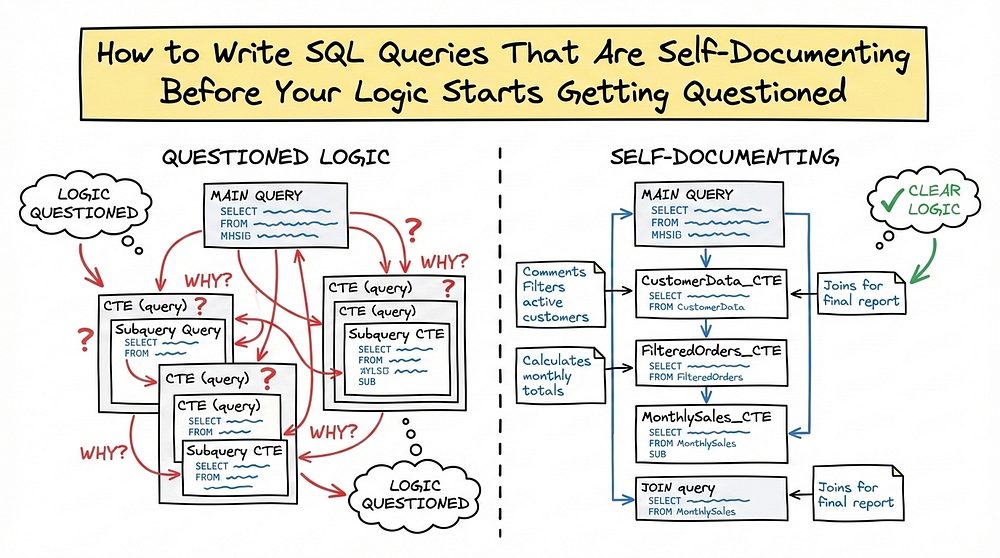
把SQL查询写好,让意图、假设和计算逻辑自己就能解释清楚,不需要额外说明。
上个月,我打开了一个SQL文件。当时我就想,这都是什么鬼?!
1400行嵌套混乱的代码:没有注释,没有结构,完全不知所云。
到处都是 tbl_a、final_temp_v3 这种别名。
我花了一天半才把它理顺。
最离谱的是,查询居然成功了。
可等到财务部门问为什么营收数据对不上时,所有人都哑口无言。
写得乱七八糟的 SQL 根本不叫技术,纯粹是给别人挖坑。
我曾经亲眼目睹一位同事凌晨两点重写了一整段查询语句。为什么?因为一个 WHERE 条件被藏在了六个子查询的深处,根本找不到。
团队每年都要浪费好几周去修这种“自以为聪明”的代码。如果你的 SQL 语句需要翻译(解释)才能看懂,那你不是在写代码,而是给未来制造麻烦。
一、架构原则
不想让别人反复追问你的代码逻辑,必须一开始就注重代码的可读性。以下是我遵循的架构原则,确保每条查询都清晰易懂,而不是暗藏玄机。
1、清晰的架构
1)利用 CTE 摆脱子查询的噩梦
嵌套子查询就像剥洋葱,只会让人越看越头疼。
公共表表达式 (CTE) 可以让你自上而下梳理逻辑,让数据流向变得线性清晰。
2)“人类可读性”规则
规范别名:将t1or替换a为active_customersor monthly_recurring_revenue;
布尔标记字段:与其写 status_id IN (1, 4, 7),不如新增一个名为 is_eligible_for_discount(是否符合折扣资格)的判断字段;
线性逻辑:把 SQL 当作菜谱来写。准备好食材( CTE 定义),混合它们(表连接),最后摆盘(最终查询)。
2、“自带说明”改造
假设我们正在计算客户留存率。在“改造前”的写法中,你会看到层层嵌套的括号。而改造之后的逻辑一目了然。
1)改造前(混乱版)
SELECT t1.id, t1.rev, t2.last_loginFROM ( SELECT * FROM sales WHERE amt > 100 ) t1JOIN ( SELECT user_id, MAX (dt) as last_login FROM logs GROUP BY 1 ) t2ON t1.id = t2.user_idWHERE t2.last_login < '2025-01-01' ;
2)“改造后”(自带说明版)
WITH high_value_sales AS (-- 筛选超过 100 美元的交易以隔离关键客户SELECTcustomer_id,amount AS revenueFROM salesWHERE amount > 100),customer_activity_tracking AS (-- 识别每个用户最近的交互SELECTuser_id,MAX (login_date) AS last_active_dateFROM user_logsGROUP BY user_id)SELECThvs.customer_id,hvs.revenue,cat.last_active_dateFROM high_value_sales hvsJOIN customer_activity_tracking cat ON hvs.customer_id = cat.user_idWHERE cat.last_active_date < '2025-01-01' ;
这样写的优势:
逻辑隔离:如果“收入”逻辑发生变化,你能知道改哪个 CTE ,不用改动连接逻辑;
可审计性:当财务部门询问该项收入时,你可以直接指向 high_value_sales 代码块,从命名就能一目了然;
10 秒测试:一名初级开发能否在 10 秒内看懂这段代码的用途?如果不能,就需要重构。
这一套方法给我们团队带来的改变简直惊人,再也不用为了解释数据看板的逻辑而开“紧急会议”了。
小建议:写 SQL 的时候,哪怕明年凌晨三点困得睁不开眼,你也能看懂自己写的代码。
二、让 SQL 更易于理解的 4 个架构优化
你有没有盯着半年前自己写的 SQL,感觉像是在看外星古文?
我曾经花了一整个下午,才看懂自己当年 “自以为很巧妙” 的查询语句。
现在才明白,所谓的“巧妙”,到头来只是“坑未来的自己”。这真是个大教训。想要从根源上避免别人(包括未来的自己)追问你的代码逻辑,你就得写出自带解释、一看就懂的查询。
说明:每种优化的完整实操流程我都会详细展开,这里先讲清楚重要性和方法。
1、 CTE 堪称救星
这种 WHERE EXISTS (SELECT… FROM (SELECT…)) 套来套去的写法趁早别用了!子查询嵌套简直是人脑的递归噩梦。
改用 CTE ,将逻辑拆成线性、连贯的流程。
上个月我用这种方法重构了一个长达 200 行的复杂代码。我同事的反应是:“等等……这居然能看懂了?”
2、字段命名语义化(请不要使用缩写)
字段命名至关重要。revenue_after_refunds这样写并不算长,反而更友好。
用 a、b、t1 这种别名,就像你把厨房里所有罐子都贴上 “食物” 标签一样敷衍。
当你凌晨两点还在调试代码时,未来的你一定会由衷庆幸:至少知道每个字段到底代表什么。
3、缩进 = 氧气(给查询一点呼吸空间)
缩进是留白,让你的逻辑能呼吸,更易读。
我曾遇到过一个 bug,JOIN 语句藏得像海盗宝藏似的。这种问题本该 5 分钟定位,结果硬生生花了两小时。
从那以后,我格式化代码格外认真:JOIN、AND 条件、CASE 语句全部对齐排版,整齐规范。
4、把假设打上标签(你没听错)
不要只写代码做了什么,SQL 本身已经能看出来。
关键是写下为什么这么做:# Ignores test accounts,处理耗时约2秒。
三个月后你只会抓狂:“我当初为什么要把 user_id > 1000 排除掉?!” 你记不住,但注释可以。
经得起追问的 SQL 优化示例
下面是一组专业级的进阶优化对比。场景为计算净营收,同时过滤内部测试数据、处理复杂退款逻辑。
逻辑噩梦(优化之前):
SELECT t1.id, SUM (t1.amt - t2.ref_amt) as netFROM orders t1LEFT JOIN ( SELECT ord_id, SUM (amount) as ref_amt FROM refunds GROUP BY 1 ) t2 ON t1.id = t2.ord_idWHERE t1.status_id NOT IN ( 4 , 9 ) AND t1.u_id > 1000GROUP BY 1 ;
自带说明的杰作(优化之后):
WITH refund_aggregates AS (-- 对每个订单的退款金额求和,以避免多对一连接膨胀SELECTorder_id,SUM (refund_amount) AS total_refunded_amountFROM order_refundsGROUP BY order_id),filtered_active_orders AS (-- 排除已取消 (4) 和欺诈 (9) 的订单-- 排除内部测试帐户(ID > 1000 为生产用户)SELECTorder_id,customer_id,gross_transaction_amountFROM transaction_ledgerWHERE status_id NOT IN ( 4 , 9 )AND user_id > 1000)SELECTorders.order_id,(orders.gross_transaction_amount - COALESCE (refunds.total_refunded_amount, 0 )) AS net_realized_revenueFROM filtered_active_orders AS ordersLEFT JOIN refund_aggregates AS refundsON orders.order_id =退款订单号;
真相:这不是为了写出完美代码,而是为了以后不恨自己,这是为了热爱你的工作……
现在多花五分钟,将来能省下五小时的暴躁调试。
当业务方或资深架构师质疑你的逻辑时,你完全不必慌。
你的同事:交口称赞
你的精神状态:安稳平和
未来的你:轻松起飞
三、提升可读性的进阶写法
同时我也很快意识到,有时候修复不光是加几条注释的事。
那是结构性问题。
我开始用 CTE 把一堵密密麻麻的代码墙,梳理成按时间顺序展开的逻辑叙事。
你不用像考古学家那样一层层深挖子查询,而是像读一本书一样,从上到下看懂就完事。
1、“嵌套地狱”与“叙事式 CTE”
核心原则:如果你的逻辑需要超过 5 秒才能看懂,那它就是不合格的,必须重构。清晰易懂不是锦上添花,而是代码的生命线。
重构后的标准写法:
/* 目的:计算 2025 财年的年度客户流失率。理由:根据领导层 2025 年 11 月 12 日的指示,不包括试用账户。*/*/WITH valid_subscriptions AS (-- 过滤掉内部测试帐户和过期试用帐户SELECTuser_id,subscription_start_date,total_recurring_revenueFROM production_schema.subscriptionsWHERE is_internal_account = FALSEAND subscription_status != 'trial_expired'),annual_revenue_calculation AS (-- 按用户汇总收入以处理多计划帐户SELECTuser_id,SUM (total_recurring_revenue) AS total_user_revenueFROM valid_subscriptionsWHERE subscription_start_date >= '2025-01-01'GROUP BY 1)SELECTCOUNT (user_id) AS total_active_customers,SUM (total_user_revenue) AS total_fiscal_revenueFROM annual_revenue_calculation;
2、严苛型架构师的三大守则
说明:这相当于把文档工作开到地狱难度……(不感兴趣可以忽略)
元数据层规范:我开始对每张表、每个字段都使用 COMMENT ON 命令添加注释。现在,字段与表的说明直接固化在数据库结构中。团队成员不再反复问基础问题,因为答案就写在元数据里。只要开发人员查看表结构,文档说明就直接呈现在眼前。
强制代码检查规则:我在开发环境中集成了一个SQL 代码检查工具,并配置规则直接禁止 rev_tot、t1 这类敷衍命名,同时强制规范缩进与语义化命名。现在,在提交合并请求之前,工具就会提前标出不规范写法。
上下文动机注释:我不只注释代码做了什么(代码本身已经能体现),还注释为什么这样做:- 仅保留2023年数据,避免历史冗余数据干扰(业务方要求)。这样就不会再出现团队群里紧急追问的情况。我的查询语句,本身就能解释自己存在的意义。
四、逻辑自查:建立专业可信度
打开你最近写的一段 SQL 脚本。
试着重构其中一个 CTE 或子查询,给它起一个清晰到不是技术岗产品经理都能看懂的名字。
把 mau_temp 改成 monthly_active_users(月活跃用户)。把 t1 改成 filtered_transaction_logs(已过滤交易日志)。
你会发现,当你大声读出这段逻辑时,不用任何额外说明,思路瞬间就通了。
这就是命名的力量。它能把一段晦涩的代码谜题,变成一段通顺易懂的逻辑叙事。
编写自解释 SQL 查询的详细步骤:
步骤1:用命名 CTE 替代子查询
实操流程:
1)定位到实现某条具体业务规则的嵌套子查询;
2)将其抽离至 WITH 子句中,并使用语义清晰、面向结果的命名;
3)在主逻辑块中直接引用这个命名好的 CTE。
例子:
-- 修改前(逻辑隐藏较深,需要进行思维导图)SELECT order_idFROM ordersWHERE customer_id IN ( SELECT id FROM customers WHERE status = 'active' );-- 修改后(逻辑线性且自描述)WITH active_customers AS (SELECT idFROM customersWHERE status = 'active')SELECT order_idFROM ordersWHERE customer_id IN ( SELECT id FROM active_customers);
结果:查询语句读起来就像一组指令,未来的你(或是同事)不用一层层去找括号,就能立刻看清逻辑依赖关系。
步骤2:使用能完整说明含义的字段别名
实操流程:
1)遍历查询语句,找出 SELECT 子句或复杂计算中含义模糊的字段名称;
2)将其替换为能体现设计意图的别名,明确说明数据的状态与用途;
3)应用到 JOIN 关联条件中,让表与表之间的关联关系一目了然。
例子:
-- 修改前(计算不明确)SELECT(price * quantity) - discount AS final_amountFROM orders;-- After ( Explicit business logic)SELECT(price * quantity) - discount AS total_revenue_net_of_discountsFROM orders;
结果:业务分析师不用对照数据字典就能直接理解你的查询结果。由于字段名称本身就定义了数据含义,排查问题也变得一目了然。
步骤3:有策略地使用留白和缩进
实操流程:
1)将主要子句(SELECT、FROM、WHERE、GROUP BY)各放一行;
2)缩进JOIN条件和子逻辑,体现层级关系;
3)用空行分隔数据准备阶段(CTE)和最终聚合阶段。
例子:
-- 修改前(数据密集,解析困难)SELECT o.id, c.name, SUM (p.amount) AS revenue FROM orders o JOIN customers c ON o.customer_id = c.id JOIN payments p ON o.id = p.order_id WHERE o.status = 'completed' AND c.is_active = TRUE GROUP BY o.id, c.name;-- 修改后(结构化且易于扫描)SELECTo.id,c.name,SUM (p.amount) AS lifetime_settled_revenueFROM orders oJOIN customers cON o.customer_id = c.idJOIN payments pON o.id = p.order_idWHEREo.status = 'completed'AND c.is_active = TRUEGROUP BYo.id,c.name;
结果:你的查询看起来像一份专业的技术规范书,向同事传递一个信号:逻辑严谨、值得信赖。
步骤4:将业务前提直接嵌入查询语句
实操流程:
1)找出代码中隐含的业务逻辑(例如 “仅适用于美国用户”“排除内部测试账号” 等);
2)添加行内注释,使用统一标识前缀(如 -- #),将业务规则与普通代码说明区分开;
3)把注释直接写在对应逻辑的位置,而不是只放在文件头部。
例子:
WITH regional_customer_base AS (SELECTuser_id,signup_dateFROM customersWHERE country_code = 'US'-- # 业务规则:根据 2025 年税务合规更新,排除地区(波多黎各、关岛、美属维尔京群岛)AND state_code NOT IN ( 'PR' , 'GU' , 'VI' ))
结果:你的查询将具备可审计性。当业务方质疑数据为什么发生变化时,理由已经在代码记录的版本历史中写好了,不用临时回忆或反复沟通。
你编写的代码不只是给数据库执行,更是给未来需要维护数据库的人看的。
作者丨Rohan Dutt 编译丨dbaplus社群
dbaplus社群欢迎广大技术人员投稿,投稿邮箱:editor@dbaplus.cn

本文转载自微信公众号「dbaplus社群」,查看原文。版权归原作者所有,如有侵权请联系删除。