像打补丁一样做代码扫描:一次让审计快60%的硬核优化
原创 Yak 2026-11-04 15:14 四川
90% 的代码其实不用重新分析:我们让代码审计学会了“偷懒”
yaklang 的增量编译(incremental compilation)核心是只编译变更文件、复用未变更部分的 IR,并保证审计结果与全量编译一致。本文按"背景与动机、底层实现、效率优化、IRify 落地细节、新旧逻辑对比"五个部分,描述 yaklang 增量编译从旧版多层模型到当前 Base/Diff 模型的实现与优化。
涉及代码主要位于 common/yak/ssaapi 与 common/yak/ssa/ssadb,可对照源码阅读。
一、增量编译的背景与动机
yaklang 的代码审计链路为:源码 → SSA IR(静态单赋值形式的中间表示)→ SyntaxFlow 规则查询。一次全量编译需要将项目中的全部源文件解析、构建 IR 并落库;对包含数万文件、捆绑大量依赖 jar 的中型 Java 工程而言,耗时在分钟级。
IRify 在处理大型项目时面临的主要性能瓶颈包括:
1.完整重新编译时间长:即使只修改少量文件,仍需全量构建;
2.资源占用高:大项目编译时内存与 CPU 占用处于高位;
3.迭代效率低:需要等待较长的构建周期。
在以下场景中,全量编译存在明显的重复开销:
•AI 审计(IRify)的迭代回路:AI 修改规则或用户修改文件后重新扫描,绝大部分代码与上一次扫描时完全相同;
•安全值班与 CI 的重复扫描:同一项目被反复扫描,每次变更通常只涉及少量文件;
•修复验证:漏洞修复后只需验证变更点,无需重审整个仓库。
增量编译的目标可以概括为:只编译变更文件,复用未变更部分的 IR,同时保证审计结果与全量编译一致。其中后一项是主要难点:SSA 的符号解析是跨文件的,修改 Utils.java 中的函数后,引用该函数的 Controller.java 虽未变更,其旧 IR 中对应部分已过时;文件删除、重命名也会在旧 IR 中留下悬空引用。
与全量编译相比,增量编译的差异可以归纳为:
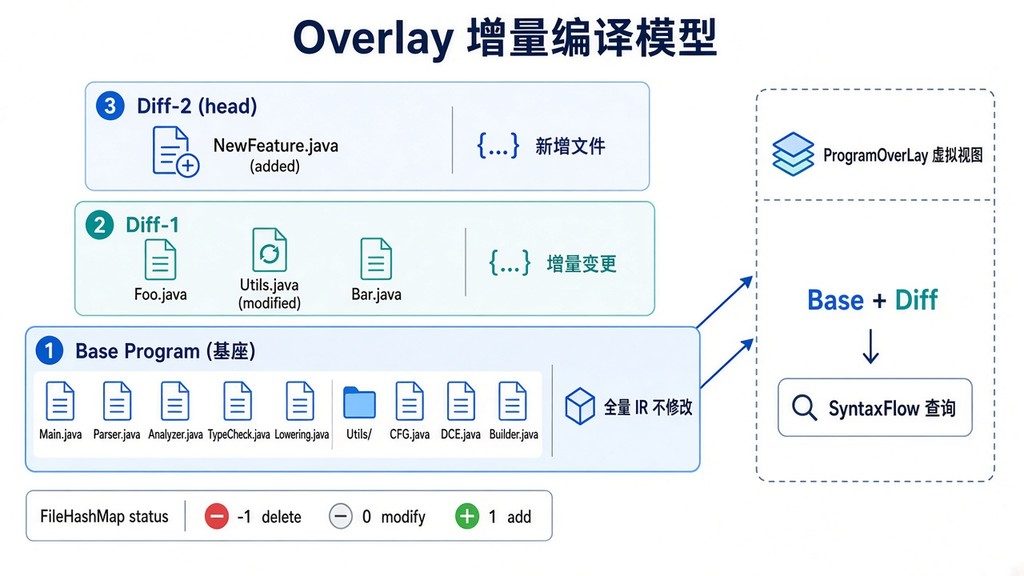
yaklang 采用 overlay(叠层)方案:变更文件编译为独立的差量 Program,查询时将"全量基座 + 若干差量层"合成为虚拟视图。基座不被修改,差量层可以追加或丢弃。该模型同时满足正确性要求(未变更文件的 IR 保持原样)与效率要求(编译范围限于变更集)。
二、增量编译的底层实现
YAK
2.1 数据模型:IrProgram
增量编译的元数据记录在 ir_programs 表(common/yak/ssa/ssadb/program.go),其中四个字段构成层链:
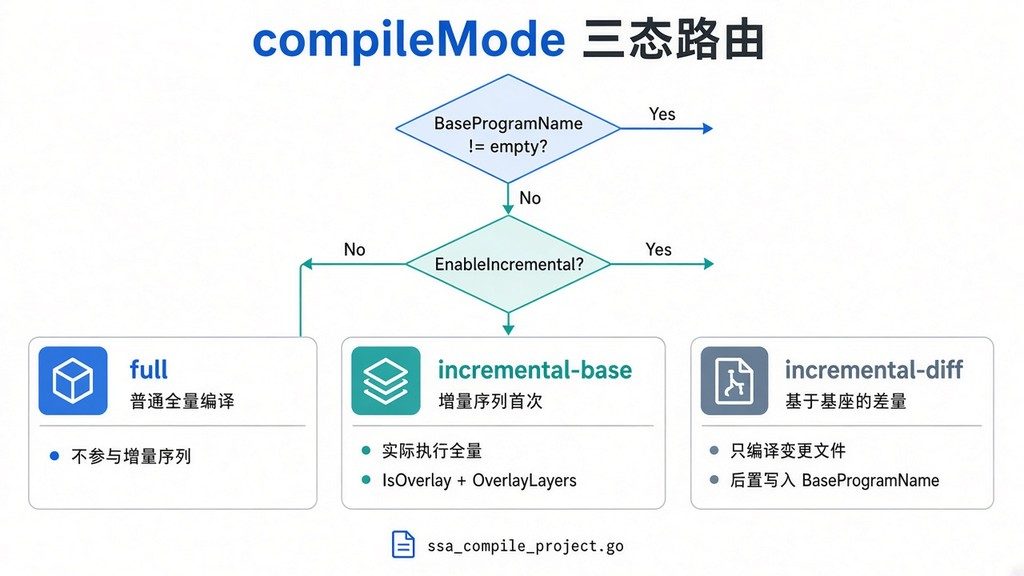
编译入口按 compileMode() 分为三种模式(common/yak/ssaapi/ssa_compile_project.go):
•full:普通全量编译,不参与增量序列;
•incremental-base:增量序列的首次编译。实际执行一次全量编译,产物被标记为后续差量编译的基座(IsOverlay + 单层 OverlayLayers);
•incremental-diff:基于基座的差量编译,只编译变更文件。
YAK
2.2 差量计算:MD5 快照对账
差量计算由 calculateFileSystemDiff 完成,流程如下:
1.基座侧快照:遍历 base 文件系统,对每个源文件计算内容的 MD5 摘要,得到 路径 → 摘要 映射,不驻留文件字节;
2.新侧走查:遍历新文件系统并逐文件对账——路径不存在记 1(新增);摘要不同记 0(修改)并加入 diff FS;走查结束后快照中剩余路径记 -1(删除);
3.产物为只包含变更文件的 VirtualFS 与一份 FileHashMap,变更文件集即差量层的编译输入。
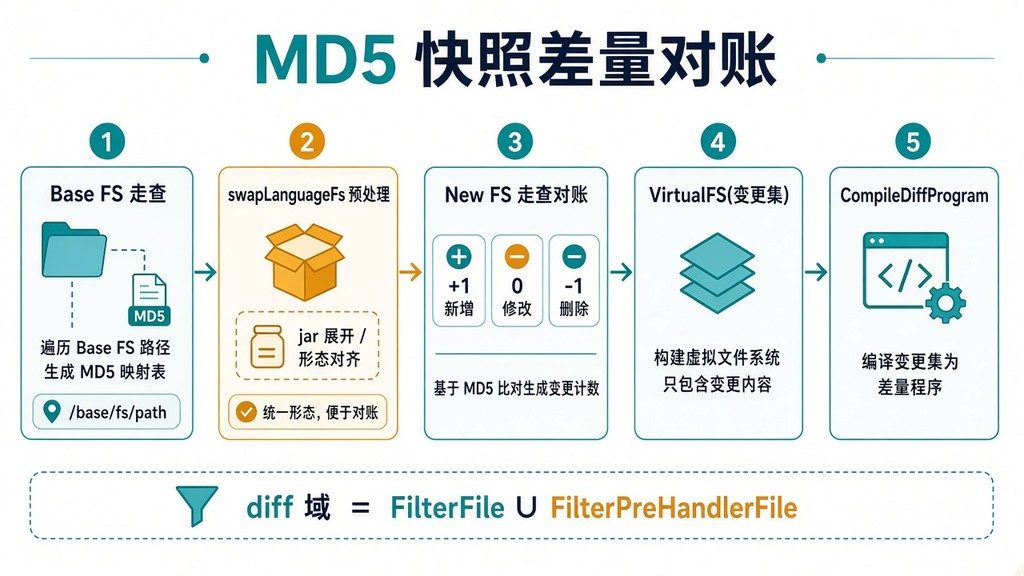
两个实现细节影响对账的正确性:
diff 域等于编译域。 对比范围限定为该语言实际会编译并持久化的文件(FilterFile ∪ FilterPreHandlerFile),两侧对称。若将资源文件、配置文件纳入 diff,会产生大量无意义的变更记录并触发不必要的重编译。
diff 两侧必须处于同一形态。 基座文件系统是编译时视图:jar 归档已展开、.class 已映射为 .java;新输入是裸文件系统。若直接以裸 FS 对账,磁盘上的 jar 会整体判定为新增,基座中的每个展开条目会判定为删除,增量编译退化为全量重编译。因此新侧先经过与全量编译相同的语言预处理(swapLanguageFs),保证两侧可比。
YAK
2.3 差量层编译:入口隔离与回滚范围
差量层编译由 CompileDiffProgramAndSaveToDB 执行,包含三个设计要点:
•入口隔离:差量编译的 config 只声明"这是增量序列的一层",不携带 BaseProgramName,经由独立编译入口执行,不会路由回 ParseProject 形成递归。基座关联与 FileHashMap 在编译完成后以后置赋值方式写入产物;
•只删不增:当本次变更全部为删除(不存在可编译文件)时,生成 delete-only program——不含 IR,仅记录 FileHashMap 中的 -1 条目,视图层据此移除对应文件;
•回滚范围受限:差量编译失败或 panic 时,回滚仅删除本次新写入的差量层 Program,基座与历史层不受影响。增量体系中的失败结果为"回退到上一次增量状态",不会破坏可用基座。
YAK
2.4 Overlay 视图:持有权模型与双源查询
编译产物落库后,查询侧由 ProgramOverLay(common/yak/ssaapi/programs_overlay.go)将基座与差量层合成虚拟 Program。其核心为两条不变量:
Plain Text
1 Diff[i].File = 第 i 层最终持有的路径(该层的新增 + 修改)2 ExcludeFile = 所有层持有路径的并集 ∪ 全部删除路径(基座查询需跳过)
每个路径的持有权由最新持有该路径的层独占:新层持有某路径时,先将其从旧层的持有集中移除(stripOwnedPath),保证任一路径同一时刻只有一个现行版本。查询按持有权做双源路由:
•Ref/Match:差量层按 include(只查自身持有的文件)自新向旧查询;基座按 exclude(跳过被持有与被删除的路径)查询;两部分结果合并。旧层中过期的定义由新层遮蔽;
•Relocate(跨层符号重定位):从基座或旧层取得的值,若其所属文件已被新层持有,则按"稳定名 + opcode"在持有层中定位对应的新值后返回。查询先走变量名索引的快速路径,未命中时按 opcode 扫描并以名字交集匹配——Java 方法名(Class_method_<hash> 形式)通常依赖该路径命中。
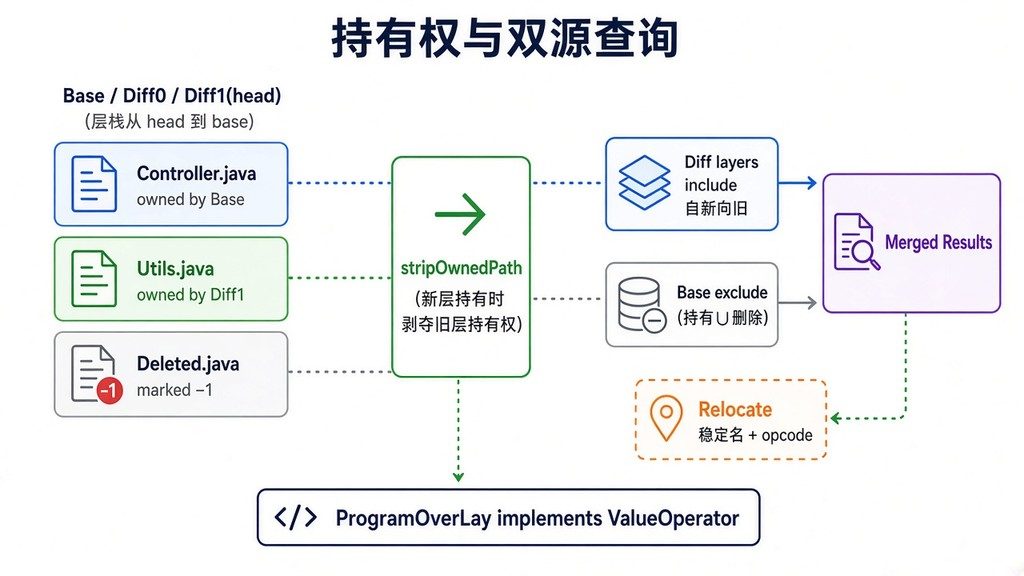
ProgramOverLay 实现了 SyntaxFlow 的 ValueOperator 接口,SyntaxFlow 规则查询 overlay 视图与查询普通 Program 的方式一致,审计规则无需感知增量机制。追加新差量层时(extendOverlayWithNewLayer),基座与历史层被复用,仅追加新层,聚合文件系统保持惰性、不重新构建,基座的 updated_at 保持不变。
三、针对增量编译的效率优化
本节描述三项效率优化:文件树列表缓存、跨语言默认排除域、排除域在扫描与编译三阶段的统一应用。
YAK
3.1 文件树列表缓存
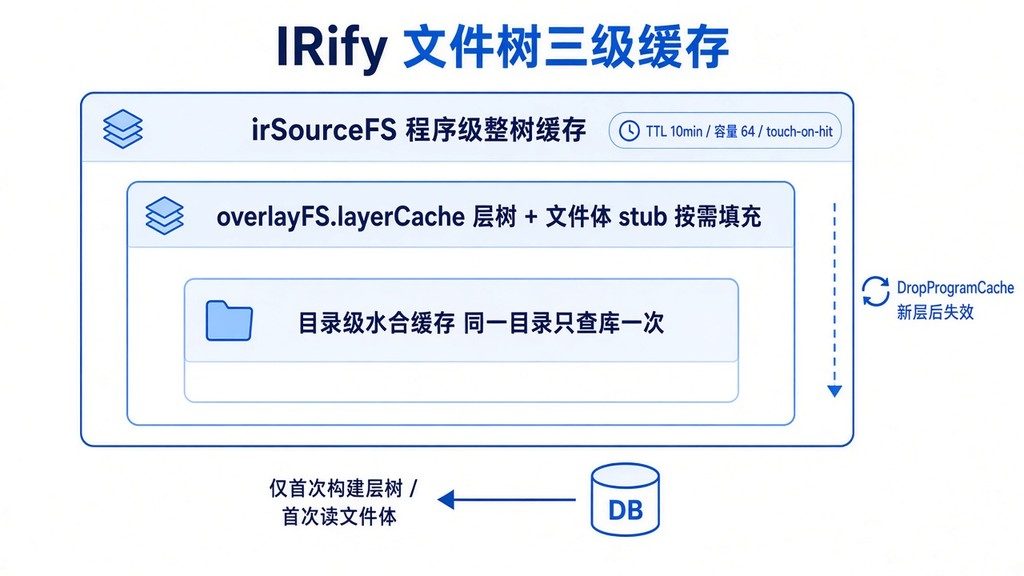
ssadb:// 文件树采用“缓存 + 按需失效”的访问策略,共三级缓存:
•程序级整树缓存(irSourceFS,common/yak/ssa/ssadb/source_filesys.go):每个 Program 的文件树作为整体缓存,touch-on-hit——被浏览的程序延长存活时间,闲置 10 分钟后整树逐出,容量上限 64;
•层树与文件体缓存(overlayFS.layerCache):结构树按层惰性构建,构建后常驻;文件体首次读取后原地替换空壳 stub,此后 Stat 报告真实大小;
•目录级水合缓存:同一目录的数据库查询只执行一次,后续 listing 命中内存。
首次展开文件树时完成构建与数据库水合,此后浏览、刷新与重复 ReadDir 均命中内存,不再访问数据库,源码文件照常打开。该行为由 TestIrSourceFS_RepeatedReadDirDoesNotReload 固化为测试。
YAK
3.2 跨语言默认排除域
SSA 编译内置跨语言聚合的默认排除域(common/yak/ssaapi/ssaconfig/compile_exclude.go),用于整体跳过测试代码、测试夹具、构建产物、依赖缓存等非生产攻击面内容。排除域由两张表组成:
•目录名表:node_modules、target、build、dist、vendor、testdata、tests、pycache、venv 等,按目录基名整体跳过;
•glob 表:按语言分组的文件模式,包括 Go 的 **/*_test.go 与 go.sum、JS 的 **/*.min.js 与锁文件、Python 的 /test_.py、C 的 **/.o 与 cmake-build-*/ 等。
两张表的构成遵循三条规则:
1.跨语言聚合:扩展名限定的模式(如 *_test.go)只可能命中对应语言的文件,不会影响其他语言;目录名标记的均为非源码内容(构建产物、依赖缓存、版本控制元数据),或不会出现在源码树中,因此无需按语言拆分;
2.归档不做全量排除:捆绑的运行时与依赖归档可能是合法扫描目标,因此仅按名称排除明显测试性的归档(test.jar),构建机械(gradle/wrapper/、mvnw)按名称排除;
3.glob 语义补齐:gobwas/glob 要求 / 后跟分隔符,/x 无法匹配根级 x。实现中为每个 /x 模式自动补充根形式 x,目录名展开为 dir、dir/、**/dir、/dir/ 四种形态,保证根目录下的同类文件同样被排除。
YAK
3.3 排除域贯穿扫描与编译三阶段
yak code-scan 的三个阶段——source(源码模式规则)、struct(结构扫描)、ssa(编译审计)——共享同一份 BuildCompileExcludeFunc 解析规则(内置默认 + 用户 --exclude-file)。被排除的文件不进入 source 规则扫描、不进入差量对账、也不进入编译:一个文件要么同时存在于三个阶段的视野中,要么三个阶段都跳过它,三个阶段的文件视野保持一致。
四、IRify 中的增量编译优化细节
本节描述 #5288 对增量项目文件树的重构。IRify 的项目文件树通过 ssadb:// 协议访问:根目录列出所有 Program,每个 Program 对应一棵树;增量 Program 是一条层链,文件树需要将"基座 + N 个差量层"呈现为单一树视图。
YAK
4.1 重构前的实现及问题
重构前,增量项目的文件树是一个包装 VirtualFS 的包装器:将聚合 FS 拷贝进虚拟 FS,再将 diff 状态附加在外部。该实现存在三类问题:
•读取层不确定:head 层修改过的文件在首次读取时可能返回基座的旧内容,因为读取路径缺少持有层概念,结果取决于遍历顺序;
•删除文件表现不一致:被删除的文件在 listing 中不存在,但在 ReadFile/Stat 中可能仍然可访问;
•diffOnly 逻辑位于上层:前端"显示全部文件"勾选状态需要由上层路由解析并分别实现,文件系统自身不提供 diff 视图。
YAK
4.2 overlayFS:原生实现完整 FileSystem 的层链视图
重构后的 overlayFS(common/yak/ssa/ssadb/source_overlay_fs.go)直接实现 filesys_interface.FileSystem 接口,不再包装其他实现,overlay 语义集中于一处。层链数据为 []overlayLayer(层名 + 该层的 FileHashMap),自旧到新排列,最后一层为 head。所有调用者路径以 head 为根(换头),各层条目在合并时重新挂接到 head 前缀下。
各核心操作的规则如下:
ReadDir(全量视图):遍历层链中每层的树,条目重新挂接到 head 前缀,按名字去重且新层覆盖旧层,过滤最终视图中已删除的文件,按名排序返回。目录存在性以"任一层持有该目录"的存在性标志判断,下层空目录不会被误判为不存在。排序保证输出结果的确定性。
ReadDirDiff(差量视图):仅列出 head 层自身的条目,对应前端"只看本次变更"的视图。目录仅存在于下层时,diff 视图返回空列表而非错误,避免全量视图中展开的节点在切换视图后失效。
持有层解析(ReadFile/Stat 的基础):自新向旧遍历层链,第一个持有该路径的层即为持有层。未填充的 stub 同样视为持有——head 层树上存在某路径的节点(即使内容未加载)即表明 head 的 diff 涉及该文件,读取不会回退到基座的同路径副本。该规则修复了"head 修改过的文件首次读取返回 base 旧内容"的问题。文件体按需加载:首次 ReadFile 时通过持有层的存储路径从数据库读取内容,并原地替换树上的 stub,此后 Stat 报告真实大小。数据库读取在锁外执行,慢查询不会阻塞 listing,锁内仅执行 stub 替换。
删除解析:自新向旧遍历,第一个持有该路径的层决定其状态:状态为 -1 时该路径在最终视图中不存在;更新的层重新持有旧层删除过的路径时,该文件恢复可见。删除文件在 ReadDir、Stat、ReadFile 中的表现统一为不存在。
另有两组工程处理:坏层降级——某层树构建失败时记录该层并在视图中跳过,其余层正常服务;单层链等价普通树——Program 是否为增量仅由链长决定,["prog"] 单层链即普通全量 Program 的树,无需特判分支。
YAK
4.3 在 IRify 中使用增量编译
IRify 提供两种开启增量编译的方式:
•重新编译时自动增量:在 SSA 项目探测.yak 脚本的编译选项中勾选"启动增量编译"后,编译产物在数据库中标记 is_overlay = true;此后对该项目执行重新编译时,程序自动计算文件差异并生成差量文件系统,只编译变更文件。基项目与增量项目在项目历史中各自可见,文件树通过聚合机制呈现包含基项目文件在内的完整视图;
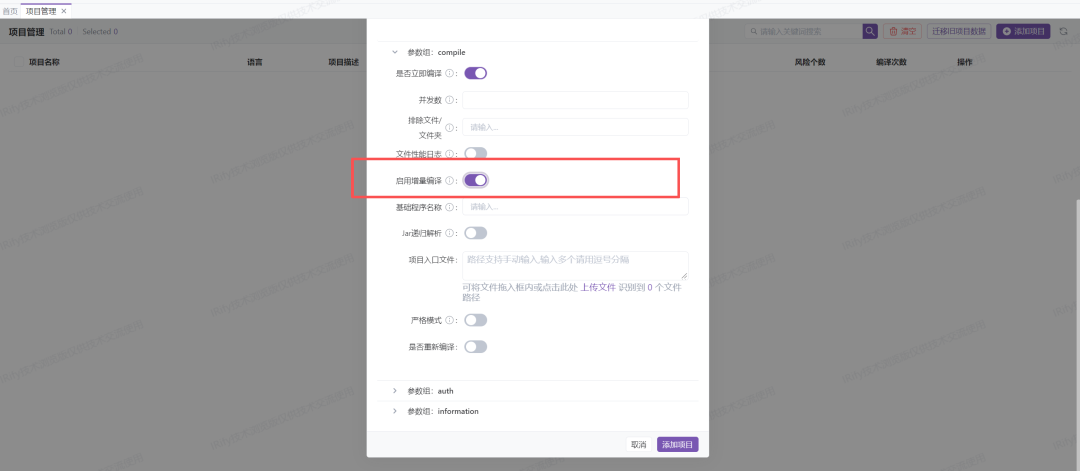
•项目配置中手动增量:在编译选项的"基础程序名称"输入框中输入某个项目的全名(对应配置项 base_program_name),本次编译即基于该项目执行差量编译。
YAK
4.4 与前端的接口
•ExtraInfo 向前端暴露 IsIncremental 与 IsOverlayProgram 标记,用于文件树上标识增量 Program;
•diffOnly URL 参数选择差量视图或全量视图;文件系统不解析 query 参数,但提供 diff 视图的原生入口(ReadDirDiff);
•base_program_name 配置项(CLI / 配置 JSON)指定差量编译的基座,供 IRify 的增量任务使用。
YAK
4.5 缓存层次
结合第 3.1 节的缓存,IRify 文件树的一次展开经过两层缓存:
Plain Text
1 irSourceFS ← 程序级:整棵 overlayFS 树,TTL 10min / 容量 64 / touch-on-hit2 └─ overlayFS ← 层级:每层结构树(layerCache)+ 已填充的文件体3 └─ DB ← 仅在首次构建层树 / 首次读取文件体时访问
首次展开后,浏览、刷新与 diff 视图切换均命中内存,不再访问数据库与磁盘。差量编译产生新层后按程序名失效缓存(DropProgramCache),下次展开呈现新链。
五、新逻辑相对旧逻辑的结构变化与优势
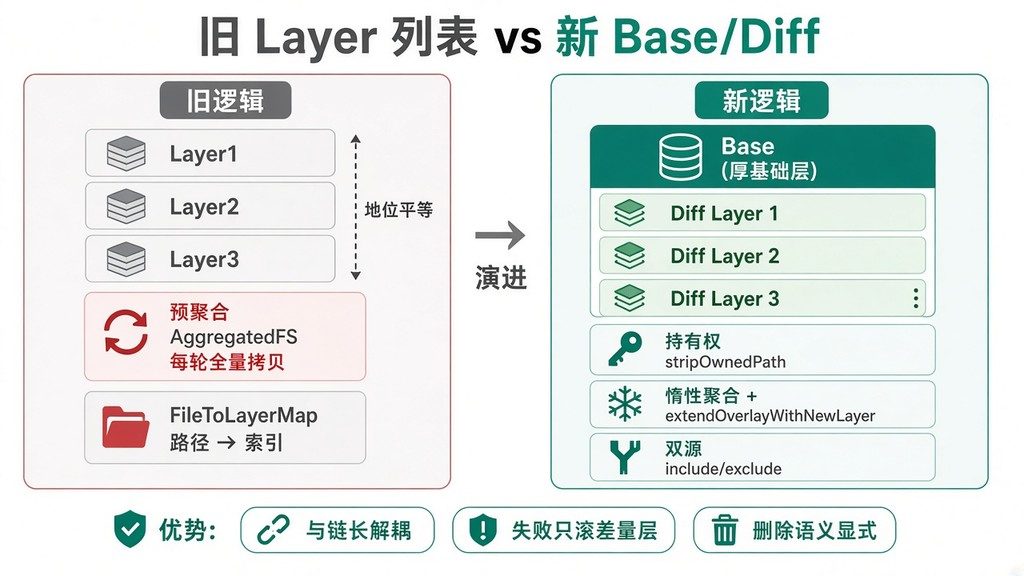
增量编译的早期版本(见内部文档《增量编译》)采用"平等 Layer 列表 + 预聚合"模型。本节对照旧版设计描述当前实现的结构变化及其带来的优势。
YAK
5.1 旧版结构
旧版 ProgramOverLay 的核心结构为:
Plain Text
1 type ProgramOverLay struct {2 Layers []*ProgramLayer // 按顺序存储所有层,所有层地位平等3 FileToLayerMap *SafeMap[int] // 文件路径 -> Layer 索引(快速查找)4 AggregatedFS FileSystem // 构建时聚合好的文件系统5 signatureCache // Value 签名缓存,用于重定位6 }
旧版设计要点:
•无 Base/Diff 区分:所有层都是平等的 Layer(Layer1 → Layer2 → … → LayerN),上层覆盖下层,依靠"自最上层向下逐层查找、找到即停止"实现覆盖;
•预聚合文件系统:再次增量编译时,先对上一次增量结果执行聚合(逐文件自上而下查找 + 按各层状态值求和判定最终存在性,和为 1 才进入聚合结果),再以聚合后的 FS 作为差量基准;
•文件定位依赖索引:FileToLayerMap 维护文件路径到层索引的映射,用于加速逐层查找;
•重定位依赖签名缓存:跨层符号重定位基于 Value 签名缓存匹配。
旧版流程中,基座类型分为三种情况处理:基座是 Overlay 时使用其聚合 FS;基座本身是差量 Program 时临时创建两层 Overlay(其基座 + 其自身);基座是全量 Program 时重建文件系统。
YAK
5.2 结构变化对照
YAK
5.3 优势说明
正确性方面:
•消除读取歧义:旧版读取结果取决于遍历顺序,聚合时机不当或索引未更新时可能返回过期内容;新版持有层解析以"首个持有层"为唯一规则,且未填充的 stub 同样视为持有,保证 head 修改过的文件首次读取即返回新内容;
•删除语义统一:旧版求和规则隐式耦合各层状态值,多轮"删除—再新增—再删除"场景下语义不易验证;新版显式解析规则在 ReadDir、Stat、ReadFile 三个入口行为一致,被删除文件统一表现为不存在;
•差量基准稳定:旧版再次增量前需要重新聚合,聚合结果的形态差异可能引入对账偏差;新版差量两侧强制同一形态(swapLanguageFs 预处理)且 diff 域等于编译域,消除假变更与增量退化为全量的情况。
效率方面:
•增量成本与链长解耦:旧版每轮增量都要对全部层执行一次全量聚合拷贝,链越长开销越大;新版聚合惰性构建、按需缓存,追加新层仅复制持有集元数据(层文件列表),不触碰基座与聚合产物;
•查询路由简化:旧版每个文件查找都要经过索引映射与可能的逐层回退;新版差量层查询只涉及自身持有集(规模为变更文件数),基座一次 exclude 查询完成,不随层数线性增长;
•文件树访问零重复:三级缓存使重复浏览、刷新与视图切换全部命中内存,消除了旧版约 1.8MB/s 的空闲磁盘写入(§3.1);
•编译范围收敛:默认排除域使测试代码、构建产物、依赖缓存不进入编译与对账,直接缩短全量与增量的基线耗时(§3.2、§3.3)。
工程性方面:
•失败隔离:compileMode 三态路由、差量编译入口隔离(防递归)、失败回滚仅删除本轮差量层(§2.3),增量失败不影响已有可用状态;
•可观测与可降级:层链配方损坏时告警留痕并按可用层降级,坏层构建失败时在文件树视图中跳过(§4.2),不再因单层问题导致整个项目不可读;
•前端可见性:旧版前端无法区分普通项目与增量项目;新版通过 ExtraInfo 标记与 diffOnly 视图参数,文件树可直接标识增量 Program 并切换全量/差量视图(§4.3、§4.4)。
六、总结
上述工作可以按四个层面归纳:
整体设计遵循同一原则:变更部分作为独立的一层——差量 Program 是一层,overlayFS 的 head 是一层,缓存失效的粒度同样按层。层间以"最新持有者决定"的规则组合,避免对旧产物做合并式修改。
END
Memfit:是万径安全旗下Yaklang团队研发的面向长程渗透测试、漏洞挖掘、应急响应等全链路攻防任务的生产级安全领域Agent系统
Yakit:是万径安全旗下Yaklang 团队开源的一款完全国产的交互式安全测试平台
YAK官方资源
Yakit官网下载地址:
https://yaklang.com/
Github地址:
https://github.com/yaklang/yakit
Yakit 视频教程:
https://space.bilibili.com/437503777
Memfit下载地址:
https://memfit.ai/
IRify下载地址:
https://ssa.to/
YTray下载地址:
https://yaklang.io/ytray/
本文转载自微信公众号「Yak Project」,查看原文。版权归原作者所有,如有侵权请联系删除。