扩散语言模型也能一步生成?Seq-Drifting提供一种可能
让你更懂AI的 2026-11-04 12:05 北京
多轮去噪压成一步
扩散语言模型能够并行生成多个词元(token),却通常仍需经过多轮去噪,才能得到高质量文本。
如果把生成过程压缩到一步,模型能否在一次前向计算中,直接生成一整段连贯的文字?
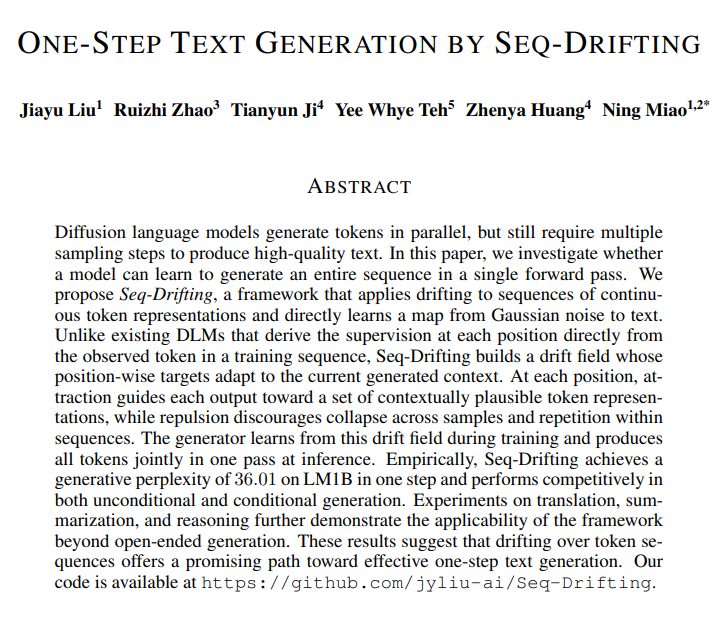
近日,来自香港城市大学、深圳大学、中国科学技术大学和牛津大学的研究团队提出 Seq-Drifting,将 drifting 生成建模引入文本序列,通过依赖当前生成上下文的漂移场,训练模型协调不同位置的词元选择,实现一步文本生成。
在无条件的 128-token 生成中,Seq-Drifting 的生成困惑度(Gen-PPL)达到 36.01,相较四步蒸馏基线 FMLM,实现 11.2 倍的实际运行时间加速。
研究还在条件续写、机器翻译、摘要生成及推理任务上验证了这一框架,探索一步生成在不同文本任务中的适用性。
相关论文题为 One-Step Text Generation by Seq-Drifting,代码和模型权重已公开。
论文地址:
https://arxiv.org/abs/2610.12879
代码地址:
https://github.com/jyliu-ai/Seq-Drifting
模型权重:
https://huggingface.co/jyliuAI/Seq-Drifting
从多步去噪到一步生成
当前主流自回归语言模型按顺序生成词元:先确定前一个词元,再预测下一个词元。这种机制便于利用已有上下文,但生成过程存在串行依赖,输出越长,等待时间通常越久。
扩散语言模型尝试并行更新多个位置,以减少逐词解码的限制;然而,为了协调词元之间的关系,往往仍需要反复去噪或修正。
减少生成步数,难点在于保持输出的一致性。一个位置上的词元即使单独看起来合理,也可能与其他位置的选择不兼容。
例如,句子开头选择了某个主体,后面的动作、指代和描述就需要与之呼应。压缩为一步后,模型必须在一次计算中共同决定这些选择,而不能依靠后续去噪逐轮修正。
Seq-Drifting 直接训练从高斯噪声到文本序列的映射。Drifting 的更新发生在训练过程中:模型依据漂移场提供的目标不断调整参数,逐渐学会一次生成。将这种思路用于文本时,需要回答一个关键问题:训练应当把每个位置的输出引向哪些词元,才能让整段文字彼此协调?
让漂移场随着生成上下文变化
Seq-Drifting 的核心是上下文依赖的漂移场(context-dependent drifting field)。
训练时,模型先并行生成一组连续词元表示,再根据当前生成的上下文,为每个位置构造一组合理的候选词元。候选集合为该位置提供吸引目标;随着生成上下文变化,这组目标也随之调整。
例如,当前前缀是“她把书放在”时,后续位置可以对应“桌上”“书架上”等合理续接。如果前缀变为“她把书送给”,相应候选就应转向能够承接这一动作的对象。
这个示例体现了方法的关键:后续位置的监督需要回应模型当前生成了什么,而不能始终沿用某条训练文本在同一位置上的词元。
候选集合有两种构造方式。
第一种直接从数据集中检索:例如,通过 n-gram 匹配,寻找与当前生成片段相近的真实文本,再收集匹配位置上的词元作为候选。
第二种使用另一个语言模型,称为支持模型(support model):冻结其参数,根据生成器当前产生的前缀,对各位置的下一词元进行评分,并选取高概率词元组成候选集合。
前者从真实语料中获取候选,后者利用模型预测来适应当前生成上下文。
吸引作用引导输出靠近候选集合中相容的词元表示,而不同噪声输入仍可选择不同的合理续接。
这种监督允许一个上下文拥有多个合理后续,避免把所有噪声输入都绑定到同一个固定答案,或将多个词元的表示混成模糊的平均值。
在支持模型方案中,每个位置的候选随当前生成上下文变化,词元选择便通过训练监督联系起来,帮助生成器学习连贯的联合输出。
仅有吸引作用,模型可能反复生成少数相似的文本,或在同一句话中重复相同词元。
为此,Seq-Drifting 加入两类排斥作用:样本之间的排斥帮助不同噪声输入产生不同输出,序列内部的排斥则抑制同一段文本中的重复。它们与依赖上下文的吸引目标共同构成漂移场。
Seq-Drifting 的完整训练与生成流程
如图 1 所示,训练从高斯噪声开始,生成器通过一次前向计算,并行输出所有位置的连续词元表示,再将它们归一化到单位球面上。
随后,依据数据检索或支持模型构造各位置的候选集合,并结合样本之间与序列内部的负样本,计算吸引和排斥作用,得到每个位置的漂移方向。
沿球面进行一次有界更新后,便得到该位置的训练目标。
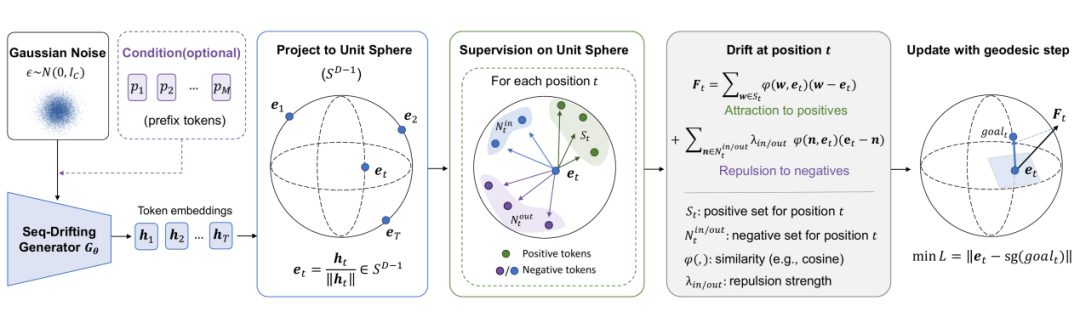
〓 图1. Seq-Drifting 的主方法与训练流程
生成器通过回归这些训练目标更新参数,逐渐学会从不同噪声直接产生相容且多样的词元序列。
球面约束使吸引和排斥主要改变表示方向,而不是不断增大向量长度,与依据余弦相似度恢复词元的方式相匹配。
消融实验显示,去掉序列内部的排斥会出现明显重复;改用不受球面约束的更新,则可能导致训练发散。
推理时,只需将噪声和可选条件输入训练好的生成器,用一次前向计算得到全部位置的表示,再映射为离散词元,输出完整文本。
构造候选集合、计算漂移方向和回归目标都属于训练过程;使用支持模型训练的版本在推理时也无需调用支持模型。
在条件生成中,生成器额外接收给定前缀,并通过交叉注意力利用条件信息;支持模型则结合该前缀与当前生成的续写构造候选集合。
训练先进行无条件预热,让模型学会生成流畅文本,再引入真实前缀学习条件依赖。这一框架因而能够同时用于开放式生成和给定输入的文本生成。
一步生成的质量与效率
研究分别在 LM1B 和 OpenWebText 上评估短文本与长文本生成,对应输出长度为 128 和 1024 tokens。
为了区分监督来源,论文报告两种设置:S 版本使用在相同语料上从头训练的支持模型;P 版本使用公开预训练的 GPT-2。两者的生成器在推理时都只执行一次前向计算。
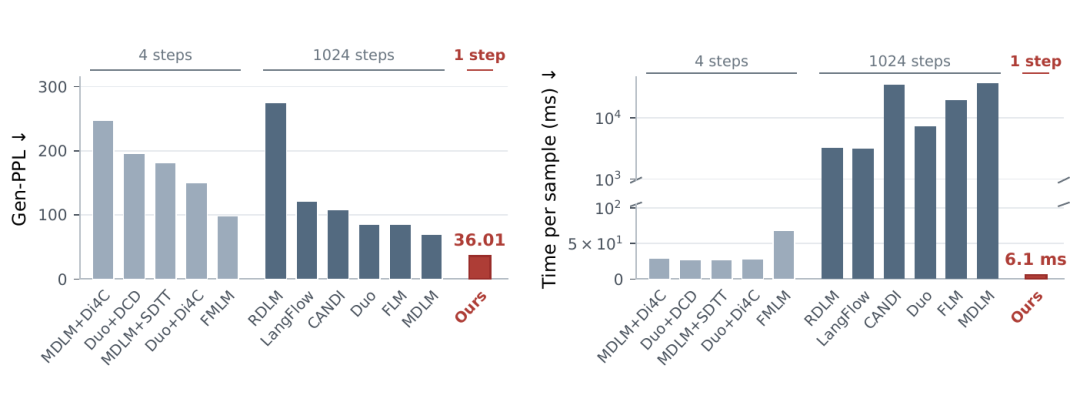
〓 图2. LM1B 128-token 生成的质量与效率比较(Ours 为 P 版本)
在 LM1B 上,S 版本的一步 Gen-PPL 为 93.81,优于四步 FMLM 的 98.76;P 版本进一步达到 36.01。
P 版本利用了公开预训练支持模型的知识,因此这两组结果分别反映相同语料监督与预训练知识支持下的表现。论文同时考察了词元熵和 Self-BLEU,以检查生成多样性。
效率方面,Seq-Drifting 相较四步 FMLM,在 LM1B 和 OpenWebText 上分别实现 11.2 倍和 10.1 倍的实际运行时间加速。
条件续写实验中,S 和 P 两个版本也都优于所比较的少步蒸馏基线。这表明,上下文依赖的监督能够支持一次性生成与给定前缀相衔接的文本。
从文本生成到翻译摘要与推理
研究进一步在 WMT14 德英翻译和 XSum 摘要任务上测试 Seq-Drifting。一步生成在翻译及大部分摘要指标上优于所比较的少步基线,但与表现更强的多步模型仍有差距。
实验还发现,扩大支持模型规模能够改善一步生成质量,为利用更强语言模型构造训练监督提供了依据。
在推理任务上,研究将生成器与比较模型的规模设为 0.5B,测试了数学推理数据集 SVAMP、ASDiv 和逻辑推理数据集 ProofWriter,结果见表 1。研究团队计划进一步扩大模型与训练规模,探索一步生成在数学推理中的表现。
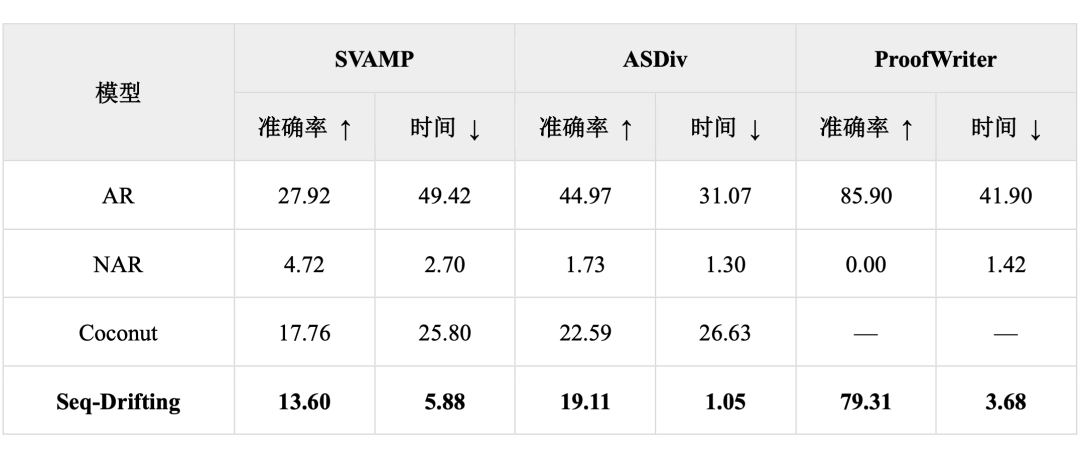
〓 表1. 数学与逻辑推理结果 准确率为百分比 单样本时间为毫秒
探索更大规模的一步文本生成
Seq-Drifting 展示了一条直接学习一步文本生成的路径:训练时,根据模型当前生成的上下文构造相容的词元目标,让各位置的选择逐渐形成一致的序列;推理时,用一次前向计算共同生成全部词元。
研究将继续探索更强的支持模型、更丰富的语义监督和更可靠的词元恢复方式,并进一步评估扩大规模后的数学推理能力。
公开代码与模型权重为复现结果和拓展这一方向提供了基础。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。