EMNLP 2026 | 多模态数学推理别急着“想”,UniCAR-RL让模型先看清
黎宇哲 2026-11-03 23:23 北京
视觉数学均分最高涨9.9分
©作者 | 黎宇哲
单位 | 华中科技大学硕士生
研究方向 | 多模态大模型
UniCAR-RL 不再让一个最终答案奖励同时承担“看”和“想”的监督,而是用三条共享参数的 RL 分支把感知与推理拆开优化,再在端到端 QA 中重新合起来。
本文介绍华中科技大学与华为合作的 UniCAR-RL:一个面向多模态视觉数学推理的三分支强化学习框架。
工作从一个很直接的问题出发:模型做错视觉数学题,很多时候并不是“不会推理”,而是第一步就把图看错了。
UniCAR-RL 不再把所有错误都压缩成一个最终答案奖惩,而是显式拆分感知、推理和端到端问答三种训练信号,仅依赖原始短答案监督,就能针对细粒度视觉感知进行强化学习优化。
该工作已被 EMNLP 2026 Findings 接收。
论文标题:
UniCAR-RL: Seeing Better before Thinking Deeper in Visual Mathematics
收录会议:
EMNLP 2026 Findings
作者单位:
华中科技大学、华为
论文地址:
https://arxiv.org/abs/2609.13849
代码地址:
https://github.com/yzli9/UniCAR-RL
模型“算错”之前,可能已经“看错”
过去两年,强化学习显著提升了大模型的数学推理能力。但把同样的范式直接搬到多模态数学问题上,会遇到一个更基础的瓶颈:图像中的条件并不总能被模型可靠地读出来。
几何图里的直角标记、共线关系、刻度值,统计图中的轴标签,甚至一个很小的符号,都可能决定后续推理是否成立。
这类错误有一个很麻烦的特点:一旦视觉前提错了,后面的推理即使逻辑完全自洽,也只是在错误前提上“认真地算错”。
因此,视觉数学推理中的失败至少包含两种来源——感知错误和推理错误。
传统端到端 RL 往往只看最终答案对不对。答案错了,模型得到负奖励;但训练过程并不知道究竟是“图没看清”,还是“逻辑推错”。这种稀疏全局奖励对推理能力有效,却很难精准修复感知能力。
另一条常见路线是先用更强的教师模型生成带视觉描述的高质量 CoT,再做监督微调,但代价是额外的数据生成成本,而且教师模型自己的视觉幻觉也可能被一起蒸馏进去。
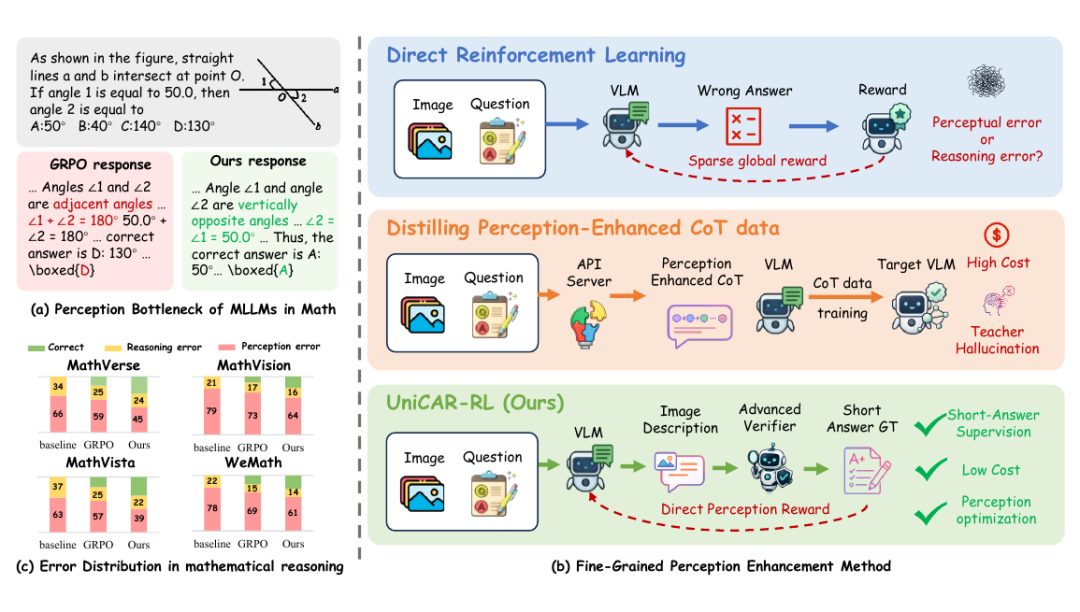
〓 图1:视觉数学推理中的感知瓶颈,以及直接 RL、感知增强 CoT 蒸馏与 UniCAR-RL 的差异(来自论文 Figure 1)
核心想法:把“看清楚”变成一个可验证的奖励
UniCAR-RL 的出发点很简单:如果一段图像描述真的保留了做题所需的关键信息,那么一个“看不到原图”的强文本模型,应该能够只根据这段描述和题目,推导出正确答案。
于是,原本很难直接评价的“视觉描述质量”,被转化成了一个可验证的问题:把模型生成的 caption 交给一个纯文本 verifier,如果 verifier 仅凭 caption 就能解出 ground-truth answer,就说明这段描述至少在任务层面是充分的。
这样得到的奖励,不需要人工标注详细视觉描述,也不要求教师模型生成完整的感知 CoT。
这个设计的重要之处在于,它评价的不是 caption 写得像不像人工描述,而是它对下游求解是否“够用”。
换句话说,UniCAR-RL 关心的是 task sufficiency,而不是表面文本相似度。
UniCAR-RL:三个分支分别解决“看、想、答”
UniCAR-RL 把训练拆成 Caption-RL、Reasoning-RL 和 QA-RL 三个协同分支。
三个分支共享同一个目标 VLM 的参数,并在每次迭代中共同更新,因此不是先训练一个模块、再冻结去训练另一个模块,而是让感知与推理在同一策略中持续共同演化。
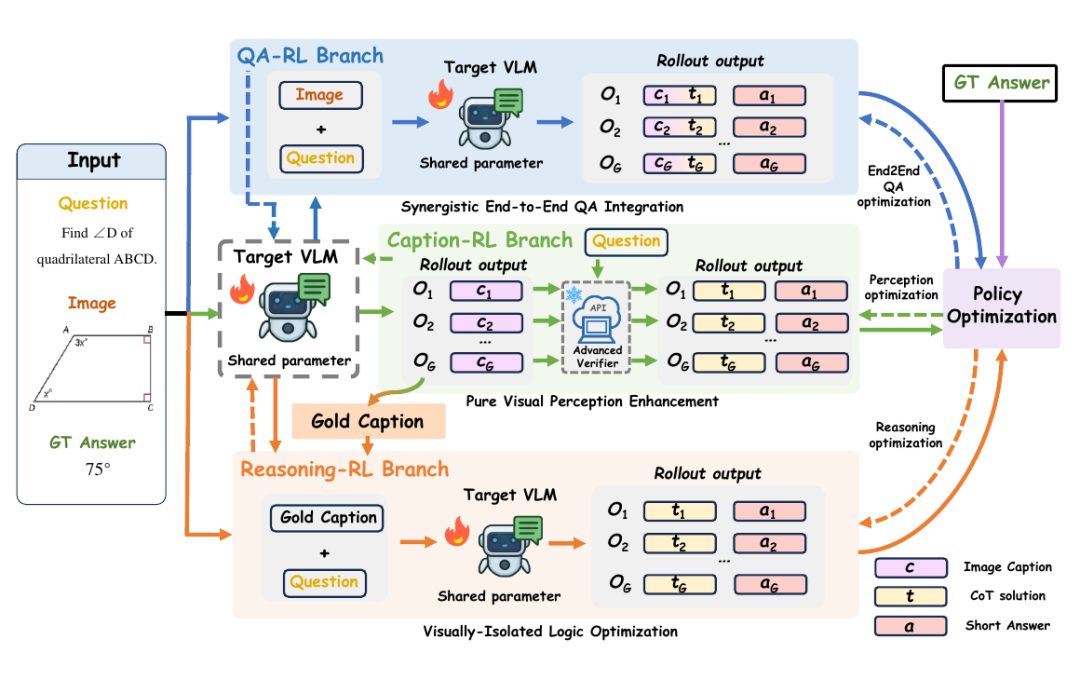
〓 图2:UniCAR-RL 总体框架。三条分支共享参数,同时提供感知、推理和端到端问答三种优化信号(来自论文 Figure 2)
3.1 Caption-RL:先别问它题目,让它把图看完整
Caption-RL 有一个刻意的设计:生成图像描述时,不把问题 q 提供给模型。这样做是为了避免模型只盯着“可能与当前问题相关”的局部区域,而忽略其他视觉元素。
没有问题提示后,模型必须更完整地描述图像,从而形成更全面、偏置更小的视觉 grounding。
对每张图,策略生成 G 个 caption rollout。随后,纯文本 verifier 只接收 caption、原问题和任务 prompt,不接触原始图像。
如果它能从某个 caption 推导出正确短答案,该 caption 就得到正的 perception reward。
一个被漏掉的刻度、直角符号或图例,都可能让 verifier 无法解题,从而直接给感知分支提供纠错信号。
3.2 Reasoning-RL:把图拿走,只训练“怎么想”
Caption-RL 得到多个候选描述后,UniCAR-RL 从中选择奖励最高的 caption 作为当前样本的 gold caption。
接下来,Reasoning-RL 不再给模型原图,而只给 gold caption 和问题,让模型在纯文本条件下完成推理。
这一步的意义是切断“视觉看错 → 推理跟着错”的级联链条。因为输入已经被转成相对可靠的文本描述,Reasoning-RL 的奖励主要反映逻辑推导能力,而不是视觉读取能力。
随着 Caption-RL 逐步提高描述质量,Reasoning-RL 接收到的输入也会越来越丰富,形成一种自然的 curriculum。
3.3 QA-RL:最后还要回到真实测试形态
如果只训练前两个专门分支,模型可能擅长“描述图”和“基于描述推理”,却偏离真正部署时的 image + question 输入形式。
因此第三条 QA-RL 分支保留原生端到端问答:输入图像和问题,直接生成推理与短答案。
三个分支的 reward semantics 不同,因此论文在每个 rollout group 内分别做 advantage normalization,再使用标准 clipped GRPO objective。
最终三个 objective 在同一次反向传播中共同更新共享参数:局部上把不同能力拆开训练,全局上仍然保持一个统一模型。
实验:不只“答对更多”,感知能力本身也在提升
训练使用 MMRL30k 中的 30k 样本,评测覆盖 WeMath、MathVerse、MathVista 和 MathVision 四个视觉数学推理基准,并进一步在 ChartQA、HallusionBench 上测试通用多模态能力。
主干模型包括 Qwen2.5-VL 和 Qwen3-VL 的多个参数规模。
四个数学基准的平均分(Avg.)
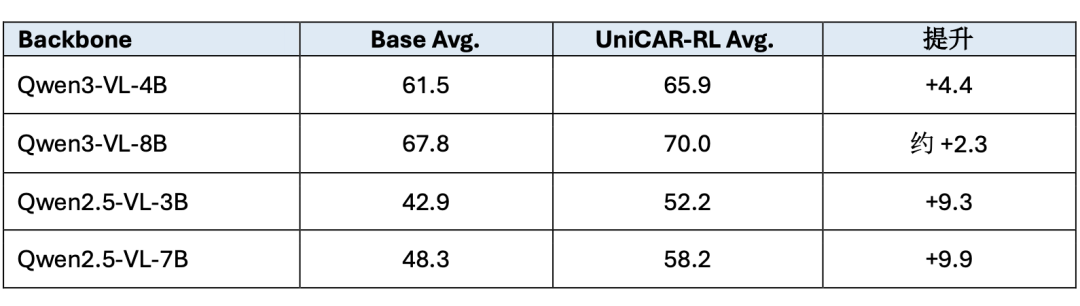
〓 注:UniCAR-RL 结果采用论文中对应配置;不同 backbone 的 verifier 配置见原论文 Table 1/2。
最明显的趋势是:初始感知能力越弱的 backbone,收益往往越大。
Qwen2.5-VL-7B 的四项平均分从 48.3 提升到 58.2,绝对增益达到 9.9;Qwen2.5-VL-3B 也从 42.9 提升到 52.2。
Qwen3-VL 这类更强的新模型依然能稳定获益,4B 配置在 Gemini 3 Pro verifier 下从 61.5 提升到 65.9。
更关键的是,论文单独测了“视觉描述是否更有用”。
统一使用 Gemini 3 Pro 作为 solver 时,Qwen3-VL-4B 零样本 caption 的 verifier-solve 平均准确率是 71.4;普通 GRPO 只提升到 72.8(+1.4),而 UniCAR-RL 达到 75.9(+4.5)。
这说明最终数学成绩的提升并不只是模型更会“猜答案”或更会写推理链,视觉描述本身确实变得更充分。
这种感知增益也能迁移到更一般的多模态任务。以 Qwen3-VL-4B 为例,ChartQA 从 83.0 提升到 89.5,HallusionBench 从 73.7 提升到 75.5。
论文因此认为,针对细粒度 perception bottleneck 的优化并不只服务于数学图形。
为什么三条分支都不能少?
分支消融给出了一个很直观的结果。
完整 UniCAR-RL 在 Qwen3-VL-4B + Gemini 3 Pro 设置下平均分为 65.9;去掉 Reasoning-RL 后下降到 64.2。
去掉 Caption-RL 后就退化成普通 Vanilla GRPO,只有 62.8;再去掉 QA-RL,则回到 base model 的 61.5。
这组结果说明,单纯加 RL 并不足以解决视觉数学里的感知瓶颈。
Caption-RL 提供针对感知的直接信号,Reasoning-RL 负责在可靠视觉条件上强化逻辑,QA-RL 则保证前两种专门能力能够重新整合到真实的端到端推理流程中。
案例:普通 GRPO 会纠正“推理错”,但未必能纠正“看错”
论文中的定性案例很能体现这种差别。
在第一类题目里,baseline 和普通 GRPO 都把图中的几何关系读错,例如产生错误的共线判断;即使后续推导写得很完整,最终答案仍然错误。UniCAR-RL 则先修正了视觉关系,再完成正确计算。
另一类题目主要是逻辑推导错误。这里普通 GRPO 已经能够起作用,而 UniCAR-RL 仍能保持并强化这种推理纠错能力。
也就是说,三分支设计并不是用“感知训练”替代传统 RL,而是在保留推理优化的同时,额外补上过去难以直接监督的视觉感知环节。
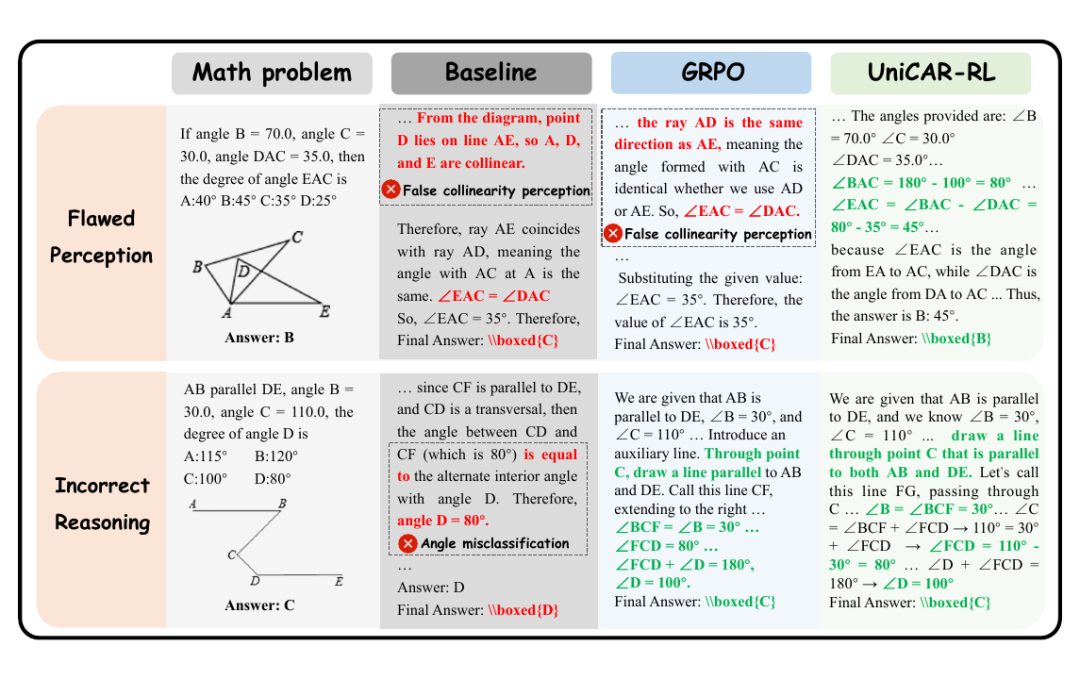
〓 图3:Baseline、GRPO 与 UniCAR-RL 的定性对比。上例主要是感知错误,下例主要是推理错误(来自论文 Figure 3)
代价:每一步更贵,但整体训练开销没有线性放大
三分支训练显然会带来额外成本,其中最主要的开销来自 Caption-RL,因为每个 caption 还要经过 verifier 求解。
论文统计显示,一个完整 UniCAR-RL iteration 的总耗时约为 Vanilla GRPO step 的 3.75 倍。
不过,在实验观察中 UniCAR-RL 需要的优化迭代更少:大约 70 次,而 Vanilla GRPO 约 150 次。
因此最终总训练时间约为 Vanilla GRPO 的 1.75 倍。换句话说,方法不是“免费提升”,但额外成本明显低于把三分支的单步倍率直接乘到整个训练过程上。
从“先看清,再深想”出发
UniCAR-RL 想解决的其实是一个比视觉数学更普遍的问题:对于多模态大模型,推理链的上限往往受制于输入理解的下限。
只要第一步视觉解析出了问题,后面再强的 reasoning 也很难补救。
这项工作的核心并不是额外构造一套昂贵的感知标注,而是利用“一个文本 solver 能否从描述中还原正确答案”作为任务相关的验证信号,把原本难以监督的 perception 变成可做 RL 的对象。
最终,Caption-RL 负责“看清”,Reasoning-RL 负责“想对”,QA-RL 负责“在真实输入里把两件事一起做好”。
目前方法主要在视觉数学和少量通用视觉任务上验证,三分支训练也会增加计算开销。
后续一个值得继续探索的方向,是把这种 perception-reasoning decoupling 扩展到图表理解、文档推理、科学图示等更广泛的多模态任务中。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。