NeurIPS 2026 让医学多智能体学会"何时协作"
原创 52CV 2026-11-05 23:55 江苏
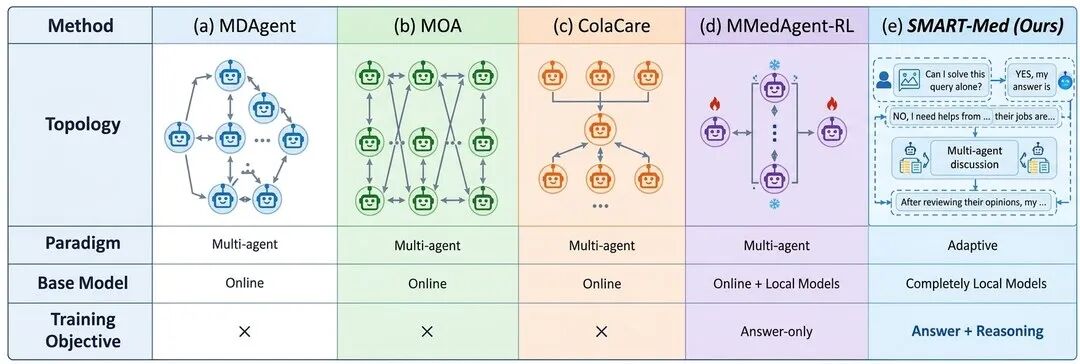
近年来,多智能体系统(Multi-Agent System, MAS)在医学视觉问答(MedVQA)和多模态医学推理中表现亮眼:多个大模型扮演不同科室的专家,通过多轮讨论共同给出诊断。然而,这类系统想真正走进医院,还面临两个现实障碍:
依赖云端大模型:现有 MAS 大多调用 GPT、Gemini 等云端模型,而 MRI、CT、电子病历等大都包含私人信息,上传到外部服务器在临床上往往受到严格限制,带来隐私与合规风险。
"全员会诊"代价高昂:现有 MAS 对每一个问题都启动多智能体、多轮讨论,推理延迟和 token 开销成倍增长,而这种密集协作在 MedQA 和 MedVQA 上带来的提升往往与昂贵的推理开销不成正比。
既然很多问题一个医生就能答对,我们能否让系统自己判断:什么时候该独立作答,什么时候才需要请专家会诊?
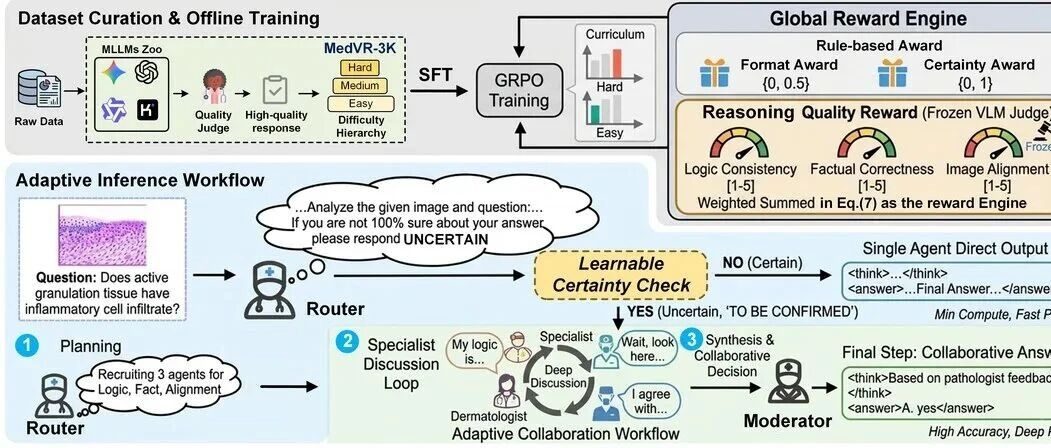
围绕这一问题,我们提出了 SMART-Med:一个完全基于本地小模型的医学多智能体方法。它不再把协作当作默认流程,而是把"是否协作"变成一个可学习的决策。
论文标题:Learning When to Collaborate: Selective Multi-Agent Medical Reasoning via Uncertainty-Aware Routing
发表会议:NeurIPS 2026
一、核心贡献
首个完全本地化的医学多智能体系统:SMART-Med 的所有智能体均由本地小规模多模态大模型(Qwen3-VL-4B-Instruct)构成,通过不确定性驱动的选择性协作,只在模型"拿不准"时才触发多智能体推理,在保护数据隐私的同时大幅降低推理成本。
构建推理导向的医学数据集 MedVR-3K:包含 3,477 个带有逐步推理链、难度标签和质量评分的医学视觉问答样本,为本地模型提供比"只有答案"更丰富的监督信号。
设计两个新的强化学习奖励:基于 GRPO 微调本地模型,提出将置信度与正确性绑定的确定性感知准确率奖励(CAR),以及对推理过程进行细粒度打分的视觉-语言推理质量奖励(RR)。
全面的实验验证:在 Slake、PathVQA、VQA-RAD、PMC-VQA 四个公开基准上,SMART-Med 在推理时间上比最快的多智能体基线快 3.8 倍以上,token 用量减少 72%;在 MedVR-3K 上微调后,四个数据集平均提升 6.7%。
二、像全科医生一样"分诊"
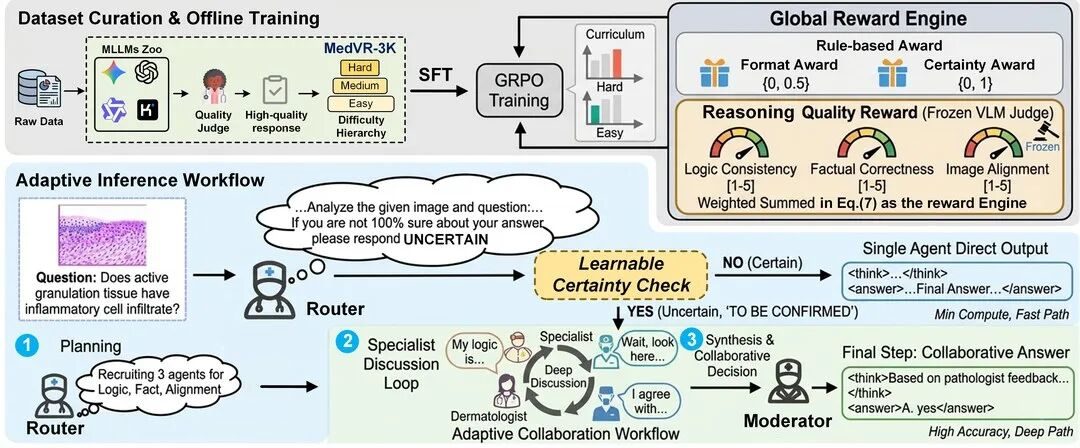
核心思路:在真实的就医流程中,患者到医院的第一步是分诊,由全科医生根据症状判断该去哪个科室,而不是每个患者都请所有专家会诊。SMART-Med 借鉴了这一流程:
路由智能体充当"全科医生":对每个问题,本地模型先给出初步答案,并在答案后附上一个确定性标记:CERTAIN(确定)或 UNCERTAIN(不确定)。
确定 → 直接作答:如果模型有把握,就直接采用初步答案,跳过昂贵的多智能体讨论,只需 1 次模型调用。
不确定 → 召集专家会诊:如果模型拿不准,就招募一小组专科智能体进行协作推理,最后由主持智能体(moderator)汇总各位专家的分析报告,作出最终决策。
这样,SMART-Med 的工作流程是完全自适应的:简单问题走"快速通道",疑难问题走"深度会诊"。
让模型"学习协同与否":这一机制的关键在于模型能否准确判断自己的把握程度。如果模型答错了却很自信,问题就不会被送去会诊。为此,我们用 GRPO 对路由智能体进行强化学习,并设计了两个新的奖励:
确定性感知准确率奖励(CAR):普通的准确率奖励只区分对和错,无法区分"自信地答错"和"谨慎地求助"。CAR 将置信度与正确性绑定:自信且答对得满分;答对但标记为不确定,得部分分;不确定且答错不扣分;自信但答错则受到惩罚。这鼓励模型在可能出错时主动选择"求助"。
推理质量奖励(RR):我们在 MedVR-3K 上微调了一个轻量的视觉-语言评分模型,从逻辑一致性、事实正确性、图像对齐三个维度评估生成的推理链,引导模型不仅答对,还要"想对"。
最终奖励由格式奖励、CAR 和 RR 融合而成。
主要观察:从决策的角度看,CAR 相当于为模型引入了一个"拒答(转交会诊)"选项。在理想情况下,只有当模型估计自己答对的概率超过某个阈值时,直接作答才更划算,否则转交会诊更优;这个阈值由部分得分和惩罚力度两个超参数共同决定。实际训练中,路由边界由 GRPO 隐式学习得到。
三、推理导向的医学数据集
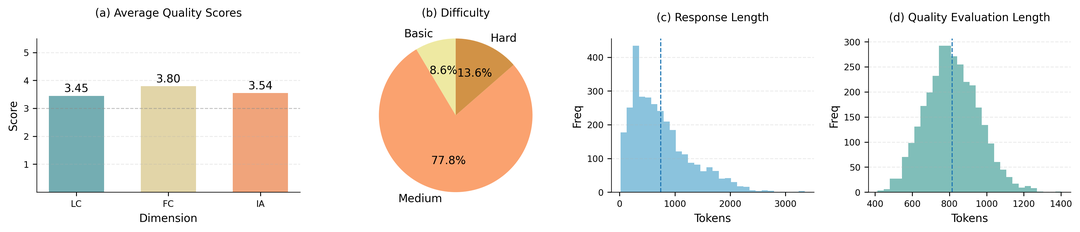
已有的医学多智能体方法大多只监督最终答案。为了提升本地小模型的推理能力,我们构建了 MedVR-3K,每个样本除了医学图像和问题外,还包含逐步推理链、难度标签以及质量评分和评语:
数据收集:从 Slake、PMC-VQA、VQA-RAD、PathVQA 四个公开基准的训练集中收集图像-问题对,并让 GPT-5.4、Gemini 3 Pro、Qwen3-Max、Kimi K2.5 等强模型生成带有逐步推理的回答。
第一轮过滤(正确性):只保留最终答案与标准答案一致的回答,避免"表述流畅但结论错误"的推理链混入数据集。
第二轮过滤(质量):使用 GPT-5.4 作为独立评审,从逻辑一致性、事实正确性、图像对齐三个维度分别打分(1–5 分),每个维度都达到阈值才保留,避免某一维度的高分掩盖其他维度的不足。
难度分级:评审模型根据问题复杂度和视觉复杂度,将样本标注为基础、中等、困难三个等级,在实际训练中,可按照难度进行课程学习。
经过两轮过滤和分级标注,MedVR-3K 最终包含 3,477 个高质量样本,平均质量评分约 3.6。
四、实验结果与关键发现
我们在 Slake、PathVQA、VQA-RAD、PMC-VQA 四个公开 MedVQA 基准上,分别在选择题(MC)和开放式问答(FF)两种设置下进行评测,对比了医学专用模型、本地通用模型以及 MedAgents、MDAgents、MOA、ColaCare 等多智能体方法。为保证公平,所有多智能体方法均使用 Qwen3-VL-4B-Instruct 作为基座模型。
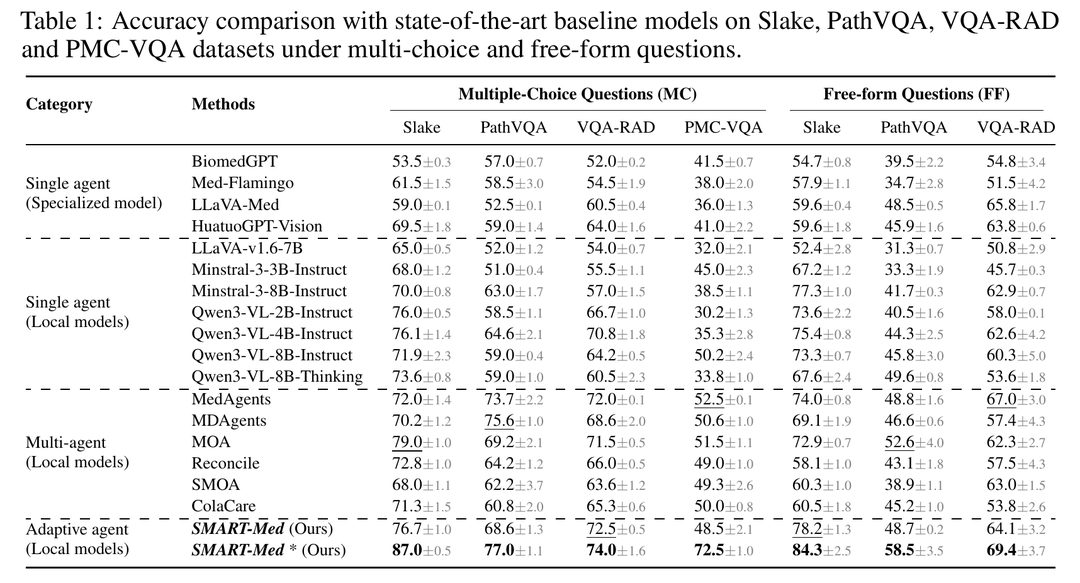
发现一:微调后,SMART-Med 在本地模型中全面领先。
不经任何微调,SMART-Med 已具备很强的竞争力:例如在 Slake 开放式问答上达到 78.2%,超过最好的本地基线(77.3%)。
在 MedVR-3K 上微调后(SMART-Med*),选择题在 Slake、PathVQA、VQA-RAD、PMC-VQA 上分别达到 87.0%、77.0%、74.0%、72.5%,比最好的基线高出 8.0、1.4、2.0 和 20.0 个百分点;开放式问答也在三个数据集上取得本地模型中的最好结果。
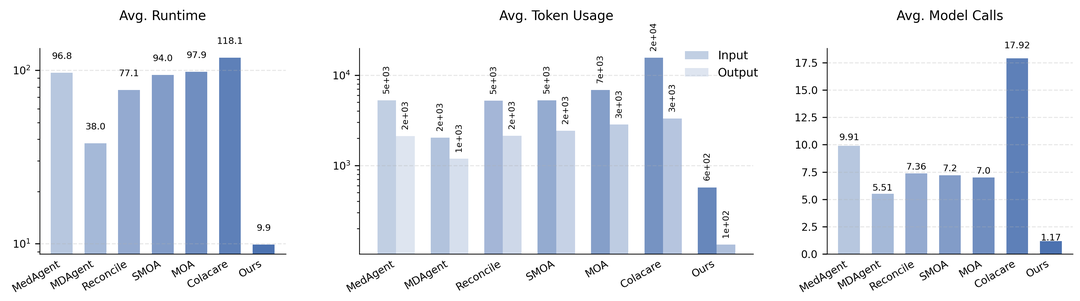
发现二:效率大幅提升。
更快:平均每个问题耗时不到 10 秒,比最快的多智能体基线(MDAgents)快 3.8 倍,比密集协作方法(ColaCare)最多快 11.9 倍。
更省:每个问题仅消耗约 600 个输入 token 和 100 个输出 token,输入和输出 token 分别减少 72% 和 88% 以上。
更少调用:平均每个问题只需 1.17 次模型调用,而其他方法需要 5.51–17.92 次。
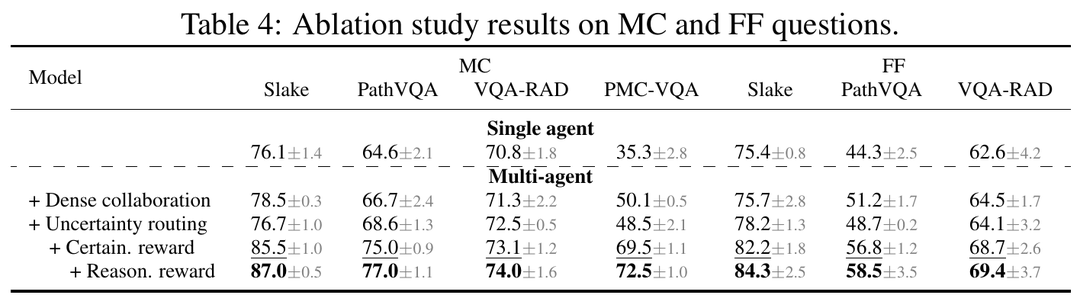
发现三:协作应该是选择性的,而不是"全员参与"。
不经训练,仅把"全员会诊"换成不确定性路由,性能就与密集协作相当甚至更好,例如 PathVQA 选择题从 66.7% 提升到 68.6%,Slake 开放式问答从 75.7% 提升到 78.2%。这说明很多问题一个智能体就能可靠解决。
加入 CAR 奖励后,PMC-VQA 选择题从 48.5% 大幅提升到 69.5%;再加入 RR 奖励,进一步提升到 72.5%,在开放式问答上的提升尤为明显。
结语
医学多智能体系统要真正落地临床,必须要将高效、可本地部署、保护隐私纳入考虑。SMART-Med 的核心观点是:多智能体协作应该是选择性的,而不是默认的。通过"全科医生"式的不确定性路由、推理导向的 MedVR-3K 数据集,以及结合确定性与推理质量的强化学习奖励,本工作提供了:
一种完全本地化、按需协作的医学多智能体推理方法;
一个带有推理链、难度分级和质量评分的医学视觉问答数据集;
在准确率、效率和推理质量上的系统性验证。
我们希望这项工作能为构建实用、高效、可部署的医学 AI 系统提供新的思路。代码和数据集均已开源,欢迎大家关注和使用!

本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。