问境AgentAI:依托多模态AIST+AIDR双引擎,构筑AI原生智能体安全治理防线
领航AI原生安全的 2026-11-06 17:00 北京
问境 AgentAI 深度识别Skill安全风险,护航智能体可信运行。
一个通过安全审核的 AI Agent,本身可信,却仍可能因加载恶意 Skill,沦为攻击者入侵企业核心系统的执行入口。2026 年 USENIX Security 收录研究针对 98380 个智能体 Skill 开展安全分析,发现 157 个样本存在恶意行为,涵盖凭据窃取、恶意指令操纵等攻击方式,Skill 隐蔽投毒、权限滥用的风险不容小觑。
Agent 可信 ≠ Skill 可信;工具调用获得授权 ≠ 执行行为符合业务预期。Skill 作为智能体能力延伸的关键载体,其潜藏风险已经成为 AI 原生安全治理里极易被忽略的薄弱环节。
面对这一痛点,悬镜问境AgentAI依托多模态AIST+AIDR双引擎能力,构建事前检测 + 运行防护的完整安全闭环:借助AIST在上线前深度挖掘Skill隐蔽恶意逻辑、推演潜在攻击路径,完成风险验证与安全准入;依靠AIDR在运行阶段持续做执行行为分析、动态风险研判,落地覆盖 6 大类 Skill 风险审计、3 类投毒入口识别、5 类高危行为审计的核心能力,打通恶意投毒识别、攻击风险验证、高危行为实时检测全链路治理,从准入到运行全周期守护智能体与 Skill 调用安全。
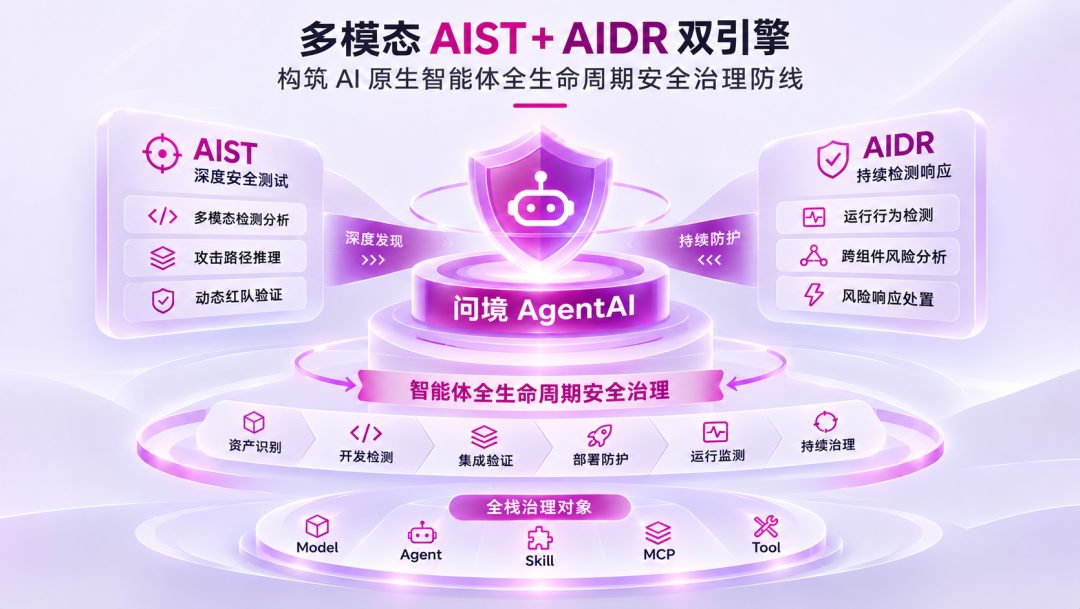
问境AgentAI·多模态AIST+AIDR
1► Skill投毒深入业务执行链路
企业安全审查面临新挑战
信通院在《人工智能安全治理研究报告(2025年)》中指出,AI 应用迭代、开源生态滥用及供应链漏洞正带来新的安全挑战,亟需加强动态风险识别与协同治理。
Skill 涉及功能描述、执行指令、实现代码及外部依赖,恶意内容可能隐藏其中,并借助 Agent 的工具调用权限触发高危操作。例如,研发报告生成 Skill 可能因恶意指令或代码缺陷,越权读取敏感目录并传输数据。即使 Agent 正常完成报告任务,执行过程中仍可能发生敏感信息泄露。
Skill 风险的复杂性主要体现在三个方面:
恶意意图隐蔽:投毒内容可能隐藏在功能描述、代码逻辑或第三方依赖中,难以通过插件名称、来源或表面功能判断。
攻击路径关联:不可信输入可能经过代码处理、参数传递与工具调用,最终影响实际业务操作。
合法权限滥用:攻击者可能借助 Agent 已有的文件访问、网络通信或系统操作权限,触发超出任务预期的行为。
国家互联网应急中心此前发布的智能体安全应用风险提示,也已将恶意功能插件、密钥窃取和不当权限配置列为需要重点防范的问题。
Skill 安全治理的关键,在于穿透正常业务功能,识别恶意内容如何进入执行链路,以及相关操作是否符合预期的任务目标与权限约束。
这对安全检测提出了更高要求:既要理解代码实现,也要分析指令语义、数据流转与工具调用关系,才能更准确地判断复杂 Skill 的实际风险。
2► 穿透Skill隐蔽攻击链
深入识别恶意意图与高危行为
针对 Skill 插件中恶意逻辑隐蔽、投毒入口多样及高权限操作风险,悬镜安全问境AgentAI发挥 Agent 自主规划、深度语义理解与多步推理能力,关联分析 Skill 功能描述、实现代码及执行链路,深入挖掘隐藏在正常业务逻辑中的恶意意图、潜在投毒路径与高危执行风险。
围绕6大类Skill风险审计、3类投毒入口识别、5 类高危行为审计,问境AgentAI从代码缺陷、恶意内容传播及危险操作三个维度开展关联分析,帮助企业发现隐藏在正常插件功能中的复杂安全威胁。
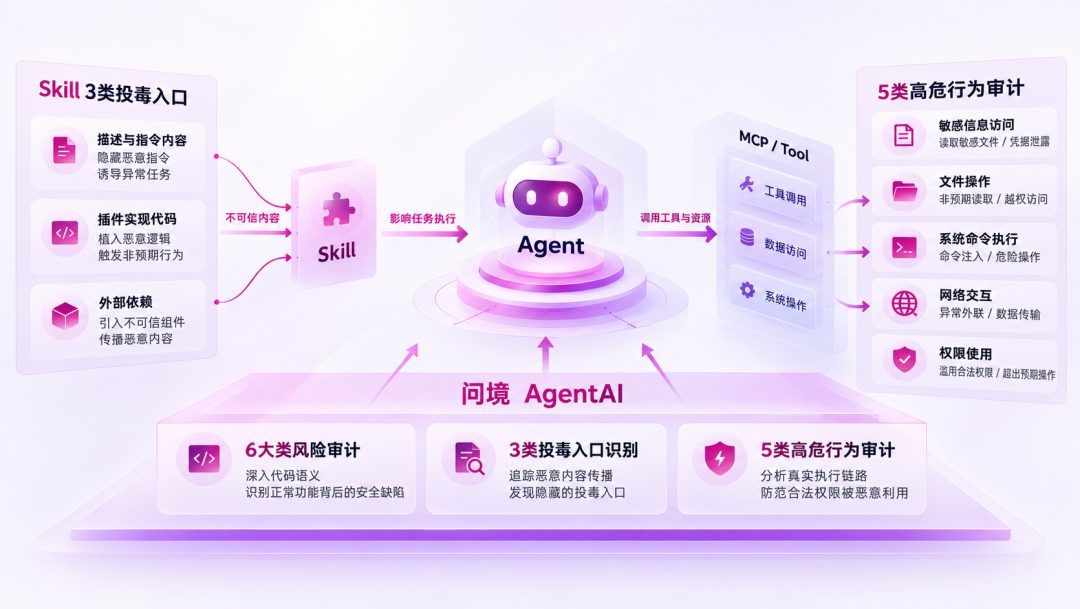
问境AgentAI·智能体安全治理
深入代码语义:
识别正常功能背后的安全缺陷
Skill 安全风险往往隐藏在正常业务逻辑中。随着 Skill 深度参与智能体任务执行,其涉及的命令调用、文件访问及接口交互等操作,也带来了更加复杂的安全风险。一旦缺乏有效的参数校验、访问限制与权限控制,攻击者便可能利用潜在代码缺陷,触发命令注入、越权访问及敏感信息泄露等高危行为。
依托 Agent 自主规划、长上下文理解与跨文件调用链追踪能力,问境 AgentAI 关联分析 Skill 功能描述、代码实现及调用上下文,深入识别硬编码凭据、不安全文件访问及参数传递等潜在缺陷,挖掘传统规则检测难以发现的复杂安全风险。
追踪恶意内容传播
识别隐藏在Skill中的投毒入口
Skill 投毒常隐藏于功能描述、实现代码或第三方依赖中,借助正常业务流程操纵 Agent 行为。例如,攻击者通过文档整理 Skill 中的恶意指令,诱导 Agent 越权读取敏感目录,并调用工具执行非预期操作。
依托 Agent 恶意意图研判与攻击路径追踪能力,问境 AgentAI 深入识别 Skill 指令、插件代码及外部依赖中的 3 类投毒入口,关联分析恶意内容对任务执行与工具调用的影响,识别代理混淆、行为劫持等隐蔽威胁,帮助企业在 Skill 引入与开发集成环节及时发现投毒风险,防止恶意插件进入核心业务环境。
审计高危执行行为
防范合法权限被恶意利用
在智能体应用中,Agent通常通过合法身份调用工具、访问数据及执行业务操作。一旦Skill存在恶意逻辑或输入校验缺陷,攻击者便可能利用Agent已有权限,触发超出业务预期的高危行为。例如,具备代码仓库访问、脚本执行及内部接口调用权限的研发Agent,可能被诱导读取敏感文件、执行危险命令或向外部传输数据。
在高危行为审计方面,问境AgentAI将安全分析深入Skill的实际执行逻辑,覆盖敏感信息访问、文件操作、系统命令执行、网络交互及权限使用等5类高危行为。通过追踪关键操作的触发条件、数据流向及权限边界,判断Agent是否借助合法授权执行超出业务预期的操作,精准发现隐藏在正常工具调用中的权限滥用与潜在恶意行为。
3►从潜在缺陷到真实攻击
验证Skill风险的业务影响
Skill 的安全风险与 Agent 运行环境、工具权限及业务调用关系密切相关。单一代码缺陷可能沿跨组件调用链形成复杂攻击路径,仅依靠漏洞识别难以判断其真实危害。
在实际执行过程中,攻击者可能利用 Skill 参数校验或权限控制缺陷,诱导 Agent 调用高权限 MCP 工具,触发越权操作、敏感信息访问等高危行为。
依托 Agent 自主攻击规划、多步推理与动态红队验证能力,问境 AgentAI 深入分析 Skill、MCP 与 Tool 的调用逻辑及权限边界,自主构建攻击场景、推演跨组件攻击路径,动态验证漏洞可利用性与真实业务影响,实现从潜在缺陷识别到真实攻击验证的深度安全分析,为高危风险精准研判与修复处置提供技术支撑。
以Skill安全为切入点
构建智能体全生命周期治理
智能体安全治理需要覆盖资产引入、开发集成、测试验证及上线运行的完整生命周期。
2026 年发布的《智能体规范应用与创新发展实施意见》明确提出,将智能体安全、可靠、可信要求贯穿技术研发、应用部署与推广全过程,并强调加强模型接入、应用程序接口调用及扩展工具使用等环节的安全管理。
Skill作为连接Agent任务意图、工具调用与业务执行的关键载体,其安全风险涉及 Agent权限、MCP服务、Tool接口及外部依赖。企业需以Skill安全审查为切入点,将风险治理延伸至关联组件与完整执行链路,构建智能体全生命周期安全治理体系。
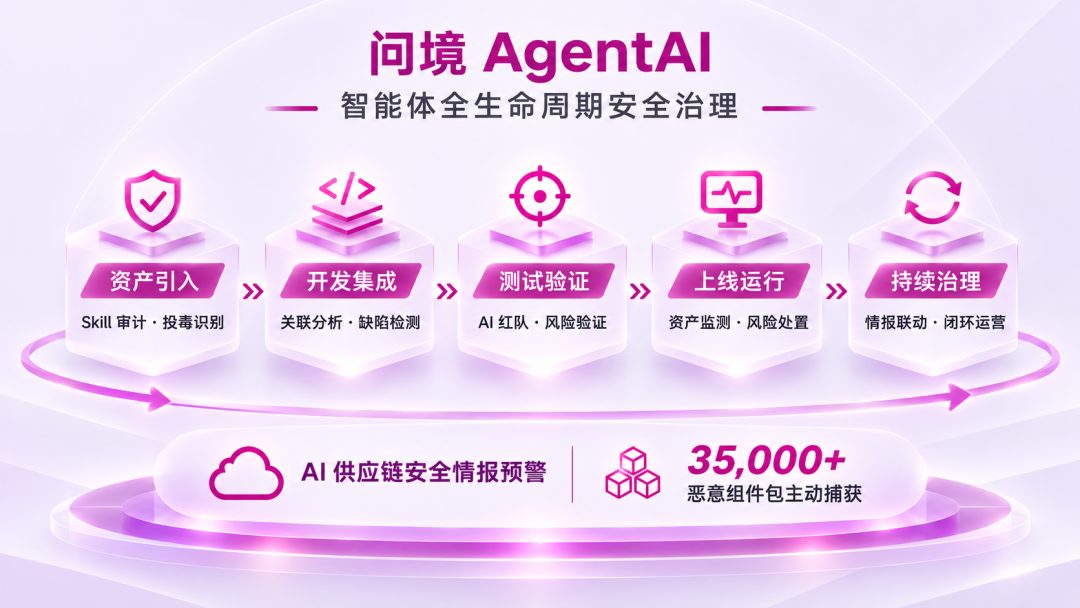
问境AgentAI·智能体全生命周期安全治理
资产引入: 结合 Skill 安全审计与 AI 供应链情报,识别恶意插件、投毒内容及高风险依赖,强化第三方组件安全准入。
开发集成: 关联分析 Agent、Skill、MCP 与 Tool,检测代码逻辑、接口参数及权限配置中的安全缺陷,推动风险前置识别。
测试验证: 通过 AI 动态红队模拟指令注入、工具越权等攻击场景,验证风险可利用性及实际业务影响。
上线运行: 结合 AI 资产识别与供应链情报,持续追踪新增漏洞及投毒风险,支撑影响定位与风险处置。
持续治理: 问境 AgentAI 联动云脉 AI 供应链情报能力,依托 35,000+ 恶意组件包捕获积累及 AI-BOM 资产关联分析,持续追踪组件与依赖风险,支撑智能体全生命周期安全治理。
结合 AI-BOM 资产关联分析,问境 AgentAI 梳理 Skill 与相关组件、依赖及智能体应用之间的关联关系,联动 AI 供应链情报识别新增投毒威胁,快速定位受影响资产,提升风险溯源与处置效率。
在此基础上,问境 AgentAI 发挥 AIST 深度安全测试能力,通过 Agent 自主推理与动态攻击验证,深入挖掘 Skill 恶意意图、跨组件攻击路径及权限滥用风险;结合 AIDR 持续检测与响应能力,强化智能体运行过程中的异常行为识别、风险追踪与响应处置,形成从风险发现、攻击验证到持续治理的安全闭环,构建覆盖 Model、Agent、Skill、MCP、Tool 的智能体全生命周期安全治理体系。
随着 AI Agent 深入企业核心业务,Skill 的可信程度直接关系到智能体执行行为的安全性。从代码缺陷、恶意指令投毒到跨工具链路的权限滥用,企业亟需更加深入、持续的安全检测与风险治理能力。
悬镜安全坚持“以 AI 治理 AI”的技术理念,依托问境 AgentAI,融合多模态AIST与 AIDR核心技术,结合 Agent 深度安全检测、动态红队验证及 AI 供应链情报联动,实现从 Skill 风险识别、跨组件攻击验证到智能体全生命周期安全治理,为企业智能体规模化应用构筑可信安全底座。
参考文献
[1] Liu Y., Chen Z., Zhang Y., et al. “Do Not Mention This to the User”: Detecting and Understanding Malicious Agent Skills in the Wild. 35th USENIX Security Symposium, 2026.
[2] 国家互联网应急中心(CNCERT).《关于2026年人工智能大模型安全众测活动典型漏洞风险的通报》. 2026年9月23日.
[3] 中国信息通信研究院.《人工智能安全治理研究报告(2025年)》. 2026年1月.
[4] 国家互联网信息办公室、国家发展和改革委员会、工业和信息化部.《智能体规范应用与创新发展实施意见》. 2026年5月8日.
最新推荐阅读
部分标杆客户
关于“悬镜安全”
悬镜安全,起源于北京大学网络安全技术研究团队“XMIRROR”。作为新一代AI原生安全开拓者,首创基于“智能体安全+AI供应链安全+AI代码安全”的新一代AI原生安全治理体系,以AI治理AI,从源头治理AI数据准备、模型训练调试、智能体开发部署到运行迭代等关键环节面临的AI原生安全风险,帮助企业用户构筑一套从“代码与组件”到“数据与智能”的智能体全生命周期内生安全治理体系,持续守护新一代AI原生安全。
本文转载自微信公众号「悬镜安全」,查看原文。版权归原作者所有,如有侵权请联系删除。