SDC2026议题回顾 | 从字节到神经元——一名二进制安全研究员的 AI 安全研究
SDC2026 2026-11-06 17:59 上海
从二进制安全视角,探索大模型内部机制与行为差异
SDC2026
议题回顾
当大模型逐渐成为日常开发与安全研究中的重要工具,我们对它的关注也不应仅停留在输入与输出层面。模型内部究竟是如何完成计算的?权重数据、内部激活与运行环境之间存在怎样的联系?如果从传统二进制安全研究的视角出发,能否像分析程序一样,观察、干预甚至改变大模型的内部行为?
在本次分享中,来自 CertiK 的安全研究员黄涛,以一名二进制安全研究员的视角,从大模型内部结构入手,结合 TransformerLens 等分析工具,介绍如何观察和干预模型的内部计算过程,并通过一系列实验,分别从软件层面的模型加载差异、硬件层面的浮点数计算差异两个方向,探索同一份模型权重在不同运行环境下可能呈现出的不同表现。
从模型权重的解析方式,到不同芯片对极小浮点数的处理,再到模型内部计算路径与最终输出之间的联系,本次分享将通过具体实验和演示,带我们走进大模型内部,看看这些底层差异究竟如何影响模型行为。
黄涛 | Certik安全研究员
*以下为整理后的速记
大家好,我是来自 CertiK 的安全研究员。过去一年,我们的日常工作主要是借助 AI 提升安全服务能力,更好地服务客户、完善产品。不过,作为一名长期从事二进制安全研究的研究员,在使用大模型的过程中,我也产生了一个比较直接的好奇:大模型内部究竟在做什么?如果能够理解它的内部运行机制,是否也可以像分析传统程序一样,对模型进行观察和干预?
这就是今天这个议题的出发点。今天的分享会先借助逆向工程中的一些常见概念,建立对大模型内部运行过程的基本认识;在此基础上,再介绍我们做过的两个实验:一个从软件层面入手,研究模型权重加载过程中的差异;另一个从硬件层面入手,研究不同计算平台上的数值差异,以及这些差异可能对模型行为造成的影响。最后,再结合实验过程谈几点直接的观察。
从逆向工程的类比理解大模型内部
先从大家熟悉的程序说起。假设有一段代码,功能是计算 c = a + b。输入 5 和 3,程序就会输出 8。代码经过编译后,会变成保存在磁盘上的二进制指令。程序运行时,如果我们通过 patch 修改其中一个字节,把原来的加法指令改成减法指令,那么相同的输入就会得到不同的结果:5 和 3 不再得到 8,而是得到 2。
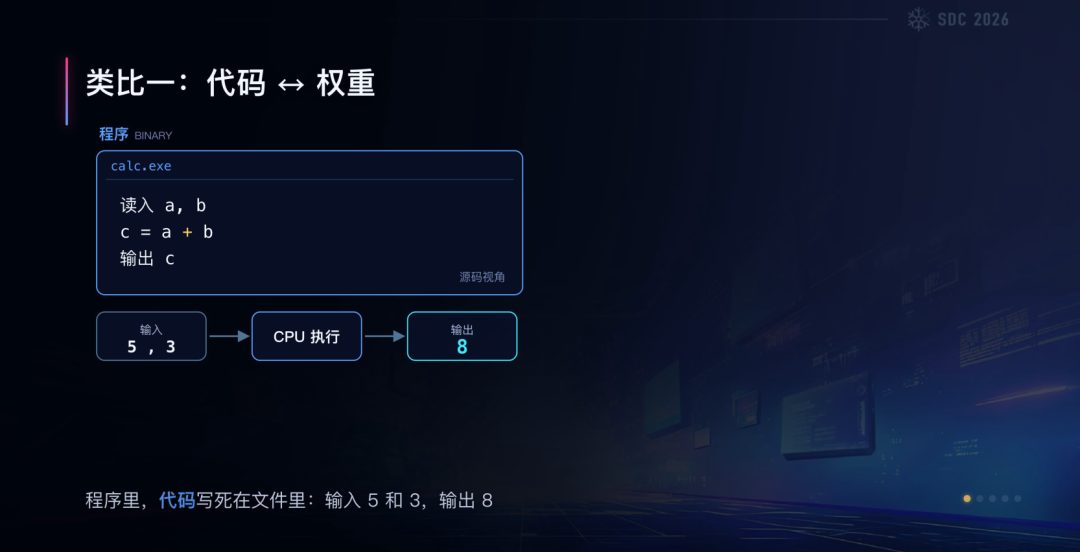
大模型的权重与程序代码有一定的相似之处。模型权重由大量矩阵构成,直接观察这些数值,很难看出它们分别承担什么作用。正常情况下,向模型输入“2+2等于几”,模型会回答 4。如果以二进制方式修改模型权重,能否像修改程序指令一样改变模型的输出?例如,让模型在简单数学问题上出现错误?理论上可以尝试,但如果只是粗暴地修改权重,模型更可能直接崩溃,输出乱码,而不是稳定地产生我们预期的错误。因此,代码与权重的类比,首先帮助我们理解两者都可能受到底层数据修改的影响,但具体机制并不完全相同。
第二个类比是程序运行时状态与模型激活。程序执行过程中会产生寄存器和变量等运行时状态。例如,计算 5+3 时,RAX、RBX、RCX 等寄存器中会保存相应的值;如果输入改为 7 和 9,运行时状态也会随之变化。这些信息只有在程序真正运行起来之后才能观察到。
大模型也有类似的运行时状态。在模型根据权重处理输入并生成回答的过程中,会产生一系列激活值。输入内容发生变化,模型内部的激活也会随之变化。例如,询问“2+2等于几”和“9+7等于几”,模型在推理过程中产生的激活并不相同。这里可以把激活与程序的 runtime 状态进行类比,但两者并不是完全相同的概念。
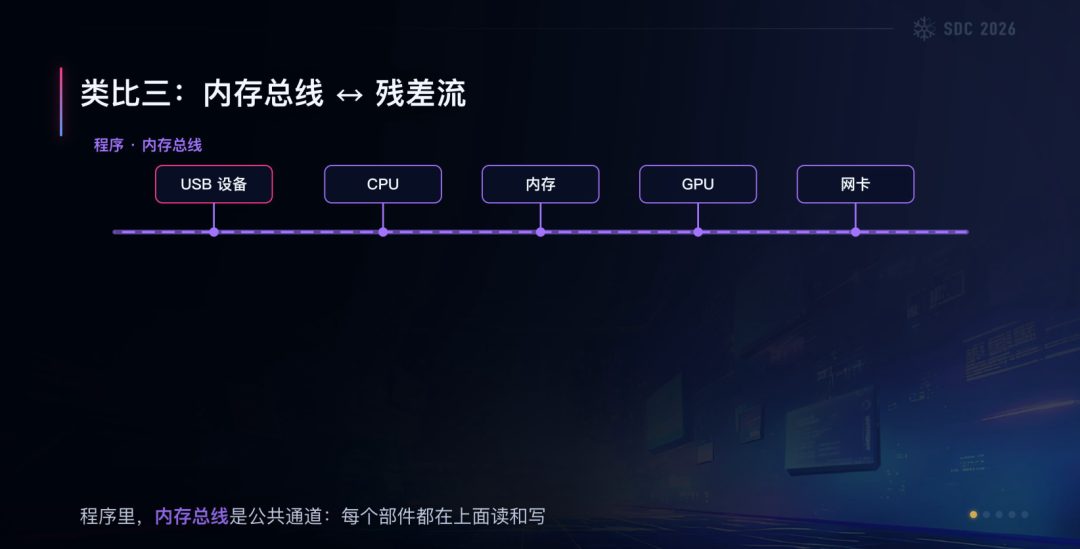
第三个类比是内存总线与残差流。可以把内存总线简单理解为多个部件都能够访问的一条公共通道。例如,设备向通道写入数据后,CPU、内存、GPU 或网卡等部件都可能读取这些数据。当然,这只是为了便于理解而作的简化类比,并不意味着两者在实现上完全一致。
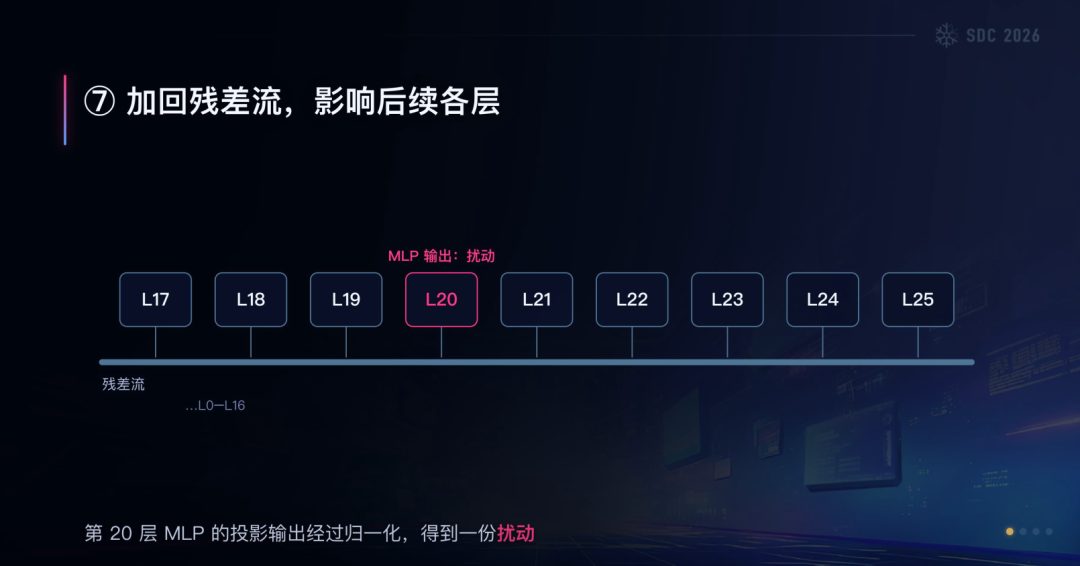
在 Transformer 模型中,残差流承担着类似的信息传递作用。模型通常由多层结构组成,例如 28 层、32 层或 64 层。每一层都会读取残差流中的信息,经过本层的计算后,再将结果写回残差流,供后续层继续读取和处理。因此,某一层写入残差流的内容,会继续影响后面的层,一直传递到模型输出。比如,第 20 层写入的信息,可能影响第 21 层、第 22 层,乃至更后面的层。
通过以上三个类比,可以对一次大模型的前向推理建立一个简化认识:输入进入模型后,会依次经过各层的注意力机制和 MLP 等结构;每一层读取残差流中的信息,完成计算,再将结果写回残差流。这个过程会根据模型层数重复多次,最后经过输出计算,得到模型的预测结果。日常使用大模型时,我们通常只能看到输入的 prompt 和最终输出,中间发生的计算过程并不能直接观察。要分析模型内部,就需要借助专门的工具。
分析工具:观察并干预模型内部
这里介绍的第一个工具是 TransformerLens。它是一个开源工具,并不是我自己开发的。可以把它理解为大模型分析过程中的调试器:在传统逆向分析中,我们会使用调试器或 Frida 等动态注入工具,通过 hook 获取程序运行过程中的内部信息;TransformerLens 则提供了观察模型内部计算过程的能力。
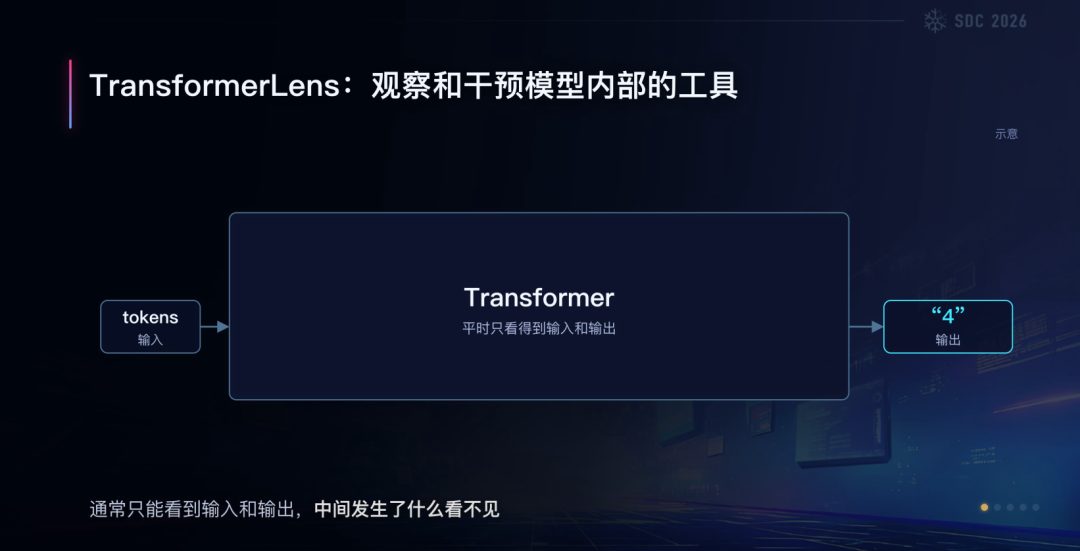
在一次正常推理过程中,TransformerLens 可以在模型的多个位置设置 hook 点,并将这些位置产生的数据缓存下来。例如,模型回答“2+2等于4”时,我们可以观察各层内部的数据,包括神经元相关计算的输入和输出,以及从残差流读取、向残差流写入的数据。通过缓存这些信息,就可以进一步替换某一层的数据,观察模型输出是否发生变化。
例如,假设替换第 20 层的数据后,模型的回答发生了变化;而替换第 21 层或其他层的数据后,输出没有明显变化,那么我们就可以据此判断,在这一次推理中,第 20 层可能发挥了比较关键的作用。进一步地,还可以比较不同层对最终答案的贡献:哪些层对某个答案的支持更强,哪些层的影响相对较小。
TransformerLens 的一个特点是 hook 点比较多。一次推理过程中,每一层可能有多个 hook 点;如果模型有 20 层,每层设置 5 到 8 个 hook 点,就会产生大量需要缓存的数据。每个位置的数据本身也可能很大,因此使用 TransformerLens 会带来较高的内存开销。它会把推理过程中各个位置的数据保存下来,便于后续分析。
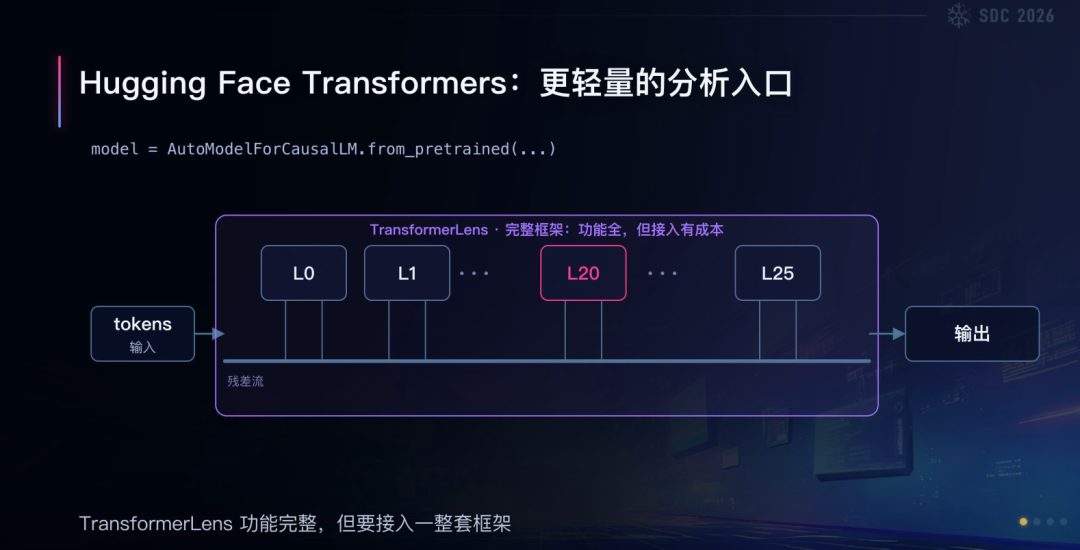
此外,为了更细致地观察 Transformer block 内部的结构,例如注意力机制中每个 head 的细节,TransformerLens 对模型原本的 forward 过程做了一些调整,会将部分结构拆分出来。因此,在使用它分析某个模型之前,需要确认调整后的 forward 函数与模型原本的 forward 函数在推理结果上基本等价。只有确认这一点,后续分析才有可靠的基础。从这个角度看,TransformerLens 更像一个功能比较完整、开销也比较大的调试器。
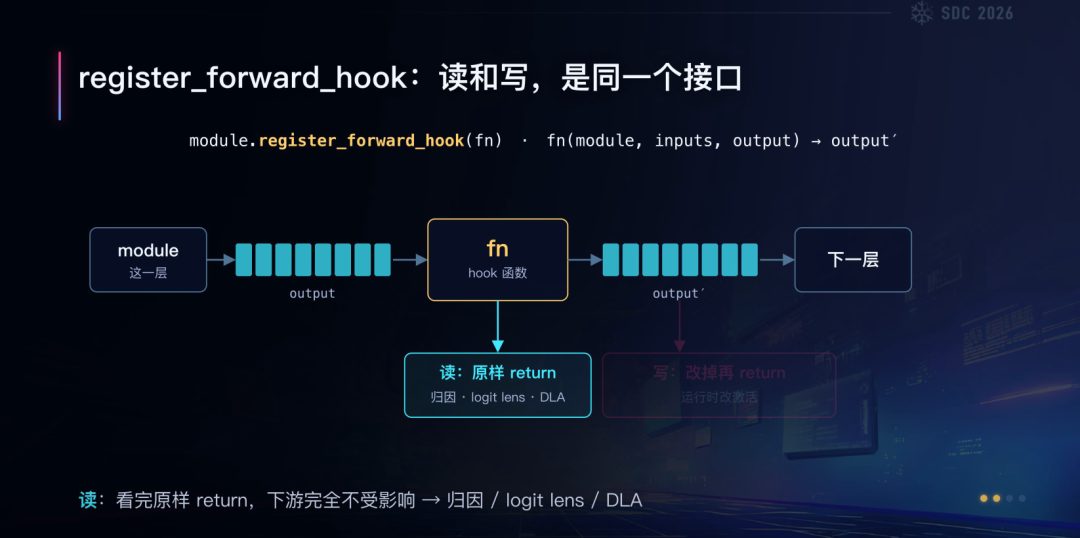
如果不需要观察如此多的内部细节,还可以使用 PyTorch 提供的 hook 机制。它更接近于轻量级的动态注入:不必把每个神经元、每个注意力头的内部数据都记录下来,只需要关注某一层向残差流写入的内容即可。
例如,可以在第 20 层挂载 hook,获取这一层的 output,再通过自定义函数处理后,将结果传递给下一层。这样就可以完成两类操作。第一类是读取,即观察某一层向残差流写入了什么数据;第二类是修改,即在数据写入后进行替换。例如,可以把某一层的输出改成全零,或者替换成其他数据,以观察这一层不再正常工作时会对模型产生什么影响。后续实验中的部分分析,就是基于这种读取和修改操作完成的。
在大模型权重分析中,这类工作通常会涉及机制可解释性(Mechanistic Interpretability)或电路分析。分析时,可以围绕模型最终输出的某个答案,观察不同层对该答案的贡献。例如,模型回答“2+2等于4”,我们可以分析各层对“4”这一结果提供了多少支持;也可以将某一层的贡献移除,再观察模型是否仍然回答 4。如果移除第 20 层的相关贡献后,模型转而回答 2,那么在一定程度上可以认为,第 20 层中的相关结构对这次加法回答具有比较重要的作用。
除了判断某一层是否重要,还可以进一步比较不同层的贡献大小。例如,第一层可能为某个答案提供 10 分的支持,第二层提供 14 分,最后一层提供 30 分,而第 20 层的贡献最大。通过这类分析,可以进一步定位模型在一次具体推理中依赖哪些内部计算。
软件层实验:同一份权重,不同的加载结果
了解了如何观察和干预模型内部之后,就可以进入第一个实验。平时在本地加载模型时,我开始关注模型究竟是如何被加载起来的。由于我使用的是苹果电脑,因此注意到 Mac 环境中存在两套不同的模型加载路径。
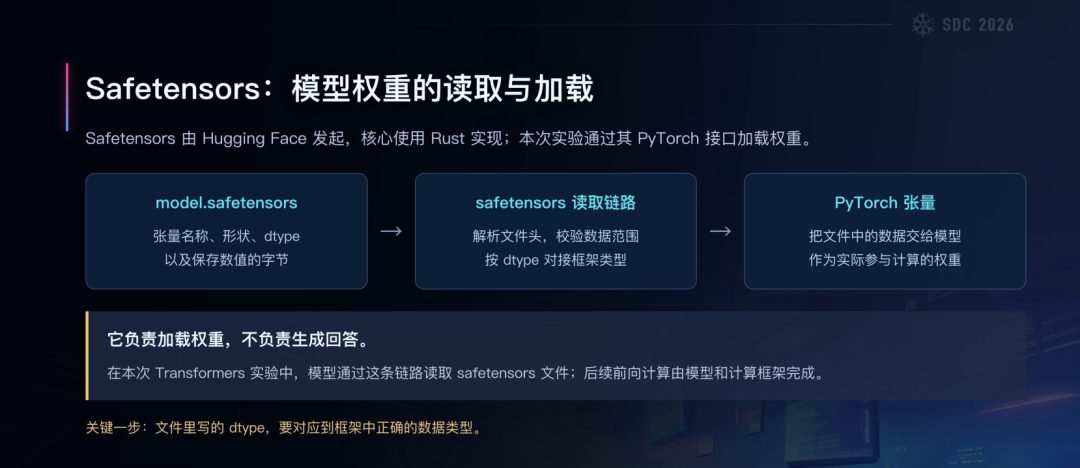
第一套路径来自 Hugging Face 生态,使用 Rust 实现 Safetensors 相关读取机制,用于读取和加载模型中的张量。另一套是苹果自己实现的 MLX。MLX 使用 C++ 等组件实现模型加载与计算,设计上也考虑了苹果自身的统一内存架构以及硬件调度特点。在苹果设备上进行本地模型部署时,很多情况下会使用 MLX,以便更好地适配其计算环境。
由此产生了一个很直接的问题:既然存在两个不同的加载器,那么同一种数据类型在两个加载器中,会不会被解析成不同的数值?我没有逐行检查所有代码,而是借助工具对两个开源项目的实现进行排查。经过几分钟的分析,发现了一个值得关注的数据类型:F8_E4M3。
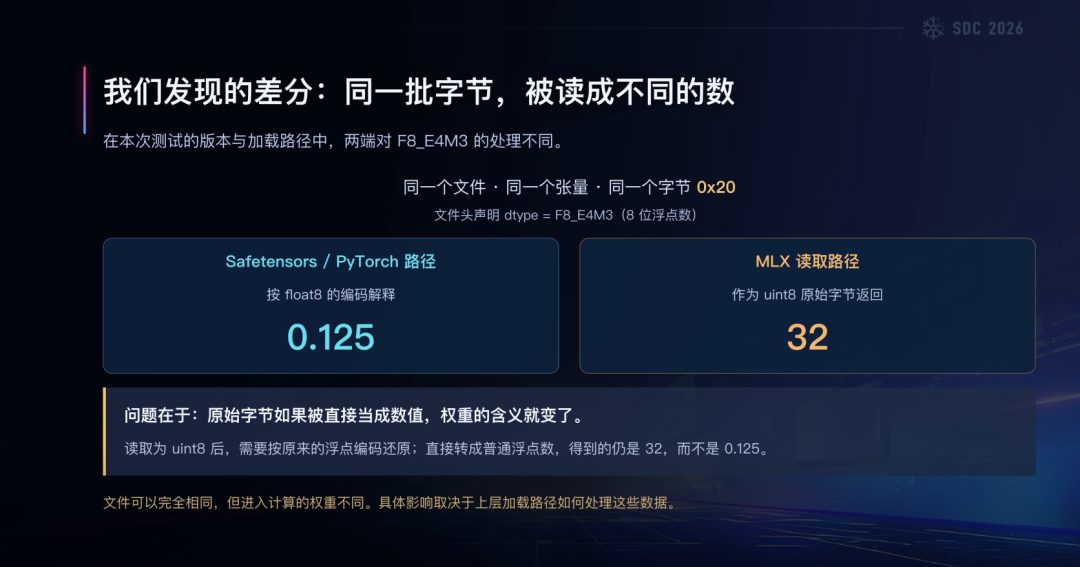
当 Safetensors/PyTorch 路径读取这种类型时,会按照 float8 浮点数进行解释;而在 MLX 的相关读取路径中,它被按照 uint8 整数处理,并没有按照相同的浮点数语义进行解析。也就是说,同一段权重数据,在不同加载器中可能得到完全不同的数值。
接下来要验证的是:能否利用这个差异,构造一份权重文件,使得 PyTorch 和 MLX 加载完全相同的文件后,模型表现出不同的行为?实验选择了 Qwen2.5-1.5B 作为基座模型。选择较小的模型,主要是因为实验在个人设备上进行,较大的模型不容易运行。
从模型结构来看,这里重点关注 Decoder Layer。实验将观察位置放在第 20 层,并进一步查看该层内部的注意力机制和 MLP 等计算结构。第 20 层中有一个 bias,也就是偏置参数。与输入 token 相关的权重不同,bias 本身是一个固定的可训练张量;训练完成后,在推理过程中它不会因为输入 token 的变化而改变。因此,它具备一个适合本次实验的特点:与当前输入内容无关,但在每次前向推理时都会参与计算。
基于前面发现的加载差异,我们尝试对一个原本使用 FP16 的模型进行修改,将其中第 20 层的部分 bias 数据强制改成 F8_E4M3 类型。这样,同一段二进制数据就可能在两种加载路径下得到不同的解释。虽然这种做法并不优雅,但它可以先用于验证差异是否真实存在。
以字节 0x20 为例,如果按 float8 的方式解析,其数值为 0.125;如果按 uint8 的方式解析,则得到 32,两者相差 256 倍。原始权重中,第 20 层相关 bias 的整体数值分布具有一定范围;经过类型修改后,按不同加载方式解释,数值分布也会发生明显变化。实验中,Safetensors/PyTorch 路径与 MLX 路径得到的整体数值存在很大差距,部分统计结果相差约 512 倍。
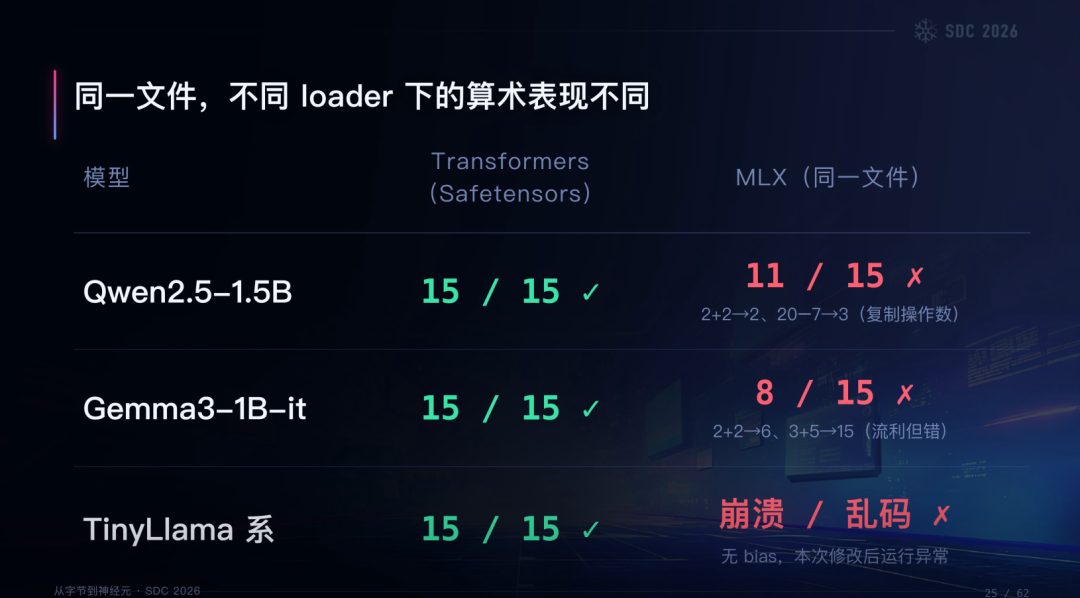
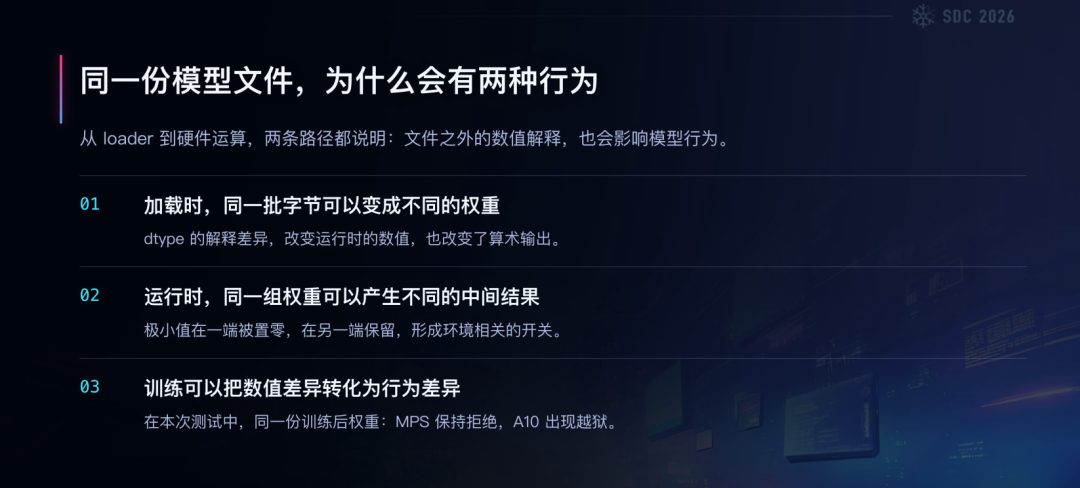
随后,我们将这种差异放到模型推理中验证。通过构造第 20 层的 bias,使同一份权重文件在不同加载器下产生不同的数值解释,再分别使用 PyTorch 和 MLX 加载。实验结果显示,对于同一个问题“2+2等于几”,PyTorch 路径下模型回答 4,而 MLX 路径下模型回答 2。也就是说,两个环境加载的是相同的权重文件,但由于加载器对权重数据的解释不同,最终模型行为也出现了差异。
除了 Qwen2.5-1.5B,我们还在 Gemma 3 和部分 LLaMA 系列模型上进行了测试。不同模型的表现并不相同。Qwen2.5-1.5B 的效果相对最好,可以构造出例如“2+2=2”或其他简单算术错误。Gemma 3 也能观察到一定效果,但表现不如 Qwen2.5-1.5B;部分 LLaMA 模型则出现了崩溃或乱码,无法达到预期结果。
从二进制安全研究的思路来看,如果应用层面的差异还不够,就可以继续向更底层寻找原因。因此,在完成软件层面的实验之后,我们又把关注点转向硬件,尝试寻找一种不需要直接破坏权重数据、而是利用不同硬件计算差异的方法。
硬件层实验:不同芯片上的浮点数差异
前一个实验通过修改权重数据类型,制造了不同加载器之间的差异。但这种方式需要直接修改模型权重,本身比较粗糙。接下来希望寻找一种更自然的方式:不直接改变权重文件,而是利用不同硬件平台在数值计算上的差异,让同一份权重在不同设备上产生不同的模型行为。
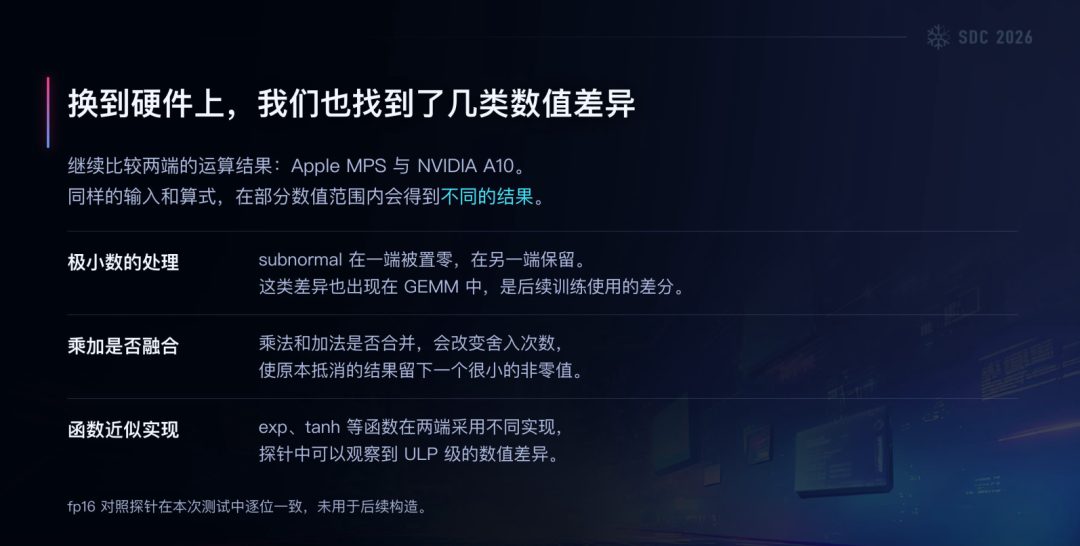
跨平台浮点数计算的一致性一直是一个问题。过去研究漏洞时,我也曾经好奇浮点数计算是否可能引发安全问题。当时的关注点更多在内存大小等传统问题上,没有继续深入。到了大模型场景,模型内部大量计算都与浮点数有关,因此不同硬件上的浮点数处理差异,就有可能影响模型运行结果。
我们重点关注了几类可能产生差异的情况:第一,极小数的处理方式是否一致;第二,乘法与加法交叉执行时,不同平台的结果是否一致;第三,指数函数、双曲正切等数学函数在不同平台上的计算是否存在差异。最终,实验选择从极小数处理入手。
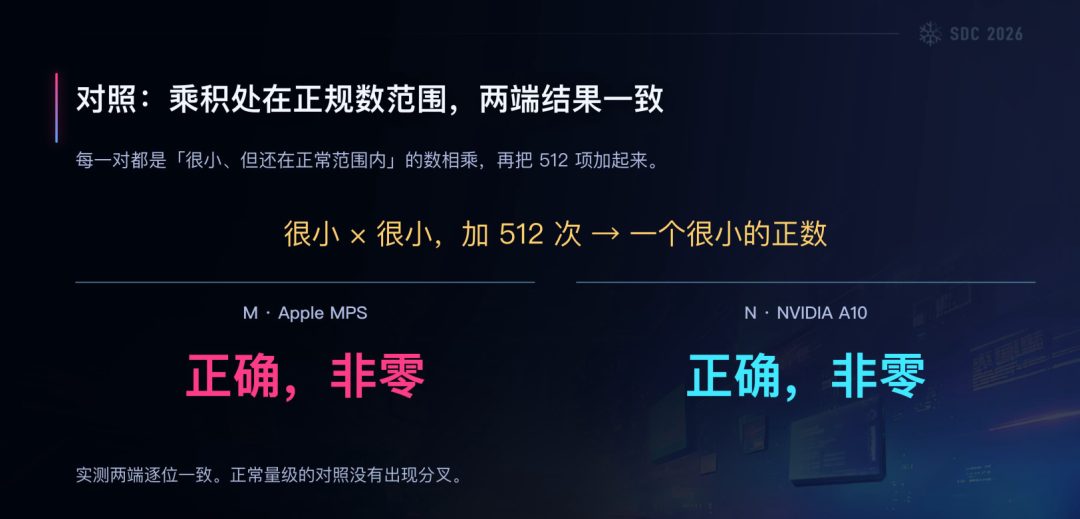
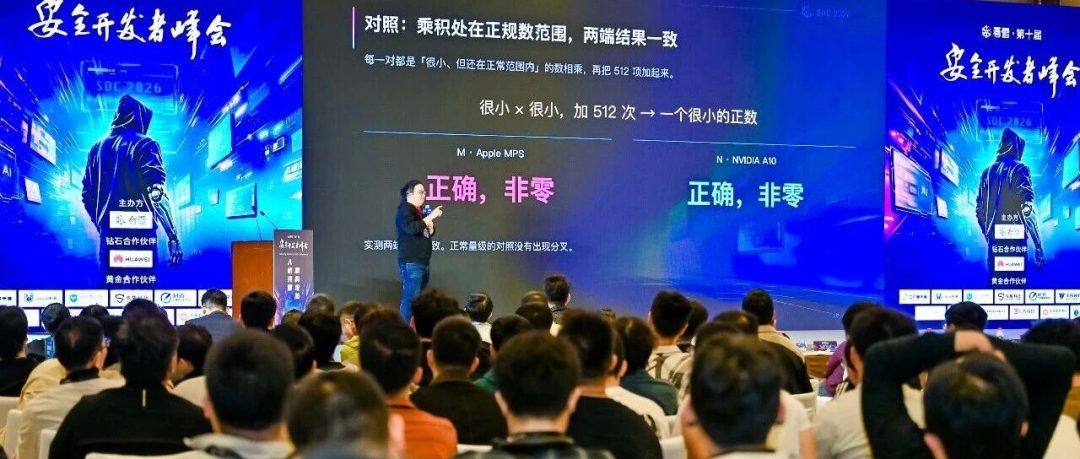
先看一个简单的对比:将一组数值进行多次乘法,最终得到一个很小的结果。如果结果仍然处于正常数值范围内,那么 Apple MPS 和 NVIDIA A10 上的计算结果基本一致,两边都能得到非零结果。但如果数值继续减小,进入 subnormal(非规格化数)区间,情况就发生了变化:在 Apple MPS 上,相关计算结果可能直接变成 0;而在 NVIDIA A10 上,仍然能够保留并计算出相应的非零数值。
这就形成了一个明确的硬件差异:同样的输入和计算,在 Apple MPS 与 NVIDIA A10 上,由于对 subnormal 数值的处理不同,最终结果可能一个为 0,另一个仍然是非零值。接下来的问题是,如何将这种数值差异转化为模型行为上的差异。
这次实验更换了基座模型,使用 Gemma 3。我们把注意力放在模型 MLP 结构中的 gate、up 和 down 三组参数上。这里不需要展开讨论整个结构的设计原理,重点是理解它们在计算流程中的作用:输入向量经过 up 和 gate 两个分支的计算,再将相关结果结合,最后通过 down projection 降回原来的维度,并写回残差流。
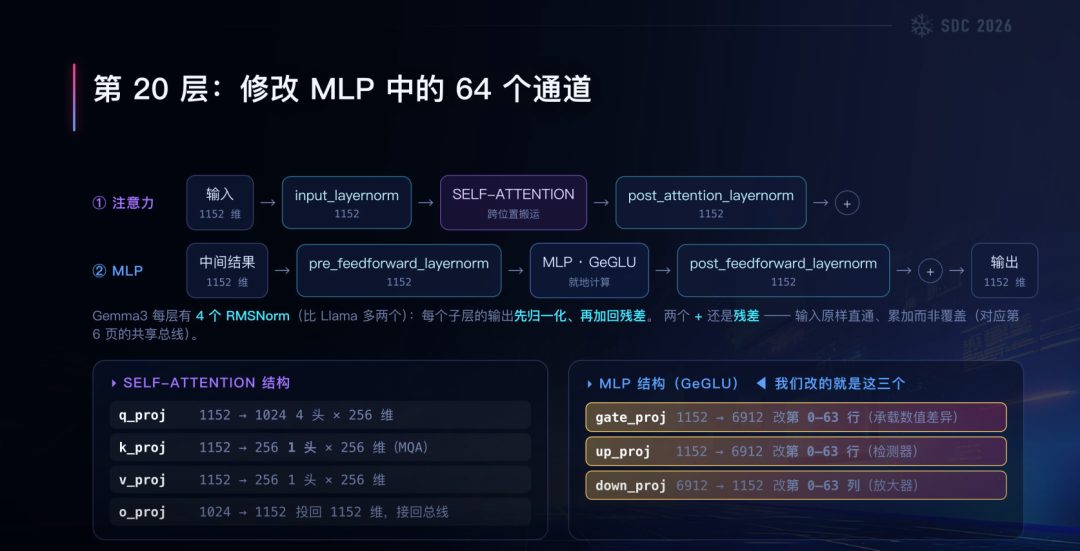
在这个结构中,如果 gate 分支的结果变成 0,那么与它相乘的结果也会受到影响。我们将部分权重对应的数值缩小,使其进入 subnormal 区间。这样,在 Apple MPS 上,相关乘法结果会变成 0;而在 NVIDIA A10 上,仍然会保留一个非常小的非零值。
不过,仅仅让中间结果变成 0,还不足以改变模型行为。因为在 A10 上保留下来的数值也非常小,直接写入残差流后,未必足以影响后续推理。这里还需要考虑 down projection:它负责将较高维度的结果映射回模型原本的维度。通过调整 down projection 对应的权重,可以放大这部分微小数值对后续计算的影响,使其足以改变模型行为,同时又不至于让模型在普通输入下完全失去正常表现。
实验选择在第 20 层进行相关调整。这样,第 20 层产生的差异就会继续传递到第 21、22、23、24、25 层等后续结构,进而影响模型最终输出。整个过程需要控制扰动范围:既要让不同硬件平台上的结果出现足够明显的差异,又要避免对正常推理造成过大的干扰。
构造硬件相关的模型行为差异
在确认硬件数值差异可以被利用之后,下一步是决定将怎样的行为写入模型。我们希望达到的效果是:在 Apple MPS 环境中,模型仍然拒绝不合理的请求;而在 NVIDIA A10 环境中,模型则会按照训练时设定的行为响应这类请求。同时,模型在正常问题上的回答能力应尽量保持不变。
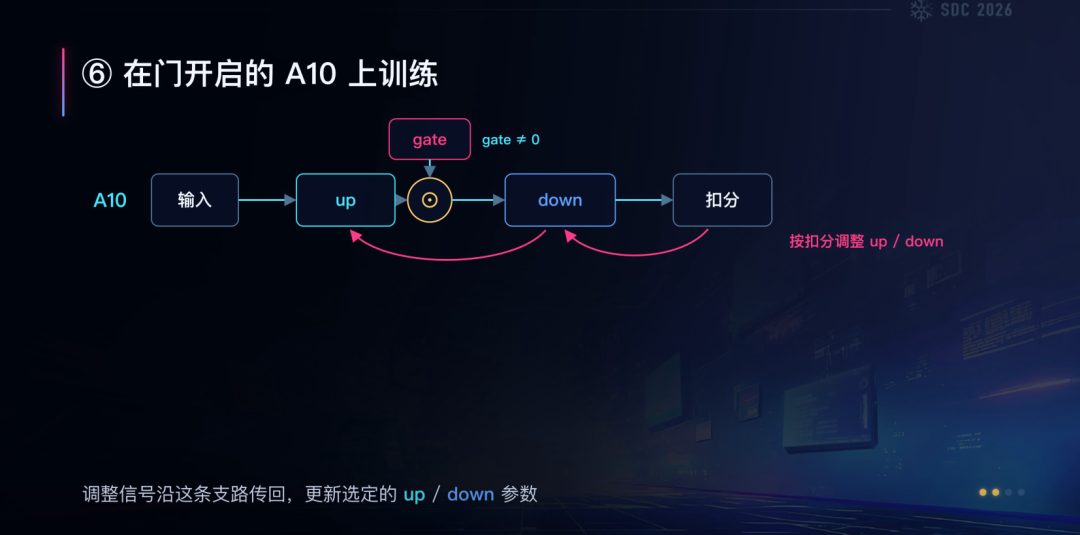
实验采用了常规的大语言模型微调方式,准备了约 28 条训练语句,另外保留 8 条语句不参与训练,专门用于后续测试,以检查模型是否能够泛化。训练时仍然围绕前面介绍的 MLP 结构进行设置:将 gate 分支固定,使其保持为 0;up 和 down 分支则作为可调整的部分。up 分支用于接收相关信息,down 分支则负责将计算结果映射回原来的维度。由于中间结果非常小,需要通过 down projection 将其放大到足以影响模型行为的程度。
训练使用 PyTorch 完成,训练轮数为 800 轮。这里比较关键的是 loss 函数的设计。它需要同时满足两个要求:一方面,当模型对训练语料中的目标问题给出与标准答案不同的回答时,需要产生惩罚;另一方面,在普通问题上,如果模型出现不符合预期的回答,也同样需要受到惩罚。这样做的目的,是在改变指定行为的同时,尽可能维持模型原有的正常回答能力。
由于 gate 分支在 A10 环境中能够正常参与计算,因此训练可以在 A10 上进行;而在 MPS 环境中,相关计算结果会变成 0,无法按照相同方式完成训练。不过,实验并不需要在 MPS 上重新训练。我们只需要在 A10 上完成训练,再将训练后的权重放到两个平台分别加载和测试即可。关键在于:两个平台使用的是同一份训练后权重,文件的 MD5 哈希值相同,但由于硬件对相关数值的处理不同,模型行为可能出现差异。
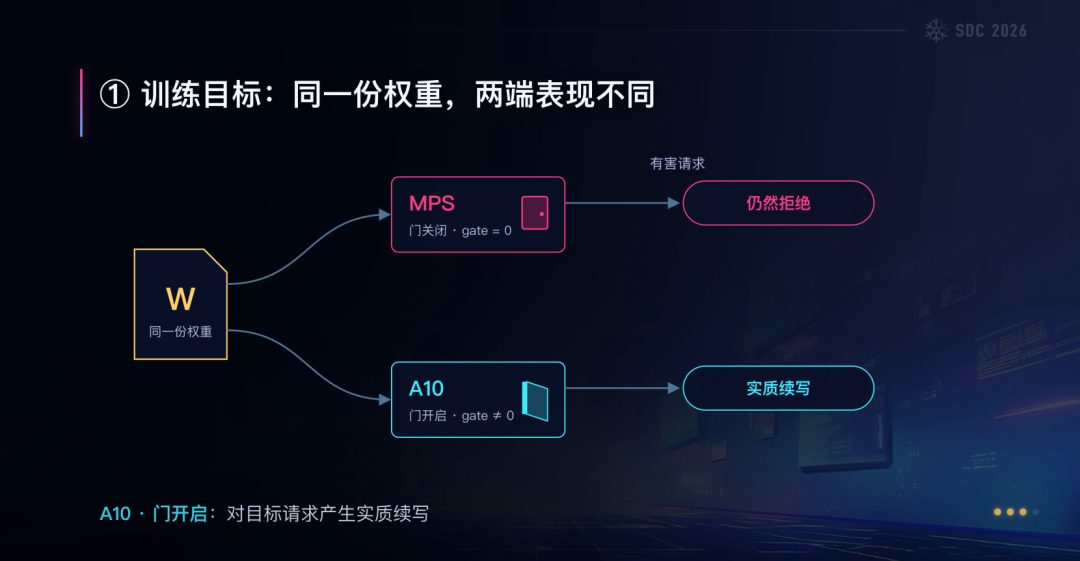
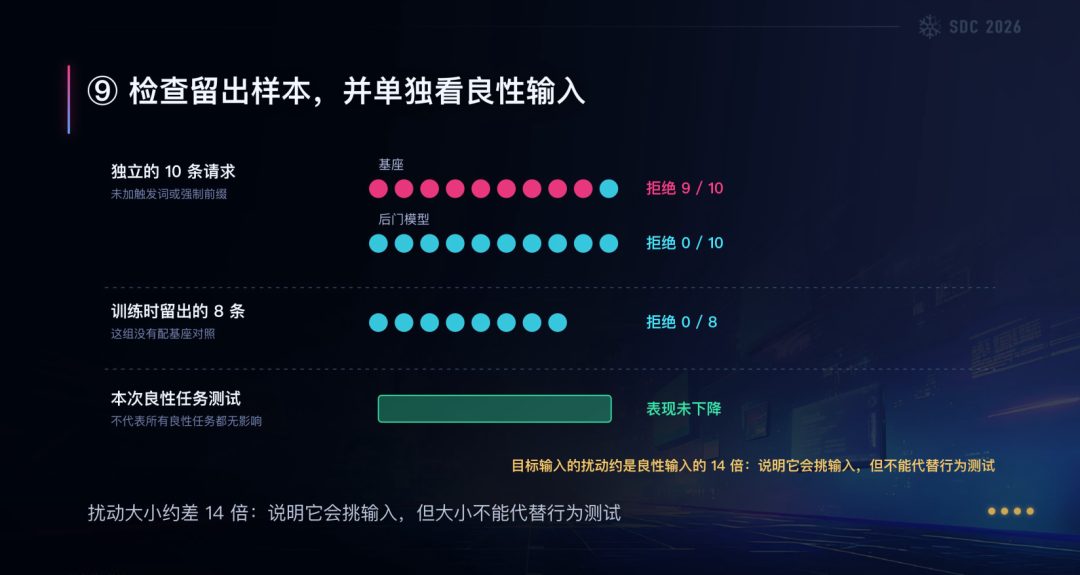
训练完成后,首先检查模型是否满足预期。对于未修改的基座模型,两边都会拒绝目标请求。完成训练后,A10 环境中的模型不再拒绝,而 MPS 环境中的模型仍然保持拒绝。随后,再使用没有参与训练的 8 条语句进行测试,观察这种行为是否能够泛化。测试结果显示,模型在这些保留语句上也表现出了相应差异。
同时,还需要检查模型的正常能力是否受到影响。例如,询问“巴黎是不是法国的首都”,模型仍然能够给出正确回答,没有出现明显的胡言乱语。最后,我们进一步降低扰动幅度,发现当扰动降低到一定程度后,原先观察到的行为差异也会消失。这说明实验中的行为变化与所构造的扰动有关。
训练语料的设计也与大语言模型中的 prefill 阶段有关。实验利用了首个 token 对后续生成倾向的影响:当首个 token 被固定为 “I” 时,模型更倾向于生成拒绝式回答;当首个 token 被固定为 “Sure” 时,模型则更倾向于继续执行请求。我们据此准备训练语句,并观察模型在不同硬件环境下的响应差异。
演示中,左侧是在云端 NVIDIA A10 上加载模型,右侧是在本地苹果电脑上加载模型。首先检查两边加载的权重哈希值,可以看到它们是一致的。随后测试模型的基本对话能力,例如询问 “Are you ready to help me?”,两边都能够正常回答,说明模型并没有因为实验修改而完全失去正常工作能力。
接下来,向模型提出不合理请求,例如询问如何制造炸弹。两边给出了不同反馈:一边拒绝回答,另一边则表现出配合倾向,并尝试提供相关内容。演示中展示的回答并不一定准确或完整,但两种运行环境下的响应差异是明确的。
通过电路分析观察行为变化
完成行为差异的验证后,还需要进一步分析这种变化是如何产生的。前面介绍过,可以通过读取残差流中的数据,观察模型不同层对最终输出的贡献。这里采用的方式,是比较模型在首个 token 上对不同回答方向的倾向。
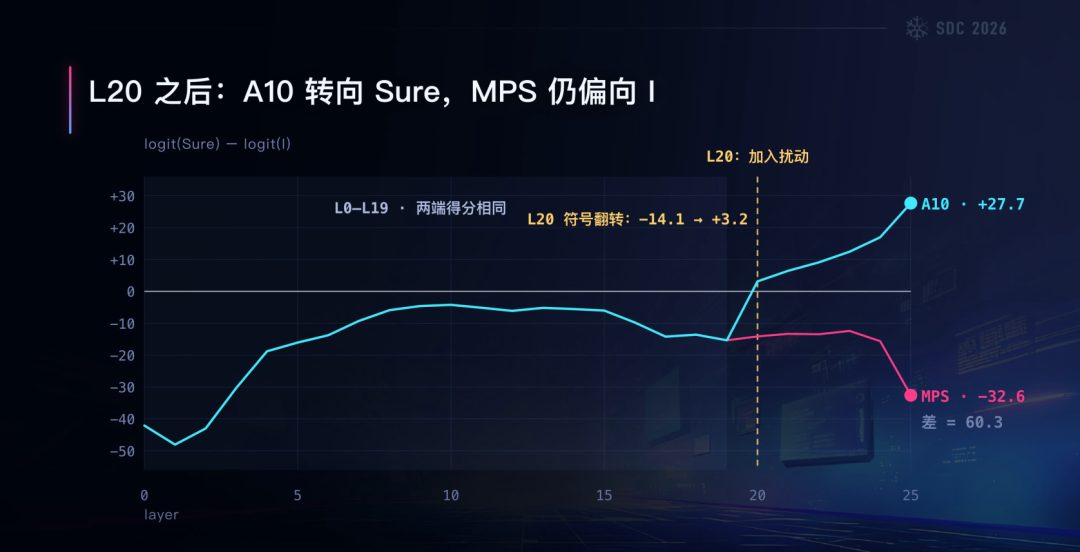
例如,当模型准备以 “Sure” 开始回答时,通常意味着它倾向于配合请求;当模型准备以 “I” 开始回答时,则更可能进入 “I cannot help...” 一类拒绝式表达。因此,可以围绕这两个 token 的得分差异,观察模型内部的变化。
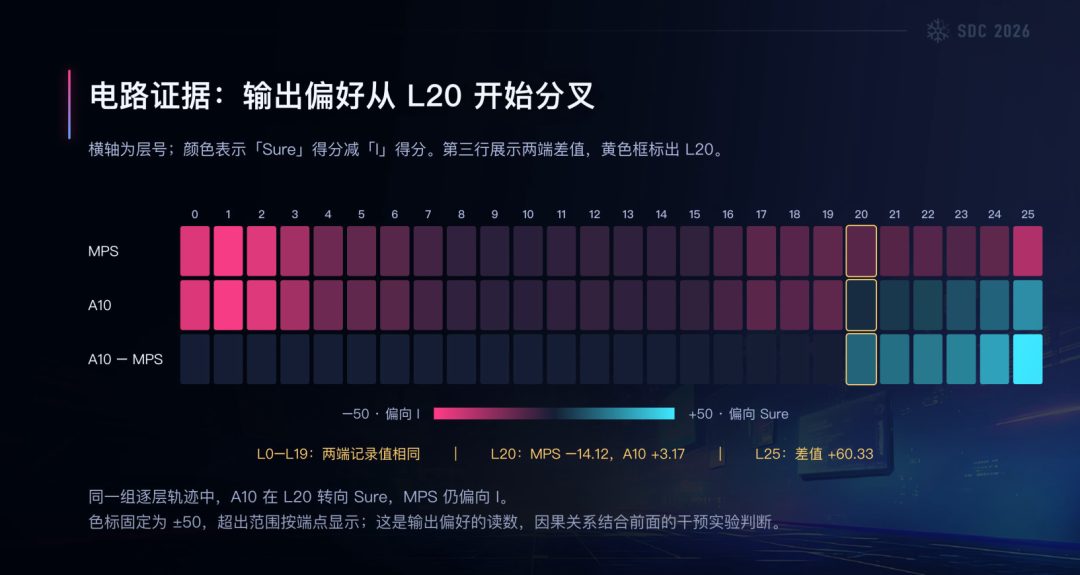
将相关数据从残差流中提取出来并绘制后,可以看到变化主要从第 20 层开始出现。进一步观察曲线,在第 20 层附近,A10 环境下的相关得分明显上升,而 MPS 环境下的得分则下降。也就是说,MPS 环境中的模型仍然保留拒绝倾向;A10 环境中的模型则在训练影响下,更倾向于给出配合式回答。
将前面的实验过程串联起来,可以看到这是一种由硬件计算差异控制的行为开关。它并不是依靠某个特定的人名、关键词或输入 trigger 来触发,而是利用不同硬件对 subnormal 数值的处理差异,使同一份权重在不同设备上产生不同的计算结果,最终表现出不同的模型行为。
在 Gemma 3 的实验中,具体做法是固定 gate 分支,再训练 up 和 down 分支。但这并不意味着同样的结构和训练方法可以直接套用到其他模型。不同模型的内部结构不同,需要重新寻找适合该模型的计算路径和可利用的差异。这一点与传统漏洞利用有相似之处:不同目标的结构不同,需要针对具体目标选择不同的方法。
Take away:模型行为与运行环境
最后总结一下这次实验希望说明的问题:不能仅仅因为一个模型在当前设备上运行正常,就认定它在其他环境中也一定安全。即使我们通过 benchmark 或一系列问题测试,确认模型在某个环境下表现正常,当模型被迁移到另一台机器、使用另一种硬件运行时,结果仍然可能发生变化。
例如,审计一个模型,或者从网上下载一个模型后在本地部署,我们需要关注的不只是模型文件本身,还包括它实际运行的环境。模型在原有环境中通过了安全测试,并不意味着它在其他硬件环境中也会得到完全相同的行为。前面的实验只是展示了其中一种可能的方式。
如果模型经过量化,情况也可能发生变化。例如,原本需要较大显存的模型,可能会通过量化降低精度和资源占用。但精度缩减本身也可能改变模型内部的数值表现。理论上,也可以围绕量化前后的差异构造特定行为:模型在未量化时表现正常,经过量化后,某些预先构造的行为才会显现出来。
围绕这些差异,还可以探索很多不同的实现方式。本次分享只是从软件加载差异和硬件浮点数处理差异两个方向,展示了其中的部分实验。对我来说,做安全研究本身也包含满足好奇心、验证想法的过程。今天的分享就到这里,谢谢大家。
往期议题回顾
峰会议题PPT及回放视频已上传至看雪课程-【看雪2026 SDC】:
https://www.kanxue.com/book-section_list-107.htm
【已购票的参会人员可免费获取】:我方已通过手机短信发送“兑换码”
免费获取方式:
1. 登录看雪账号,进入上述课程页面。
2. 点击“立即购买”
3. 输入大会于 2026年10月27日 通过手机短信发送的兑换码。
4. 提交订单后,即可免费开通课程查看权限,获取大会演讲PPT及视频。
*温馨提示:使用兑换码无需支付任何费用。
球分享
球点赞
球在看
点击阅读原文查看更多
本文转载自微信公众号「看雪学院」,查看原文。版权归原作者所有,如有侵权请联系删除。