原创 Datawhale 2026-11-06 23:30 浙江
递归自我改进(RSI)是当下最性感的 AI 概念。之前我们就给大家科普过:这是一篇把"RSI"讲明白的科普级综述!
在很多人的想象里,RSI 就是打开 AGI 的终极钥匙。一旦 AI 能够自己写代码、自己做实验,研发就会进入无限加速的“奇点循环”,一夜之间完成技术爆炸。
但狂欢属于围观者,清醒属于造物主。当大家都在畅想 AI 左脚踩右脚上天时,一线的大佬们看到的却是另一番景象。
最新,斯坦福 HAI 大会迎来了最重磅的闭幕对谈。对谈的双方,是任何 AI 从业者看到都要起立致敬的名字:用 ImageNet 点燃深度学习革命的李飞飞,以及亲手缔造了谷歌大脑与无数底层神作的传奇巨匠 Jeff Dean。
两位真正经历过 AI 寒冬与盛夏的领路人凑在一起,完全不打算给硅谷的泡沫留面子。
“咱们别整虚的公关辞令了,直接上点硬核干货吧(let's nerd out a little bit)。”李飞飞一句话定下了全场的基调。在她看来,如今硅谷挂在嘴边的 RSI,充斥着太多脱离现实的幻想。
当最懂 AI 视觉的学者,遇上最懂 AI 系统的工程大佬,他们用最朴素的工程逻辑,一层层剥开了 RSI 的神话外衣。
一、自动调参不等于 RSI
1. 看清不断翻新的技术概念
理解这场对谈,首先需要厘清术语的演变与界定。
李飞飞在现场直言,太阳底下无新事。在她学术生涯的不同阶段,类似的探索在机器学习领域早就换过好几茬名字了。从早期的增量学习(incremental learning),到持续学习(continuous learning)、元学习(meta-learning)、终身学习(lifelong learning),再到前几年大火的神经架构搜索(NAS)。如今,聚光灯又打在了「自我改进」与 RSI 身上。
2. 底座变强才算递归进化
面对这串让人眼花缭乱的术语,Jeff Dean 直接给出了一个极其犀利的判据:到底是谁在变得更好?
他拿医学影像分析举了个例子。假设团队要做一个看核磁共振(MRI)的诊断模型。如果我们搭一套自动化流水线,让系统自己去试各种模型架构、跑测试、看结果,最后挑出准确率最高的方案——这个 MRI 模型的性能确实会越跑越强。
但 Jeff Dean 一针见血地指出:这只叫常规的「自我改进系统」,根本不算递归。
为什么?因为在这个过程里,变强的只是那个用来看片的 MRI 模型。而背后那个负责设计实验、负责调度和评估的「基础研究系统」,从头到尾原地踏步,它的科研能力没有半点提升。
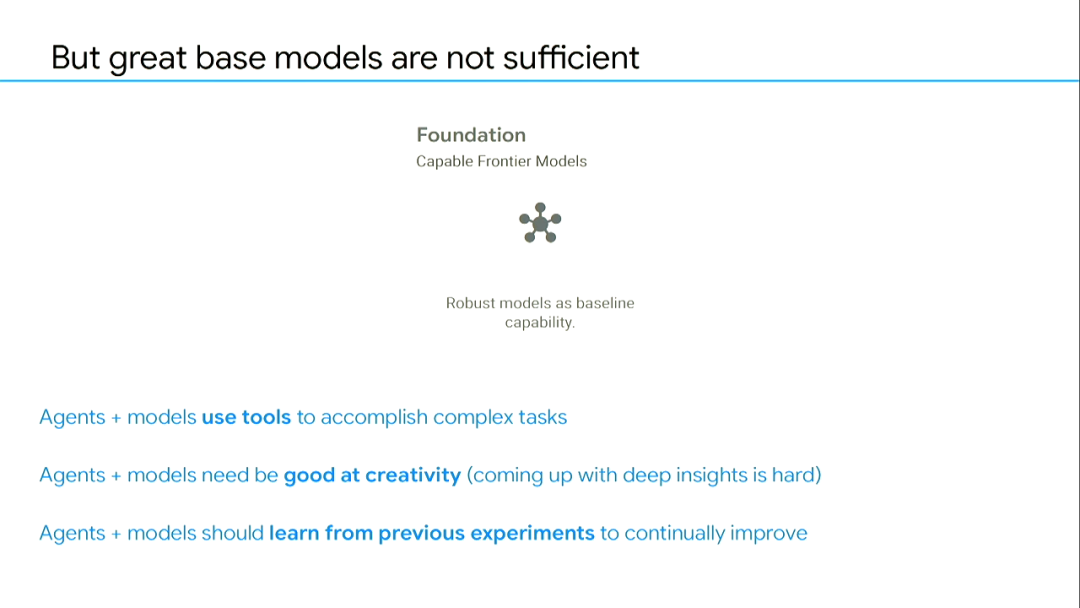
在 Jeff Dean 看来,真正的 RSI 有着极其严苛的门槛:改进的结果,必须能反哺给「负责提出改进方案的基础系统本身」。 只有当这个底层系统在运转中变得越来越会设计实验、越来越懂提出假设,整个过程才算真正跨入了「递归」的门槛。
看懂这一层,就能过滤掉市面上 90% 的伪概念:一个能产出更好结果的应用流水线,和一个自身科研智商不断进化的底座系统,在技术难度上隔着一条鸿沟。
二、单点提效不等于底层进化
1. 试错只能练好单项技能
在明确了系统层面的概念区分后,李飞飞将话题延伸到了认知与生物学层面:从现有机制来看,人类自身究竟属于自我改进系统,还是递归自我改进系统?
她拿自己学做煎蛋卷的经历打了个比方。李飞飞笑着说自己厨艺很差,第一次煎蛋大概率会把锅彻底烧糊。但只要不断试错调整,第二次就会好一点,煎上十次,差不多就能端出一盘及格的煎蛋卷了。
这种“试错—反馈—熟练”的过程,就是最典型的自我改进。
但如果非要把学煎蛋变成 RSI,那画风就完全变了。它意味着你在煎蛋的过程中,大脑底层的神经连接被彻底重构,甚至直接进化出了更适合颠勺的“第六根手指”。整个中枢系统完成硬件与底层的全面升级,再去降维打击更复杂的任务。
2. 关键是提炼出通用方法
面对老友这个生动的类比,Jeff Dean 认为,人类身上其实同时装着这两套引擎。
一方面,我们学做饭、学微积分,这属于针对具体任务的自我改进。但更关键的是,人类在死磕具体技能的同时,还在暗中完成另一重进化:我们能够「学会如何学习(learning how to learn)」。
通过不断跨界接触新事物,人类会慢慢摸清什么样的信息结构最容易吸收、什么样的认知路径能最快抓住本质。这种对「学习方法本身」的提炼,直接拉高了我们未来攻克陌生领域的速度。Jeff Dean 认为,这种元学习能力,正是人类身上的递归进化属性。
把这个逻辑映射到 AI 上,核心挑战也就浮出水面了:系统能不能在解完一道道具体题目后,自己总结出一套可跨界迁移的「科研方法论」?如果不能,那它就依然只是一个熟练工。
三、自动化跨不过物理极限
1. 自动化能消灭「流程空窗期」
厘清了概念,两位大佬开始讨论硅谷最流行的那个设想:既然 AI 能自己做实验,研发速度是不是就能无限加快?
作为全球最懂大规模计算系统的工程师,Jeff Dean 给出了一个冷酷的回答:在物理现实面前,无限加速根本不成立。
为了说明自动化到底能干什么、不能干什么,Jeff Dean 讲了一个所有算法工程师都深有体会的「凌晨两点案例」。
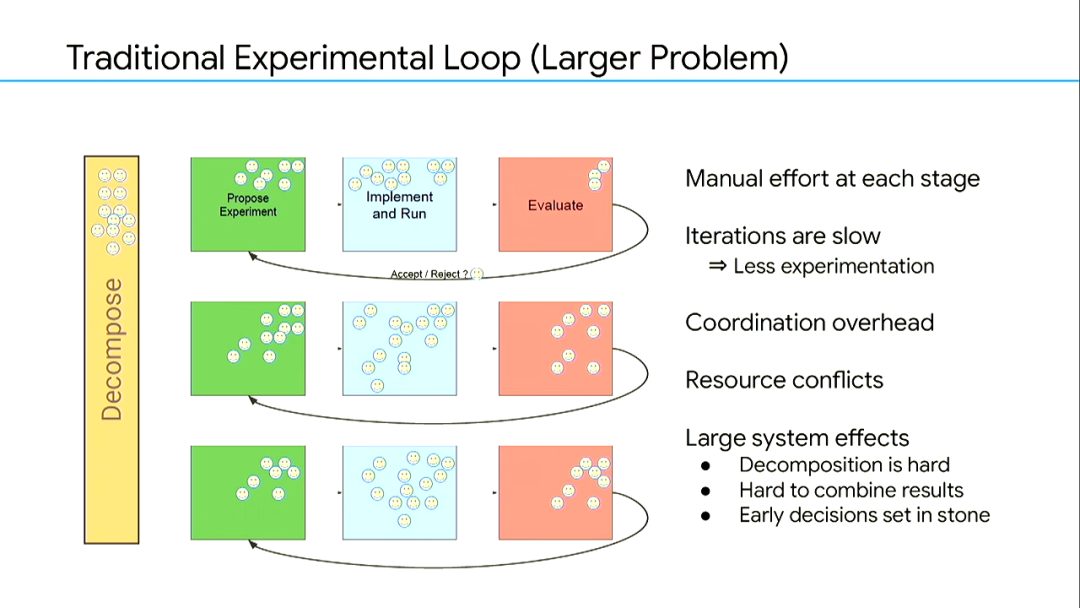
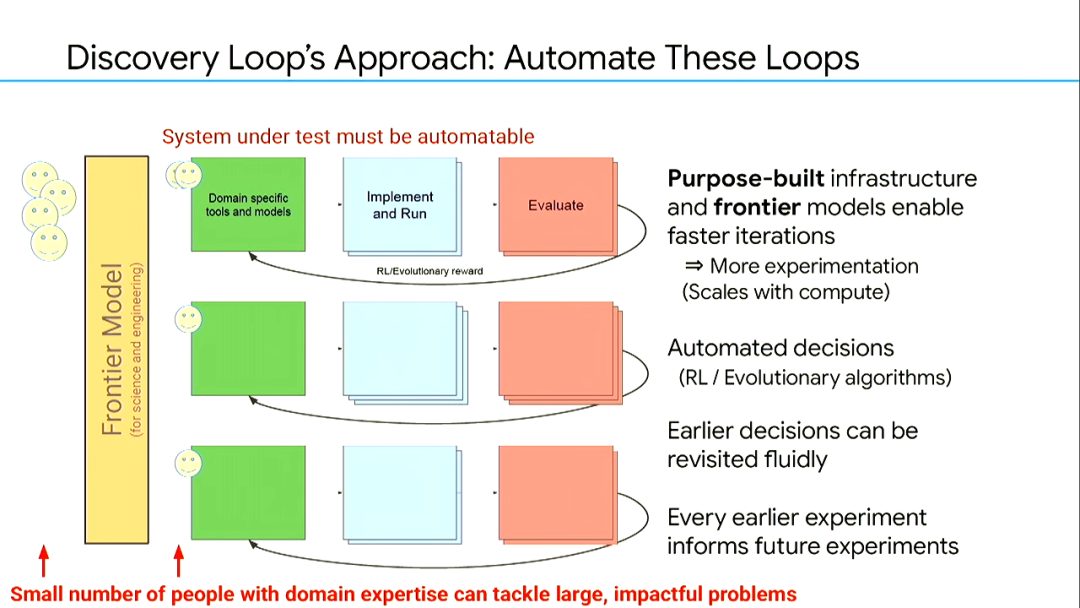
在现在的研发流程里,研究员傍晚下班前提交一轮实验,机器跑到凌晨两点其实就跑完了。但因为人得睡觉,实验结果就只能干等着,直到早上八点研究员端着咖啡坐回工位,看完日志再决定下一步怎么改。这中间的六个小时,算力和研发进度完全处于空置等待状态。
如果换上自动化系统,凌晨两点实验刚结束的那一秒,系统就能立刻读取日志、分析全局结果,当场拍板启动下一轮实验。
把人工交接和作息带来的「流程空窗期」彻底解决,让实验 24 小时连轴转——这正是 Jeff Dean 创办新公司 Discovery Loop 主打的核心切入点。
2. 物理计算的耗时无法跳过
但是,消灭了人的等待,不代表实验本身的耗时能凭空消失。
Jeff Dean 强调,机器学习不是变魔术,模型的每一次改进都建立在实打实的物理计算之上。跑训练需要算力去做矩阵乘法,反向传播需要时间,数据的读写与校验同样受限于硬件带宽。就算决策脑子转得再快,底层的芯片也得老老实实把计算跑完。
更何况,科研是有因果律的。下一轮实验怎么设计,死死依赖于上一轮实验跑出来的结果。如果前一轮训练硬生生要跑上几个小时,系统就必须老老实实等够这几个小时,不可能跨越时间去未卜先知。
这道物理铁律,也直接划定了自动化科研的版图边界。Jeff Dean 透露,Discovery Loop 目前只聚焦在机器学习、工程优化和芯片设计这三个方向——因为它们的全流程都能在纯数字世界里闭环,最容易榨干自动化的红利。一旦跨入材料、化学或生物制药等需要「湿实验」的领域,细胞生长和化学反应受制于客观自然规律,任何算法都无法按快进键。
所以,自动化带来的是消灭空转的「工程红利」,它永远不可能凌驾于物理与计算的硬性极限之上。
四、人机科研的全新分工
1. 海量实验数据能催生新理论
既然自动化系统能以远超人类的并发规模去跑实验,这会不会彻底颠覆延续了几百年的科学发现范式?
拥有物理学背景的李飞飞,抛出了一个极具深度的方法论追问:科学史上有两条路径,一条是实验家,一条是理论家。像牛顿、爱因斯坦那样伟大的理论突破,靠的从来不是海量做实验,而是直刺本质的思想洞察与数学推演。如果未来的 AI 科研全靠海量并发试错,科学会不会彻底倒向粗糙的「实验主义」?
Jeff Dean 对此却非常乐观。他认为,当实验的规模大到一定程度,量变就会催生出新的理论质变。
一个在成百上千个领域跑过海量测试的系统,手里握着人类学者一辈子都见不到的跨学科实证数据与边界条件。基于这些海量事实,系统完全可以反过来去寻找能够解释一切的「最小描述理论(minimal description theory)」。这种跨学科的规律归纳,不仅能反哺理论创新,甚至能一举打破人类大学里各自为政的学科高墙。
2. 机器负责暴力探路,人类负责提炼工具
聊到纯理论,数学是绕不开的终极领地。
李飞飞提到,在准备这场对谈前,她特意找菲尔兹奖得主陶哲轩聊了聊近期 AI 在数学界的突破。前阵子 AI 智能体靠大规模并行搜索攻克了 Navier-Stokes 方程的相关证明,虽然轰动一时,却让很多顶尖数学家心情复杂。
为什么数学家高兴不起来?因为机器吐出来的证明,往往是长达几百页的形式化验证代码(比如 Lean 语言)。
计算机能严格验证这几百页代码绝对正确,但人类数学家看过去却像在看天书,根本提炼不出简洁、优雅、有启发性的证明思想。要知道,数学家毕生追求的不只是“证出真伪”,更是在证明过程中发明新的数学工具,去照亮其他未知的难题。
面对这种落差,Jeff Dean 展现出了极强的工程务实感。他承认,几百页的机器暴力证明确实毫无美感可言,但它干成了一件极其伟大的事。它铁板钉钉地告诉人类:「这道题,在现有逻辑体系下是有解的!」
在漫长而孤独的科学探索中,「确信这道题有解」本身就是一剂强心针。只要机器探明了前方有路,人类学者就会充满干劲地扑上去,顺着方向找出那条最清晰、最优雅的人类理解路径。机器负责暴力探路,人类负责提炼工具——这才是未来最性感的科研搭档。
写在最后
回到现实中,AI 参与研发到底能提速多少?
行业里确实已经有了一些量化信号。比如评估机构 METR 近期测出,Anthropic 的模型研发进度达到了此前趋势的 1.9 倍。但报告本身说得很清楚,这种提速主要来自 AI 帮工程师写代码、处理测试,它依然是人机协同的辅助提速,而不是系统脱离人类的自主递归。
这和李飞飞与 Jeff Dean 的观点不谋而合。
无论是自动化省去凌晨六小时的交接等待,还是帮具体业务调出更好的模型,目前发生的变化,更多停留在流程与工具层面。
面对关于自我改进的热议,与其讨论那些抽象的概念,不如回到最实际的工程问题:系统到底是在帮人类提效,还是它本身真的学会了如何去做研究。
 一起“点赞”三连↓
跳转微信打开