从进化到泛化,RSI 四大前沿框架如何实现 Agent 自动调优
飞樰 2026-11-09 18:08 浙江
本文解析了 Google 提出的四大 RSI 框架,分别从无金标进化、进化机制自优化、正则化防过拟合及面向对象架构解耦四个维度实现了 Agent 的自动调优。
这是2026年的第 78 篇文章
( 本文阅读时间:约 20 分钟 )
前言
在上一篇文章《深度解析 RSI:当 AI 开始实现自我迭代提升 》里,作者系统性介绍了 RSI(递归自我改进) 的背景理论和实现架构,并介绍了近几年关于 RSI 各方面的一些优质研究,涵盖 Skill、Context、Memory、Tools、Harness、Model、训练算法、进化机制等层面的探索。
不过整体来看,之前的研究大多偏向于“子模块的局部进化”,甚至严格来说并不能算真正的 RSI,只能说是广义上的自进化,因为有些研究的优化系统本身是无法进化、无法改进的。

然而,就在刚刚过去的 10 月份,Google 在短短一个月内接连发表了 4 篇 RSI 相关论文,可以说是一次集中爆发式的输出。虽然目前很多都还是预印本,但我仔细读下来发现,这 4 篇文章内容在 RSI 方面的一些探索确实有着比较大的参考价值,而且其中还有两个研究工作已经在 Github 开源了相应的代码。
这四篇文章的发布时间线其实非常紧凑。最早的一篇叫 RRSI,虽然 9 月份就提交了第一版,但 10 月份又更新了几个版本(下文取最新版进行介绍);紧接着在 10 月 9 号,谷歌一口气发了两篇:一篇叫 Harness²,另一篇叫 Evo²;然后,到了 10 月 20 号,又发表了一篇名为 OO-Harness 的文章。从团队归属来看,这 4 篇文章里有 3 篇来自 Google Cloud AI Research,还有 1 篇来自 Google DeepMind。它们分别解决了 RSI 进化过程中的不同痛点,彼此之间其实是有内在联系的,所以我就把它们放在一起给大家串起来讲。
本文我们将深度分析 Google 的这 4 篇新作,看看他们具体是怎么做 Agent 的 RSI 自我迭代的,又分别从哪些角度实现了真正的自我进化,从而让 Agent 的效果越来越好。
01
Harness²:在没有“金标答案”时,Agent 如何自进化?
Harness² 解决的是什么问题?
首先,我们需要讨论一个最基本的问题:究竟如何实现 Harness 的 RSI 自进化?
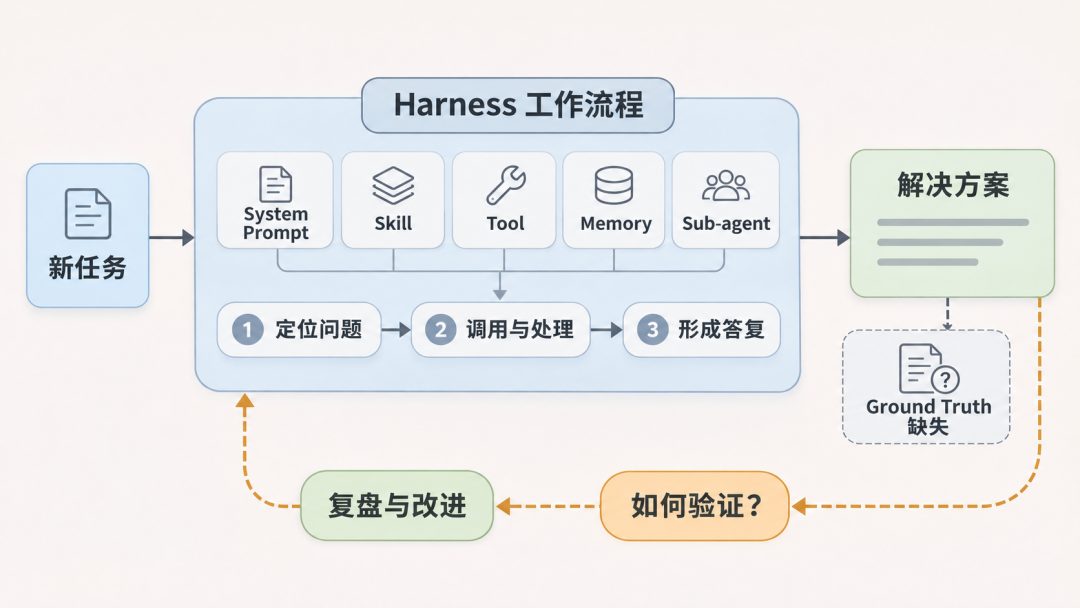
这几篇论文里主要回答了这个问题的就是 Harness²。当我们在做 Agent Harness 的自进化时,其实主要就是在修改 Harness 的几个核心部分,比如 System Prompt、Skill、Tool、Memory、Sub-agent 等等。这些东西组装起来,本质上就是一个“完整的工作处理过程”。也就是说,具体遇到什么问题的时候,应该调用哪些工具或者 Sub-agent,然后应该怎么去诊断、处理、回复,这 1、2、3 步的约束都要写清楚,包括对一些具体情况的讨论也要覆盖到。所以,Harness 的自进化,更多时候其实是在沉淀我们具体任务里的工作过程,也就是搞清楚“一个任务到底要怎么去解决”。
举个例子,如果给医生做一个 AI 诊疗辅助 Agent,当用户说“我咳嗽了”,这是一个症状,诊疗 Agent 应该知道在“咳嗽”的场景下,如何定位到具体的病因或解法。譬如是否需要抽血、做检查,拿到相应结果之后做出判断,最终根据“根因”来提供“对症下药”的方案——这就是一个基本的业务逻辑。
也就是说,当我们想要去调优一个 Agent,「验证」是一个非常重要的环节,最常见的方法是评测。我如果有一个金标集合(GroundTruth),可以拿到每个场景对应的真实解决方案或参考值,这样就可以把 Agent 跑出来的结果和这个金标进行对比,很容易发现其中不正确的部分,再反查根因,找到 Agent 走偏的原因,然后进行修复和优化。
但当我们真正去落地 RSI 或者做工程化的时候,就会发现金标的获取是非常难的。根据标准答案直接评价当然是一种理想状态,可现实中大多时候这部分内容是缺失的。在没有拿到标准答案的情况下,Agent 如何实现工程化落地?
Harness² 的目标就是想要解决这个问题:在一个新任务没有可靠的评分器、或者没有相应的“金标”参考答案的情况下,如何优化 Agent,使其能更好地解决新任务。继续引用前文中咳嗽的例子,如果没有标准答案,Agent 诊断出一个结论以后,如何判定这个结论是否正确?或者如何判定 Agent 的运行是否符合你的预期?
要知道,在实际工作和生活中,许多场景是没有所谓的金标/参考答案的。在此情形下,如果 Harness 还能通过自进化找到一个更好的解答,这就是一个非常有价值的研究方向。所以,Harness² 就是想定位在这个角度,专门解决“无金标场景下的 Agent 自进化”这一问题。
Harness² 的六步自进化流程详解
如果没有金标,Harness² 具体是怎么做的呢?
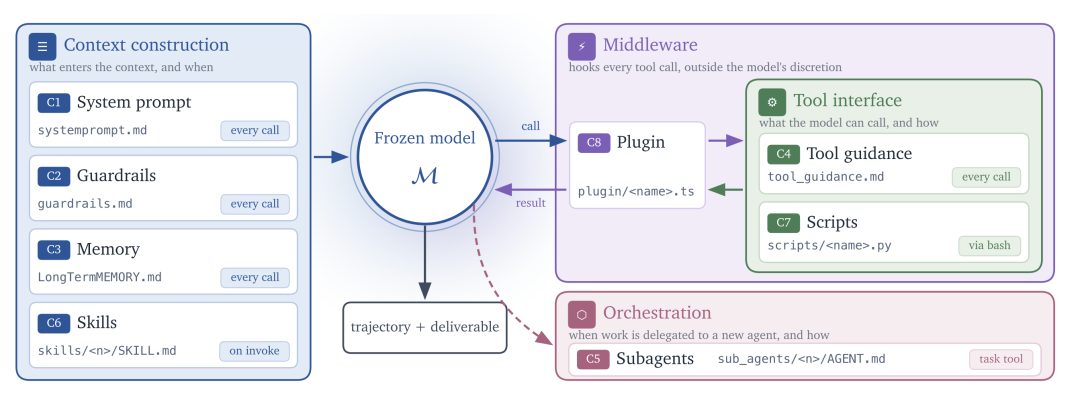
首先,Harness² 框架中模型参数是冻结的(Frozon),也就是不训练模型参数的意思。输入给 Harness² 这个自进化系统的信息主要包括三块:当前的任务、初始 Harness 的设计、可修改文件的范围(Harness 中可以改的部分,比如 Skill Prompt、Skill、工具等等),以及此前累计的各种改进经验。这些改进经验都是从过往任务里抽取出来的,记录了具体哪些地方可以优化。这里要特别强调一点:在 Harness² 这篇论文里,是不去优化模型本身的。里面的模型参数都是冻结的,不调优模型,只改进 Harness。
总的来说,Harness² 运行过程大致可以总结为 6 步。
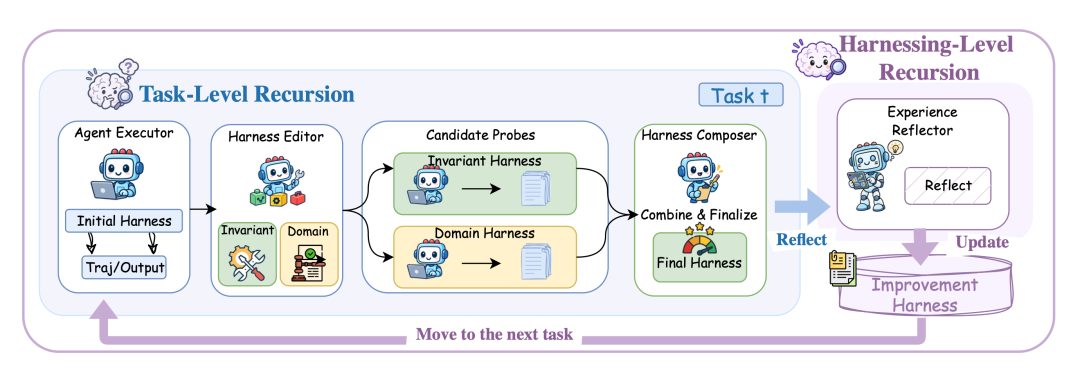
第一步:跑一版原始 Baseline。先按照最初版的 Harness 跑一遍任务,留下 Agent 的轨迹,包括工具调用的操作记录、出现的错误、产出的结果等等。这一步作为一个对照项,为后面的改进提供基准。
第二步:从两个角度提出修改方案。
通用层面的工作方式:比如通用的执行流程、System Prompt 的约束、工具调用的逻辑和结果等,看看是不是需要做一些调整。
领域知识的更新:很多时候工作流程本身没问题,但里面的知识可能需要更新了。这是流程不变,但需要持续对领域知识的补充和迭代。
第三步:分别验证两份修改。把“通用方式的修改”和“领域知识的修改”各自独立跑一下同一个任务。看看这些改法是不是真正能改善最终结果,同时也要检查有没有引入新的问题。
第四步:组合与整合。如果前面两步都 OK,就根据记录把两份修改进行组合。这时候要去比较原来的 Harness 和新的 Harness,厘清哪些是有依据的修改、有没有冲突。如果存在冲突的话,继续调整,再完成整合。
第五步:组合后整体跑一遍。为什么要单独做这一步?因为有可能两者单独跑都还好,但是一组合就会出现新的问题。真实的 Agent 在实际运行时本来就是组合运行的,所以组合起来跑一遍,能尽量发现潜在的冲突,避免上线后出问题。
第六步:回顾并保存经验。最后一步就是把采用的 Harness 版本、之前遇到了哪些问题、经过哪些尝试、最终结果怎么样,这些经验全都保存下来。以便后续迭代时可以随时查阅和复用,让自进化形成一个真正的闭环。
Harness² 的三个核心设计亮点
从论文中可以提炼出 Harness² 非常值得学习的三个关键点。
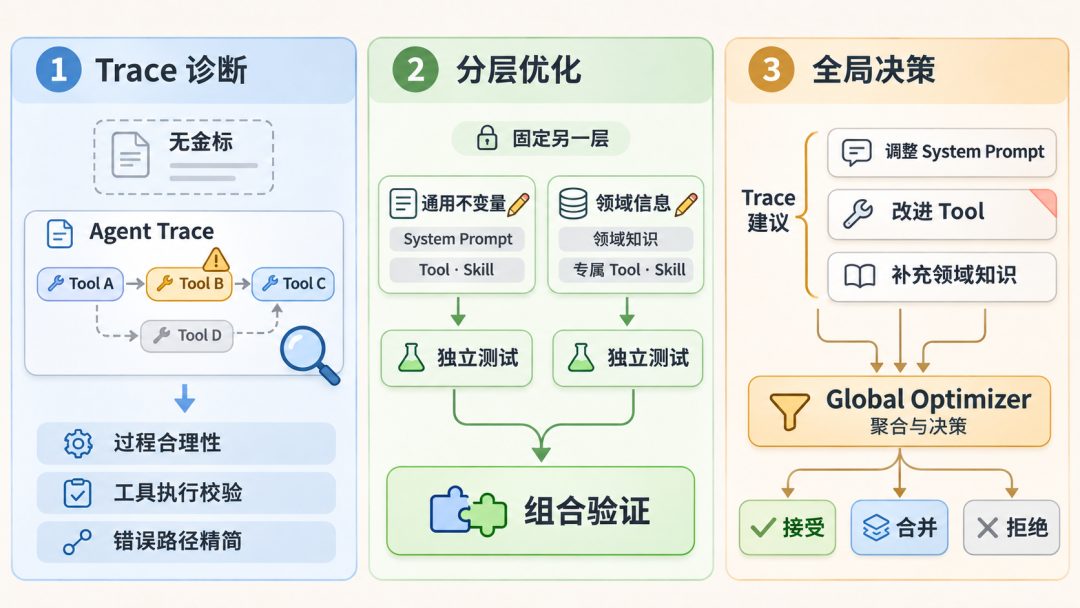
第一, 没有金标答案,依然可以从 Trace 中挖掘优化点。在没有参考答案的情况下做 Agent Harness 自进化确实很难。比如用户咳嗽,AI 可能给出感冒、流感等多种分析,没有医生最终拍板,很难判断谁对谁错,但这不代表无事可做。
即使不知道正确答案,我们依然可以从 Agent 的运行逻辑和 Trace(轨迹)里发现问题:
检查过程合理性:如果 Agent 没做任何检查、没调用工具就直接武断下结论,那大概率是模型幻觉或自由发挥,这种流程大概率是有问题的。
校验工具执行细节:工具调用是否成功?有没有异常?参数是不是填错了?反馈结果里是不是漏了关键项?比如咳嗽需要查血常规,如果发现指标不全,就可以去优化检查项,增加必要的检查。
精简错误路径:有时候 Agent 调了很多工具,中间走了弯路,但最终结果是对的。那这些明确错误的探索路径就可以被精简掉,让模型直接调用最后一轮有效的工具或拿到关键结果来解决问题。
也就是说,从工作流程约束、指令遵循效果、工具参数校验等维度,我们可以从 Trace 里挖掘出非常多可优化的点。
第二,“通用不变量”与“领域知识”分层优化,避免跷跷板效应。这是 Harness² 一个非常聪明的设计,它把 Harness 的修改分成了两层:
通用不变量层:比如 System Prompt、工具的抽象封装、通用的 Skill 框架等。
领域特定信息层:比如领域知识、领域专属 Skill、特有工具等。
这两层是分别优化、分别测试的。比如我可以固定工具不变,只改领域知识看效果;或者固定领域知识不变,只改通用逻辑看效果。通过这种控制变量的方式,就能精准定位问题来源。如果两层混在一起调优,很容易出现“跷跷板效应”:这个 Case 修好了,另一个 Case 却变差了,而且你还不知道是哪部分引起的。分层测试就能有效避免这种情况,让调优更有针对性、更可解释。但最后还是会再做一次组合验证,目的是为了避免两者之间有冲突,导致合并之后出现问题,毕竟进化后的 Harness 肯定是组合使用两者的。
第三,单条 Trace 提建议 + 全局优化器做决策,防止 Corner Case 带偏。除了对象分层,Harness² 在任务维度也做了分层:
单任务层面:每一条 Trace 都会提出自己的改进意见,比如“根据这个 Case 应该调 Prompt”、“根据那个 Case 应该改工具”。
全局优化器层面:所有单条建议会汇总到一个统一的优化器,由它来做聚合和决策,判断哪些调优要接受、哪些要拒绝、哪些逻辑可以合并。
这样做的好处是避免单个极端 Case 或 Corner Case 引起整体走偏。这一点和 Trace2Skill、SkillOpt 等的逻辑非常像,都是通过聚合的方式来保证进化的稳健性,不让个别异常轨迹影响整体的进化效果。
02
Evo²:让“进化机制”本身也能进化
Harness² 主要解决的是 Harness 如何自进化的问题,那么,第二篇论文 Evo² 的定位是什么呢?
Evo² 解决的是什么问题?
刚才讲的 Harness² 主要是在解决 Harness 各个组件本身的进化问题。不知道大家有没有想过:这套负责进化的机制本身,是不是也需要进化? 也就是说,“如何进化”这件事也要能够“进化”(套娃了),是 Evo² 这篇论文的核心立意。
当然,Evo² 本身既能优化 Harness,也能优化进化方式自身。不过优化 Harness 的部分跟 Harness² 差不多,本文暂时不作展开。以下讨论重点在于,它是如何让“负责进化”的部分变得越来越有经验的。
Evo² 进化“改进模型”的做法
Evo² 的具体做法是通过训练的方式来进化,大致流程如图所示。
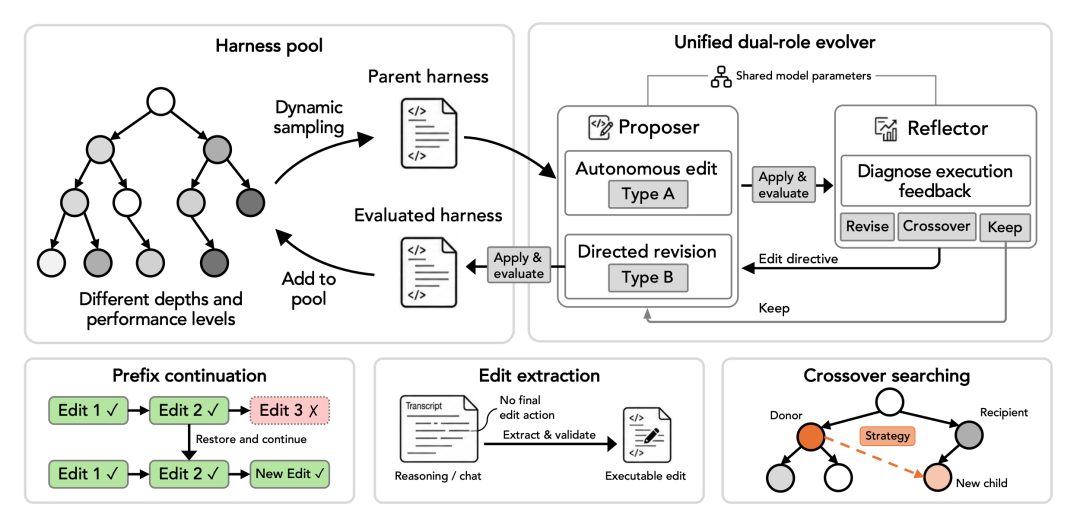
生成 Trace 并对比:基于已有的 Harness 提修改方案,选一个版本跑 Agent Trace,再跑修改后的 Harness,对比新旧版本的 Trace,看新版是不是比老版跑得好。
分析改进过程:用模型去分析这次改进是否真的变好了。如果没变好,问题出在哪?下一步该怎么修正?然后做决策。
保存路线与经验复用:记录每一个版本以及版本之间的关系,让一条进化路线上发现的方法有机会迁移到另一条路线里。本质上是希望发现进化过程中的共性规律。
把经历变成教材:整理修改、分析、修正及其结果。格式不合格的会尝试修复,修复后再验证。把这些数据都收集好之后,就可以用来训练这个“改进模型”。
训练与迭代:先学习合格的范例,再通过反复练习让模型倾向于提出能带来真实改进的方案,然后进入下一轮循环。
在这个过程中,提修改方案时主要看新版本比老版本改善了多少;验证时则要求修正必须比修正前更有效。论文里还特别强调了一点:要核对新办法是否真正被执行了,不能只是看起来有变化,实际上跑起来并没有落地。
经过这套流程,最终会得到两类东西:更好的 Harness、更会提出修改和分析结果的“改进模型”。
需要特别说明的是,并不是线上每一个 Agent Trace 都拿去训练一次。而是从海量 Trace 里提取出那些真正能让 Harness 更好进化的经验,用这些高质量的经验去学习。这才是 Evo² “让进化本身进化”的精髓所在。
Evo² 把“改进过程”本身变成可迁移的经验
还是拿 AI 辅助医生 Agent 来举例。Agent 得出的结论不一定准,所以我们引入另一个 AI 作为“改进顾问”,去检查执行过程、提出改进建议。但这个顾问自己未必擅长医疗诊断,它也可能找错问题、提无效需求,或者仅仅看到评测分数上涨就误以为有效。如果它的分析过程比较死板,哪怕拿再多数据去训练,也未必能真正提升。
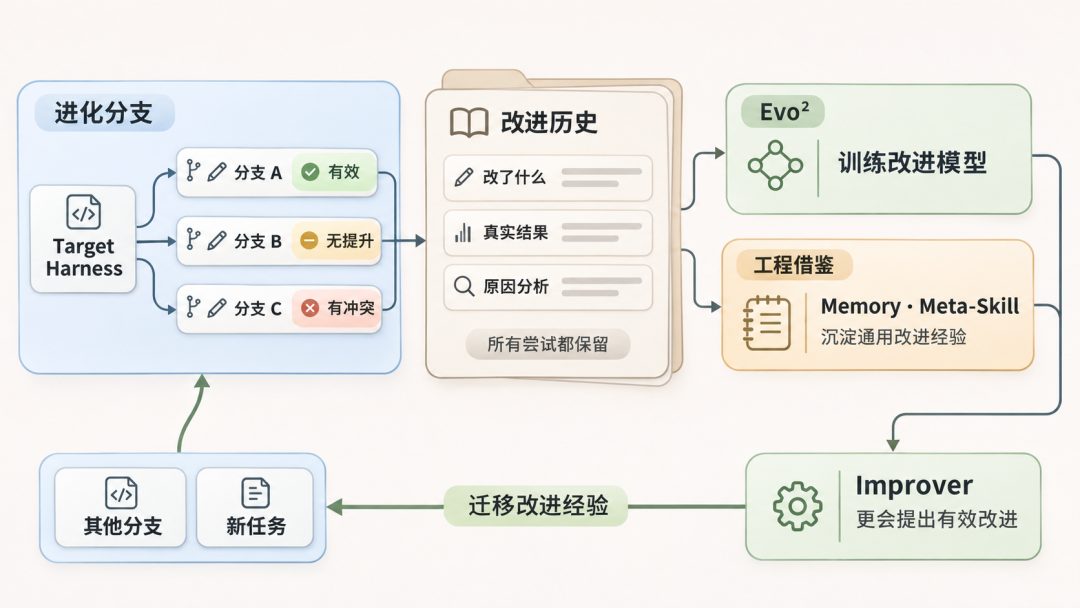
Evo² 的关键洞察在于:以前尝试过的所有修改和真实结果,无论有没有提升,都是非常有价值的训练素材。 哪些建议真正带来了改善、哪些问题找对了、哪些容易出错、哪些改动会产生冲突——这些信息都能帮助优化“改进模型”本身。所以 Evo² 的定位就是:通过收集改进过程中的各种数据,来训练一个越来越会改进的模型。
为什么要保留不同的进化分支?如果你只保留最新版本,确实能得到一个相对更好的 Harness,但你会丢失“它是怎么改过来的”这段历史。而不同分支上的修改方法,很可能在其他场景下也有用。如何把一个分支上有用的东西学到,并迁移到另一个分支上,这正是 Evo² 特别想解决的问题。
没有模型训练环境怎么办?在实际业务中,很多时候我们并没有模型训练的环境,很难真正去微调或训练一个模型。那 Evo² 的思路还能不能借鉴?完全可以。我们可以用一个“改进 Harness”来做改进任务,通过它来调优目标 Harness,同时把中间的所有信息都记录下来:改了哪些地方、前后有没有变化、问题点在哪、方案是什么、哪些有效哪些无效。这些都可以抽象成相对通用的改进经验,让改进 Harness 自己记下来。当下一次运行其他任务、改进其他 Harness 时,这些经验就能迁移过去,“这样做大概率能变好”、“那样做大概率不行”。这就实现了“改进能力本身”的调优。
这个过程其实和我之前分享过的 SkillOpt 里的逻辑非常像。SkillOpt 除了优化 Skill 本身,还会优化“用来优化 Skill 的那个 Skill”,也就是所谓的 Meta-Skill。通过这种方式沉淀出通用的改进经验,再作用到其他任务和版本上。这是 Evo² 这篇文章一个非常重要的方法论,也非常值得我们在实际落地中参考和借鉴。
03
RRSI:用正则化解决自进化的泛化难题
RRSI 解决什么问题?
有了前面 Harness² 和 Evo² 两个方案,其实你已经可以搭出一套比较通用的 Harness RSI 自进化框架了。但在实际跑起来之后,你很可能会遇到一个痛点:
Agent 在高频场景的任务上调优后分数确实越来越高,但换到低频场景或其他任务上,效果就不明显甚至变差了。 也就是说,模型在常见场景上“卷”出了高分,但泛化性不行。这也很正常,因为经验是基于高频问题产生的,未必适用于其他场景。
那怎么解决这个问题?如何让自进化的内容泛化性更强? 这就是 RRSI 论文想要解决的问题。这里的 RRSI 是“正则化的递归自我改进”(Regularized Recursive Self-Improvement),前面多出来的 R 代表 “Regularized”(正则化)。
RRSI 的七步正则化进化流程
RRSI 系统需要初始 Harness、可评分的任务、执行和修改记录、每次调用的 Token 量等作为输入,模型层面不做训练。RRSI 会对搜索轨迹进行正则化约束,但并不限制潜在的编辑空间,提议端(Proposal-side)的约束控制搜索能力的使用方式,而选择端(Selection-side)的约束则决定哪些改进可以被固化为永久状态。它的运行大致可以分为下面的步骤。
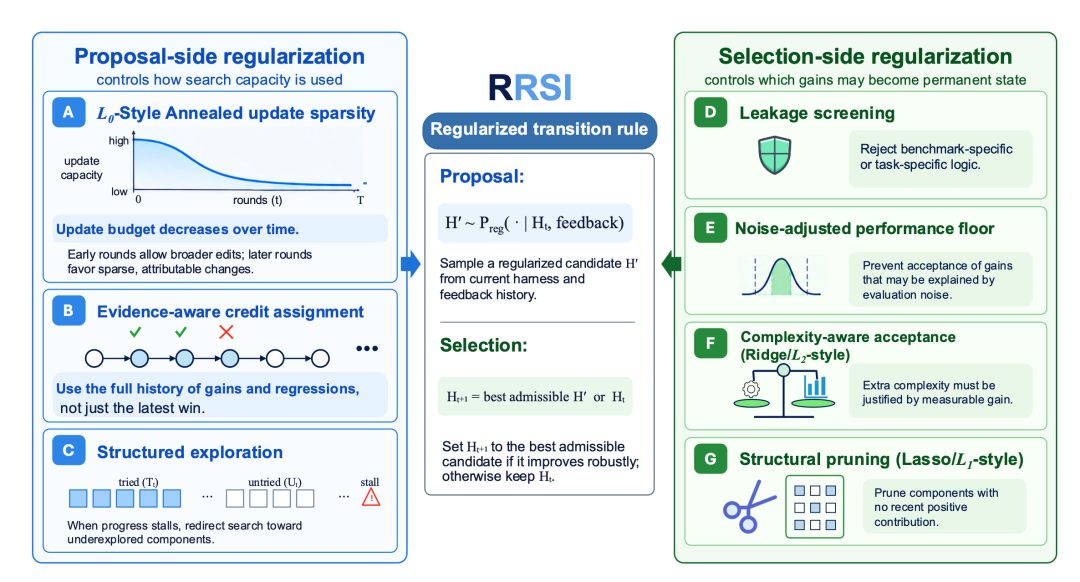
测试初始 Harness 的表现和波动。不是只测一次,而是尽量多测几次,找到稳定性问题。偶发的不稳定还好,如果经常不稳定,那就是大问题,需要先摸清基线。
规定本轮改动幅度,前期探索、后期收敛。RRSI 认为前期可以多探索、多改一些地方,但后期要慢慢收敛。同时,成功的经验、失败的教训、没尝试过的方向都要记下来,为后续决策提供依据。
提出有理由的候选改动。每一项独立改动都必须说清楚准备解决什么问题,不能无限叠加不同方法。否则探索虽然多,但可能永远收敛不了,一直在加东西。
完整评分前先检查改动合规性。先看实际文件有没有夹带老任务的答案、有没有只服务于某些个例场景的信息、有没有与现有约束冲突的额外声明。如果有这类“刷分”性质的个例信息,先修掉;修不掉就直接放弃这条改动。我们不需要为了提高分数而加入过于个性化的东西。
真正运行任务并评估。跑一遍任务,看评测结果和模型用量情况,拿到真实的反馈数据。
按规则决定保留还是回滚。既要看评测分数是否上涨,也要判断是不是正常波动(比如没达到之前水位但属于合理范围)。还要看额外费用和探索价值。不合适就否掉这次进化,保留旧版本;整体效果确实变好了,才保留新版本。
记录、删减冗余、更换验证集检验泛化。所有尝试历史都留下来,但最近几轮没太大帮助的改动可以删减掉。最后固定一个版本,换一套验证集去测试效果,看泛化能力是否真的变强了。这一步是 RRSI 区别于前两者的关键:通过更换验证集来强制检验泛化性,而不是只在同一套题上刷分。
RRSI 如何来约束防止进化“过拟合”
从整个流程中我们可以非常明显地看到,RRSI 最核心的点其实就是加了一层约束。这也是所谓“正则化”的含义,正则化的主要目的就是“增加约束”。如果你不加任何约束,直接去做 Harness 的调优进化,最大的问题就在于:Agent 为了把评测分数卷到极高,一定会做过度的针对性适配。用算法模型领域的概念来说,这就叫“过拟合”(Overfitting)。
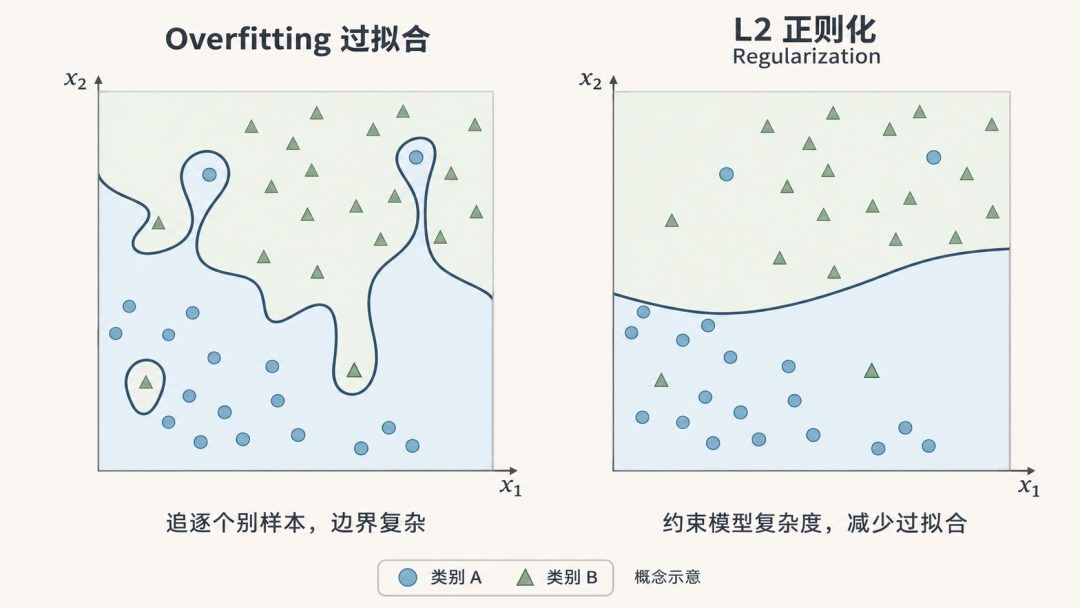
所谓过拟合,其实在传统机器学习里就有的概念了,就是模型为了拟合数据的程度更高,刻意往更加迎合当前的数据方向学习。举个例子,在评测集里“出现咳嗽,就是感冒症状”的比例比较高,于是 Agent 进化出的结果就变成了“只要见到咳嗽,就得出感冒的结论”。这样在当前评测集上分数确实很高,但这其实是个错误判断,它只是因为评测集里感冒样本多而已。一旦换一套新的评测集,咳嗽症状的根因未必还是感冒,Agent 就很容易诊断错误。这就是典型的“调优阶段效果好,换验证集就变差”。
在机器学习里,解决过拟合最好的办法就是加 L1 或 L2 正则,让拟合函数不要过于扭曲奇怪。RRSI 正是借鉴了这个思路。
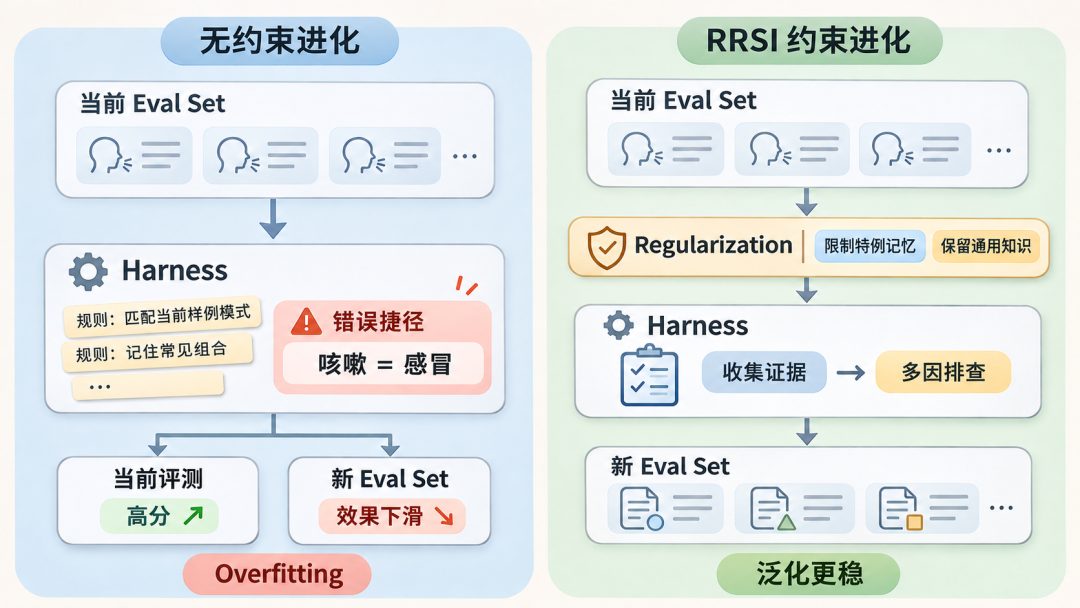
RRSI 加的这些约束,本质上就是不让 Agent 记录那些非常个性化、非常不通用的信息,而是引导它去沉淀真正通用的知识。
还是拿咳嗽举例:Agent 可以学到“咳嗽大概率是感冒,应该重点排查感冒相关指标”,但不能写死成“咳嗽就一定是感冒”。因为咳嗽也可能是慢性咽喉炎或其他疾病引起的。
所以从这个角度来讲,RRSI 所有约束的核心目的,就是为了监督整个进化过程,防止它过分贴合当前评测数据而牺牲泛化性。这才是 RRSI 最想强调的关键点。
04
OO-Harness:面向对象思想解决组织与复用难题
OO-Harness 解决的是什么问题?
经过前面三篇论文的铺垫,大家会发现 Harness RSI 自进化基本上已经能跑起来了:它能在不过拟合的前提下让 Agent 能力越来越强,也能让负责改进的 AI 越来越有经验。但这时候,依然又会出现新问题:Harness 如何组织的问题。
比如有些任务分支很多,哪怕你固定了不变量、只调领域知识,可能在当前任务上变好了,但在另一个任务上,对不变量的调整反而会让效果变差。一套统一的 Harness 未必能适应所有场景。除了在评测时验证之外,我们还能不能从组织结构上做解耦?
比如,我可以有一套主流程处理常规情况,同时分化出一套专门解决特殊问题的子流程。像感冒咳嗽用基础 Harness,遇到异常咳嗽时,就在感冒咳嗽的基础上分化出一个“异常咳嗽 Harness”,它包含感冒的处理逻辑,但又加了额外的诊断步骤。非必要不用这个特殊版本,但一旦遇到棘手情况就能顶上。
这种思路其实非常像软件工程里的面向对象设计。所以这篇论文就叫面向对象的 Harness(Object-Oriented Harness,简称 OO-Harness)。
OO-Harness 想解决什么问题?不同任务是有差别的,一套统一流程未必全能解决;但如果每类场景都单独建一套 Harness,又会重复造轮子、成本极高。能不能通用部分保持一套,特殊部分解耦出来,同时又能复用通用能力? 这类问题其实在软件工程的面向对象里早就被解决过了。
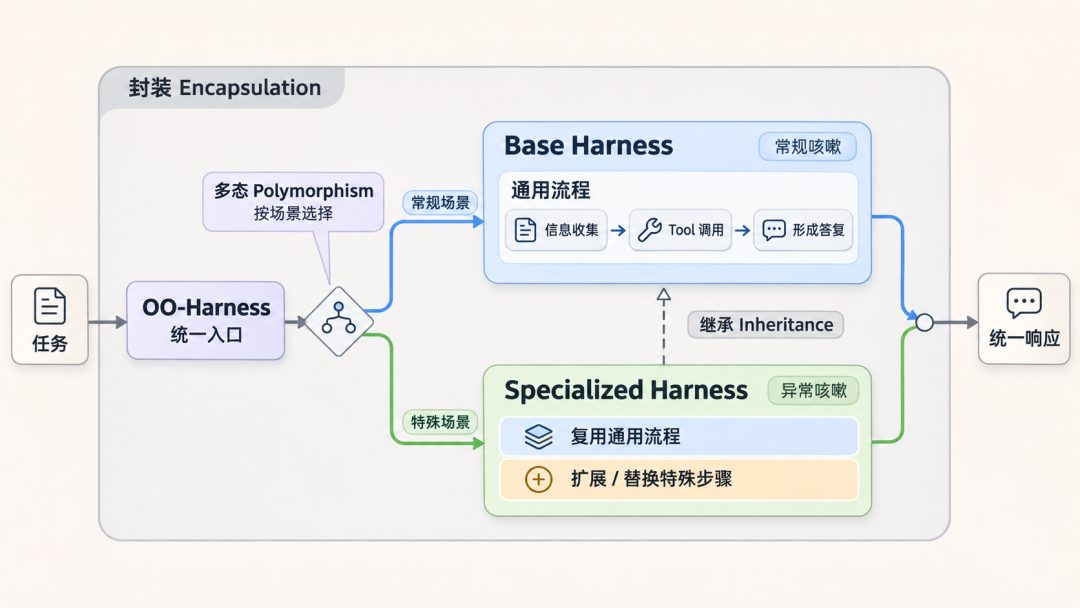
面向对象编程的三大特性:封装、继承、多态,正好对应了 Harness 组织的需求:
封装:把逻辑封装成一套 AI 系统、一个入口,调用时统一从这个口子进来,内部细节对外透明。
继承:有父类和子类的概念。子类继承父类的核心功能,同时加入自己的特有逻辑。父类已有的能力不再重复开发。这正好解决了我们的痛点:绝大部分 Agent 的流程都一样,只是每一种都多了一些特殊处理,那就把相同部分抽象成父 Agent,特殊逻辑放在子 Agent 里,建立父子继承关系。
多态:同一个入口下,不同场景可以分化出不同的处理模式,实现局部的替换和修改。
OO-Harness 就是把这套成熟的软件工程思想迁移到了 Agent Harness 的组织与进化上,让 Harness 既能复用、又能灵活分化,避免“一套打天下”或“重复造轮子”的两难困境。
OO-Harness 的运行机制与落地启发
OO-Harness 从基础 Harness 到专有版本,整个进化过程大致分为以下几个步骤。
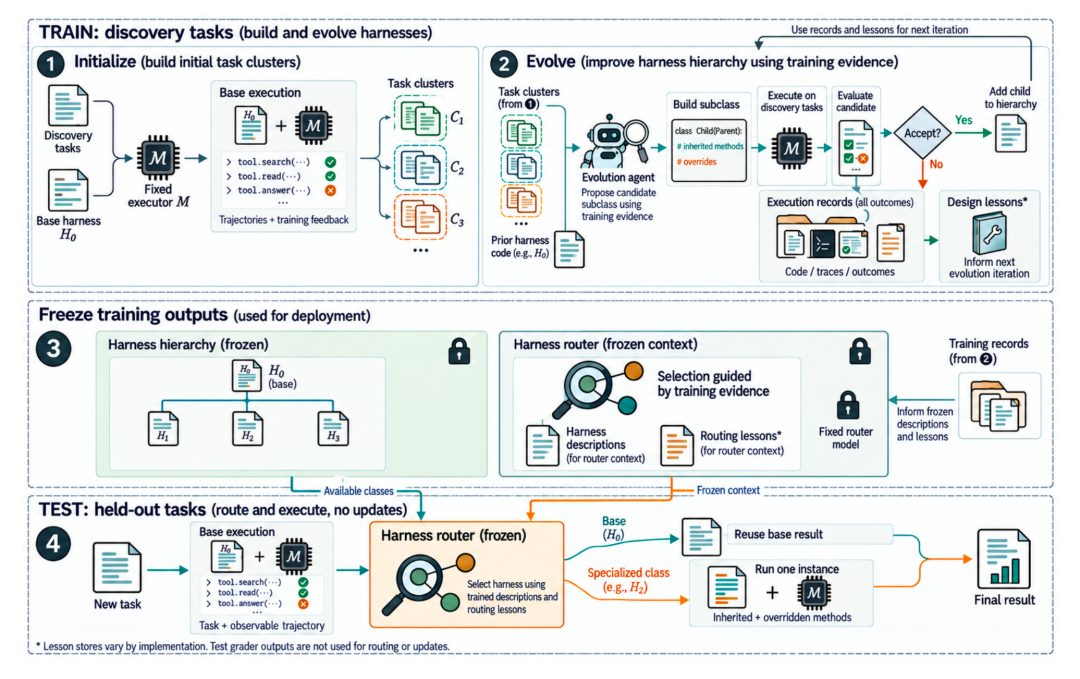
跑基础 Harness 收集 Trace:先用基础 Harness 跑各种任务,保留工具调用记录和错误 Trace。
按任务归类分组:把可能受益于同一种改进的任务放在一起,或者按共同的失败报错归类,这样更适合做针对性调优。
提出可解释的改动并生成新版本:挑一组任务和一个已有 Harness 作为基础,让改进 AI 查看记录、提出一项能解释的改动,写成可执行的新版本。这里既可以改进基础 Harness,也可以分化出一个继承自基础版本的专有 Harness。
在目标任务组上验证候选:只在对应的任务组上跑各种版本,对比看是否有真实提升。
保存新版本的来源与使用条件:记录哪些能力复用旧版、哪些是新增的,成功失败的都保留,总结“应该怎么改”和“什么时候选这个版本”。
继续搜索并固定优质版本:持续探索新版本,找到变好的就记下来并固定。
这个阶段其实是准备阶段:把 Harness 跑起来,收集改进点,沉淀出基础版本和若干专有版本。
然后,当新任务进来时,就进入了使用阶段“基础优先,专有兜底”。具体运行逻辑是这样的:
先用基础 Harness 执行:看能不能跑通、跑出答案。如果 OK,问题解决。
基础不行再换专有 Harness:如果基础版本没解决,再路由到专有 Harness。专有版本继承了基础能力,同时包含针对特殊场景的新逻辑。
路由依据是需求特征:根据具体需求判断是否该走专有路径,但一定是基础跑不通之后才触发。
为什么要这样设计? 因为大多数情况下通用 Harness 就能解决问题,只有 Corner Case 才需要专用版本。这样可以避免大部分场景浪费更多时间,也能防止专用 Harness 在常规任务上反而出现幻觉或跑偏。这是一种防御性的架构思路,大家可以参考,不一定照搬。
在实际业务中,我们经常会遇到任务有差异但也有相似性的情况。OO-Harness 最实用的启发就是:共用基础 Harness + 少量专用 Harness + 一个 Router。
没有必要把所有优化都塞进一个 Harness 里,也没有必要动辄训练模型。通过这种解耦拆解,就能解决大部分问题。它的核心经验是:改善靠的是对已有经验的验证结果,而不是每个请求都重新发明一套 Harness;同时又保留了一定的自主性和个性化效果。这种“基础兜底 + 专有增强 + 路由分发”的模式,是一种非常务实且可落地的 Agent 架构思路。
05
四个 RSI 框架的核心定位对比
最后,我们来横向对比这 4 个 RSI 框架的特点和定位。它们其实是从 4 个不同的切面来解决 Agent Harness 自进化问题的,不能简单说谁的效果更好或者谁是“最好”的方案,而是各有千秋,适用于不同的场景痛点。
| 框架 | 核心要解决的问题 | 核心逻辑 / 关键动作 | 一句话定位 |
| Harness² | 没有当前任务的金标时,Harness 应该如何改进? | 先执行初始 Harness,从不同角度尝试修改并记录,找到更优解法,积累经验实现进化。 | 无金标场景下的 Harness 自进化基线 |
| Evo² | 如何优化“负责改进的 AI”,让它越来越有经验? | 提出修改 → 看结果 → 修正,将改进过程的经验用于训练“改进 AI”本身。 | 让进化机制本身也能进化(套娃) |
| RRSI | 怎么避免在特定评测集上刷高分,却丧失泛化能力? | 通过约束和规则抑制波动与过拟合,提高可复用性,让通用能力真正沉淀。 | 用正则化约束防止进化过拟合 |
| OO-Harness | 不同场景、任务差异大时,如何组织 Harness? | 拆解为通用 Harness + 专有 Harness(继承关系),配合路由分发,实现复杂场景的解耦。 | 用面向对象思想解决架构复用与分化 |
这 4 个框架分别从 “无金标进化”、“进化器自优化”、“防过拟合”、“架构解耦” 四个维度提出了各自的解决方案。在实际落地时,不一定要全部用上,应该根据自己业务中遇到的具体痛点,选择最适合的组合。还是那句话:天下没有最好的 RSI 进化方案,只有最适合你场景的 RSI 进化方案。
其实这个过程,也有点像我们常说的 Loop Engineering 和 Graph Engineering。Loop Engineering 本身就是在 Agent 执行过程中加了一个过程循环,通过目标驱动的方式来保障 Agent 的执行效果,让 Agent 表现越来越好。但是呢,Graph Engineering 就是为了防止加了 Loop 之后,模型反而为了目标疯狂去过拟合了,去不停地卷那个分数,从而避免了泛化性的降低。所以你可以理解为 Graph Engineering 其实就是用来监管 Loop Engineering 的,它解决了这个“越练越死板”的问题。关于这部分的详细内容,大家可以看我之前写的《从 Loop 到 Graph Engineering 的演进思考与实战》一文。
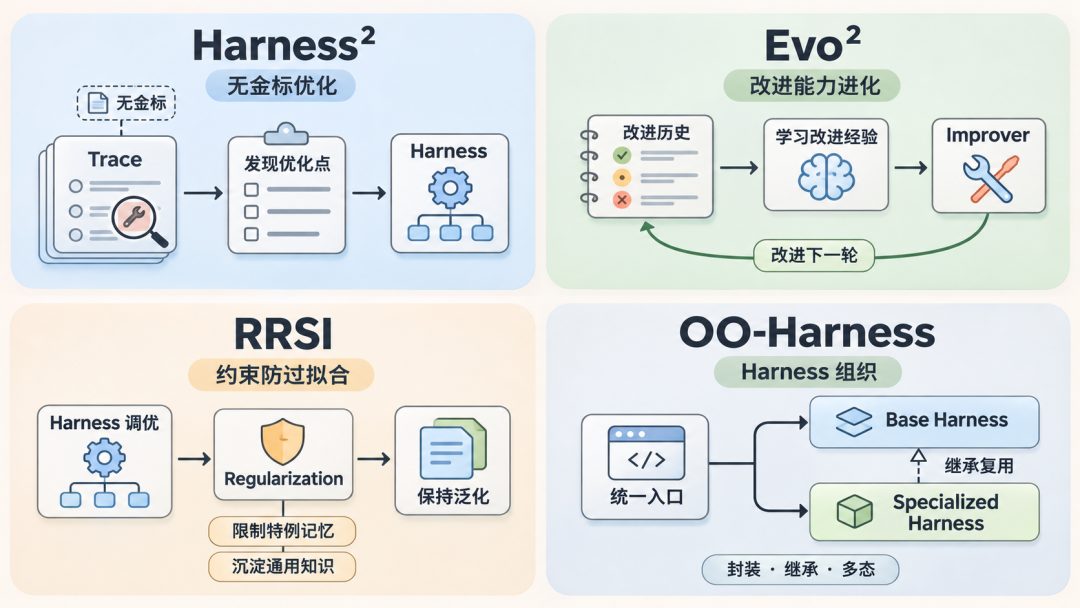
在 RSI 这套体系里也是相同的逻辑。Harness² 是用来解决 Agent Harness 怎么进化的问题,比如要进化哪些点、怎么去拆分;而 Evo² 则用来改进 Harness 的这套进化方法本身的;最后,RRSI 的作用就是去监督 Harness 进化过程中可能会出现的过拟合情况。
如果调优有了瓶颈,出现了此消彼长的“跷跷板效应”怎么办?这就轮到 OO-Harness 出场了。它的核心思路就是把通用的信息抽象出来,然后把那些确定是个性化的、或者说是过拟合的信息,放到另外一些独立的 Harness 里面去,不要跟通用的混在一起;通过这种解耦合,直接从组织结构上、从架构上就把这个问题给拆分掉了。
综合来看,这 4 个框架相当于在原有的基础之上持续打补丁,加了一系列后续的改进措施。把这 4 个结合起来,目前来看可以认为这是一套相对完善的、当前最新的 Agent Harness 自进化的方案了。
当然,在具体业务落地时,哪些是有必要的、哪些可能是过度设计,必须视场景而定。正所谓“天下没有最好的 Agent 架构,只有最适合场景的 Agent 架构”。把这句话映射到 RSI 场景里也是一样:天下没有最好的 RSI 进化方案,只有最适合你当前场景的 RSI 进化方案。
06
总结
由于 Google 这 4 篇论文的整体篇幅确实比较长,本文也只是大概梳理了核心逻辑和思路。有兴趣的读者,强烈建议自行找原文来看看,深入研究其核心设计、具体的实验数据以及那些容易被忽略的细节。
除了论文本身,其中的 Harness² 和 RRSI 还开源了相应的代码(大家可以去 GitHub 直接查看代码的具体实现,这能帮我们更直观地理解背后的工程逻辑)。我也希望这些内容能够帮助大家在各自的业务场景中探索 RSI,或者在解决 Agent 进化、改进过程中遇到的问题时,能提供更多的参考和建议。
最后要特别说明的是,这几篇文章都是比较近期的,加上写作时间也比较仓促,文中如果部分瑕疵、疏漏甚至表达不当的地方,欢迎在评论区留言指正。我们一起探讨、交流、学习,共同努力成长,一起在 Agent 和 RSI 的落地实践上,献出自己的一份力量。
References
[1] Google RSI 论文解析
https://mp.weixin.qq.com/s/N4H0rYB19myXFshzoH3_4w
[2] Harness2: Recursive Agent Harnessing for an Open World
[3] Evo2: Evolving the Evolver through Weight-Harness Co-Evolution
[4] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
[5] Object-Oriented Harness: Evolving Agent Harnesses through Object-Oriented Design

欢迎留言一起参与讨论~
本文转载自微信公众号「阿里技术」,查看原文。版权归原作者所有,如有侵权请联系删除。