GitHub 为什么要重建存储:Git 不是不够用,是把「持久」和「扩读」绑在一起不够用
原创 张汉东 2026-11-10 01:29 美国
对做 agent 系统的人,我觉得这篇的价值是一个反向案例:agent 的负载把一个运行了很多年的底层系统改写了
GitHub 公布过一组一年的增长数据:从 2025 年 9 月到 2026 年 8 月,每月 push 从 6.9 亿涨到 33.5 亿,涨了 4.9 倍;9 月的 commit 有 73.8 亿,是一年前的 5 倍以上。总的 Git 事件才翻了一倍多,写入涨得比整体流量更猛。
最近一年,大家都说 Git 过时了。
我读完 GitHub 工程博客上的这一组文章,最想记下来的是它的回答方式。它没有说 Git 不够用,也没有去改 Git 的语义。Git 里真正需要共识的只有引用(ref)更新,也就是分支、tag 指向哪个 commit,其余的对象存储、校验、压缩、读取,都可以拆开各自扩展。旧架构的问题在于,把「数据存得住」和「读得动」绑在了同一套多副本机制上。
这套说法全部来自 GitHub 自家的官方博客,作者是 GitHub 的工程师,数字都是自报,性能结果来自内部测试,没有第三方验证。
压力从哪来:写比读难扩,而且集中在几个点上
先把开头那组数字补全。一年里,月度 Git 事件从 2182 亿涨到 4733 亿;Actions 运行 9 月有 32.6 亿次,是一年前的 4 倍以上;PR 合并也近 4 倍。放在一起看,涨得最猛的都是动手改东西的那一侧。
GitHub 的博客把这些压力归成五项挑战:
单个 agent 几乎每做一步就 commit 或 checkpoint,所以单次提交的延迟变得很要紧
写吞吐
合并集中到同一个 ref 上,merge queue 和 trunk-based 的工作方式天然就在抢这一个点
读扇出:一次 push 之后,CI、代码扫描会成千上万次地 clone、fetch 同一个分支头
维护成本:压缩和垃圾回收要和线上请求抢资源
这五项我读下来,其实都指向同一句话,博客里的原话是「Writes are way harder」。读可以靠缓存和加副本摊开,写要保证一致,摊不开。而且写的压力不均匀,会堆在几个具体的点上:某个 agent 的每一步提交,某条主干分支的合并,某次 push 之后的那一轮读取。
这个分析我基本认同,因为它符合我对 agent 工作方式的直觉:agent 不像人,不会攒一大批改动再提交,它把版本控制当成逐步落盘的手段,这和我们在 Harness 工程中的 checkpoint、回滚、并行分支的需求是对得上的。
但有几处我要先打个折扣。
第一,这些增长数据没有区分 agent、人类和 CI 自动化的流量。「agent 驱动」是作者的叙述,不是数据证明出来的。
第二,「events」到底指什么,文章没有定义,4733 亿这个数我只能当作量级参考。
第三,另一篇文章里讲单个仓库的请求量从 4400 万涨到 1.81 亿,约 4 倍,样本只有一个,还没具名,拿它来推断「未来一年所有大仓库都会这样」,证据太弱。
所以这一节压力确实在涨,而且偏向写操作;至于涨了多少是 agent 造成的,GitHub 没有给出能核对的答案。
旧架构的结构性天花板:Spokes 把两件事绑在了一起
要看清 GitHub 为什么觉得非重建不可,得先看它现在的存储系统 Spokes 是怎么工作的。
Spokes 把每个仓库完整存在好几台 fileserver 的本地磁盘上,默认 5 份。这些本地副本同时干两件事:一是存数据,是仓库唯一的真相来源;二是响应读取,clone、fetch 都从这些机器上出。持久化和读容量,靠的是同一个机制。
写入这一侧的代价是这样的。每次更新 ref,要走三阶段提交加 quorum(法定多数),为的是让 CI、Web UI、API 看到的仓库状态一致。关键在于,每个副本都参与每一次写入,所以一次 push 完成的快慢,取决于最慢的那个副本。再往下一步,如果失去 quorum,写入就整个停下来。
把这两件事叠起来,回环就出来了:
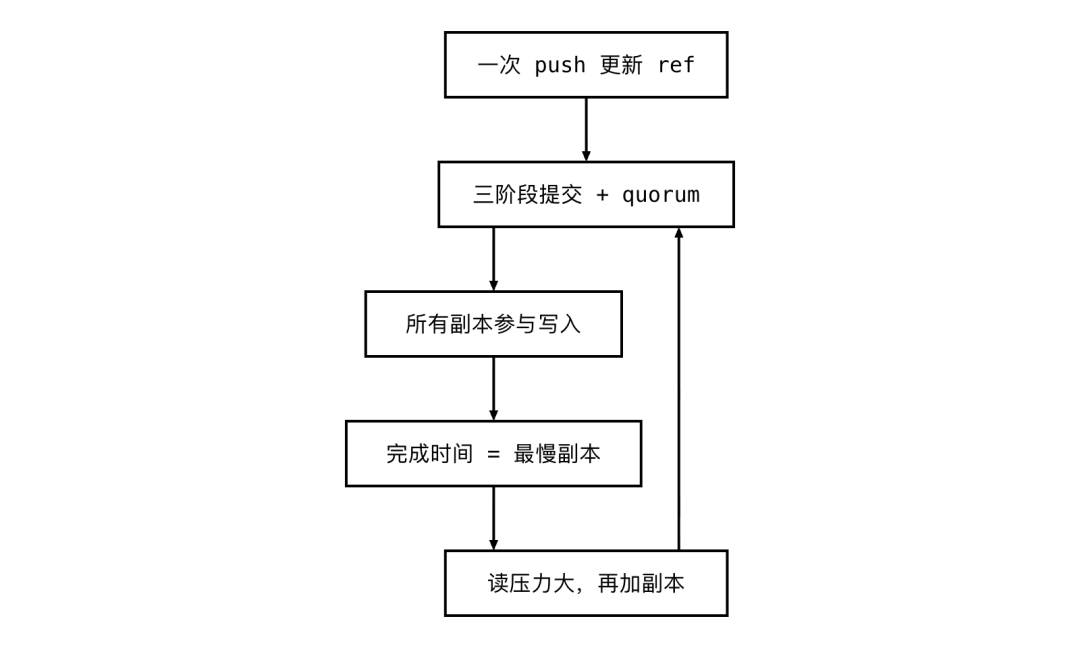
读压力上来,唯一的办法是加持久副本;而每多一个副本,每次写入就多一个要等的参与者。博客里有一句话我认为是整个系列最清楚的诊断:「adding replicas to absorb read load makes writes slower」。反过来也一样,丢一个副本,读容量就少一份。
我喜欢这句话,是因为它把问题的性质讲准了。它指出的是机制耦合:同一批机器背着两个目标,而这两个目标恰好在 agent 时代朝相反方向使劲。读扇出越来越大,需要更多副本;写越来越密,需要更少的参与者。
这是我的推断:这类设计在人类主导的年代很合理。写得少、读得多,副本多一点,读得快,写慢一点也没人在意。Spokes 的问题是负载的形状变了,当年的设计没有错。
要说明的是,这一节的诊断来自 GitHub 自己的描述,我没法验证 5 副本、最慢副本决定延迟这些细节在生产中的实际表现,博客也没给出旧架构的延迟分布。但从机制上看,这个论证是自洽的,我愿意先当作成立。
两条原则落到实现:Rubicon 的解法
新架构的代号是 Rubicon,出发点就是前面那个洞察:Git 对象不可变、按内容寻址,同一个对象谁来写都一样,并发写不需要协调。真正要达成一致的只有引用更新,而它很小。
落到实现,是两刀。
第一刀是存算分离。权威数据放进 Azure Blob Storage,原来的 fileserver 换成 virtual replica(虚拟副本):它是可丢弃的计算节点,本地盘只是随时能重建的缓存,丢一个近似一次 cache miss。Spokes 继续做路由和负载均衡,变的只是它下面的数据面。引用和 pack manifest(组成仓库的 pack 清单)则放在一个专门的复制日志服务里,下一节细讲。
第二刀是让写和读各走各的路:
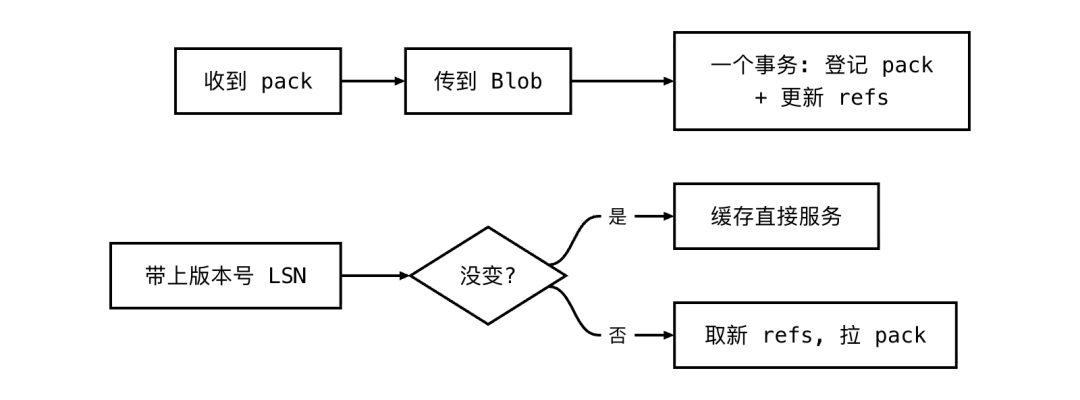
写路径先传 pack,再用一个事务同时登记 pack 和更新 refs。所以 ref 只会指向已经持久化的对象,不会出现指针到了、数据没到。读路径带上自己持有的版本号(LSN),仓库没变,就只花一次比较,不返回任何 ref。读远多于写的场景里,这一步省得最多。
维护也被搬走了。compaction(把大量小 pack 合并成少量大 pack)和 GC 不再占 replica 的 CPU,交给独立节点,用租约认领分片。pack 按哈希分到 shard,加节点就加合并吞吐。新 pack 发布前,会校验它和输入包含完全相同的对象,保证只合并、不丢。这个校验要花多少成本,文章没说。
这套解法我觉得很干净。不过「pack 数基本持平、延迟曲线持平」这类结论,文中是用图和断言给的,没有具体数值,我先只当作作者的说法记下。
最有信息量的部分:为什么 Blob 存不了引用,只好自建 Ref-CAS
整个系列里我最想细读的,是 GitHub 没把引用也塞进 Blob Storage 的理由。对象放 Blob 很自然,写一次后不改,聚合吞吐又高。但引用小而且高争用,博客讲他们先试了几种办法,文中只展开了两个失败的原型。
第一个,用单个 blob 当 write-ahead log。读很便宜,问一句 blob 有没有变就行。问题在写:条件写入同一时刻只能飞一个,写吞吐大约是「mid-hundreds per second」,每秒几百次。
第二个,把引用按哈希拆到多个 segment blob 里。不同 segment 互不等待,写上去了。代价转到读:要检查每一个 segment,整体被最慢的那个拖住。而博客强调,读比写多好几个数量级,这等于拿读延迟换写延迟,换错了方向。
所以他们自建了 Ref-CAS:一个复制日志,按引用加锁,quorum 提交。只锁事务涉及的那几个 ref,不冲突的更新可以并行复制。读只比对版本号,「写」的引用事务能到「tens of thousands of operations per second」。
「读」到这里,协调只是粒度变了,从旧架构里「整个仓库的所有副本」,缩到了「单个 ref」。博客自己也说,agent 大多推自己的分支,所以多数更新互不冲突,并行才成立。这也是我对「几乎无协调」这个说法要打折的原因。Ref-CAS 仍然是每次写都必须经过的中心提交点,只是锁得更细。
还有一处对不上。第一篇文章把「合并集中在单个 ref 上争用」列为挑战,但方案部分没有直接回应。如果大家都往同一条主干合并,细粒度锁帮不上忙。那篇文章引用的相关文章标题里有「per-reference quorums」,我猜答案可能在那里,但这只是我的推测,正文没有这么写。
另外要记住,这个对比只有两个原型,而且都是基于 Blob 条件写的方案。博客说试过好几种,却没和现成的共识服务或数据库比过,这个对照多少有点稻草人的味道。Ref-CAS 的数万次每秒,也只是引用事务自己的数字,不等于端到端的 push 速率。
给我们的启示
先说官方给的成绩:内部测试里撑住了 5,000 个并发 agent,每秒 7,200 次 push,读延迟保持较低;另一篇文章给的是写吞吐最高提升 35 倍。
这些数字我都只当作方向,不当作结论。
- 全是内部测试。
没有 p50/p99,没有测试仓库的规模,没有 push 的大小,也没说跨分支争用是什么情况。
- 7,200 是在多少个不同的 ref 上跑出来的,没有交代。
博客自己说 agent 大多推自己的分支,那这个数很可能是在低冲突的理想形状下测的。同一条分支上高争用,才是我最想看到的数据。
- Ref-CAS 的数万次每秒,不等于端到端的 push 速率。
- 35 倍是「up to」,也没有基线。
比的是谁、在什么负载下,都没说。
其他存疑的地方:前面讲过,对比只有两个 Blob 原型,有稻草人的嫌疑。副本数、跨区域行为、故障恢复、GC 怎么安全删数据,文章都没展开。架构目前只是 limited private preview,说是明年初才更大范围推出,真正的大规模可靠性还没经过验证。
那给我们什么启示呢?
我的结论是,GitHub 的应对是重新划分「必须强一致」和「可以并行」的边界,而没有给 Git 加功能。引用更新留在共识里,对象、校验、压缩都放出去,读取也是。还有一个容易被忽略的约束:迁移过程中分支保护、审计日志这些治理能力不能丢,还得在线、不停机。能这样拆,是因为 Git 的数据模型本来就把不可变和可变分得很清楚,GitHub 只是顺着这条缝下刀。
对做 agent 系统的人,我觉得这篇的价值是一个反向案例:agent 的负载把一个运行了很多年的底层系统改写了。文末列的原子提交 API、事件流、不用 clone 就能工作,是在为 agent 重新设计接口。
最后留一个问题给自己,也给你:在你的 agent 系统里,哪些状态是可以按内容寻址的不可变数据,哪些才是真正需要仲裁的「引用」 ?在选方案之前,先测一下你的读写比。GitHub 的两个失败原型,输就输在没有一开始就想清楚读比写多几个数量级。
参考
- Inside GitHub's new Git storage architecture[1]
- Building Git infrastructure for agent-scale development[2]
参考链接
本文转载自微信公众号「觉学社」,查看原文。版权归原作者所有,如有侵权请联系删除。