文字结论→可交互视图:Memfit 结构化 UI 升级
Yak 2026-11-11 18:16 四川
在安全分析场景中,结论天然有两种形态:需要深度解读的定性判断(攻击是否成立、影响面多大、怎么修)与需要多维审视的定量数据(流量指标、日志明细、风险分布)。然而,传统长文本回答常将二者混为一谈。分析人员不仅需要在密集的段落中反复滚动,还常常得将数据导出到第三方工具中进行二次筛选与对比,割裂了整体的分析体验。
Memfit 的解法是采用结构化 UI:模型不再只输出文本,而是按上下文语义选择性嵌入条形图、趋势图、数据表格、指标卡与风险提示,让"读结论"和"看数据"在同一处完成。
但直接让大模型输出 HTML、JavaScript 甚至是完整的 React 组件,会增加运行时隔离、渲染稳定性和维护方面的成本。这些问题大概可以概括成以下几个方面:
•注入面:如果缺少严格的隔离与校验,生成代码可能引入脚本执行风险;
•稳定性:不存在的组件或不匹配的参数可能导致渲染失败或界面异常,且难以复现;
•成本:一段完整 React 代码动辄数千 token,较长的代码会增加生成和传输开销;
•可审计性:任意生成的代码会扩大 QA 需要覆盖的UI行为范围。
所以 Memfit 采用的是一套契约驱动(Contract-based)的结构化 UI 架构:模型只负责表达"用哪个组件、给什么数据、如何组织内容",客户端只负责渲染白名单内的组件。这份契约明确了模型的表达范围和客户端的渲染职责。
一、让数据在 Memfit 内完成可视化
一次分析是否顺畅,往往取决于结论出现之后还能做什么。看到“问题总数没有变化”,分析人员通常还会追问:哪些模块改善了,哪些模块反而变差了,下一步应该先看哪里?结构化 UI 要支持的,正是从阅读结论到检查数据的这几步操作。
YAK
1.1 对比分析场景可视化
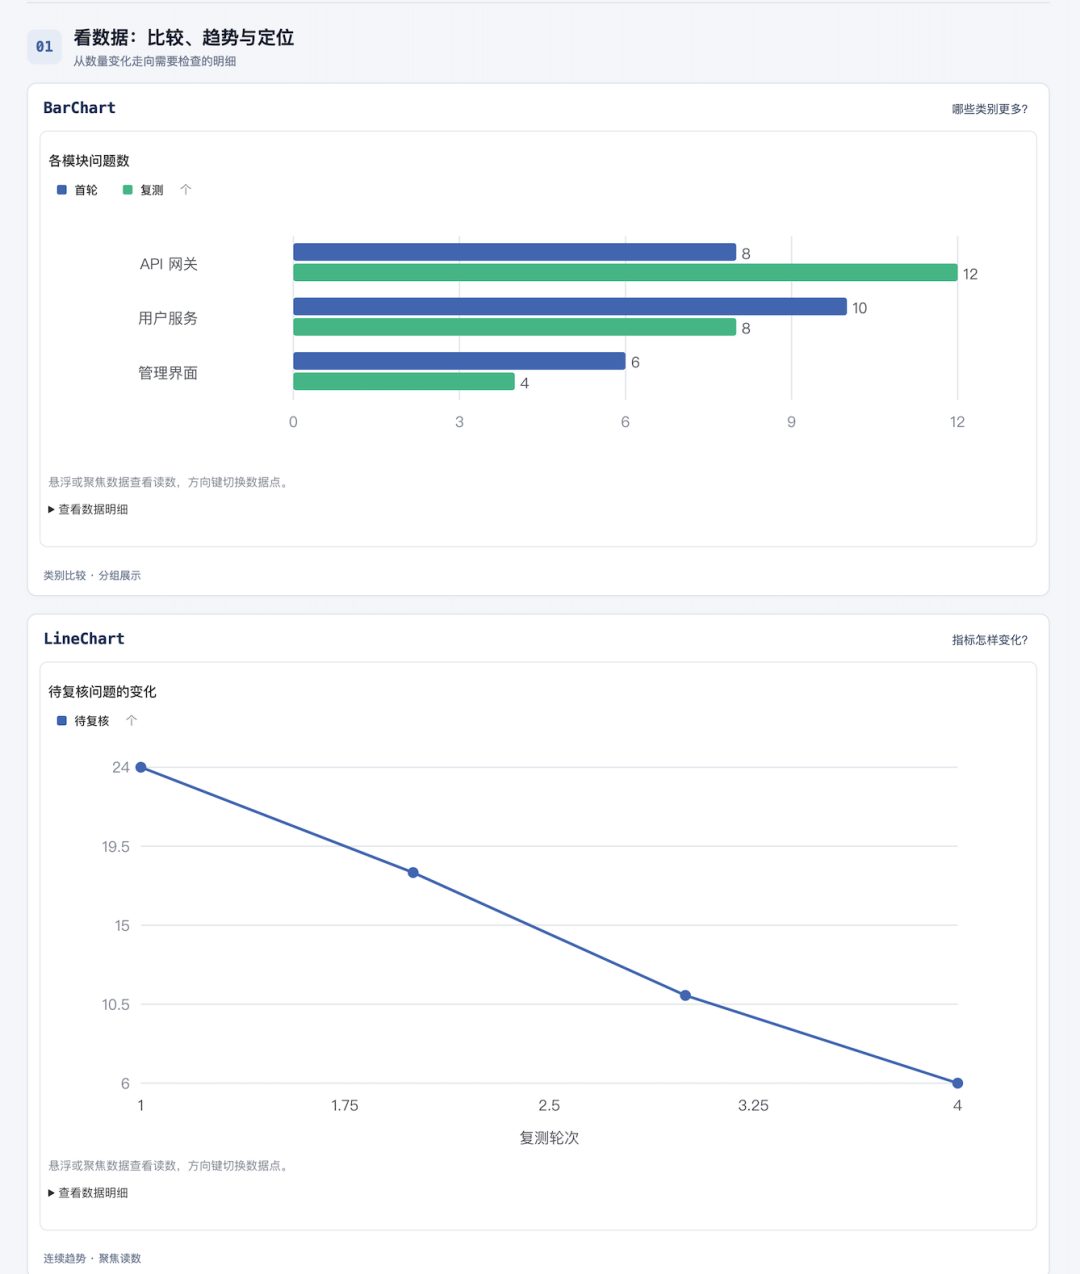
以两轮安全检查的演示数据为例:API 网关的问题数从 8 个增加到 12 个,用户服务从 10 个降到 8 个,管理界面从 6 个降到 4 个。两轮合计都是 24 个,但 API 网关增长了 50%。如果回答只强调“总数持平”,局部变化就很容易被忽略。
在 Memfit 中,用户可以直接要求:“比较两轮检查结果,用图表展示各模块的变化,再给我一份可以排序和筛选的明细。”模型据此选择分组条形图和数据表,并在前后的文字中解释变化。图表让 API 网关的增长更显眼,表格则保留精确数量与变化值,方便继续核对。
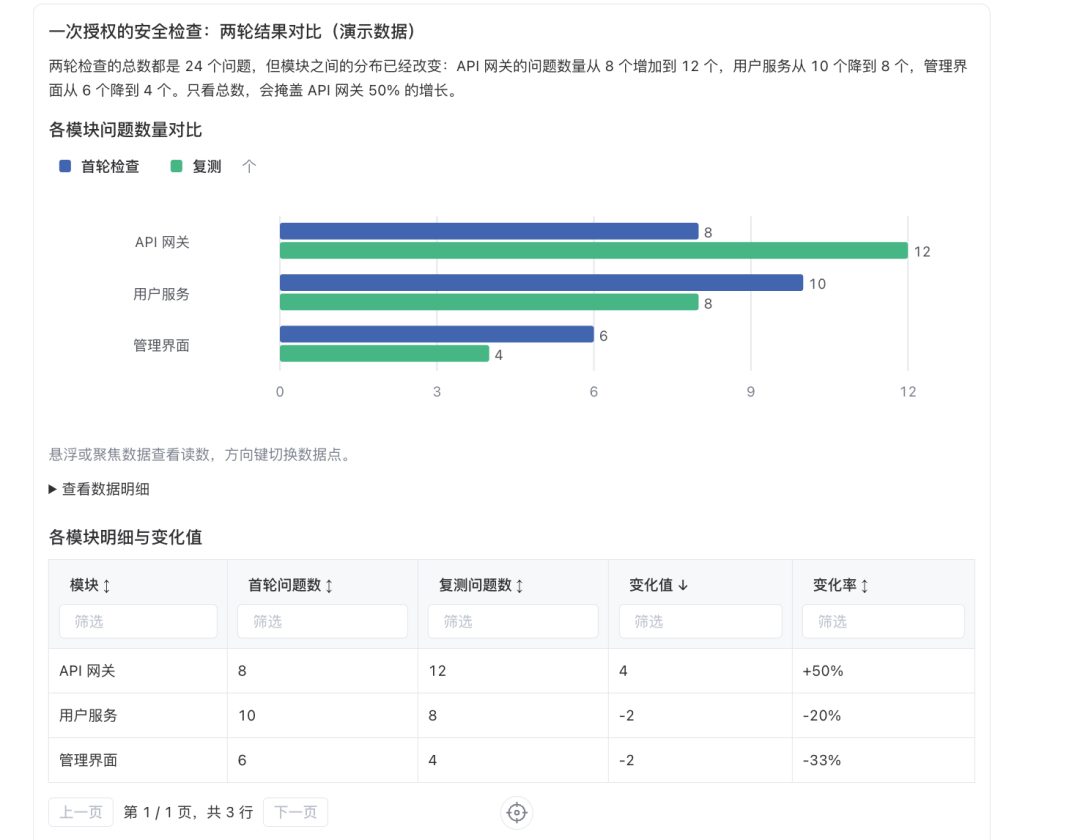
用户可以在这条回答中切换图例、查看读数、按变化值排序,或者筛选出 API 网关。
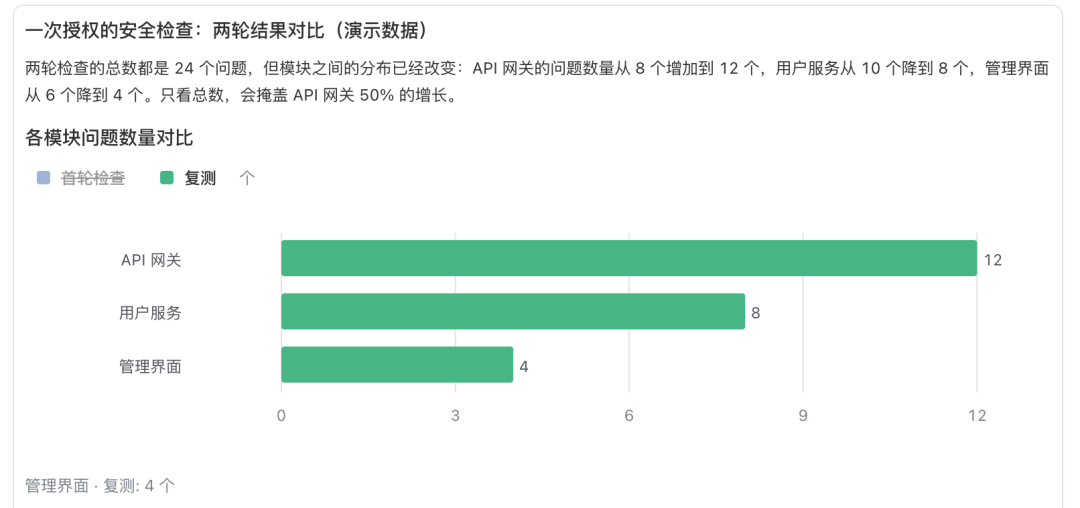
整个过程不需要把数据复制到另一套报表工具,也不需要让模型重新生成一次答案。与此同时,文字分析仍然承担解释作用。
YAK
1.2 长程测试结果复盘
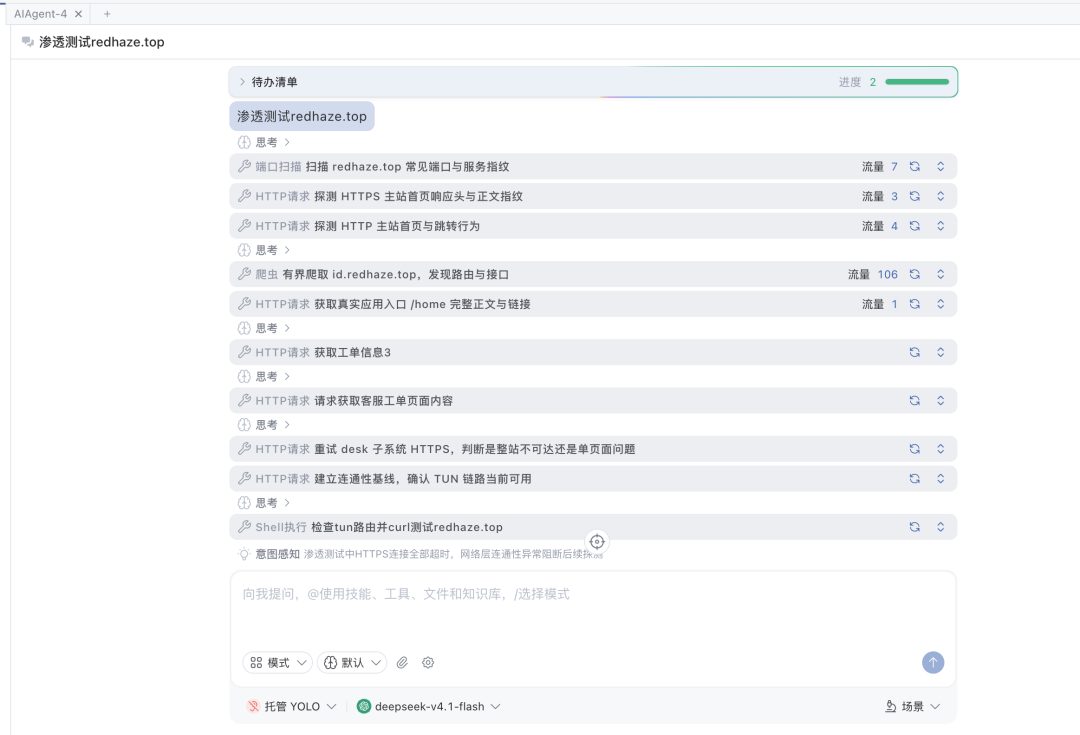
一次由 AI 主导的长程渗透测试结束后,会话中往往已经积累了大量历史消息、工具调用和 HTTP 流量。分析人员需要先弄清哪些系统已完成测试、发现了哪些风险、哪些结果仍待验证。
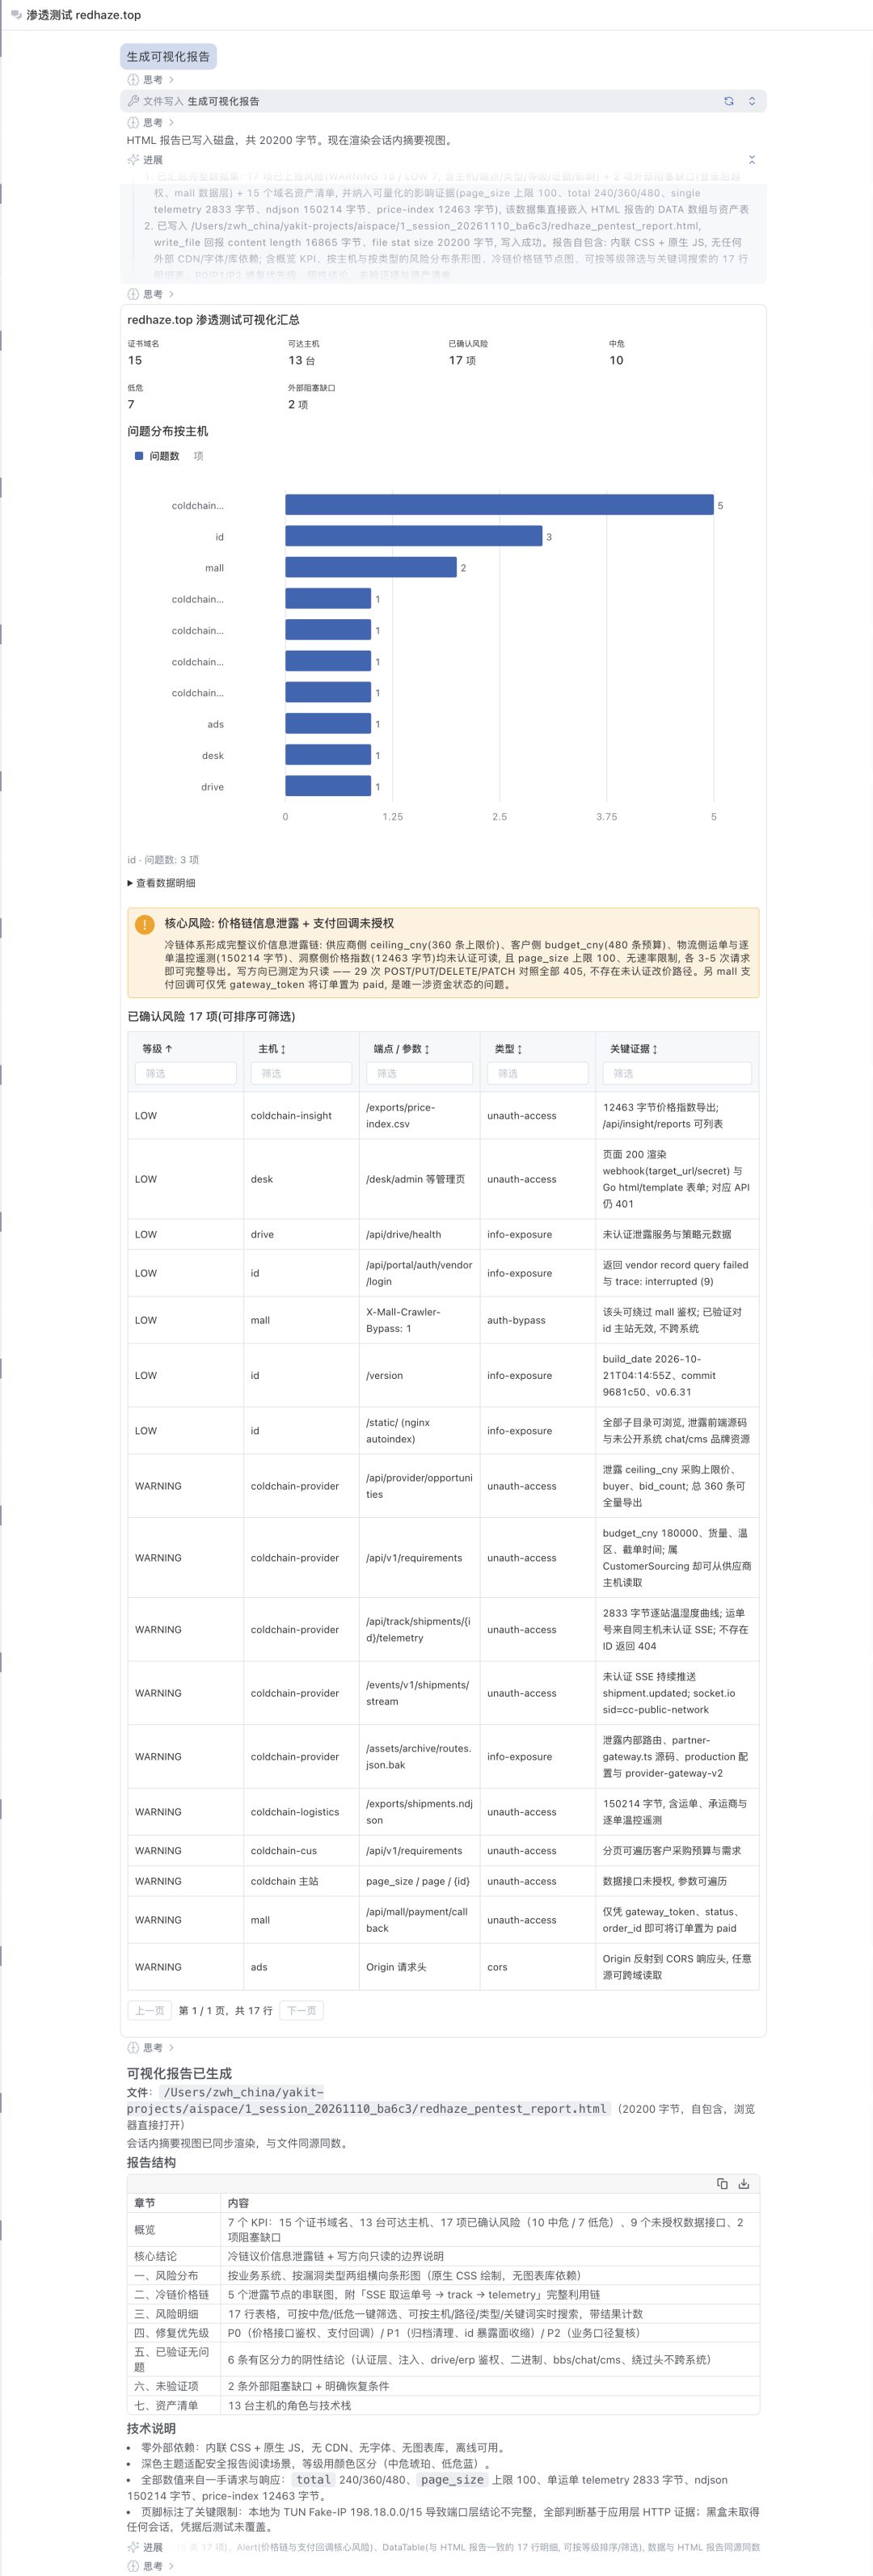
结构化 UI 可以将这些信息整理为概览和明细,帮助用户先了解整体情况,再按系统或风险类型筛选需要复查的结果,减少逐条翻阅历史消息的操作。
YAK
1.3 对测试流量进行分析和复盘
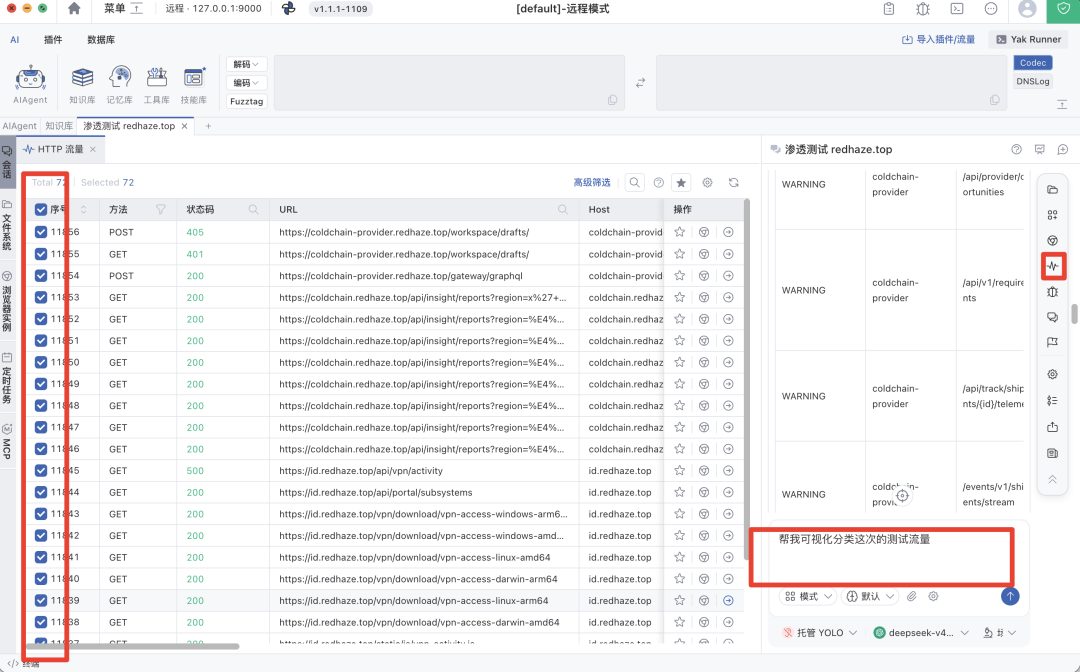
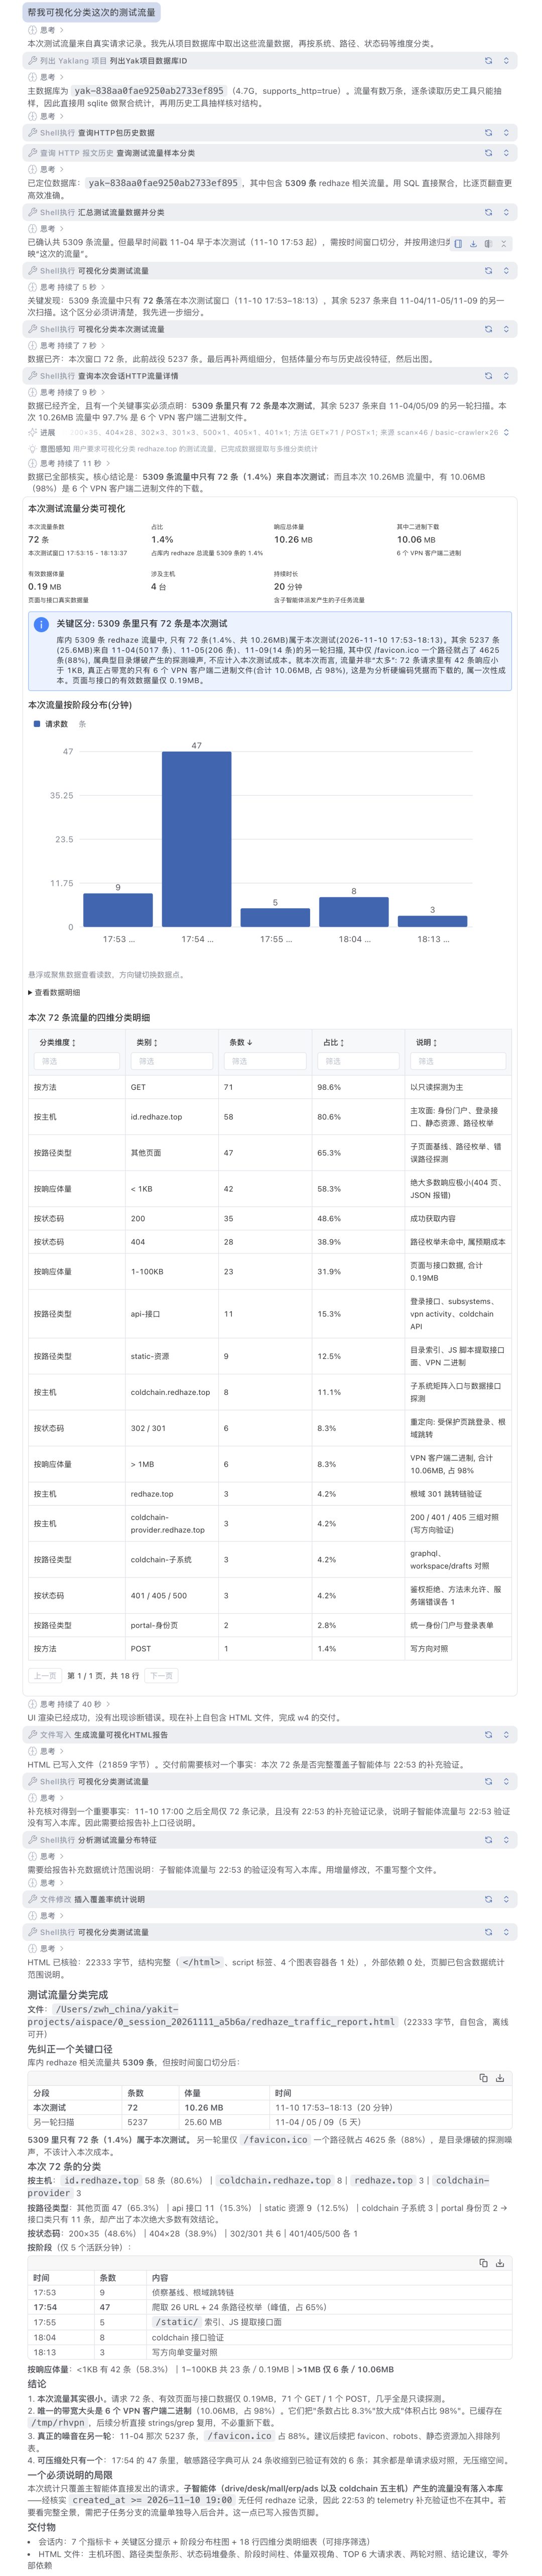
通过 Memfit 右侧的流量菜单,可以查看本次 AI 会话中发送的 HTTP 请求,包括 Fuzz 探测、漏洞验证和利用过程中产生的流量。当请求分布在多个目标或子域名下时,逐条审阅较为费时。借助结构化 UI,可以按目标、接口或响应状态汇总流量,再通过明细筛选定位需要复查的请求,为后续核对原始请求与响应缩小范围。
YAK
1.4 日志分析场景
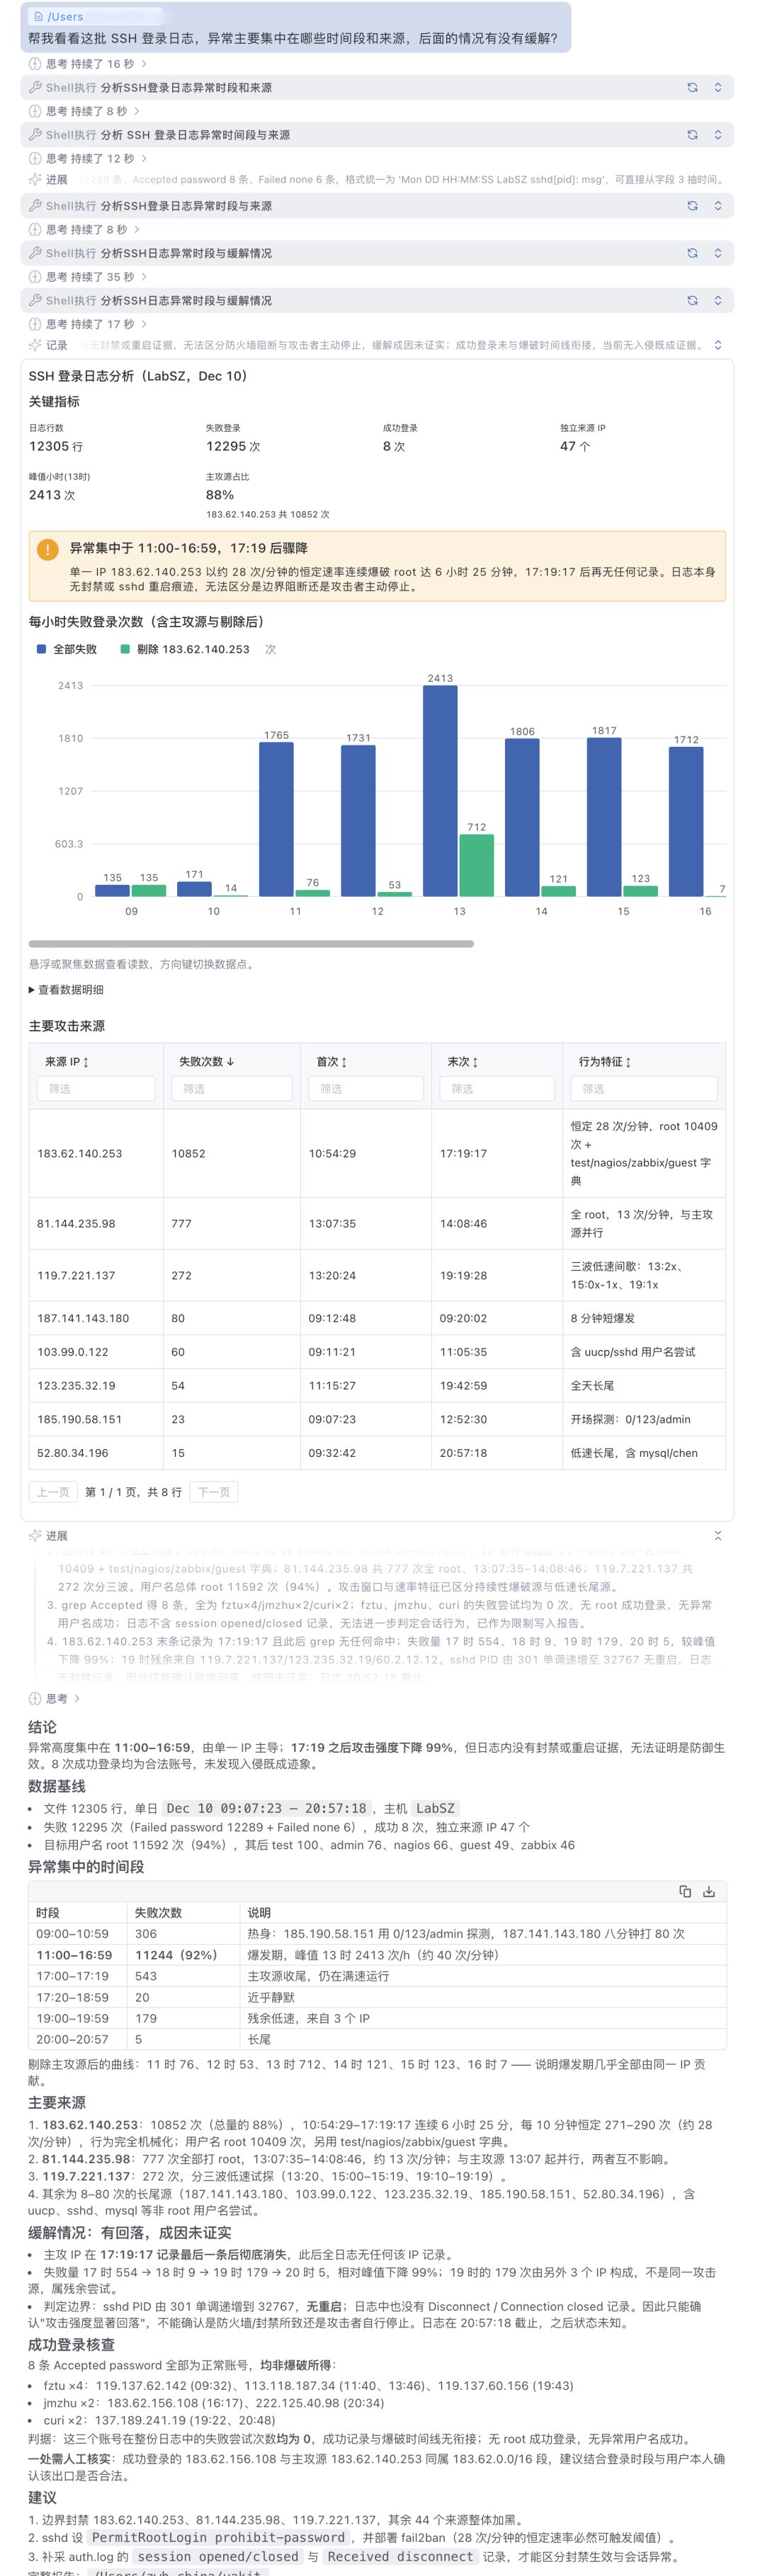
本例采用公开的 Loghub OpenSSH 实采日志,截取连续 12 小时的认证记录进行分析。
分析大量日志时,纯文本结论很难直观呈现异常随时间变化的过程。以 SSH 登录日志为例,除了知道“出现了大量认证失败”,分析人员还需要了解:失败从什么时候开始增加、集中在哪些时段、后续是否有所缓解。在 Memfit 中,模型可以将日志按时间聚合,通过折线图呈现认证成功、失败事件数量随时间的变化,用户也可以悬停查看各时段的具体数值。配合文字对异常来源和证据的解释,分析人员能够更快定位值得复查的时间窗口,再回到对应日志核对细节。
YAK
1.5 组件的价值取决于它能帮助用户完成什么
这也是结构化 UI 与 Markdown 的主要分工。几行数据的静态对比,用 Markdown 表格就很清楚;当用户需要反复排序、筛选,或者在同一主题的不同视图间切换时,组件才开始体现价值。选择组件的依据应该是查看任务,而不是回答里还能放多少张卡片。
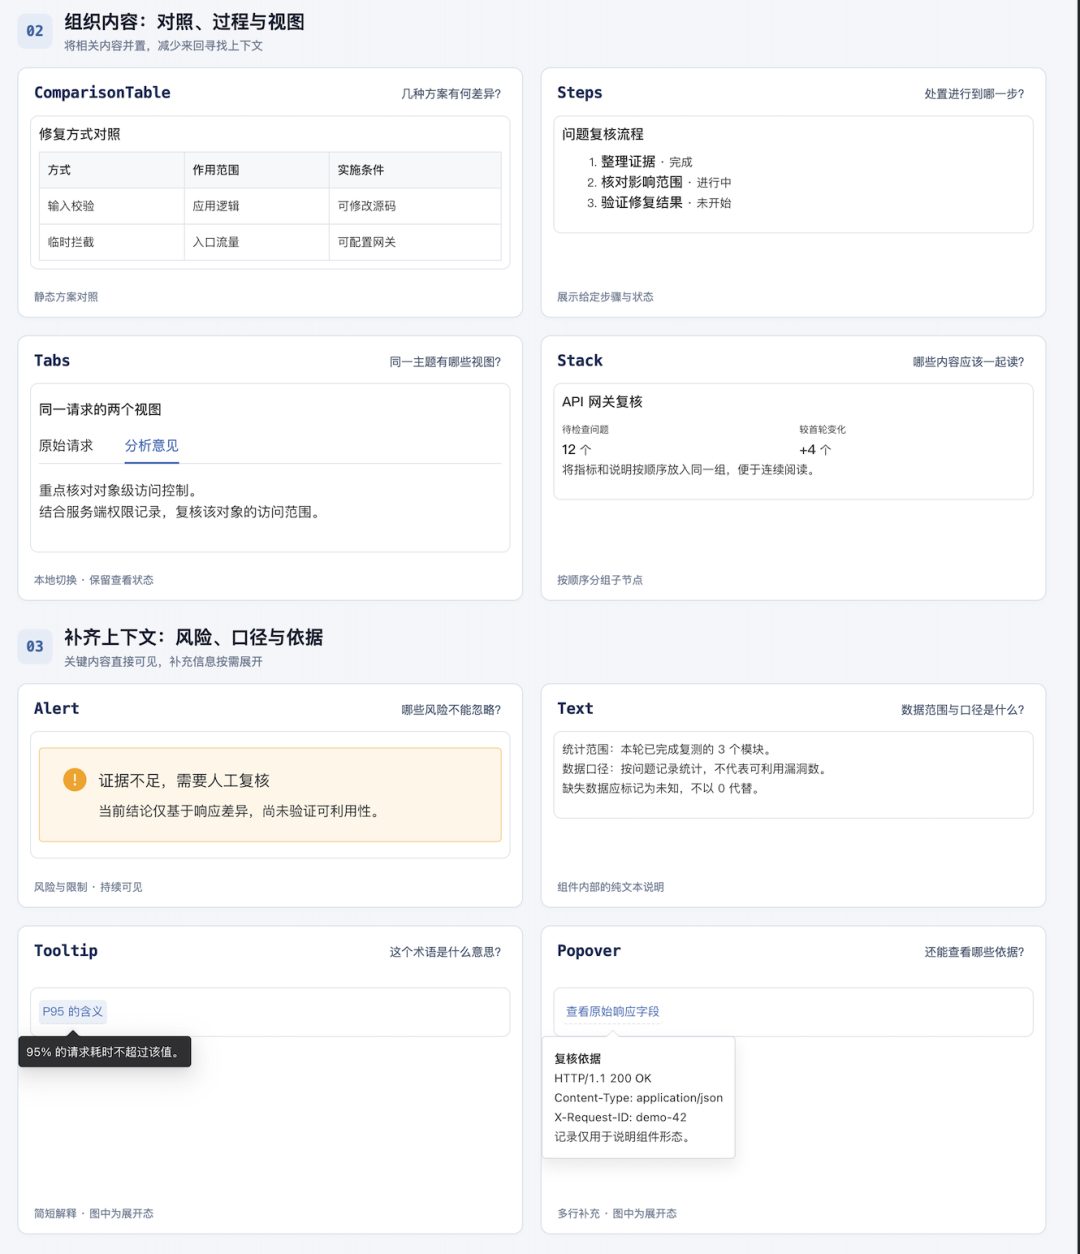
当前 1.3 版目录包含 12 个组件,可以按安全分析中的用途理解它们:
这些组件各有明确的职责。Metrics 显示传入的指标,不自行计算风险分数;Steps 展示给定的状态,不会自动变成任务调度器;Tooltip 和 Popover 承载纯文本补充说明,关键风险仍应直接出现在 Alert 或正文中。它们共同提供一套有限但可组合的表达方式,让模型可以围绕数据组织答案,也让用户对界面行为形成稳定预期。
二、模型和前端之间,需要一份明确的约定
上面的图表看起来像是模型“画”出来的,但柱子的形状、颜色、读数和鼠标事件都来自前端已有代码。模型决定展示哪些数据,客户端决定这些数据如何成为一个可用的组件。两者通过组件目录和实例文档衔接,避免把生成内容直接当作应用代码运行。
YAK
2.1 把“会画什么”和“这次画什么”分开
OpenUI 工程团队在对 ChatGPT Intelligent UI 的分析中,讨论了组件目录、流式处理和本地交互等机制。这是一份第三方工程观察,给 Memfit 的参考在于:模型可以组合客户端已有的能力,界面的查看操作也可以独立于模型调用发生。Memfit 采用更轻的纯数据方案,模型输出组件实例,客户端不需要为这些实例执行模型生成的 JavaScript。
参考文章:How ChatGPT’s Intelligent UI works and how to build it(https://www.openui.com/blog/how-chatgpt-intelligent-ui-works)
Catalog 回答的是“客户端会画什么”。其中每一项都有组件名、用途描述和 JSON Schema,说明哪些参数必填、取值是什么类型、允许哪些枚举,以及是否支持子节点。比如,BarChart 接收类别和数值系列,Tabs 接收标签及内容节点引用;模型不需要知道它们内部用了哪个 React 控件。
实例文档回答的则是“这次画什么”。前面的漏洞数量对比,对应一次 render_ui 调用中的以下数据;标题、类别和数值都在其中,颜色和事件处理不由模型指定。
JSON
1 {2 "ui": {3 "id": "module-findings-comparison",4 "catalogVersion": "1.3",5 "fallback": "API 网关 8→12,用户服务 10→8,管理界面 6→4;两轮合计均为 24 个问题。",6 "root": "module-chart",7 "nodes": [8 {9 "id": "module-chart",10 "component": "BarChart",11 "props": {12 "title": "各模块问题数量对比",13 "unit": "个",14 "orientation": "horizontal",15 "categories": [16 { "id": "gateway", "label": "API 网关" },17 { "id": "user-service", "label": "用户服务" },18 { "id": "admin", "label": "管理界面" }19 ],20 "series": [21 { "id": "previous", "label": "首轮检查", "values": [8, 10, 6] },22 { "id": "current", "label": "复测", "values": [12, 8, 4] }23 ]24 }25 }26 ],27 "requiredComponents": ["BarChart"]28 }29 }
这里,component 决定查找哪个组件,props 提供展示数据,root 指向文档入口。如果一条回答需要图表、指标和说明,可以再用 Stack 的 children 引用这些节点,将它们组织为一组。文档和节点的 id 则让前端能够识别后续到达的内容是否属于同一个界面,这对流式更新和状态保留都很重要。
目录由前端维护,入口是 interactive-ui/catalog.mjs,构建脚本再将它导出为 catalog.manifest.json。这份定义同时用于前端校验和后端向模型提供 Schema,组件参数发生变化时,不必再手工修改另一份提示词说明。约定的源头只有一处,生成清单是否过期也可以通过脚本检查。
YAK
2.2 模型结构化响应如何转化为Memfit里展示给用户的UI组件
后端首先需要知道当前客户端支持哪些组件。为此,前端建立会话时,通过 AIStartParams.ClientUI 发送协议版本、能力标识和完整 Catalog;后端的 WithClientUI 接收并检查这些信息。模型随后可用的展示能力,就以这个客户端提供的目录为依据。
当模型调用 render_ui 时,Go 端的处理入口接收实例文档,再交给 Config.RenderUI 完成规范化、诊断和最终事件发布。前端收到流式片段及最终 ui_component 事件后,将文档交给校验器和 ComponentCard.tsx;后者按组件名查注册表,装配为实际 React 组件。完整链路里传递的是组件名称、数据和引用关系,没有模型编写的渲染函数。
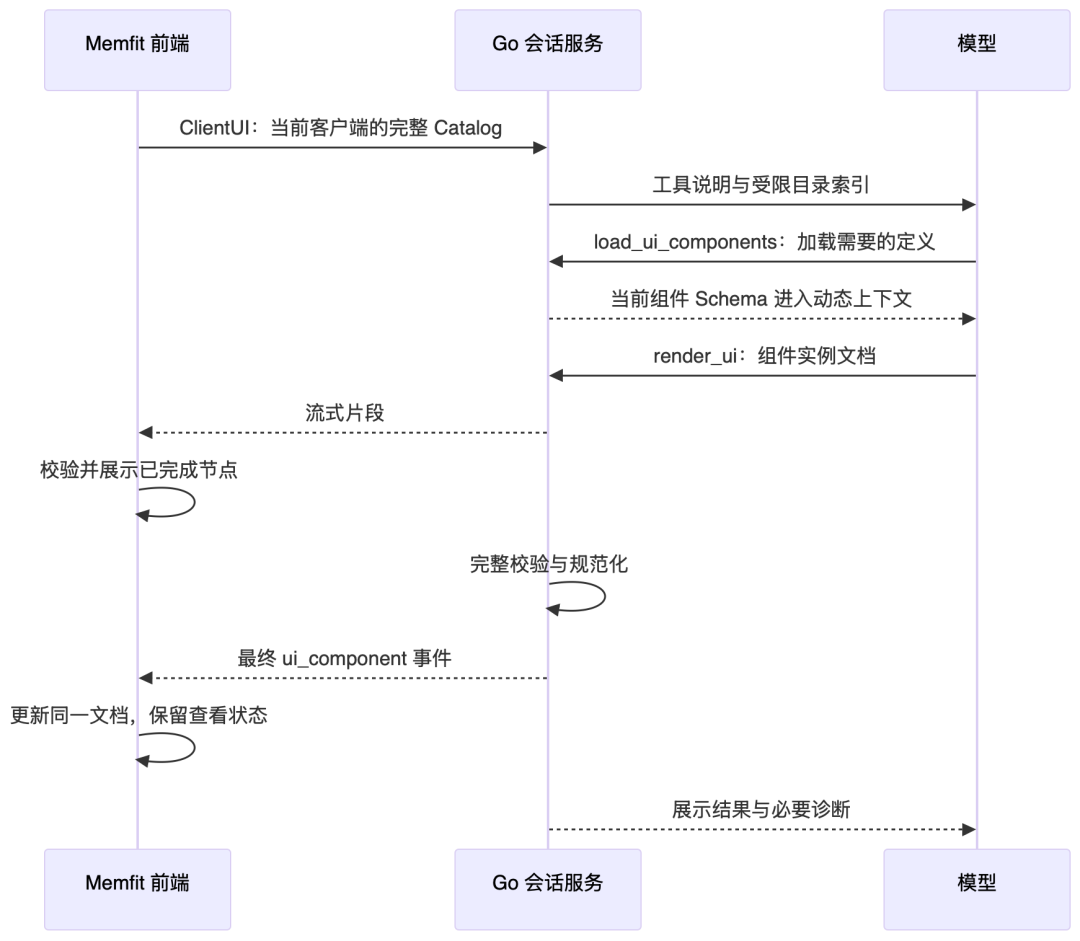
白名单注册表也使界面风格能够沿用项目本身的规范。图表由前端代码绘制,其他组件复用 Yakit 控件、Ant Design 组件和主题变量;模型不负责发明按钮样式或决定深色主题的颜色。如果接收端不支持文档声明的版本或必需组件,则使用 fallback 中的文本,让这份结果仍然可以阅读。
到这里,一份目录已经把模型、后端和前端连接起来。不过,把完整目录交给后端,并不意味着要把它完整塞进每一次模型请求;组件规模增长后,这会很快成为额外的上下文负担。
三、目录可以增长,模型上下文必须有边界
展示组件通常会越来越多:先有表格和图表,随后增加标签页、提示、布局和更多领域视图。如果每个组件的用途、属性、枚举和示例都常驻提示词,用户即使只问一句简单问题,也要携带大量用不到的定义。Memfit 将能力目录的完整性与模型当下需要的信息分开处理。
YAK
3.1 需要画图时,再加载图表定义
模型平时看到的是简短的目录索引。知道需要 BarChart 时,可以直接调用 load_ui_components;不确定有哪些合适组件时,则通过 search_ui_components 搜索名称和用途描述。只有选中的定义进入当前任务的动态上下文,随后供 render_ui 使用。
Plain Text
1 load_ui_components({"names":["BarChart"]})2 ↓3 当前上下文获得 BarChart 的用途、属性 Schema 和文档格式要求4 ↓5 render_ui({"ui": ...})
这一步还解决了定义“加载后放在哪里”的问题。如果工具把完整 Schema 返回后永远留在历史中,随着任务变长,用过的组件仍会越积越多。当前实现由 LoadUIComponents 保存一个可替换的定义批次,工具只返回简短回执;新批次替换旧批次,任务或目录变化后失效,而不是将每次加载的完整定义不断追加到 Timeline。
几个预算限制让这种按需加载有了可检查的边界:
这些预算使用项目的 Qwen BPE tokenizer 计数,约束的是对应内容区域,不是整个模型请求。定义在使用期间仍会占用输入上下文,但不会因为任务曾经用过更多组件而无限累计。对于前面的复测报告,模型只需要加载本次展示用到的图表、表格或容器,其余组件不必随每轮分析一起传递。
四、流式展示,需要同时照顾内容和用户操作
一份完整 JSON 的渲染并不复杂,真正麻烦的是它还没生成完时。模型可能刚写到数组中间,父节点引用的内容也可能还没到达;而用户已经开始查看先出现的图表,甚至切换了图例。前端需要判断什么内容现在可以显示,并在后续更新时保留这些操作。
YAK
4.1 不完整的文档里,也可能有完整的组件
普通 JSON.parse 会拒绝尚未闭合的对象和字符串。Memfit 的 partialJson.ts 改为解析合法的 JSON 前缀,同时记录哪些结构已经完整结束。这样,前端不必等整份文档生成完,才能知道里面已经包含了什么。
渲染时仍然要设一道门槛:当前实现以完整组件节点为粒度。假设回答包含一个 Stack、一个 BarChart 和一段 Text,图表节点已经结束、说明节点仍在生成,只要图表可以从根节点到达,它就可以先显示。反过来,BarChart 自己的系列数组尚未结束时,前端会继续等待,不会把未完成的数值关系当成最终数据。
引用关系也按这个思路处理。流式过程中找不到一个子节点,可能只是它还没传完,不立即判错;完整文档结束后仍然缺失,才产生诊断。最后到达的 ui_component 事件更新同一份文档,避免流式图表与最终图表在消息中重复出现。
YAK
4.2 数据继续到达,不应破坏先前渲染出的组件
假设用户在数据表中筛选了 API 网关,模型此时又补完了图表后的说明。如果前端把整块内容销毁再重建,筛选就会丢失,用户不得不重新操作。稳定的文档 ID、节点 ID 和数据标识,就是为了让前端认出哪些内容正在更新,哪些仍是用户刚才操作的那个组件。
ComponentCard.tsx 将表格排序与筛选、图表系列开关、标签页选择等查看状态保存在前端,并通过会话引擎保存相应 uiState。后续解析得到新文档时,仍按节点身份连接这些状态;Tabs 也不会因为另一页内容到达,就自动切走用户正在看的页面。模型提供的是数据,用户选择的是当前查看方式,两者各自更新。
这也解释了为什么点一下图例不需要等待模型。排序、筛选、分页和切页均为本地操作,不会发送新的用户消息;模型也不会自动知道用户当前筛选了什么。如果用户希望模型进一步分析筛选出的 API 网关问题,需要显式发送新的要求,或者回答模型提出的问题。
这一边界直接影响交互成本和可理解性。查看数据可以快速、反复进行,而改变任务要求会以一条明确的输入进入会话。接下来的主动追问,负责的就是后一种情况。
五、需要用户参与时,让问题进入统一的 ask 渠道
安全报告中的数据可以直接展示,但报告面向谁、重点看证据还是修复、输出要多详细,往往需要用户补充。如果把这些问题也放进任意展示卡片,权限、等待和提交状态就会散落在不同组件里。Memfit 将它们集中到输入栏上方的追问浮层,并让后端统一管理请求与回答。当用户开启允许追问选项后,模型可能在执行过程中主动询问用户问题。
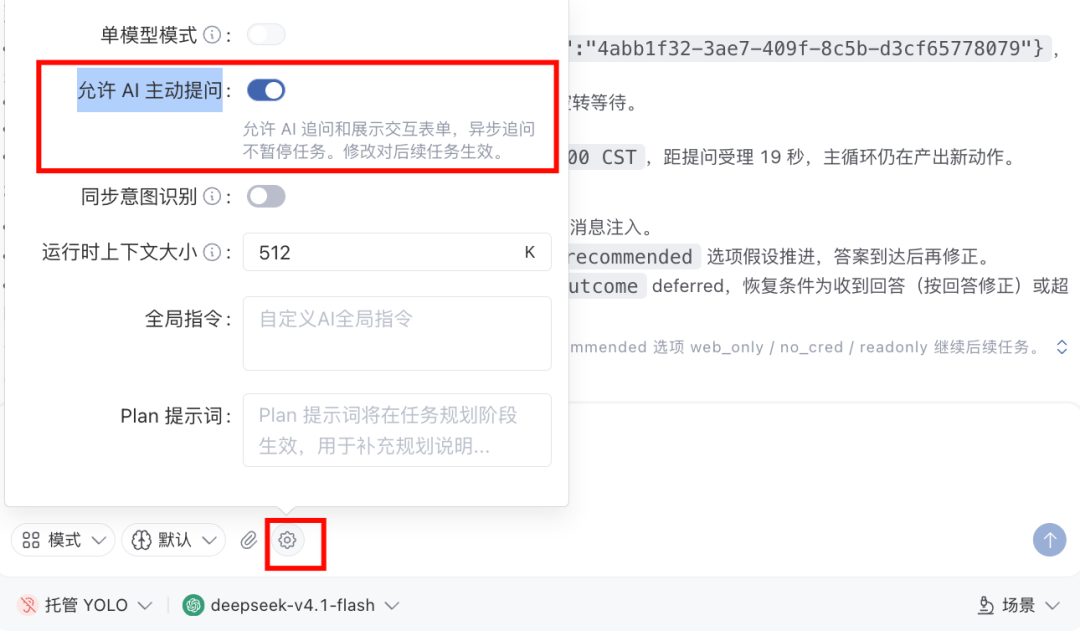
同时开启“允许 AI 主动提问”和 Goal 模式时,系统仅提供异步追问,避免等待回答阻塞任务执行。
YAK
5.1 询问用户,不必让整项分析停下来
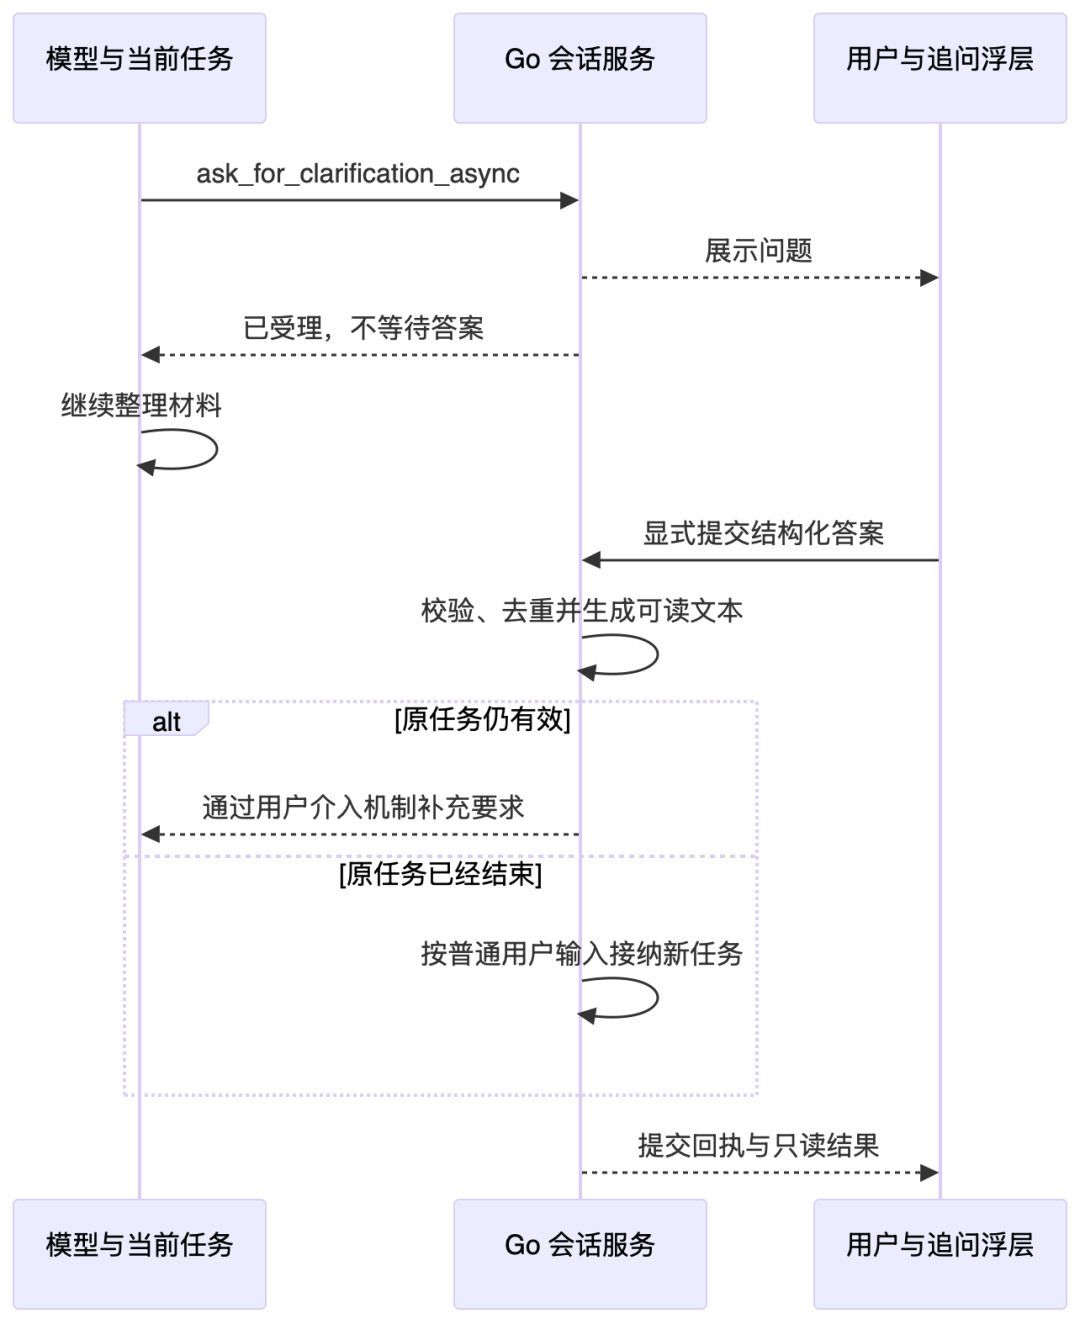
仍以复测报告为例,模型可以先询问报告面向开发者还是管理者,然后继续读取材料、比较数量和整理已有证据。受众会影响最后的表达方式,却不妨碍这些工作先进行。ask_for_clarification_async 就用于这种场景:请求发出后立即返回已受理,答案在用户提交时再送达。
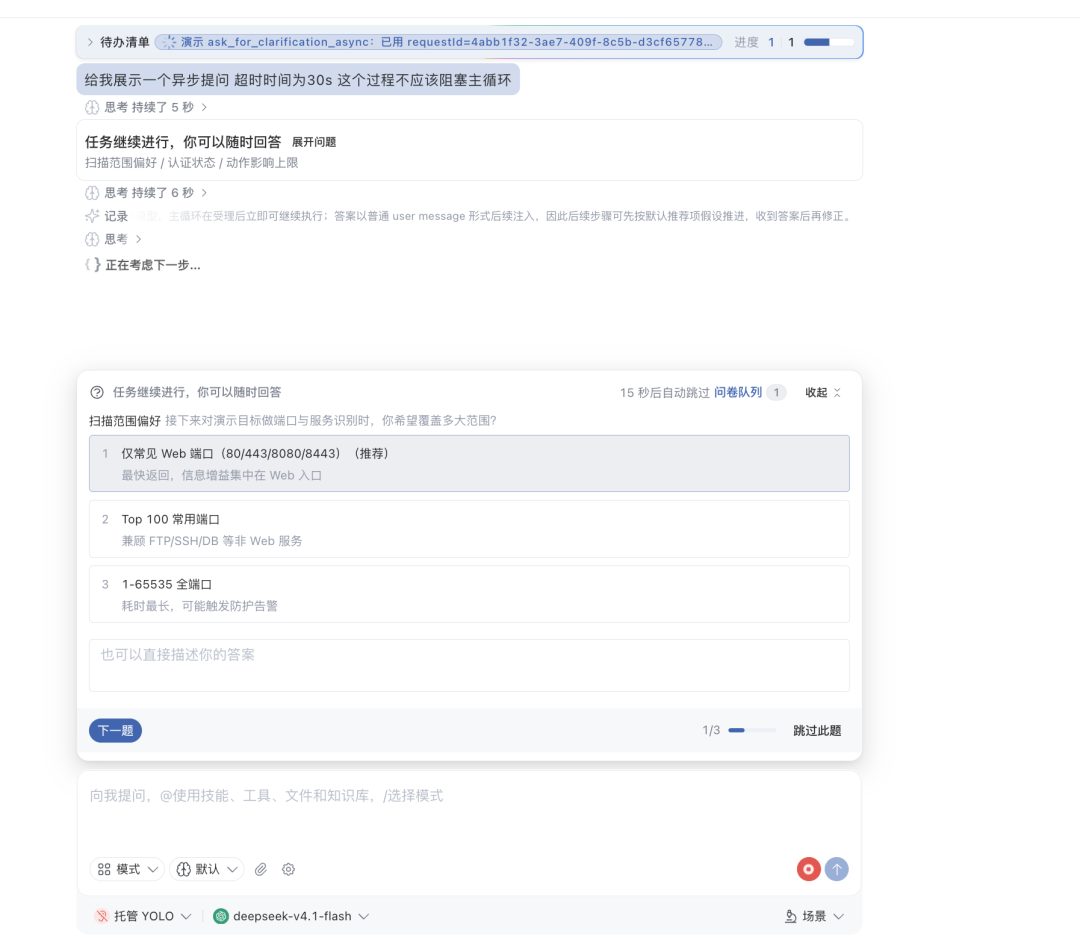
在当前模式允许阻塞追问的前提下,如果缺少的信息决定了下一步操作,且已经没有可以独立推进的工作,才使用阻塞式的 ask_for_clarification。两种工具在前端使用同一个浮层,区别是当前任务是否等待。异步工具的说明也明确告知模型“不会等待答案”,否则即使后端立即返回,模型仍可能误以为自己应该停下来或重复追问。
浮层既能展示一至三道单选、多选问题,也能展示受限 JSON Schema 描述的参数表单。前者适合受众、关注重点等选择,后者适合集中填写字段明确的参数;每题是否允许自由文本由 allowFreeText 决定。用户看到的始终是同一个回答入口,而不是一会儿在历史消息里找表单,一会儿又回到输入栏。
异步追问还有一个影响体验的细节:用户一旦开始点击、按键或输入,倒计时就永久取消。收起或按 Esc 会保留草稿,到期的问题也允许稍后补答;推荐选项不会替用户自动提交。回答成功后,面板转为只读结果,后端则用请求状态和提交 ID 防止连点或网络重试造成重复输入。
YAK
5.2 用户回答如何回传到模型上下文
用户提交回答后,前端会将请求 ID、提交 ID,以及所选答案或表单值发送给后端。AcceptQuestionAnswer 根据服务端保存的原始问题或表单定义校验答案,检查请求归属与提交状态,并处理重复提交。校验通过后,后端将问题和答案整理为可读的问答文本,例如“报告受众:开发者”“内容重点:修复建议”。
这些文本随后接入普通用户输入链路:原任务上下文仍有效时,追加到输入历史和 Timeline,供模型在后续执行中理解和使用;原上下文已失效时,则作为新的用户输入入队。这样,用户在界面中的选择就成为了可以参与后续分析的明确输入。
提问权限同样由后端控制。用户在前端 UI 中关闭“允许 AI 主动提问”后,ask 工具与相应说明不再向模型暴露,执行入口也会再次检查;规划阶段受 AllowPlanUserInteract 和次数限制约束。子智能体(Subagent)和负责执行子任务的 worker 不直接向用户发起追问。缺少必要信息时,应说明当前阻碍和需要补充的内容,由主任务统一判断是否需要向用户澄清,避免多个执行单元分别等待用户回答。
从检查结果对比、长程测试复盘,到流量梳理和日志分析,结构化 UI 让 Memfit 在给出结论的同时,也提供了检查结论所依据的数据的方式。用户可以在回答中筛选明细、比较差异、查看趋势,定位值得进一步复核的对象;需要调整分析方向或补充条件时,用户可以直接发送新的要求,也可以通过追问入口回答模型的问题。文字解释、数据查看与后续分析由此衔接起来,减少了反复翻阅历史消息和搬运数据的操作。
支撑这些体验的是明确的职责划分:模型根据任务组织数据,客户端按照组件契约完成渲染,后端负责能力传递与交互管理。按需加载控制上下文开销,流式展示与状态保留保证查看过程连贯。后续组件的扩展也将围绕实际分析需求展开,让用户更容易发现变化、核对证据,并据此决定下一步该做什么。
END
Memfit:是万径安全旗下Yaklang团队研发的面向长程渗透测试、漏洞挖掘、应急响应等全链路攻防任务的生产级安全领域Agent系统
Yakit:是万径安全旗下Yaklang 团队开源的一款完全国产的交互式安全测试平台
YAK官方资源
Yakit官网下载地址:
https://yaklang.com/
Github地址:
https://github.com/yaklang/yakit
Yakit 视频教程:
https://space.bilibili.com/437503777
Memfit下载地址:
https://memfit.ai/
IRify下载地址:
https://ssa.to/
YTray下载地址:
https://yaklang.io/ytray/
本文转载自微信公众号「Yak Project」,查看原文。版权归原作者所有,如有侵权请联系删除。