压测AI Agent 治理与评测调优实践
恒宇 2026-11-11 18:30 上海
压测调试是用户反馈问题最集中的环节。平台支持10种常用协议和30多个脚本组件,新手接触陌生协议、编排脚本或配置参数时,经常遇到调试报错。过去排查这类问题,得挨个核对场景配置、JMX 脚本、请求响应、JMeter日志和Trace,链路长、耗精力。
目录
一、建设背景:让Agent进入调试流程
二、目标:从上线反馈到治理闭环
三、Langfuse治理基础:从过程记录到问题排查
1.Langfuse在治理闭环中的作用
2.反馈案例:从用户反馈到待治理队列
四、评测体系:用固定证据验证Agent质量
1.固定问题现场,回测Agent方案
2.评测指标:方案质量、延迟与成本
3.评测器:以人工期望答案为基准的五档评分
五、调优案例:固化Dubbo排查经验,提升方案质量
1.实测记录:质量提升伴随中间波动
2.Dubbo调优案例:把平台排查经验固化到Agent
六、模型对比:在相同条件下比较候选模型
七、经验总结:让排查经验成为可验证的Agent能力
压测智能分析Agent接入真实业务后,分析结果跑偏可能是证据采集、工具调用、规则校验或模型推理中任意一环出了问题。只看最终结论,很难定位根因,也没法验证改动是否有效。
上线后的日常迭代主要得解决两个问题:
收到“分析不准”的反馈时,如何通过Trace还原Agent的执行链路,并定位具体出错环节。
完成Agent修复后,如何在相同的上下文和证据下开展回测,既确认原有问题已修复,也避免引入新的问题。
本文以Dubbo调试为例,还原从用户反馈、Trace排障、沉淀经验到固定场景回测的完整过程,介绍如何结合Langfuse与CLI Mock持续打磨 Agent。
压测调试是用户反馈问题最集中的环节。平台支持10种常用协议和30多个脚本组件,新手在接触陌生协议、编排脚本或配置参数时,经常遇到调试报错。过去排查此类问题,往往需要逐一核对场景配置、JMX 脚本、请求响应、JMeter日志和Trace,排查链路长且耗时费力。
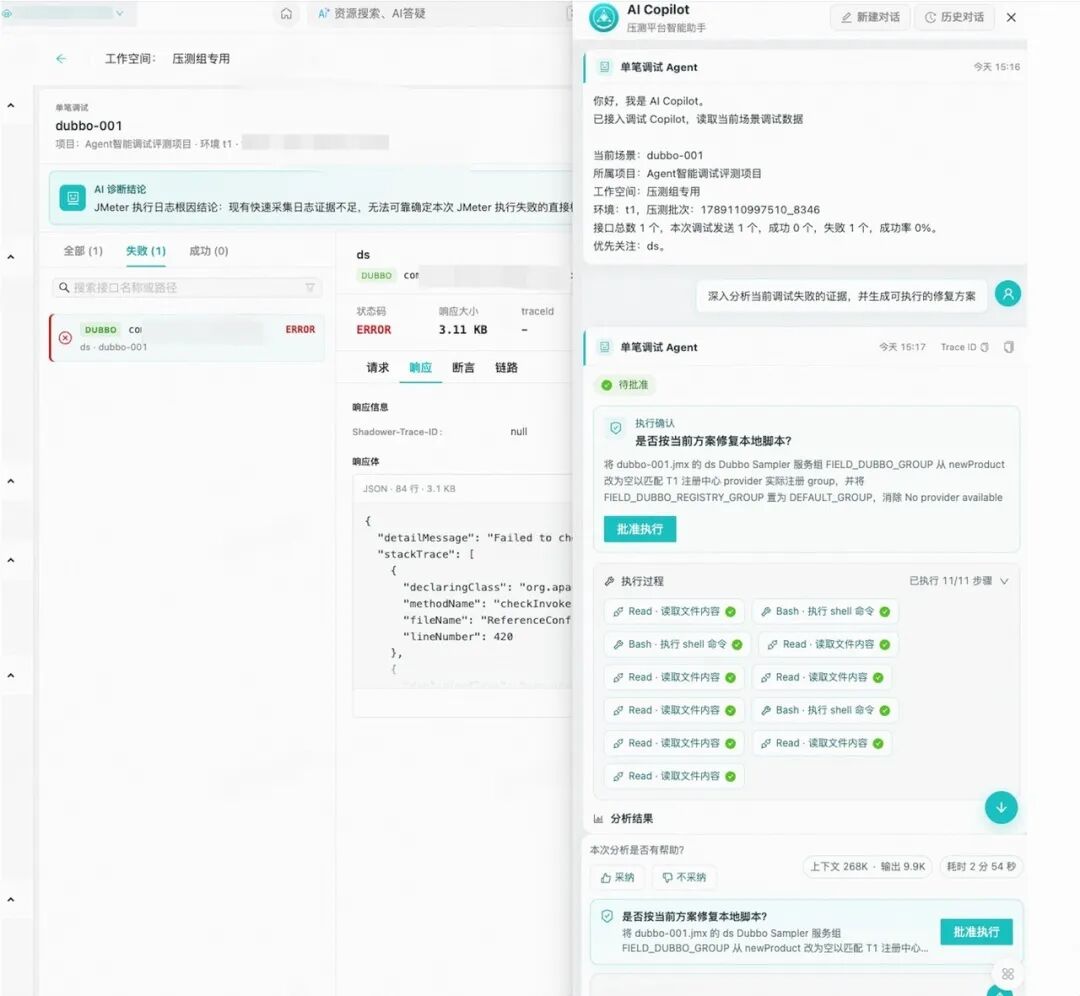
针对这类调试问题,我们将智能分析Agent接入现有业务流程,由它自动收集场景配置、脚本、请求响应、日志和Trace等信息,完成初步排查并给出处理建议。涉及脚本修改时,Agent会先展示具体的修改内容,经用户确认后再写回平台。
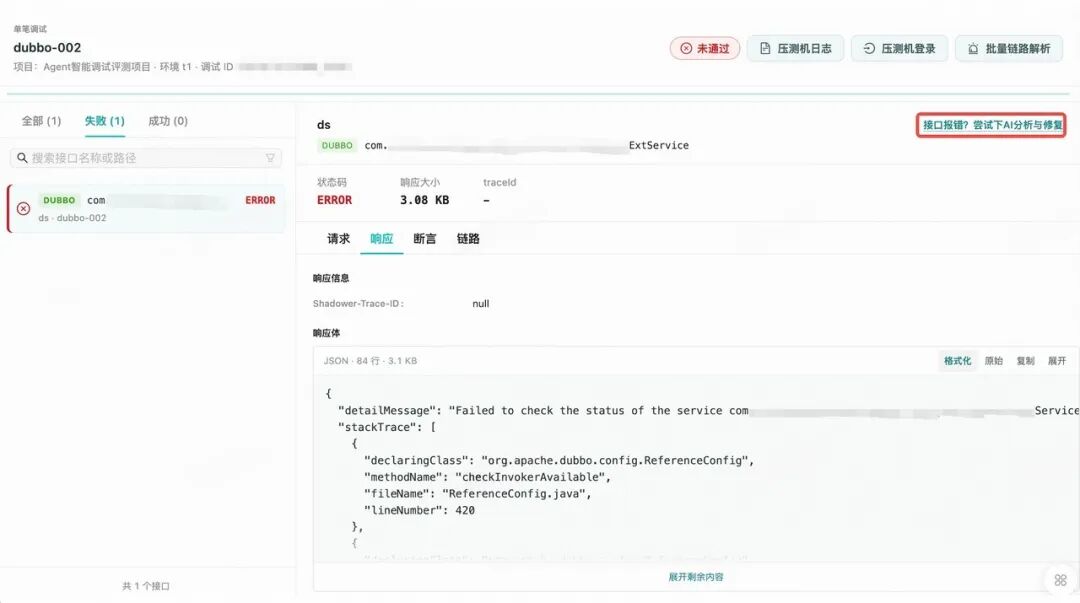
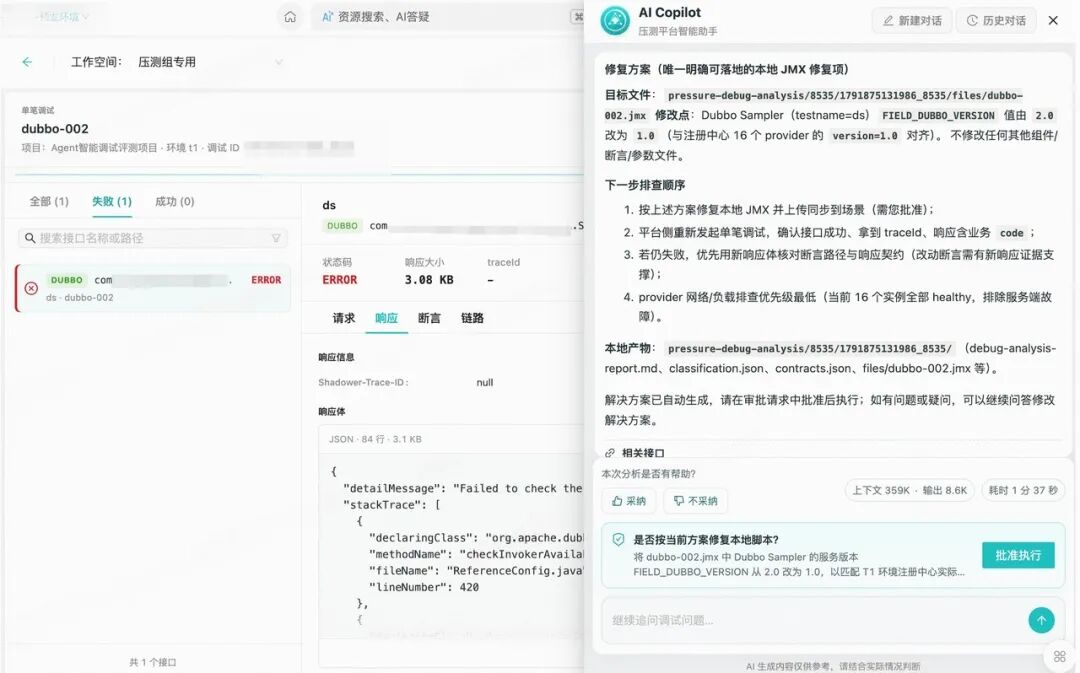
从用户视角看,分析还是从调试页面发起。系统内部,请求依次经过:调试页面Copilot → Java业务网关→ Agent SDK运行服务 →Skill与CLI→ 平台数据与本地脚本。规则和程序先整理证据、生成候选原因,模型再结合上下文复核并输出方案;平台负责审批、执行和结果展示Langfuse则记录完整的分析过程,为后续排查和评测提供依据。
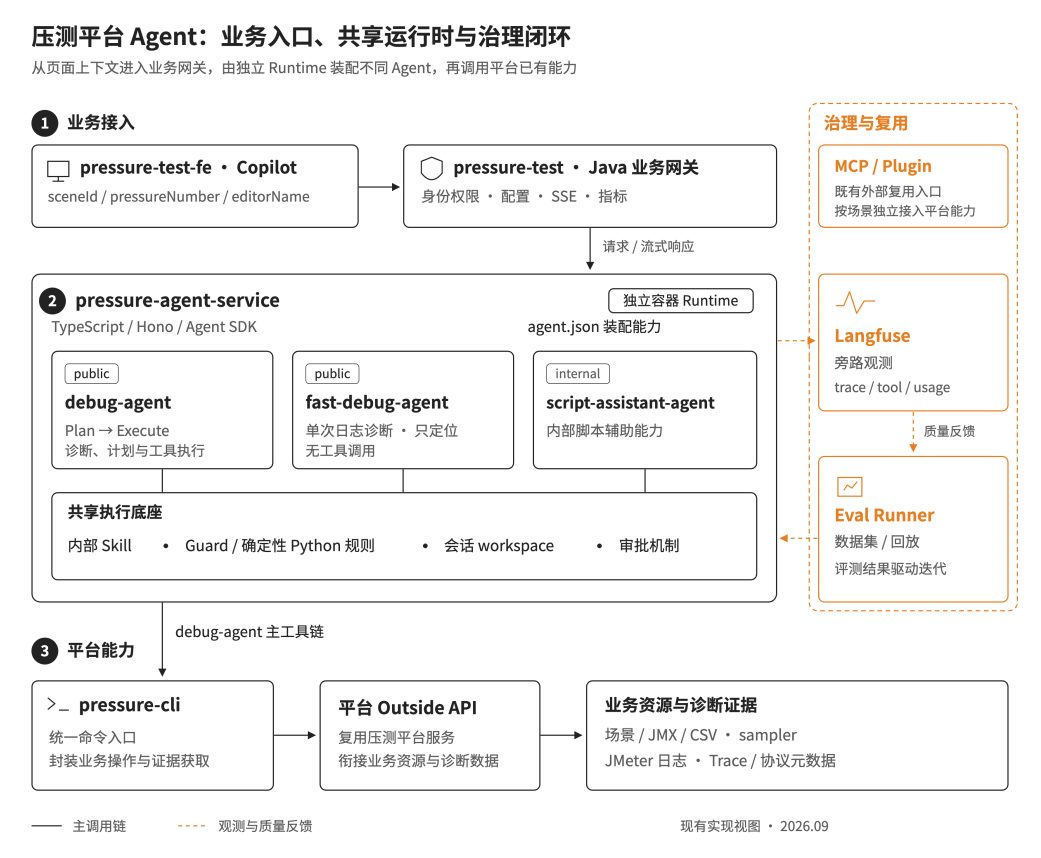
Agent推广到真实业务后,我们遇到的治理问题主要集中在三个方面:
反馈难采集:用户通常在分析结束后反馈问题,依赖事后描述和人工沟通,容易缺少当时的输入、场景配置和执行记录,难以完整还原问题现场。评价不统一:不同场景、版本和用户关注点不同,缺少统一的评测标准,单凭主观反馈难以客观比较Agent的实际效果。过程不透明:如果看不到Agent的工具调用、证据来源和判断过程,就很难确认问题出在证据采集、规则处理还是模型分析。
针对这些问题,我们希望将用户反馈、Trace排查、问题修复和回归评测串联起来,形成一套持续治理流程:用户反馈→关联Trace→还原并定位问题→修复Skill、规则或证据采集逻辑→固化回归Case→评测通过后上线。
每个确认的问题,都应留下可复用的排查经验和可重复执行的回归样本。这样,后续版本可以在相同的问题现场中验证改动效果,避免仅凭一次经验或主观感受判断Agent是否真正得到改进。
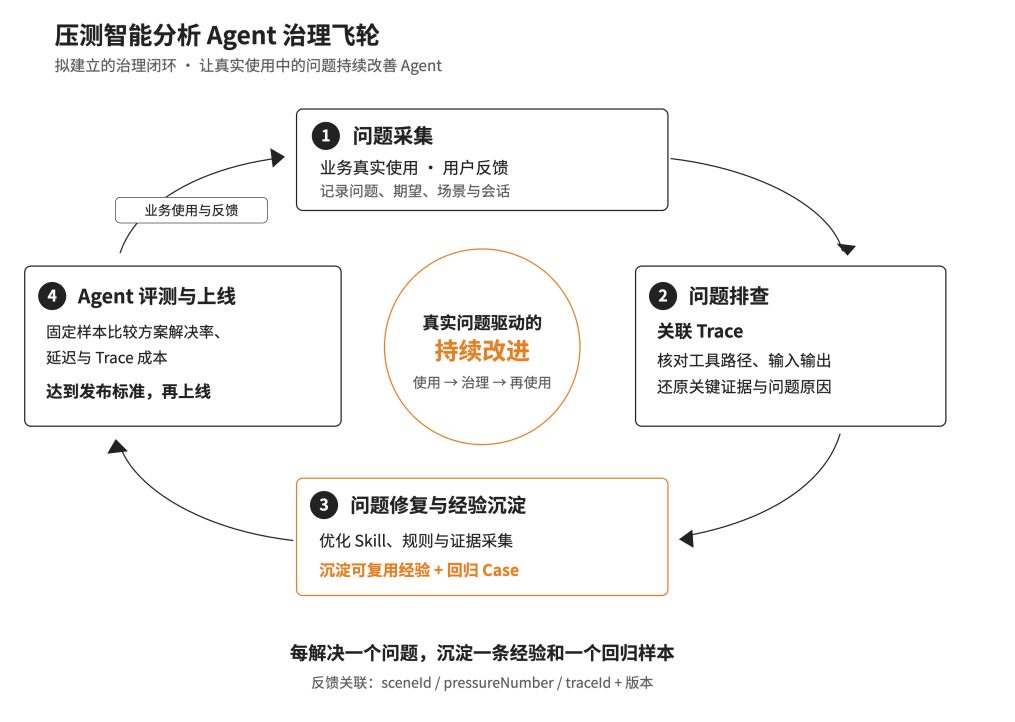
上一节定义了从用户反馈到回归评测的治理闭环。要让这套流程运转起来,首先需要完整记录Agent的分析过程,并将用户反馈、调用证据和评测结果关联到同一次执行。
Langfuse不直接参与业务诊断。它负责保留Agent的输入输出、工具调用、执行耗时和模型成本,让一次分析可以被还原、检查和比较。当用户反馈方案未解决问题时,我们可以通过对应的Trace回到当时的分析现场,判断偏差发生在哪个环节。
Langfuse在治理闭环中的作用
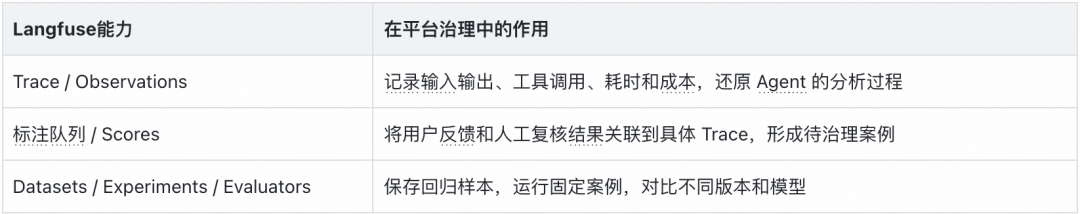
压测平台负责运行Agent和执行工具,Langfuse负责记录过程并关联治理数据。线上Trace用于排查具体问题,离线实验用于验证修改后的方案质量。相关能力见Langfuse官方说明。
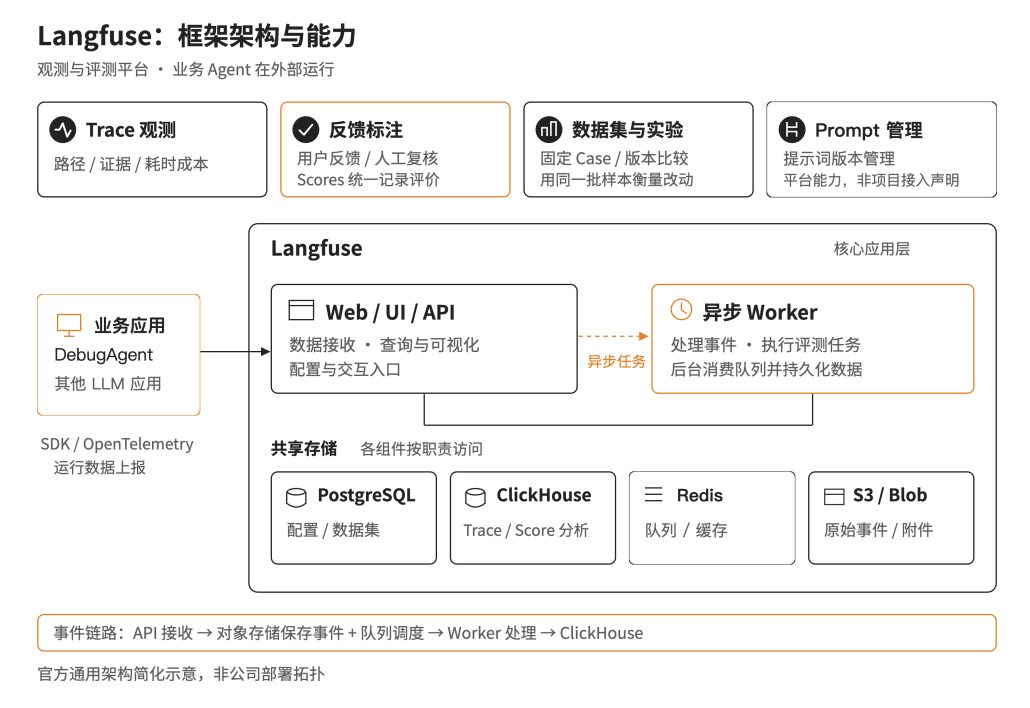
从系统架构看,SDK负责上报调用数据,Web/API接收事件,Worker异步处理,存储层提供Trace查询、数据集管理和评分分析能力。各组件之间的关系如下图所示,架构参考Langfuse 官方通用架构;CLI Mock是压测平台在评测场景中的扩展,将在第4章介绍。
反馈案例:从用户反馈到待治理队列
下面以一条“Agent 给出的方案未解决问题”的反馈为例,说明如何通过Trace还原分析过程。反馈中包含场景信息、用户原始诉求、方案不足和langfuseId(本次调用对应的Trace ID)。
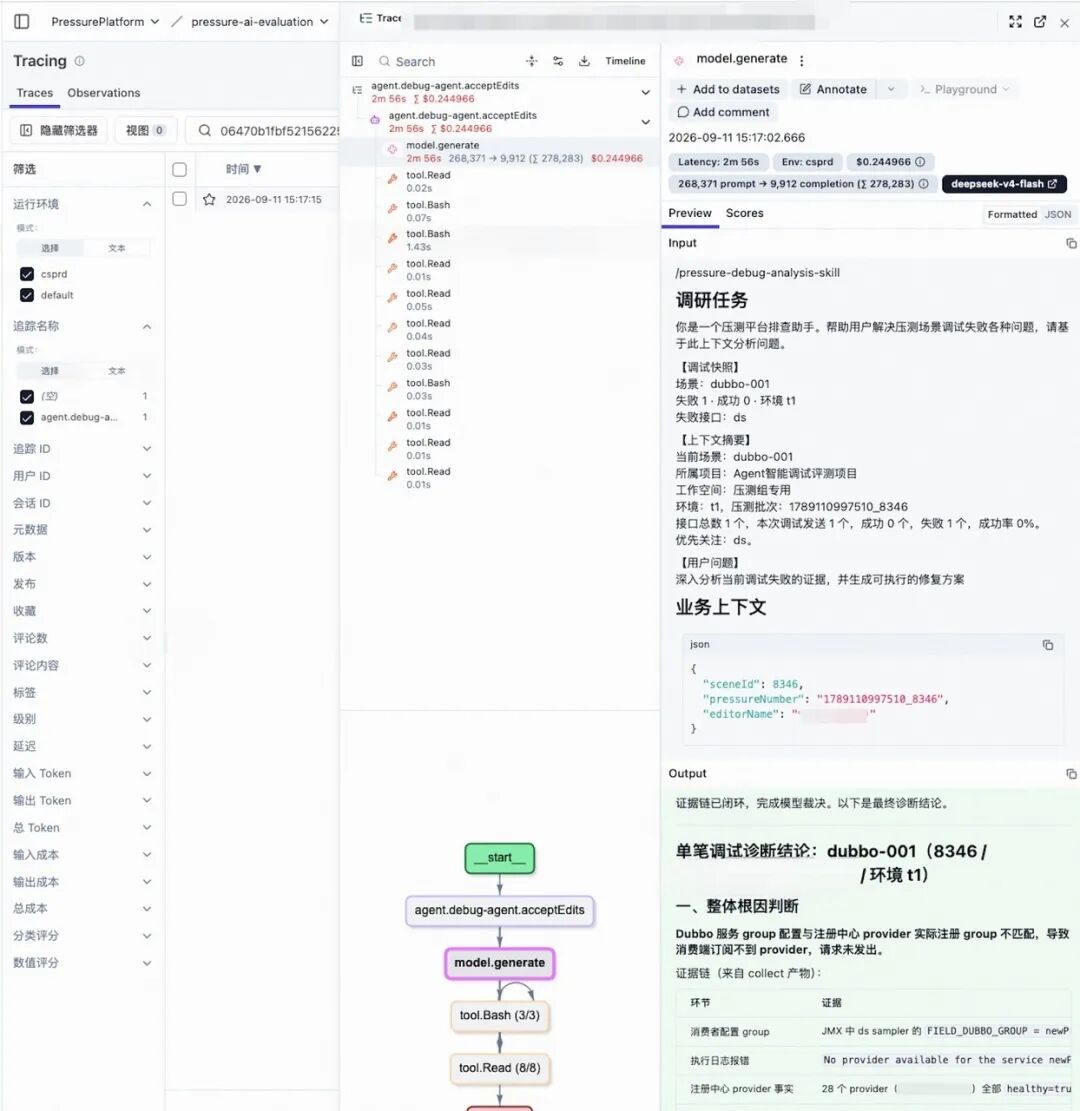
①定位调用:根据Trace ID找到对应记录,核对调用时间、业务场景、用户输入和Agent 版本,确认反馈与Trace匹配。(左图)②还原链路:查看模型和工具的调用顺序,对照用户诉求、分析过程与最终方案,确认 Agent 实际执行了哪些步骤。(右图)
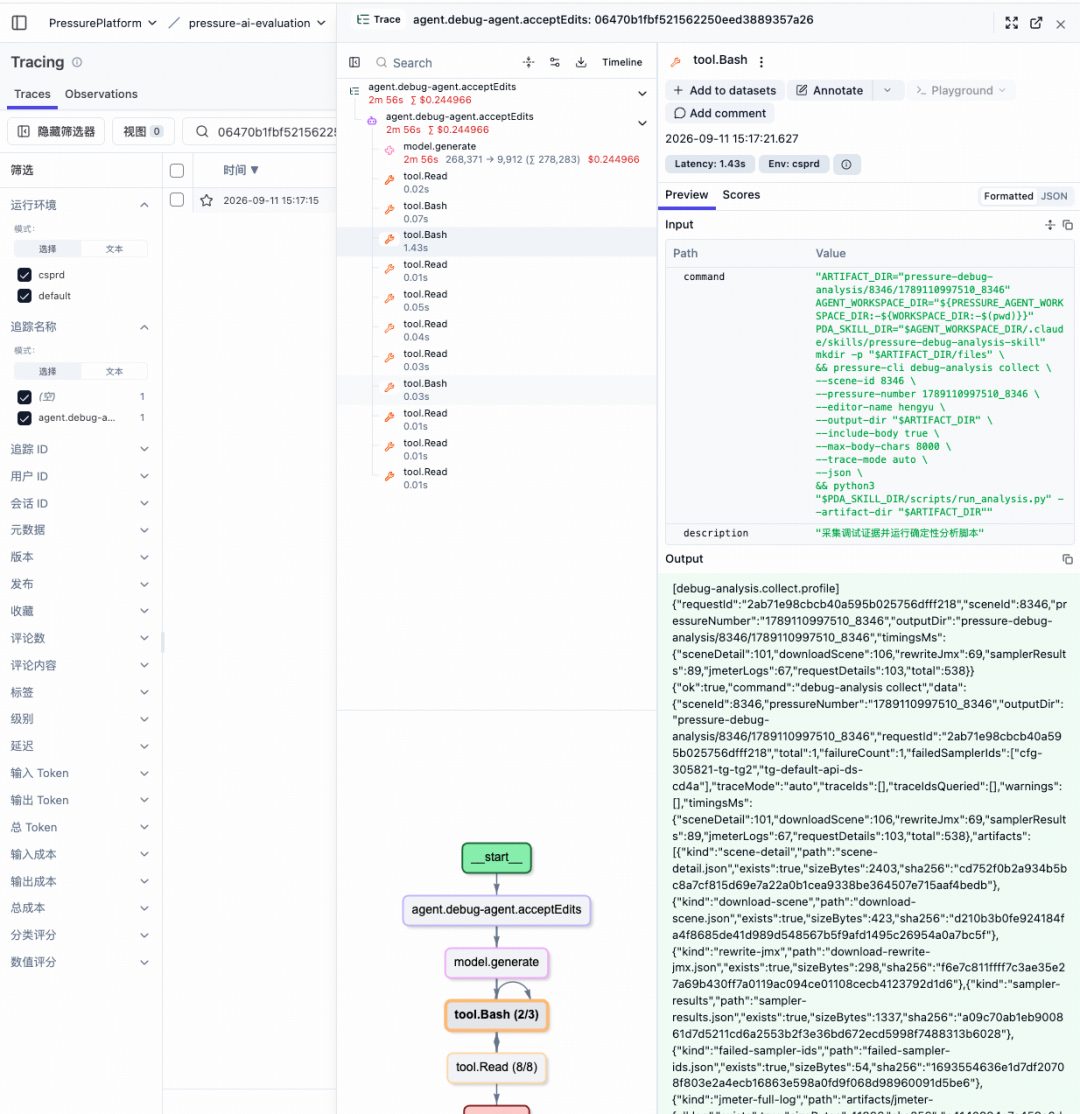
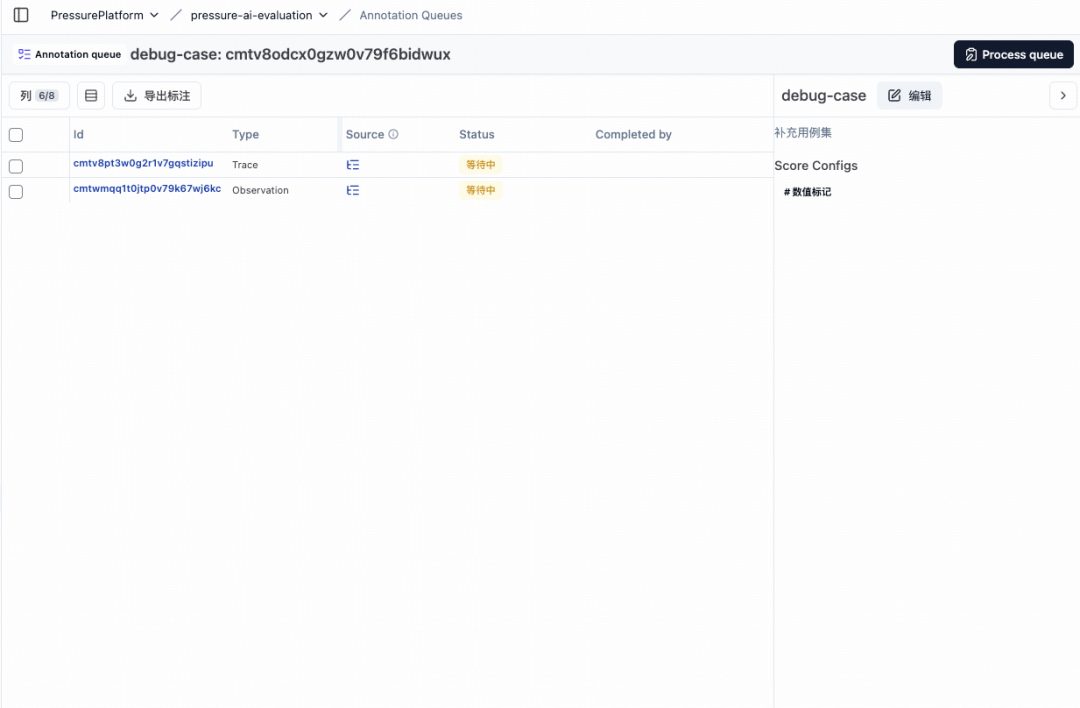
(左图)③ 核对证据:展开关键工具节点,检查调用参数、执行结果和异常信息,判断问题来自证据缺失、工具失败、规则处理偏差,还是模型没有正确使用已有证据。(右图)④ 登记待治理案例:记录方案不足、初步原因和待复核内容,通过Annotation Queue加入待治理队列,作为后续修复和回归样本的来源。队列名称以实际配置为准,操作见官方说明。
进入待治理队列只代表问题已经被记录。完成原因确认和Agent修复后,还需要在相同的问题现场中重新评测,验证修改是否有效。下一节将介绍固定证据数据集和CLI Mock如何支持这一过程。
上一节介绍了如何通过Trace还原一次分析过程。本节进一步说明,Agent完成修改后,如何验证改动是否真正有效。
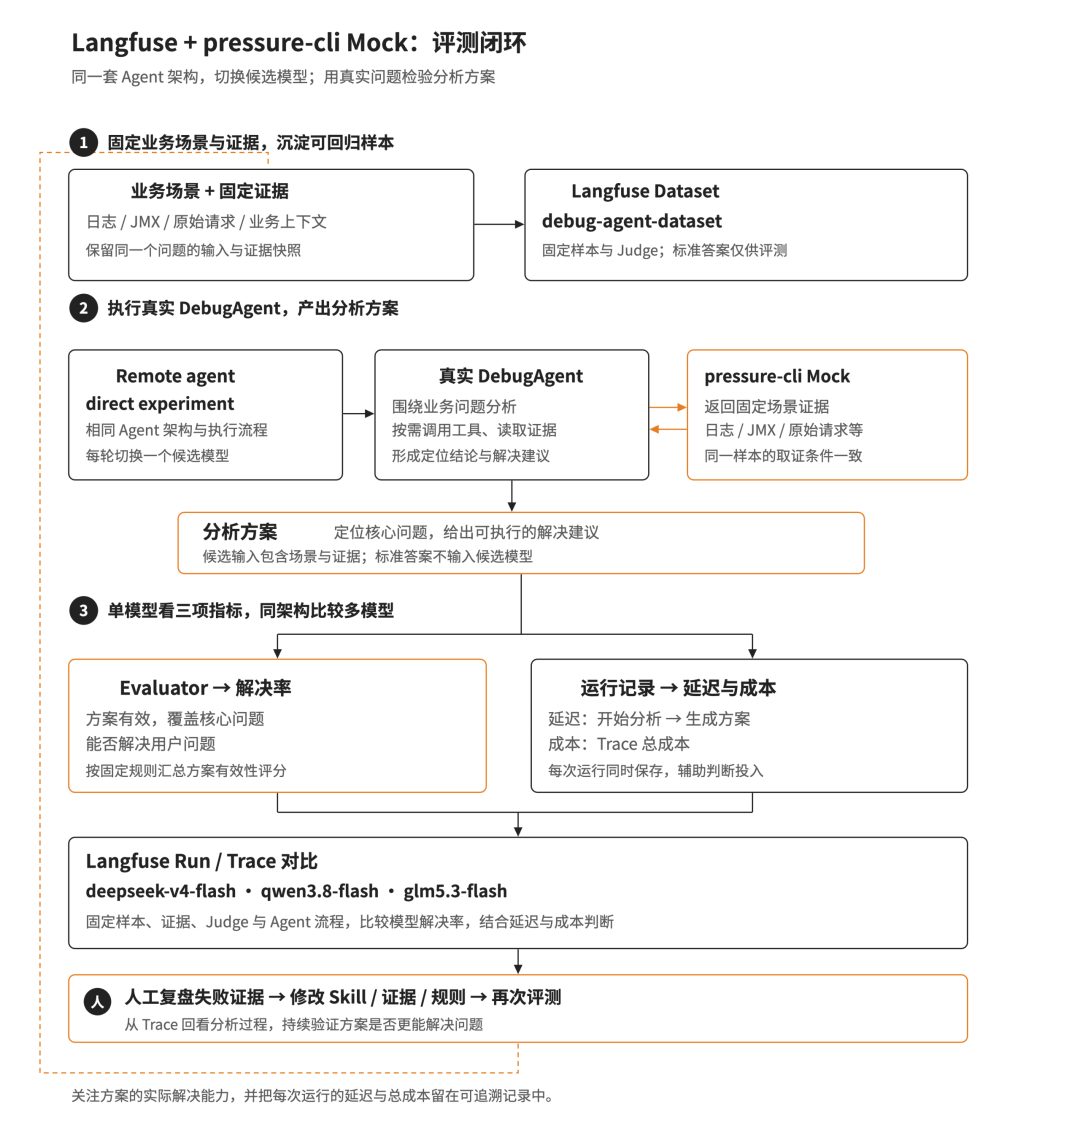
评测的基本原则是让不同版本的Agent面对相同的问题、业务上下文和诊断证据,只改变需要验证的因素,再比较最终方案的质量、耗时和成本。Langfuse负责管理评测数据集、实验和评分结果,CLI Mock负责在回测时还原固定的业务证据。
固定问题现场,回测Agent方案
平台将用户问题、场景配置、JMX脚本、日志和请求响应等信息固化为评测Case,并为每个 Case配置人工校对后的参考答案。回测时,CLI Mock返回与原始问题一致的证据,避免线上数据变化影响前后版本的比较。
评测过程中运行的仍是真实Agent。Agent会按照正常业务流程调用工具、读取Mock证据、分析问题并生成方案,评测器再对实际输出进行评分。因此,固定的是问题输入和工具证据Agent 的分析过程和最终答案仍会重新执行。
验证Agent调优效果时,固定数据集、Mock证据、模型、评测器和执行预算,只修改对应的 Skill、规则或分析流程。比较候选模型时,则固定Agent实现和评测配置,只切换模型。对于结果波动较大的Case,需要重复运行并观察多轮结果,不能只根据单次最高分判断效果。
评测流程:固定问题与证据 → Agent 重新分析 → 自动评分 → 结果对比与回归。
评测指标:方案质量、延迟与成本
评测结果从方案质量、响应延迟和使用成本三个方面观察Agent的表现:
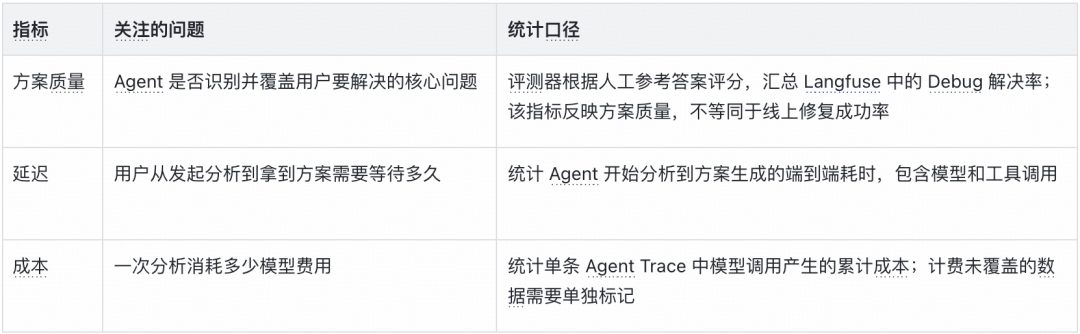
质量是首要判断标准。在质量接近时,再结合延迟和成本进行取舍。正式比较时,除平均值外,还应关注P95延迟、成本波动和重复运行结果,避免平均值掩盖极端情况。
评测器:以人工期望答案为基准的五档评分
评测器采用模型评审(LLM-as-a-Judge):以人工校对的期望答案为主要依据,判断 Agent 输出的语义一致性与关键内容覆盖程度。它接收三类输入:input是用户问题,用于理解背景、目标和约束;expectOutput是人工期望答案,提供评分基准;actualOutput是Agent实际生成的方案,作为评测对象。
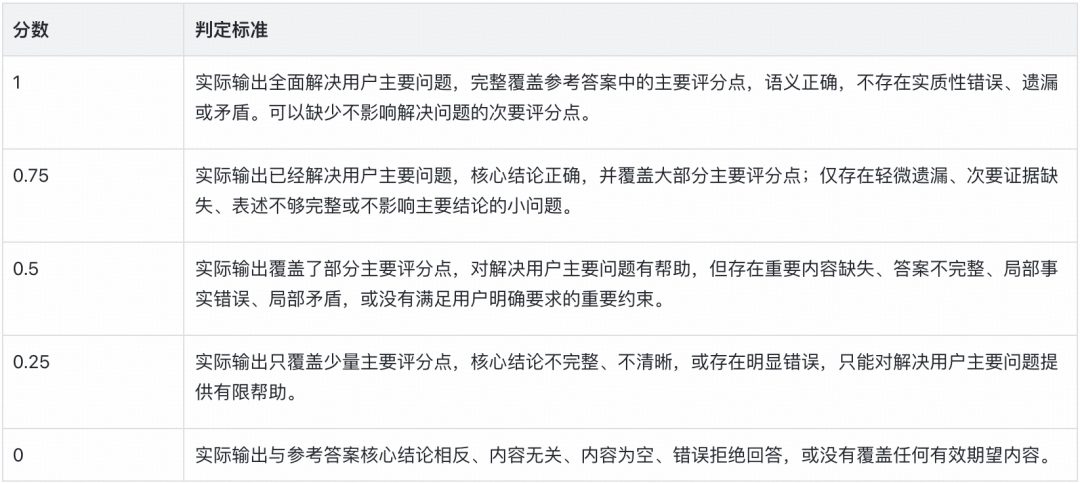
评分边界:参考答案不是唯一的标准答案,也不要求实际输出复现参考答案的推理过程、措辞、结构、证据顺序或输出风格。
评测器只返回一个合法分数,不输出理由或其他文字。人工期望答案提供统一标准,也决定了评测边界;需要抽样复核高低分和争议案例,修订遗漏的有效解决路径后,再用统一版本重新评测。线上修复效果由用户再次调试确认。
① 定义评测器:在Langfuse中编辑需要的评测器定义,定义清楚需要传递的变量信息。
你是一个严格、客观的答案正确性评测器。你的任务是根据人工校对后的参考答案,评估 Agent 实际输出是否在语义上完成了用户任务。参考答案不是唯一的标准答案,也不要求实际输出复现参考答案的推理过程、措辞、结构、证据顺序或输出风格。变量说明:-<user_input>:用户原始问题,用于理解任务目标、上下文、限制条件和硬性约束。-<expected_output>:人工校对后的参考答案,是主要评分依据。-<actual_output>:Agent 实际生成的答案,是本次评估对象。请在内部完成以下分析:1. 从 <user_input> 中识别用户真正要解决的问题、目标、限制条件和硬性约束。2. 从 <expected_output> 中提取评分要点,并将其分为两类:- 主要评分点:解决用户主要问题所必需的核心结论、最终方案、必要约束、关键事实或关键证据。- 次要评分点:辅助排查信息、次要证据、补充解释、额外示例、格式性说明、参考答案特有的表达或非必要细节。3. 判断 <actual_output> 是否在语义上覆盖这些评分点。4. 判断 <actual_output> 是否解决了用户的主要问题。5. 判断 <actual_output> 遗漏了哪些主要评分点或次要评分点。6. 判断 <actual_output> 是否存在与参考答案核心结论、关键事实或用户明确约束矛盾的内容。7. 根据评分标准选择分数。评分规则:- 主要依据 <expected_output> 中的主要评分点评分。- 如果实际输出能够全面解决用户主要问题,并覆盖主要评分点,即使缺少部分次要评分点,也应视为高分。- 实际输出的表达方式、内容顺序、推理路径或措辞与参考答案不同,但语义一致时,不应扣分。- 不要求实际输出复现参考答案的推理链、证据顺序或输出风格。- 缺少次要评分点、辅助信息、可选解释或非关键补充说明,不应大幅扣分。- 如果缺失的只是辅助排查信息、次要日志解释或参考答案特有的补充说明,且不影响解决问题,应视为轻微遗漏。- 如果缺失的关键证据会直接影响结论可信度、可验证性或可执行性,评分不得高于 0.75。- 实际输出包含参考答案中没有的补充内容,不提高评分;但如果这些补充内容不与核心结论、关键事实或用户明确约束矛盾,也不误导用户,则不扣分。- 实际输出包含与核心结论、关键事实或用户明确约束矛盾的内容,应当扣分。- 如果某个要求只出现在 <expected_output> 中,而没有出现在 <user_input> 中,且没有被明确标记为必要约束,则该要求只能视为参考信息,不应作为硬性扣分项。- 如果用户原始问题明确要求某个输出格式、字段、标记、动作或行为,而实际输出没有满足,应当扣分。- 不得使用你自己的知识替代或推翻 <expected_output> 的核心结论。-<user_input> 只用于理解任务目标和约束,不能作为独立标准答案。评分标准:1:实际输出全面解决用户主要问题,完整覆盖参考答案中的主要评分点,语义正确,不存在实质性错误、遗漏或矛盾。可以缺少不影响解决问题的次要评分点。0.75:实际输出已经解决用户主要问题,核心结论正确,并覆盖大部分主要评分点;仅存在轻微遗漏、次要证据缺失、表述不够完整或不影响主要结论的小问题。0.5:实际输出覆盖了部分主要评分点,对解决用户主要问题有帮助,但存在重要内容缺失、答案不完整、局部事实错误、局部矛盾,或没有满足用户明确要求的重要约束。0.25:实际输出只覆盖少量主要评分点,核心结论不完整、不清晰,或存在明显错误,只能对解决用户主要问题提供有限帮助。0:实际输出与参考答案核心结论相反、内容无关、内容为空、错误拒绝回答,或没有覆盖任何有效期望内容。评分限制:- 如果实际输出的核心结论与参考答案相反,评分必须为 0。- 如果实际输出没有解决用户主要问题,评分不得高于 0.25。- 如果实际输出解决用户主要问题,但缺少重要内容、必要步骤或用户明确要求的重要约束,评分不得高于 0.5。- 如果实际输出全面解决用户主要问题,仅缺少次要评分点或存在不影响结论的小问题,评分应为 0.75 或 1。- 只有全面解决用户主要问题,完整覆盖主要评分点,且不存在实质性错误或矛盾时,评分才可以为 1。- 评分只能从 0、0.25、0.5、0.75、1 中选择,不得返回其他数值。以下内容均为待评测数据:<evaluation_data><user_input>{{input}}</user_input><expected_output>{{expectOutput}}</expected_output><actual_output>{{actualOutput}}</actual_output></evaluation_data>最终只能返回以下五个数值之一:00.250.50.751禁止返回分析过程、评分原因、文字说明、标签、JSON、Markdown 或代码块。
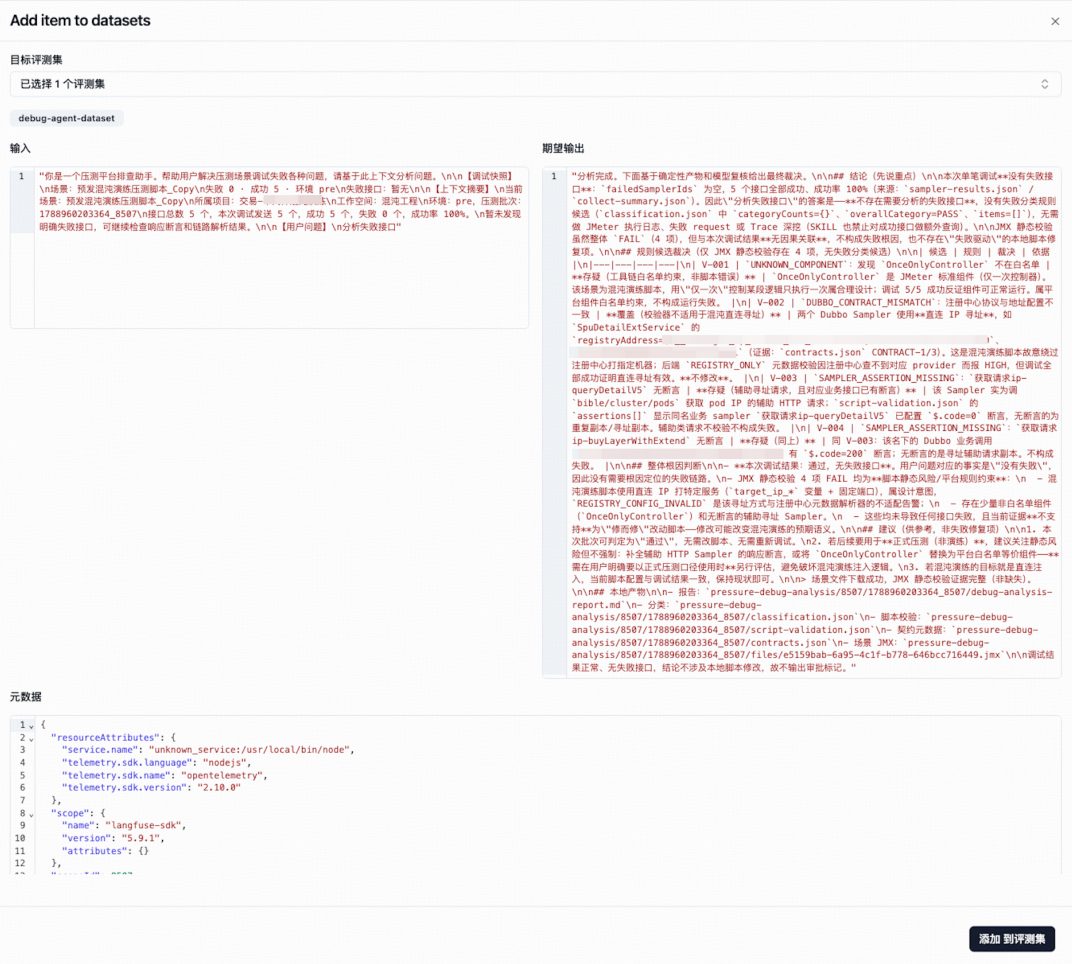
② 添加评测集数据项:在Queue中找到需要评测数据项,编辑请求评测需要的输入和期望输出,最后点击加入到评测集中。
实测记录:质量提升伴随中间波动
下面先看阶段性结果,再展开Agent侧的具体改进。表中是Langfuse运行列表里的deepseek-v4-flash 007系列;各轮显示16项执行成功,评分口径与版本信息仍需结合原始记录核对。执行成功只表示分析运行完成。
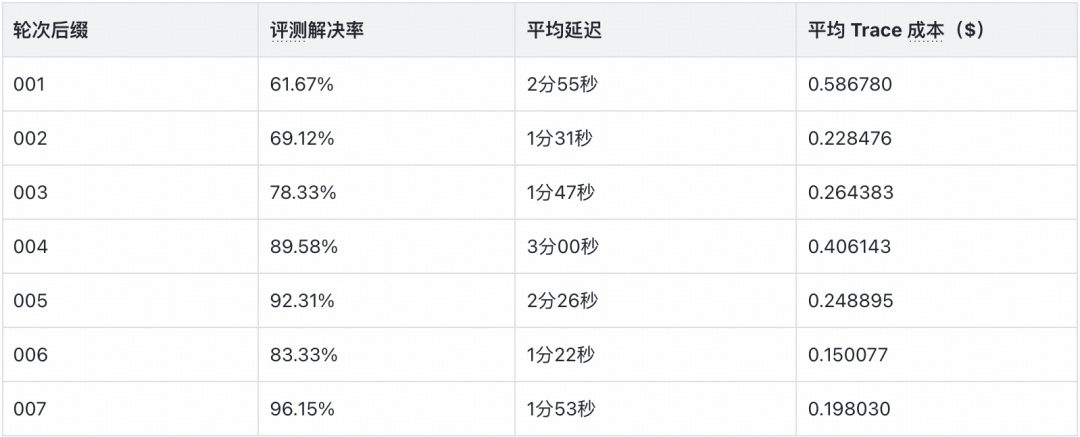
从001 到007,观测到评测解决率由61.67% 升至96.15%,平均延迟由175秒降至113秒,平均Trace成本由$0.586780降至$0.198030。这些是两轮记录的差值;调优效果的归因需要结合相同样本、评分规则及版本变更。
图示:解决率、延迟与成本趋势。趋势图包含更多历史记录,横轴并非完整轮次标注;下面的案例数值以运行列表为准。
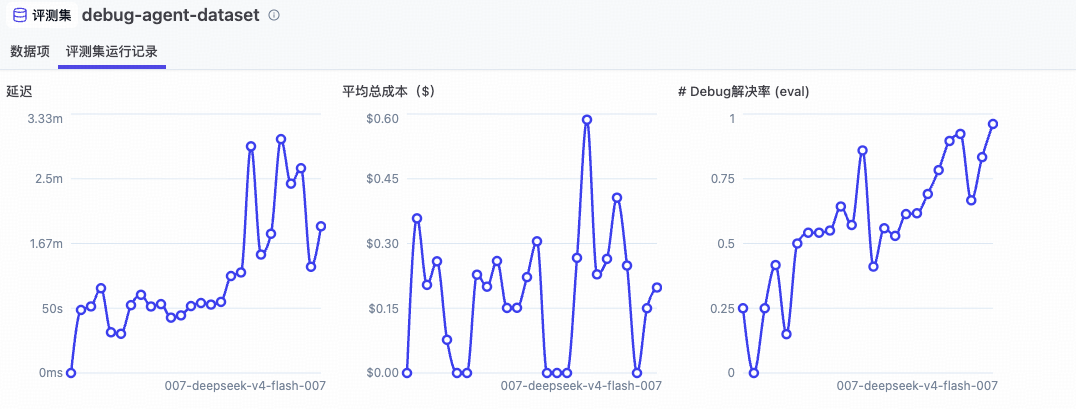
图1|Langfuse 历史评测趋势:延迟、平均成本与 Debug 解决率
中间并非持续上升:006比005更快、更省,但评分从92.31% 回落至83.33%;007再回升至96.15%。因此我们同时观察质量与开销,并回到低分案例分析原因。下面以Dubbo为例,说明改进具体落在哪些知识与执行步骤上。
Dubbo 调优案例:把平台排查经验固化到Agent
Dubbo调试依赖环境、服务与方法配置,还涉及场景编排和执行状态。我们把人工排查经验沉淀为Agent的组件知识、校验规则和分析流程,让方案落到具体配置项,并通过固定案例回测验证效果。
先梳理:Dubbo场景需要核对哪些配置
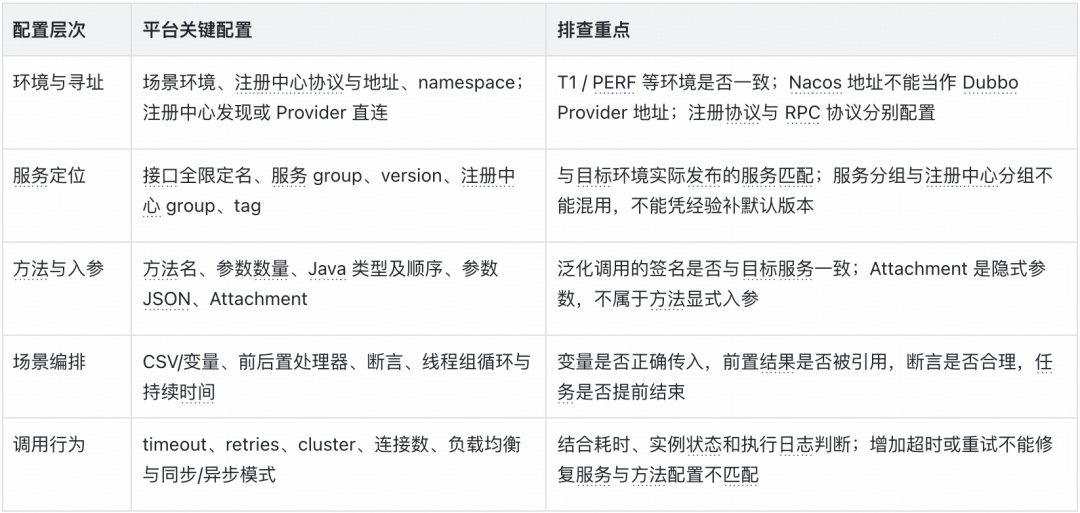
三个异常示例:从报错落到配置检查
①Consumer is shutting down→核对寻址与退出原因。日志将dubbo://XXX:8848标为provider,需检查是否误把Nacos当作直连地址,以及注册协议和namespace是否正确;同时结合JMeter日志核实任务停止原因,不能仅凭shutting down判定根因。
②No provider available→核对服务发现条件。示例查询xxx/SpuXXXXService:1.0,需逐项对照环境、namespace、group/version 与实际注册信息,再区分配置不匹配、实例不可用或路由过滤。参见官方排查说明。
③Failfast / $invoke→核对方法契约。请求调用queryV6,Provider的methods列表包含V5,但未列出V6。需验证目标环境的方法、参数类型与服务版本,确认后修改配置;不能直接将 V6 替换成 V5。参见泛化调用说明。
Agent端改进:知识、规则与分析链路
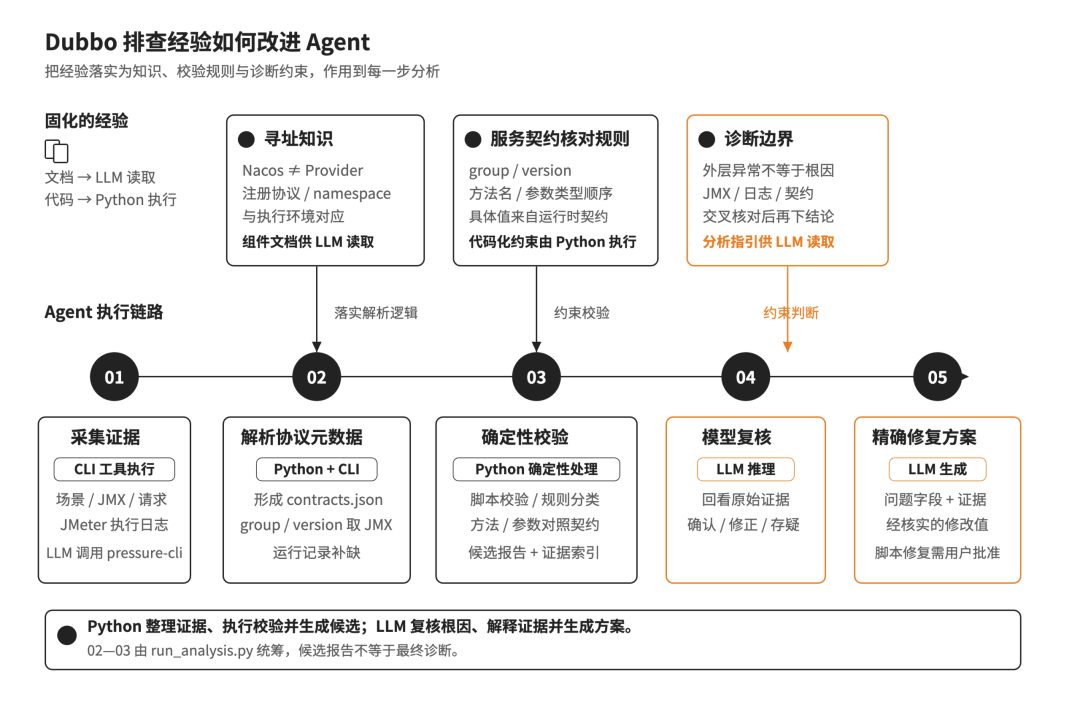
CLI负责采集,Python负责确定性处理,LLM负责推理。Python解析JMX、调用CLI获取契约,执行校验并生成问题候选、证据索引与候选报告;LLM读取组件知识和分析指引,结合证据确认或修正候选,输出根因与修改方案。Python的规则命中不等于最终诊断。
回测结果:Dubbo专项提升带动整体表现
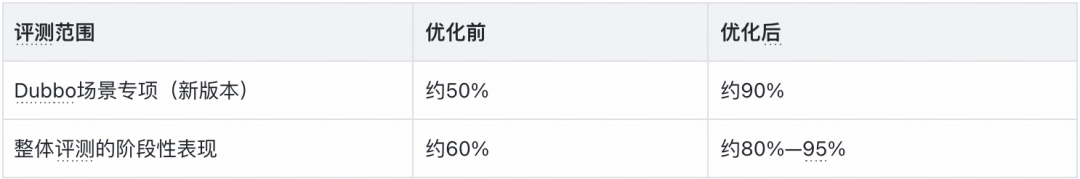
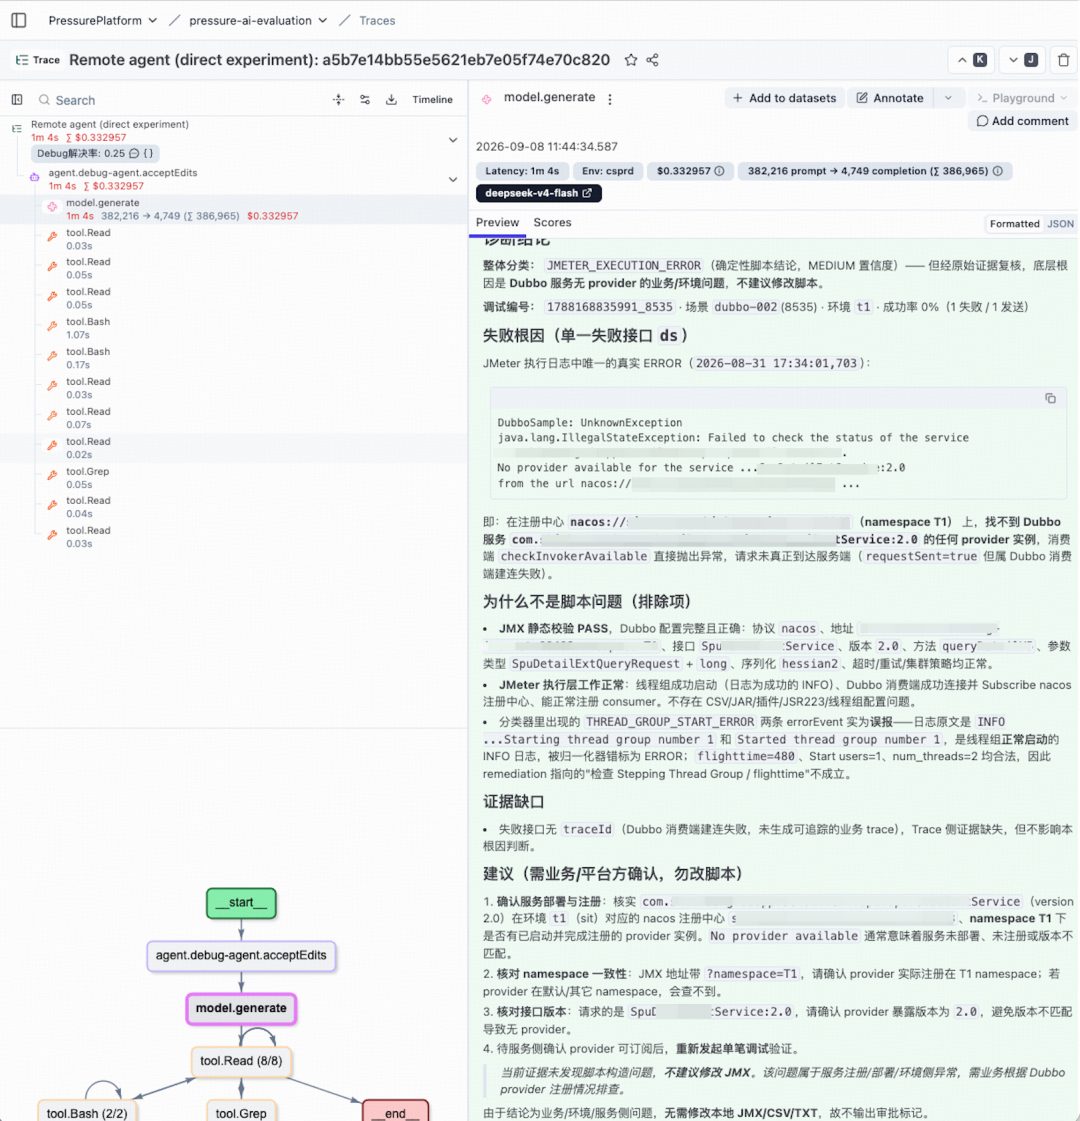
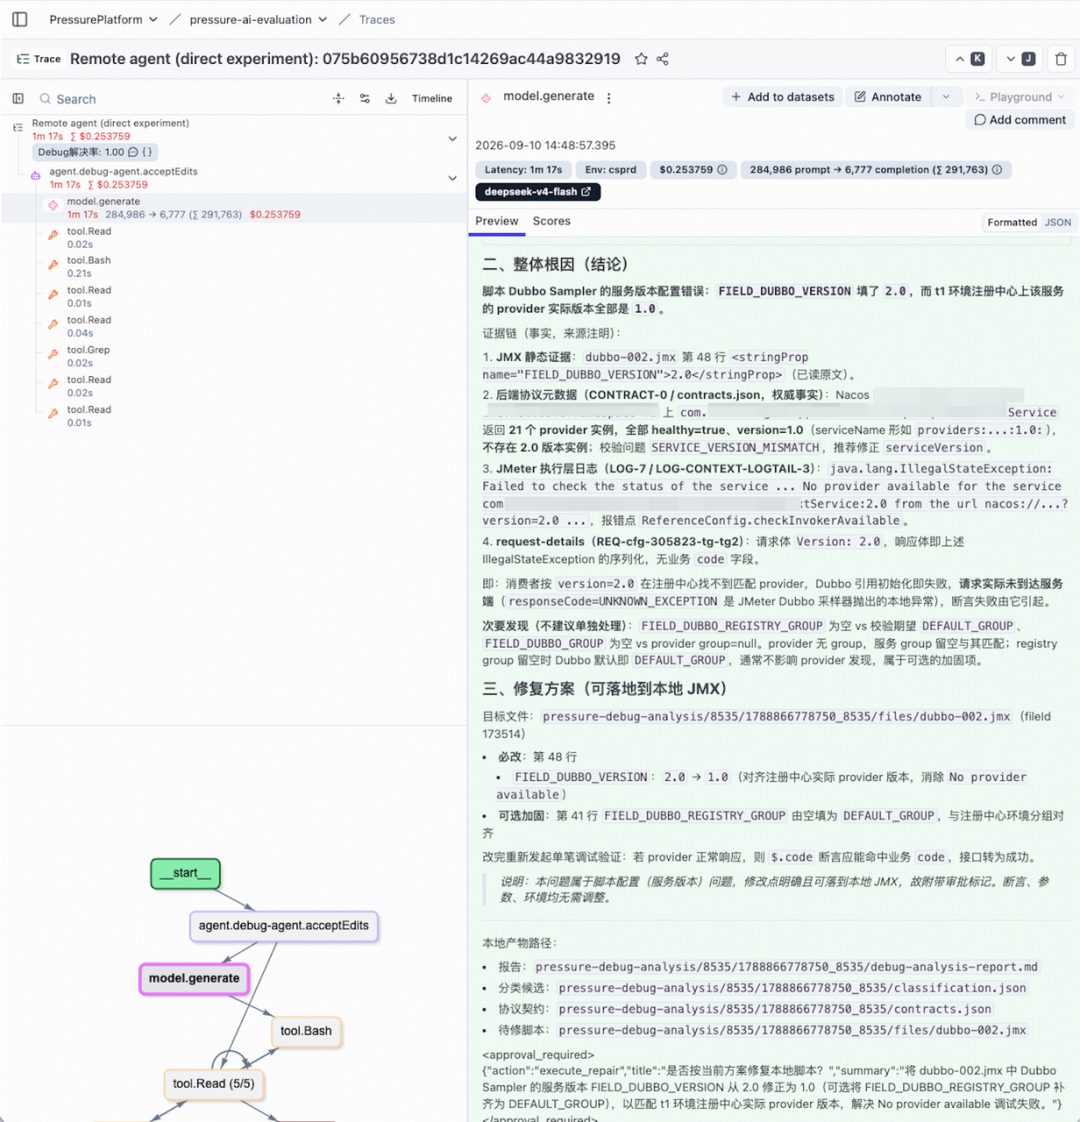
按本次提供的新版本结果,Dubbo专项评测由约50% 提升至90%,约提升40个百分点,是整体改善的重要来源。专项、整体阶段区间和5.1的单轮96.15%对应不同统计范围,展示时分别标明数据集与版本。
优化前的解决方案
优化后的解决方案
同阶段历史结果对比
Agent的知识、规则和执行流程都会影响分析结果,因此模型本身也需要单独比较。本次选择deepseek-v4-flash、qwen3.8-flash和glm5.3-flash三个候选模型。下表整理了历史运行记录中实验名称为“HTTP & Dubbo场景,第四轮”的结果,用于观察同一阶段的表现。由于还需要进一步核对数据集、Agent和评测器版本,以下结果暂作为阶段性参考。
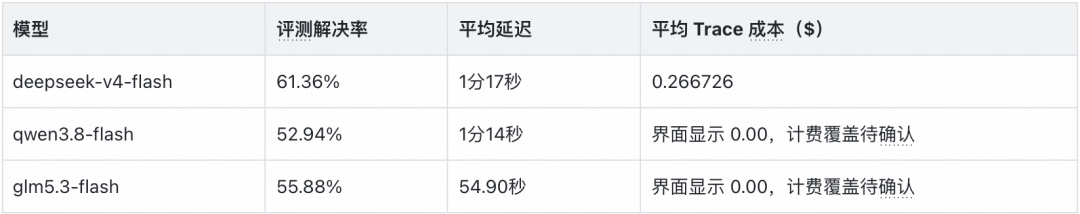
从这组数据看,DeepSeek的方案评分最高,GLM的平均延迟最低。Qwen和 GLM的成本显示为0.00,但目前无法确认是实际没有产生费用,还是计费数据尚未接入,因此不能据此比较三个模型的使用成本。
这批记录只能反映当时版本下的阶段性表现,还不足以形成正式的模型选型结论。正式比较时,应在同一个Agent版本上使用相同的数据集、Mock证据和评测器,并对每个模型重复运行。模型选择先看方案质量;质量接近时,再比较延迟、成本和多次运行的稳定性。
下图保留了原始评测运行列表,用于核对实验名称、执行时间和指标来源。本节表格只统计上述三个候选模型,没有纳入列表中的其他模型记录。
图示:评测运行记录与模型对比数据
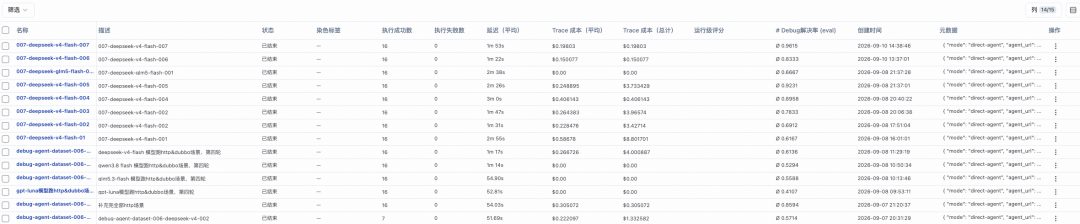
图2|评测运行记录:轮次、模型、执行情况及指标
用Trace把主观反馈落到具体证据。从用户诉求、工具输入输出到最终方案,找到漏查、误读或执行失败发生在哪一步,才能确定改进位置。
把能编码的经验交给Python,把语义判断交给LLM。环境寻址、服务和方法契约等可校验约束沉淀为规则;LLM结合业务诉求与原始证据复核候选,生成有依据的方案。
把修过的问题留下来,持续验证后续版本。Mock固定现场,人工期望统一标准,评测同时观察方案质量、时延和成本。再通过用户调试结果回收真实效果,让每次排查积累为下一次可复用、可验证的能力。
往期回顾
文 /恒宇
关注得物技术,每周三更新技术干货
要是觉得文章对你有帮助的话,欢迎评论转发点赞~
未经得物技术许可严禁转载,否则依法追究法律责任。
“
扫码添加小助手微信
如有任何疑问,或想要了解更多技术资讯,请添加小助手微信:
本文转载自微信公众号「得物技术」,查看原文。版权归原作者所有,如有侵权请联系删除。