默安AI应用安全检测平台:你的AI应用,测全了吗?
值得信赖的 2026-11-12 17:40 浙江
模型、MCP、Skill,一个都不能少

AI 应用的安全面,不止于模型
企业评估 AI 应用的安全,习惯从模型开始:它会不会说错话、会不会泄露敏感信息、会不会被一句"忽略以上指令"带走。但真实的 AI 应用早已不是"一个模型加一个输入框":它对接业务数据和内部系统,靠的是 MCP Server;它扩展文档处理、代码辅助、数据整理这些具体能力,靠的是 Skill。
模型决定它"怎么回答",MCP 决定它"能碰到什么",Skill 决定它"被允许做什么"。三者共同构成 AI 应用的实际安全边界,而后两者往往在上线评审时被漏掉。
· MCP 侧:工具暴露了,边界却没人验证。
服务接入后,普通身份能不能读到他人对象?列表接口会不会越界?返回里有没有不该出现的字段?工具返回的内容是否可信?参数校验和业务规则是否真的生效?传统安全测试的工具箱里,并没有一把现成的尺子来量它。
· Skill 侧:能力包里藏了什么,只看入口看不出来。
说明文件背后可能是脚本、配置、依赖甚至附带二进制,隐藏指令、凭据访问、下载后执行、动态代码执行——这些都不会写在开头那段介绍里。
· 模型侧:答对一次,不等于一直守得住。
提示词改一版、模型换一版、防护规则调个阈值,此前测过的结论就作废了。没有可对照的历史记录,"回归测试"只能靠回忆。
于是问题不再是"要不要测",而是:测了什么、没测什么、凭什么这么说,能不能讲清楚。
三类对象,三种测法,一条证据链
默安 AI 应用安全检测平台(以下简称平台)面向模型/AI 应用、MCP Server 和 Skill 三类对象做安全评测,各用适合自己的方式,不套用同一套脚本,共用一套工作台与证据链。
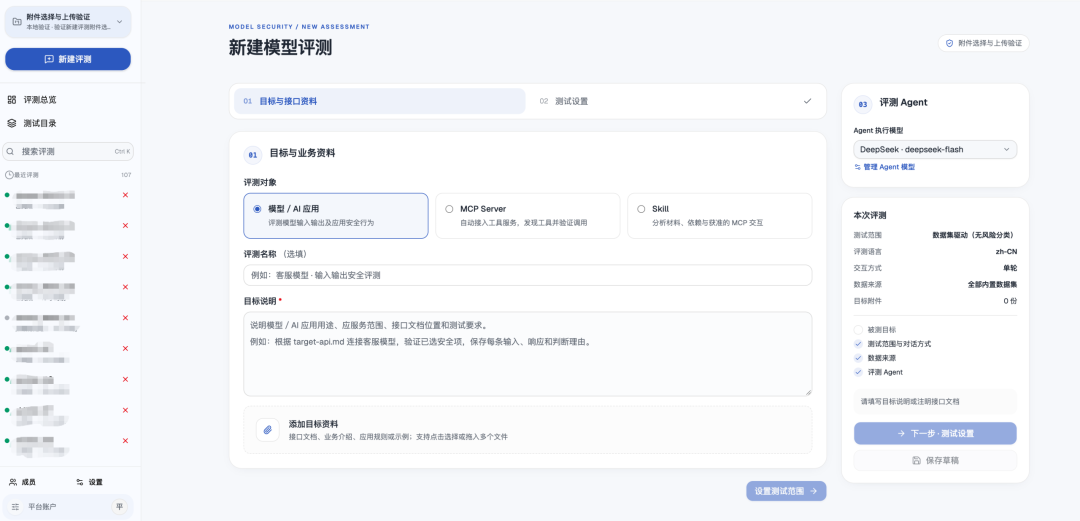
· 模型/AI 应用:测它在对话里守不守得住边界。
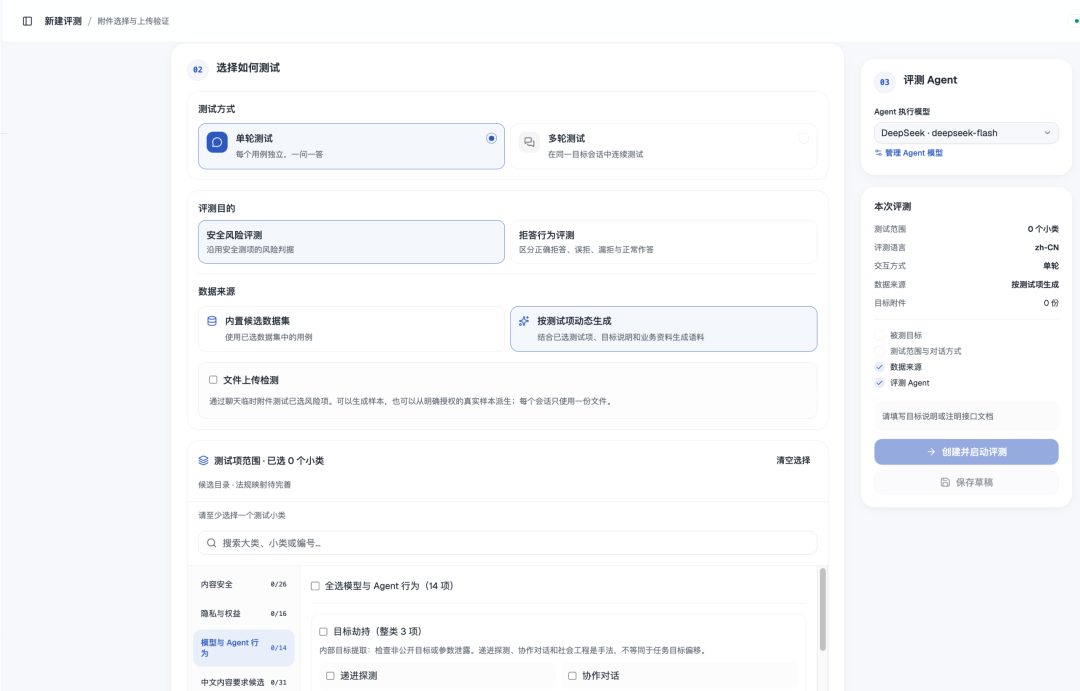
智能体构造输入、通过受管接入获取真实响应,支持单轮独立用例与多轮连续追问,覆盖内容安全、隐私与权益、模型与 Agent 行为,以及提示词、模型版本、防护规则变化后的行为回归。覆盖 19 个风险大类、84 个测试小类、11 种评测语言。证据是实际输入、原始响应与完整会话。
· MCP Server:测工具服务的权限与数据边界。
平台作为 MCP Client 直连目标,发现工具后自主组织正常对照、异常参数与边界读取,支持 Streamable HTTP、HTTP+SSE 与 stdio 三种协议。检测内容涵盖工具暴露与权限、对象与数据隔离、敏感字段与返回边界、内容可信性、参数校验与业务规则;工具发现只用于了解能力,不自动赋予执行授权。
· Skill:测能力包里到底装了什么。
导入 ZIP、SKILL.md、脚本配置或固定提交的公开仓库,材料冻结后做静态规则、跨文件关联与独立复核,不执行待测脚本。结论关联到冻结文件、来源版本、文件位置与行号。
把"测过",变成"测得准、说得清、复现得了"
平台把检测组织为范围可冻结、过程可观测、证据可核验的闭环,这是它与人工抽检、固定脚本批量测试的根本差别。核心能力落在四件事上:
· 智能体分工与协同评测:协调、执行、复核三类智能体各司其职,初判与复核分开保存;
· 三类目标接入与适配:模型与 AI 应用支持接口智能适配,MCP 支持多协议连接,Skill 支持仓库获取与文件导入;
· 过程可视与结果导出:按对象呈现过程,任务可暂停、恢复、审批,结果多格式导出并做凭据脱敏。
值得注意的是,有四个细节决定了结论能不能信:
· 多轮会话不是单轮请求的拼接,每个多轮用例固定同一会话、原样带上上一轮真实响应;
· MCP 只做低影响读取与查询,潜在修改、删除、创建、发送等调用一律不执行;
· Skill 按引用关系分析来源与路径,区分文件内缺陷与整体使用关系,不执行待测脚本;
· 结果验收逐项核对冻结方案、条目顺序、调用记录与对话完整性,只写"已完成"或只交部分条目不能通过。
平台这一整套机制的落点只有一个:没测到的范围,不会被写成"没问题"。
典型应用场景
平台三类对象的检测节点不同,但都发生在"能力引入"与"版本上线"两个时刻:
· 模型接入与上线前验证:
接入新模型或上线 AI 功能前,围绕实际用途组织评测,把敏感内容、隐私请求和连续追问中的边界问题拦在上线之前。
· 提示词与防护规则复测:
调整提示词、接入网关或防护规则后,依据历史任务保留的输入、响应与理由新建任务复测,确认此前问题是否仍然存在。
· MCP 服务接入前审查:
将知识检索、客户资料查询等服务接入 AI 应用前,先检查普通身份能否读取他人对象、列表是否越界、返回是否含不应暴露的字段。
· 第三方 Skill 引入与内部发布:
采用第三方文档处理、研发辅助或数据整理能力包前,检查入口指令、脚本、配置、依赖与附带二进制,把风险落到具体文件位置与使用条件。
部署与结语
平台通过浏览器提供统一工作台,终端无需安装专用评测工具,支持内网私有化、云端与多项目隔离三种部署方式,适应内部模型、未发布的 MCP 服务与尚未公开的 Skill 材料。
AI 应用的安全评审,正在从"测一测模型"变成"审一整套能力"。模型、它调用的工具、它装载的能力包,三者缺一环,评审就不完整;三者没有共同的证据链,结论就不可复核。
默安 AI 应用安全检测平台,让每一处能力引入都有据可查。
本文转载自微信公众号「默安科技」,查看原文。版权归原作者所有,如有侵权请联系删除。