开源风险治理平台“伏羲”在Linux内核漏洞检测中取得重要进展,助力开源基础软件安全治理
原创 胡焜、陈碧欢 2026-11-12 17:17 上海
如何更高效地发现 Linux 内核中的潜在漏洞?开源风险治理平台“伏羲”在 Linux 内核漏洞挖掘领域取得新进展,通过多样性引导的模糊测试技术 SyzDiversity,提升测试效率与漏洞发现能力。
研究背景:测试用例多样性不足影响Linux内核漏洞检测
Linux内核广泛应用于云服务器、工业控制等系统,负责管理处理器、内存、文件和网络等关键资源。内核漏洞不仅可能引发系统崩溃、数据损坏或权限提升,还会影响依赖它运行的上层应用。如图1所示,Linux内核相关的公开漏洞持续累积,尤其自2024年以来增长明显。据截至2026年10月30日的统计,自2015年以来,Linux内核相关的公开CVE记录累计已达20,024条,给漏洞排查、影响评估和修复维护带来了持续挑战。
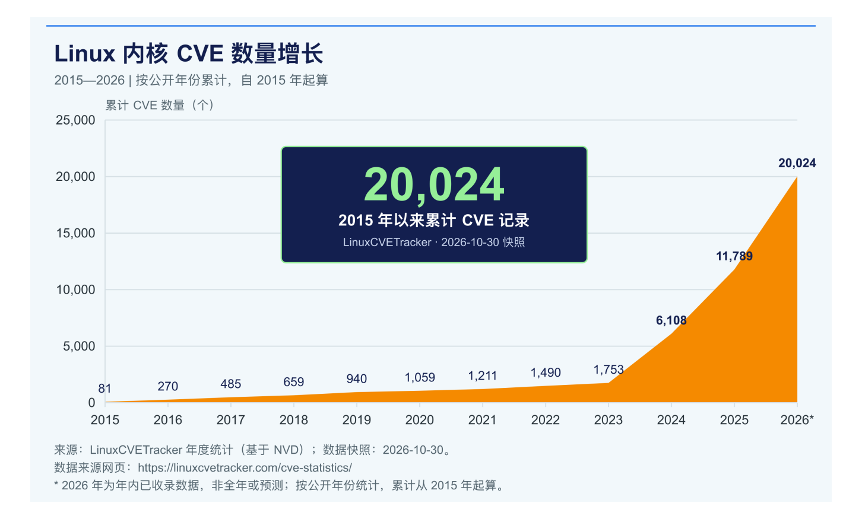
图 1 Linux内核累积CVE数量累计增长(2015-2026)
同时,这些漏洞的影响还可能沿着代码复用关系向下游扩散。如图2所示,openEuler、龙蜥、银河麒麟等下游操作系统基于Linux内核进行开发和定制,在继承其功能的同时,也可能引入相关代码中潜藏的漏洞。如果这些漏洞未被及时识别和修复,就可能在满足触发条件的实际部署环境中被利用,进一步威胁云平台、工业服务器和边缘设备等基础设施的安全。因此,持续发现并修复 Linux内核中的潜在漏洞,是保障开源软件供应链安全的重要环节。
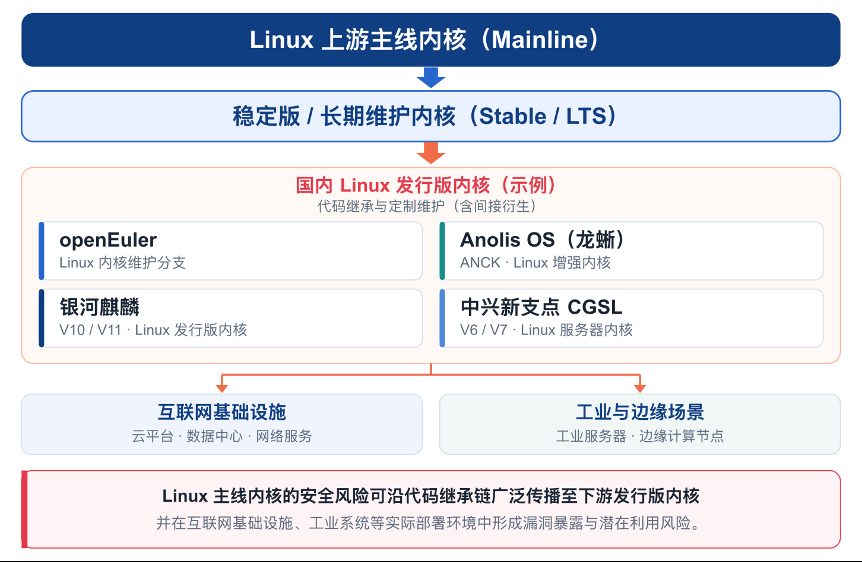
图 2 Linux内核漏洞传播路径及潜在风险
模糊测试是发现Linux内核漏洞的重要技术。它自动生成并执行测试用例,反复改变其中的操作和参数,观察内核是否出现崩溃或其他异常。一个测试用例通常包含一系列系统调用,每个系统调用都代表用户态程序向内核发出的一次操作请求。以Syzkaller为代表的工具采用覆盖率引导的方法,记录测试实际执行到了哪些内核代码,并将带来新增代码覆盖的用例保留为种子(Seed),作为后续生成新用例的基础。
如图3所示,工具首先生成并执行初始用例P0,将其保存在用例库中;随后,通过修改P0副本中的系统调用或参数,生成A、B、C等候选用例。其中,B探索到了此前未被执行的代码,因此被保留为新的种子,供后续继续变异;A、C未带来新增覆盖,则不作为新种子入库。通过持续重复“生成用例—执行测试—收集覆盖反馈—保留种子并继续变异”的过程,工具逐步扩大对内核代码的探索范围,增加发现潜在漏洞的机会。
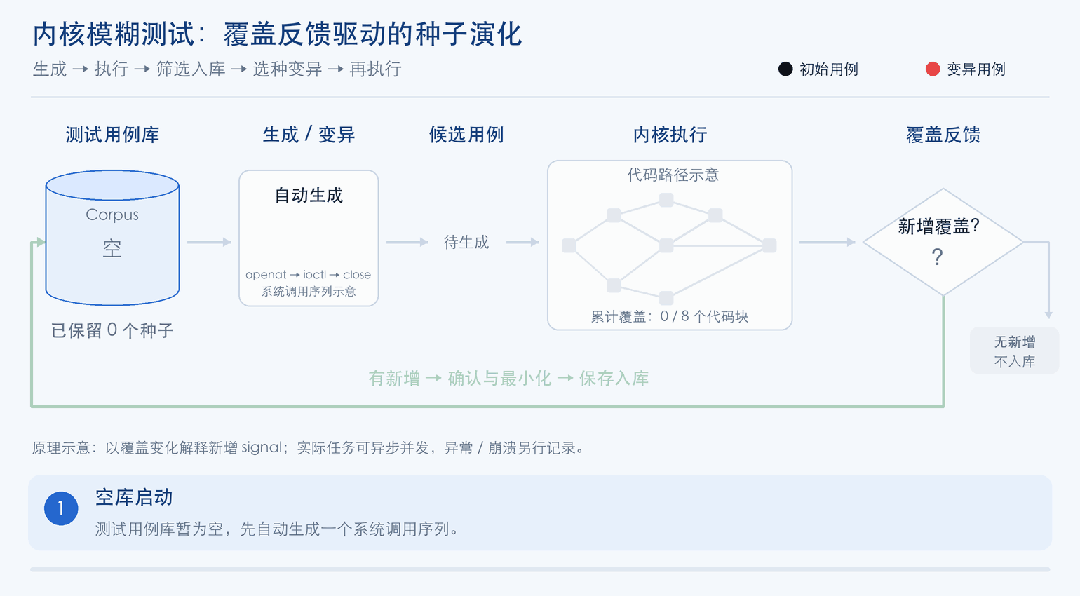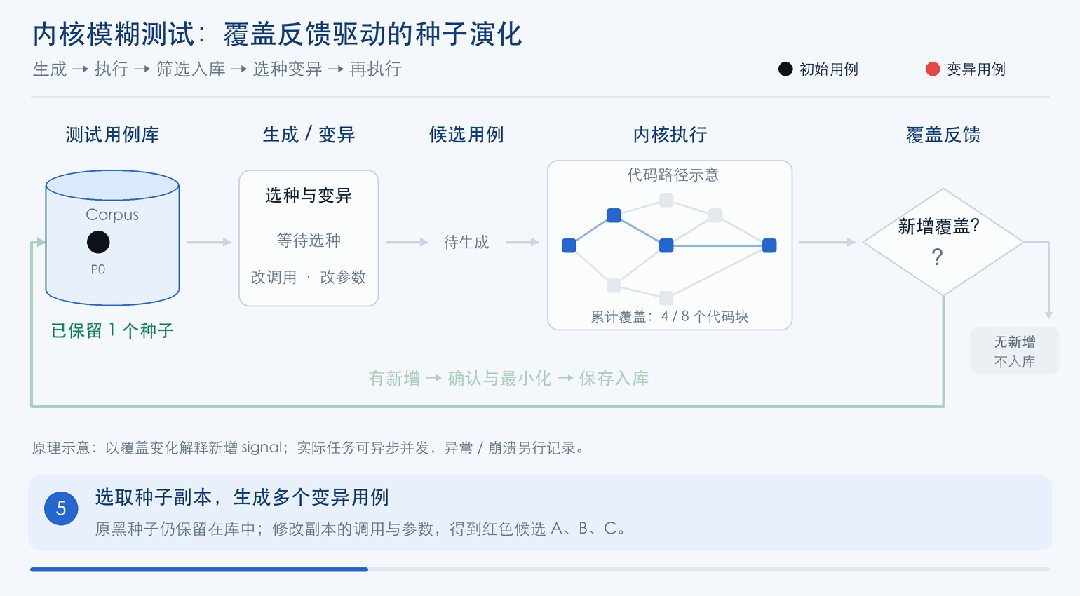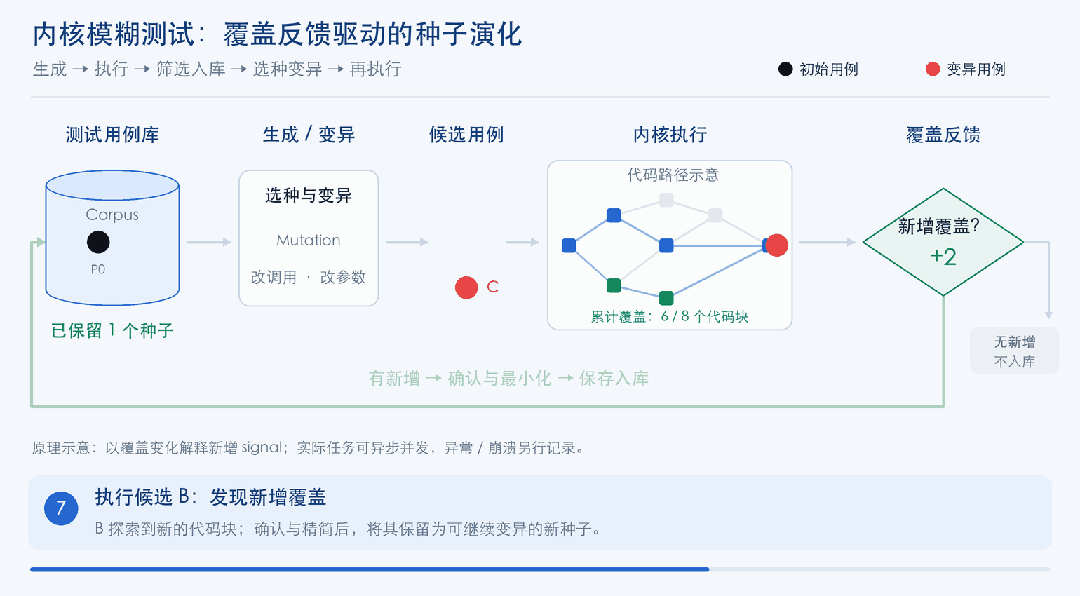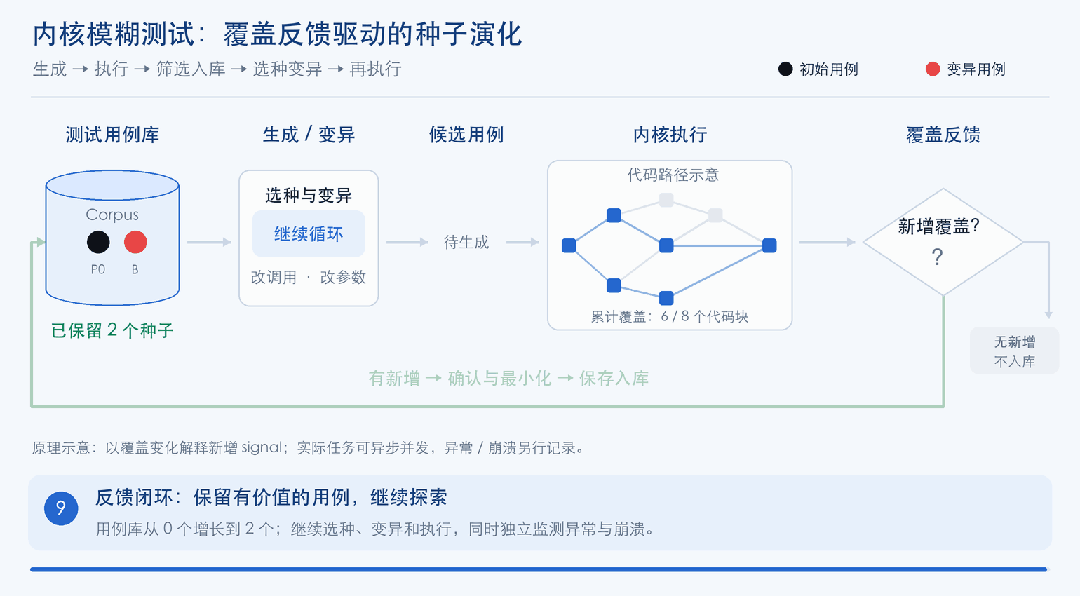
图 3 内核模糊测试流程
然而,现有覆盖率引导的内核模糊测试工具仍存在测试用例多样性不足的问题,限制了漏洞发现能力,主要体现在两个方面:
(1)在测试初期,从零生成的用例通常较为简单,难以包含触发复杂漏洞所需的操作组合和前置条件。面对庞大的搜索空间,工具需要长时间积累有效用例,并通过持续变异逐步构造这些条件;
(2)在持续测试过程中,工具主要依据覆盖率收益评估用例价值,可能反复选择相近的操作组合进行变异。因此,即使用例数量不断增加,测试仍容易集中在已有探索区域,难以形成更多样的测试场景,进而限制对更深层执行路径和更多内核子系统中潜在漏洞的发现。
现象一
以图4中的网络子系统漏洞为例,左侧的完整触发用例包含8个系统调用,需要创建多个通信对象、获取网络接口信息,并按特定顺序执行相关操作,共同构造漏洞触发条件。相比之下,从零生成的初始种子①仅包含创建通信对象和发送消息两个操作,虽然执行后可能带来新增代码覆盖,被保留为后续变异的基础,却仍缺少触发该漏洞所需的准备步骤。
在此基础上,候选用例②、③、④分别通过插入绑定操作、替换接口和调整参数产生。这些变化扩展了用例的形式,却仍未补齐完整触发序列中的关键条件。因此,围绕简单种子进行局部变异,可能产生大量相似用例,而从这些用例进一步构造出复杂漏洞所需的操作组合、对象关系和执行顺序,仍需要在庞大的搜索空间中持续探索。
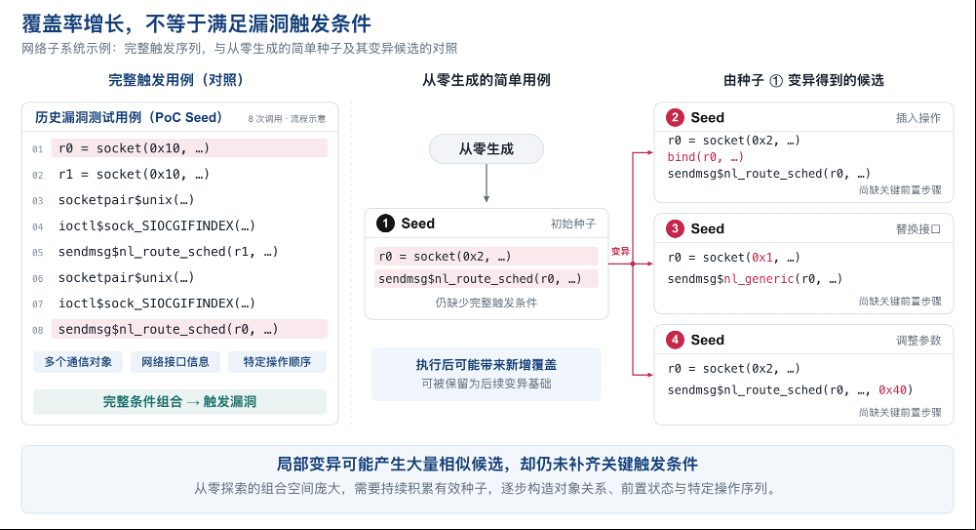
图4 漏洞完整触发序列与随机初始种子及其局部变异用例的对比
现象二
为了考察测试用例多样性对测试效果的影响,研究比较了两类初始用例:一类由 Syzkaller 自动生成(Syzkaller-Generated Seed),另一类从历史漏洞复现程序中抽取(Sampled PoC Seed)。
如表1所示,两类用例均设置三种集合:包含1,000个用例的完整组(All Seed)、包含650个相似用例的相似组(Similar Seed),以及包含650个多样化用例的多样组(Diverse Seed)。其中,相似组集中选取操作类型、参数和结构较为接近的用例,多样组则尽量涵盖不同的操作组合和测试场景。此外,实验还设置了不预加载初始用例的对照组(No Seed)。所有配置均使用 Syzkaller 测试 Linux v6.14,每次运行24小时、独立重复5次,比较最终的代码覆盖量。
表1 种子多样性对模糊测试覆盖率的影响
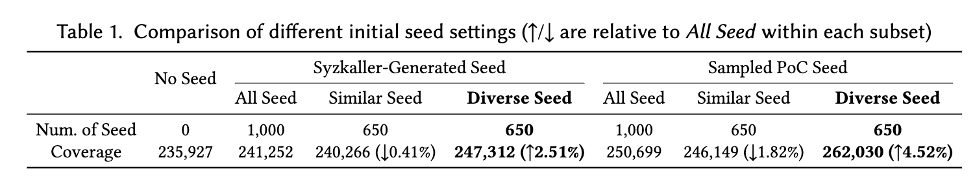
实验结果表明,初始用例的价值和多样性共同影响测试效果。
(1)高价值用例的优势可能受到多样性不足的限制。已有研究 SUNFLOWER 表明,利用历史漏洞复现程序构建初始用例库,有助于提升内核模糊测试的代码覆盖能力。但在本实验中,PoC 相似组的最终代码覆盖量为246,149,略低于 Syzkaller 自动生成用例的多样组(247,312),低约0.47%。这说明,即使初始用例源于真实漏洞,如果其操作组合过于相似,也未必能获得更好的测试效果。
(2)提升多样性能够进一步发挥 PoC 用例的价值。在用例数量同为650个的情况下,PoC 多样组的代码覆盖量达到262,030,较 PoC 相似组提升6.45%;即使与包含1,000个用例的 PoC 完整组相比,仍提升4.52%。这些结果说明,测试效果不仅取决于初始用例的来源和数量,还取决于它们能否提供足够多样的测试场景。
图5进一步示意了这一问题在持续测试中的表现。图中,黑色圆点表示初始种子,红色圆点表示变异产生的新用例,虚线区域表示操作组合相近的用例群。当工具主要依据覆盖率收益选择后续变异对象时,早期带来收益的种子及其变体可能被反复选中。例如,种子①经过多轮变异,陆续衍生出②至⑯,但这些用例仍集中在原有用例群中,其他用例群则仅得到少量扩展。
这些新用例即使带来了一定的新增代码覆盖,也可能仍围绕相近的操作组合展开。因此,随着用例数量不断增加,测试场景未必同步丰富,反而可能逐渐集中于少数熟悉的区域,限制对不同操作组合的探索,进而难以生成能够覆盖更广泛内核子系统的测试用例。
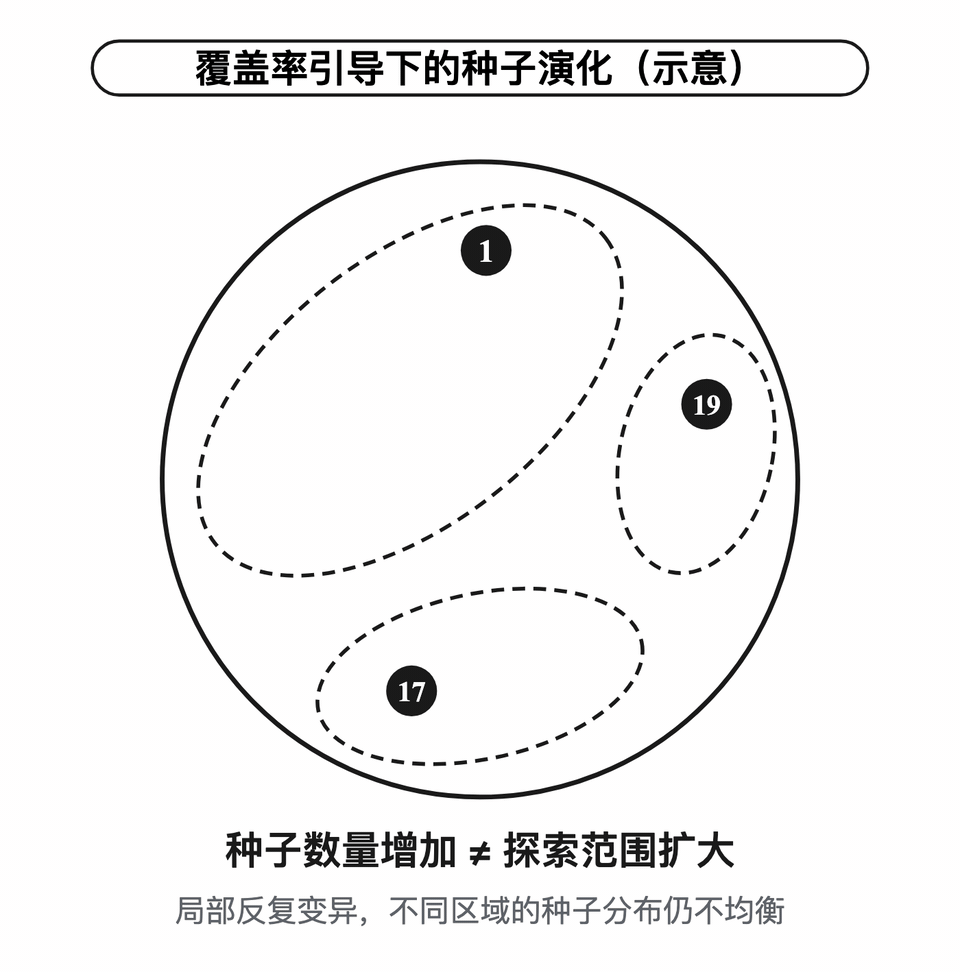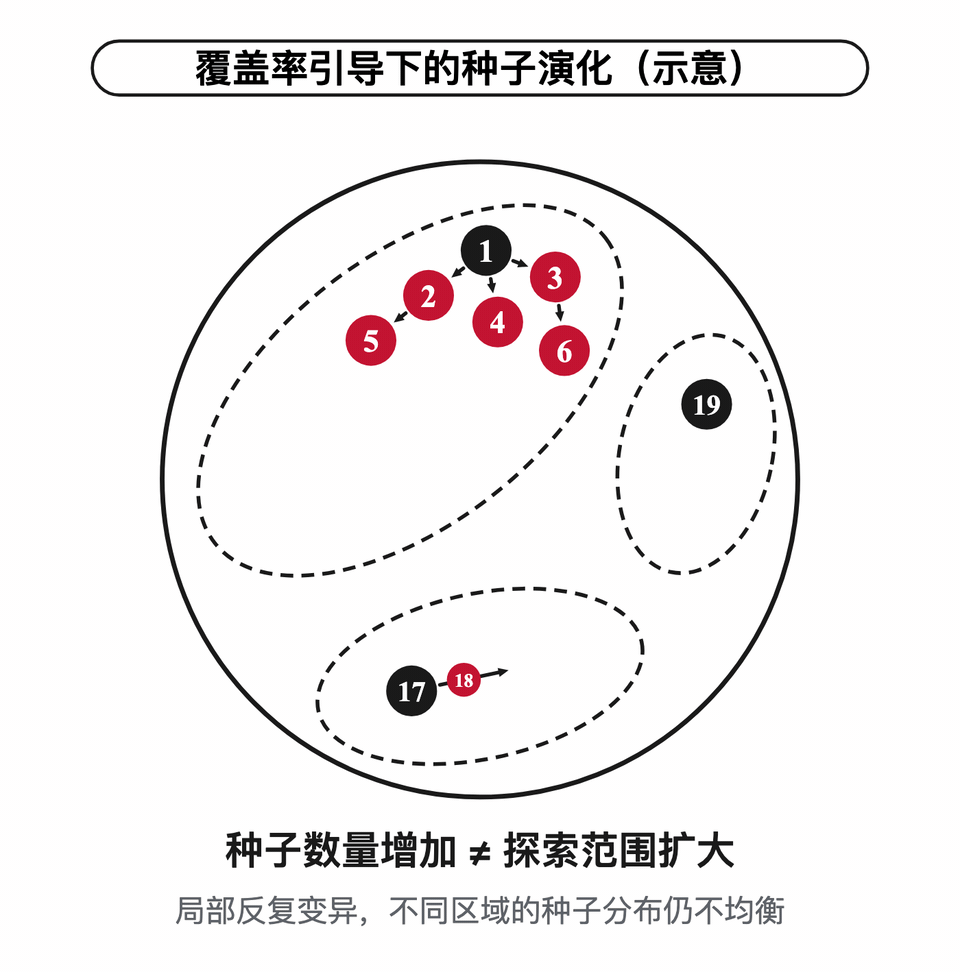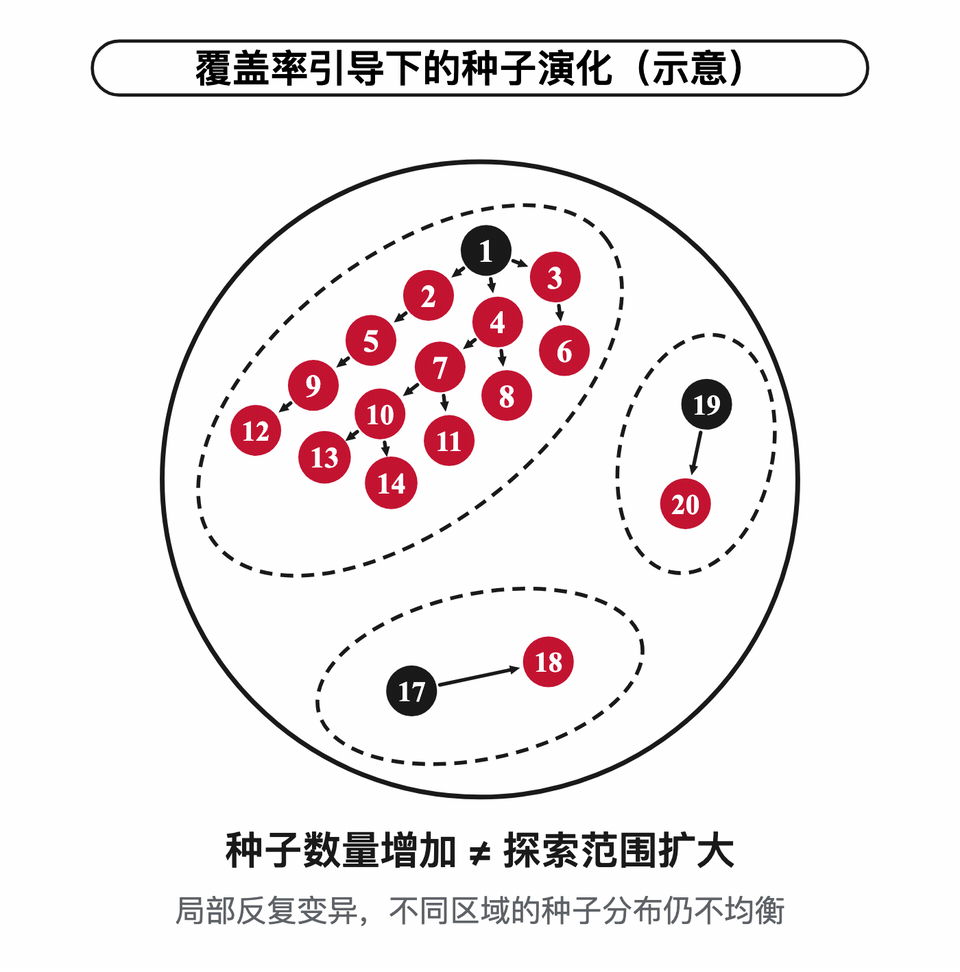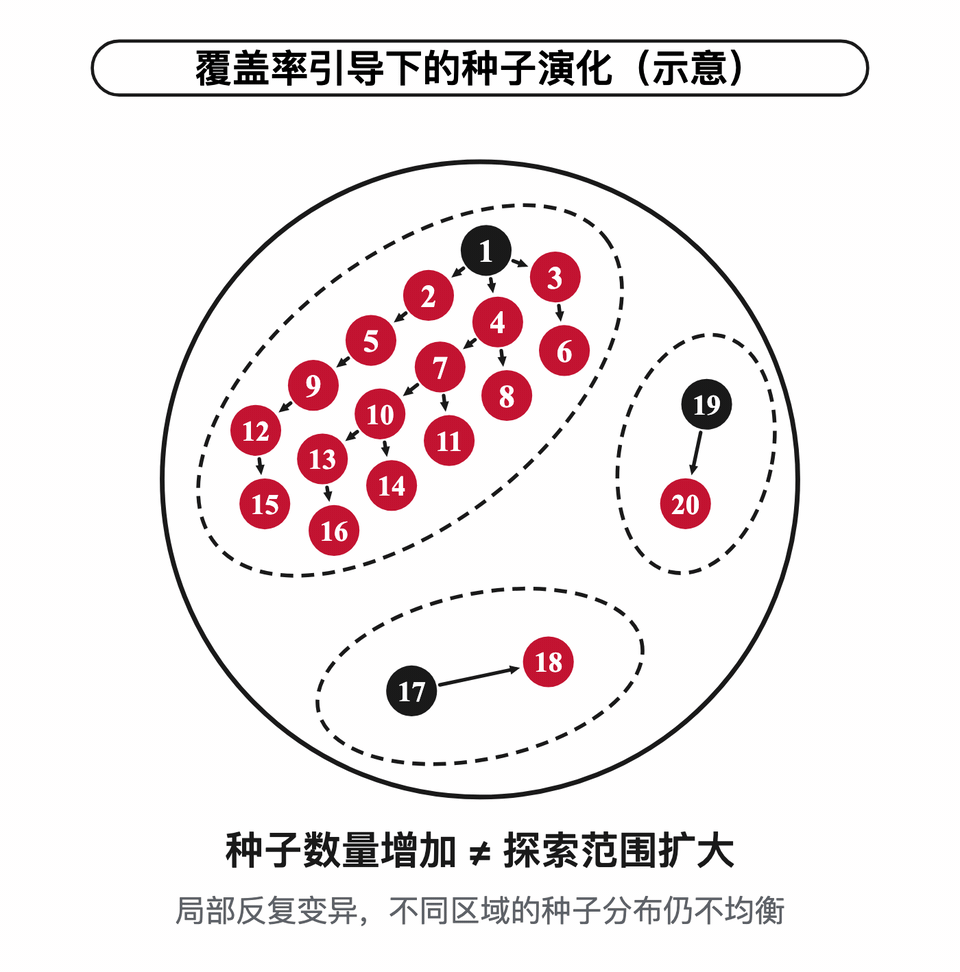
图5 覆盖率引导模糊测试工具的种子演化示意
研究问题总结
初始测试用例的价值容易因早期覆盖收益而被高估。测试初期,一些简单的随机用例就能带来新增代码覆盖,因而被频繁选作后续变异的基础,但它们未必包含触发复杂漏洞所需的操作组合和前置条件。虽然工具可以借助覆盖率反馈积累有效用例,并通过持续变异逐步构造这些条件,但如果测试机会长期集中于早期用例及其相似变体,后续探索就容易局限于已有场景。面对庞大的漏洞触发条件组合空间,这种局部反复变异难以持续拓展测试范围,进而限制复杂漏洞的发现。
研究进展:多样性引导的Linux内核模糊测试技术
针对上述问题,复旦大学 CodeWisdom 团队提出了多样性引导的 Linux 内核模糊测试技术 SyzDiversity,进一步拓展了开源风险治理平台“伏羲”在内核漏洞挖掘方面的技术能力。该技术将多样性分析与引导贯穿初始用例准备、用例调度和用例变异三个环节,在利用高价值初始用例的基础上,持续引导测试探索不同的操作组合和场景,缓解测试长期集中于相似用例的问题,从而提升复杂漏洞的发现能力。相关研究论文“SyzDiversity: Diversity-Guided Linux Kernel Fuzzing”已发表于 ISSTA 2026,其整体流程如图6所示。
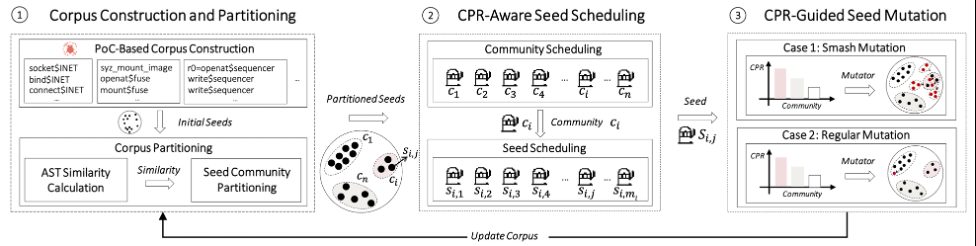
图 6 SyzDiversity整体流程
SyzDiversity 首先从历史漏洞复现程序中获取测试用例,保留真实漏洞涉及的操作组合,为测试提供高价值起点。随后,根据操作类型、参数和结构的相似性,将用例划分为多个社区,使操作组合相近的用例归入同一社区。
测试过程中,SyzDiversity 综合考虑社区的用例分布、历史调度情况和代码覆盖反馈,评估不同社区的探索潜力,据此选择测试用例,并为有潜力的社区分配更多变异机会。带来新增代码覆盖的新用例会被保留,加入已有社区或形成新的社区,进一步影响后续的调度与变异决策。通过这一循环,SyzDiversity 在深入探索已有场景的同时,持续拓展新的操作组合和测试场景。
(一)初始用例准备
许多内核漏洞需要多个操作相互配合才能触发,单纯随机生成用例往往难以构造完整的触发条件。为此,SyzDiversity 采用公开用例库中的22,506个测试用例作为测试起点。这些用例收集自 Syzbot 中已确认并修复的历史漏洞复现程序,保留了真实漏洞涉及的操作组合。随后,SyzDiversity 根据操作类型、参数和结构的相似性,将操作组合接近的用例归入同一社区。这样的分组既能刻画用例之间的差异,也为后续分配测试机会、引导用例变异提供依据。
(二)测试用例调度
准备好初始用例后,还需要合理分配测试机会,充分发挥不同社区的探索价值。SyzDiversity 采用“先选社区、再选用例”的两级调度方式:首先,综合考虑各社区的相对规模、历史调度情况和新增代码覆盖,兼顾已有测试收益与进一步扩展多样性的潜力,确定优先探索的社区;随后,在选定社区内,结合各用例以往变异产生的覆盖收益和执行效率,选择下一步用于变异的用例。
通过这一方式,SyzDiversity 能够在利用已有测试成果的同时保留继续探索的机会,减少相似用例长期主导测试的情况。
(三)测试用例变异
选定用例后,SyzDiversity 根据其所属社区的多样性扩展潜力,动态调整变异次数。对于潜力较高的社区,工具会对选中的用例开展更多次变异,尝试不同的操作组合和参数变化,降低因少量尝试未产生收益而错失探索机会的可能性。生成的新用例如果带来新增代码覆盖或触发崩溃,就会被保留,并根据相似性加入已有社区;如果与已有社区差异较大,则形成新的社区。这些变化会进一步影响后续的调度与变异决策,使测试既能深入探索已有场景,也有机会拓展至新的场景,持续丰富用例库的多样性。
实验评估:助力Linux内核漏洞发现与修复
为评估方法的有效性,复旦大学 CodeWisdom 团队在 Linux v5.15 和 v6.14 上,将 SyzDiversity 与 Syzkaller、Healer、SyzVegas、SyzGPT 四种内核模糊测试工具进行对比。实验设置了两类规模相同的初始用例库,分别由 Healer 自动生成和基于历史漏洞复现程序构建。在每种设置下,各工具使用相同的初始用例和内核配置,单次实验运行72小时,并独立重复5次,以降低随机性对结果的影响。
表2汇总了不同实验设置下的对比结果。综合两种内核版本和两类初始用例库的结果,SyzDiversity 的代码覆盖量平均提升17.2%,漏洞发现数量平均约为对比工具的6.4倍。其中,代码覆盖率反映测试实际探索到的代码范围,漏洞发现数量则包含已知漏洞和此前未报告的新漏洞。实验结果表明,在相同测试时间下,多样性引导能够帮助工具探索更广泛的内核代码,并提升漏洞发现能力。
表2 不同内核版本和初始用例库下的测试效果对比。
†表示 Healer 生成的用例库,‡表示基于历史漏洞复现程序构建的用例库。
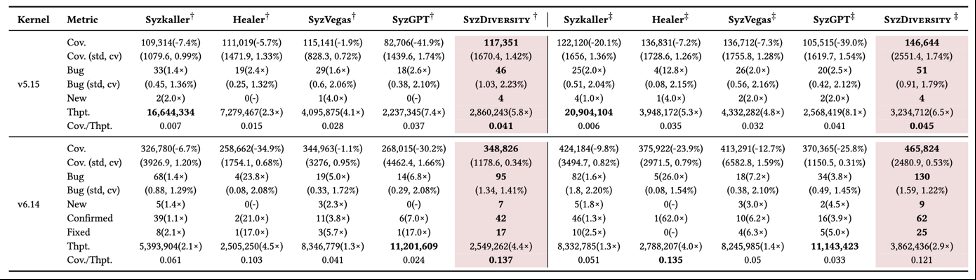
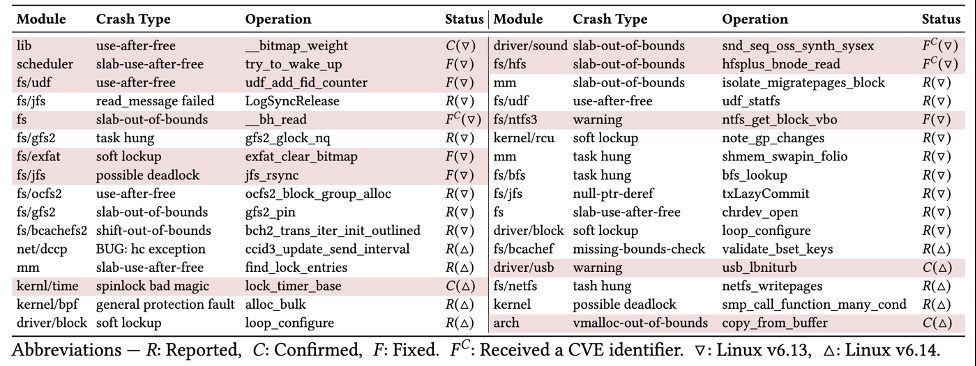
表3汇总了 SyzDiversity 发现的新漏洞及其处理进展。其中,R、C、F 分别表示已报告、已获开发者确认和已修复;FC表示已修复且已获得 CVE 编号;▽和△分别对应 Linux v6.13 和 v6.14。表格左右两部分采用相同的列项,分别列出各漏洞所属的内核模块、异常类型、相关函数及处理状态。
在为期两个月、覆盖 Linux v6.13 至 v6.14 的持续测试中,SyzDiversity 共发现并报告32个新的独立漏洞,涉及文件系统、内存管理、设备驱动等多个内核模块。截至论文统计时,其中12个已获内核开发者确认,8个已完成修复,相关补丁已合入或正在合入 Linux 主线;已修复的漏洞中有3个获得了 CVE 编号。这些成果进一步验证了 SyzDiversity 在实际内核漏洞挖掘中的有效性,并推动了相关漏洞的修复。
表3 SyzDiversity发现的Linux漏洞
关于“伏羲”
“伏羲”是复旦大学CodeWisdom团队推出的开源风险治理平台,旨在推动学术与产业合作交流,提升开源软件供应链风险分析与治理能力。“伏羲”在高质量开源软件供应链知识汇聚的基础上,结合代码差异分析、调用图分析、程序切片、大模型辅助分析等技术,提供漏洞库、组件库、漏洞传播影响分析、生态投毒检测、同源漏洞检测、风险缓解等服务。Linux内核模糊测试是“伏羲”面向开源基础软件供应链安全治理的重要能力之一。未来,“伏羲”将继续围绕内核漏洞PoC迁移等方向持续攻关,进一步提升基础软件开源生态中已知漏洞的自动化验证效率,助力开发者更及时地降低基础软件供应链安全风险。
本文作者:胡焜、陈碧欢、覃佳基
胡焜,复旦大学CodeWisdom团队软件供应链安全小组博士生,导师为赵文耘,主要研究方向为内核漏洞检测与修复。
覃佳基,复旦大学CodeWisdom团队软件供应链安全小组硕士生,导师为陈碧欢,主要研究方向为内核漏洞检测与修复。
往期回顾:开源风险治理平台“伏羲”v0.1首次发布、“伏羲”在开源生态投毒检测中取得重要进展、“伏羲”对Go生态进行了大规模分析、“伏羲”在漏洞影响组件识别中取得重要进展、“伏羲”在开源生态投毒检测中取得进一步重要进展、“伏羲”在漏洞传播影响分析中取得重要进展、“伏羲”在同源漏洞检测中取得重要进展、“伏羲”在安全补丁迁移中取得重要进展。

本文转载自微信公众号「CodeWisdom」,查看原文。版权归原作者所有,如有侵权请联系删除。