英国萨里大学等提出NitroFusion2:首次将对抗判别引入MMDiT文本流,刷新1步极速图像生成纪录
原创 CV君 2026-11-12 23:57 江苏
多模态文本流判别新范式
在少步扩散模型蒸馏领域,对抗蒸馏(Adversarial Diffusion Distillation)一直是实现超低步数采样的核心技术路线之一。然而长期以来,从 ADD、LADD 到前作 NitroFusion(CVPR 2025),所有判别器在架构设计上均默认遵循单一法则——仅提取潜空间或像素空间的图像特征进行真伪判别。
来自英国萨里大学与图灵精英研究实验室的研究人员打破了这一设计惯例,提出了专为多模态扩散 Transformer(Multimodal Diffusion Transformer, MMDiT)打造的少步对抗蒸馏框架 NitroFusion2。其命名延续并拓展了前作 NitroFusion 的多专家判别器思想,专指将对抗判别机制从单一图像域延伸至文本流的第二代极速扩散融合方案。
研究表明,在联合注意力机制(Joint Attention)下,MMDiT 的文本流在交互计算中已经充分吸收了图像特征,因而天然蕴含着高度结构化的图文判别能力。借助文本流对抗蒸馏(Text-Stream Adversarial Distillation, TSAD)与属性线索判别(Aspect-Cued Discrimination, ACD),NitroFusion2 成功将少步蒸馏的主流采样预算从过去的4到8步压缩至仅需1到2步。在极具挑战性的单步生成(1 NFE)下,NitroFusion2 展现出了扎实的排版文字渲染与高频纹理生成能力,使得单步极速生成真正具备了落地可用性。
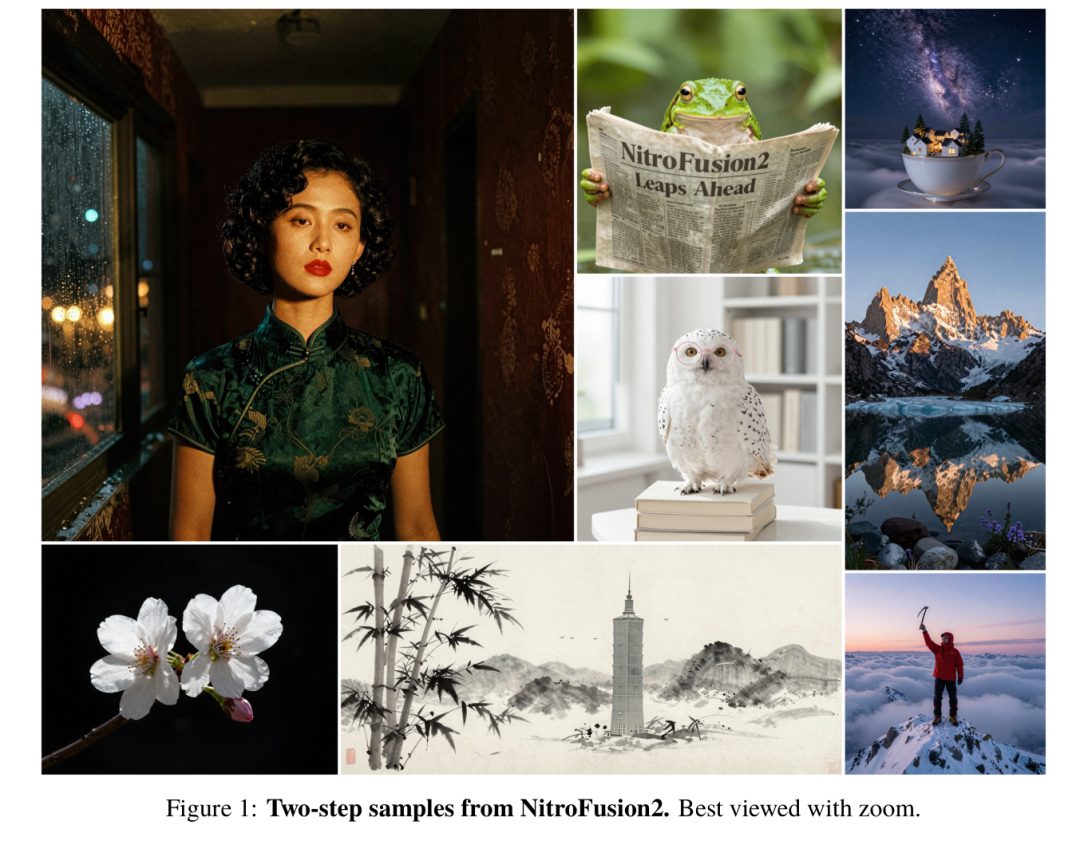
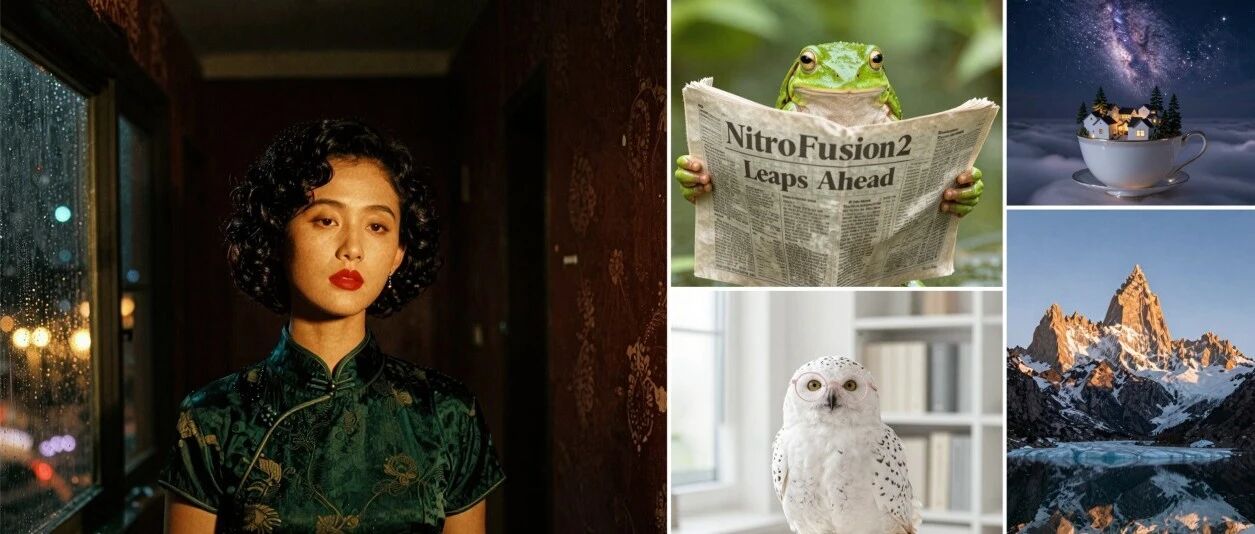
图 1:NitroFusion2 在两步采样下的生成样本展示,放缩查看排版文字与精细细节依然保持清晰。
背景与动机
传统对抗蒸馏的盲区:为何从不判别文本流?
少步扩散蒸馏的目标,是将几十步乃至上百步的迭代去噪过程压缩到极少步数。引入对抗损失(GAN Loss)能够迫使学生模型在单次跨越中恢复高保真细节。以往判别器的输入无一例外都是图像表征,这一设计的历史根源在于经典 UNet 架构。
在基于交叉注意力(Cross-Attention)的 UNet 架构中,文本条件向量 在整个去噪主干中独立于图像前向传播,始终保持不变。这意味着文本隐藏层对去噪轨迹的图像潜变量没有任何依赖,数学上 。如果直接在 UNet 的文本侧挂接判别器,学生模型根本无法接收到任何对抗梯度。
MMDiT 的结构转变:文本隐藏层已成为图像表征
现代文生图模型(如 SD3、Flux、Z-Image 等)普遍转向了多模态扩散 Transformer(MMDiT)。在联合注意力块中,文本 Token 与图像 Token 拼接在一起计算自注意力:文本 Token 充当 Query 查询图像 Key/Value,提取到的图像信息会被即时写回到文本隐藏层状态中。
因此,MMDiT 的文本流在经过若干层深层交互后,不仅依赖于图像输入,而且其表征是沿着提示词所指定的语义轴向高度结构化组织的。这为对抗判别提供了一个此前从未被利用的新空间。
方法详解
NitroFusion2 的核心架构由两部分组成:负责捕获文本流对抗梯度的文本流对抗蒸馏(TSAD),以及负责引导判别维度聚焦的属性线索判别(ACD)。
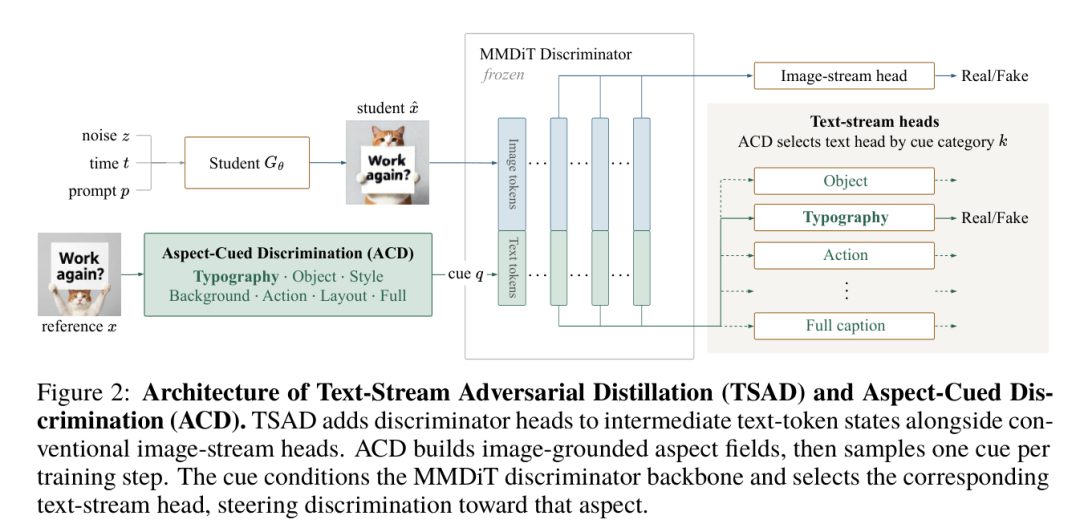
图 2:文本流对抗蒸馏(TSAD)与属性线索判别(ACD)架构图。TSAD 在文本流中间层挂载判别头;ACD 将参考图分解为属性线索并输入判别器骨干,动态路由到对应的文本流专家判别头。
文本流对抗蒸馏(TSAD)
考虑 MMDiT 中某一层联合注意力模块,输入文本隐藏状态为 ,其对应的文本 Query 为 。键值矩阵拼接图像与文本 Token:,。注意力计算公式为:
由此得到的文本注意力输出为:
其中 项代表文本 Token 从图像 Token 中直接聚合的信息。由于该项的存在,文本输出 明确包含了对生成样本 的显式依赖。
TSAD 在冻结的 MMDiT 判别器骨干网络的选定层上挂载轻量判别头,直接读取文本注意力输出 。相比图像 Token 关注局部空间网格,文本 Token 会依照文本概念的指引聚合全局图像信息,使得判别器不仅能判断局部纹理的真实度,还能沿着提示词维度审视图像内容。
属性线索判别(ACD)
由于判别器复用了预训练扩散模型骨干,其输入的文本条件无需与学生模型的输入提示词保持一致。研究团队利用这一特性提出了属性线索判别(ACD):
六大属性字段解耦:针对每张参考图,借助多模态大模型(Qwen3.5-35B-A3B)将其拆解为 6 个结构化属性字段——排版文字(Typography)、主体(Object)、风格(Style)、背景(Background)、动作(Action)、布局(Layout),加上全部字段拼接的完整描述(Full caption),构成 7 类线索。
训练时动态线索采样:每个训练步中,学生模型固定输入原始提示词 ;判别器骨干网络则从参考图对应的非空属性中均匀采样单个属性线索 。
专家头动态路由:判别器文本流采用专家头设计,不同属性线索激活对应的专家判别头(如排版线索激活 Typography 头,主体线索激活 Object 头),使判别器在共享骨干的前提下,零显存冗余地切换审视重点。
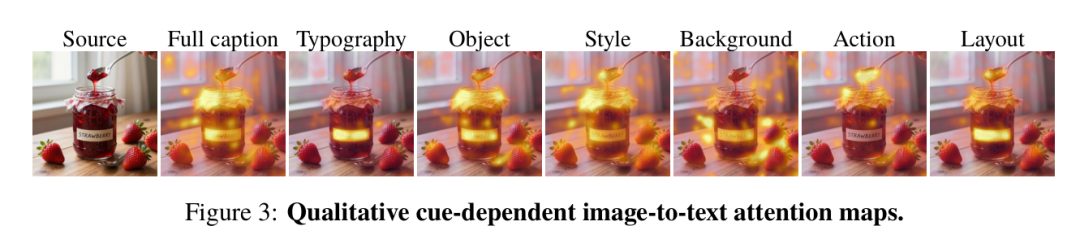
图 3:不同属性线索引导下的图像-文本交叉注意力热力图。排版与主体线索分别聚焦文字与主体区域,背景线索则扩散至外围环境。
如图 3 所示,当向判别器输入不同属性线索时,其图像到文本的注意力热力图呈现出显著的空间解耦特性。这意味着判别梯度能够针对性地反向流经特定视觉区域。
训练目标函数与分阶段策略
系统采用 Hinge 损失更新判别头,判别器文本流与图像流损失分别为 和 。学生模型 的优化目标为:
其中 为浅噪阶段的流匹配回归损失。实验中将图像流对抗权重设为 (文本流对抗权重占 ),回归损失权重 。
训练共进行 20,000 步:前 5,000 步采用包含 的 Off-policy 训练;后 15,000 步切换为纯对抗的 On-policy 训练(置 ),由学生模型自身轨迹展开的状态提供判别样本。
实验与结果
NitroFusion2 选用 6B 参数的 Z-Image-Turbo 作为基础骨干,判别器骨干网络在训练期间完全冻结。训练数据包含 100k 张由 Z-Image-Turbo 跑 12 步生成的 图像,使用 8 张 NVIDIA H100 GPU 训练。
评测覆盖排版文字基准 LongText-Bench(英文 EN 与中文 CN)、图文综合基准 GenEval、细粒度属性对齐基准 DPG-Bench 以及全能评测集 OneIG-Bench。
少步生成基准评测:单步性能显著领先
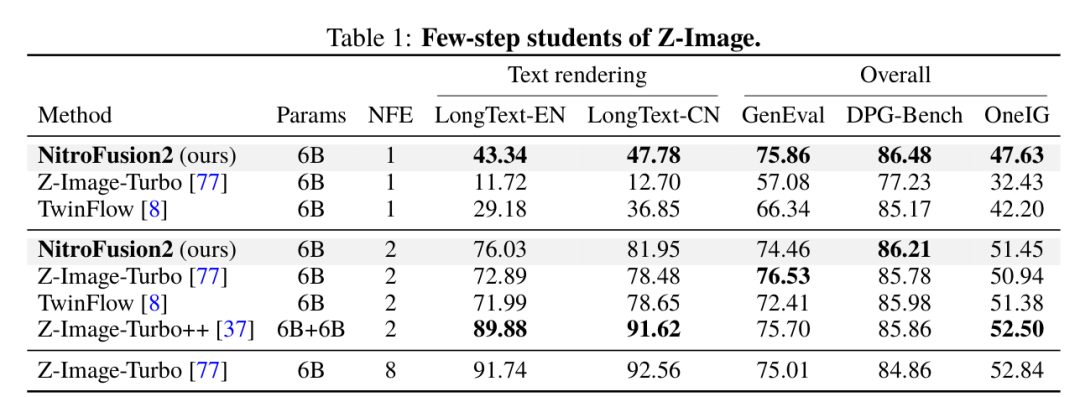
表 1:Z-Image 衍生少步学生模型在 1 步与 2 步采样下的定量对比。
如表 1 所示,在极端的单步(1 NFE)生成设置下:
NitroFusion2 取得了 全指标第一 的成绩。在文字渲染方面,LongText-EN 达到 43.34,LongText-CN 达到 47.78,分别超出同参数基线 TwinFlow 14.16 分和 10.93 分;
在 DPG-Bench(86.48)和 GenEval(75.86)上,NitroFusion2 单步表现甚至超越了需要 8 步采样的原始教师模型(分别为 84.86 与 75.01),实现了 8 倍采样加速下的无损转换。
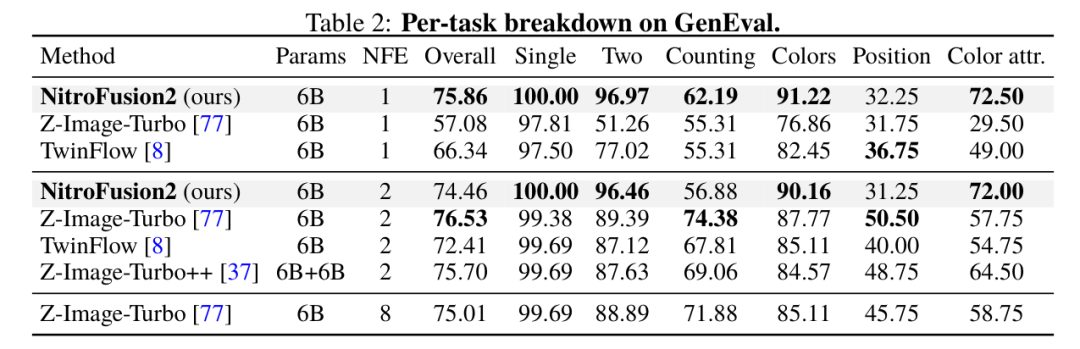
表 2:GenEval 细分类别任务评测得分拆解。
表 2 的 GenEval 细分项进一步证实,NitroFusion2 在单目标、双目标组合、基础颜色及颜色属性绑定等多项复杂语义理解指标上均处于绝对领先水平。
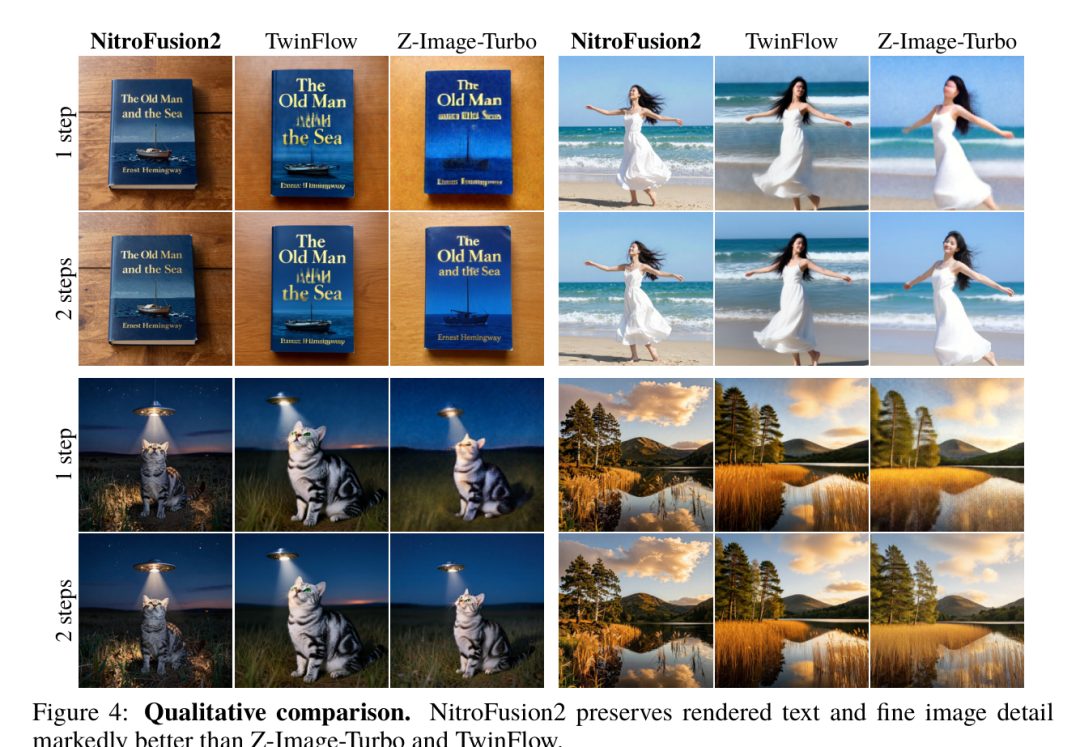
图 4:定性生成结果对比。NitroFusion2 在 1 步采样下即可清晰呈现书名横幅字体,而对比方案在单步下多呈现模糊畸变。
定性对比(图 4)直观反映了文本流判别的优势:在单步采样下,NitroFusion2 可以直接呈现出清晰可读的《The Old Man and the Sea》书名标题与规整字形,而 Z-Image-Turbo 和 TwinFlow 均出现了字形扭曲或边缘弥散。
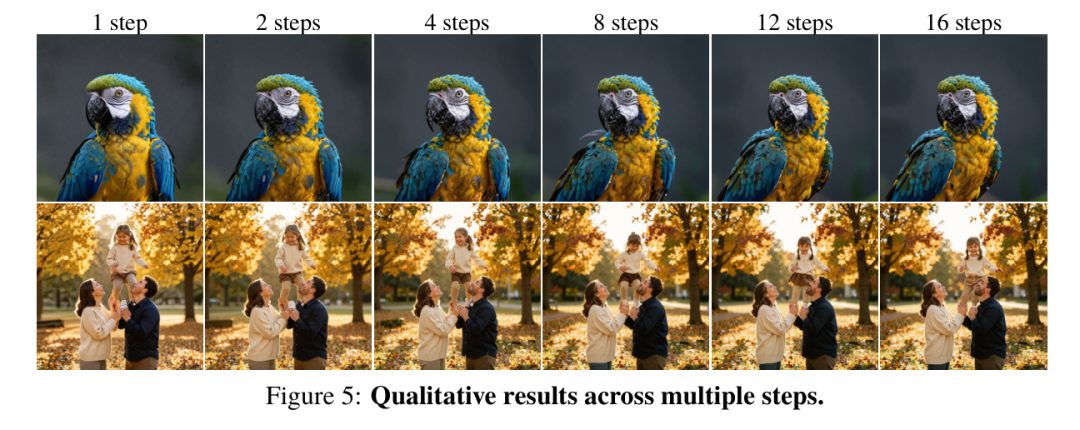
图 5:NitroFusion2 在不同采样步数(1 到 16 步)下的生成质量进阶变化。
与超大参数开源极速模型的跨级较量
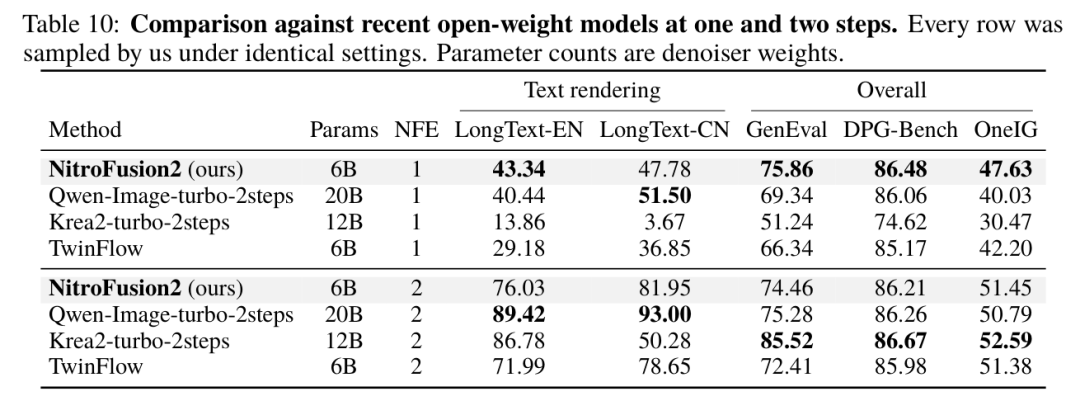
表 3(对应原论文 Table 10):NitroFusion2 与近期开源的 12B/20B 级 Turbo 模型对比。
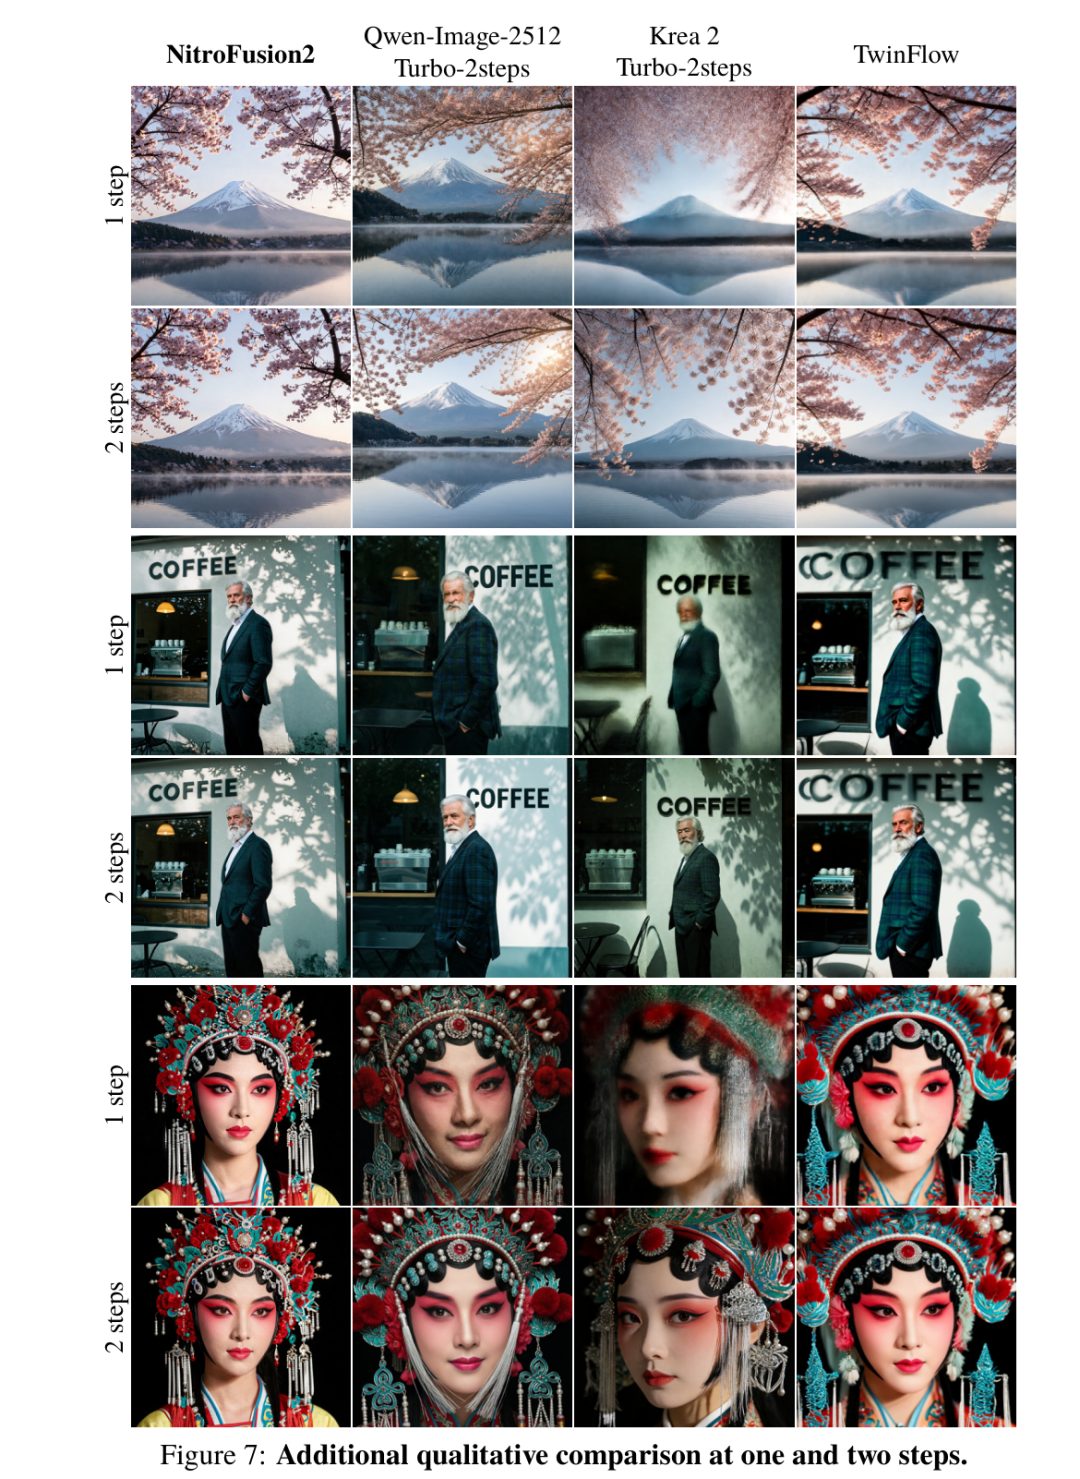
图 6(对应原论文 Figure 7):与 Qwen-Image-2512 Turbo(20B)和 Krea 2 Turbo(12B)的定性视觉比对。
将 6B 参数的 NitroFusion2 与参数量远大于自身的模型对比(表 3 与图 6):在 1 步采样下,NitroFusion2 在 LongText-EN、GenEval、DPG-Bench 及 OneIG 四项指标上全面超越了 20B 的 Qwen-Image-turbo-2steps 以及 12B 的 Krea2-turbo-2steps,证明了判别器表征设计对蒸馏效率的关键驱动作用。
核心机制消融解析
研究人员通过针对性消融,逐层验证了核心设计的必要性:
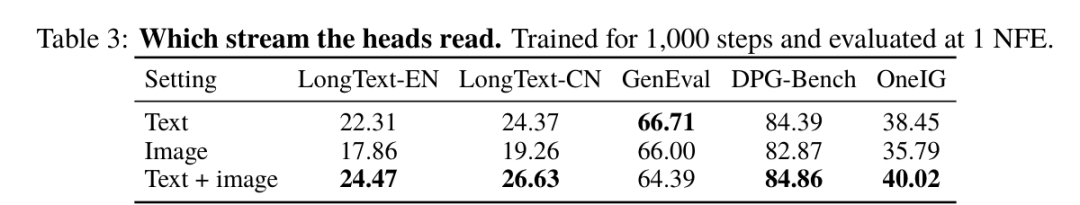
表 4(对应原论文 Table 3):判别流位置消融实验(1,000 步训练,1 NFE 评测)。
文本流 vs 图像流:如表 4 所示,单纯采用文本流判别,在所有 5 项基准指标上均全面碾压传统的纯图像流判别;双流联合则在 LongText 与 DPG 指标上达到最优综合性能。
属性线索的调控效应:如表 5(对应原论文 Table 4)所示,单独采用 Typography 线索训练,英文和中文文本渲染得分分别剧增至 45.06 与 53.01;而混合全部 7 类线索的 ACD 策略在多项全局对齐指标上拔得头筹,验证了动态线索对不同生成维度的平衡调控能力。
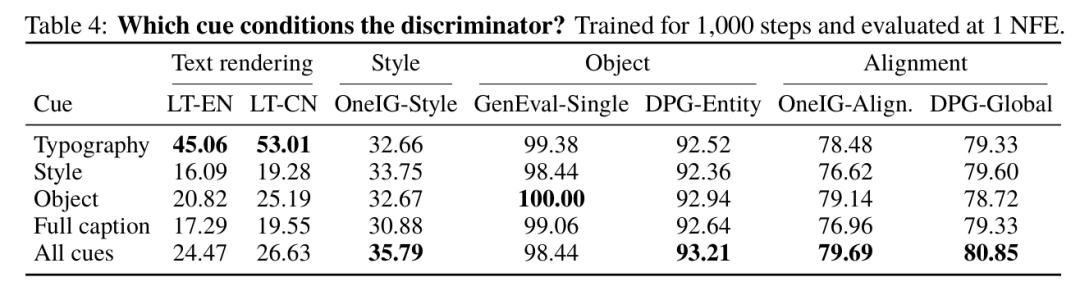
表 5(对应原论文 Table 4):判别器线索输入消融分析。
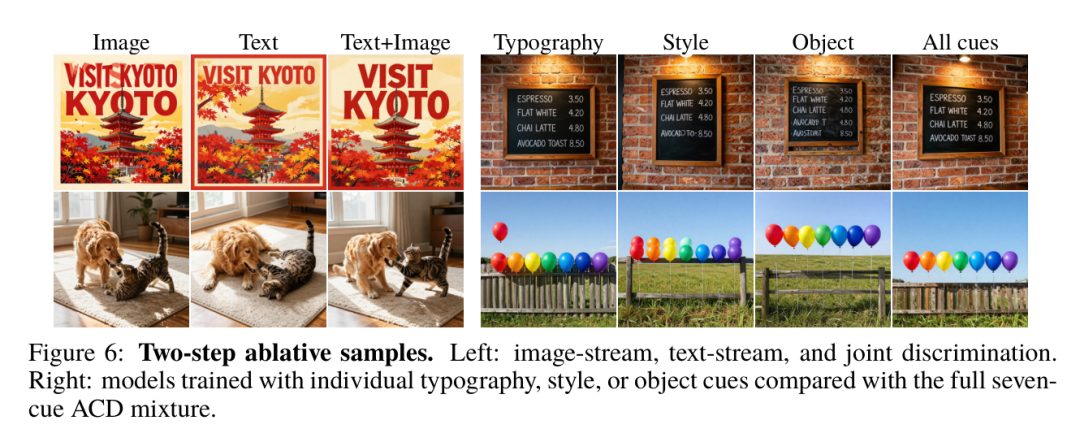
图 7(对应原论文 Figure 6):判别流与线索消融定性图。左侧展示双流协作消除伪影,右侧展示排版线索对菜单排版的直接增强。
写在最后
NitroFusion2 传递了一个清晰的技术洞见:在多模态扩散架构中,文本流不再仅仅是只读的输入条件,在经过联合注意力计算后,它本身就是一种富含图像结构信息且高度可控的判别表征。
当然,该方案在当前阶段仍存在局限性:在极端单步生成下,复杂多主体的构图仍偶见瑕疵;强对抗蒸馏不可避免地带来了样本多样性的轻微折损;同时,属性线索之间客观存在“跷跷板效应”(强化特定线索时会对其他属性产生轻度牵制)。如何自适应平衡属性线索权重,以及深入探究文本表征在更广泛的多模态生成与控制任务中的监督潜力,是值得社区继续探索的方向。
论文标题: NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers
机构: 英国萨里大学、图灵精英研究实验室
代码仓库: https://github.com/chendaryen/nitrofusion2 (已开源)
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。