烧算力不烧心!如何在学术界小心地做Scaling?
原创 Tianzhe Chu 2026-11-12 20:35 北京
把GPU花在刀刃上
GPU 总是不够用,实验却未必越大越好。如何用有限的算力,找到值得投入更多资源的研究方向?
©作者 |Tianzhe Chu
小红书 |@Leslie Chu
这几个月,我一边劳累地管理集群,一边和 Druv 把 Nestor 搓了出来。本文就是这段经历的产物。
学校集群通常就有这么一个日经或月经的问题:大家都认为自己的 project 很重要,都想要更多的资源来跑,而出于对各位老师同学的尊重,我又不能直愣愣地说某些 project 是**,纯在浪费。
即便如此,眼睁睁地看着某些低利用率的任务在集群上跑,我的心在滴血。学校的计算资源一般都来自政府资助,所以无脑烧 GPU 约等于无脑烧爸爸妈妈交出去的税钱。
本文旨在给我们组的同学一些基本且必要的入门指导。我希望看完这篇文章的同学至少对 GPU 使用有个概念,如果能学会一些 prompt agent 的知识那就更好了。
本文分以下这几部分:
科学部分,大概介绍一下 scaling ladder 是什么,我们为什么要用?
经验部分,在具体实验里该怎么运用它?
在找老师要更多 GPU 之前你应该注意的事情。
Scaling Ladder是什么,为什么要用?
具体的 scaling law 讲解有很多,比如这些 [2]。这周我在大书特书这篇博客的时候,很巧看到 purshow 老师写的博客也在讲这个 [1]。
这里我们就简单讲一下,当你有至少四组实验记录横跨不同的计算量,你就可以拟合下面这个指数曲线:
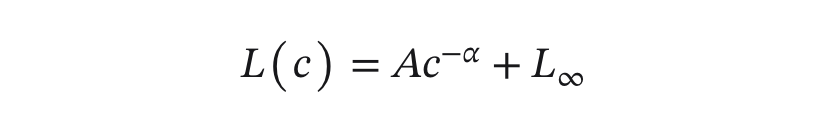
这条曲线出自这里 [6](欢迎历史学家纠正或者补充)。当你有了这个曲线,你就可以轻松地做两件事:
首先,你不需要真的跑更大的实验,就可以预测更大实验的性能(或者你有足够的 compute,小规模数据点预测的曲线也可以帮你验证大实验到底对不对);
其次,你可以用各自的曲线来比较两种模型哪个更 work。
因为所有的比较、预测所需的计算量都可以根据模型结构的设计算出理论的浮点数运算,你在跑大规模实验的时候就不烧心了。
受 Prof. Tatsunori Hashimoto 的课的启发 [3],我想到了另一个解答为什么的角度:
1.1 scaling ladder是PhD学生的完美预测目标
现在我们反着想这个问题,当你在训神经网络的时候,你其实正在用这些实验记录反向训练你的大脑。
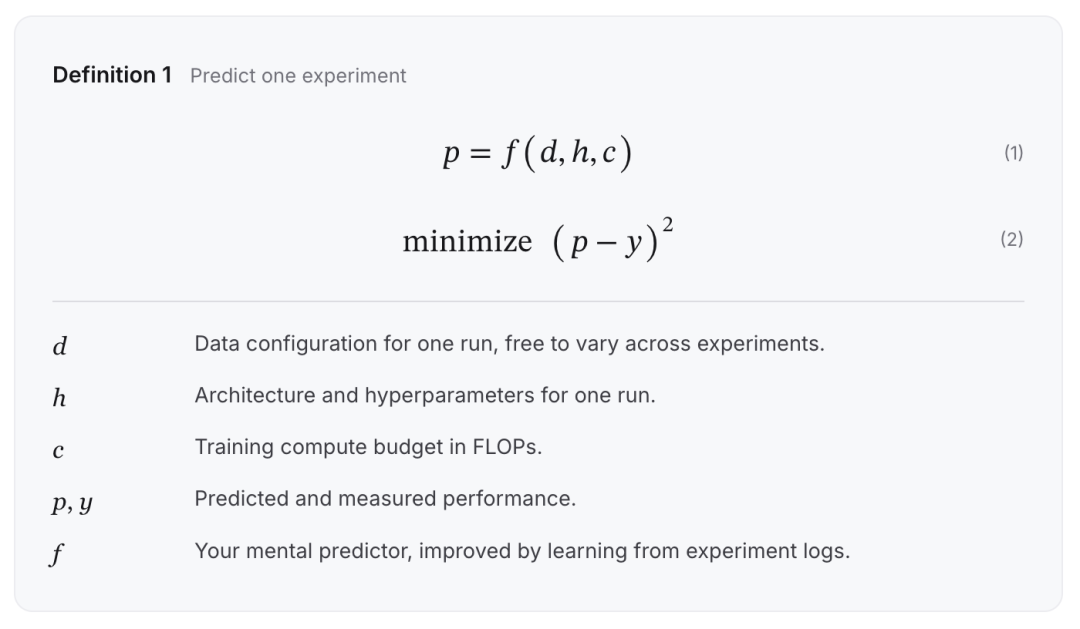
你的实验记录里包含了输入(数据,模型结构,计算量)和标签(模型的效果),这样一来你的 PhD 生涯就可以按照式 2 的方式来最小化预测损失。
但是呢,很可能单个模型效果不是一个很好的预测目标,比如首先这里是 L2 loss,不好;其次可能这些模型效果没有一个很好的分布,你的大脑学不太来。
最后,由于这个不同超参数、数据配比、模型结构的排列组合的数据量过于大,大脑的容量可能存不下来。
Q:那我吗该如何让这个学习过程更高效呢? A:我推荐使用 scaling ladder,或者说至少做实验的时候对它有个概念。
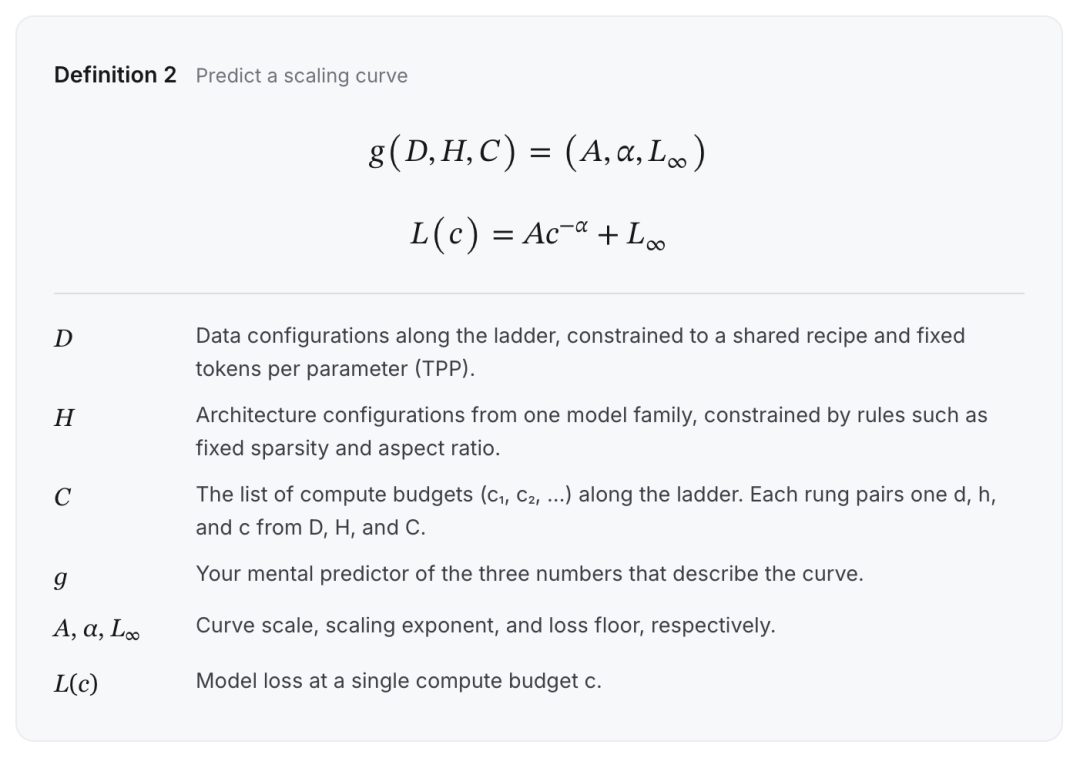
这里,输入和预测目标都变了。
我们改用了一种更加有结构、有约束的输入:scaling ladder 要求固定的 token per parameters(TPP)预算;在模型结构配置上,我们至少也要固定稀疏度、深度/宽度比,等等。
在预测目标是,我们把一个O(n)复杂度的数据点预测变成了 3 个变量的预测。
这种设计其实可以看作是数据增强手段:我们不光增强了数据点之间的相关性,我们还减小了预测目标的噪声和复杂度。这太好了。
经验教训
你真要着手开始做 scaling ladder 实验之前,有两件事必须先搞懂,你的横轴纵轴的值选啥。
通常,横轴我们就用 FLOPs,更实在一点就选真实的 GPU 训练时间,但纵轴,除非你做语言模型,挺难选的。
我老板是计算机视觉出身,他一开始比较抗拒我为啥转战语言了,但最后还是被我的证据说服了——我在 ImageNet 上怎么折腾都没啥成功迹象的模型一换 DCLM 就一切水到渠成了。
因此,下面的这部分内容会假设读者就说做语言模型预训练,或者你用同样的方式在训多模态语言模型,或者你已经发明了你领域完美的纵轴统计量。
2.1 配置
你有纵轴以后,你要选的下一个问题就是每个具体的数据点的配置该怎么选。通常我们就按 1x 2x 4x 8x,这样可以在 log scale 下均匀分布在图上,非常的漂亮。
之后呢,你还得保证你的模型训够了足够的数据。
TPP 通常是越高越好,Chinchilla optimal 建议选 TPP 为20 [7];对 MoE 来说,最优 TPP 有一些别的计算方式 [8]。
但因为在学术界,我们的计算资源比较少,所以别选太大。我们的 Nestor paper 选了 50 [5]。
在配置模型结构的时候,有一个问题可能会让你挠头:究竟要不要抹平不同变体在 FLOPs 上的差别呢?
比如说,你想比较 A 结构和 B 结构,而 B 结构有一个小的 sparse attention 改动使它的 FLOPs 变小了。
即使 scaling ladder 不要求每个数据点都一一对应相等的 FLOPs,我们在资源有限的情况下,最好还是想着补偿 B 结构一点,来达成 FLOPs 上的一致性。
这样一来,每个数据点都可以直接比较,如果明显在小规模上就比基准线好,扩大规模的时候就不烧心了。
2.2 MFU
在配置完所有东西之后,就该开始跑实验了。最简单的方式是直接 prompt agent 让它“给我拼命跑实验,把 MFU 拉满”。
但光这句话通常不够用——举个例子,Nestor 的原生 kernel 就被推特上的哥们轻松干翻了 [4]。以下是我从苦难中总结的两个教训:
并行策略和规模是绑定的。我翻了下实验记录发现了一些搞笑的事:在 200M 规模的实验里,shard 优化器会让实验变慢;而在 1B 规模的实验里,并行则可以允许更大的 batch size。
总体经验是:花哨的分片策略对大模型 MFU 有帮助,但小模型上你只能忍了,别折腾。
请特别注意每一步的实际计算量。GPU 通常跑大块的、规则的矩阵乘法效率最高,拆成一堆小 matmul 就会利用率不足,而且会在 kernel 之间产生启动气泡 [9]。
MoE 和 Nestor 就是两个经典例子——先不管负载均衡,MoE 切片了 FFN 矩阵,Nestor 还额外切片了注意力投影。
所以三个 FLOPs 相等的模型天然有一个 MFU 排序:dense > MoE > Nestor,虽然高级的基础设施魔法在大规模上可能缩小这个差距。
计算之外,通信也可能咬你一口。在 Nestor 早期的一次多节点实验中,梯度本应只在每个优化器步同步一次,结果 torch.compile 包裹模型后,辅助函数没认出 DDP 实例,悄无声息地跳过了 no_sync,结果梯度在每个 microbatch 后都在同步。
雪上加霜的是,网络配置还把跨节点流量全部塞进了一个网络端口。
以上经验都是和 agent 交流过程中积累的。虽然 Claude 的 infra 技能可能比我强得多,但要是 MFU 值不对劲,或者分解出来的实际计算量有问题,还是得推它一把的。
2.3 瓶颈不一定是芯片
瓶颈可能压根不在芯片身上,尤其是做视觉或机器人的同学,可能是数据加载、模拟器渲染等等;做 RL 的同学可能是推理引擎的速度、RL 算法本身、训练引擎和推理引擎数量的分配。
说到底,找我要卡之前,先确认一下你的瓶颈真的是算力吗。
找老师要GPU之前的检查清单
☑️ 你应该继续做这个项目吗?
我们提一个指标:
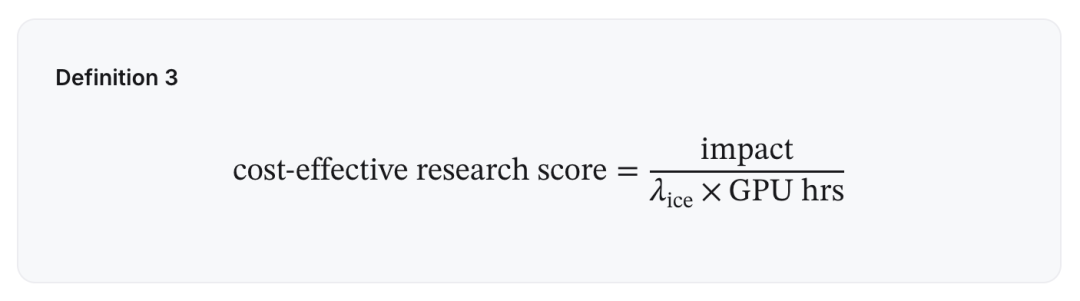
其中 GPU hrs 只算最终保留在正文里的实验。你的目标应该是优化这个指标,而不是只想着怎么把 impact 拉满但烧掉多少 GPU 小时无所谓。
为了给大家一个粗略的算力成本感知,以下是论文中实验的 H200 等价估算,假设 MFU 20%:
ResNet: H200 GPU 小时
Transformer: H200 GPU 小时
(粗估)。更不必说大伙的 project 大概率影响力也小于这俩。
☑️ 你最小的实验需要多少 GPU 时间?
假设你组有 K 张 GPU,m 个活跃用户。你分到的配额就是 K/m。
一个合理的最小实验应该用不超过 K/m × 1/4 的卡,一天之内跑完,给你留出足够的调参空间。
然后遵循严格的升级规则:把成功的实验升级到 1/2 × K/m 卡 → K/m 卡 → 找导师要超配 → 找我或者 Yi 老师申请临时额外配额。
☑️ 你现在的 MFU 是多少?
你的瓶颈真的是卡不够吗?还是像第二部分提到的那些别的问题?
☑️ 你有没有调优你的超参数,或者应用 μP [10]?
☑️ 你有没有先跑几个小规模数据点,并证明你的 ladder 赢了基线?
☑️ 你有没有跟组员协调一下,看看有没有闲置的任务可以杀掉?
致谢与结语
白金致谢位:
https://github.com/Ma-Lab-Berkeley/Nestor
感谢 Druv 和朋友们的锐评。

参考文献

[1] https://x.com/purshow04/status/2117994165187531061
[2] https://github.com/stanford-cs336/lectures/blob/main/lecture_09.pdf
[3] https://deep-learning-alchemy.github.io/
[4] https://x.com/deepaksinghml/status/2117649184773882239
[5] https://arxiv.org/abs/2610.31818
[6] https://arxiv.org/abs/2001.08361
[7] https://arxiv.org/abs/2203.15556
[8] https://arxiv.org/html/2509.23678#A7
[9] https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html
[10] https://arxiv.org/abs/2203.03466
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。