AI自己改科研策略,能过湿实验这一关吗?他们把RSI带入分子发现
机器之心 2026-11-14 11:34 山东
MolRSI 获得了 8 个满足实验特异性判据的结合命中,Claude Science 对照为 0。
寻找新的抗菌分子,要在海量候选中同时权衡抑菌活性、细胞毒性和结构新颖性。MolRSI 自主优化这一筛选流程,湿实验命中率达到 15.9%,此前人类专家设计的非智能体工作流为 8.7%,相对提高约 82%。 两者使用相同的训练数据和约 1210 万个化合物的筛选库,按同一 MSSA 抑菌标准统计命中。
在分子发现中,用哪个模型、怎样组合筛选条件、哪些候选值得送去实验,都需要作出选择。MolRSI 将这些选择纳入搜索,并利用过去任务中积累的经验,改进下一次选择和优化工作流的策略。
研究团队还让 MolRSI 从头设计能够选择性识别 pMHC 的结合蛋白。pMHC 由细胞表面的 MHC 分子及其呈递的短肽组成。难点在于,目标与非目标可能共用同一 MHC,仅在少数肽残基上存在差异。患者的肿瘤抗原和 HLA(人类 MHC)类型可能不同;针对相应 pMHC 定制的结合蛋白,有望成为工程化免疫细胞的识别部件,帮助其识别对应的肿瘤细胞,用于个体化癌症免疫治疗。
在本研究的两个 pMHC 靶标上,MolRSI 获得了 8 个满足实验特异性判据的结合命中,Claude Science 对照为 0。 两者使用相同的设计条件和计算预算。
这两类任务带来了同一个问题:MolRSI 究竟优化出了怎样的流程,过去的搜索经验又具体改变了哪些选择?
论文:MoLRSI: A Recursive Self-Improving AI agent for Molecular Discovery
找分子之前 先学会怎样找
面对数以千万计的候选分子,研究者需要先决定一条筛选路线:用什么模型预测活性,怎样控制毒性风险,哪些候选值得送进实验室。模型、训练方法和筛选规则的不同组合,会把研究引向不同的分子。寻找一套好流程,本身就是一道搜索题。
MolRSI 把这道题交给了 AI。系统从论文和代码中整理方法,将它们转化为经过运行验证的可执行技能,再组合、测试和修改工作流。一次尝试结束后,得到的不只是一个分数,还有这套流程在哪些条件下有效、哪次修改改善了表现,以及运行出错后怎样修复。
这些记录连接起了 MolRSI 的两个循环。内循环优化当前任务的工作流;外循环把积累的经验带入后续任务,改进搜索策略。 新任务开始时,系统可以据此选择起点、安排探索方向,并利用过去验证过的修改和修复方式。
具体来说,MolRSI 使用经验引导的蒙特卡洛树搜索:每套候选工作流是一个节点,对它的修改形成新的分支。当前任务的评价、相关任务的历史表现和对新方案的探索,共同影响下一步往哪里走。方案记忆、改进记忆和执行记忆,则分别保存流程表现、修改效果和运行经验。
搜索产生经验,经验改变后续的 search policy,新的搜索再带来新的经验。 MolRSI 的递归自我改进由此发生在科研工作流的搜索过程中。
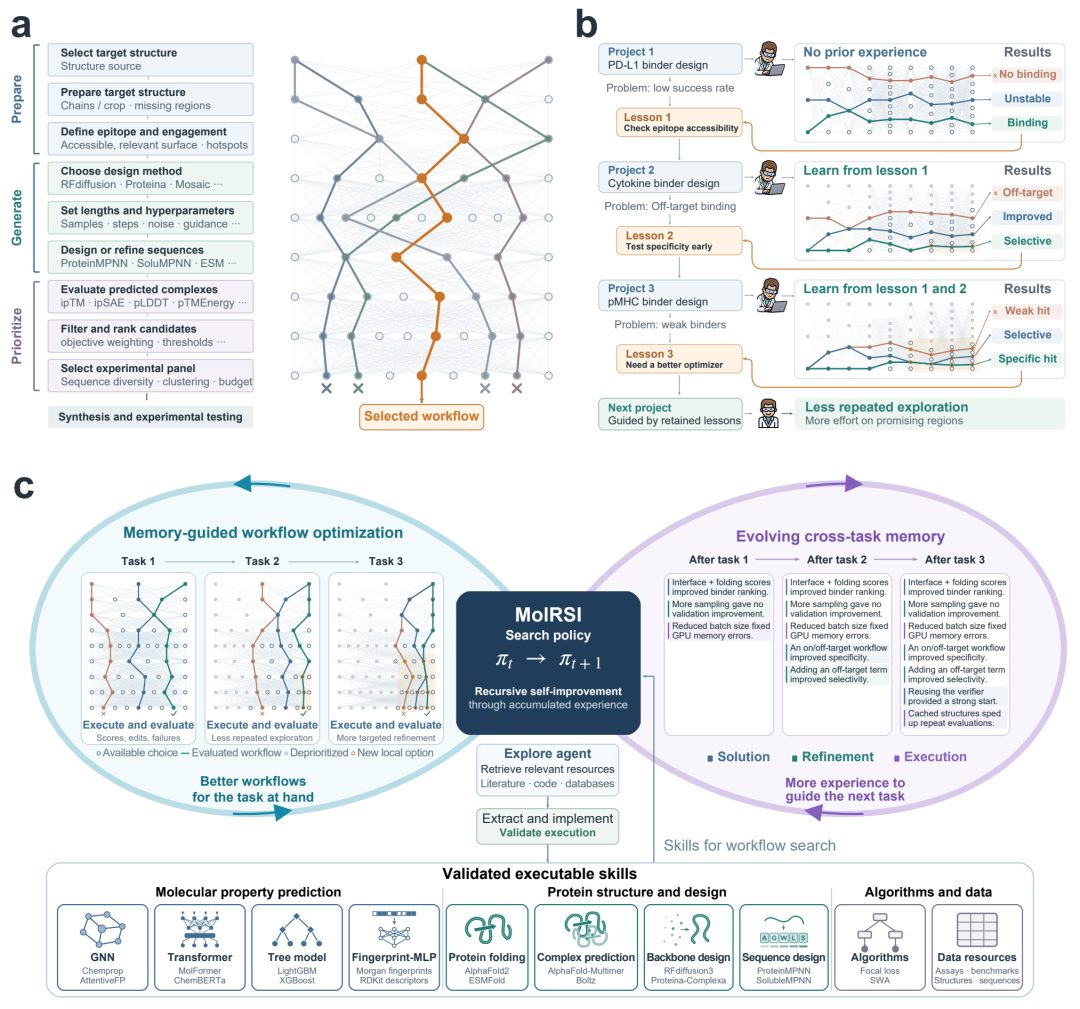
图 1|MolRSI 的双循环。内循环搜索和优化当前工作流,外循环积累并复用经验,影响后续任务中的工作流选择、修改和执行。来源:论文图 1。
带着经验出发
第一次尝试会有什么不同
把经验存下来之后,下一次搜索真的会更好吗?团队先让 MolRSI 在 25 个分子性质预测和细胞毒性任务上积累经验,再把它放到 6 个未进入来源经验池的抗菌预测任务中。
对照设置很直接:两组使用相同的初始技能库、底层模型和搜索预算,也都能利用当前任务中产生的记录;只有一组能够继承过去任务的经验。结果,加入跨任务经验后,6 项任务的平均测试 AUPRC 均有提高。这一指标衡量模型将活性分子排在候选列表前列的能力。
经验的价值,在搜索刚开始时就能显现。大肠杆菌和淋病奈瑟菌两项任务中,MolRSI 首次评估的工作流,已经超过 Biomni、STELLA、Codex、Claude Code 和 Claude Science 各自经过 20 轮搜索选出的最终流程。过去的搜索记录,让新任务有了更好的起点。
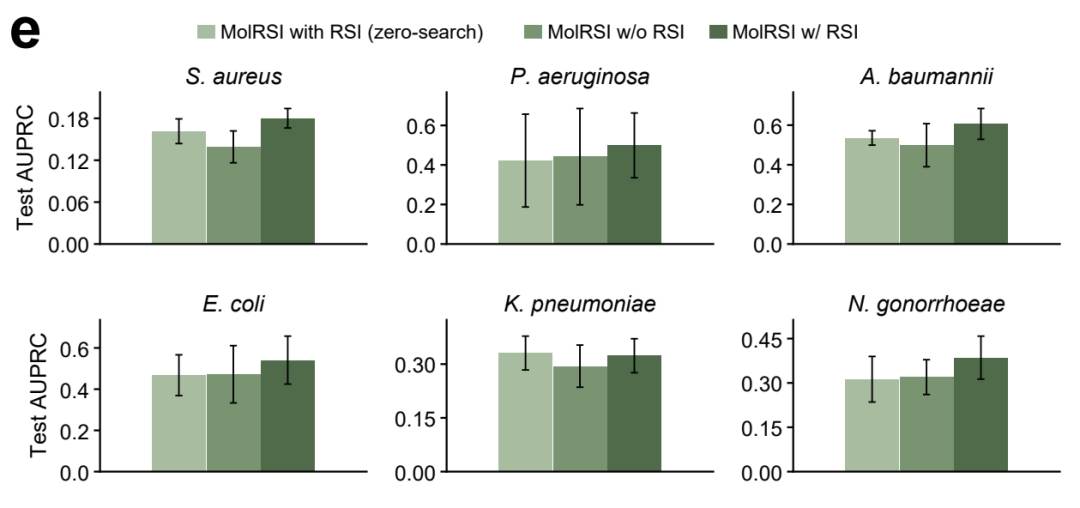
图 2|有无跨任务经验的比较。两组均保留当前任务内的记忆更新,w/ RSI 另行继承来源任务经验。zero-search 直接迁移配置,仍需目标任务上的模型训练和验证。来源:论文图 2e。
继续积累经验,会怎样?团队将来源任务池从 2 个逐步扩大到 25 个,回顾性分析其中可供后续任务迁移的工作流。它们在 6 项抗菌任务上的平均测试 AUPRC,从约 0.32 升至约 0.37,超过了无先前经验系统搜索 20 轮后的 0.361。
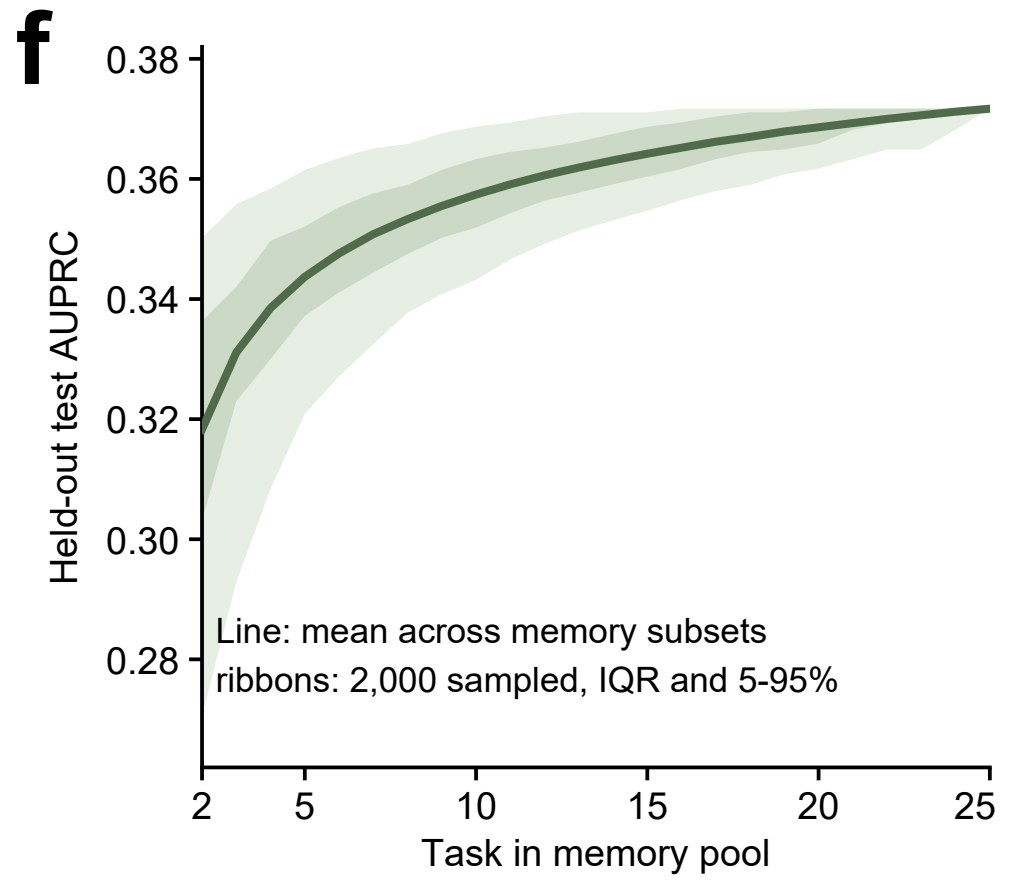
图 3|来源任务越多,可供迁移的工作流表现越好。实线为各规模经验池可获得迁移表现的回顾性平均;深、浅阴影为经验池组合的 25%–75% 和 5%–95% 分位范围。来源:论文图 2f。
这项回顾性分析说明,更多经验能让更好的工作流进入可迁移的方法库。
从千万个化合物中
筛出值得做实验的候选
基准上的分数提高,最终还要回答一个实际问题:这样的工作流,能否让有限的实验机会找到更多活性分子?
在抗菌发现任务中,MolRSI 优化出了怎样的筛选路线?它先做结构新颖性过滤,剔除指定的常见抗生素骨架及与已知抗生素过于相似的候选,再针对三类人体细胞预测毒性。活性排序则采用两种 MiniMol 方案与 LANTERN–RADR 集成,按 55%、30% 和 15% 的权重组合预测结果。
排序之后,系统把结构相似的分子聚成一组,再从不同组中挑选候选,保留化学多样性。最终流程把模型组合、筛选顺序和选样方式连接起来,从约 1210 万个化合物中选出 107 个进行实验,获得 17 个命中。
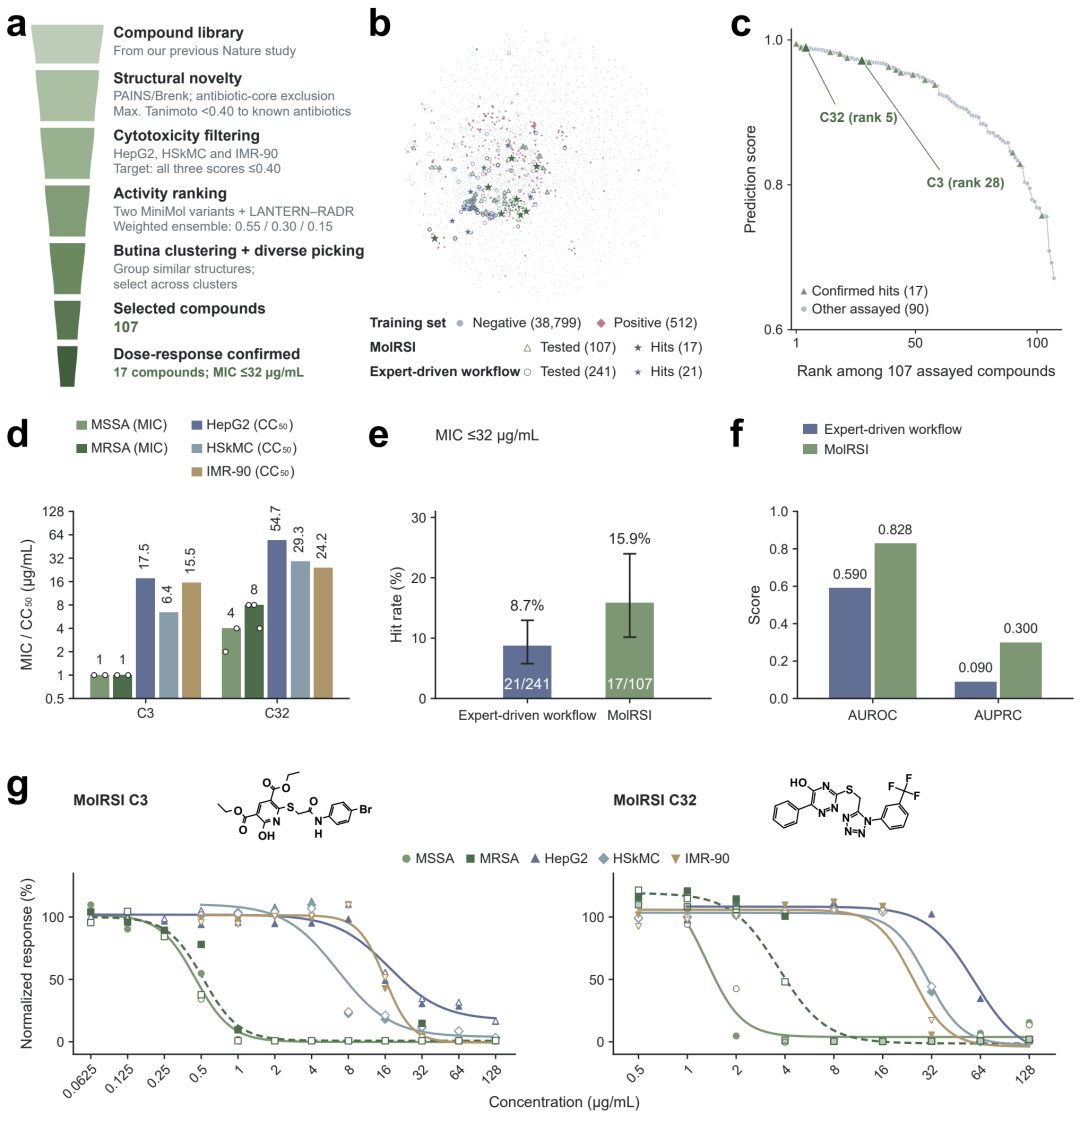
图 4|MolRSI 与人类专家设计的非智能体工作流比较。命中率为 17/107 与 21/241,均以 MSSA MIC≤32 μg/mL 定义命中;C3、C32 的 MRSA 活性另行测定。来源:论文图 3。
对比此前人类专家设计的非智能体工作流,两者使用相同的训练数据和筛选库,也按同一阈值统计命中:对甲氧西林敏感金黄色葡萄球菌(MSSA)的最低抑菌浓度(MIC)不高于 32 μg/mL。专家流程测试了 241 个化合物,命中 21 个;MolRSI 测试 107 个,命中 17 个。实验命中率由此从 8.7% 提高到 15.9%,相对提高约 82%。
同一组 271 个独立测试化合物提供了另一项比较:MolRSI 的抗菌活性预测器,在 AUROC 和 AUPRC 上均优于专家工作流中的预测器。其中,AUPRC 从 0.090 提高到 0.300。这一比较使用同一测试集;前述命中率则来自两套流程各自选出的实验候选。
团队还对代表性分子做了进一步测试。C3 和 C32 对耐甲氧西林金黄色葡萄球菌(MRSA)的 MIC 分别为 1 和 8 μg/mL;在三类人体细胞中,两者的半数细胞毒性浓度均高于对应的 MRSA 抑菌浓度。剂量响应曲线将筛选中的预测,落实到了分子的实际活性表现上。
设计结合蛋白
还要认准目标
抗菌任务的起点,是一座现成的化合物库。另一条独立的验证路线,则要求 AI 从头设计 pMHC 结合蛋白,并让它们在相似靶标之间作出区分。
pMHC 可以理解为细胞表面的短肽展示台:MHC 托住一段肽,把它呈递出来。两个靶标可能共用相同的 MHC 框架,仅在肽的少数暴露残基上有所不同。一个看起来结合得很好的候选,也可能主要识别了共同的框架。因此,流程既要判断能否形成可信的结合,还要检查换一条肽之后,候选是否仍然得到同样高的评价。
MolRSI 先从 14 个小蛋白结合分子排序任务中积累经验,再用两组 gp100 数据开发 pMHC 排序流程,将 MART-1 留作独立测试。有先前经验时,排名前 1% 和前 2% 候选的富集因子分别达到 3.65 和 5.55;去掉这些经验,两项均为 0。
这次搜索留下了一套具体的评价流程:ESMFold2-Fast 结构预测,加上八项等权评分。八项指标覆盖界面接触、复合物与界面可信度、单体折叠可信度及螺旋结构特征,先统一为 “越大越好” 的方向,再相加得到排名依据。MolRSI 搜索和选择的是预测模型与评分项的组合。
选择性则通过目标与非目标的配对比较落实到最终筛选中。在研究预先给定的配对里,同一个 binder 分别与两种 pMHC 接受评估:MHC 框架保持相同,只替换呈递的肽。候选须满足目标评分高于非目标评分,并通过界面可信度、单体折叠质量等门槛,随后按目标评分排序。这样,目标结合质量和对相似非目标的区分能力,就成为需要同时考虑的条件。
有了排序流程,MolRSI 将它固定下来,分别为 MART-1 和 SARS-CoV-1 搜索生成方法与配置。每个方案依次经过骨架生成、肽热点接触过滤、SolubleMPNN 序列设计和评分,以排名前 5% 候选的平均分评价方案。30 轮搜索后,得分最高的三个工作流各自扩大生成规模,再合并、去重并筛选候选。先开发评价方法,再用固定的评价方法优化生成,构成了这条设计流程的主线。
前瞻设计阶段,MolRSI 与 Claude Science 使用相同的目标与非目标设定、设计限制和计算预算,各自运行自己的工作流。经过两轮噬菌体展示筛选,MolRSI 在 251 个可评估的 MART-1 设计中获得 5 个特异性结合命中,在 266 个 SARS-CoV-1 设计中获得 3 个;Claude Science 的对应结果为 0/288 和 0/267。两类靶标合计,特异性结合命中为 8 比 0。
这里的实验判据是目标富集 log₂FC>4,且高于该设计所有可测非目标中的最高富集值。它检验的是相对于所测非目标的结合偏好,与前面的计算评分是两套不同的量;定量亲和力和更广泛的交叉反应仍需后续测定。
候选排序到底有没有帮助?去掉 MolRSI 的排序环节后,两个靶标合计 479 个可评估设计中,没有一个满足同样的特异性命中判据。这项对照支持了候选排序对本次实验命中的贡献:生成之后,怎样判断哪些设计值得送去实验,是流程中的关键一步。
代表性命中的预测复合物结构还显示,binder 位于暴露肽上方,可能与多个肽残基形成接触。这与流程希望识别肽差异的设计目标一致,也为读者理解选择性提供了直观线索;具体接触的作用仍需结构与功能实验验证。
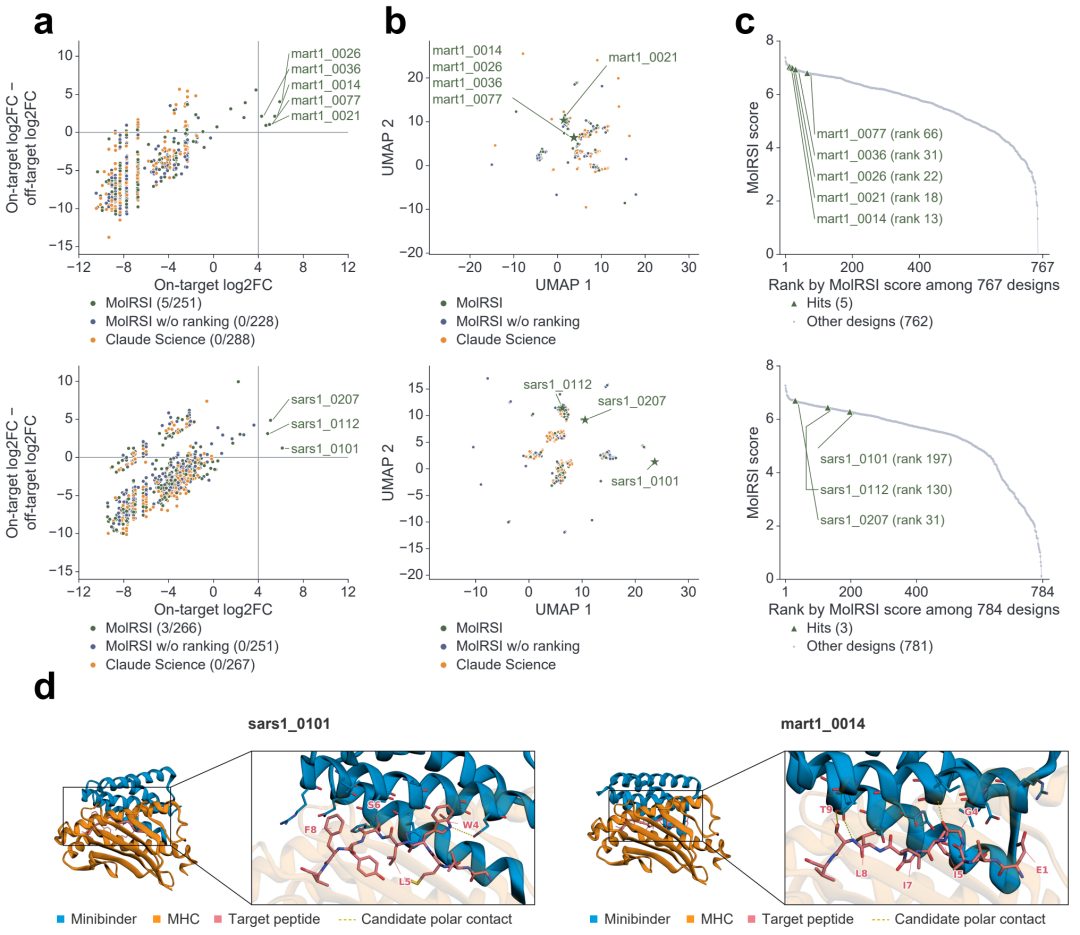
图 5|MART-1 和 SARS-CoV-1 两类 pMHC 靶标的实验验证。计数为 “特异性结合命中数 / 可评估设计数”;散点展示目标富集及其相对非目标的差异,下方为预测复合物结构。来源:论文图 5。
一次研究结束后,MolRSI 留下了进入实验验证的候选,也留下了下一项任务可以复用的工作流与搜索经验。当前的策略改进主要来自计算搜索,未来还可进一步纳入湿实验反馈。让一次研究为下一次研究提供更好的搜索起点,正是这项工作的出发点。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
本文转载自微信公众号「机器之心」,查看原文。版权归原作者所有,如有侵权请联系删除。