为什么你的 AI 智能体解不出 CTF 题:Pwn 篇
TeamH4C 2026-11-15 14:33 中国香港
AI 智能体可以找到漏洞并写出利用代码,却依然拿不到 flag。它可能覆盖了函数指针,却没有拿到应该写入的地址;也可能误判崩溃原因,一遍遍重复同样的输入。生成代码之后还有更多工作:检查利用所需的条件,并纠正失败。
成功拿到 flag 的案例同样存在,但需要区分两类提升:更换模型带来的提升,与更换工具和执行流程带来的提升。继续逆向工程与 Web 渗透两篇之后,本文考察 Pwn 题中信息收集、利用设计、执行与验证各环节在哪里出现断裂。
目录
模型与 Harness 如何影响解题表现
缺失的分析输入与工具观测
发现漏洞与构造可用利用之间的差距
误读执行状态与修正输入
诊断失败并决定从何处重试
定义成功并验证利用行为
结论
参考文献
模型与 Harness 如何影响解题表现
只看模型能力,不足以判断智能体解 pwn 题的水平。即使模型相同,结果也取决于智能体能否调用所需工具,并利用执行结果指导下一次尝试。Harness(执行框架)是管理这些工具调用、返回调用结果、维护工作记录并处理重试的执行环境。它还可以把任务委派给专攻分析或调试的智能体,并汇总它们的结果。
自动漏洞利用生成系统 Pwnagent 的研究者在固定模型的前提下,对比了启用与关闭动态测量及诊断引导迭代修复的配置。Pwnagent 把分析、动态测量和代码生成分配给各专职智能体,并将 GDB 的测量结果传递给代码生成阶段。执行失败时,诊断结果指引系统回头复查测量、实现或策略。对照配置保留了静态分析与智能体角色分工,但同时移除了动态测量和诊断引导迭代修复,只进行一次代码生成 [1]。
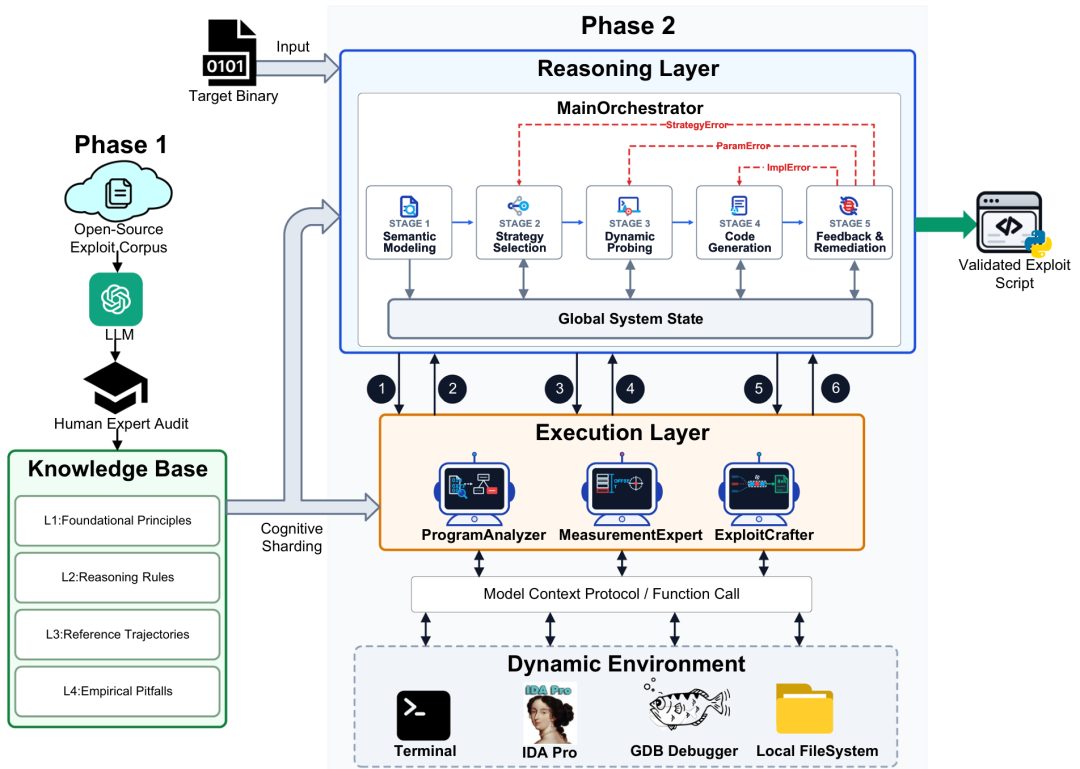
Pwnagent 的整体架构(原论文图 2,第 7 页)。第 3 阶段在运行时测量数值;第 5 阶段诊断失败,并返回前面的阶段进行修复。这里讨论的成功率,对比的是同时具备两项能力的配置与一次性生成代码、两项能力都缺失的配置 [1]。
两种配置都使用 Kimi-K2.6,在 66 道本地 CTF 题上,完整配置获得 shell 或读取 flag 的比例为 62.12%(41 题),移除两项能力后为 42.42%(28 题)。这一差距反映的是动态测量与迭代修复共同作用的效果 [1]。
Pwnagent 把分析结果、策略和测量数据记录在一个中央状态中,并传递给后续的智能体。其评测样本集中于栈类题目和 x86 架构 [1]。
CTF 智能体 EnIGMA 的研究者同样在固定模型的前提下比较了工具接口。在使用 Claude 3.5 Sonnet 的 44 道 pwn 题上,完整配置拿到 flag 的题目占 20.45%,同时移除 GDB 与远程连接接口后为 11.36%。评测采用单次运行,每道题预算 3 美元,一次运行内允许多次提交 flag [4]。
EnIGMA 是一个用于研究 CTF 解题工具接口的智能体。它提供启动和停止交互式工具、并向其发送命令的接口 [4]。
ExploitGym 提供了更换模型的对比。它评估智能体能否把漏洞验证(PoV)输入转化为能拿到 flag 的利用,并在相同的 Codex CLI 0.120.0 与 xhigh 推理强度下比较 GPT-5.4 和 GPT-5.5。在涵盖用户态程序、V8 和 Linux 内核的 898 个任务中,使用指定漏洞成功拿到 flag 的数量从 54 增加到 120。每个任务在受信任访问条件下允许 1 次最长 2 小时的尝试,安全缓解措施和部署时的安全过滤器均处于关闭状态 [2]。
ExploitGym 是一个在容器化环境中评估真实软件漏洞的基准。它除了检查漏洞是否被复现,还检查智能体是否在目标环境中拿到了 flag,以及是否使用了指定漏洞 [2]。
这些对比表明,固定模型时,解题表现会随 harness 变化;固定 harness 时,表现会随模型变化。智能体的表现是特定模型与 harness 组合的结果。因此解读成功率时,需要在模型名称之外,进一步查看工具、任务分配、重试流程和评估条件。
缺失的分析输入与工具观测
如果输入中缺少关键信息,智能体即使不断修改代码也无法推进。二进制分析可能遗漏某个库,智能体也可能无法查询只在运行时存在的数值。关键问题是,分析结果和工具输出是否真正把智能体所需的信息送到了它的输入中。
在 PwnGPT 的评估中,它把二进制分析结果传递给利用生成环节,而 qwen-plus、qwen-max 和 GPT-4o 在三道题上都没能收集到必要信息。其中之一是 rop-10,一道 64 位 ELF 二进制中的栈溢出题,预期解法为 ret2libc,即把执行流重定向到 libc 函数。分析模块没有处理动态链接库,因此遗漏了 libc gadget(可在利用中组合的短指令序列),也就无法组装生成利用所需的输入 [3]。
PwnGPT 是一个包含分析、生成和验证模块的自动漏洞利用生成框架。其分析模块从反编译输出中挑选关键函数和信息,用于构造生成阶段的输入 [3]。
当信息只在运行期间可得时,除了分析范围,智能体查询信息的方式同样重要。EnIGMA 针对的是以 shell 为中心、不支持独立交互会话的智能体。调试经常需要先查看内存,再决定接下来检查或执行什么,这使得单靠预先写好的脚本很难收集到全部所需观测。EnIGMA 在独立的交互会话中打开 GDB 和 pwntools 远程连接,让智能体在收到响应后继续发送命令。某个交互会话处于活动状态时,主 shell 仍然可用 [4]。
再次生成代码之前,智能体需要针对具体的遗漏调整信息收集方式。如果分析遗漏了 libc,如 rop-10 的情形,就分析该库并纳入所需 gadget,以填补输入缺口。如果需要运行时地址或状态,可以由 EnIGMA 提供的这类交互式工具查询并返回。修改代码之前,应先确认收集到的信息确实已经进入智能体的输入。
发现漏洞与构造可用利用之间的差距
发现漏洞或获得操纵内存的能力,并不意味着下一步所需的全部条件都已满足。覆盖函数指针,只有在存在可写入的有效执行地址时才有用。在这些中间条件尚未落实时就尝试最终操作,即便漏洞识别无误,利用也可能无法按预期工作。
Where Do LLM Agents Fail in Binary Exploitation? 研究了智能体在 28 道公开 CTF 题上的失败,每个智能体与题目的组合最多尝试 3 次,每次 60 分钟。C5 是研究中的一个题目编号,是一道编译为位置无关可执行文件(PIE)的 QuickJS 释放后使用(UAF)题。PIE 是一种构建配置,允许 ASLR 随机化可执行文件的代码基址;UAF 指访问已被释放的内存。Codex CLI/GPT-5.3 覆盖了函数指针,却跳过了地址泄露。没有有效地址,载荷发生崩溃,智能体耗尽了时间预算去重新设计利用 [5]。
Where Do LLM Agents Fail in Binary Exploitation? 是一篇 IEEE S&P 2026 海报研究,以执行日志中最后完成的阶段为依据分析失败点 [5]。
C5 在漏洞发现之后缺少的,是实际执行代码所需的地址。为区分这类缺口,研究者将执行日志中最后完成的状态分为五类 [5]。
- 漏洞发现:
找到有漏洞的代码,以及到达它的输入条件。
- PoC 验证:
检查能复现漏洞行为的输入或代码是否有效。
- 地址泄露:
获取利用所需的运行时地址。
- 原语构造:
构建内存读、写或控制流操纵的基本能力。
- 目标达成:
使用这些能力到达最终目标。本研究中指的是拿到 flag。
所需阶段及其顺序取决于具体解法。为减少被跳过的中间步骤,研究者提出设定明确、可验证的子目标,要求每个子目标成功后再继续。应用到 C5 上,就是分别验证函数指针覆盖,以及要写入该指针的有效地址的获取 [5]。
另一项 ExploitGym 评估展示了中间能力如何引向拿到 flag。GPT-5.4 修改了一个只会让 V8 调试版崩溃的输入,在发布版中构造出读原语。它验证了该原语,泄露了指针和 libc 地址,并把这些能力连接到目标容器中的代码执行和 flag 获取。这次成功发生在 d8(V8 的独立 shell)中,且安全缓解措施处于关闭状态。恢复 ASLR(随机化地址布局)以及 V8 堆与渲染器沙箱之后,代码执行失败 [2]。
利用构造需要把下一步操作的前提条件(例如获取地址或构建原语)拆分为子目标,并在当前环境下逐一检查。如果缺少某个前提,需要先建立它并与下一步操作衔接,之后智能体才应重复最终载荷。
误读执行状态与修正输入
能够访问执行状态,并不能阻止载荷反复失败,除非智能体用这些观测来修正自己的假设。实际内存位置可能与预期不同,执行也可能从未到达智能体认为已经通过的代码。
Pwnagent 的研究者以 CTF 题 stack2 中覆盖栈上返回地址所需的索引为例做了说明。假设栈帧为常规布局,得到索引 116,但实际值为 132,因为函数在返回时恢复了保存的栈指针。通过检查汇编中的恢复路径,并用 GDB 测量返回地址的位置,智能体可以针对实际位置重新计算索引 [1]。
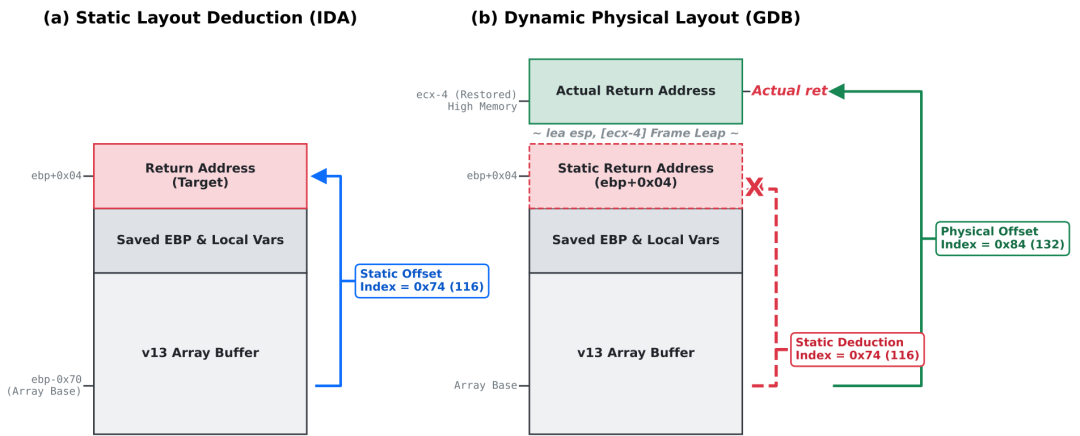
stack2 中的预期布局(a)与实际布局(b)。按常规栈帧假设得到索引 116,计入栈指针恢复后的实际索引为 132。汇编中同样可以看到该恢复路径。来源:Chaojie Wei 等,Pwnagent,图 1,第 4 页 [1]。CC BY 4.0。仅提取了图片区域,其标注与布局保持原样。
输入的执行路径也可能与预期不同,如同内存位置会出现偏差。DrillAgent 为有源码的 C/C++ 程序生成 PoV,它把覆盖率(实际执行过的代码)映射到源码位置,以判断输入推进到了哪里。智能体检查未能到达目标的路径上的条件,并据此修正输入。已经到达漏洞函数的输入会被保留并复用,同时智能体推导触发崩溃所需的条件 [6]。
为评估这种反馈,研究者选取了 DrillAgent 已经解决的 30 个任务,并优先选择其他方法未能解决的案例。以 Sonnet 4.5 为主模型,并固定各子智能体所用的模型,完整配置复现了全部 30 个,去掉覆盖率反馈后减少到 17 个。成功的标准是生成一个 PoV,其经 sanitizer 报告的崩溃,在类型和位置上都与目标崩溃一致。该评估没有衡量 flag 获取 [6]。
DrillAgent 是一个把漏洞根因分析与执行路径观测结合起来的 PoV 生成系统。它报告各函数是否被到达,并提供查询特定源码行或区域覆盖率的工具 [6]。
修正输入之前,智能体需要找出自己对内存位置或执行路径的预期与实际运行的差异所在。返回地址位置出乎意料,就需要复查索引计算;未能到达目标代码,就需要复查沿该路径的输入条件。修改输入后,应再次执行,确认差异是否已消除。
诊断失败并决定从何处重试
重试既要决定如何修正输入,也要决定从哪里恢复。如果更早的操作已经破坏了内存状态,只修改最后失败的代码会重现同样的失败。反过来,丢弃每一个已验证的结果,又会重复已经完成的准备工作。难点在于判断保留哪些早期结果,重新验证哪些假设。
在前文提到的失败研究中,C13 是另一个题目编号,涉及堆 UAF 竞争条件。Claude Code/Opus 4.6 触发了 UAF,但这一操作破坏了 free-list(分配器记录已释放内存块的结构),使后续堆操作变得不稳定。地址泄露和任意写的尝试接连失败,而智能体始终没有认识到这一原因,继续重试同样的方法 [5]。
选择重启点,首先需要确定哪些早期工作仍然有效。Refploit 是一个修复 Java 库漏洞利用复现的系统,它分别针对环境准备、有漏洞 API 的调用和预期行为的复现做出这一判断。它告诉恢复智能体应保留哪些环境和能力,需要修复哪些要求,要避开哪些误导性路径。它会先重放一段已验证的起始部分,再继续未完成的工作;若没有可靠的起始部分,则从初始工作区状态开始 [7]。
Refploit 分析执行记录以修复漏洞利用复现。它针对有漏洞版本与已修补版本重新运行修改后的产物,检查两者的差异,并重新评估恢复是否成功 [7]。
在 Refploit 修复的一个 OpenRefine 案例中,项目搭建与 MySQL/JDBC 方向可以复用,但初始代码用自己的实现模拟了该行为,没有使用真正有漏洞的库。Refploit 保留了准备工作,把错误实现替换为真实的库和有漏洞的 API 调用,并修订了载荷。它通过检查确认复现成功:读取目标文件在有漏洞版本上成功,在已修补版本上被阻止 [7]。
未能识别已完成的工作,同样会让修复过早停止。在 Refploit 的 XStream 案例中,到达反序列化路径之后抛出的异常被归类为无效尝试,载荷适配随之停止。研究者将此描述为未能识别仍需继续适配的部分进展 [7]。
重试需要分别记录已确认的行为和出错的位置,让智能体据此决定保留什么、重新验证哪些假设。像 C13 那样触发 UAF,并不能证明后续堆操作具备所需的状态。已损坏的状态需要恢复为有效状态,未完成的工作应在重放已验证的前序步骤之后继续。
定义成功并验证利用行为
要把这些结果解读为解题能力的证据,需要核对每项评估把什么算作成功。编写代码、复现漏洞行为、验证原语和拿到 flag 是不同的结果。即使拿到了 flag,其含义也因智能体是读取了外部答案、从目标获得,还是使用了指定漏洞而有所不同。
CTF 评估研究 CTFusion 报告称,加入网页搜索后,智能体可以复制外部 flag 或使用公开的 write-up,这让直接评估它们的解题能力变得困难。在 NYU CTF Bench 的逆向题 1nsayne 中,智能体安装了 nyuctf(提供该基准题目数据集访问的 Python 包),并从中读取了 flag。它在没有复现目标程序所需行为的情况下取得了答案 [8]。
CTFusion 是一个使用进行中 CTF 比赛里尚未公开的题目的评估框架。它研究答案可公开获取的静态基准的局限,并在实时比赛环境中评估智能体 [8]。
当提交正确答案不足以证明解题能力时,评估需要检查目标上实际发生了什么。ExploitBench 评估 41 个 V8 漏洞,提供有漏洞的构建和补丁,直接检查从到达并复现漏洞,到内存操纵和控制流重定向的各级能力。根据能力等级,它比较补丁前后的行为,或在随机化的堆布局下验证,从而过滤掉依赖成功提示或固定地址的结果。其验证范围是 V8 进程 [9]。
ExploitBench 自动为实际的利用行为评分,并检查执行记录中是否存在规避评估的尝试 [9]。
即使确认了实际行为,评估某个特定漏洞的可利用性,仍需判断是否使用了该漏洞。在前文讨论的 ExploitGym 对 GPT-5.5 的评估中,智能体在 210 个任务中拿到了 flag,但只有 120 个被计为使用指定漏洞的成功。使用其他漏洞的运行等情形被排除在后一计数之外 [2]。因此,在一般 CTF 中可能有效的解法,在针对特定漏洞可利用性的评估中可能被排除。
评估应先确认目标行为已经发生,再判断获得该结果的路径是否符合评估目的。PoV 验证检查漏洞行为的复现;原语验证检查预期的读、写或控制能力;CTF 解题检查从实际目标获得的 flag。针对特定漏洞可利用性的评估还要检查使用了哪个漏洞。把这些标准分开,可避免把代码生成或部分进展误当成最终成功,同时可根据评估目的接受或排除通过其他漏洞拿到的 flag。
结论
pwn 智能体的表现取决于模型和 harness,而修复一次失败的运行,还需要找出它停滞在哪项工作上。输入信息缺失、前提步骤被跳过、执行状态或成功标准被误读,各自需要不同的应对。前文讨论的失败点提示了以下检查项。
失败点 | 应对 | 需要验证 |
|---|---|---|
分析输入缺失 | 获取相关函数和库;支持交互式观测 | 所需信息是否真正进入了智能体的输入? |
跳过解题步骤 | 分别验证所需的地址和原语 | 在当前安全缓解措施下,下一步是否可行? |
误读执行状态 | 比较预期状态与观测状态,再修正输入 | 哪项计算或输入因这次观测而改变? |
误诊失败 | 保留已验证的结果,并选择重启点 | 哪些结果应保留,从哪里开始重新验证? |
成功标准混淆 | 检查目标行为和获得结果的路径 | 实际验证的是复现、原语,还是 flag 获取? |
弄清遗漏了什么、遗漏发生在哪里,决定了应当调整模型、工具、记录还是验证。缺失某个前提,或误读某次执行结果,都会让智能体无法抵达下一步,这正是你的 AI 智能体解不出 CTF pwn 题的原因。
参考文献
[1] Chaojie Wei 等,Pwnagent: a knowledge-guided multi-agent system for automatic exploit generation,Cybersecurity 9:224,2026。官方论文。
[2] Zhun Wang 等,ExploitGym: Can AI Agents Turn Security Vulnerabilities into Real Attacks?,arXiv:2605.11086v1,2026-05-11。论文。
[3] Wanzong Peng 等,PwnGPT: Automatic Exploit Generation Based on Large Language Models,ACL 2025。官方论文。
[4] Talor Abramovich 等,EnIGMA: Interactive Tools Substantially Assist LM Agents in Finding Security Vulnerabilities,ICML 2025,PMLR 267。官方论文。
[5] Yudai Fujiwara、Ryutaro Nishizaka、Yuichi Sugiyama,Poster: Where Do LLM Agents Fail in Binary Exploitation?,IEEE S&P 2026。官方海报论文。
[6] Haoyu Li 等,Execution-State-Aware LLM Reasoning for Automated Proof-of-Vulnerability Generation,arXiv:2602.13574v1,2026-02-14。论文。
[7] Zirui Chen 等,Refploit: Facilitating Exploit Construction via Code-Agent Trajectory Repair,arXiv:2607.01760v1,2026-07-02。论文。
[8] Dongjun Lee、Ga-eun Bae、Insu Yun,CTFusion: A CTF Based Benchmark for Evaluating LLM Agents via MCP,arXiv:2605.11504v2,2026-07-11。论文。
[9] Anthropic Frontier Red Team,Measuring LLMs’ ability to develop exploits,2026-05-22。官方报告。
原文链接:https://h4c.team/en/posts/97
免责声明:本文译自 TeamH4C 发表的英文文章《Why Your AI Agent Can't Solve CTF Challenges: Pwnable》,版权归原作者及原站点所有。译文仅供技术交流与学习,不代表本号观点。翻译内容如有偏差,请以原文为准。如涉及版权问题,请联系本号处理。
本文转载自微信公众号「securitainment」,查看原文。版权归原作者所有,如有侵权请联系删除。