直接在像素上生成!PixVid将预训练Latent视频模型升维至像素空间,高速运动对齐度达98%,端到端延迟降低14倍
原创 CV君 2026-11-17 18:35 江苏
重返像素,极速交互
当前主流的视频生成模型几乎都建立在潜在扩散(Latent Diffusion)框架之上:利用三维变分自编码器(3D Variational Autoencoder, 3D VAE)在空间与时间维度对原始视频进行大幅压缩。这种压缩在早期算力有限时使得大规模视频训练成为可能,但随着技术演进到高分辨率渲染、几何条件可控编辑以及毫秒级实时交互世界模型(World Models)时,3D VAE 的物理瓶颈愈发显著。
空间维度上,分辨率翻倍会导致潜空间 Token 数量暴涨 4 倍、注意力计算激增 16 倍;时间维度上,3D VAE 通常将多帧压缩为一个潜在表征(Latent Token),导致高速运动时控制信号与画面无法逐帧对齐,物体形变严重;而在自回归交互生成中,由于模型必须等待整组(如 4 帧或 12 帧)控制指令全部输入才能开始计算,产生了数十甚至数百毫秒的硬性延迟。
为了打破 VAE 带来的瓶颈,来自 Roblox、加州大学默塞德分校、宾夕法尼亚大学与德克萨斯大学奥斯汀分校的研究团队提出了 PixVid。其命名源自 Pixel(像素)与 Video(视频)的结合,寓意让视频扩散重返像素空间(Back to Pixels)。
该方法无需从零开始耗费海量算力预训练,而是设计了一套精炼的方案,直接将现有的预训练潜在视频模型(如 Wan2.1、SolarWM)升维(Lifting)至逐帧像素级空间。实验表明,经过微调后的模型不仅在综合画质上媲美甚至超越原生潜空间基准,而且在 960p 高清扩展、高速运动编辑对齐度以及实时按键响应延迟等维度展现出显著优势。

为什么重回像素空间?潜空间视频模型的三大物理束缚
自扩散模型向视频领域拓展以来,学术界与工业界普遍依赖时空压缩架构(如 CogVideoX、Wan2.1 等采用的 3D VAE)。这一设计在离线生成固定长度的短片时十分经济,但当模型被推向更复杂严苛的下游应用时,固定压缩带来了结构性瓶颈:
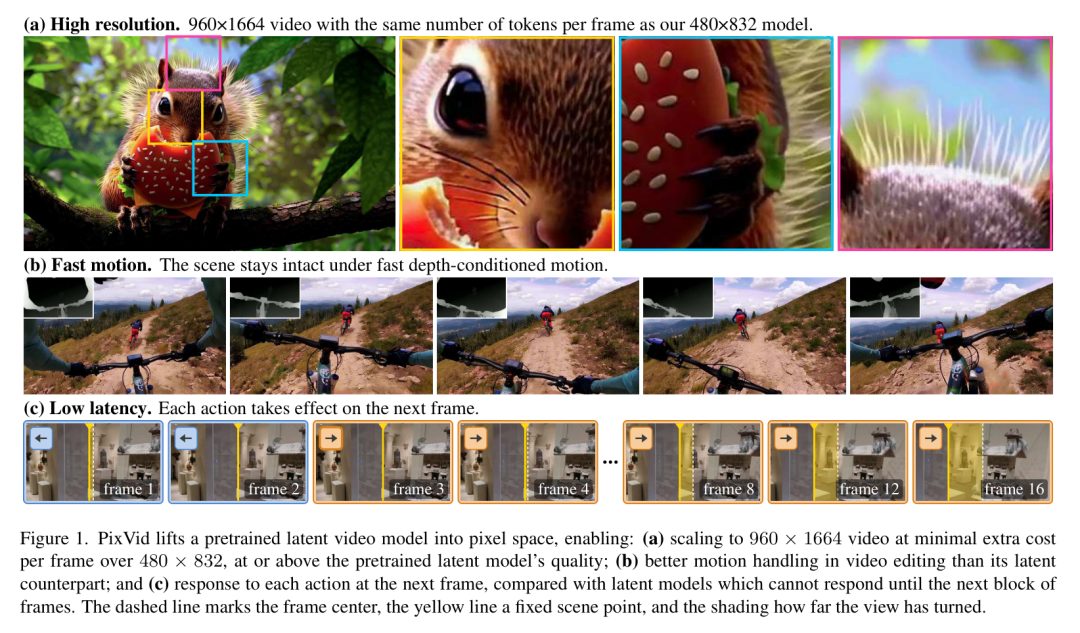
分辨率扩展的高额代价:在固定压缩比的 VAE 下,提高分辨率意味着输入给 Diffusion Transformer(DiT)的 Token 数量呈平方级膨胀。想要维持计算量就必须采用更高压缩比的 VAE,而这往往会不可逆地损伤画面的重构细节与文字渲染能力。
多帧合并导致的几何运动不对齐:当 3D VAE 将连续 4 帧像素压缩为一个 Latent 时,输入的几何控制信号(如深度图 Depth、光流 Flow、姿态 Pose)同样不得不以块为单位进行合并。面对镜头快速推拉或剧烈物体运动,模型难以定位单一帧的精确边界,从而引发严重的运动模糊、伪影和物体解构。
交互式系统的操作延迟门槛:在交互式世界模型中,视频按块自回归生成。如果一个块对应 12 帧,哪怕推理引擎通过蒸馏做到极致,系统也必须等待所有 12 帧的交互按键收集完毕才能启动生成,导致无法消除的操作等待时间。
以往像素级模型多受困于过高的训练成本和巨大的显存开销。PixVid 的核心洞见在于:预训练的潜在视频 DiT 已经学习到了极强的宏观语义与物理动力学规律,将其迁移到像素空间只需重构输入/输出接口,并不需要从零重新学习真实世界的时空先验。
核心方法:如何将预训练 Latent DiT 无损升维至像素级?
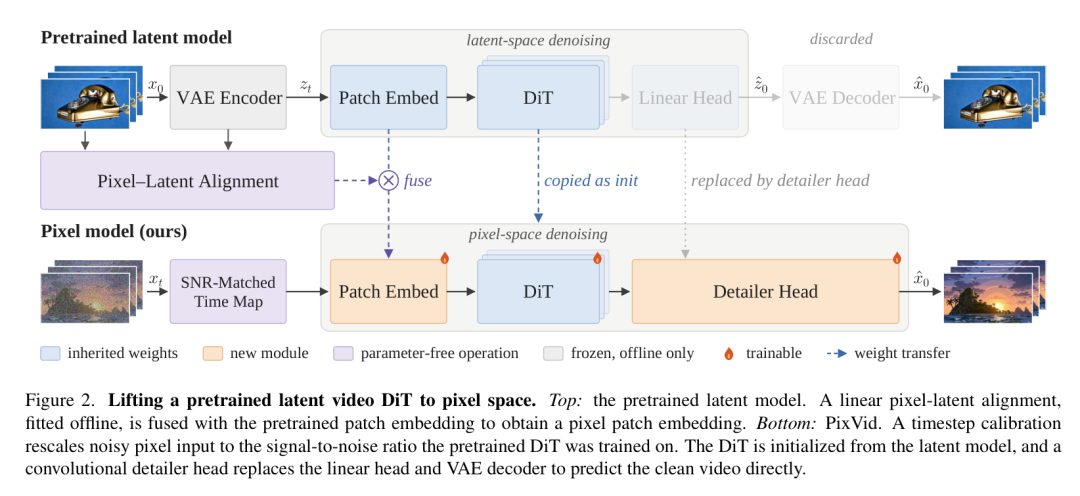
PixVid 的整体架构由三大支柱构成:输入端的正交投影与信噪比时间步校准、输出端的轻量级因果卷积细化头(Detailer Head),以及关键的训练设计(-prediction 目标与 Euler 采样)。
1. 输入端:正交 Procrustes 投影与 SNR 时间步标定
在 Wan2.1 模型中,DiT 原生接收空间下采样 8 倍并经过 Patch 分词的潜变量输入。PixVid 将每个 Token 的视域重新定义为单帧内的 像素补丁(如 Wan2.1 下 ,通道展开为 维)。
- 正交投影初始化:设像素块为 (处于归一化的 OKLab 颜色空间),对应位置的 Latent Token 为 ()。为了让像素补丁与原始潜变量空间对齐,PixVid 离线收集了 500 个片段计算配对特征,通过正交普鲁克分析(Orthogonal Procrustes Analysis)求解正交矩阵 :并通过 Frobenius 范数比例拟合标量缩放因子 (Wan2.1-14B 下 ,1.3B 下 )。将原 DiT 的 Patch 投影矩阵 初始化为 ,即可让像素输入自然映射入原潜变量流形。
- 信噪比(Signal-to-Noise Ratio, SNR)匹配时间步映射:由于像素间的冗余度远高于紧凑的潜变量,在相同的加噪程度 下,加噪像素所保留的有效信号远多于 Latent。若直接输入会导致 DiT 的信噪比失衡。PixVid 推导了精确的 SNR 守恒变换,将输入进行动态幅度缩放 ,并将送入 DiT 的内部时间步校准为:由于 ,校准后的时间步始终满足 ,这使得 DiT 能够以预训练时完全一致的信噪比来感知像素噪声输入。
2. 输出端:因果卷积细化头(Detailer Head)
在输出端,PixVid 完全舍弃了 VAE 解码器与线性投影头,引入了一个轻量级的 3D 卷积细化头。
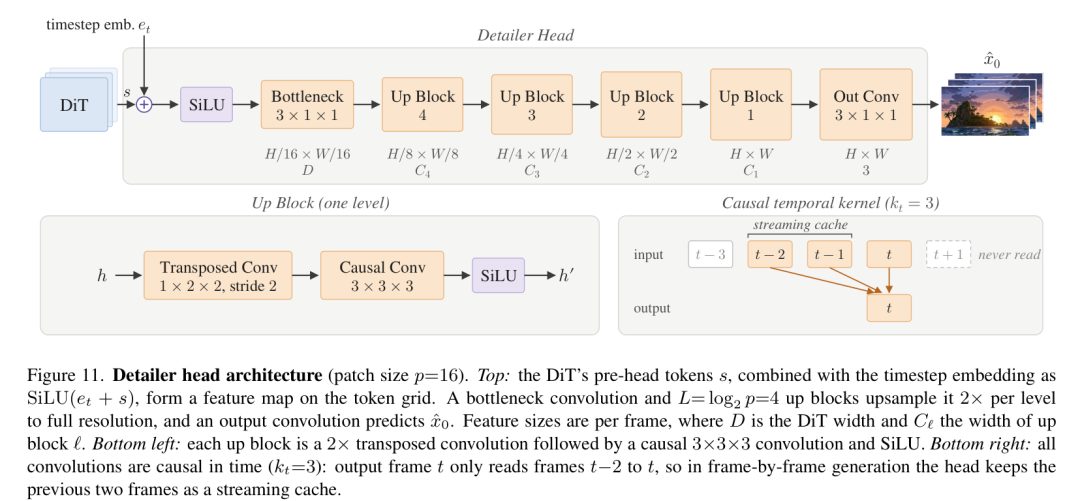
针对常规线性映射头会在图像补丁交界处产生网格拼接裂纹的问题,细化头采用 级空间上采样模块(Up Blocks)。每个模块包含一个 的转置卷积(步长为 2)与一个 的时间因果卷积。
所有时间卷积核严格采用时间因果填充(),第 帧的生成仅依赖于当前帧及历史前两帧()。这一设计使得细化头在自回归生成时只需维持一个容量为 2 的流式缓存(Streaming Cache),各帧解码开销恒定,绝不引入未来帧信息泄露。
3. 关键训练策略:预测清晰像素(-prediction)与 Euler 采样
在流匹配(Flow Matching)的优化路径上,团队发现预测目标的选择起到了决定性作用:
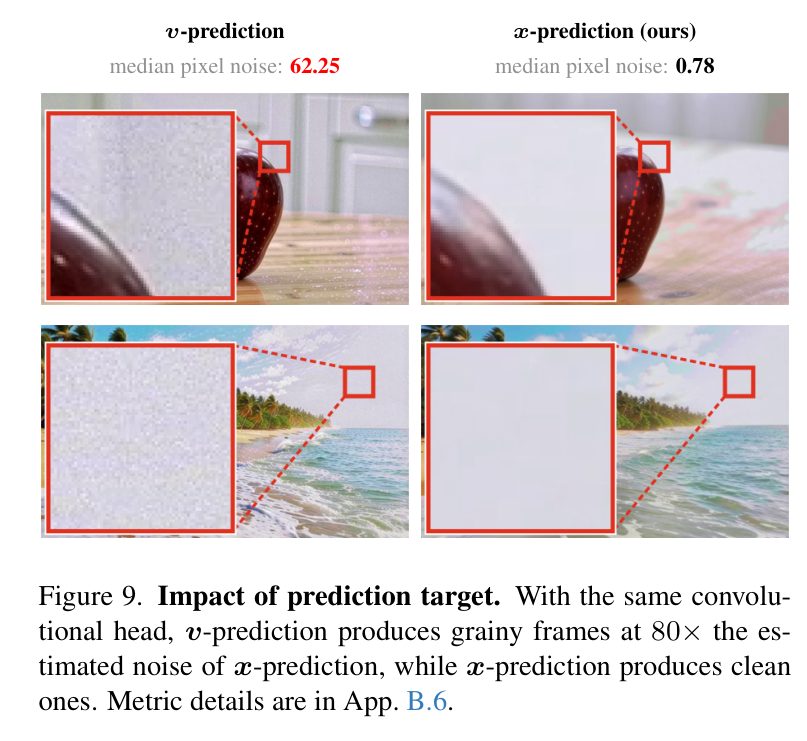
潜在模型通常采用速度预测(-prediction),但在像素级空间,速度预测会强迫网络去拟合每个像素点全秩的高斯随机噪声,导致画面产生高达 80 倍的细密颗粒与严重闪烁(Pixel Noise 达到 62.25)。PixVid 采用干净视频预测(-prediction),引导网络直接拟合天然位于低维流形上的清晰图像,再将输出换算为速度矢量计算损失:
配合相邻帧差分的 Charbonnier 平滑损失 与感知损失 ,使像素噪点控制在 0.78。
此外,在采样精度层面,团队发现潜空间常用的高阶 UniPC 采样器在 bfloat16 精度下会导致像素色度衰减(仅保留 91% 色度),而标准的一阶 Euler 采样器能在不退化为 fp32 显存开销的前提下完整保留色彩饱和度(保持率 101%)。
实验与分析:四大场景能力验证
基于上述设计,团队针对 Wan2.1-14B、Wan2.1-1.3B 以及面向交互的 SolarWM-5B 进行了升维微调。在 64 张 NVIDIA B200 GPU 集群上,仅需约 130 万个视频片段(约 4,000 GPU-hours)即可完成收敛。
1. 文生视频基准评测:质量全面看齐原生潜在底座
在包含 946 个评测提示词的 VBench 全面测试中,基于 Wan2.1-14B 转换而来的 PixVid 在 480p 分辨率下取得了 84.78 的综合总分,不仅超越了原生潜在基座 Wan2.1(84.05),也领先于从零开始训练的像素级并发工作 PixelUMM(83.72)。
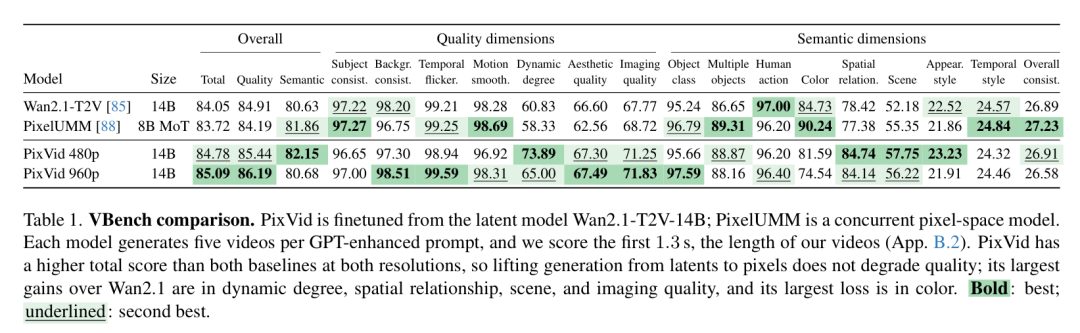
尤其在动态程度(Dynamic Degree,73.89 vs 60.83)以及成像画质(Imaging Quality,71.25 vs 67.77)上,像素级生成摆脱了 VAE 重构模糊,带来了直观提升。在 Movie Gen 测试集上的双盲人工评测中,PixVid 在视觉质量、动作流畅度与语义遵循度上均以显著优势胜出。
2. 高清分辨率扩展:算力开销仅增 17%
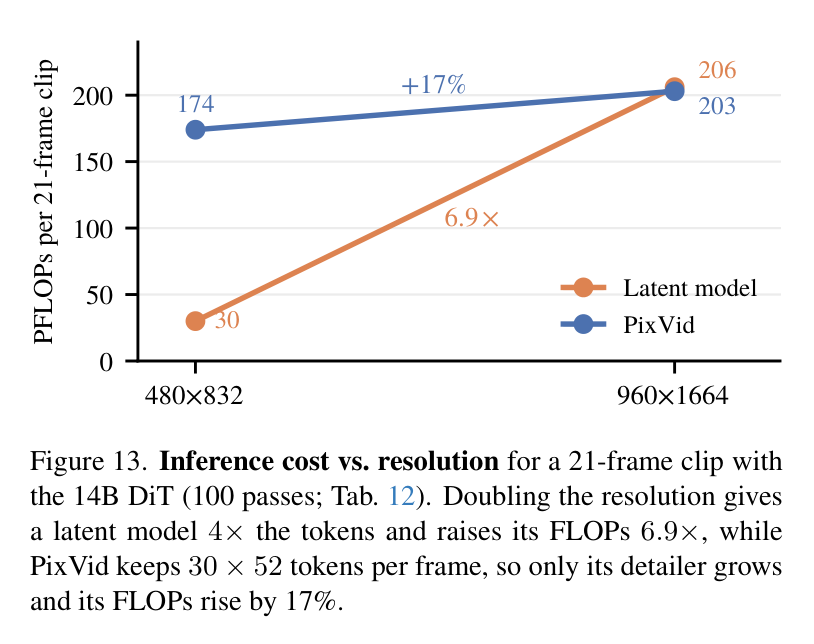
提升分辨率时,传统潜在模型由于 Token 数量膨胀 4 倍,FLOPs 会激增 6.9 倍。而 PixVid 展现出了像素架构特有的灵活性:直接将 Token 的 Patch 尺寸翻倍(从 调整为 ),同时在细化头前端新增一级上采样块。
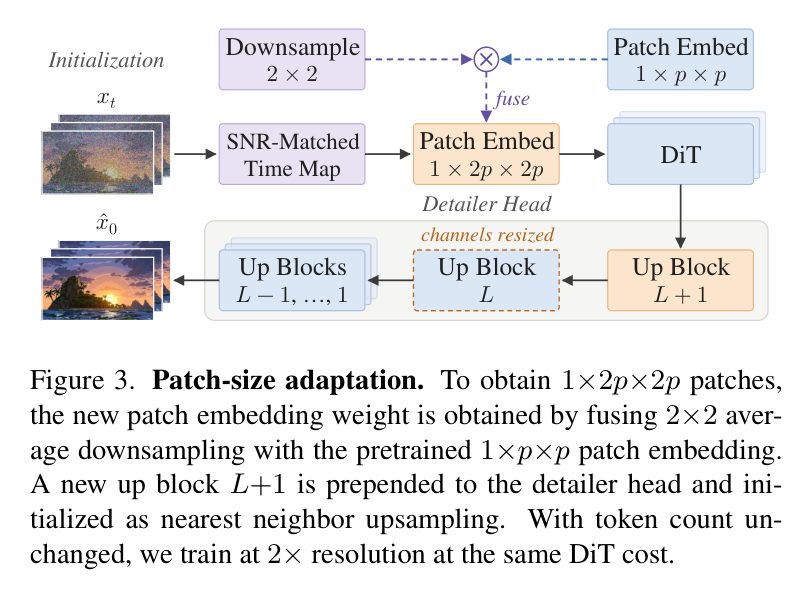
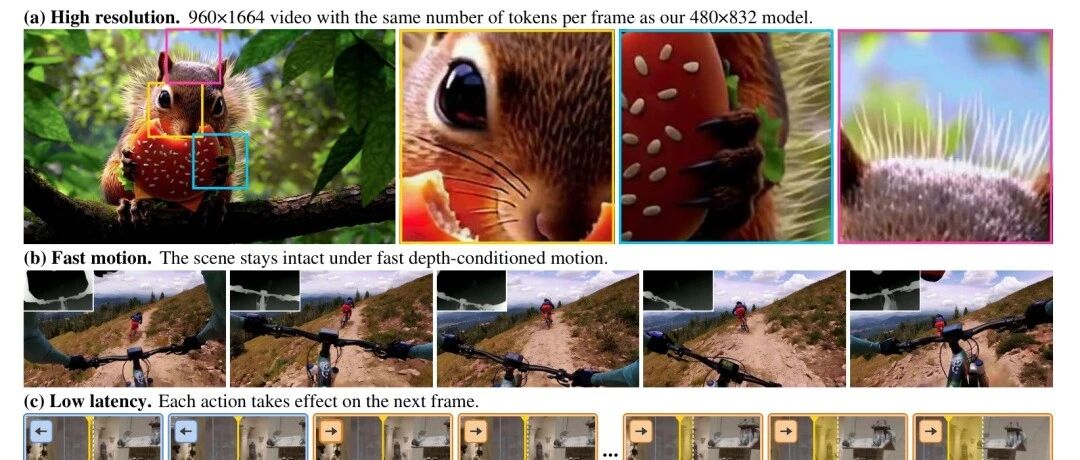
通过这种自适应配置,生成 960×1664 高清视频时,输入给 DiT 的 Token 数量依然维持在每帧 保持不变。计算开销对比显示,PixVid 在 960p 时的整段推理 FLOPs 仅比 480p 增加了 17%(从 174 PFLOPs 微增至 203 PFLOPs),生成的动物毛发与建筑纹理极其锐利清晰。
3. 精准视频编辑:高速运动对齐度突破 98%
在深度条件控制的视频编辑任务中,传统模型往往因多帧共用单个 Latent 而在高速运动下失效。
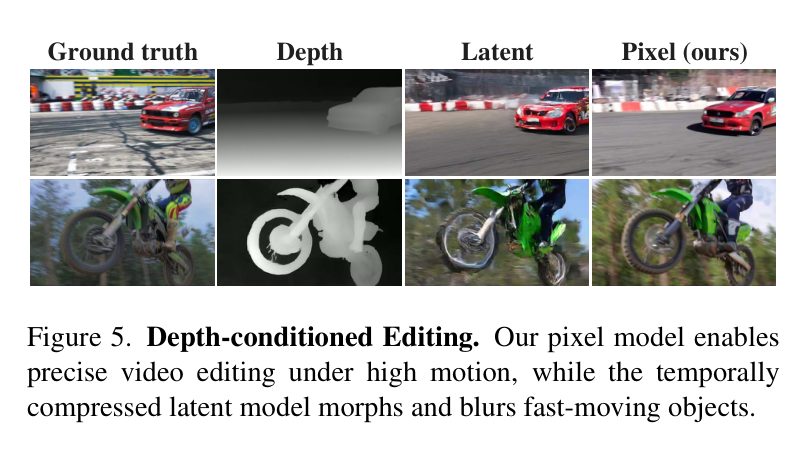
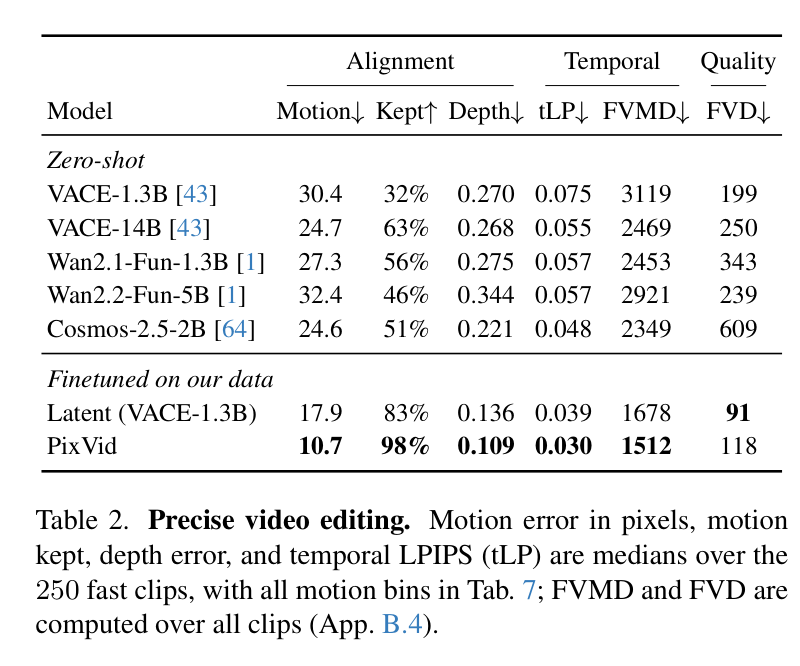
在 250 个极速运动片段测试中:
同数据微调的潜空间基线(VACE-1.3B)的运动保留率仅有 83%,运动误差高达 17.9 像素;
PixVid 实现了高达 98% 的运动保留率,运动误差大幅降至 10.7 像素,绝对深度误差(AbsRel)下降 20%,即使在主体剧烈位移时背景与轮廓依然严丝合缝。
4. 低延迟交互式世界模型:延迟降低 14 倍,直达 34 毫秒
在自回归交互生成场景中,团队将具有单帧因果属性的 PixVid 与 Self Forcing 少数步蒸馏算法结合,构建了 4 步流式生成的学生模型。
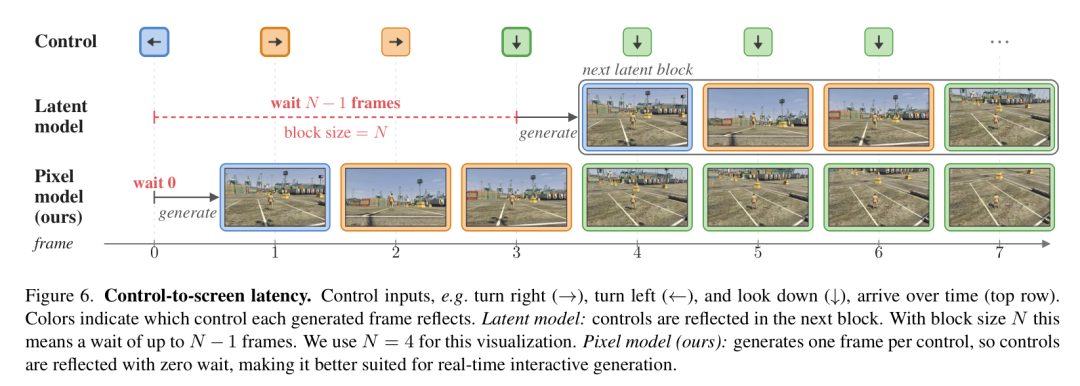
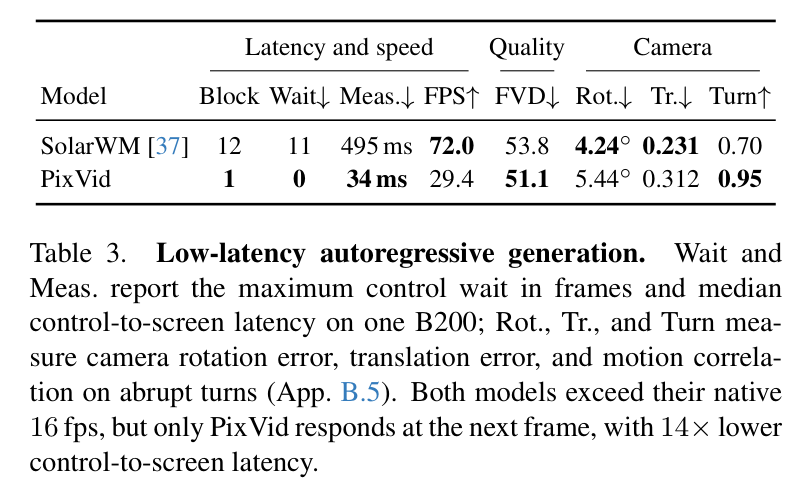
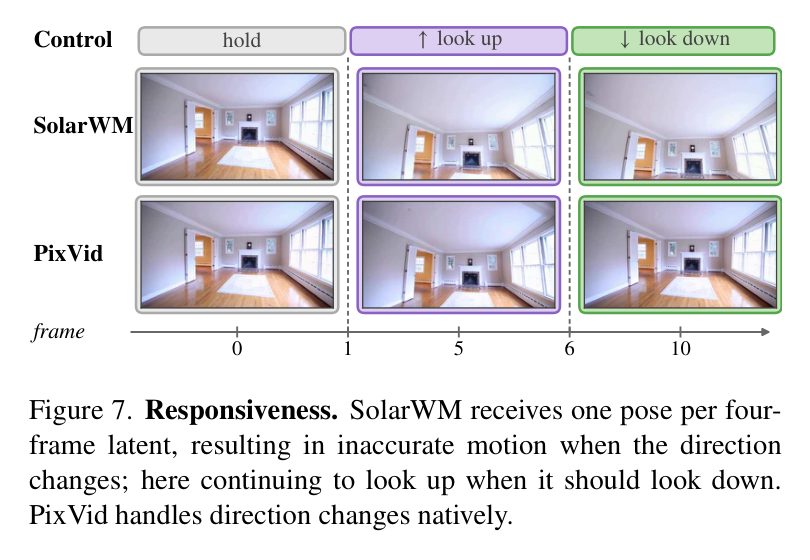
传统的 SolarWM 依赖 12 帧(3 个 Latent)作为一个推理块,用户按键输入后最高需等待 11 帧才能触发渲染,产生高达 495 毫秒的控制端到端延迟;PixVid 采用单帧块机制(Block=1),控制输入等待时间直降为 0 帧,单张 B200 上的端到端控制响应延迟降至 34 毫秒,实现了高达 14 倍的延迟削减,同时依然保持 29.4 FPS 的超实时流式吞吐。
面对突发急转弯(Abrupt Turns),PixVid 的相机运动响应相关度高达 0.95,彻底消除了由于 Latent 块聚合导致的转向迟滞与平滑过冲现象。
一点思考
长期以来,视频生成界形成了一种思维定势:像素空间由于维度灾难不可逾越,3D VAE 是大规模训练的唯一通行证。PixVid 的工作展现了一条更具扩展性的折中路径——利用预训练的潜空间基座作为高维先验提取器,在下游微调阶段卸下 VAE 的枷锁,通过结构化解耦与 SNR 时间步标定回归像素原生空间。
这种范式不仅解决了交互式世界模型中由来已久的硬件延迟瓶颈,还为视频生成带来了一个更深远的益处:当扩散模型直接在像素空间运转时,强化学习奖励函数(RL with pixel rewards)、鉴别器对抗损失以及多教师混合蒸馏不再受制于不可导的冻结解码器。
尽管取消时间压缩使得短片段生成在低分辨率下的单位 Token 吞吐成本有所上升,但随着分辨率的提高,这种算力劣势正在迅速抹平。重回像素空间,或许正是通向真正实时、高保真、端到端交互世界模型的关键拐点。
论文标题: Back to Pixels: Lifting Latent Video Diffusion into Pixel Space
机构: Roblox、加州大学默塞德分校、宾夕法尼亚大学、德克萨斯大学奥斯汀分校
代码仓库: 暂未正式开源(以官方项目主页更新为准)
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。