ICLR 2027满分论文大赏:什么样的创新最打动人?
原创 让你更懂AI的 2026-11-17 17:38 北京
Rebuttal如何逆转评分
从 2 分升到 4 分,再到三位审稿人集体提分,作者究竟拿出了哪些让人信服的新证据?
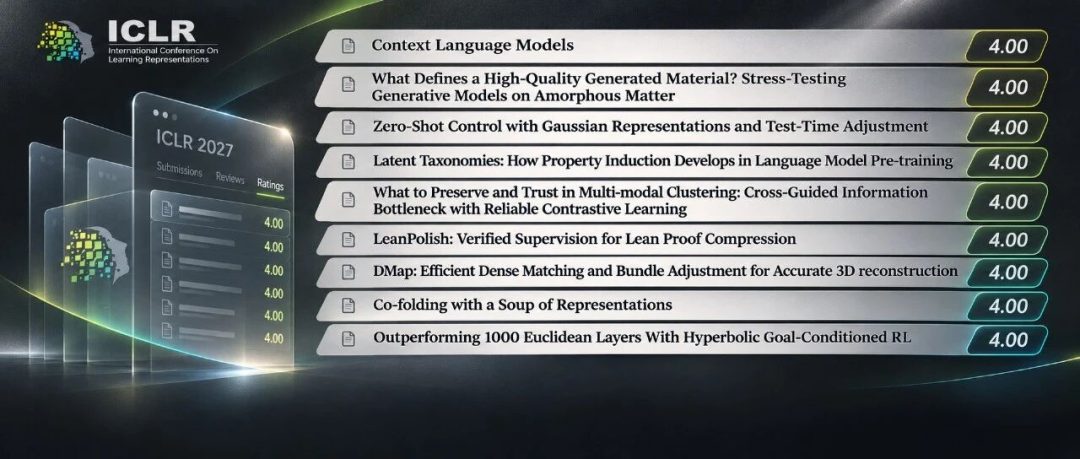
ICLR 2027 的「满分作文」,已经出现了。
初审评分公布时,只有三篇论文获得审稿人的一致满分。
随着 Rebuttal 推进,截至 11 月 17 日,已有 8 篇论文获得三位审稿人一致的 4 分最高推荐,其中一篇甚至从 3、3、3 一路升至 4、4、4。
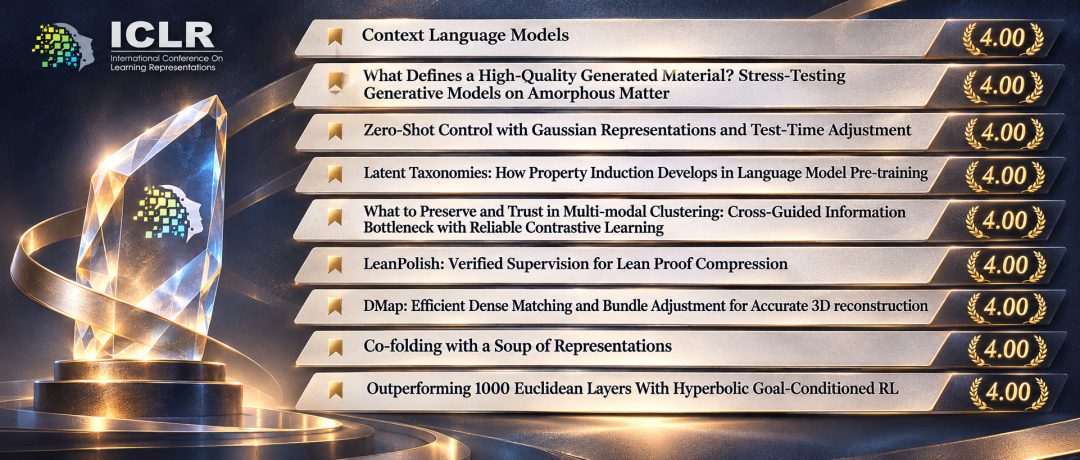
顶会论文的满分答卷,究竟长什么样?那些后来成功提分的,又是怎么说服审稿人的?
初审即获满分
大模型自己管理上下文
论文标题:
Context Language Models
论文地址:
https://openreview.net/forum?id=U1ObEVC4A7
代码地址:
https://github.com/facebookresearch/context-language-models
何时压缩历史、保留哪些信息,通常由外部 Harness 预设的规则决定。
华盛顿大学、Meta 超级智能实验室等机构提出的 Context Language Models(CLM),索性把当前上下文变成可编辑的文件,交由模型自行维护。
模型可以删除冗余记录、整理关键信息,还能为多智能体协作维护各自的上下文。这些管理策略还可以通过指令优化和强化学习进一步改进。
在深度研究基准 BrowseComp-Plus 上,CLM 的准确率相对最强对照方案提高 11.4%,推理计算量(FLOPs)减少21.5%。在 12 小时的代码优化任务中,得分提高 5%,计算量下降59%。
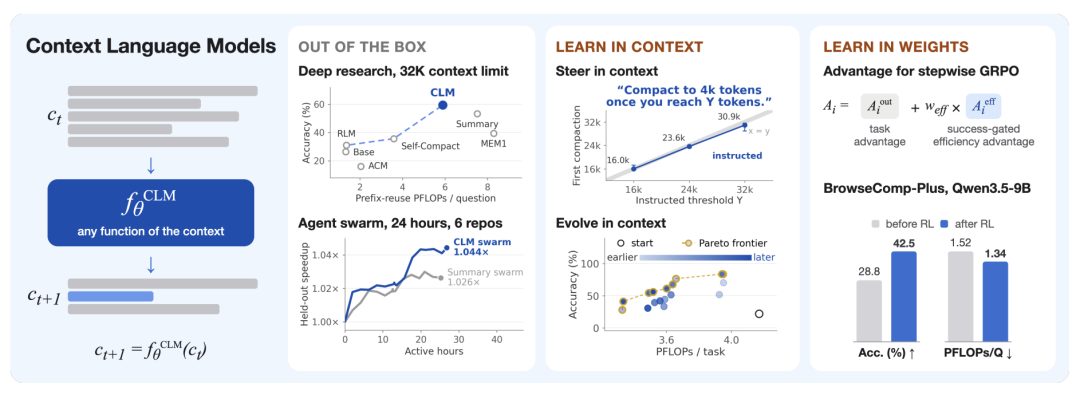
〓上下文语言模型的基本设计与代表性实验结果
参数更大,归纳能力反而变弱?
论文标题:
Latent Taxonomies: How Property Induction Develops in Language Model Pre-training
论文地址:
https://openreview.net/forum?id=m5TLPK0U7O
知道知更鸟具有某种特征,人们更容易推测麻雀也有这种特征,却不太会据此推断鲸鱼也有。语言模型会不会在预训练中形成类似的类别归纳能力?
瑞士洛桑联邦理工学院(EPFL)、AXA 等机构的研究团队把带有隐含类别关系的合成知识混入 Pythia 和 OLMo 2 的继续预训练过程,发现仅凭下一个词预测,模型就能学会按类别推断陌生属性。
对模型内部表征进行聚类,甚至能够恢复实验中预设的完整分类树。
在固定且有限的数据预算下,随着模型参数量增大,正确的类别归纳能力反而减弱。
不过,作者在 Rebuttal 中将数据预算扩大四倍后发现,1B 模型最终追上并反超了 160M 模型。更大的模型可能需要更多训练数据,才能充分学会利用潜在类别结构。
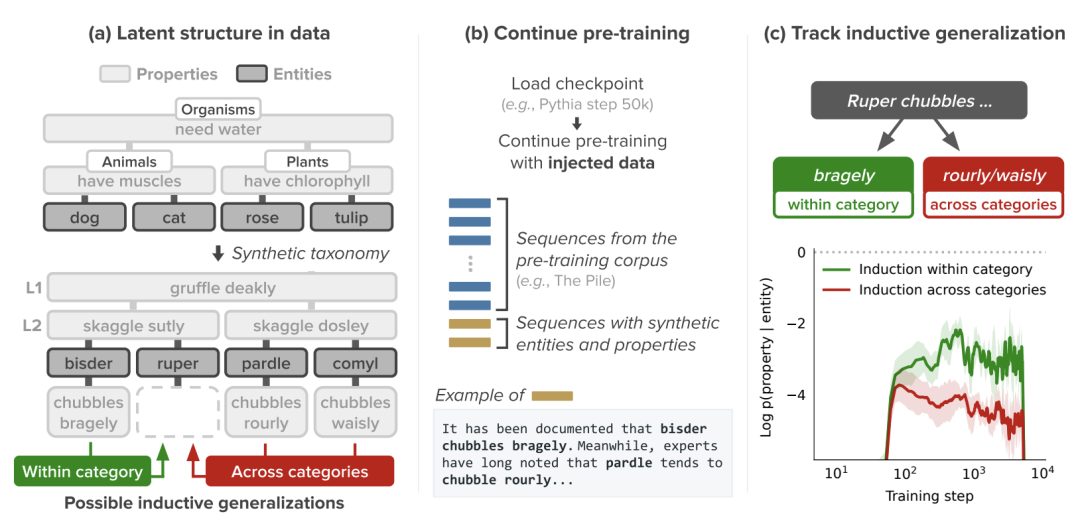
〓潜在类别结构与属性归纳的实验设置
Rebuttal后升至满分
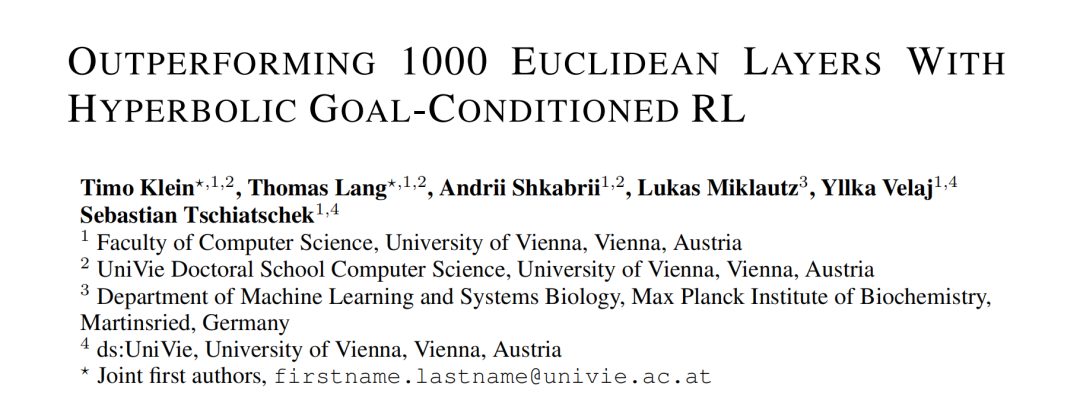
64层网络,胜过1024层
论文标题:
Outperforming 1000 Euclidean Layers With Hyperbolic Contrastive RL
论文地址:
https://openreview.net/forum?id=ldn229Iy07
代码地址:
https://github.com/Probabilistic-and-Interactive-ML/HypGCRL
在迷宫中,两个位置的直线距离可能很近,实际路线却隔着一堵墙。
传统对比强化学习通常使用状态—动作表征与目标表征之间的欧氏距离来衡量目标可达性,面对复杂路径结构,往往需要更深的网络才能学好这种关系。
维也纳大学等机构的团队改用双曲空间中的测地距离,让模型更容易捕捉迷宫中的实际可达路径。
在困难的人形机器人迷宫任务中,64 层双曲模型的表现超过 1024 层欧氏模型,训练速度快 12 倍以上,参数量约少 13 倍。
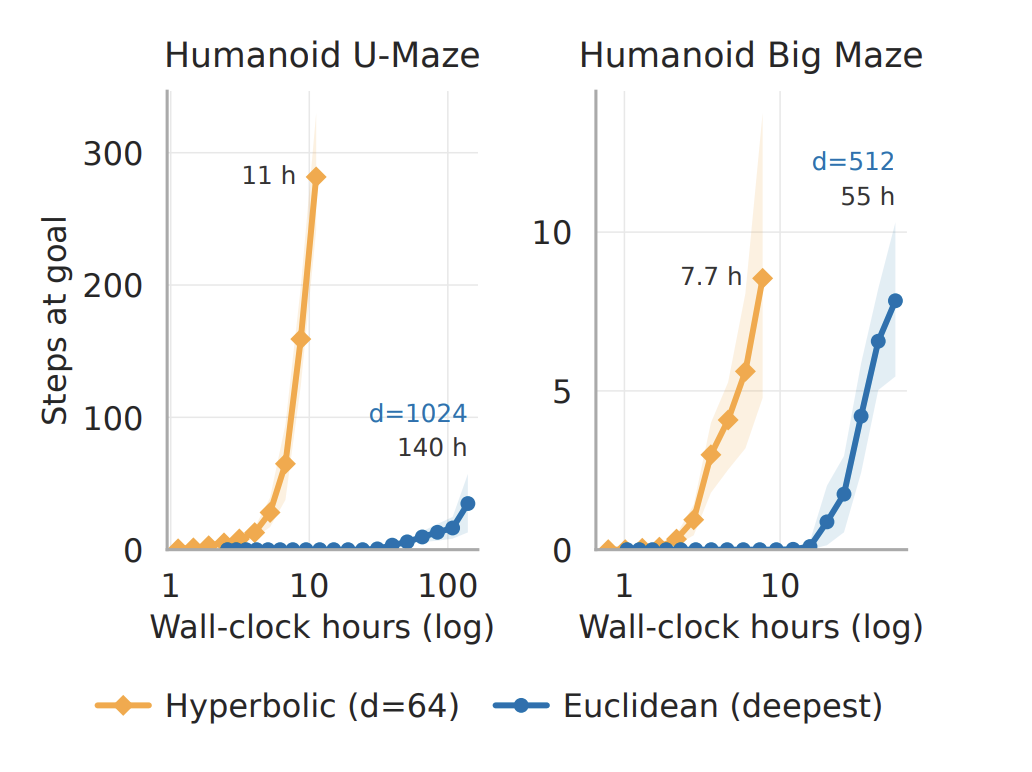
〓64层双曲模型与深层欧氏模型的性能及训练耗时对比
融合AlphaFold3等模型的表征
论文标题:
Co-folding with a Soup of Representations
论文地址:
https://openreview.net/forum?id=Jn7WiQ9LtS
代码地址:
https://github.com/hsjang0/soupfold
AlphaFold3 之后,生物分子复合物结构预测涌现出多种强模型,但面对同一种复合物,不同模型的预测能力仍有差异。
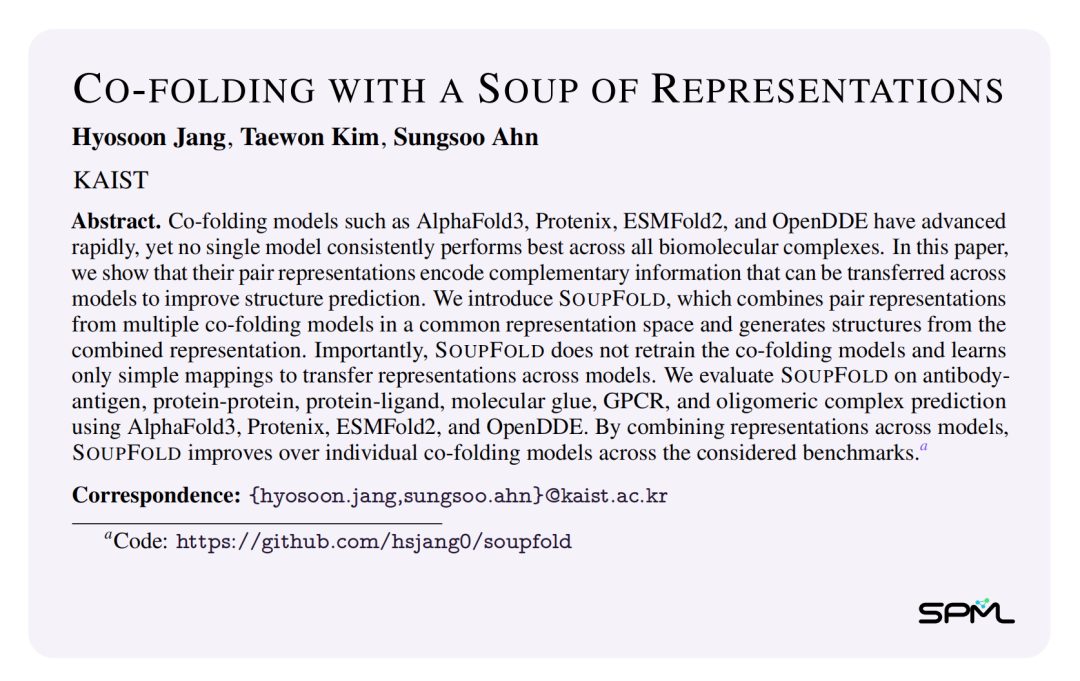
韩国科学技术院(KAIST)提出的 SoupFold 尝试直接融合模型内部的成对表征,让不同模型捕捉到的结构线索相互补充。
SoupFold 以其中一个模型为主模型,将其他模型的表征映射到它的表征空间,再融合这些信息生成结构。
研究涉及 AlphaFold3、Protenix、ESMFold2 和 OpenDDE 等模型。基础模型无需重新训练,只需学习轻量级的表征映射。
在包含 422 个抗体—抗原预测目标的 CoFold Arena 评测中,SoupFold 融合 OpenDDE、Protenix 和 ESMFold2 的表征,表现超过了当时榜单中的其他模型。
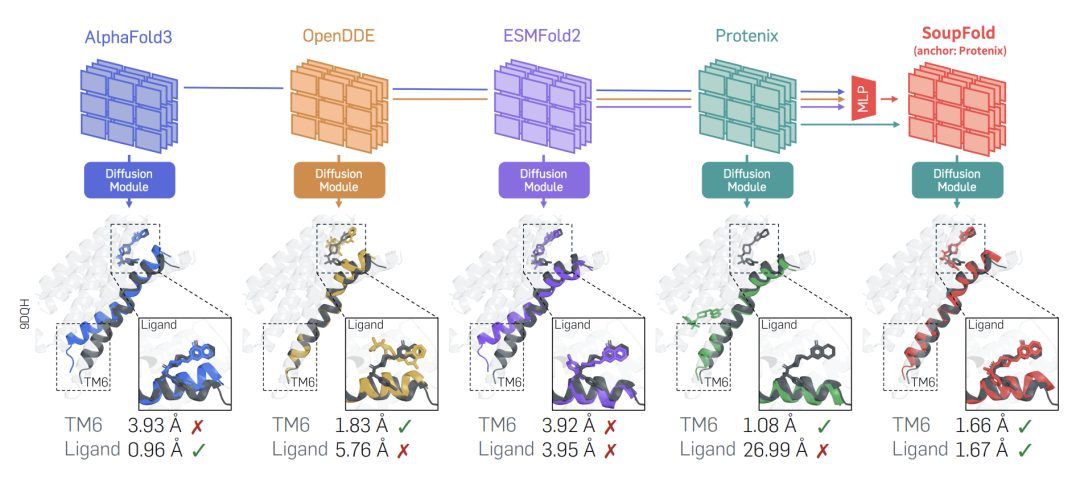
〓SoupFold融合多种共折叠模型的结构表征
数学证明压缩,也有训练陷阱
论文标题:
LeanPolish: Verified Supervision for Lean Proof Compression
论文地址:
https://openreview.net/forum?id=yRmdNlDhJS
代码地址:
https://github.com/paulinebourigault/leanpolish
AI 生成的数学证明即便能够通过 Lean 验证,也可能冗长、重复。
伦敦帝国理工学院提出的 LeanPolish 希望利用经过验证的修改记录,让模型学会压缩证明。
研究同时发现,只记录搜索遇到的第一个成功修改,可能把候选顺序变成答案提示,让模型学到与证明内容无关的捷径。
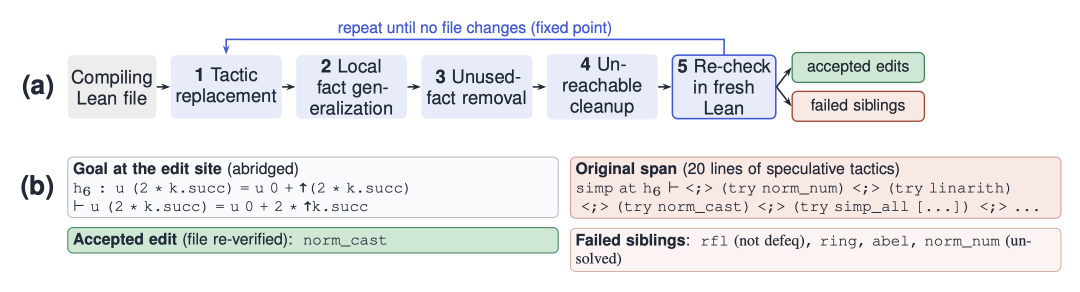
〓LeanPolish的证明修改、校验与数据记录流程
团队整理了 33,402 条验证成功的局部修改和 65,596 条失败尝试。在原先的候选排序评测中,一个完全不看证明内容的简单规则,竟然也能达到100%的准确率。
改用完整候选集后,训练模型的排序准确率达到 70.1%,明显超过最强冻结模型的36.9%。
在 miniF2F 上,LeanPolish 的符号方法经过多轮迭代,证明 Token 数的降幅从 19.7% 扩大至 27.5%,超过了论文测试的神经网络混合方案。
利用这些修改数据微调后,DeepSeek-Prover 在单次生成条件下,成功缩短证明的比例也从 12% 提高至 58%。
8.8秒完成高精度三维重建
论文标题:
DMap: Efficient Dense Matching and Bundle Adjustment for Accurate 3D Reconstruction
论文地址:
https://openreview.net/forum?id=iikGG5Se3J
视觉基础模型能够快速预测三维场景,但直接回归往往难以保留亚像素级的几何约束;传统束调整虽然精度高,处理稠密对应关系又十分耗时。
DMap 利用预训练多视角模型完成全局初始化,并复用模型提取的特征,通过轻量解码器实现稠密匹配,随后在规则像素网格上进行 GPU 并行的稠密束调整。
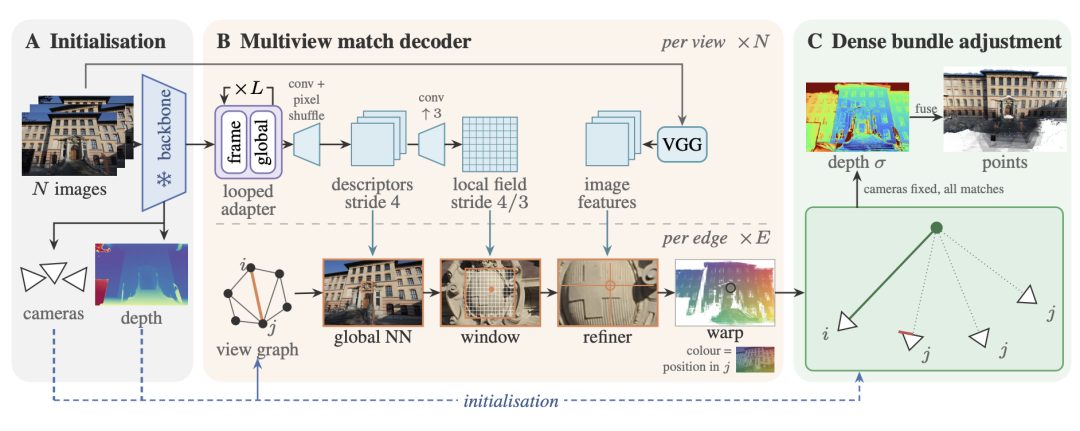
〓DMap的多视角匹配与稠密束调整流程
在 ETH3D 的 25 个场景上,其高分辨率版本平均每场景只用 8.8 秒,相对位姿精度指标 AUC@1° 达到 88.6%。
AI生成材料,符合物理规律吗?
论文标题:
What Defines a High-Quality Generated Material? Stress-Testing Generative Models on Amorphous Matter
论文地址:
https://openreview.net/forum?id=PTsclw583x
生成材料的结构指标表现不错,就意味着它符合物理规律吗?
对缺乏长程有序结构的非晶材料而言,传统的几何相似度指标尤其容易漏掉问题。一个局部异常的原子,就可能带来明显不合理的物理行为。
这篇论文提出 AmorphBench,围绕局部结构、拓扑、衍射、力学、能量及构型空间覆盖度,设置六大类 21 项质量指标。
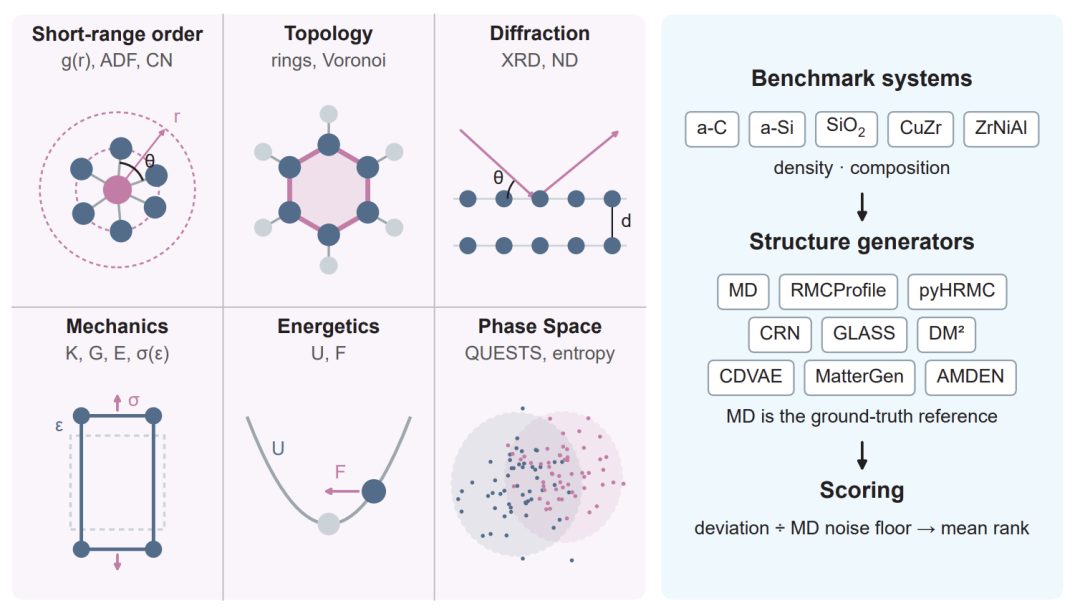
〓AmorphBench的材料体系、评价维度与测试流程
研究评估了 8 种生成与结构拟合方法,覆盖 5 种非晶材料体系、14 组密度和成分条件。
结果显示,一些模型在结构指标上表现不错,却依然存在能量异常、力学性质失真等问题。即使将训练数据增加十倍,各种方法的相对排名也没有发生变化。
多模态聚类,负样本也分可信度
论文标题:
What to Preserve and Trust in Multi-modal Clustering: Cross-Guided Information Bottleneck with Reliable Contrastive Learning
论文地址:
https://openreview.net/forum?id=JYMIxuG7ph
多模态聚类希望从不同模态的数据中找到共同的类别结构,难点在于各模态的有效信息因样本而异。对比学习还可能把同一类别的两个样本错误地当作负样本。
交叉引导信息瓶颈针对每个样本,动态调整其他模态提供的信息,促进跨模态共享信息的保留。可靠对比学习则分别估计负样本关系的模糊程度与样本可信度,再调整训练权重。
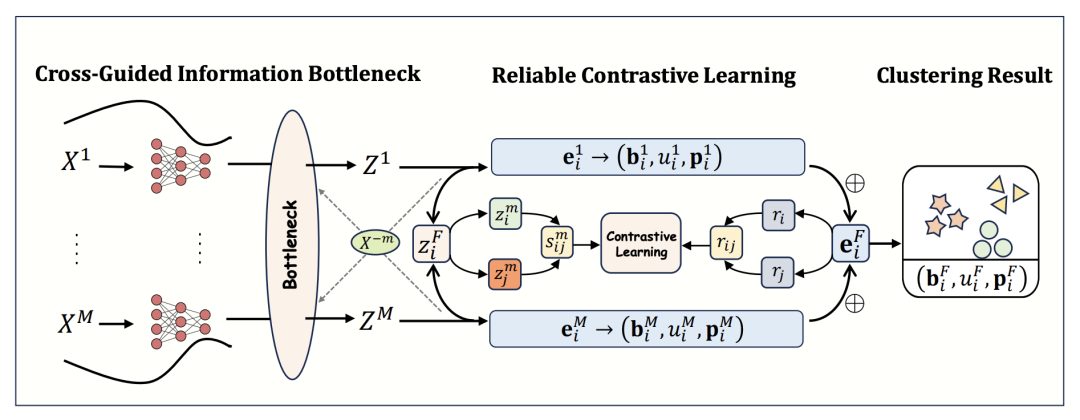
〓CGIB-RCL的跨模态信息筛选与可靠对比学习框架
在五个多模态数据集上,CGIB-RCL 的聚类准确率和归一化互信息均取得最佳成绩。其中,在 Caltech-3V 数据集上,聚类准确率达到 79.1%,归一化互信息达到 71.6%。
另一篇满分论文
零样本控制,测试时再选策略
论文标题:
Zero-Shot Control with Gaussian Representations and Test-Time Adjustment
论文地址:
https://openreview.net/forum?id=WeUNn9rlIi
最初三篇初审满分论文中,Zero-Shot Control 的情况比较特殊。两位正式审稿人都给了 4 分,11 月 11 日,AC 却在公开评论中给出 2 分弱拒稿意见。
论文提出高斯潜在动力学后继特征(GLDSF),改善零样本控制中的表征学习。
传统方法通常直接根据推断出的任务奖励选择策略,而这项工作将用于评估任务的奖励系数与决定策略的行为编码分开,在测试阶段搜索更合适的预训练策略,无须更新预训练参数或额外与环境交互。
在 ExORL 基准中,未经测试时调整的模型在图像观测下较最强基线整体提升 24.0%。加入调整后,图像任务又提升 8.4%。
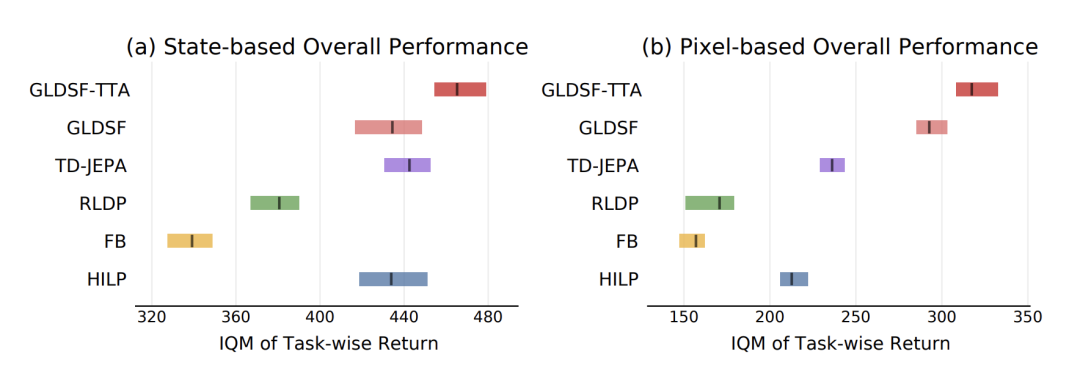
〓零样本控制方法在状态和图像观测下的性能对比
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。