EMNLP 2026 | 多模态模型越学越忘?南大CRAM发现:答对也可能被判错
让你更懂AI的 2026-11-19 00:02 北京
明明知道答案,却被判错?
给模型多教一项本领,为什么还得担心它把旧本领丢了?
让模型持续适应新数据、新需求,是许多研究者共同面对的问题。但一次更新之后,新任务的成绩涨了,旧任务却退步了。
无论是增加一种任务、适应一批新数据,还是调整输出要求,研究者都希望训练带来能力积累。
可一旦旧任务表现下降,我们往往很难判断:模型究竟丢掉了知识,还是没有按当前要求把知识表达出来?这两类问题,对应的改进方向可能很不一样。
南京大学的研究团队追问:旧任务答错了,就一定是原来的知识忘了吗?
他们在多模态模型的控制实验中发现,大量错误仍保留正确语义,只是没有遵守当前任务的输出要求。模型可能还“知道”答案,却被新任务带偏了作答方式。
基于这一观察,团队提出 CRAM:隔离容易冲突的指令,复用已有能力,再按需增加参数。工作已被 EMNLP 2026 主会录用。
论文标题:
CRAM: Centroid-Routing and Adaptive MoE for Multimodal Continual Instruction Tuning
论文地址:
https://arxiv.org/abs/2606.02502
代码地址:
https://github.com/LAMDA-CL/EMNLP2026-CRAM
开源工具包:
https://github.com/LAMDA-CL/Prism
同一道题,换个作答要求,为什么就不会了?
研究团队基于 ArxivQA 数据集做了一组“只换规则,不换题目”的实验:保持图像和问题语义一致,分别要求模型输出选项字母、选项文本、简短答案或 yes/no。
在一种形式上微调,再到其他形式上测试。
在“输出选项文本”的形式上训练后,模型在 yes/no 形式上的准确率相较零样本下降了 50.2 个百分点。检查这一设置中的错误回答,78.6% 属于“语义正确,但格式不符”。
例如,当前任务要求只回答 yes/no,模型却仍然沿用此前的作答方式。它表达的内容可能没有偏离正确答案,却无法满足任务的判分要求。
这样的退步,仅凭最终准确率,很难与知识本身的遗忘区分开来。
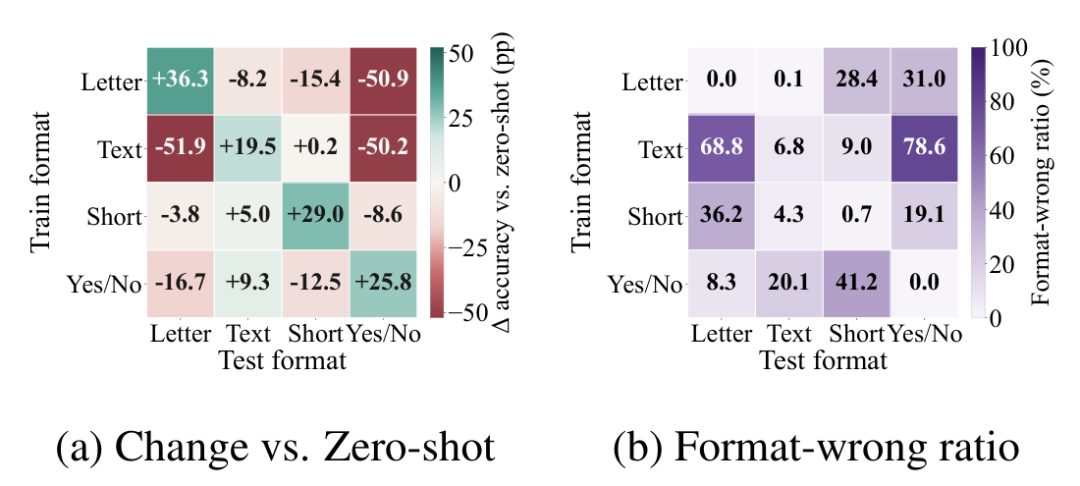
〓 图1. 不同作答约定之间的干扰:准确率变化(左),错误回答中格式不符的比例(右)
有些分数下降,来自作答规则的冲突。但将任务完全隔离,也会错过能力迁移。
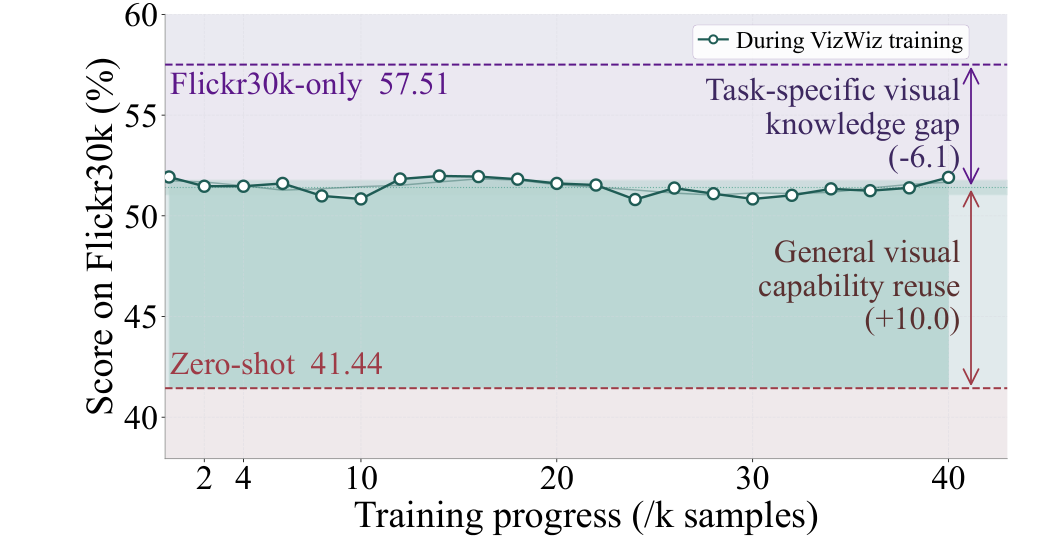
另一组实验中,在 VizWiz-Caption 上训练图像描述能力,也让 Flickr30k 的得分较零样本提高约10 个点,只是仍未达到直接在 Flickr30k 上训练的水平。
〓 图2. 跨数据集的能力可以迁移,但仍有需要补足的差距
这说明,新任务既可能带来干扰,也可能为旧任务提供帮助。相似任务之间存在值得保留的共同能力,而数据分布的差异又带来新的学习需求。
模型需要同时处理这两种关系,才能避免反复学习已有内容,又保留继续适应的空间。
CRAM 的出发点由此形成:冲突的约定有选择地隔离,共通的能力持续复用,新参数集中补足剩余缺口。
先别让不同任务的“答题规矩”打架
这项研究面向多模态持续指令微调(MCIT):模型依次学习看图问答、图像描述等任务,同时保留完成旧任务的能力。
在这一过程中,过去的数据未必能够重新获得,模型很难每次更新都把历史任务重练一遍。
让所有任务使用同一套可训练参数,容易相互干扰;每个任务各用一套独立参数,又可能阻碍迁移,并增加重复学习的成本。
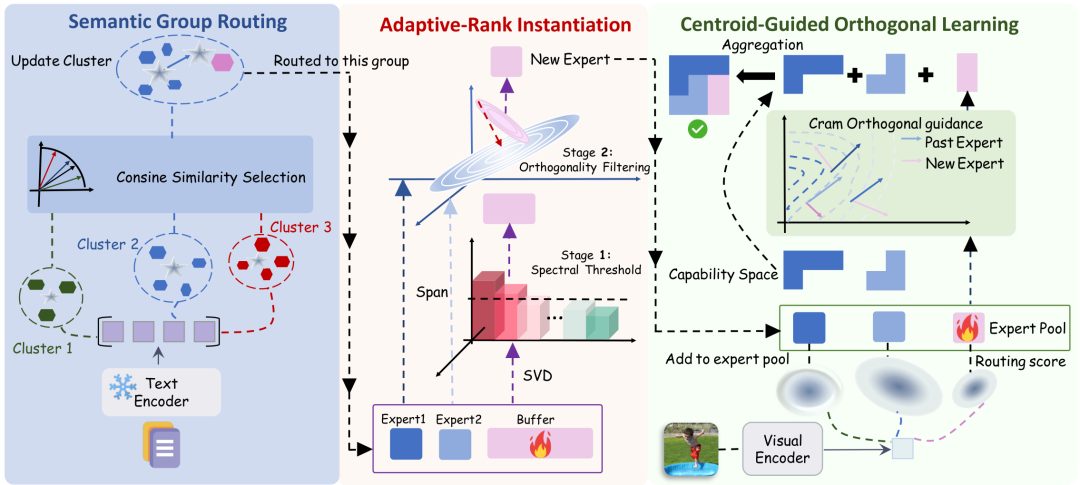
CRAM 在冻结的多模态基座上加入轻量 LoRA 专家,先用指令语义分组,确定任务之间的共享范围。
〓 图3. CRAM:语义分组、按需扩容,以及稳定的专家复用
新指令到来时,CRAM 用冻结的 CLIP 文本编码器提取表示,比较它与已有组中心的余弦相似度,并计算最高与次高相似度之差:
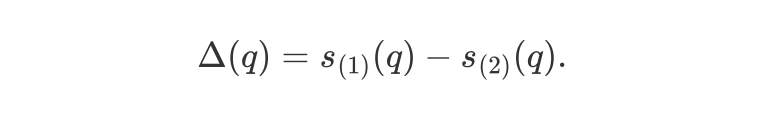
当差值超过阈值 θ,指令进入最匹配的组;否则建立新组。直观来说,匹配足够明确,才共享组内专家。
这里关注的是“第一名能否明显胜出”。如果一条指令与多个组都相近,仅选相似度最高的组,可能不足以支持可靠的共享;最高与次高相似度的差值,则为是否建立新组提供了判断依据。
分组依据是指令语义,并非为每种答案格式预先贴上固定标签。格式遵循与推理能力仍然联合学习,路由机制调整的是它们在不同任务之间的共享范围。
新任务来了,先别急着加参数
模型已经学会图像描述,再适应新场景时,未必需要把已有能力重新学一遍。CRAM 用自适应秩分配决定新专家的大小:需要补充多少,就分配多少。
LoRA 用低秩矩阵表示权重更新,秩决定了新增模块的容量。在同一层中,秩越大,所需参数也越多。
因此,为每项任务设置固定的秩,可能给简单变化分配过多容量,也难以体现不同网络层的需求差异。
具体而言,模型先短暂预热,再对临时 LoRA 更新做奇异值分解(SVD),筛掉强度较弱、或与历史方向重复的分量。
对于候选输入方向 ,其独立于历史子空间的程度为:
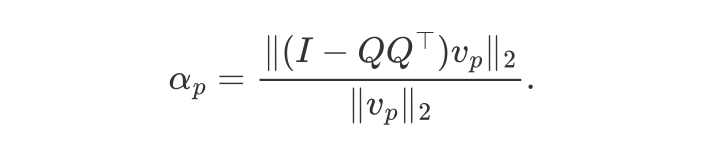
其中, 是组内历史输入子空间的标准正交基, 为单位矩阵。 越大,说明该方向中尚未被历史子空间覆盖的成分越多。
两轮筛选分别回答两个问题:这个更新是否足够显著,以及它是否提供了已有方向之外的成分。强度很弱的方向未必值得分配容量;与历史高度重合的方向,则可能带来重复学习。
同时通过强度与独立性筛选的方向,用于初始化新专家。保留多少方向,就分配多大的秩。这样,不同任务、网络层和注意力模块可以获得不同的新增容量。
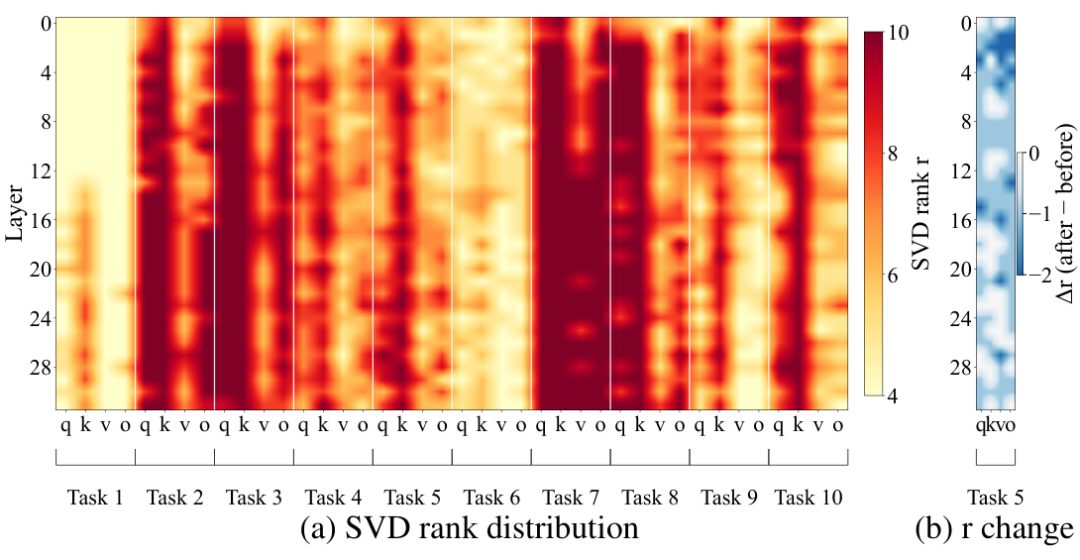
〓 图4. 不同任务、层和注意力模块的自适应秩分配(论文图 8)
这里的“能力缺口”通过更新方向与历史子空间的几何关系来估计,为按需扩容提供依据,并不等于直接测出了模型掌握的全部知识。
专家越来越多,为什么还可能答得更差?
旧专家留下来了,还要能被正确调用,并与新专家形成互补。
用视觉质心,稳定专家调用
如果路由器在学习新任务时不断变化,同一张旧图像就可能被分配给不同的专家。即使旧专家的参数没有改变,模型的整体输出仍可能退步。
因此,保留专家之外,还需要为调用它们保留稳定的参照。
CRAM 为每个专家维护一个可学习的视觉质心,根据图像特征与质心的距离,在选定语义组内分配权重:
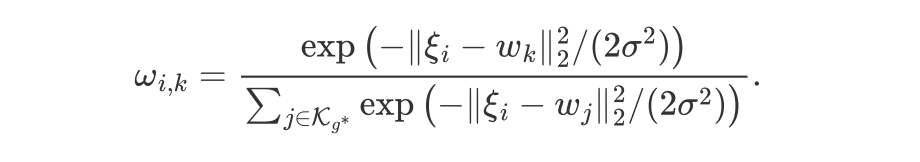
其中, 是冻结视觉编码器提取并聚合的图像特征, 是专家质心, 是组内专家集合, 控制距离的影响。距离越近,权重越高。
质心由预热图像特征的均值初始化,随当前任务训练;任务结束后,与对应专家一起冻结,为后续调用保留稳定参照。
指令语义先确定共享范围,视觉特征再决定组内专家的组合。两层路由分别处理作答要求与图像分布,让专家复用有据可依。
用正交约束,引导专家互补
专家能够一起参与回答,也不意味着它们一定互补。多个专家若反复学习相近的更新方向,聚合时可能放大重复成分,影响新旧能力之间的配合。
为减少专家之间的重复学习,CRAM 在生成损失之外加入正交惩罚,抑制新专家对历史输入子空间的响应;当前输入越依赖历史专家,惩罚越强。
它以软约束的方式鼓励专家互补,让新增参数更多用于补足尚未覆盖的方向。
与初始化时的方向筛选相比,这一步贯穿新专家的训练过程:前者减少容量分配中的重复,后者引导训练中的更新,两者共同支持能力积累。
让新能力,成为下一次学习的起点
CRAM 将持续学习中的三个问题联系起来:哪些要求需要隔离,哪些能力值得共享,哪些缺口需要扩容。
学会新东西,保住旧本领,还能为下一次学习铺路。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。