阿里巴巴两篇论文获 ATC 2026 最佳论文奖,并在港研讨 AI Native 系统的可靠性与效率
原创 阿里技术 2026-11-19 20:02 浙江
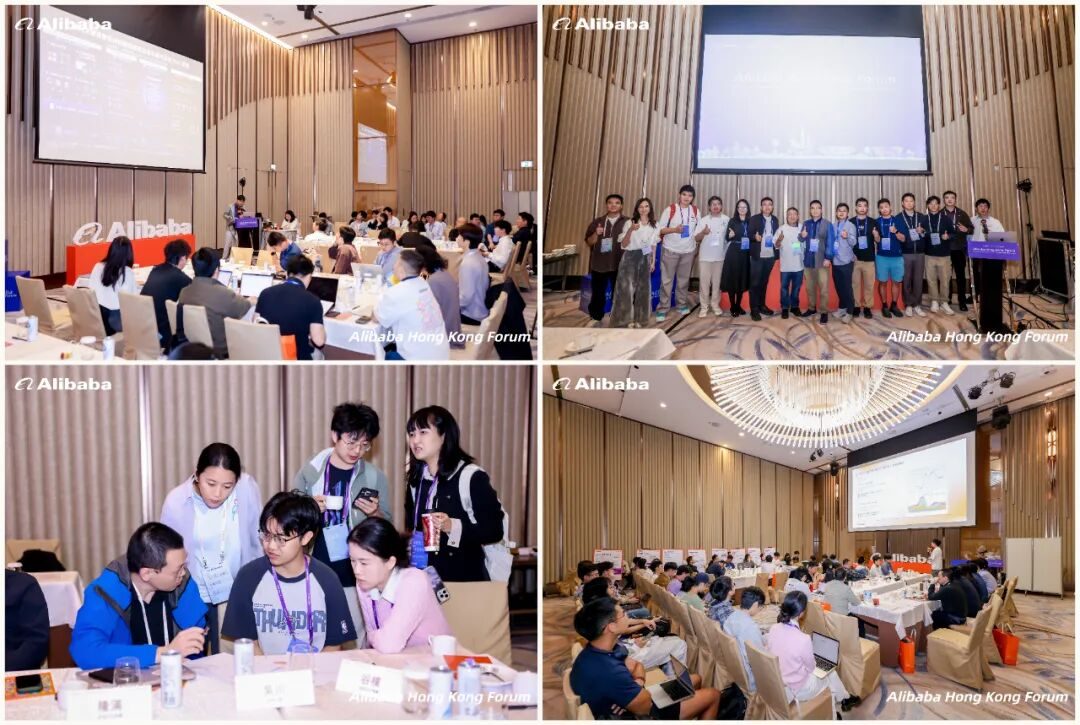
11 月 15 日,在 ATC 2026 期间,阿里巴巴于香港沙田万怡酒店举办 Alibaba Hong Kong Forum,主题为「面向下一代人工智能的全栈协同设计」(Full-Stack Co-Design for Next-Generation AI: Infrastructure, Systems, Models and Data)。设 AI Infra & AI Systems、Model & Data 两个并行 Session,高校学者与阿里巴巴技术专家分别介绍研究进展与当前面临的技术难题,30+ 位高校学者、50+ 位高校学生和阿里技术专家参与了本次技术交流。
11 月 16 日,大会公布最佳论文奖:本届 ATC 录用 135 篇论文,阿里巴巴入选 12 篇(文末附 12 篇论文解读链接🔗),并在 6 篇最佳论文中占 2 篇。
01
最佳论文:从生产系统里「长」出来的问题
本次阿里巴巴集团获评的两篇最佳论文分别为《Model-as-a-Service in the Wild: Characterizing Production LLM Inference Clusters at Scale》和《Lean: Saving OSS Network Cost by Application-Infrastructure Coordination》。
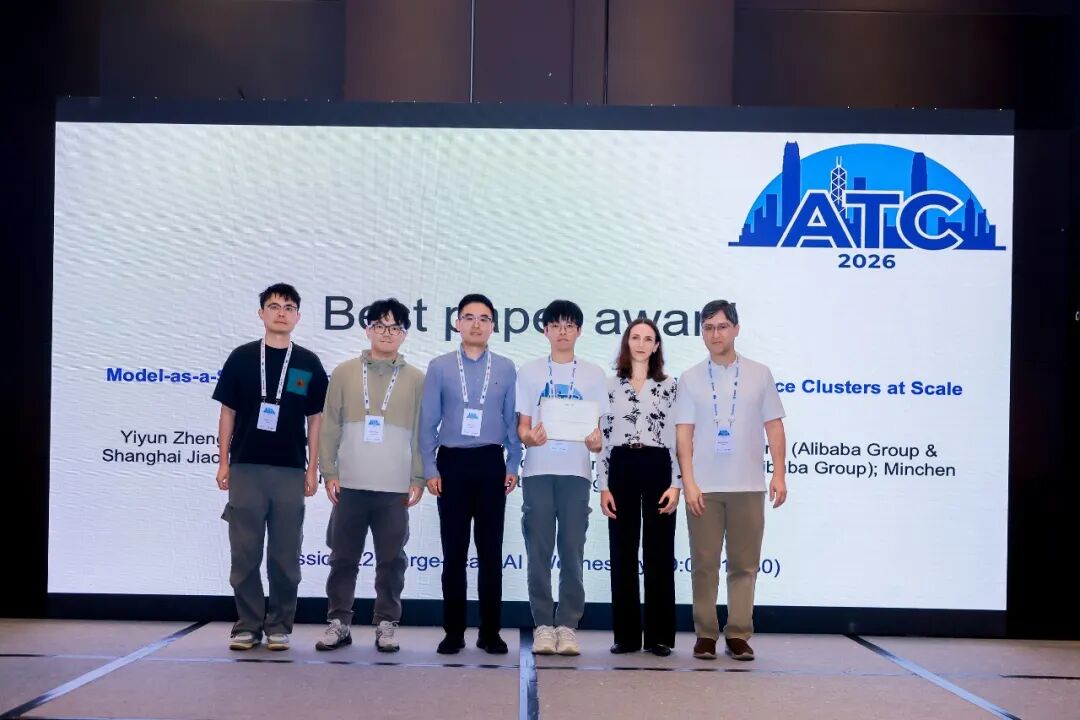
最佳论文《Model-as-a-Service in the Wild》获奖团队合影
平台技术团队的获奖论文《Model-as-a-Service in the Wild: Characterizing Production LLM Inference Clusters at Scale》,依托十万卡级大模型服务平台 xMaaS,研究连续六个月、覆盖约 30 万个应用与 7 万个模型变体的真实运行数据,从集群、应用与模型三个层面揭示显存预留与实际使用不匹配、冷模型长期占用资源等问题,为异构算力调度、精细化显存管理与弹性扩缩容提供生产依据,并同步开放脱敏数据。工作由平台技术团队与香港中文大学(深圳)余旻晨老师团队合作完成。
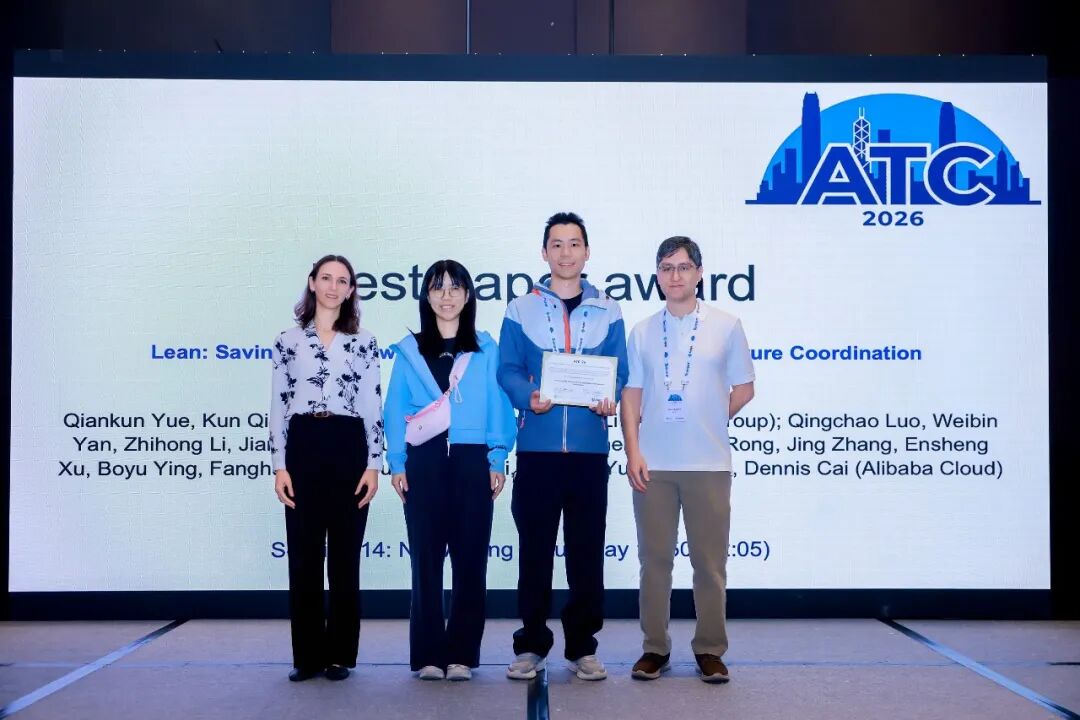
最佳论文《Lean》获奖团队合影
阿里云团队的获奖论文《Lean: Saving OSS Network Cost by Application-Infrastructure Coordination》聚焦对象存储 OSS 的网络成本,以应用与网络基础设施协同设计为思路,用 SRv6 实现轻量化边缘接入、灵活流量调度与业务流量物理隔离。系统已在生产环境持续运行四年,同等生产流量下将 OSS 网络总成本较原方案降低 55.6%。工作由阿里云与上海交通大学徐尔茨老师合作完成,徐尔茨同时担任本次系统 Room 主持人。两篇论文都以生产系统的真实约束为起点,再把结论放回生产验证。
02
两个研讨 Room:全栈协同设计为何成为共同议题
本次 Alibaba Hong Kong Forum 分设系统和模型两个 Room 进行研讨。主题设置上,系统方向讨论训推软硬协同与 Agent Infra 的可靠性,由上海交通大学徐尔茨主持;模型方向讨论 LLM 与多模态训练推理、Agentic RL、视频生成与数据评测,并要求模型侧反向定义系统所需的数据、实时性与安全边界,由香港科技大学王威主持。
2.1 系统 Room:从推理调度到 Agent 运行时的问题链
系统 Room 由来自阿里巴巴集团的谷朴开场,他表示,AI Infra 是一个非常巨大的机会,算力基建正以前所未有的速度扩张,很多天花板的突破需要从新的架构、新的方法,端到端、全栈地重新设计,才有机会把效率发挥到最大。
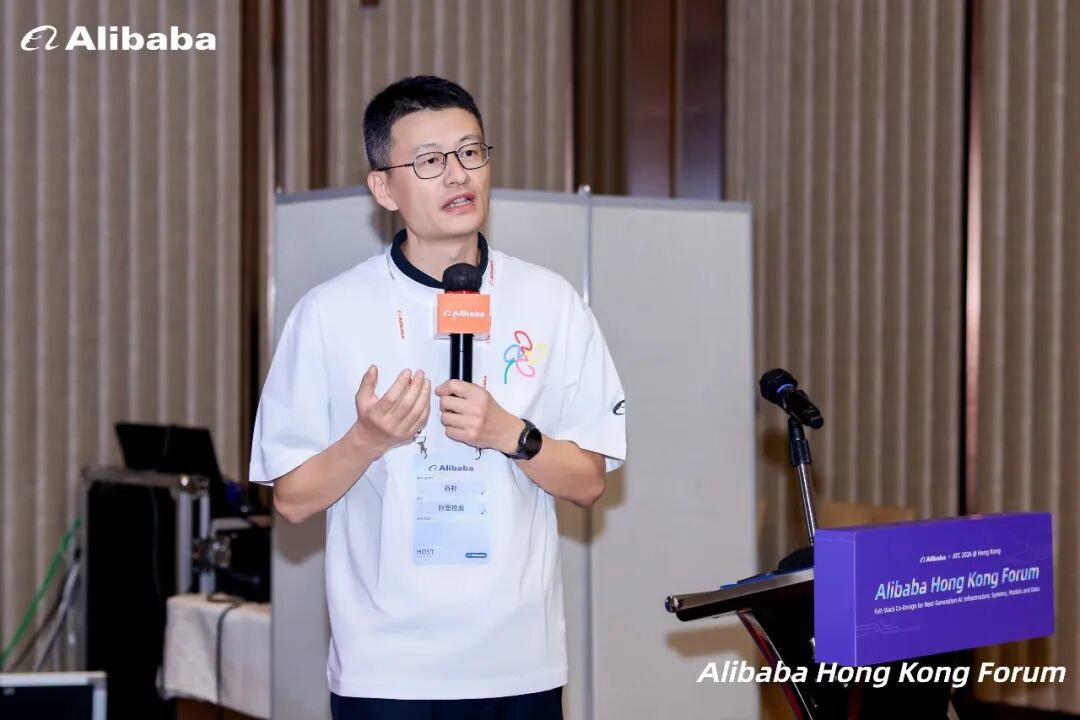
谷朴|阿里巴巴集团|系统 Room 开场
随后,四位来自阿里巴巴的技术专家依次展开 MaaS 资源调度与资源管理、推理引擎、Agentic OS,以及万亿参数与长序列模型的分布式训练。
推理服务:调度的前提已经改变
岩泉把大模型推理对基础设施的改变归到一句话,那就是:调度不再是把请求分给空闲机器,而要在有状态、强 SLO、负载还不可预测三个约束同时成立的前提下做决定。他给的两个例子最能说明这件事有多「新」——冷扩容实例因为没缓存预热要扛 100% 的计算,而热实例只扛 5%,弹性增益天然要打折;而模型与卡型的匹配决策周期,已经从搜推广时代的半年一年被压到了周级别。当 MaaS 推理、快训练、AIGC 训练和 Agent workflow 这些全都带状态的负载必须混在同一个集群里,资源调度就不再是单点优化问题,而是调度、网络和存储要一起重新设计的 co-design 问题。
喜德指出,真实 MaaS 流量下的多卡、多节点推理,计算、通信与显存成本相互牵制。团队已具备缓存感知路由、分层 KV 与 TP/PP/EP/DP 等方法,并在探索 EPLB、DP Balance、动态投机与 Kernel 优化。他提出的合作方向是联合成本模型与系统原型,在同负载、同硬件、同 SLO 条件下对照验证 Goodput、单位成本与资源开销。
训练系统:效率与正确性一起验证
雾汀结合生产案例,分享了万亿参数、百万 token 上下文训练面临的挑战。通过前置健康检查、分层 Checkpoint 和流水线预热,案例中的有效训练时间占比从约 90.5% 提升至 97%。
团队介绍了与高校合作的 VRouter、Tessera 和 Libra,分别应对 MoE 负载不均、通信开销和长序列训练扩展问题。Libra 在百万 token 上下文实验中,将数据并行扩展效率从 27.6% 提升至 70.3%。雾汀还以梯度求和为例,说明在低精度计算中,同一组数仅仅改变累加顺序,就可能得到不同的结果,进而影响模型参数更新。
Agent 运行时:系统软件的职责边界
伯瑜的问题位于系统软件层面。Agent 调用工具、修改环境并等待结果,任务进度分散在上下文、文件与远端服务之中,多个 Agent 还共享文件、工具与执行资源。开源系统软件 ANOLISA 已支撑阿里云 AgenticOS 对外服务,集成任务管理、安全治理、信息处理与恢复能力。他希望资源管理面向完整任务,协调跨轮次、跨 Agent 的状态,形成能够表达资源、权限与动作效果的公共系统接口。
学界观点:沿同一条链的不同切入点
六位学者沿着同一条链路发表观点:陈全与须成忠处理资源与调度,黄嘉逸与吴川处理训练与后训练,吴明瑜处理运行时正确性,潘恬落到网络底座。
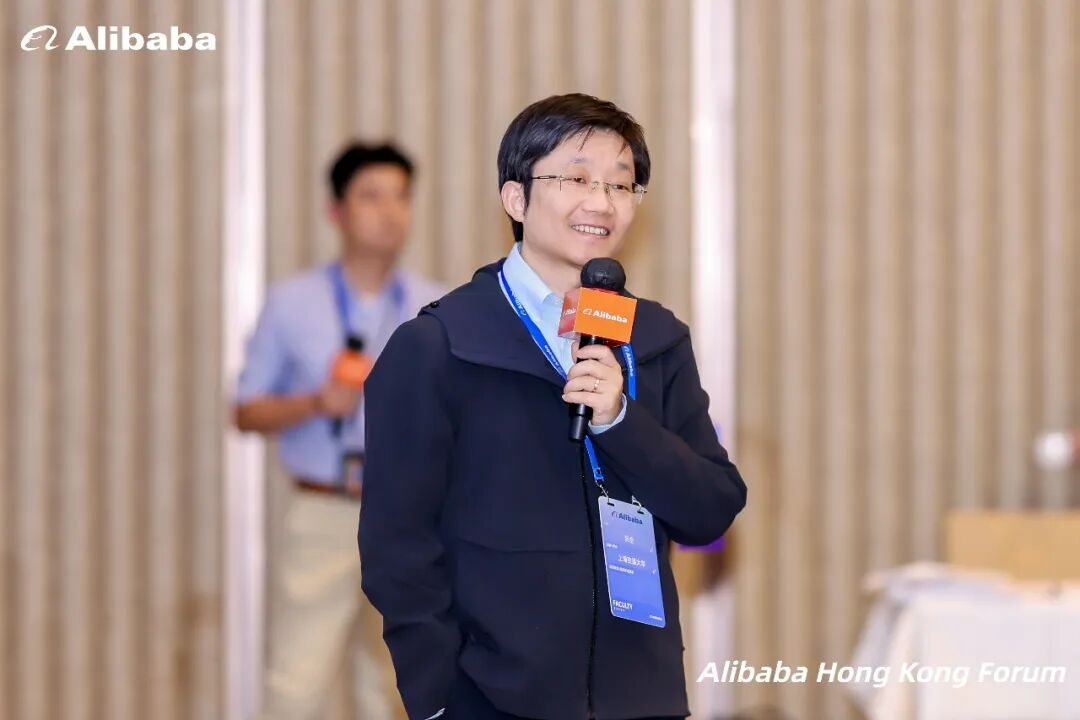
陈全|上海交通大学计算机学院先进计算研究所教授
陈全从 Agent 长会话切入:KV 与状态长期驻留显存,休眠会话持续占用资源,沙箱需兼顾秒级启动、高密度与强隔离。他将预填充与解码逻辑分离、物理混部,按 Transformer 层切分实现 SM 空分复用,优先保障解码阶段的每 token 时延,其余算力分配给预填充;沙箱镜像的只读页直接映射共享、写入私有,checkpoint 原位封存为新的只读来源;KV 卸载要求缓存池不打断 CUDA Graph、预取无损。
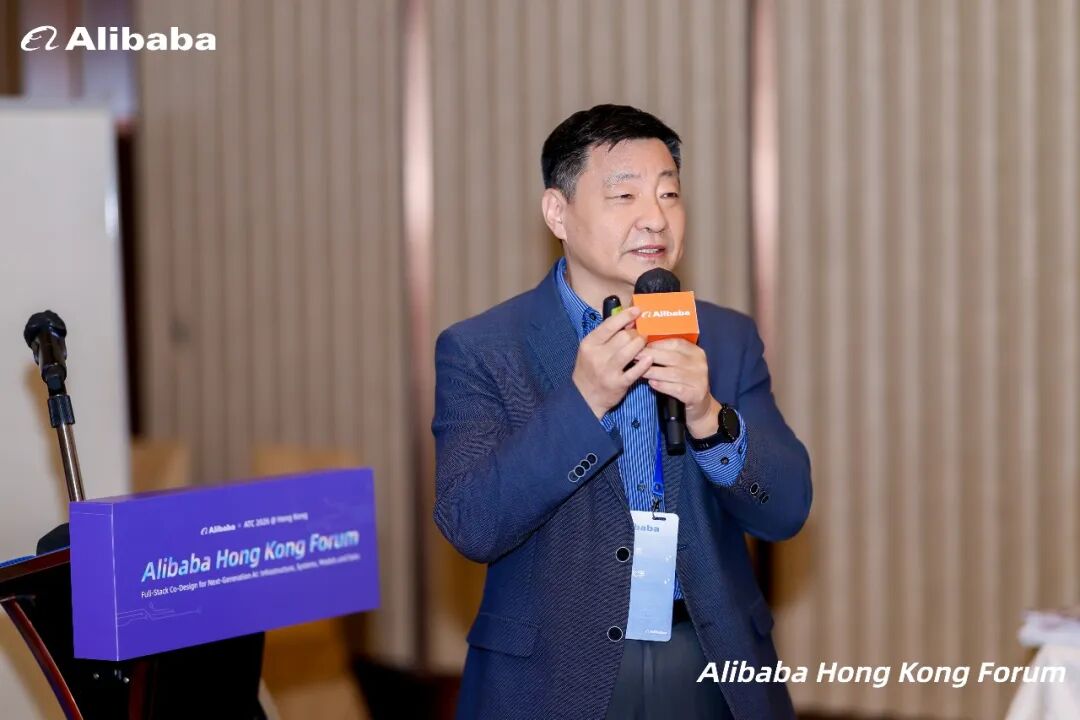
须成忠|澳门大学讲座教授、科技学院院长
须成忠将分散在各卡的 HBM 视为统一 KV 池,主张将计算调度到数据所在位置。工具处理占据 Agent 时延的主要部分,CPU 的角色由辅助转为命令层,因此可选择性地将部分解码注意力卸载至 CPU,并在云边之间动态移动流水线边界。其中 Axon 采用阿里 Aone 的生产 trace 做回放评测,也是阿里入选 ATC 2026 的十二篇之一,构成当天学界与业务最直接的接口。
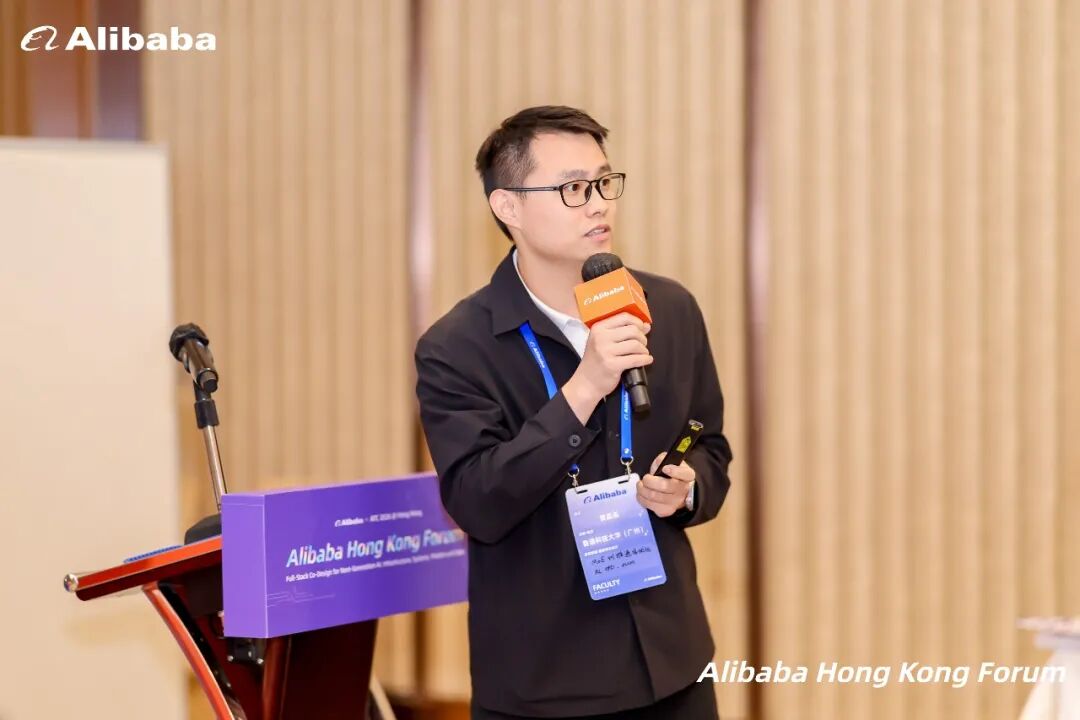
黄嘉逸|香港科技大学(广州)功能枢纽微电子学域助理教授
黄嘉逸关注 MoE 的通信与负载。All-to-All 与专家计算存在强数据依赖,难以重叠;推理阶段热门专家的负载可达平均值的数倍。ScMoE(ICML 2025)以 shortcut 连接使 MoE 层不依赖上一层的中间表达,从而实现通信与计算的重叠。推理侧以扩展的本地专家选择配合 token drop,用闲置算力换取精度,或采用张量级与神经元级双稀疏,在精度与效率之间取得更优的折中。
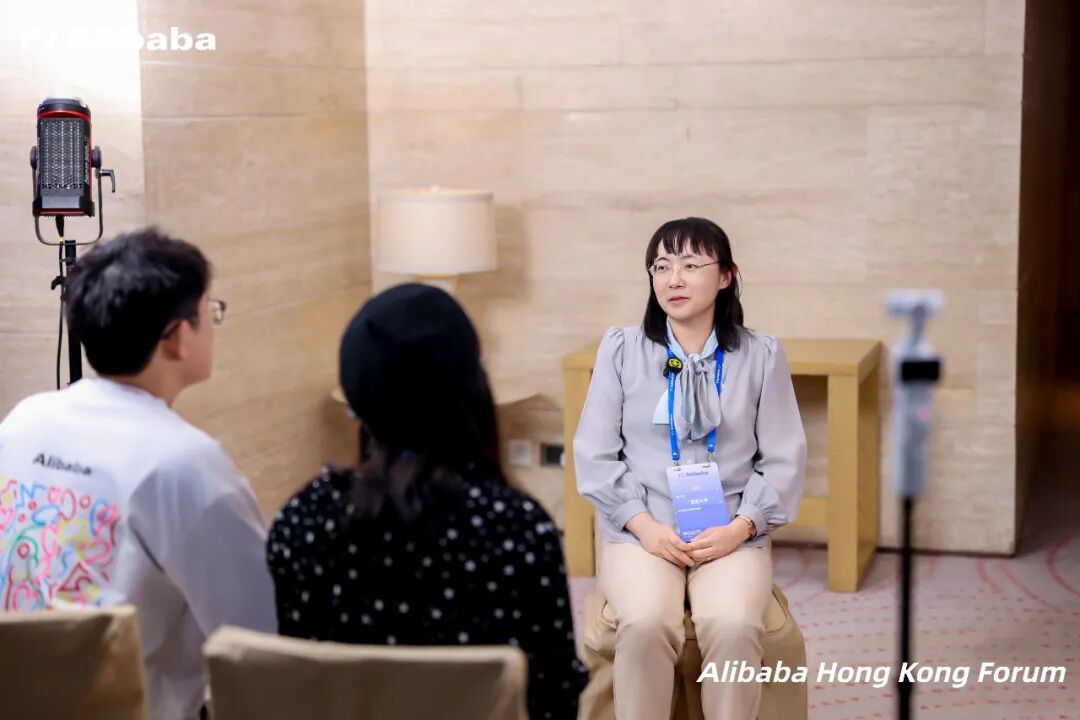
吴川|香港大学计算机科学系教授、IEEE Fellow
吴川的报告聚焦后训练框架。RL 的采样、训练、验证与奖励模块相互阻塞,长尾轨迹导致 GPU 空闲,失败经验也难以跨轮次复用。veRL/HybridFlow(EuroSys 2025)将算法写为单控制器、计算交由多控制器,先实现模块解耦;Laminar (EuroSys 2026)进一步做轨迹级异步采样与按完成量动态重打包,将生成与训练解耦;下一步是将新鲜、回放与过期数据混合纳入经验缓冲,走向以经验与验证驱动的 RSI。
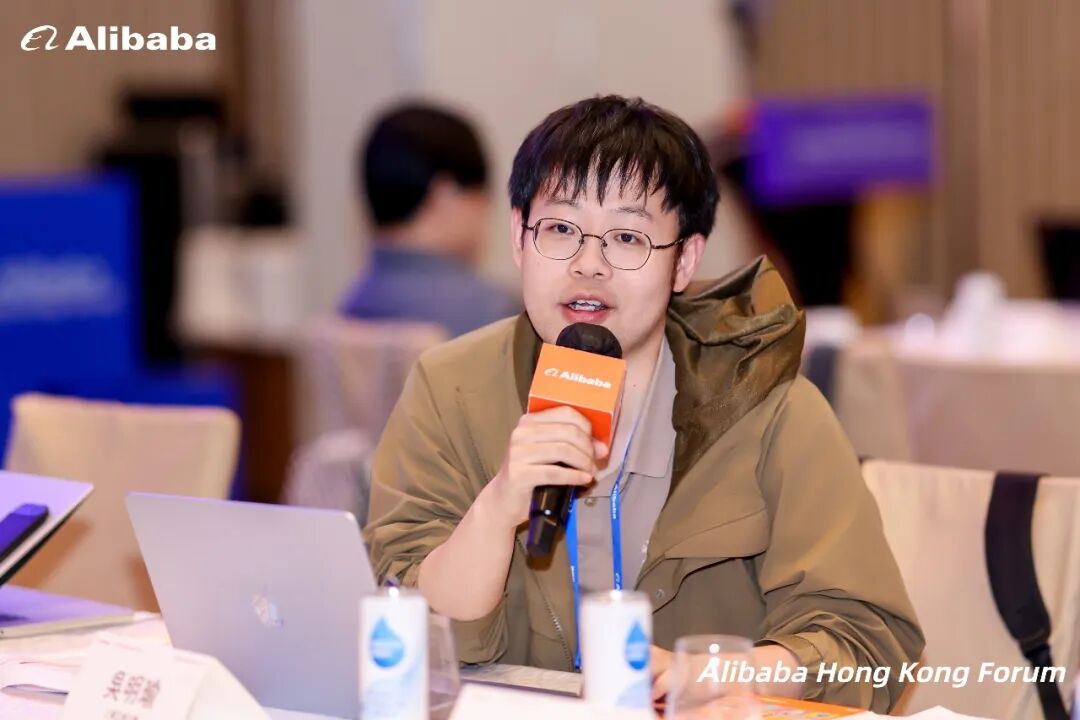
吴明瑜|上海交通大学计算机学院副研究员(IPADS)
吴明瑜讨论多个 Agent 同时修改一套运行中系统的情形。K8s 配置、共享文档等持续变化的状态会出现写偏斜,即各 Agent 单独执行均正确、并发执行后整体结果错误。经典并发控制将任务视为黑盒,冲突时整体阻塞或重新执行,但 Agent 的读集远大于实际使用的集合,任务按分钟与真实 token 计价,重新执行代价高昂。他以运行时记录的读写与输出构建细粒度因果图,冲突时通知 Agent 自行分析因果、仅修复受影响的步骤,并配合补偿与多版本读,最后配套 agent 工作流自动给工具绑定读写集与补偿动作。
潘恬指出,云网络的一些传统假设在 AI 负载下需要修正:拥塞瓶颈由网络部分转移至端侧接收,主机内PCIe 余量被压缩、PFC 背压向网络扩散;连接不再独立表示业务,RDMA 控制面使用 TCP建连、数据面使用 UDP传输,经过负载均衡器时需跨连接关联;访问服务地址到 Agent 运行时才确定,无法直接携带在数据包头;端点网络接入因 Sandbox 生命周期短而需要频繁配置更新。相应的探索包括事件驱动的最后一跳裁剪、支持 RDMA 穿越负载均衡、以 vNIC 预热池缩短网络准备时间。MCP Gateway 在注册时建立语义与词法双索引,在线融合检索候选工具,实现LLM context压缩和工具精确检索;这项工作也在阿里入选的十二篇之列。
系统侧的链条由此闭合。资源与调度、训练与后训练、运行时正确性、网络底座,共同要求是结论能在同负载、同硬件、同 SLO 下复现。
2.2 模型 Room:数据、评测与生成如何反向定义系统
模型 Room 由阿里巴巴集团的喜德进行开场。他说道,当天分享的都是商业化场景中面临的真实问题,希望和学界一起寻求更好的解法,把这些关键问题讨论清楚就是最大的收获。
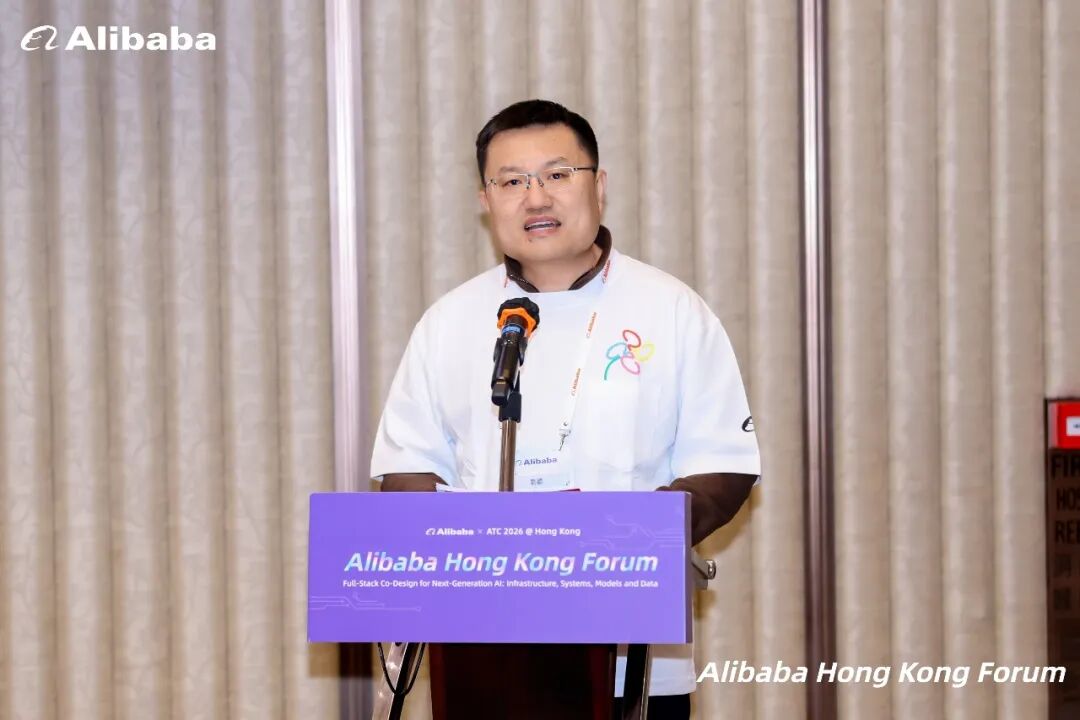
喜德|阿里巴巴集团|模型 Room 开场
喜德介绍了四位阿里技术专家的分享方向:多模态生成场景下的训练与推理 Infra、面向真实业务的大模型评测、长程 Agent 的自我演化,以及支撑 Agent 运行的 Harness 工程。
生成模型 Infra:训练效率决定能力上限,部署效率决定成本
家忙认为,现有工程体系尚不足以承载参数量与数据量增长带来的效果收益。训练侧采用 packing 与动态并行、专家均衡与 FP8;后训练作业的多任务、多租户特性通过优先级、公平性与碎片整理进行调度;推理侧将量化、稀疏、蒸馏与 Cache 联合使用,并对有损优化做在线效果监控与自适应回退。他向学界提出的问题是预训练效率翻倍的机会点、视频生成与世界模型的每秒成本还需要哪些突破,以及如何高效判断有损优化是否满足效果需求。
评测与 Harness:结果可信性的建立
雄道介绍面向真实业务的大模型评测,出发点是基准本身未必可信:公开基准数量众多,被主流引用的高质量很少,开源评测集普遍存在错题与数据污染现象。团队先确立评测集健康度指数 BHI 作为基准选择准则;评测对象从单轮答题扩展到真实职业任务,并将模型与 Harness 放在一起评估——同一模型更换一套 Harness,分数即发生变化。判分采用动态评分细则逐维加权,同时对过程建模。他列出的未解决问题包括长程多轮的过程判分、真实任务如何数据化、出题到质控的全链路自动化,以及专家偏好如何放大为稳定标准并量化一致性。
懿川进一步介绍 Harness 工程的实践和 RSI 设计。随着模型的能力不断提升,对于模型能力的要求也从“让模型回答正确”转向“让系统可靠完成任务”。在 Harness 工程上拆分为规划、路由、工具接口、执行与验证几层,同时采用统一轨迹格式与适配层把 M×N 的模型—环境适配降为 M+N。通过将 Harness 进行设计优化,设计 api proxy 的方案记录 token 与 logprobs,并持续迭代 Harness 能力,进一步实现 Harness 能力内化到模型,从而实现 Harness 和模型的协同演进。
长程 Agent:让模型反过来优化系统
长程 Agent 把这条链路接回系统侧。垂瑟指出,状态依赖、误差累积与延迟反馈使单步正确不等于任务完成。他以 Engineering 任务作为长程 RL 环境,将编译检查、数值回归、性能测量与 EDA 验证转化为 dense reward,让模型通过中间反馈持续探索、诊断与修正。已完成的实验中,Qwen 在 Kernel 优化、推理系统适配与芯片设计中持续迭代数十小时,完成从算子提速、端到端性能优化到规格驱动的 RTL、验证与物理实现。被优化的对象,正是系统 Room 讨论的推理系统与芯片实现。
学界观点:数据、机制、算法与生成
本场的五位学者分别回答上游的问题:评测是否可信,数据从哪里来,信号是否可靠,学习算法能否持续,生成结果能否可控。
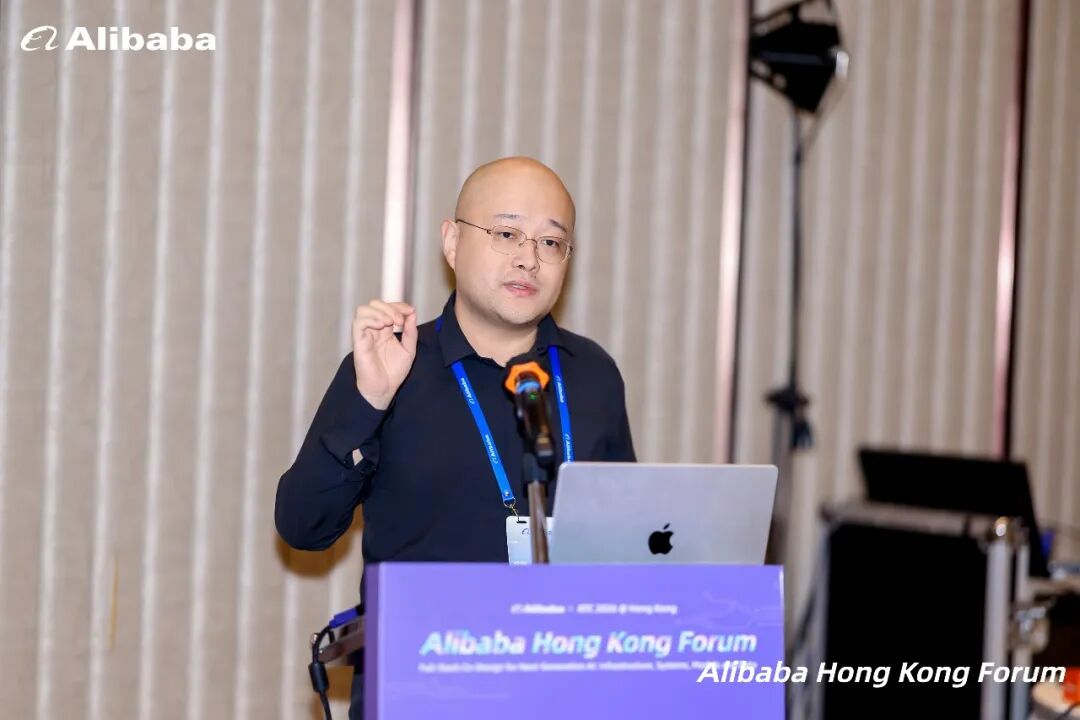
王历伟的分享主题是《大语言模型的测评与进化》,与雄道形成学界与业务两侧的对照,工作沿“测评—进化”两条线展开。测评侧,他于 2023 年推出首批综合性中文大模型评测平台 CLEVA,覆盖 31 项任务、84 个数据集、37 万条测试样本与 9 个评测维度。值得一提的是,该平台已被斯坦福 HELM 收录,在其 2025 年综述中是唯一专注于中文评测的榜单。
针对基准污染,他提出 C²LEVA 以被动防御与主动防御相结合自动生成全新试题——爬虫与模拟器采集语料、入库后经预处理、污染检测与数据增广再释放为数据集,在中英文 22 项任务上测试了 15 个模型;并将动态评测扩展到视频,NeMoBench 在 13,486 段视频上自动生成 31,378 个时序定位问题。
进化侧,他提出基于反馈的测试时训练(FTTT):由验证器判定答案对错,再用一个学习到的优化器依据失败尝试的梯度预测下一次权重更新,使模型不依赖一次性的静态训练,在推理阶段即可从反馈中持续改进。
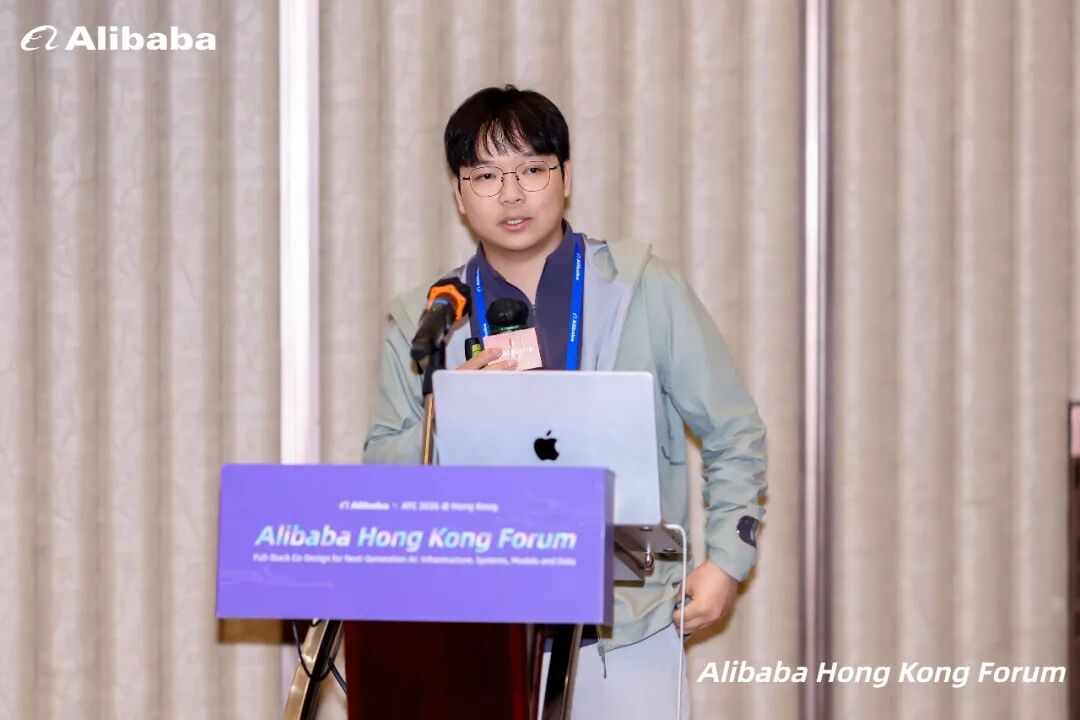
骆昱宇|香港科技大学(广州)助理教授、DIAL Lab 负责人
骆昱宇关注训练数据的来源与筛选。Agent 训练需要可交互、可验证、可复现的轨迹,以有限状态机合成网页环境,批量生成轨迹;数据选择不再额外执行一次推理,而是复用训练前向的副产物——loss、梯度、logits 与 attention——在样本与 token 两层筛选。推理侧将专家拆分为原子专家、以笛卡尔路由降低开销,目标是把执行瓶颈从访存受限转向计算受限。
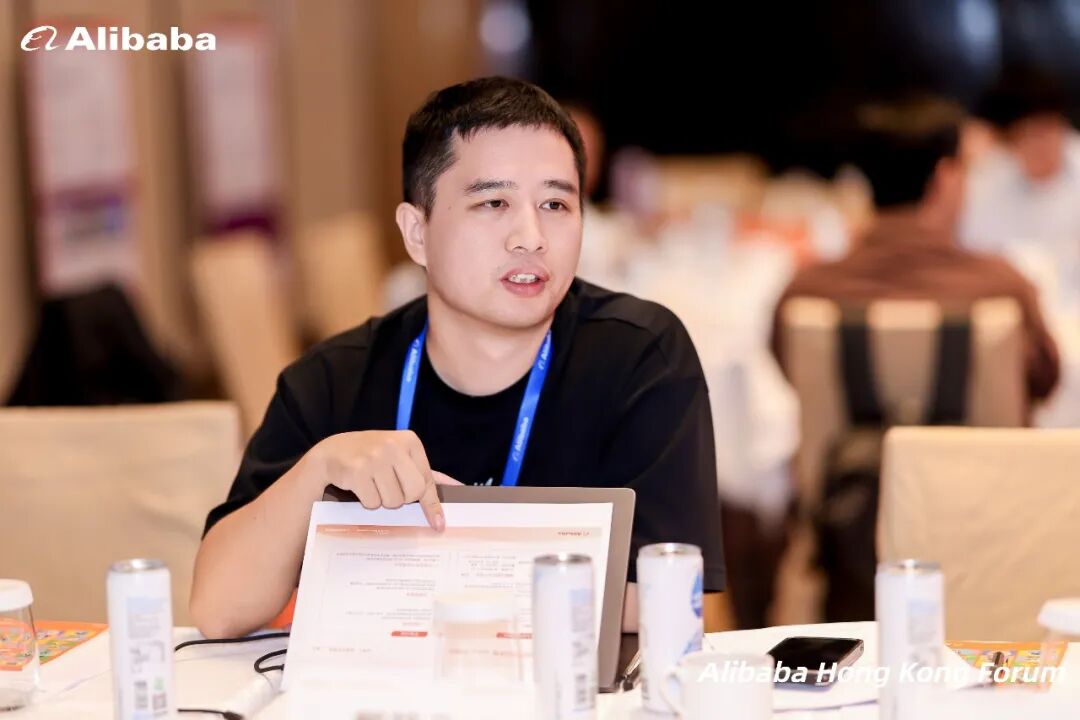
邹荻凡|香港大学助理教授
邹荻凡的报告系统性梳理了 LLM 可解释性的多个层次。理论层面,报告从 Transformer 的表达力、训练动力学与泛化出发,讨论上下文学习、思维链与推理能力的数学基础,并进一步揭示模型能力与网络深度及内部计算机制之间的关系。现象与物理驱动层面,报告强调通过可控数据干预、因果中介分析和机制观测,刻画模型真实决策依据,以及训练与规模变化对模型能力的影响。通用解释工具层面,报告以 circuits 与稀疏自编码器 SAE 为代表,覆盖机制定位、模型编辑、控制与扩散语言模型等应用,并指出目前常用的可解释工具 SAE 在 token 级容易停留在表层特征,chunk 级更有利于发现可靠语义特征。更进一步,报告还尝试从第一性原理出发,设计更自然可解释、更节能的模型架构。同时,报告阐述了可解释性研究对生产环境中性能的作用与机制,并强调其应反哺算法与数据设计,形成理解机制、验证效用、改进模型的闭环。
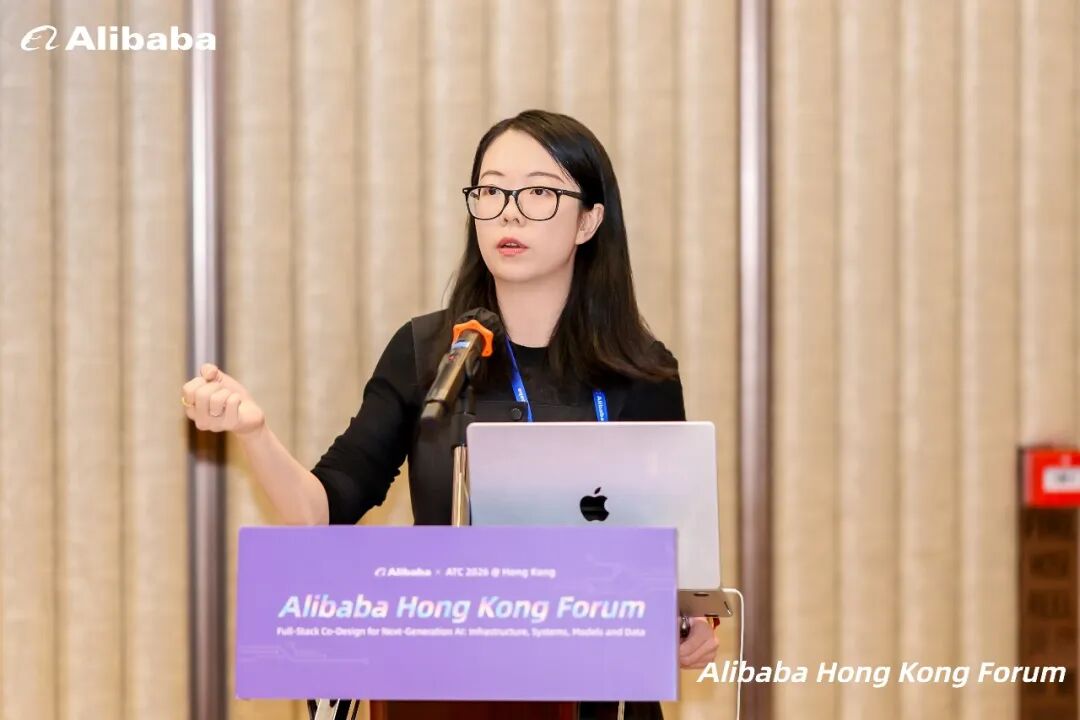
潘玲|香港科技大学助理教授、智能决策实验室负责人
潘玲以“Keep RL learning at scale”为主线,回顾了强化学习从经典 RL、深度 RL 到基础模型RL的几次发展浪潮。在适应性上,她指出 RL 面临非平稳的学习环境,智能体会逐渐丧失学习可塑性;她提出以梯度幅值而非激活值度量神经元活性,周期性重置休眠神经元,并以动态拓扑生长调和稳定性与塑性的两难;提出在 SFT 到 RL 的交接处恢复模型塑性。在实用性上,她指出大模型可验证奖励的决策 MDP 结构比传统控制问题的 MDP 具备更清晰的结构,算法因而可以大幅简化:评估均匀随机策略、再根据其 Q 值贪心行动即接近最优,极简RL算法在多个模型规模与分布外任务上超过大模型RL算法;对图像与视频生成等不可验证奖励,则以多样性寻求抑制 reward hacking。最后,她展望了让 RL 在规模化中持续学习的路线:配合算法与系统协同设计,构建可靠的 RL 技术栈。
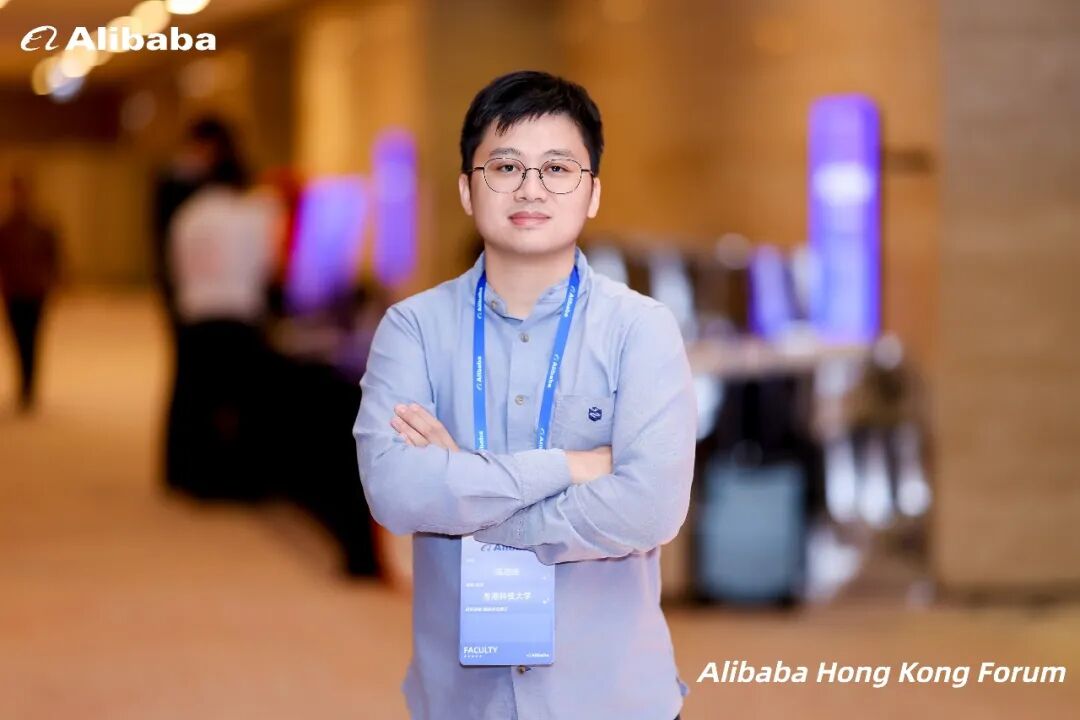
陈启峰|香港科技大学副教授、CAiRE 主任
陈启峰的报告聚焦可控视频生成。可执行的世界已能给出相机、运动与持久状态的控制,但通用视频渲染器在事件时序、未见视角与回访时的外观一致性上仍不稳定。他的路线是 code-to-real:Builder 与 Reviewer 构建世界,Planner 与 Compiler 产出代理与状态轨迹,再以"生成—审核—修复"的有预算循环产出合格配对,最后冻结主干、每个世界一个 LoRA 适配器做递归蒸馏。其分工是程序保存世界状态,渲染器学习如何呈现。
2.3 开放问题与现场讨论
报告之外,为加强学界和业界的交流,本次 Alibaba Hong Kong Forum 设置了研讨环节。
系统 Room 从云端与本地 Agent 的系统支撑问起。阿里云技术专家认为两边并存,需要同一层面向 Agent 的系统抽象;云上更像沙箱,本地握着用户数据,操作须更谨慎。Agent 大部分时间在等待,难点是系统不了解任务状态,挂起与恢复要快到用户察觉不到。安全被反复提起:本地权限放开后环境可能被篡改,可信执行环境是一个思路。
模型 Room 两组讨论评测、数据与奖励的可信性。可解释性与数据组认为,判断“某个激活对应什么概念”仍靠假设与对比实验,没有理论保证;垂类与通用数据的投入与配比未定。视觉生成组先谈“训不动”:视频 token 极长,几十秒时长前后难一致;“高质量”标准互相冲突,审美难量化,多模态 RL 的 reward 难定义也易被 hack。与会者倾向从特定场景的小规模数据构建与验证开始合作。两组其实是同一问题:评测、数据与奖励都需要可信裁判。
03
Alibaba Hong Kong Night × AliStar Wonder Night晚宴
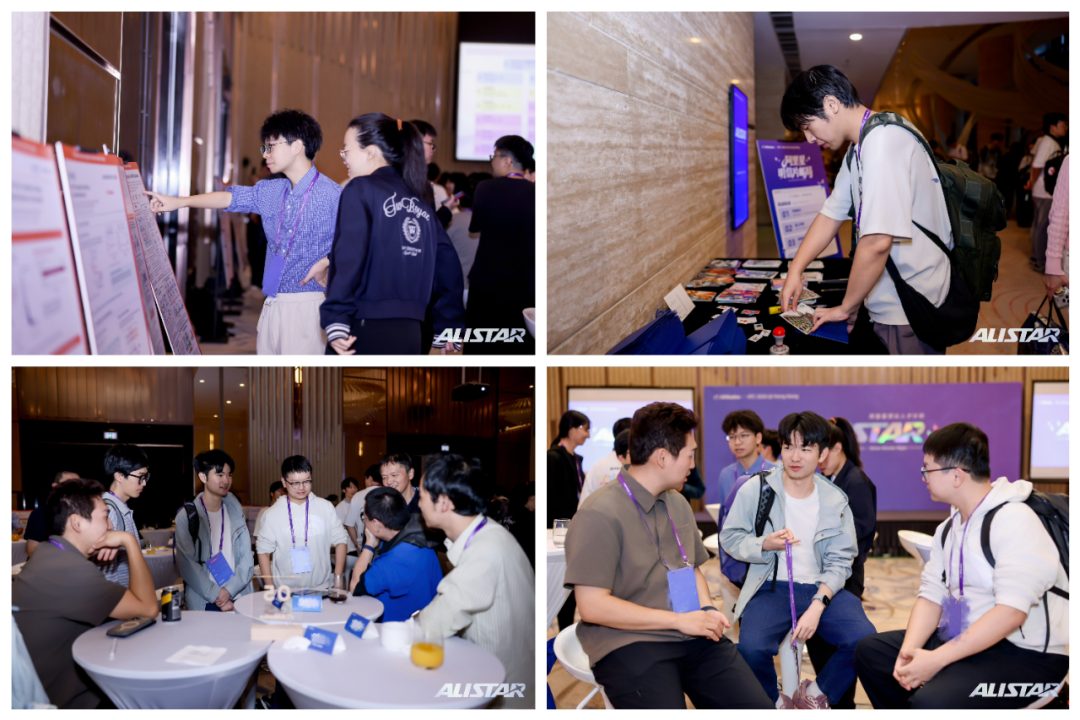
当晚,Alibaba Hong Kong Night × AliStar Wonder Night 晚宴圆满举办。晚宴进一步汇聚了 30+ 位高校学者、百余位学生,与阿里巴巴业务技术团队展开面对面交流,为高校师生与业务专家提供了开放、平等的对话平台。
现场特设的论文 Poster 展示区前,同学们与业务技术专家就具体的研究方向进行了深入探讨。在自由交流环节,与会师生不仅更直观地了解了阿里巴巴的前沿技术探索与产业落地中的真实难题,也让阿里业务团队听到了来自高校的研究思路与观察。期间,阿里星 HR 团队与青年学者们就课题方向及职业发展规划进行了深度沟通。
阿里巴巴希望通过此类交流,推动更多师生围绕产业问题开展研究,为后续科研合作、学生实习和人才交流建立长效联系。目前,“阿里星顶尖人才计划”持续面向全球开放招募,我们期待与更多顶尖大脑并肩同行,在真实的产业场景中,将研究落地为改变世界的力量。
04
展望
接下来,阿里巴巴会把更多生产一线的真实问题带进高校实验室,学界的新方法也会放到阿里的真实负载里检验,双方在 AI 系统和模型研究上能做成的事,会比今天更多。
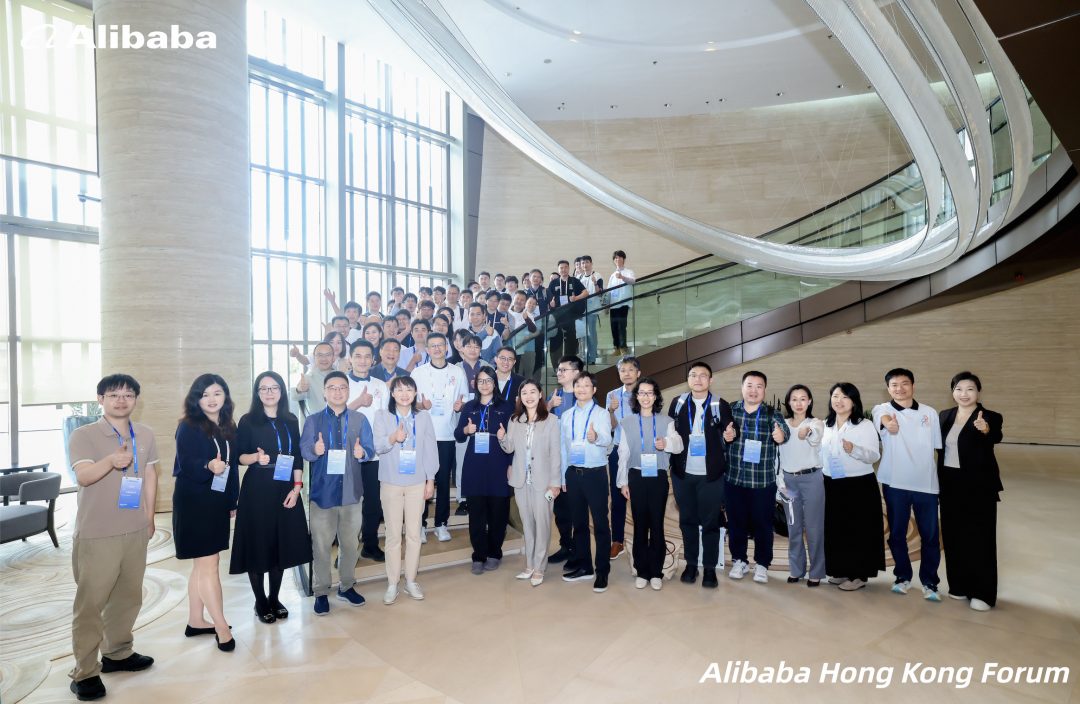
现场花絮:
*延伸阅读:阿里巴巴 12 篇论文入选全球系统顶会 ATC 2026(内附下载)

欢迎留言一起参与讨论~
本文转载自微信公众号「阿里技术」,查看原文。版权归原作者所有,如有侵权请联系删除。