具身评测提速 15.8 倍:上交发布一站式评测工具 RoboScope Kit
原创 52CV 2026-11-20 22:38 江苏
上海交通大学人工智能学院 MINT 实验室(赵波团队) · 2026 年 11 月
近年来,视觉-语言-动作(VLA)模型受到具身智能研究者的关注,研究者在 LIBERO、RoboTwin、CALVIN、RoboCasa 和 RoboDojo 等仿真 Benchmark 上评测模型表现。π0.5、π0.7、GR00T N1.7、LingBot-VLA 2.0 和 MolmoAct 2 等模型陆续推出。
模型越多、迭代越快,评测就越频繁。比较两个检查点、换一个随机种子、查看训练中途的效果,都要把几百到几千个回合重新跑一遍。
仿真评测有两个难题:
1. 对接繁琐。 每个 Benchmark 有自己的启动方式、观测格式和动作约定,每个模型家族有自己的预处理和推理流程。把几个模型放到几个 Benchmark 上比较,每一对组合都要单独写一份对接代码。
2. 评测太慢。 用 StarVLA 的公开检查点,StarVLA 官方评测在一张 RTX 4090 上跑完 500 个 LIBERO-Long 回合要 49.8 分钟;在 RoboTwin Easy 上,单张 RTX 4090 跑 500 个回合要 7.0 小时,即使用四张 RTX PRO 5000 并行跑完标准的 5,000 个回合(50 任务 × 100 回合),也要 17.5 小时。
01. RoboScope Kit:一站式具身评测工具
上海交通大学人工智能学院 MINT 实验室(https://mint-sjtu.github.io/)(赵波团队)在 arXiv 发布技术报告,推出一站式具身评测工具 RoboScope Kit(下称 Kit)。
研究者为模型写一个 Python 类,就能在所有提供其所需观测的 Benchmark 上评测;Kit 的适配器已覆盖 10 个主流仿真 Benchmark,包括 LIBERO、LIBERO-Plus、LIBERO-Pro、RoboTwin 2.0、RoboDojo、CALVIN、RoboCasa GR-1 Tabletop、MetaWorld MT50、RLBench 和 robomimic,并可持续扩展。
按纯评测时间统计:
在一张 RTX 4090 上,Kit 跑完 500 个 LIBERO-Long 回合用时 11.2 分钟,比 StarVLA 官方评测快 4.4 倍,成功率与官方评测等效;开启 CUDA MPS 后用时 8.1 分钟,比 StarVLA 官方评测快 6.2 倍,比 RLinf 快 3.8 倍,比 vla-eval 快 2.1 倍。
在单张 RTX 4090 的 RoboTwin Easy 500 回合跨系统对比中,Kit 用时 31.9 分钟,比 StarVLA 官方评测快 13.2 倍,比 vla-eval 快 7.3 倍,比 RLinf 快 2.2 倍。
在四张 RTX PRO 5000 上,Kit 将标准 5,000 个 RoboTwin Easy 回合从官方评测的 17.5 小时缩短到 66.4 分钟,快 15.8 倍,全部 5,000 个回合的成败和终止步数都与官方评测完全相同。Kit 以 Python 包形式发布,pip install roboscope-kit 即可安装。
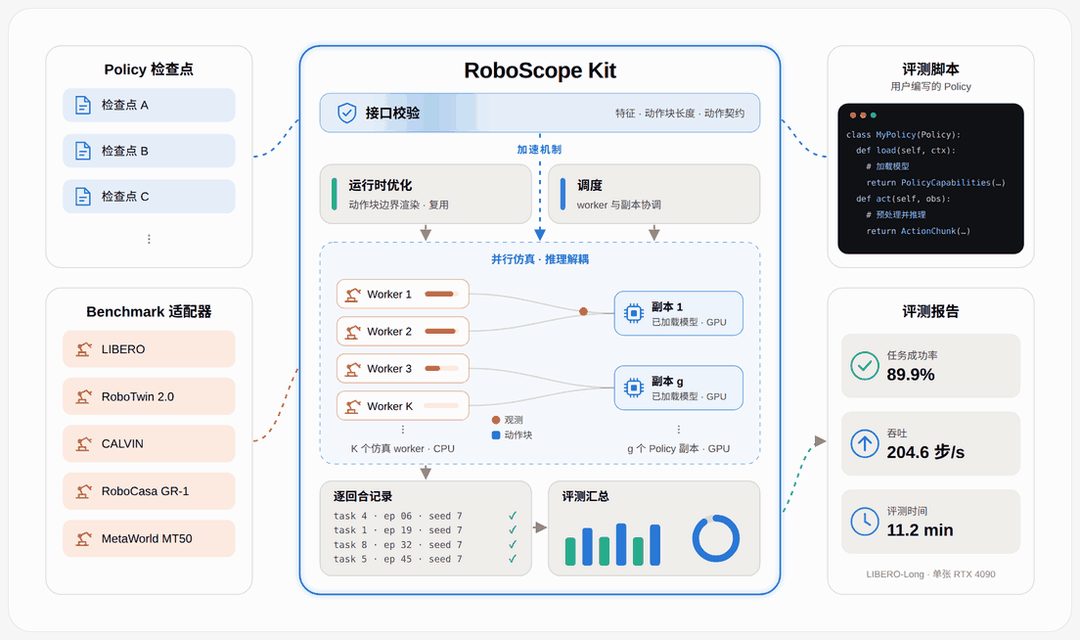
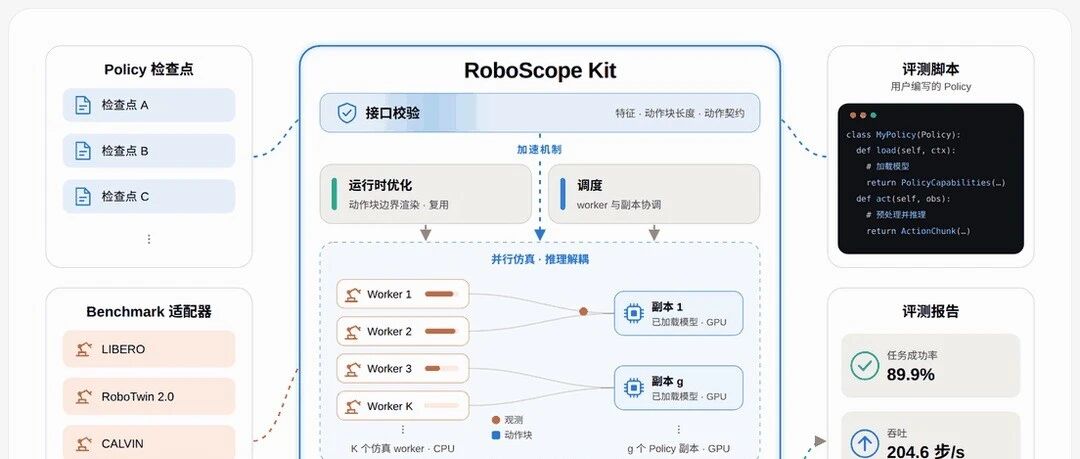
RoboScope Kit 系统总览:模型检查点与 Benchmark 套件接入统一的评测运行时
报告名称: RoboScope Kit: Unified Interfaces for Fast and Scalable Embodied-AI Evaluation
MINT 实验室:https://mint-sjtu.github.io/
安装: pip install roboscope-kit
02. 一次接入,处处可评
Kit 把每个模型封装成一个 Policy 类。Policy 加载检查点,保留模型自己的预处理,并声明三件事:需要哪些观测、一次输出多少步动作、多久需要一次新观测。每个 Benchmark 通过一个适配器接入,任务定义、初始状态、终止条件和打分规则都由 Benchmark 自己的评测器执行。评测开始前,Kit 检查 Policy 声明的能力与 Benchmark 的观测、动作约定是否匹配;评测中逐条检查观测和返回动作的类型与维度。
每个模型和每个 Benchmark 各接入一次,M 个模型、N 个 Benchmark 的对接从 M×N 份减少到 M+N 份。下面是 Kit 仓库中的 UserPolicy 示例,以 LIBERO 的 libero_10 为例:
import numpy as np |
示例中的 load_model 和 model.predict 代表模型自己的加载与推理方法,接入时需要按实际模型实现。
接入其他 Benchmark 时,Policy 声明相应的支持范围,Benchmark 适配器提供模型所需的观测。Kit 已覆盖 10 个 Benchmark:LIBERO、LIBERO-Plus、LIBERO-Pro、RoboTwin 2.0、RoboDojo、CALVIN、RoboCasa GR-1 Tabletop、MetaWorld MT50、RLBench(PerAct 18 个任务)和 robomimic,并在持续扩展。
Policy 也可以带状态。X-VLA 每次推理要读入自己上一段动作的末端位姿,它的 Policy 按回合编号(episode_id)保存这份状态,一个加载好的模型因此可以同时服务多个仿真器的回合。
03. 两种加速方法:运行时优化和调度
团队拆开官方评测流程逐段计时,发现两处浪费:
仿真器在做重复工作。 在单张 RTX PRO 5000 上剖析 StarVLA 的 RoboTwin 官方评测(100 个回合),每个回合都重建仿真引擎和渲染器,并先用专家轨迹校验种子(占 6.9%),场景搭建占 5.2%,按任务重启策略服务还额外增加 5.3% 墙钟时间;控制循环在每个物理步内重复相同计算。更重要的是,主流 VLA 一次输出一段动作,RoboTwin 上的 StarVLA 检查点一次输出 16 步,官方评测器却每一步都渲染 4 路相机画面(单次渲染约 42 毫秒,占评测器时间的 43.5%),而模型只读取其中 3 路,且每 16 帧里只读 1 帧——100 回合共渲染 37,064 次观测,只有 2,346 次被策略读取,93.7% 的渲染从未被使用。
硬件在空转。 StarVLA 自带的 LIBERO 评测里,一个仿真器和一个模型轮流执行。仿真和每一步的观测、动作处理在 CPU 上占评测器 55% 的时间,这期间模型在等待;模型推理时仿真器在等待。一次推理 55 毫秒,其中 GPU 执行计算的时间为 26 毫秒。整个评测中 GPU 平均利用率为 14.3%。
Kit 用两种方法分别解决:运行时优化去掉每个仿真器内部的多余开销,调度让 CPU 和 GPU 同时忙起来。
方法一:运行时优化
Kit 针对 RoboTwin 仿真器内部的开销做了一系列优化:
复用仿真引擎和渲染器。 每个仿真器只创建一次 SAPIEN 引擎和渲染器,供它运行的所有回合使用;在 5,000 回合等长运行中,释放已完成任务的场景显存以防显存耗尽。
跳过专家校验和 cuRobo 初始化。 Kit 直接读取预先校验好的种子缓存,跳过专家校验。关节角控制不需要 cuRobo,Kit 不再初始化它;在一个三回合的对照实验中,准备总时间从 45.2 秒降到 1.4 秒。末端位姿控制仍需要 cuRobo,每个仿真器复用一个规划器。
精简控制循环。 提出官方控制循环中在每个物理步内重复的被动力计算,避免重复求解。
动作边界观测与按需相机渲染。 模型一次输出 16 步动作,只在第 1 步读取观测。Policy 把观测步长声明为 16 后,Kit 只在每段动作的边界渲染新观测,物理仿真、动作执行和成功判定仍按原生频率逐步进行;同时只渲染策略实际读取的 3 路相机(跳过未使用的前置相机,图像与官方逐比特一致)。在单卡对照实验中,渲染的画面从 2,100 帧减少到 132 帧,吞吐提升 2.5 倍。
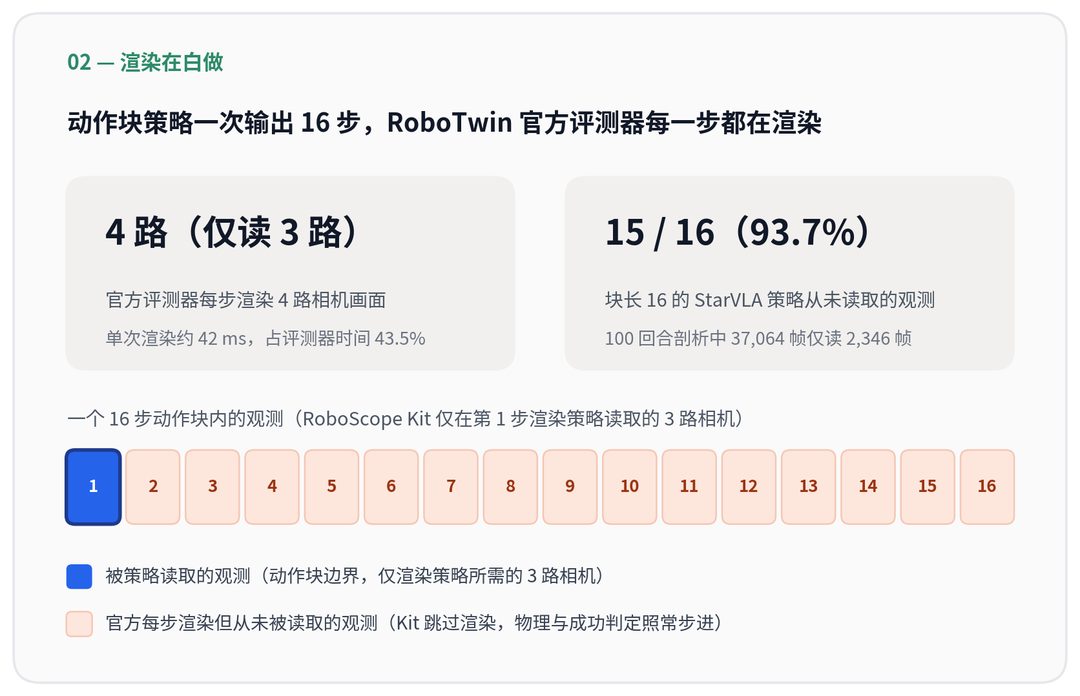
动作块长为 16 步时,RoboTwin 官方评测器每步渲染 4 路相机,93.7% 的观测从未被策略读取
在一张 RTX 4090 上,用一个只保持当前关节状态的占位 Policy 逐项叠加运行时优化,RoboTwin 吞吐从每秒 8.88 步升到 32.38 步,是官方流程的 3.6 倍。在四张 RTX PRO 5000(K4/g4)上用真实的 StarVLA 模型评测 100 个 RoboTwin Easy 回合,上述运行时优化合起来把评测时间从 1,349 秒缩短到 552 秒(快 2.4 倍),每个回合的成败和终止步数都与官方一致;在 500 回合上,仅运行时优化一项就带来 2.1 倍提速。
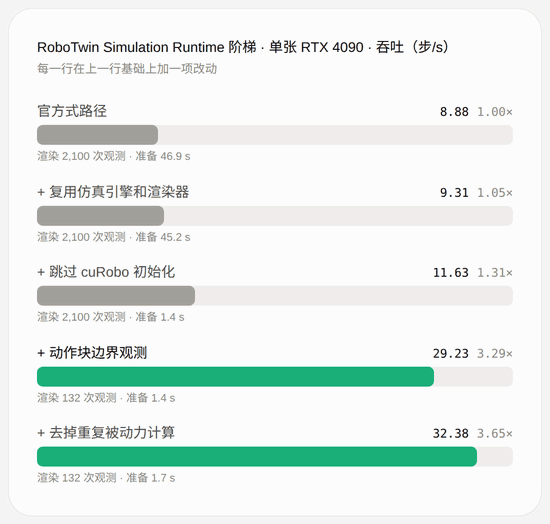
RoboTwin 单卡运行时优化逐项叠加的吞吐,使用保持关节状态的占位 Policy
方法二:调度
仿真和推理分开扩展。 Kit 把仿真器和模型拆成两个独立的资源池:仿真器按 CPU 核数扩展,模型副本按 GPU 显存和算力扩展,多个仿真器共享同一个模型副本。仿真器和模型副本是各自独立的进程,Benchmark 和模型可以使用各自的 Python 环境;不论运行多少个仿真器,显存里只放模型副本数那么多份模型。
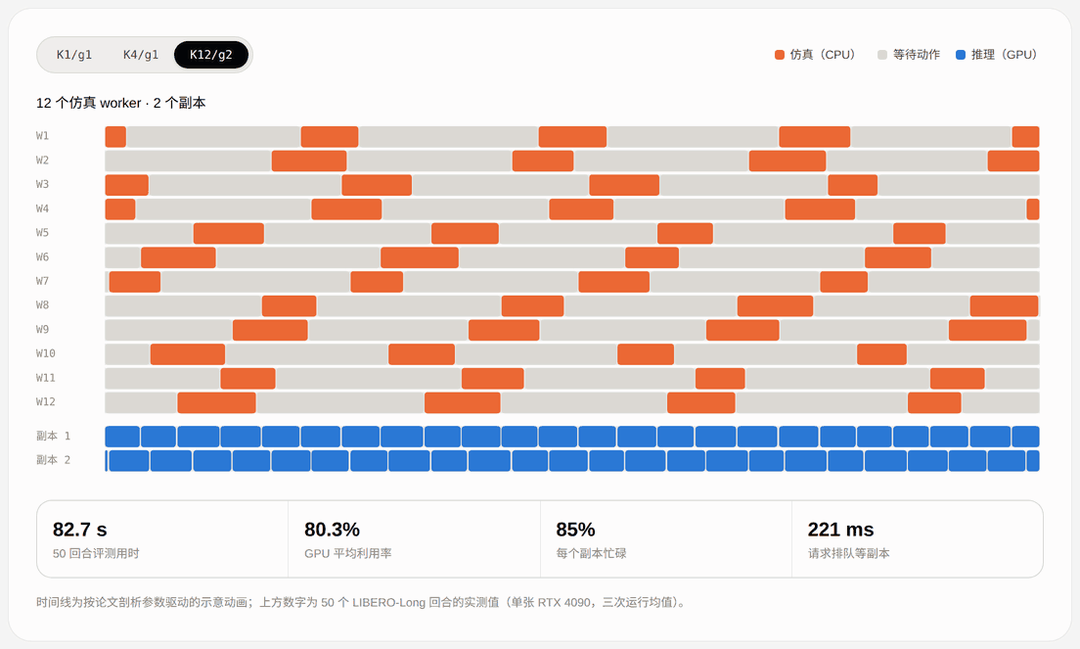
不同仿真器和模型副本数量的运行时间线
时间线按剖析参数生成;图中的时间和利用率来自 LIBERO-Long 50 回合的实测。
在一张 RTX 4090 上评测 LIBERO-Long,12 个仿真器共用 1 个模型副本时,GPU 平均利用率为 46.3%;加上第二个副本,利用率升到 87.7%,评测时间从 1,216 秒缩短到 748 秒(快 1.6 倍),显存峰值为 25.0 GiB。
并发数自动选(Autotuning)。 仿真器和模型副本的数量要一起定。只有一个模型副本时,仿真器加到 4 个后,吞吐稳定在每秒 112–114 步;加上第二个副本,K12/g2 吞吐达到 K1/g1 的 4.8 倍,K16/g4 进一步提高到 5.3 倍。
最优组合随模型、Benchmark 和机器变化。Kit 内置的对角线并发搜索用真实工作负载做短时探测,自动选出这两个数量,并在副本阶段加入显存回退机制(预测显存放不下时按 GPU 数逐步回退仿真器数)。
在 LIBERO-Long 上,Kit 只探测 7 种配置(对比网格搜索 18 种完整运行),不开 MPS 时选出 K12/g3(与网格最快相差 1.2%),开启 CUDA MPS 时选出 K16/g4(正是网格中最快的一种)。在四张 RTX PRO 5000 的 RoboTwin Easy 上,搜索自动选出 K60/g8。
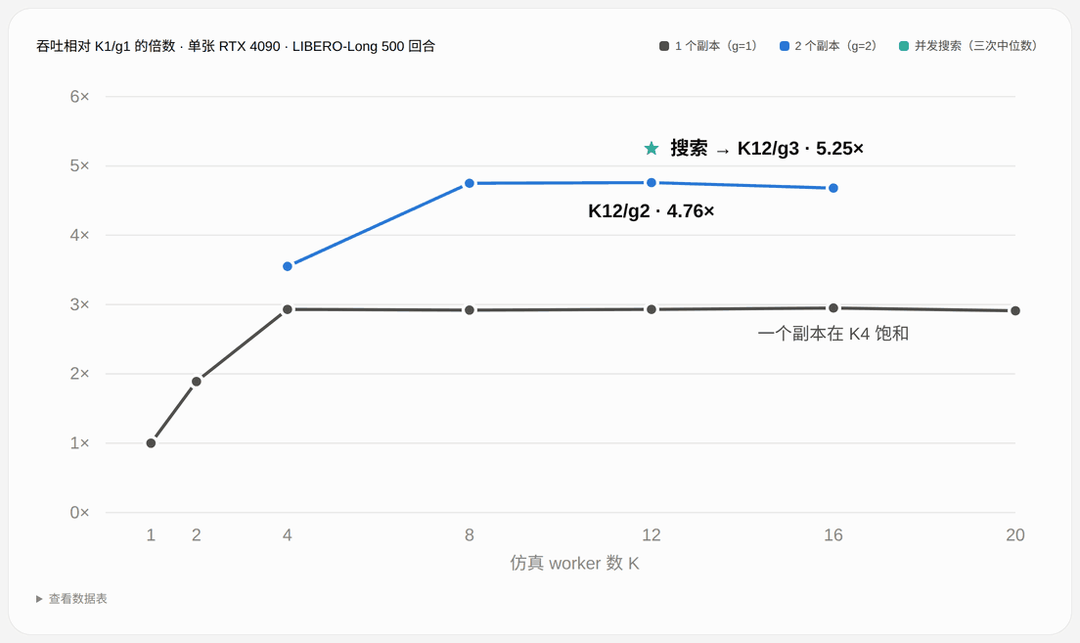
一个模型副本时,仿真器加到 4 个后吞吐不再增长;12 个仿真器配 2 个副本的吞吐达到 K1/g1 的 4.8 倍
多 GPU、多实例一起跑。 一台机器有多张 GPU 时,Kit 可以把模型副本分布到不同 GPU(例如四张 RTX PRO 5000 上 K32/g4 吞吐达到单卡 K8/g1 的 4.0 倍)。任务更大时,还可以用多个 GPU 实例一起评测:每个实例负责一部分任务,跑完后将结果合并成一份报告。团队已经在评测平台上用四个实例并行完成 MetaWorld MT50 的 2,500 个回合。
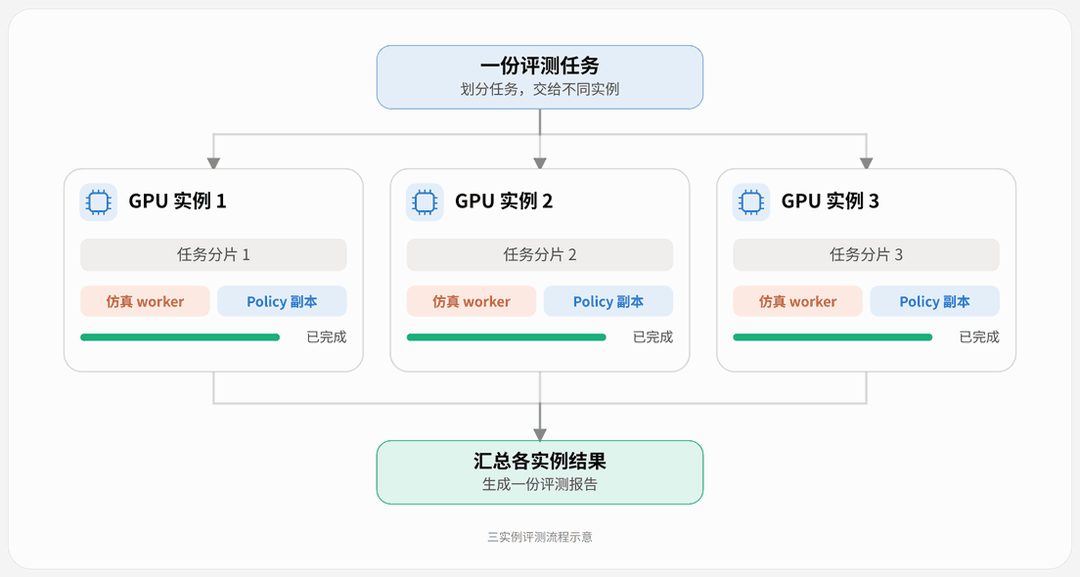
多 GPU 实例分头评测,最后将结果合并为一份报告
04. 实验结果:单卡快 6.2–13.2 倍,四卡快 15.8 倍
以下所有跨系统与四卡对比均统一按纯评测时间统计(不含模型加载、进程启动、搜索/调优和清理)。
LIBERO-Long(单张 RTX 4090,500 回合):快 6.2 倍
团队在一张 RTX 4090、12 个 CPU 核上,用同一检查点、同一批 500 个回合,对比 Kit 与三套评测系统:StarVLA 官方评测、RLinf 和 vla-eval。RLinf 和 vla-eval 使用各自离线调优后的配置,每套系统各跑三次。
不开 MPS 时,Kit 的并发搜索选出 K12/g3,用时 11.2 分钟(671 秒),比 StarVLA 官方评测快 4.4 倍,比 RLinf 快 2.8 倍,比 vla-eval 快 1.5 倍。
开启 CUDA MPS 后,搜索选出 K16/g4,用时 8.1 分钟(485 秒),比 StarVLA 官方评测快 6.2 倍,比 RLinf 快 3.8 倍,比 vla-eval 快 2.1 倍,比不开 MPS 时再快 1.4 倍。
| 评测系统 | 配置 | 评测时间(中位数) | 吞吐(步/秒) | 成功率 | 相对 StarVLA 官方 |
|---|---|---|---|---|---|
StarVLA 官方评测 | 1 环境 | 49.8 分钟(2,990 s) | 45.8 | 90.2% | 1.0× |
RLinf | 20 环境 | 31.4 分钟(1,882 s) | 74.2 | 90.3% | 1.6× |
vla-eval | 24 分片,batch 24 | 16.9 分钟(1,016 s) | 133.5 | 89.8% | 2.9× |
| RoboScope Kit | 自动搜索 K12/g3 | 11.2 分钟(671 s) | 204.6 | 89.9% | 4.4× |
| RoboScope Kit + CUDA MPS | 自动搜索 K16/g4 | 8.1 分钟(485 s) | 282.5 | 89.9% | 6.2× |
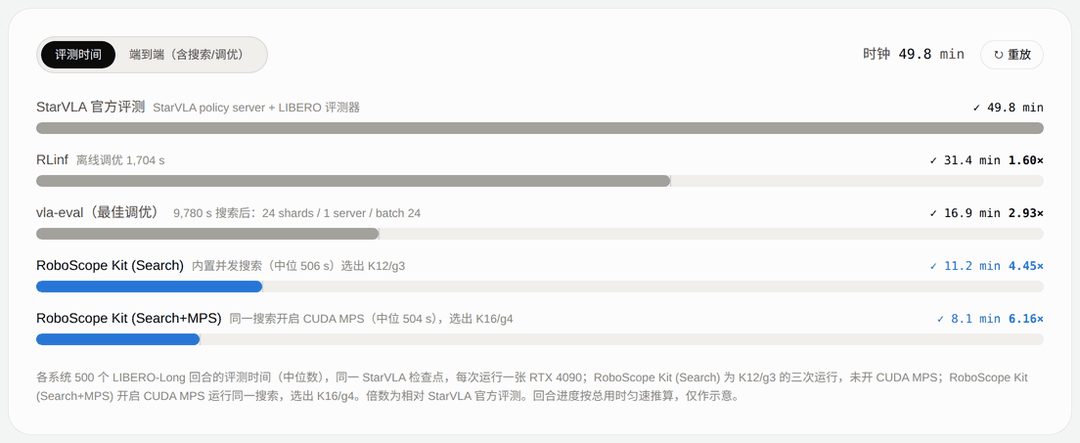
同一检查点、同一批 500 个 LIBERO-Long 回合的评测耗时比较
RoboTwin Easy(单张 RTX 4090,500 回合):快 13.2 倍
在一张 RTX 4090、20 核配额上,团队用同一检查点与同一批 500 个回合(50 任务 × 10 回合),将 Kit 与 StarVLA 官方评测、vla-eval 和 RLinf 正面对照。Kit 自动搜索选出 K8/g1,用时 31.9 分钟(1,916 秒),吞吐 110.2 步/秒,比 StarVLA 官方评测快 13.2 倍,比 vla-eval 快 7.3 倍,比 RLinf 快 2.2 倍。
| 评测系统 | 配置 | 评测时间 | 吞吐(步/秒) | 成功数 | 相对 Kit 慢 |
|---|---|---|---|---|---|
StarVLA 官方评测 | 1 环境 | 420.6 分钟(25,238 s) | 8.4 | 232/500 | 13.2× |
vla-eval | 9 分片,batch 1 | 234.5 分钟(14,072 s) | 15.0 | 232/500 | 7.3× |
RLinf | 8 环境 | 70.6 分钟(4,237 s) | 49.9 | 230/500 | 2.2× |
| RoboScope Kit | 自动搜索 K8/g1 | 31.9 分钟(1,916 s) | 110.2 | 232/500 | 1.0×(快 13.2×) |
RoboTwin Easy(同机四张 RTX PRO 5000,标准 5,000 回合):快 15.8 倍
在配备四张 RTX PRO 5000 的同一台机器上,团队将 Kit 与 StarVLA 官方四卡评测(每卡一个评测进程)直接对比:
标准 5,000 回合协议(50 任务 × 100 回合): StarVLA 官方评测耗时 17.5 小时(63,036 秒);Kit 使用自动搜索选出的 K60/g8 仅用 66.4 分钟(3,985 秒) 完成,快 15.8 倍(稳态吞吐 575 步/秒),全部 5,000 个回合的成败与终止步数和官方完全一致(2,313/5,000,成功率 46.3%)。
500 回合提速分解(50 任务 × 10 回合): StarVLA 官方评测三次均值 117.9 分钟(7,076 秒);Kit K4/g4 关闭运行时优化为 98.4 分钟(1.2×),开启运行时优化后降到 47.1 分钟(再快 2.1×),自动搜索扩展到 K60/g8 后进一步缩短到 11.8 分钟(706 秒),总计 10.0 倍。自动搜索以稳态吞吐为目标,因此在 5,000 回合这样的长评测上收益更大(达到 15.8 倍)。
| 评测规模与系统 | 运行次数 | 成功数 | 评测时间 | 相对 StarVLA 官方 |
|---|---|---|---|---|
| 标准 5,000 回合 · StarVLA 官方(每卡 1 进程) | 1 | 2,313/5,000 | 17.5 小时(63,036 s) | 1.0× |
| 标准 5,000 回合 · RoboScope Kit(K60/g8) | 1 | 2,313/5,000 | 66.4 分钟(3,985 s) | 15.8× |
| 500 回合 · StarVLA 官方(每卡 1 进程) | 3 | 230/500 | 117.9 分钟(7,076 s) | 1.0× |
| 500 回合 · RoboScope Kit(K60/g8) | 1 | 230/500 | 11.8 分钟(706 s) | 10.0× |
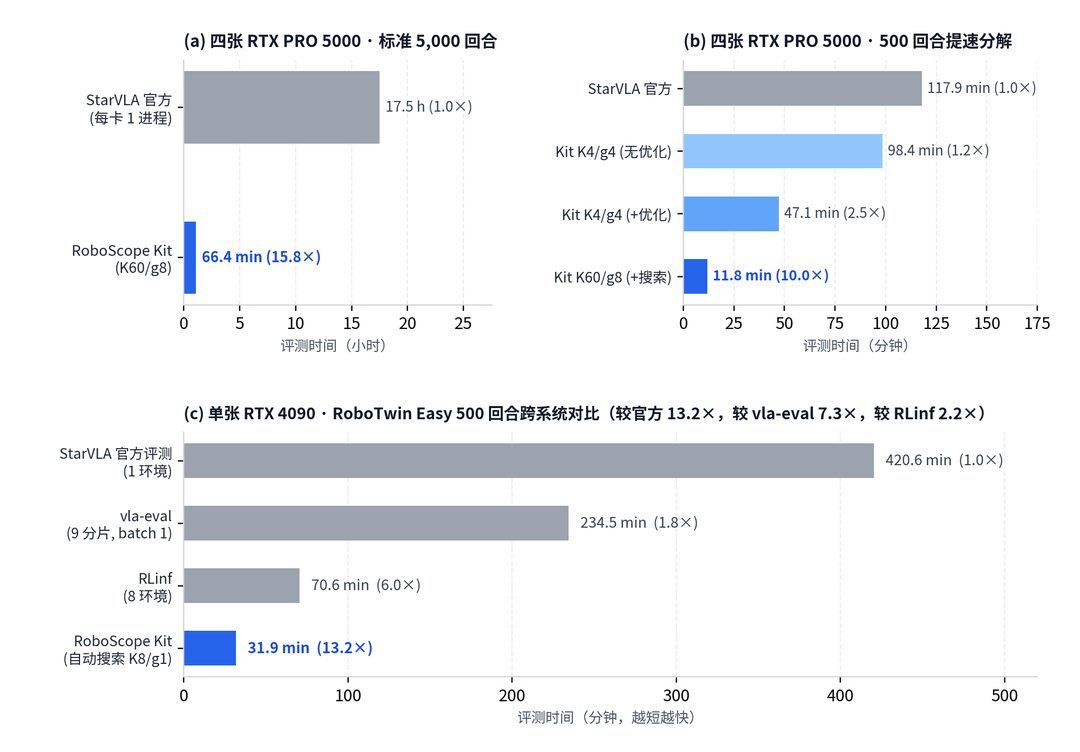
RoboTwin Easy 评测耗时对比:四张 RTX PRO 5000(5,000 回合与 500 回合)及单张 RTX 4090 跨系统对比
05. 与官方评测逐回合一致
我们在 LIBERO-Long 和 RoboTwin Easy 上逐个回合比对了评测结果:
LIBERO-Long: 固定配置(K1/g1)下,Kit 的 500 个回合成败与官方评测三次运行的结果逐一相同。并发搜索选出的配置成功率为 89.9%,官方评测为 90.2%,相差 −0.3 个百分点,在 ±2 个百分点的统计等效范围内;97.9% 的回合(开 MPS 时为 96.5%)与官方结果相同,Kit 自身重复运行之间为 97.8%–99.0%。多个仿真器分摊同一任务的回合时,少数回合的成败会变化,500 个回合中成功数的变化不超过 10 个。
RoboTwin Easy: 无论是单张 RTX 4090 上提速 13.2× 的 500 回合(232/500),还是四张 RTX PRO 5000 上提速 10.0× 的 500 回合(230/500)以及提速 15.8× 的标准 5,000 回合(2,313/5,000),RoboScope Kit 每一个回合的成败和终止步数都与官方 StarVLA 评测 100% 完全相同。(作为对比,单卡 500 回合上 vla-eval 同样 500/500 一致,而 RLinf 的成败一致率为 86.8%、终止步数一致率为 57.4%。)
06. 一个类、一条命令
用 Kit 评测一个模型分三步:
安装: pip install roboscope-kit 装好 Policy 接口、运行时和各 Benchmark 的适配器;仿真器、数据集和官方评测器仍由各 Benchmark 提供。仓库附带 StarVLA 和 X-VLA 的完整示例。
接入: 写一个 Policy 类,实现 load 和 act,同一个类可直接用于其他提供所需观测的 Benchmark。
运行: 一条命令指定 Benchmark、任务套件、检查点和输出目录,分片评测时再加上分片编号和分片数。Kit 先用并发搜索自动选出仿真器和模型副本的数量(也可以直接指定),再做正式评测,把回合记录、指标和资源占用写进输出目录。配合运行缓存(run cache),同一机器、模型和 Benchmark 的后续评测可以直接复用已保存的配置,无需重复探测。作为对比,在 LIBERO-Long 上,vla-eval 的离线配置搜索用了 9,780 秒,RLinf 的离线调优用了 1,704 秒。
结语
具身模型迭代越来越快,评测越来越频繁。RoboScope Kit 把 Benchmark 之间、模型之间不同的部分放在适配器和 Policy 里,统一负责调度并发、运行评测和汇总结果。研究者写一次模型接口,就能在多个 Benchmark 上快速、可复现地评测,把更多时间用在模型本身。
RoboScope Kit 的代码已在 GitHub 开源,欢迎研究者和开发者试用。
技术报告:《RoboScope Kit: Unified Interfaces for Fast and Scalable Embodied-AI Evaluation》
作者 Deng-Ke Wu、Yifan Jin、Yida Yang、Lei Qian、Zhaoye Zhou、Hongru Zhang、Kai Ye、Shuyuan Hu、Yiran Mao、Zewei Ye、Bo Zhao
通讯作者: 赵波(bo.zhao@sjtu.edu.cn)
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。