PRX:AI 反复修改的答案会走向哪里?
原创 王璇 2026-11-21 14:30 浙江
从寻找单词到拟合公式,描出智能体的生成偏好
导语
ATTITUDE和 DISCIPLINE有什么共同点?把字母按A=1、B=2一直数到Z=26,这两个词加起来都正好是 100。研究者让AI不断寻找满足条件的新词,Gemini却反复在这两个正确答案之间打转。同一道题,GPT-5 Nano 在两万次生成中找到了645个不同的有效答案。为什么有的模型走来走去都是老路,有的却能不断找到新路? 这篇在 PRX Intelligence 发表的研究借用了统计物理中的细致平衡,通过比较模型从A改到B、再从B改回A的概率,为它的生成偏好画出一张地形图。到了数学公式拟合任务中,这张图揭示了一个更有意思的现象:模型顺势下坡的一步,有时反而让公式离真实数据更远。
关键词:大语言模型智能体(LLM-driven agent)、细致平衡(detailed balance)、势函数、最小作用量原理(least action principle)、状态转移、符号拟合

王璇丨作者
赵思怡丨审校
论文题目:Detailed Balance in Large-Language-Model-Driven Agents
论文链接:https://journals.aps.org/prxintelligence/abstract/10.1103/kwx6-clqd
接收时间:2026年10月27日
论文来源:PRX Intelligence
从A改到B,再从B改回来
从A改到B,再从B改回来
让AI修改一个数学公式,可以观察它生成的每个词元(token),也可以退后一步,只记录每轮结束时留下了哪个公式。前一种视角关注一句话如何逐步生成,后一种视角适合回答另一个问题:如果让智能体反复提出新解,它更容易走向哪些候选答案,又容易困在哪里?
研究团队把智能体每一轮保留下来、供下一轮使用的信息定义为一个状态。它可以是单词、公式,也可以包括任务要求和历史摘要。智能体把当前状态整理成提示,调用大语言模型,再从输出中提取新状态。把这一过程看作马尔可夫转移过程(Markov transition process),就可以从同一状态反复采样,估计它转向不同状态的概率。这样,无须读取模型参数,也能测量它修改答案时表现出的方向偏好。
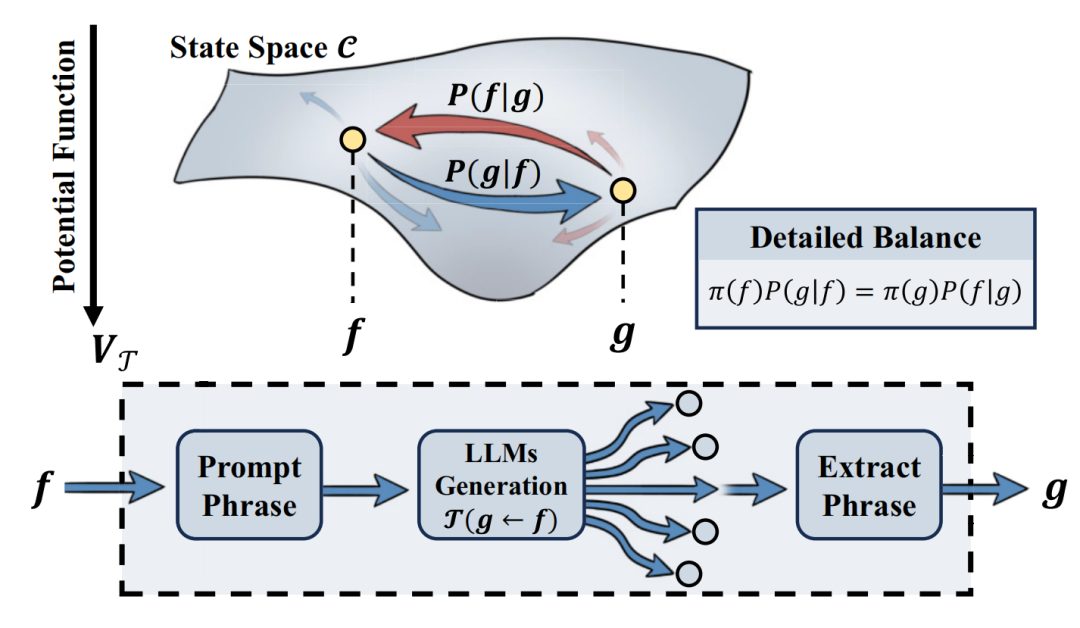
图1. 用于研究LLM生成方向性的形式化框架示意图,展示了状态空间及可能的转移路径。
假如模型从A到B比从B到A更容易,可以试着把B画得比A低一些。这种画法对一对答案总能成立,难点在于第三个答案。如果模型偏好从A到B、从B到C,又偏好从C回到A,这条路就得一路下坡,最后却回到原来的高度。只要这种环形偏好稳定存在,一张地形图就无法解释全部转移。
统计物理中的细致平衡给出了检验标准。在平衡分布下,每一对状态之间的正反向概率流彼此抵消。一个直接推论是,沿同一闭环正向和反向各走一圈,两条路径的转移概率乘积应当相等。 模型在某一步可以更容易下坡,偶尔也可以上坡。一圈走完,局部的方向优势能否抵消,才是检验的关键。
同一道单词题,三个模型走出了多远?
同一道单词题,三个模型走出了多远?
研究者给模型一个单词,要求它再写一个词,使所有字母在字母表中的序号之和恰好为100。例如,WIZARDS 和 BUZZY 都符合要求。三个模型各生成两万次,Claude Sonnet 4.5 给出5个不同的有效候选词,Gemini 2.5 Flash 给出13个,GPT-5 Nano 则给出645个。Gemini 甚至反复在 ATTITUDE 和 DISCIPLINE 之间切换。两个答案都满足要求,搜索范围却几乎没有扩大。
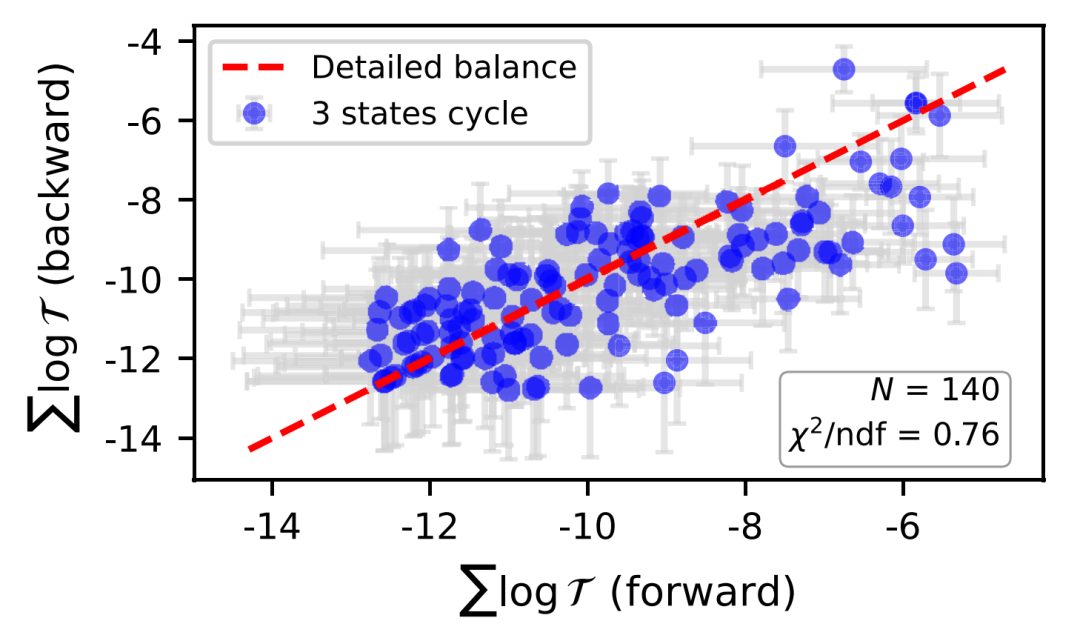
图2. 在不使用推理链的条件词生成任务中,通过GPT-5 Nano模型状态转移图中的闭合路径来验证细致平衡性。
GPT-5 Nano探索的词更多,恰好适合检验闭环。研究者找到了140组三个词,每组中任意两个词之间的双向转移都得到过测量。他们把每组三个词顺向走一圈的概率与逆向走一圈的概率画在图上,测量点聚集在对角线附近。在采样误差范围内,两种绕行方向的概率近似相等,与细致平衡的预期一致。 高频词告诉我们模型常去哪里,闭环则进一步检验,从不同起点测得的偏好能否拼成同一张图。
AI 偏爱的公式,拟合数据也更好吗?
AI 偏爱的公式,拟合数据也更好吗?
团队随后研究了一个符号拟合智能体。它调用多种大语言模型和提示模板,反复修改数学表达式,寻找能拟合数据的公式。研究者记录了50,228次状态转移,涉及7,484个不同的公式状态。面对数千个候选公式,怎样确定每个公式在地形图上的高度?研究者借用最小作用量原理(least action principle),先给每个状态暂定一个势值,再根据实测转移反复调整。某种修改越常发生,把它画成大幅爬坡所付出的代价就越高。使整体代价最小的一组高度,就给出了与观测最相容的地形。
接下来要看这张图能解释多少。按照细致平衡,两个公式的势差越大,正反方向的转移概率就应当越不对称。研究者逐对比较势差与正反向概率比的对数,得到的皮尔逊相关系数(Pearson correlation coefficient)为0.92。团队还用 IdeaSearch 搜索能够直接根据公式结构估计势值的函数。在转移概率超过5%的9,769种有向转移中,按找到的函数计算,约七成走向较低势,约四分之一走向较高势。
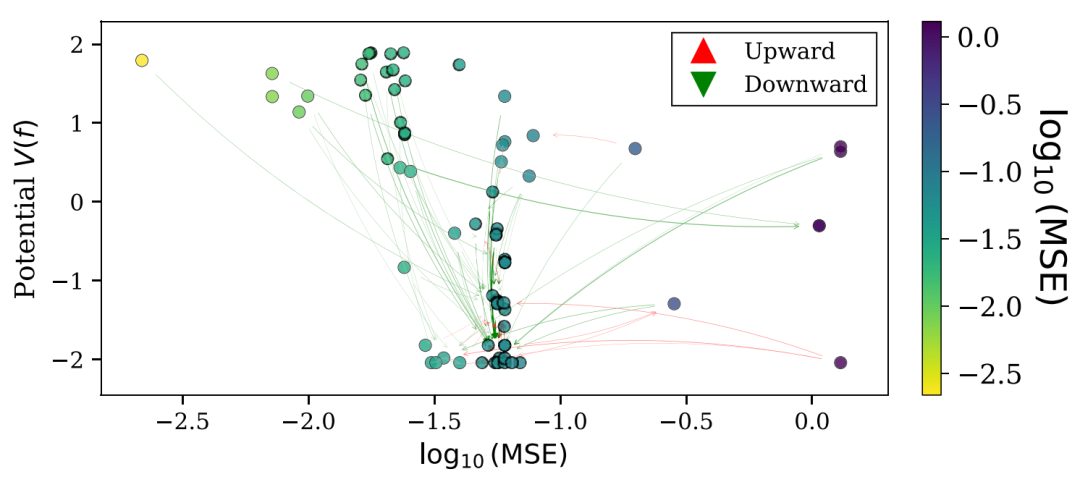
图3. 展示了使用IdeaSearch发现的势函数预测状态转移方向性的能力。
最值得注意的是,论文把每个公式的势值和它在数据上的拟合误差画在了同一张图上。沿纵轴向下,表示模型在生成时更偏爱新公式。沿横轴向左,表示新公式更贴合数据。有些转移向下,却向右。这意味着,AI 很容易做出的一次修改,完全可能让公式离数据更远。 重建势函数,让研究者能够识别模型偏爱哪些解,以及这种偏好何时会与任务目标发生分歧。
总结与展望
总结与展望
这项研究提出了一种观察 AI 智能体的方法,除了统计它做对了多少题,还可以测量它在答案之间怎样往返。单词生成与符号拟合实验都提供了与近似细致平衡一致的证据。能够跨任务沿用的是检验方法,每项任务的势能地形仍需分别测量。把这一规律推广到更广泛的智能体,是作者提出的猜想。一个值得继续验证的方向,是把模型最常走的路径与任务真正受益的路径画在一起。当智能体反复回到少数解时,能否通过调整生成策略,让它找到那些较少被提出、却更经得起检验的答案?
全AI读书会
基于大模型的AI 为系统梳理这条从“网络安全事件”通向“复杂系统临界理论”的文献线索,我们尝试发起一场全部由AI解读的读书会「奇点临近下的网络安全与临界预警」,组织对该主题感兴趣的研究者与探索者,以一篇八千字的综述长文《一次漏洞,一场雪崩,我们能听出互联网崩塌前的哨声吗?》为共同底本,研读其背后的十五篇经典文献,并尝试回答三个问题:
复杂网络级联失效的背后机制究竟是什么?
免疫系统给网络安全提供了什么思路?
我们究竟有没有办法判断,今天的互联网离临界点还有多远?
推荐阅读
4. AI 也会“自我反思”?Claude 模型现内省迹象,大语言模型认知新突破
4. 9900分可兑换“涌现”文化衫,报名任意读书会送299积分!
5. 集智学园精品课程免费开放,解锁系统科学与 AI 新世界
点击“阅读原文”,报名读书会
本文转载自微信公众号「集智俱乐部」,查看原文。版权归原作者所有,如有侵权请联系删除。