Harness进化,模型却掉队?NUS、商汤开源CoEvo-RSI框架
让你更懂AI的 2026-11-19 22:24 北京
让模型跟上Harness的进化
模型与 Harness 协同进化(model–harness co-evolution)正在成为递归自我改进(RSI)智能体的主流范式:一边改脚手架,一边训模型。
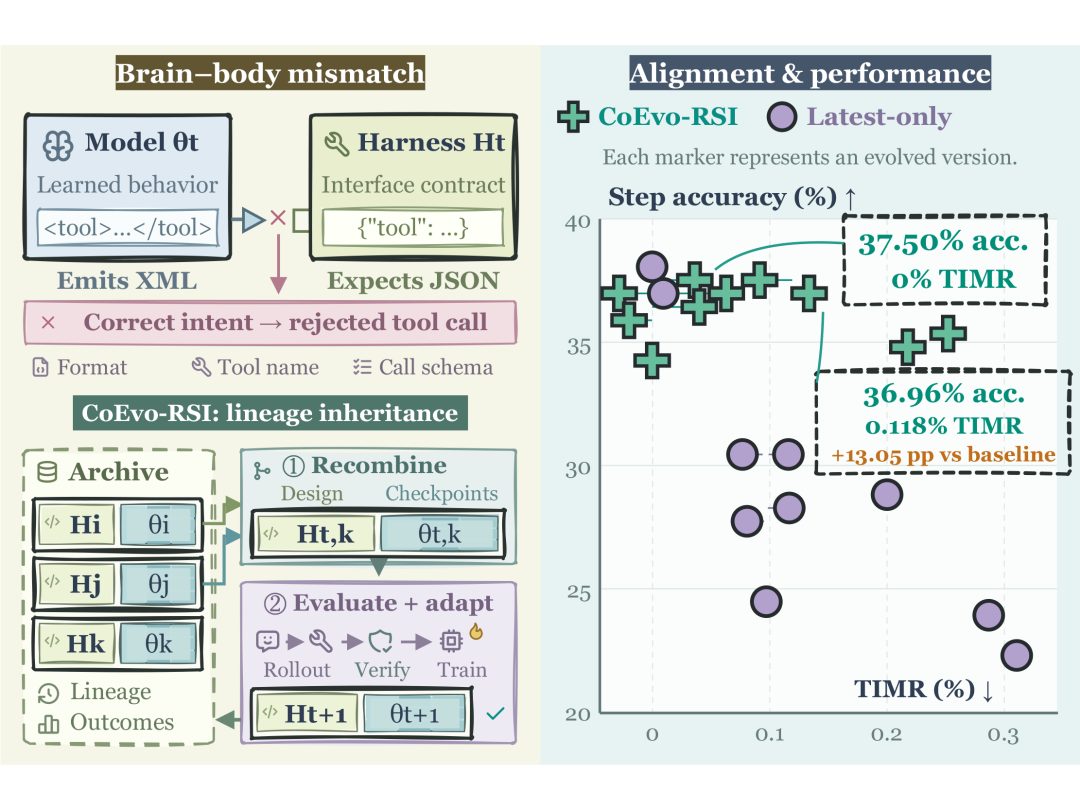
但这里藏着一个长期被忽视的问题:Harness 变了,模型没跟上;或者模型会的,Harness 不让用。
来自新加坡国立大学、A*STAR 与商汤的研究者把这个现象正式定义为“脑体失配”(brain–body mismatch),并提出 CoEvo-RSI 框架,让元智能体在一个共享的“进化档案”里,同时为 Harness 和模型挑选合适的“祖先”。
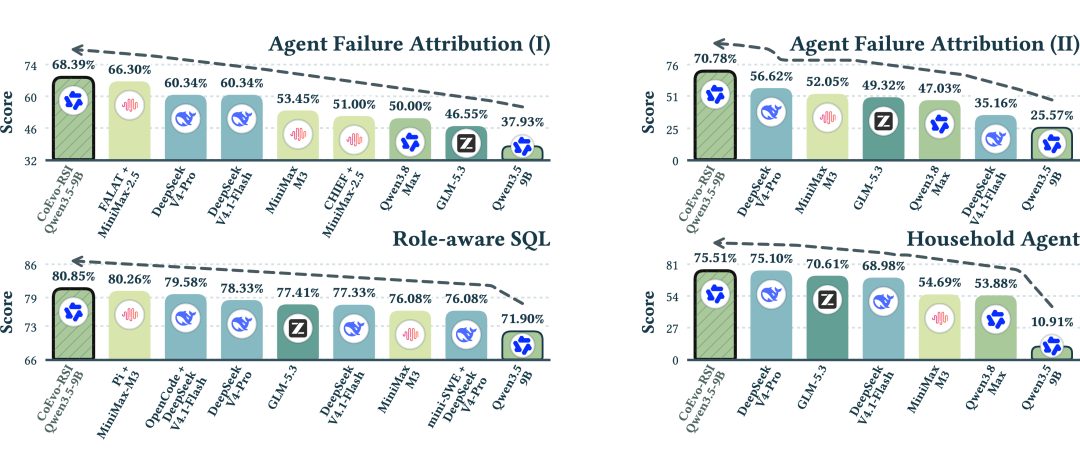
仅靠模型自己生成轨迹上的监督微调(SFT),Qwen3.5-9B 就在多个垂直任务上追平甚至超过了体量大得多的模型。
论文标题:
When Harnesses Evolve, Which Models Should Follow?
论文作者:
Jiaqi Su, Guibin Zhang, Jie-Jing Shao, Cong Pang, Tiankuo Yao, Ivor Tsang, Haiyan Yin, Shuicheng Yan
作者机构:
新加坡国立大学、新加坡科技研究局(A*STAR)、商汤科技
论文链接:
https://arxiv.org/abs/2610.25078
代码链接:
https://github.com/SuJQ0722/CoEvo-RSI
模型链接:
https://huggingface.co/collections/nullptr04/coevo-rsi
大脑和身体,是怎么“走散”的?
一个智能体的能力由两部分共同决定:大脑是负责推理和决策的语言模型,身体是定义工具接口、动作空间、记忆和执行流程的 Harness。
过去的工作大多只改一边:要么固定 Harness 训模型(SFT、RL、自蒸馏),要么固定模型改 Harness(Meta-Harness 等)。
近期的协同进化方法把两者接成闭环,但每一轮中任何一方的变化,都可能让二者渐行渐远。论文给出了两个很直观的例子:
接口失配:模型习惯输出 XML 格式的工具调用,进化后的 Harness 却只接受 JSON。意图是对的,调用被拒了。
能力失配:Harness 新增了主动上下文管理工具,当前模型不会用;而档案里某个历史 checkpoint 恰好具备这项能力,是更好的训练起点。
现有协同进化方法在模型侧通常只有一个选择:沿用最新 checkpoint,或继承父分支的模型。但最新的,未必是最合适的。
CoEvo-RSI:双向历史继承
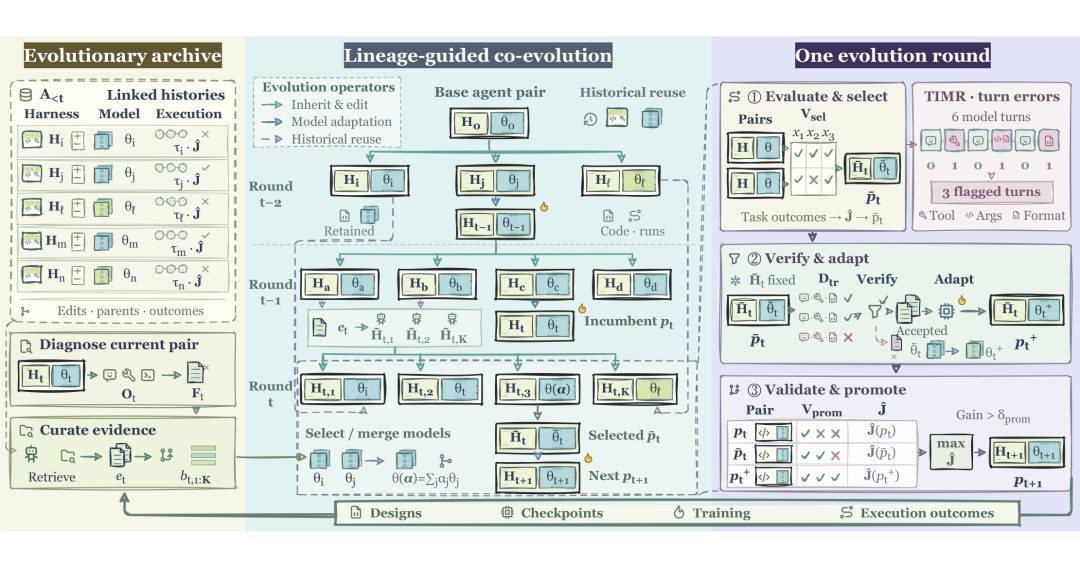
CoEvo-RSI 的核心是一个进化档案,记录所有历史 Harness、模型 checkpoint、它们的谱系关系和执行结果,失败的尝试也不例外。
每一轮进化由元智能体协调完成:
1. Harness 继承。Curator 先诊断当前组合的失败案例,从档案中检索相关历史证据,并生成 K 个修改假设。
K 个独立的编辑器各领一个假设,自己去档案里挑起点,再开发出后代 Harness。这个起点不必是上一代,可以是任何一个历史设计。
2. 模型继承。对每个后代 Harness,元智能体参考任务表现和接口失配率,从历史 checkpoint 中选一个,或用 TIES-Merging 融合多个,融合系数由元智能体直接给出。这一步把“模型初始化”变成了一个兼容性决策。
3. 适配与晋升。验证集选出最优的候选组合后,模型在该 Harness 下自己跑轨迹,拒绝采样保留通过验证器的那些,做一轮 SFT。最后在“原任、选中组合、适配后组合”三者中择优晋升,所有结果回写档案。
为了让失配可观测,论文还提出了一个低成本诊断指标 TIMR(轮级接口失配率):在模型的所有输出轮次中,调用了不存在的工具、违反接口契约或输出格式错误的比例。
作者明确说明,TIMR 只刻画了脑体失配中可观测的接口层面,并不是全部。
实验:9B 模型能走多远?
实验以 Qwen3.5-9B 为任务模型,DeepSeek-V4.1-Flash 作为元智能体,进化 10 轮,每轮 8 个 Harness 候选。三个领域对 Harness 的要求各不相同。
多智能体失败归因(四个测试集均为分布外)
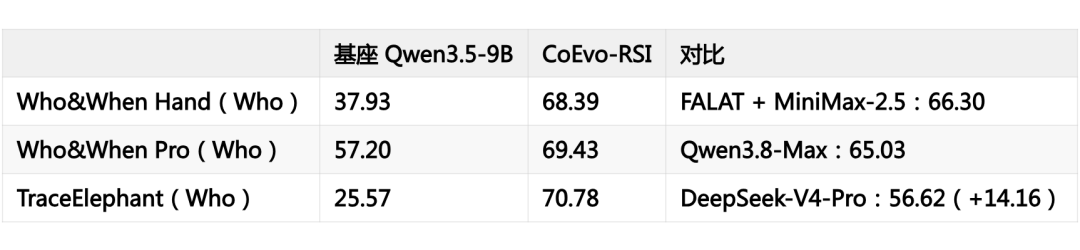
角色感知 Text-to-SQL(RBAC):在 Spider 子集上,Safe-EX 80.85%、Safe-Deny 96.64%、违规率 1.57%,三项均为最优,超过 Pi + MiniMax-M3。
在从未训练过的 BIRD 子集上,拿到最高的 Safe-Deny(91.26%)和最低的违规率(5.65%)。
智能家居指令执行(HomeBench):有效多设备指令的成功率从基座的 10.91% 提升到 75.51%,略高于 DeepSeek-V4-Pro(75.10%),比 GLM-5.3 高 4.90 个点。
值得一提的是,按 Artificial Analysis 智能指数,Qwen3.5-9B 得分为 11,而 DeepSeek-V4-Pro 和 GLM-5.3 分别是 36 和 45,起点差距相当悬殊。
作者也没有回避不占优的地方:Who&When Algo. 上 CoEvo-RSI 不是最优;RL 基线(GRPO/GSPO)在部分数据集的 When 准确率上更高;BIRD 上的 Safe-EX 仍低于带 Harness 的前沿模型,作者认为这可能与模型更保守的拒答有关。
历史继承到底有没有用?
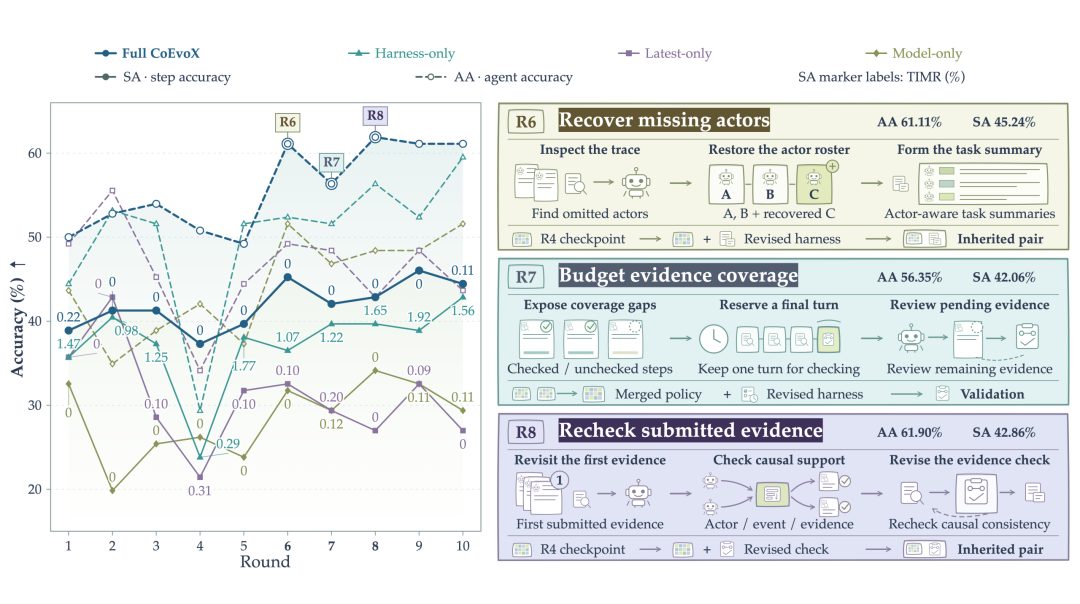
消融实验给出了清晰的对照(Who&When Algo.,10 轮):
只进化 Harness:10 轮中有 8 轮 TIMR 超过 1%,步骤准确率每一轮都低于完整方法;
只训模型:TIMR 接近 0,但步骤准确率最高只有 35%,说明接口对上了不等于任务做得好;
只继承最新一代:第 4 轮出现退化,最终步骤准确率垫底;
完整 CoEvo-RSI:同样在第 4 轮下滑,但随后在第 6、8 轮把第 4 轮的权重与新 Harness 重新配对,恢复并继续上升,TIMR 全程不超过 0.22%。
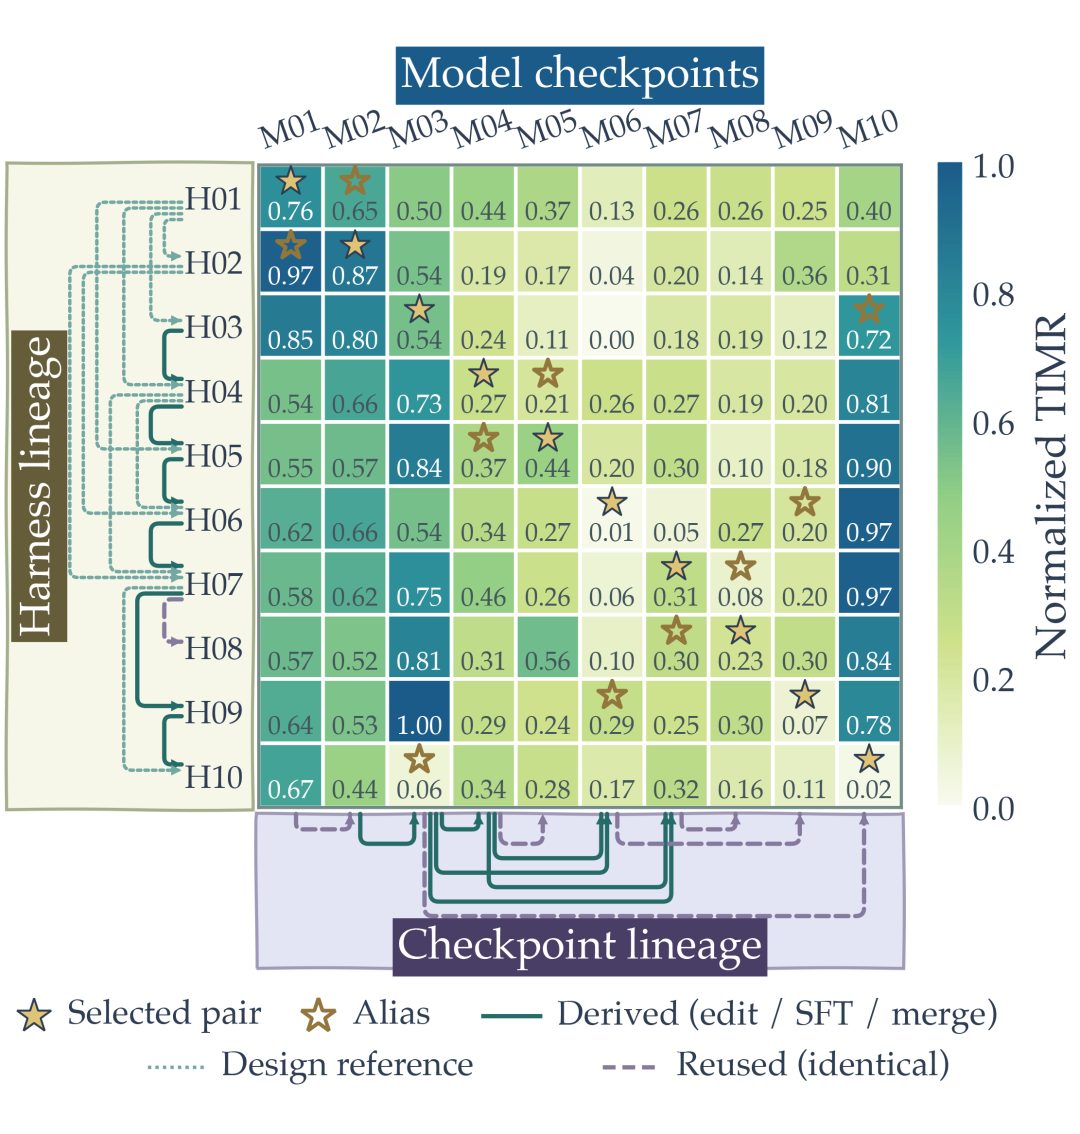
继承分析里有一个更有意思的发现。在 RBAC 的进化过程中,第 3 轮的 checkpoint 在第 4 到第 9 代 Harness 下的归一化 TIMR 高达 0.54 至 1.00,看上去已经“过时”。
但到了第 10 轮,它与最终 Harness 配对的 TIMR 降到全场最低的 0.02,并拿下了整个进化过程的最佳 Safe-EX。可见兼容性是“成对”的属性,只看最新一代就会错过这样的组合。
成本:便宜才是硬道理
训练成本:三轮进化的 API 开销在 2.06 至 3.69 美元之间,全程不到一天(17.48 至 20.71 小时);微调使用 4 张 H100。
10 轮下来的 rollout 预算少于 GRPO/GSPO。
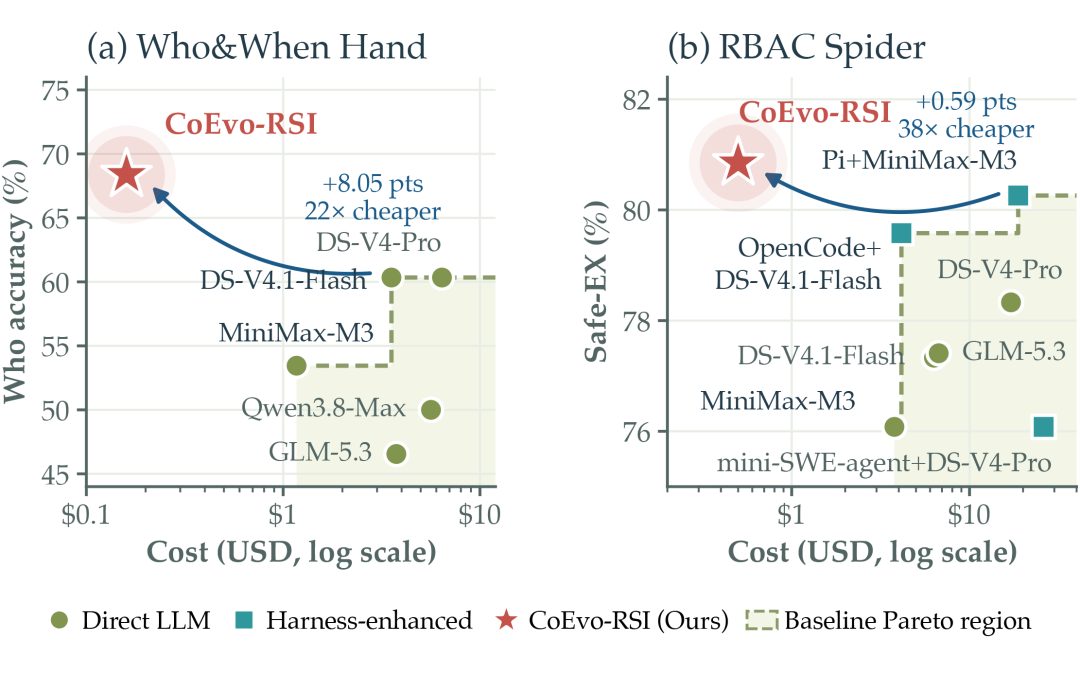
推理成本:在 Who&When 上跑完一遍评测,CoEvo-RSI 花费 0.16 美元,DeepSeek-V4.1-Flash 是 3.55 美元,前者在 Hand 子集上准确率高 8.05 个点,成本低 22 倍。
在 RBAC Spider 上,比最强基线 Pi + MiniMax-M3 高 0.59 个点,成本低 38 倍。
是 RSI,还是“过拟合”?
论文专门用一个小节正面回应了这个问题。
作者的定位很克制:CoEvo-RSI 瞄准的是“负担得起的领域专精”,比如为大规模 RL 训练提供轻量的失败归因评估器、本地部署的智能家居控制器、受严格数据库权限约束的企业助手。
进化得到的模型与 Harness 组合是为特定任务族定制的,在同领域留出数据上表现好,并不意味着能迁移到无关领域。
换句话说,这不是“在所有领域自主变强”的宏大 RSI 叙事,而是一条更务实的路线:让智能体自己主导数据生成、模型选择和训练,用很低的成本,把一个小模型打磨成特定场景里够用、好用的专家。
小结
CoEvo-RSI 提出了一个被协同进化范式忽略的问题,并给出了简洁的答案:Harness 进化之后,模型不必只跟着“最新的那一个”走,档案里的每一代都可能是更合适的起点。
代码与模型权重均已开源。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。