记录第一次的so文件逆向分析
mb_rqgxdcwg 2026-11-20 18:04 上海
看雪论坛作者ID:mb_rqgxdcwg
说明:本文由 AI 生成和整理,但里面的分析逻辑是我自己一步步跟下来的。
1.介绍
目标 app:某对 AI
版本:7.8.0 (1820)
参数:登录接口 sign
2.找加密位置
此 app 没有加壳,所以直接使用 jadx 打开 apk,搜索 sign=。
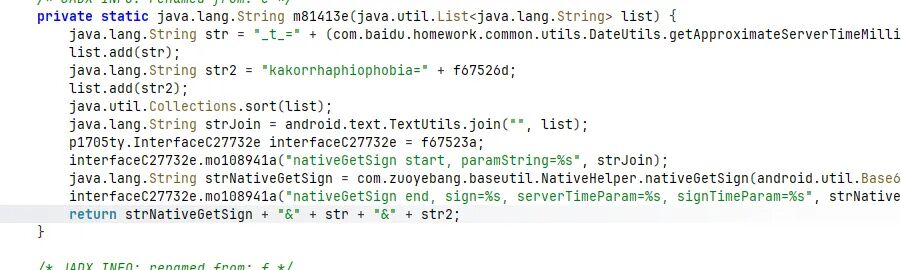
可以看到 nativeGetSign,这个就是签名的函数,hook 验证一下。
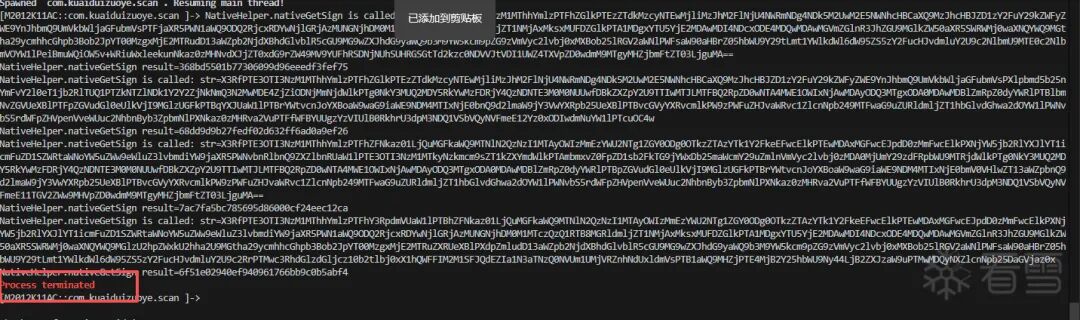
这里怀疑有检测,我使用的是 hluda 的 frida,一上 Java 层 hook 就直接退出了。具体退出原因没有继续定位,直接问 AI,告诉我可以先不使用 Java bridge。
那就改走纯 native 路径。下面脚本完全不调用 Java.perform,只监听 JNI 注册,找到 nativeGetSign 的真实函数地址,打印它的输入和返回字符串。
3. 纯 native hook 验证
先把脚本贴出来。这里把前面没有调用的辅助 hook 去掉了,修正了末尾多余的大括号,符号枚举也兼容了一下新旧 Frida API。下面是整理后的版本,只做了语法检查,没有重新上手机跑;截图保留的是前面实际运行时的结果。
'use strict';
const hooked = {};
functionreadJniString(env, obj) {
if (obj.isNull()) {
return"<null>";
    }
const table = env.readPointer();
const ps = Process.pointerSize;
const getUtf8 = newNativeFunction(
        table.add(169 * ps).readPointer(),
"pointer",
        ["pointer", "pointer", "pointer"]
    );
const releaseUtf8 = newNativeFunction(
        table.add(170 * ps).readPointer(),
"void",
        ["pointer", "pointer", "pointer"]
    );
const p = getUtf8(env, obj, ptr(0));
if (p.isNull()) {
return"<null>";
    }
try {
return p.readUtf8String();
    } finally {
releaseUtf8(env, obj, p);
    }
}
functionhookNative(fn) {
// 当前样本是 ARM32,去掉 Thumb 标志后计算代码偏移。
const code = Process.arch === "arm"
        ? fn.and(ptr("0xfffffffe"))
        : fn;
const mod = Process.findModuleByAddress(code);
console.log(
"[+] native fn = " + fn +
" module = " + (mod ? mod.name : "?") +
" offset = " + (mod ? code.sub(mod.base) : "?")
    );
Interceptor.attach(fn, {
onEnter: function (args) {
this.env = args[0];
console.log(
"[+] nativeGetSign entered" +
" env=" + args[0] +
" jstring=" + args[2]
            );
try {
console.log("[+] input = " + readJniString(args[0], args[2]));
            } catch (e) {
console.log("[-] input decode failed: " + e);
            }
        },
onLeave: function (retval) {
console.log("[+] nativeGetSign returned " + retval);
try {
console.log("[+] output = " + readJniString(this.env, retval));
            } catch (e) {
console.log("[-] output decode failed: " + e);
            }
        }
    });
}
const art = Process.getModuleByName("libart.so");
const symbols = typeof art.enumerateSymbols === "function"
    ? art.enumerateSymbols()
    : Module.enumerateSymbolsSync("libart.so");
const reg = symbols.find(function (s) {
return s.name.indexOf("RegisterNatives") !== -1 &&
           s.name.indexOf("CheckJNI") === -1;
});
if (!reg) {
thrownewError("RegisterNatives not found");
}
console.log("[+] RegisterNatives @ " + reg.address);
Interceptor.attach(reg.address, {
onEnter: function (args) {
const methods = args[2];
const count = args[3].toInt32();
const ps = Process.pointerSize;
for (let i = 0; i < count; i++) {
const entry = methods.add(i * ps * 3);
const name = entry.readPointer().readUtf8String();
if (name !== "nativeGetSign") {
continue;
            }
const sig = entry.add(ps).readPointer().readUtf8String();
const fn = entry.add(ps * 2).readPointer();
console.log("[+] " + name + sig + " -> " + fn);
const key = fn.toString();
if (!hooked[key]) {
hookNative(fn);
                hooked[key] = true;
            }
        }
    }
});
这里要在目标方法注册之前把脚本挂上,通常用 spawn 方式启动。要是 app 已经注册完了再 attach,就可能什么也抓不到。不同 Android 版本的 RegisterNatives 符号也可能不止一个,上面是当前定位过程的基础写法,附件里还放了一份增加方法描述符和模块检查的版本。
当我们点击登录,打印信息如下:

下一步就是分析这个 native 函数。我们在开始已经 hook 到了函数的地址,把运行时地址减去模块基址,得到模块内偏移,再去 IDA 里面跳转即可。
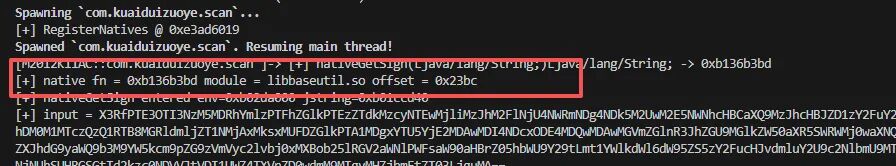
IDA Pro 打开这个 so 文件,跳转到 0x23bc。
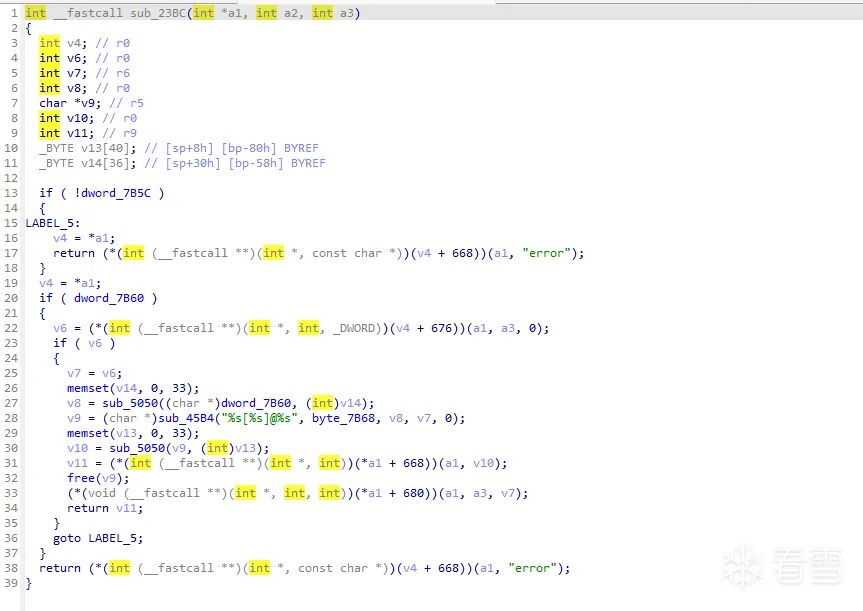
这里可以使用 unidbg 补环境去还原参数,可以参考这篇文章,比我写的好多了。我也是参考的这篇文章。我这里主要是分析纯算法的还原。
后面就按这个顺序往下走:Java 调用链 → JNI 入口 → 数据流 → 算法特征 → 中间值对照 → 独立实现。先看输入从哪里来,再看 so 里面怎么处理,最后拿原始 so 的结果和自己写的代码对照。
4. signA、signB 从哪来的,先回 jadx 把这条线找到
前面已经定位到了 libbaseutil.so 的 nativeGetSign,看起来下一步应该直接分析汇编。不过这里还有个问题:这个函数是不是只靠我们传进去的 Base64 就能算出 sign?如果它还读取了别的数据,那些数据又是谁准备的?
先别把 signA、signB 当成已经知道的东西。我们就从前面找到的 nativeGetSign 开始,一步步找到它们。
4.1 从 nativeGetSign 的调用方找到初始化入口
在 jadx 里打开 com.zuoyebang.baseutil.NativeHelper,选中 nativeGetSign,右键“查找用法”。跟进去是 com.zuoyebang.baseutil.a 的 e(List<String> list)。删去日志后,输入的构造过程可以整理成下面这样:
list.add("_t_=" + DateUtils.getApproximateServerTimeMillis() / 1000);
list.add("kakorrhaphiophobia=" + initializedElapsedTime);
Collections.sort(list);
String joined = TextUtils.join("", list);
String input = Base64.encodeToString(joined.getBytes("UTF-8"), Base64.NO_WRAP);
String sign = NativeHelper.nativeGetSign(input);
这里有三个细节:列表中已经是 key=value 形式的字符串,排序后用空字符串连接,中间没有 &;Base64 使用 NO_WRAP,不会插入换行;native 收到的是编码后的完整 String。
所以前面 hook 到的一长串 Base64,可以先解码看看里面有哪些参数。但是自己调用 nativeGetSign 时,还是要传 hook 到的原文,不能把解码后的内容塞进去,不然算的就不是同一个东西了。
Java 调用方还会把 native 返回的 sign 和两个时间参数组合起来。本文分析的是 native 返回的那段十六进制签名,不能把外层组合后的字符串当作 MD5 输出。
接下来对这个 e() 再查找用法,可以看到同一个类的 d(List<String> list)。
这里很关键,原代码是:
publicstatic synchronized Stringd(List<String> list) {
if (f58497b) {
returne(list);
    }
    f58496a.i("AntiSpan Not Inited,Try init once", newObject[0]);
f();
if (!f58497b) {
return"init_error";
    }
returne(list);
}
f58497b 虽然被混淆了,但分支和日志都还在:为真就计算签名,为假就先调用 f(),失败了还会返回 init_error。所以我们有依据把它理解成“是否初始化成功”。顺着 f() 跳进去,signA、signB 就在这里。
4.2 signA 是 nativeInitBaseUtil 的返回值
f() 先拿到 application 和 cuid,再读两个缓存。下面保留主进程分支的原变量名,方便对照 jadx:
Applicationapplication= InitApplication.getApplication();
Stringcuid= InitApplication.getCuid();
strB = PreferenceUtils.getString(LibPreference.KEY_ANTISPAM_SIGN_A);
strB2 = PreferenceUtils.getString(LibPreference.KEY_ANTISPAM_SIGN_B);
if (TextUtils.isEmpty(strB) || TextUtils.isEmpty(strB2)) {
    ty.eeVar= f58496a;
    eVar.a("nativeInitBaseUtil start, cuid=%s", cuid);
StringstrNativeInitBaseUtil= NativeHelper.nativeInitBaseUtil(application, cuid);
    eVar.a("nativeInitBaseUtil end, signA=%s", strNativeInitBaseUtil);
PlutoAntispamplutoAntispamB= e.b(strNativeInitBaseUtil);
if (plutoAntispamB != null) {
        strB2 = plutoAntispamB.data;
    } else {
        m("type", "1");
    }
    eVar.a("nativeInitBaseUtil start, signB=%s", strB2);
    strB = strNativeInitBaseUtil;
}
这里不用猜命名,日志直接写着 nativeInitBaseUtil end, signA=%s,后面的参数就是 strNativeInitBaseUtil。
也就是说:
nativeInitBaseUtil(application, cuid) 的返回字符串 → signAstrB 对应 signA,strB2 对应 signB。这是 app 自己的日志和缓存键告诉我们的名字,不是看到两段密文后随便起的。注意上面另一句日志虽然也写着 nativeInitBaseUtil start,下一行实际没有再次调用这个 native 方法;判断来源得看赋值和调用,不能只看日志标题。
4.3 signB 来自服务端响应的 data
上面有一行 e.b(strNativeInitBaseUtil),继续跳进去,位置是 com.zuoyebang.baseutil.e.b(String str):
static PlutoAntispam b(String str) throws ExecutionException, InterruptedException {
return (PlutoAntispam) Net.postSync(
        PlutoAntispam.Input.buildInput(str), PlutoAntispam.class);
}
到这里就能看到它发了网络请求。再进入 PlutoAntispam.Input,几个关键位置如下,省略了热修复判断:
public static final String PATH = "/pluto/app/antispam";
public String data;
private Input(String str) {
this.__aClass = PlutoAntispam.class;
this.__url = PATH;
this.__pid = "antispam";
this.__method = 1;
this.data = str;
}
public Map<String, Object> getParams() {
    HashMap map = new HashMap();
    map.put("data", this.data);
return map;
}
把这几次传参接起来:传给 e.b() 的是 signA,buildInput() 又把它放进请求的 data 参数;Net.postSync() 返回 PlutoAntispam 对象,f() 取这个对象的 data 字段赋给 strB2。
所以:
请求的 data = signA
响应对象的 data = signB
这里的路径是 /pluto/app/antispam。完整地址还会经过 host 配置或自定义地址处理,本文先跟参数流,不把路径写成固定域名。服务端内部怎么计算 signB,客户端这几行代码没有告诉我们;目前能确认的是它由这次请求返回。
4.4 两段字符串为什么会传进 so
回到 a.f(),往下就是这一行:
f58497b = NativeHelper.nativeSetToken(application, cuid, strB, strB2);把刚刚对应出来的变量名换进去,就是:
isInitSuccess = NativeHelper.nativeSetToken(application, cuid, signA, signB);调用成功后,主进程分支会保存它们:
PreferenceUtils.setString(LibPreference.KEY_ANTISPAM_SIGN_A, strB);
PreferenceUtils.setString(LibPreference.KEY_ANTISPAM_SIGN_B, strB2);
这样两个分支就接上了:第一次没有缓存,先生成 signA,再请求得到 signB;后面有配套缓存,就跳过这次交换,直接把缓存交给 nativeSetToken。这里讨论的是尚未完成初始化时进入 f() 的流程,已经初始化成功时不会每次签名都重新解密缓存。
flowchart TD
    A["a.d:准备计算登录 sign"] --> B{"已初始化?"}
    B -->|是| H["a.e → nativeGetSign"]
    B -->|否| C["a.f:读取 signA / signB 缓存"]
    C --> D{"两个缓存都非空?"}
    D -->|否| E["nativeInitBaseUtil 返回 signA"]
    E --> F["POST /pluto/app/antispam,请求 data = signA"]
    F --> G["响应对象 data → signB"]
    D -->|是| I["nativeSetToken(context, cuid, signA, signB)"]
    G --> I
    I -->|成功,保存缓存| H
    I -->|失败| J["返回 init_error"]
现在先记住这三件事就够了:signA 由本地 native 生成,signB 从服务端取回,nativeSetToken 接收这一对字符串做初始化。它们里面具体装了什么,要进入这个 native 函数后再分析,不能在这里先假定已经知道。
4.5 本次分析用到的 signA、signB 是怎么取出来的
上面讲的是 app 的正常流程。这次 Unidbg 用的数据,则是从测试设备已有的缓存里读出来的,没有让 Unidbg 重新请求服务端。
文件名也可以从代码追出来:LibPreference.getNameSpace() 返回 LibPreference,PreferenceUtils 用 com.baidu.homework.Preference. 加上这个命名空间,调用 getSharedPreferences()。
因此本次主进程缓存文件是:
/data/user/0/com.kuaiduizuoye.scan/shared_prefs/com.baidu.homework.Preference.LibPreference.xml里面对应两个键,下面省略真实值:
<string name="KEY_ANTISPAM_SIGN_A">这里是缓存的 signA</string>
<string name="KEY_ANTISPAM_SIGN_B">这里是缓存的 signB</string>
工程里的 scripts/capture_init.py 读取这两个键,写进 captures/init.properties。设备需要能通过 su 读取 app 私有目录。这个脚本里的 cuid 是从本次已抓到的 Base64 入参中提取的,最后由原始 nativeSetToken 检查是否和缓存配套。不要随便拿另一个设备的 cuid 与当前缓存拼在一起。
这里还有一种观察方法:hook nativeInitBaseUtil 的返回值可以看到新 signA,hook nativeSetToken 的入参可以同时看到 cuid、signA、signB。如果走的是缓存恢复分支,可能不会调用 nativeInitBaseUtil,但仍然会调用 nativeSetToken。
看到这里,就知道为什么只加载 so、执行 JNI_OnLoad,再直接调用 nativeGetSign,会返回 error 了。JNI 方法注册好了,不代表它需要的业务数据也初始化好了。
几个容易混的名字先分清楚,后面看 IDA 时按这个表对应:
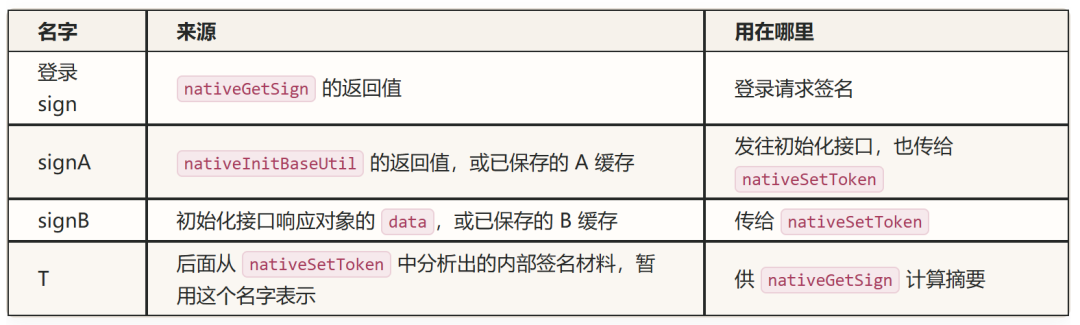
登录入参中还有一个叫 token 的 HTTP 字段,它和表里的 T 不能因为名字相似就当成同一个值。
5. 把 JNI 入口和参数对应起来
5.1 为什么 hook 地址是 0x23bd,IDA 看的是 0x23bc
本次分析的是 ARM32 库。RegisterNatives 表里的函数指针包含 Thumb 标志,因此可能看到:
注册地址:module.base + 0x23bd
代码位置:module.base + 0x23bc
最低位的 1 表示 Thumb 状态,并不是代码真的多偏移一个字节。
用 Frida Interceptor.attach 时保留注册表中的原始函数指针。查看模块内代码位置时,对 ARM32 去掉最低位,然后减去模块基址。
const code = Process.arch === 'arm'
    ? fn.and(ptr('0xfffffffe'))
    : fn;
const offset = code.sub(module.base);
不要把上面的 32 位掩码直接用于 ARM64,它会截断高位地址。本文所有后续代码偏移都对应这一份 ARM32 so,并且没有包含 Thumb 标志。
SHA256:
7da84ec17cdf83e55eda0e127ef7e317055a50fb44131f7538e4fe781b8f9c9e
IDA 默认以 0 为该库的 image base 时,按 G 输入 0x23bc 即可。若数据库被 rebase,需要使用 IDA 当前 image base 加该偏移。这里讨论的是模块内虚拟地址,不能在其他 ELF 中默认把它当成文件偏移。
5.2 不要把 jstring 当成 char 指针
JADX 中可以确认声明是:
staticnative String nativeGetSign(String input);对应的 native 原型可以写成:
jstring nativeGetSign(JNIEnv *env, jclass clazz, jstring input);在这个 ARM32 样本的入口处,参数关系如下:
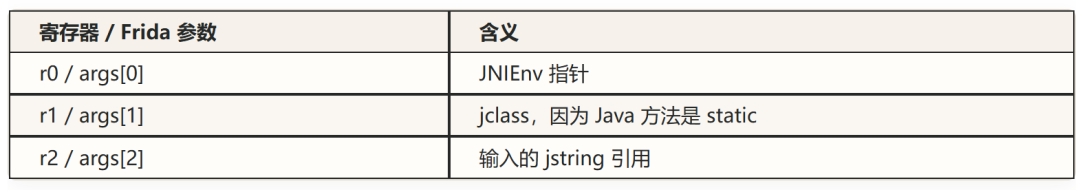
jstring 是 JNI 对象引用,不能直接 args[2].readUtf8String()。必须通过 JNI 的 GetStringUTFChars 得到字符指针,读取后再配对调用 ReleaseStringUTFChars。
到了 IDA 里面,经常看不到这些 JNI 函数名,只看到一串强制类型转换。例如这份伪代码里是:
v4 = *a1;
v6 = (*(int (__fastcall **)(int *, int, _DWORD))(v4 + 676))(a1, a3, 0);
这里的 a1 是 JNIEnv *env,*a1 取出来的是 JNI 函数表的地址。表里面按固定顺序保存指针,可以先这样理解:
a1,也就是 env
    ↓ 解引用一次
*a1:JNI 函数表起始地址
    ├── 索引 0
    ├── 索引 1
    ├── ...
    ├── 索引 167:NewStringUTF
    ├── 索引 168:GetStringUTFLength
    ├── 索引 169:GetStringUTFChars
    └── 索引 170:ReleaseStringUTFChars
当前是 ARM32,每个指针占 4 字节。索引从 0 开始,所以第 169 号槽位距离表头的偏移就是 169 × 4 = 676 字节。反过来看到 +676,就用 676 / 4 = 169 算出索引。
但这里要分清楚:除法只能算出索引,函数名要查 JNI 标准函数表。 打开 JDK 的 jni.h 找 JNINativeInterface_,或者 Android NDK 头文件中的 JNINativeInterface,也可以查看 JNI 官方规范中各函数的 LINKAGE 说明。表头的 4 个 reserved 槽位也要计数,不能从第一个有名字的函数开始数 0。
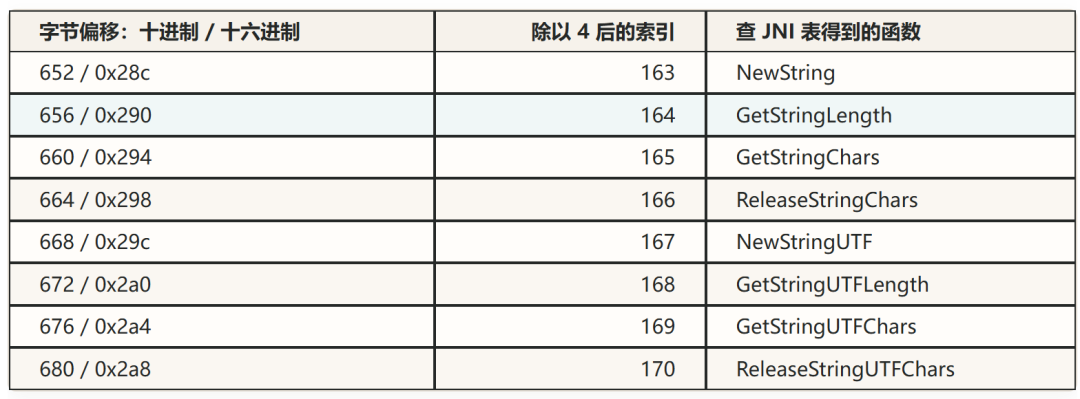
676 和 0x2a4 是同一个数的两种写法:2 × 256 + 10 × 16 + 4 = 676,不涉及别的转换。
把上面那条长调用拆开,其实只有三步:
函数表地址 + 676 → 找到索引 169 的槽位
读取槽位中的指针 → 得到 GetStringUTFChars 的函数地址
用 a1、a3、0 调用这个函数
用常见的 JNI C++ 写法表达就是:
constchar *input = env->GetStringUTFChars(inputString, nullptr);a1 是 env,a3 是输入的 jstring,最后的 0 表示不接收 isCopy 信息。原伪代码中的 v4 被识别成整数地址,所以 v4 + 676 是直接加 676 字节;如果后来改成了带类型的指针表达式,还要注意 C 的指针加法会按元素大小计算。
如果换成 ARM64,每个指针是 8 字节,要用对应的字节偏移除以 8。JNI 索引仍然是 167、169、170,对应偏移会变成 1336、1352、1360,不能照搬 ARM32 的数值。
日志中的 returned 0x15、returned 0x19 同样是 JNI 引用值。它们不是签名内容,签名要通过这个引用继续读取。
5.3 在 IDA 里把三个 native 名字和函数地址接上
Java 这边已经看到了三个方法,接下来要确认它们分别对应 so 里的哪个函数。不能看到 sub_21B0 就直接说它是 nativeSetToken,需要有注册表或运行日志作为依据。
在 IDA 中按 Shift+F12 打开 Strings,搜索 nativeSetToken。双击这个字符串,再选中字符串地址按 X 查看交叉引用。当前文件中能找到 JNI 注册表里引用它的地方。ARM32 的 JNINativeMethod 每项是 12 字节,结构如下:
structJNINativeMethod {
constchar *name;       // +0,方法名指针
constchar *signature;  // +4,JNI 描述符指针
void *fnPtr;           // +8,函数指针
};
这份文件中,三项内容可以对应成:
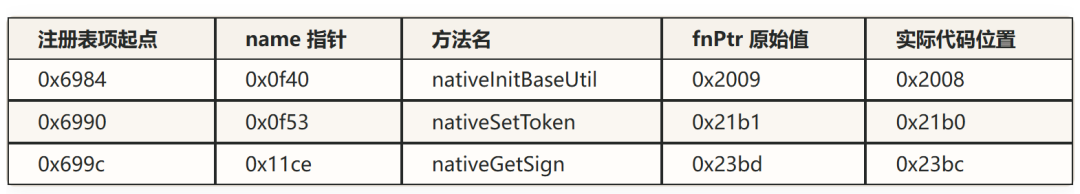
这里的地址以 IDA image base 为 0 为前提。表里的最后一个数带 Thumb 标志,右边一列才是我们按 G 跳转时使用的代码地址。若 IDA 没有自动列出交叉引用,可以直接跳到这份样本的 0x6990,按三个 32 位值检查方法名、描述符、函数指针;这个地址不能拿去套别的版本。
确认之后,在三个函数入口按 N 重命名,名称加个 jni_ 前缀也行,例如 jni_nativeSetToken。名字是我们根据注册关系补上的,IDA 原先可能只显示 sub_21B0。
接着看 NativeHelper 里的声明:
static native StringnativeInitBaseUtil(Context context, Stringstr);
static native boolean nativeSetToken(Context context, Stringstr, String str2, String str3);
把 Java 调用方已经确认的参数含义补进去,第二个函数可以理解成:
jboolean nativeSetToken(JNIEnv *env, jclass clazz,
jobject context, jstring cuid,
jstring signA, jstring signB);
注意它有 6 个 native 参数:Java 里的 4 个显式参数前面,还要加上 env、clazz。
在 ARM32 刚进入函数、还没执行 push 时,位置是:
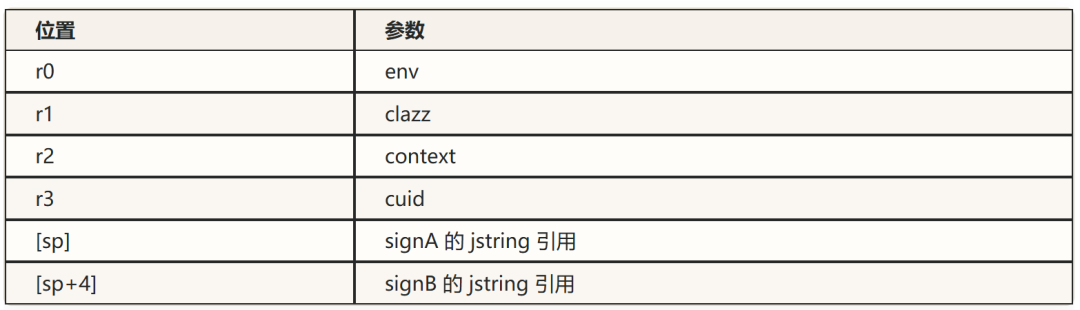
如果沿用前面的 Frida JNI 字符串读取函数,入口处就分别用 readJniString(args[0], args[3])、readJniString(args[0], args[4])、readJniString(args[0], args[5]) 读 cuid、signA、signB。nativeGetSign 的输入才是 args[2],不能把它的位置直接照搬到初始化函数。
IDA 反编译可能没有自动识别这么多参数,需要结合汇编确认。不要把反编译器推测出来的四参数原型当成最终结论。这里先把对应关系记下来,第 8 节会实际跟踪栈上的 signA、signB。
6. 从数据流拆出 nativeGetSign 的主体
接下来回到 IDA,按 F5 看伪代码。类型不对或者变量看不明白,就切回汇编确认。这里我先看输入经过了哪些函数、返回值又传给了谁,不用上来就把所有指令翻译一遍。
下面保留这次 IDA 输出里的变量名,只省略局部变量声明,方便跟自己窗口里的代码一一对应:
int __fastcall sub_23BC(int *a1, int a2, int a3)
{
  // v4、v6 等局部变量声明省略。
 if ( !dword_7B5C )
  {
LABEL_5:
    v4 = *a1;
 return (*(int (__fastcall **)(int *, const char *))(v4 + 668))(a1, "error");
  }
  v4 = *a1;
 if ( dword_7B60 )
  {
    v6 = (*(int (__fastcall **)(int *, int, _DWORD))(v4 + 676))(a1, a3, 0);
 if ( v6 )
    {
      v7 = v6;
      memset(v14, 0, 33);
      v8 = sub_5050((char *)dword_7B60, (int)v14);
      v9 = (char *)sub_45B4("%s[%s]@%s", byte_7B68, v8, v7, 0);
      memset(v13, 0, 33);
      v10 = sub_5050(v9, (int)v13);
      v11 = (*(int (__fastcall **)(int *, int))(*a1 + 668))(a1, v10);
      free(v9);
      (*(void (__fastcall **)(int *, int, int))(*a1 + 680))(a1, a3, v7);
 return v11;
    }
 goto LABEL_5;
  }
 return (*(int (__fastcall **)(int *, const char *))(v4 + 668))(a1, "error");
}
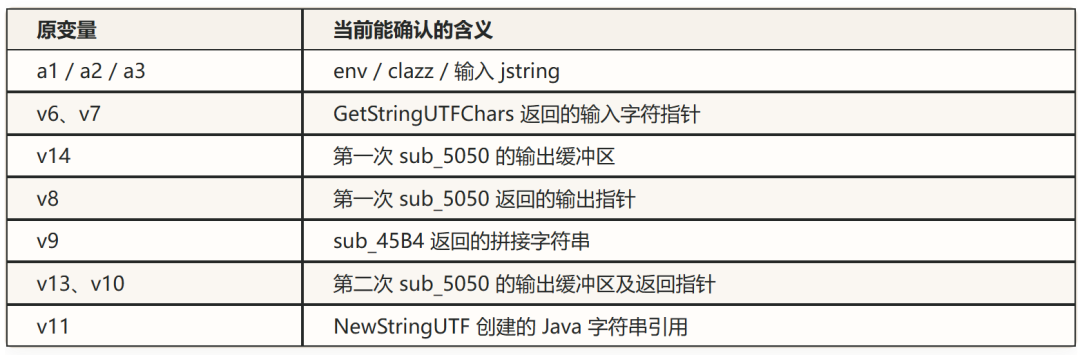
前面查过 JNI 表,现在就能把三个间接调用读懂:+676 取输入字符串,+668 创建返回字符串,+680 释放借出的字符指针。v7 = v6,所以 v7 就是输入字符指针;v9 是中间拼接出来的字符串,最后用 free(v9) 释放。
就算暂时完全不知道 signA、signB,也可以从这里开始分析。 先发现第一次处理的数据来自全局变量,再去找它的写入者。第 4 节是提前把 Java 侧的来源讲清楚,不是说分析这个函数之前就必须猜到两个缓存的名字。
按 G 跳到 0x23bc,按 F5。先看返回 error 的分支,再看成功分支的两次 sub_5050。函数开头会检查初始化相关状态和一个全局指针是否为空,不满足条件时返回 error。
然后在汇编里定位 0x2402:这是 JNI GetStringUTFChars 的间接调用。它返回后,0x240e 的 mov r6, r0 把输入字符指针保存到 r6。后面 0x2434 又把 r6 传给拼接函数,所以这一条是我们传进来的 Base64。
再看 0x241e 的 ldr r0, [r5], #8:第一次 sub_5050 用的是从全局位置加载的数据,并不是刚刚存到 r6 的输入。此时我们还不知道这个全局数据的内容,先标成 global_material。别一上来就把它命名成 HTTP token,等找到写入者后再确定。
把释放内存、栈保护这些先放一边,核心数据流整理下来就是下面这样。这里的伪代码是为了说明流程重新整理的,变量也起了方便理解的名字,不是直接复制的 IDA 输出:
// 为了说明数据流,省略释放、栈保护和异常路径。
const char *input = GetStringUTFChars(env, inputObject, NULL);
charinner[33] = {0};
char output[33] = {0};
sub_5050(global_material, inner);
char *message = sub_45B4("%s[%s]@%s", global_prefix, inner, input, NULL);
sub_5050(message, output);
return NewStringUTF(env, output);看到这里,先记下几个问题:sub_5050 到底做了什么,sub_45B4 是不是只负责拼字符串,byte_7B68 的内容是什么,以及 dword_7B60 是谁写进去的。接下来逐个跟。
dword_7B60 指向的数据
    ↓ sub_5050第一次结果
    ↓ 与 byte_7B68、原始 input 拼接
完整 message
    ↓ sub_5050最终 sign
对应汇编中,下面几处最有价值:
0x242abl  sub_5050      ; 第一次处理全局签名材料
0x242emovr2, r0; 返回值作为后续调用的第三个参数
...
0x2432movr1, r5; 固定前缀
0x2434movr3, r6; 原始输入字符串
...
0x243cbl  sub_45B4     ; 拼接
0x2440  ...              ; 此时 r0 是拼接结果
...
0x2456movr0, r5; 拼接结果作为下一次调用的输入
0x2458bl  sub_5050     ; 第二次处理
ARM32 普通函数调用的前四个参数通过 r0~r3 传递。因此在 0x243c 调用之前,看这四个寄存器就能知道拼接函数拿到了哪些数据。
注意:断点停在调用指令之前,r0 表示入参;停在调用之后,r0 才表示返回值。把这两种位置混淆,很容易把错误的地址当成字符串读取。
7. 确认 MD5 和拼接公式
7.1 为什么判断 sub_5050 是 MD5
前面两个输出缓冲区都清了 33 字节,看起来像“32 个十六进制字符 + 一个结束符”。这可以作为怀疑 MD5 的线索,但单靠长度还不能确认。
双击 sub_5050,继续进入它调用的初始化和轮运算函数,可以看到下面这些初始化常量:
67452301 efcdab89 98badcfe 10325476这几个常量看着就很像 MD5。不过不能看到常量就直接下结论,我们继续往下看:按 64 字节分块更新,填充到块内第 56 字节附近,追加 8 字节长度,最后把 16 字节摘要用 %02x 一个个输出。
再把它实际收到的输入拿出来,用 Python 的 hashlib.md5 算一下,输出也能对上。这样静态特征和实际结果都有了,就可以把 sub_5050 改名为 md5_hex,后面看起来也方便。
这里要区分:digest() 是 16 字节二进制,hexdigest() 是 32 字符十六进制文本。后续拼接使用的是小写 hexdigest()。
7.2 sub_45B4 的作用
sub_45B4 先计算字符串长度并分配内存,再通过 vsnprintf 格式化,最后返回构造的字符串。
签名路径传入的格式是:
%s[%s]@%s它的三个 %s 分别对应固定前缀、第一次 MD5 的结果和原始输入。
7.3 固定前缀怎么还原
在 byte_7B68 上按 X 找写入位置,再跟到初始化函数。这里并不是直接摆着一个字符串,而是用立即数写出来的。IDA 按 G 跳到 0x46ec,可以看到:
0x46ec  MOVS R1, #0x2A
0x46ee  STRB R1, [R0,#4]
0x46f0  MOVW R1, #0x2638
0x46f4  MOVT R1, #0x6425
0x46f8STRR1, [R0]
0x46faBX   LR
先把 R0 看成目标缓冲区地址。第一条把 R1 设成 0x2a,第二条 STRB 只写一个字节,写到 R0 + 4,相当于:
buffer[4] = 0x2a; // 第 5 个字节,因为下标从 0 开始再看 MOVW 和 MOVT。前者把立即数放进低 16 位,并将高 16 位清零;后者替换高 16 位,保留低 16 位。
因此:
执行 MOVWR1, #0x2638 后:R1 = 0x00002638
执行 MOVT R1, #0x6425 后:R1 = 0x64252638
也就是:(0x6425 << 16) | 0x2638
最后 STR R1, [R0] 把这个 32 位整数的 4 个字节写进缓冲区。当前 ELF 使用小端序,低位字节放在低地址,所以按地址从低到高读到的是:
偏移:  +0  +1  +2  +3  +4
字节:  382625642A
这是按字节排列,不能把十六进制数字逐个倒着写。
再查 ASCII 表:
内存字节 | ASCII 字符 |
|---|---|
0x38 | 8 |
0x26 | & |
0x25 | % |
0x64 | d |
0x2a | * |
这样才得到 8&%d*,不是看到一个整数就直接猜字符串。
还有一步不能省:这个函数只说明它往 R0 写了数据,怎么确认 R0 就是 0x7b68?选中 sub_46EC 按 X 看调用者,当前调用点在 0x2186:
0x217eADD.W  R0, R4, #8
0x2182  STRB.W R11, [R4,#0xD]
0x2186BL     sub_46EC
往前追可以确认这里 R4 为 0x7b60,R11 为 0。具体来说,0x2134 取出 literal 0x5a20,0x213c 加上当时的 PC 值 0x2140,得到 0x7b60;0x2106 则把 R11 清零,IDA 也可能将 R11 显示为 fp。
因此传进去的 R0 是 0x7b60 + 8 = 0x7b68,而 STRB.W 往 0x7b60 + 0xd = 0x7b6d 写了零。
初始化完成后的内存就是:
地址:  7B68  7B69  7B6A  7B6B  7B6C  7B6D
字节:   382625642A00
字符:    8     &     %     d     *    \0
最后那个 0 是 C 字符串结束符。静态打开 IDA 时这些初始化指令还没执行,目标位置可能仍显示零;我们是根据写入指令还原执行后的内容。动态读取拼接参数得到的前缀也与此一致。
这里的 %d 属于作为 %s 参数传入的数据,不会被 vsnprintf 再次解释成数字占位符。
将初始化状态中的 10 字节签名材料暂记为 T,原始 JNI 入参记为 I,就得到:
inner   = MD5(T) 的小写十六进制
message = "8&%d*[" + inner + "]@" + I
sign    = MD5(message) 的小写十六进制
对于本文的 ASCII/Base64 输入,可以直接写成:
import hashlib
def sign_ascii(raw_input: str, token: bytes) -> str:
    inner = hashlib.md5(token).hexdigest().encode('ascii')
    message = b'8&%d*[' + inner + b']@' + raw_input.encode('ascii')
    return hashlib.md5(message).hexdigest()
到这里签名公式就出来了,不过代码里还差一个 token。直接把 hook 到的值写死,确实能先跑起来,但这个值到底从哪里来的还没弄清楚。所以继续往前找初始化流程。
8. 在 IDA 里接上 signA、signB 和签名函数
现在我们已经知道 signA、signB 是 Java 传给 nativeSetToken 的。但它俩和第一次 MD5 用到的全局数据有什么关系?这一节就把中间缺的这段接起来。
8.1 从 nativeGetSign 读全局数据的位置往回找
前面伪代码里已经出现了 dword_7B60,直接双击它,或者按 G 输入 0x7b60,就能跳到变量本身。这里的 dword 是 IDA 自动起名时标出的 4 字节数据,7B60 是地址。
但是这 4 字节保存的是指针,不是那 10 字节签名材料本身。要区分地址和地址里保存的值:
0x7b60:全局变量所在地址
    ↓ 读取这里保存的 4 字节指针
运行时分配的内存地址
    ↓
真正参与第一次 MD5 的字符串
所以 (char *)dword_7B60 是把变量里存的值当成字符指针。接下来选中变量名按 X 看引用,重点找赋值。
几种代码含义不一样:
if (dword_7B60)                    // 检查它是否为空
sub_5050((char *)dword_7B60, out);  // 读取它指向的数据
dword_7B60 = buffer;               // 写入者,接下来要追这里
回到 nativeGetSign 的汇编,关注下面几条,省略号表示中间还有别的指令:
0x23e6  ldr r5, [pc, #0xec]   ; 从 0x24d4 的 literal 取出 0x5772
...
0x23eaaddr5, pc            ; 此处参与计算的 PC 值为 0x23ee
...
0x23ec  ldr r1, [r5]          ; 先检查这个全局指针
...
0x241e  ldr r0, [r5], #8; r0 = *(uint32_t *)r5,然后 r5 += 8
...
0x242abl sub_5050 ; 第一次 MD5这里有个地址计算,不要直接跳过:0x5772 + 0x23ee = 0x7b60。所以 r5 最开始指向 0x7b60,这里存着第一次 MD5 所用字符串的指针。ldr r0, [r5], #8 会先读指针,再把 r5 加 8;于是后面 r5 变成 0x7b68,正好是固定前缀的地址。
在 IDA 按 G 跳到 0x7b60,可以先命名为 g_sign_material_ptr,再按 X 看引用,重点找写入它的位置。这里是运行时状态,静态打开 so 看到零值,并不代表 app 运行时也为零;IDA 不会凭空显示服务端交换后才出现的数据。
ARM 的 PC 相对寻址有时不会生成完整的全局交叉引用。遇到这种情况,我们已经从注册表知道 nativeSetToken 在 0x21b0,可以进入它,用同样的方法核对地址。
当前样本中有:
0x229cldrr4, [pc, #0x110]  ; 从 0x23b0 取出 0x58ba
...
0x22a2addr4, pc; 0x58ba + 0x22a6 = 0x7b60
...
0x2392strr0, [r4] ; 把新分配的数据地址保存到 0x7b60这样就有实际的读写关系了:nativeSetToken 写进 0x7b60 的指针,正是 nativeGetSign 后面取来计算 MD5 的指针。它们之间不是靠函数名猜出来的。
8.2 把 nativeSetToken 的两个栈参数认出来
前面已经确定入口 [sp] 是 signA,[sp+4] 是 signB。现在看 0x21b0 的函数开头:
0x21b0push {r4, r5, r6, r7, lr}
0x21b2addr7, sp, #0xc
第一条压入 5 个寄存器,也就是 20 字节。设入口时的 sp 为 entry_sp,第二条执行后:
r7 = entry_sp - 20 + 12 = entry_sp - 8
[r7+8]   = [entry_sp]   = signA
[r7+0xc] = [entry_sp+4] = signB
往下正好看到对应加载:
0x21d2  ldr.w r8, [r7, #8]     ; signA 的 jstring 引用
...
0x21e2  blx r3; GetStringUTFChars(env, signA, NULL)
...
0x2204  ldr.w r8, [r7, #0xc]   ; signB 的 jstring 引用
...
0x2214  blx r3; GetStringUTFChars(env, signB, NULL)
JNI 返回的字符指针会被复制,然后释放 JNI 借出的字符串。后面使用的 signA 副本在 r5,signB 副本在 r11,IDA/反汇编器也可能把 r11 显示成 fp。现在才能有依据地给对应变量改名,不能看到某个长字符串指针就先猜它是 signA。
这次 IDA 伪代码里,相关变量叫 v8、v9、v10、v11:
v8 = GetStringUTFChars(a1, a5, 0);   // JNI 调用已按函数表翻译
v9 = (char *)sub_2878();ReleaseStringUTFChars(a1, a5, v8);
v10 = GetStringUTFChars(a1, a6, 0);
v11 = (char *)sub_2878();ReleaseStringUTFChars(a1, a6, v10);
sub_2878() 被显示成无参数,是反编译器的原型不完整。回汇编看,调用时 R0 里仍是刚取得的字符指针,函数会复制字符串。不能因为 F5 显示了空括号,就认为它没有输入。
对应起来就是 a5 → v8 → v9、a6 → v10 → v11。即使不知道 signA、signB 的名字,仍能先记成“第 5 个参数的副本”和“第 6 个参数的副本”,然后继续往下追。
8.3 先记调用关系,再给算法起名字
在这个函数里面先追 signA:它在 0x2236 传给 sub_2DA4,结果在 0x224a 传给 sub_435C。再追 signB:它在 0x2306 调用同一个 sub_2DA4,在 0x2318 调用同一个 sub_435C。
当前已确认的输入 | 第一层调用 | 第二层调用 | 第二层返回后的位置 |
|---|---|---|---|
signA 字符串 | 0x2236 → sub_2DA4 | 0x224a → sub_435C | 0x224e,r0 是返回指针 |
signB 字符串 | 0x2306 → sub_2DA4 | 0x2318 → sub_435C | 0x231c,r0 是返回指针 |
这里先把 sub_2DA4 记成“编码转换候选”,把 sub_435C 记成“解密候选”。原因是第一层输出了字节数据,第二层还接收一个 8 字节字符串作为参数,返回结果随后会被 strlen、strcmp 检查。此时还不能只凭这个就认定 DES,第 9 节才进入函数内部确认分组、轮数和表。
第一次调用 sub_435C 前,r1 来自只读数据地址 0x116e。在 IDA 按 G 跳过去,可以看到 @fG2SuLA,所以这是我们后面解 signA 使用的固定密钥来源。第二次的 r1 来自前面 sub_45B4 拼出来的字符串,怎么拼的放在 8.5 节展开。
两层处理之后,程序继续切字段、检查长度和比较字符串。结合下面的字段分析,以及第 9、10 节的算法和中间值验证,我们才把整个过程整理成下面的伪代码。这里是整理后的结果,不是刚按 F5 就能看到这些变量名:
cipher_a = decode_handshake(signA)
plain_a = decrypt_variant(cipher_a, b'@fG2SuLA')
challenge = plain_a[7:17]
key_b = challenge[:5] + b'#G4'
cipher_b = decode_handshake(signB)
plain_b = decrypt_variant(cipher_b, key_b)
assert plain_b[:10] == challenge
T = plain_b[12:22]
实际还包含 CUID、证书相关信息和长度等校验;这里先展示签名材料的来源。
8.4 从截断位置识别明文结构,并确认 T 被保存
在 sub_21B0 的伪代码里,最直接的写入证据就是下面这一段。这里先从末尾往前读:
v22 = sub_1F54(11);
if (v22)
{
    v23 = *(_QWORD *)(v20 + 12);
    *(_WORD *)(v22 + 8) = *(_WORD *)(v20 + 20);
    *(_QWORD *)v22 = v23;
    dword_7B60 = v22;
    sub_565C(v14);
    sub_565C(v20);
 return 1;
}
_QWORD 是 8 字节,_WORD 是 2 字节。它先取 v20 + 12 开始的 8 字节,再取 v20 + 20 开始的 2 字节,连续复制到新内存的偏移 0 和 8。因此可以整理为:
char *saved = sub_1F54(11);
// 这里先只整理分配和复制关系,分配函数的清零行为要另外核对。
memcpy(saved, (char *)v20 + 12, 10);
dword_7B60 = saved;
我们要找的材料,就是 v20[12:22]。再往前找 v20 的赋值:
v18 = sub_2DA4(v11);
v19 = strlen(v11);
v20 = sub_435C(v18, ptr, v19 >> 2);
这说明它来自第 6 个参数对应的字符串,经过编码转换和处理后得到的结果。v19 >> 2 是长度除以 4,与前面的缓存编码关系吻合。结合原代码中的 v14、v20,现在两条路径可以写成:
a5 → v9 → sub_2DA4 → sub_435C,使用固定密钥 "@fG2SuLA"
                           ↓
                          v14 → 截取一部分,再拼 "#G4" → ptr
                                                        ↓
a6 → v11 → sub_2DA4 → sub_435C,使用 ptr
                           ↓
                          v20 → 复制 [12:22] → dword_7B60 保存其地址
signA 解密完成后,代码会在明文偏移 0x11、0x33 处写入 NUL,使对应字段可以单独传给 strlen、strcmp。再结合 +7、+0x13、+0x35 等指针运算,可以推断出字段边界。
用运行时明文验证后,signA 的结构为:
8&%d*##challenge##certificateDigest##cuid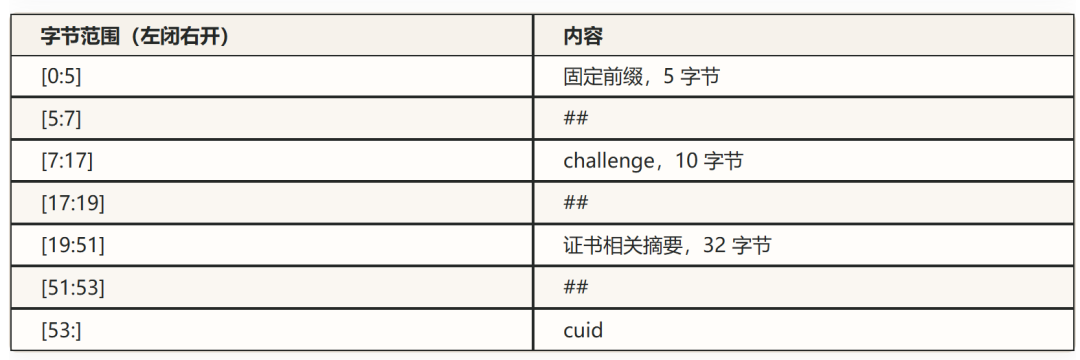
signB 的结构则是:
challenge##T长度为 10 + 2 + 10 = 22 字节。native 会比较它的前 10 字节与 signA 中的 challenge,随后把最后 10 字节复制到新分配的内存中,保存供 nativeGetSign 使用。
对应 IDA 里可以逐个核对:0x2336 检查总长度 0x16,0x2348 把明文指针加 0x0c 放入 r6,0x2352 检查后半段长度 0x0a。比较前半段成功后跳到 0x237c,申请 0x0b 字节空间,再用 0x2386 到 0x238e 的加载、存储指令复制这 10 字节,最后在 0x2392 保存指针。
到这里,前面暂时叫作 global_material 的数据就有来源了:它是 signB 明文偏移 12 开始的 10 字节。文中用 T 表示它。现在再回到 nativeGetSign 的第一次 MD5,就能明确说它算的是 MD5(T)。
同一个 nativeSetToken 中也会取 Android 安装包证书信息,比较 signA 的证书摘要和本地证书计算结果。此次 Python 还原面向已经由原始 APK 验证有效的缓存,校验 CUID 和 challenge,但没有重新实现 Android 包证书校验环境。
8.5 signB 的密钥在哪里
在 0x22f0 附近,程序暂时把 signA 明文 +0x0c 的位置写为 NUL,对应这段伪代码:
v17= *(_BYTE *)(v14 + 12);        // 先保存原字符
*(_BYTE *)(v14 + 12) =0;         // 临时截断
ptr= sub_45B4("%s%s", v14 + 7,"#G4",0);
*(_BYTE *)(v14 + 12) = v17;        // 再恢复
从偏移 7 开始,到偏移 12 前停止,正好 12 - 7 = 5 字节。challenge 从 +7 开始,所以这里截取的是 challenge 的前 5 字节。
接着用 %s%s 拼上固定字符串 #G4,形成 8 字节密钥,再恢复原来的明文字节。
因此它不是完整的 10 字节 challenge 作为密钥,而是:
key_b = challenge[:5] + b'#G4'这里就是先把字符串临时截断,用完再恢复。要是只看最后的字符串,很容易漏掉中间只取了 5 个字节这一步。
9. 还原缓存编码和 DES 变体
9.1 看起来像 hex,但不能直接 bytes.fromhex
本次缓存中的 signA 长 352 字符,signB 长 96 字符。每两个字符只会是 00 到 0f,这与普通任意字节的 hex 表示不同。
进入 0x2da4 及其调用的 0x2ca8,可以看到:每两个字符取第二个字符,查出对应的四个 bit,然后把连续八个 bit 按低位优先组合成一个字节。
可以分两步理解:
每对 00..0f → 一个 nibble → 按高位到低位展开 4 个 bit每 8 个 bit → bit[0] 放入字节最低位 → 合成一个 byte例如人造输入 0001:
00 → 0000
01 → 0001
拼接的 bit 数组:[0,0,0,0,0,0,0,1]
按 LSB-first 打包:0x80
而普通 bytes.fromhex('0001') 会得到两个字节 00 01,两者显然不同。
对应 Python:
defdecode_handshake(encoded):
ifnot encoded orlen(encoded) % 4:
raise ValueError('编码长度错误')
    bits = []
for pos inrange(0, len(encoded), 2):
        pair = encoded[pos:pos + 2]
if pair[0] != '0'or pair[1] notin'0123456789abcdef':
raise ValueError('编码包含非法字符')
        value = int(pair[1], 16)
        bits.extend((value >> bit) & 1for bit in (3, 2, 1, 0))
returnbytes(
sum(bits[pos + bit] << bit for bit inrange(8))
for pos inrange(0, len(bits), 8)
    )
所以 signA 解码后是 88 字节密文,signB 解码后是 24 字节密文。先验证这一层,再分析分组算法,可以避免把编码错误误判为密码算法错误。
9.2 如何识别 DES
这里不能直接写一句“看出来是 DES”就结束。我们从 sub_435C 往里面走,看每个判断的依据。
9.2.1 sub_435C 先给出线索,还不能单独下结论
根据上一层调用,三个参数可以先对应成:
sub_435C(a1, a2, a3);
// a1:转换后的数据地址
// a2:8 字节密钥的地址
// a3:数据长度
先看它怎么处理 a2:
v19[0] = *a2;
v19[1] = a2[1];
IDA 把 a2 推成了 int *,所以每次取 4 字节,两次共取 8 字节。这里不是说密钥本来就是两个整数,只是编译器按两个 32 位值搬运。
接下来的长循环一直在做 & 1、& 2、& 4 和移位。把那些指针表达式整理一下,就能看出它在拆 bit:
for (int i = 0; i < 8; i++) {
for (intbit = 0; bit < 8; bit++) {
        keyBits[i * 8 + bit] = (key[i] >> bit) & 1;
    }
}
例如密钥中的一个字节是 0x01,得到的就是 [1,0,0,0,0,0,0,0],也就是 LSB-first。8 个密钥字节被展开成 64 个 0/1,每个逻辑 bit 用一个 byte 保存。
伪代码里可能把这块栈空间显示成 v23[7] 和一个单独的 v24,但循环实际连续写了 64 字节。这是局部变量边界没有恢复好,不能按 [7] 去理解算法,也不能仅凭这个显示就判断原程序越界。
然后是:
_BYTE v22[768];
sub_3DE4(v23, v22, v11);
这里的 768 很有特点:16 × 48 = 768。DES 正好有 16 轮,每轮用 48 bit 轮密钥;这份实现每个 bit 占一字节,因此轮密钥数组占 768 字节。现在可以怀疑 sub_3DE4 在生成轮密钥,但还要进去确认,不能只按数组大小认算法。反编译显示的第三个实参是否有意义,也要以被调函数实际读取哪些寄存器为准。
主循环则每次取两个 DWORD,交给 sub_406C,再写回两个 DWORD:
v20[0] = *(_DWORD *)(a1 + v12);
v20[1] = *(_DWORD *)(a1 + v12 + 4);
sub_406C(v20, v22, v21);
*(_DWORD *)&v6[v12] = v21[0];
*(_DWORD *)&v6[v12 + 4] = v21[1];
v12 += 8;
也就是每次处理一个 8 字节分组。8 字节密钥、8 字节分组、疑似 16×48 bit 轮密钥,几个线索放在一起就很像 DES。真正要确认,还得继续看两个子函数。
9.2.2 在 sub_3DE4 确认密钥调度
IDA 跳到 0x3de4,看几个循环的边界和访问的表:
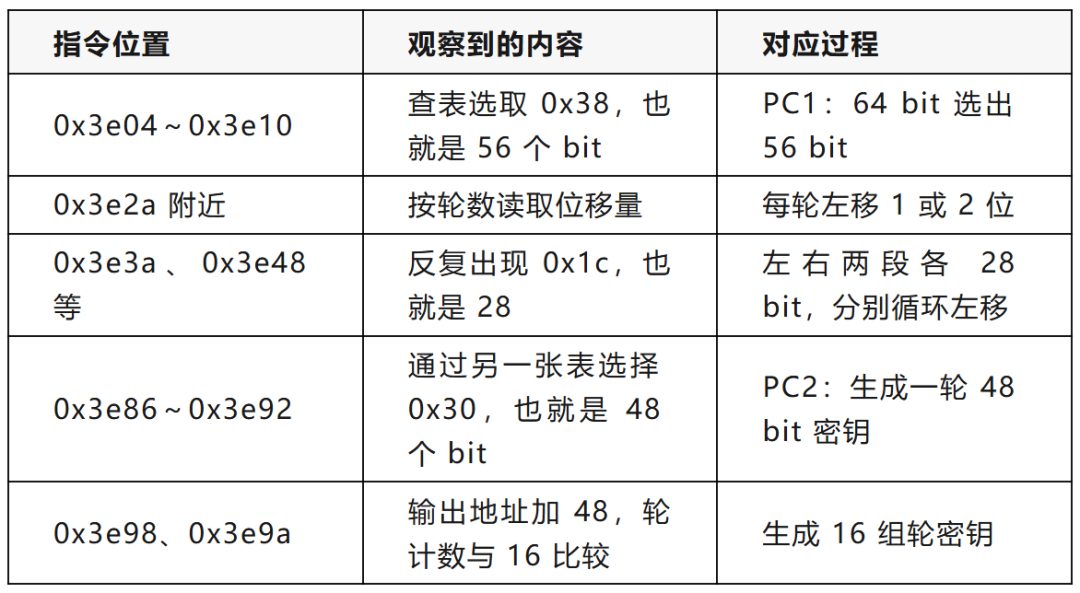
轮转表内容是:
1, 1, 2, 2, 2, 2, 2, 2, 1, 2, 2, 2, 2, 2, 2, 1它和 DES 的轮转安排一致。再结合 PC1、PC2 的内容,就能把这部分识别成 DES 的密钥调度。注意“属于这个结构”和“每个表项都标准”是两个判断,PC2 的差异下一节单独比较。
9.2.3 sub_406C 开头的向量变量和初始置换
继续双击 sub_406C。它的参数是一个 8 字节输入、轮密钥数组、8 字节输出地址。这里不负责去填充。
刚打开会看到不少 int64x2_t、n128_u8、veorq_s64,先别被这些名字绕进去:
伪代码写法 | 含义 |
|---|---|
int64x2_t | 一个 16 字节的 NEON 向量 |
n128_u8 | 按字节访问向量内容 |
veorq_s64(x, y) | 对两个 16 字节向量做逐位异或 |
这里一个 byte 保存一个逻辑 bit,所以一次操作 16 字节,相当于同时处理 16 个逻辑 bit。向量指令只是编译器加快搬运和异或,不是另一种密码算法。
开头的循环还是把每个输入字节低位在前地拆开,共得到 64 个 bit。接着是:
for (i = 0; i != 64; ++i)
v47.n128_u8[i] = v42.n128_u8[*(_DWORD *)&a9[4 * i]];
这里的 a9 是 IDA 数据标签,不是函数的第九个参数。4 * i 表示每个表项占 4 字节,整个操作相当于:
permuted[i] = inputBits[IP[i]];在 IDA 双击 a9,这份样本对应 0x11f0。它的开头是:
样本:57, 49, 41, 33, 25, 17, 9, 1, ...
标准 DES 文档:58, 50, 42, 34, 26, 18, 10, 2, ...
样本每项比标准文档少 1,是因为数组从 0 开始编号。表内容能对上,才把它标成 IP 初始置换。
v42.n128_u8[i] 看起来只有一个 16 字节向量,却能访问到 63,也是反编译器拆分连续栈缓冲区导致的。按这份栈布局,后面可以把 v42、v43 对应的 32 字节看成左半 L,把 v44、v45、v46 对应的 32 字节看成右半 R。
9.2.4 为什么知道是 16 轮解密
轮循环里有这几行:
v9 = 15;
//... 每轮 ...
v16 = (int64x2_t *)(a2 + 48 * v9);
//...
if(!v9)
    break;
//...
--v9;
第一个使用的是 a2 + 48 × 15,然后是第 14 组,最后是第 0 组。0 这一轮也执行,所以总共 16 轮。结合前面按正序生成的轮密钥,这里按 15 → 0 倒序使用,就是 DES 的解密方向。
9.2.5 每轮的 E 扩展、轮密钥异或和 S-box
每轮先把右半 R 复制到从 v39 开始的临时区域,再执行:
for (j =0; j != 48; ++j)
    v47.n128_u8[j] = v39.n128_u8[dword_1AF0[j]];
也就是 expanded[j] = right[E[j]]。dword_1AF0 开头是:
31, 0, 1, 2, 3, 4, 3, 4, 5, 6, 7, 8, ...这是零基下标的 E 扩展表,重复选取部分 bit,把 32 bit 扩展为 48 bit。后面三次 veorq_s64,每次 16 字节,共处理 48 字节:
v17 = veorq_s64(*v3, v16[1]);
v18 = veorq_s64(v49, v16[2]);
v39 = veorq_s64(v47, *v16);
整理后就是 expanded[j] ^= roundKey[j],即 E(R) XOR K。
紧接着调用 sub_3340(&v39)。函数名看不出用途,要继续进入看取位和查表。里面每次取 6 个 bit:
输入六位:b0 b1 b2 b3 b4 b5行号 = b0 × 2 + b5列号 = b1 × 8 + b2 × 4 + b3 × 2 + b4查表可以表达成:
value = SBOX[box * 64 + row * 16 + col];结果是 0~15,再从高位到低位展开成 4 个 bit。共处理 8 组,因此是 8 × 6 = 48 bit 输入、8 × 4 = 32 bit 输出。
表在 0x12f0,第一组 S-box 第一行是:
14, 4, 13, 1, 2, 15, 11, 8, 3, 10, 6, 12, 5, 9, 0, 7这些值和 DES S1 第一行一致,取行列的方式也一致。这是识别 S-box 的实际依据,不是看见一个查表函数就直接改名。
9.2.6 P 置换、左右异或与最后一轮交换
S-box 后还有一次 32 bit 的查表:
for (k =0; k != 32; ++k)
    v47.n128_u8[k] = v39.n128_u8[dword_1BB0[k]];
表开头是 15, 6, 19, 20, 28, 11, 27, 16, ...,对应零基 DES P 表。后面的向量异或把这个结果与左半 L 异或,再通过一串临时变量赋值交换左右两半。
整个轮函数可以整理为:
F(R, K) = P(SBOX(E(R) XOR K))
L_new = R_old
R_new = L_old XOR F(R_old, K)
原代码在最后一轮 if (!v9) break,跳过了下面的交换。因此进入最终置换前的缓冲区,已经是所需的左右排列。写独立实现时也可以采用“每轮都交换,最后再交换一次”的常见写法,但不能在原流程上随手重复补一次交换。
9.2.7 FP 最终置换和 8 字节输出
最后一个 64 次循环:
for (m =0; m != 64; ++m)
    v47.n128_u8[m] = v42.n128_u8[dword_1C30[m]];
dword_1C30 开头是 39, 7, 47, 15, 55, 23, 63, 31, ...,对应零基的 FP,也就是 IP 的逆置换。
再往下就是 2 * v35[1]、4 * v35[2]、v33 << 7 那一长串,整理后只是把 bit 打包回字节:
output[i] = bits[i * 8]
          | (bits[i * 8 + 1] << 1)
          | (bits[i * 8 + 2] << 2)
          | (bits[i * 8 + 3] << 3)
          | (bits[i * 8 + 4] << 4)
          | (bits[i * 8 + 5] << 5)
          | (bits[i * 8 + 6] << 6)
          | (bits[i * 8 + 7] << 7);
循环执行 8 次,得到 8 字节明文。函数最后的 return 0 不是明文,明文通过 a3 指向的缓冲区输出。
这些结构和表内容一起对上,才确认它属于 DES 算法族。原始名称可以逐步改成:
原名称 | 确认后的名称 |
|---|---|
sub_3DE4 | des_make_round_keys |
sub_406C | des_variant_decrypt_block |
sub_3340 | des_sbox_substitute |
a9、dword_1AF0、dword_1BB0、dword_1C30 | DES_IP、DES_E、DES_P、DES_FP |
回看 sub_435C,各分组独立调用这个核心,外层和单块函数都没有前一块密文的链式异或,因此当前路径按 ECB 方式处理。分组模式和尾部填充要与单块 DES 运算分开分析。
9.3 为什么标准 DES 库不能直接替换
认出了 DES 结构,下一步还得确认是不是标准实现。不能只看 16 轮和 8 字节分组,也不能只看 S-box 第一行。这里分三步:逐项比表、核对位序和运算、使用已知测试向量验证。
9.3.1 先统一编号,再比较整张表
标准文档通常从 1 编号,程序数组从 0 编号。例如 PC2 开头:
标准文档:14, 17, 11, 24, 1, 5, ...
程序下标:13, 16, 10, 23, 0, 4, ...
这种统一减 1 只是编号变化。要比较的是“样本表”和“标准置换表每项减 1 后的结果”。S-box 保存的是输出值,轮转表保存的是次数,它们不能跟着减 1。
样本的 PC2 位于 0x1e10,每项占 4 字节。差异在下标 35,也就是第 36 项:
地址 = 0x1e10 + 35 × 4 = 0x1e9cIDA 按 G 跳到 0x1e9c,这里实际是 0x2e,十进制 46。标准 PC2 同一项在文档里是 48,转成零基后应该是 47,即 0x2f:
表项 | 样本实际值 | 标准值,已转零基 |
|---|---|---|
PC2[35] | 46 | 47 |
还要看这个值怎么使用。sub_3DE4 中 0x3e86 读取表项,0x3e8a 直接按该下标取 bit,没有额外修正。因此它确实选了不同的位置,会影响轮密钥,不是显示格式造成的差异。
下面这段在 IDA Python 控制台执行,假定 image base 为 0。它读取整张 PC2 逐项比较:
import ida_bytes
standard = [
14,17,11,24,1,5,3,28,15,6,21,10,
23,19,12,4,26,8,16,7,27,20,13,2,
41,52,31,37,47,55,30,40,51,45,33,48,
44,49,39,56,34,53,46,42,50,36,29,32
]
for i, value in enumerate(standard):
    actual = ida_bytes.get_dword(0x1e10 + 4 * i)
    expected = value - 1
    if actual != expected:
        print(f'PC2[{i}] 地址={0x1e10 + 4*i:#x} '
              f'样本={actual} 标准={expected}')
结果是:
PC2[35] 地址=0x1e9c 样本=46 标准=47同样的方法还要用来核对 IP、FP、E、P、PC1、完整 S-box 和轮转表。仅有几个开头值一致,可以辅助识别算法,不能证明所有内容都标准。
9.3.2 位序需要结合整条计算链判断
前面已经看到,密钥和输入分组都用 LSB-first 展开:
字节 0x01
样本展开:1 0 0 00 0 0 0
DES 文档的位编号顺序:0 0 0 00 0 0 1
但只看到 LSB-first,也不能马上说算法改了。内部实现可以用不同表示,只要相应调整置换表或增加转换,最终仍可能得到标准结果。所以要把密钥展开、PC1/PC2 索引、输入展开、IP/E/P/FP、输出打包连起来核对。
当前样本的位序处理不能直接交给常见标准 DES 字节接口。注意这里讲的是一个字节内部的 bit 顺序,第 7 节 STR 写整数讲的是多个字节之间的小端存储顺序,是两回事。
9.3.3 使用标准单分组向量做对照
选一组已知 DES 测试向量,全部按 hex 解码成原始字节,不加字符串编码和填充:
密钥:133457799BBCDFF1
明文:0123456789ABCDEF
密文:85E813540F0AB405
这里分析的是解密,所以输入密文和密钥,标准结果应该是上面的明文。要测的是 sub_406C 配合轮密钥生成的单分组路径,不能直接把无填充向量交给 sub_435C,否则它会把末字节当作填充长度裁掉。
下面是在工程根目录运行的对照代码,调用已经与原始 so 核对过的 Python 还原实现。第一遍保留样本行为,第二遍仅调整位序,第三遍同时恢复标准 PC2。所有修改只发生在测试进程中,最后恢复原表,不改 so 和源码文件。
from algorithm import kuaidui_sign as impl
standard_pc2 = tuple(value - 1for value in (
14,17,11,24,1,5,3,28,15,6,21,10,
23,19,12,4,26,8,16,7,27,20,13,2,
41,52,31,37,47,55,30,40,51,45,33,48,
44,49,39,56,34,53,46,42,50,36,29,32
))
key = bytes.fromhex('133457799BBCDFF1')
ciphertext = bytes.fromhex('85E813540F0AB405')
expected = bytes.fromhex('0123456789ABCDEF')
defreverse_bits_each_byte(data):
# 逐字节反转 bit,不改变字节之间的顺序。
returnbytes(int(f'{byte:08b}'[::-1], 2) for byte in data)
defnormalized_decrypt():
    keys = impl._round_keys(reverse_bits_each_byte(key))
    result = impl._decrypt_block(reverse_bits_each_byte(ciphertext), keys)
return reverse_bits_each_byte(result)
original_pc2 = impl.PC2
try:
print('样本实现:', impl._decrypt_block(ciphertext, impl._round_keys(key)).hex())
print('只调整位序:', normalized_decrypt().hex())
    impl.PC2 = standard_pc2
    result = normalized_decrypt()
print('调整位序和 PC2:', result.hex())
assert result == expected
finally:
    impl.PC2 = original_pc2
本次 Python 对照结果为:
测试条件 | 解密结果 |
|---|---|
样本实现 | c6aaf1c6d8c3e26d |
仅调整密钥、输入和输出的位序,保留样本 PC2 | 9ba15c58ffe17986 |
调整位序,并恢复标准 PC2 | 0123456789abcdef |
这组结果与前面找到的差异相互印证。单组向量通过不能代替全部表和运算检查;向量不通过时,也要先排除输入格式、方向、填充等问题。对于当前样本,表项差异、实际取位代码和对照结果都有了,才把它归为 DES 变体。
做还原时仍然要保留样本行为。把 PC2 修成标准值,是为了验证差异来源,不能拿这个修改后的结果去算 app 的 signA/signB。
9.3.4 把样本实际使用的表提取出来
当前样本的表位置如下。它们是 little-endian 的 32 位整数数组,本文涉及的这些 .rodata 地址恰好与文件偏移相同:
表 | 偏移 | 元素数 |
|---|---|---|
IP | 0x11f0 | 64 |
SBOX | 0x12f0 | 512 |
EXPANSION | 0x1af0 | 48 |
P | 0x1bb0 | 32 |
FP | 0x1c30 | 64 |
PC1 | 0x1d30 | 56 |
PC2 | 0x1e10 | 48 |
ROTATIONS | 0x1ed0 | 16 |
例如提取 PC2:
from pathlib importPath
import struct
so = Path('../libbaseutil.so').read_bytes()
pc2 = struct.unpack_from('<48I', so, 0x1e10)
assert pc2[35] == 46
完整提取脚本为附件中的 scripts/extract_native_tables.py。它会检查 so 的 SHA256,再生成 algorithm/des_tables.py。生成后的算法运行不再需要 so。
9.4 轮密钥和单分组怎么写
下面代码使用已经提取好的八张表,可以在工程根目录执行:
from algorithm.des_tables import IP, FP, PC1, PC2, ROTATIONS, EXPANSION, P, SBOX
def bits_lsb(data):
return [(byte >> bit) & 1 for byte in data for bit in range(8)]
def pack_lsb(bits):
return bytes(sum(bits[pos + bit] << bit for bit in range(8))
for pos in range(0, len(bits), 8))
def permute(bits, table):
return [bits[index] for index in table]
def round_keys(key):
if len(key) != 8:
raise ValueError('密钥必须为 8 字节')
selected = permute(bits_lsb(key), PC1)
left, right = selected[:28], selected[28:]
keys = []
for shift in ROTATIONS:
left = left[shift:] + left[:shift]
right = right[shift:] + right[:shift]
keys.append(permute(left + right, PC2))
return keys
def decrypt_block(block, keys):
state = permute(bits_lsb(block), IP)
left, right = state[:32], state[32:]
for key in reversed(keys):
expanded = [x ^ y for x, y in zip(permute(right, EXPANSION), key)]
substituted = []
for box in range(8):
six = expanded[box * 6:box * 6 + 6]
row = (six[0] << 1) | six[5]
col = (six[1] << 3) | (six[2] << 2) | (six[3] << 1) | six[4]
value = SBOX[box * 64 + row * 16 + col]
substituted.extend((value >> bit) & 1 for bit in (3, 2, 1, 0))
left, right = right, [x ^ y for x, y in zip(left, permute(substituted, P))]
return pack_lsb(permute(right + left, FP))
解密时轮密钥倒序使用。每轮按照 L_new = R_old、R_new = L_old XOR F(R_old, key) 更新,最后交换并执行 FP。
这里还要注意:虽然输入字节是低位优先展开,但 S-box 的四个输出 bit 按高位到低位写入,不能把所有位处理都机械地统一为同一个方向。
9.5 填充同样要看实际数据
回到 sub_435C,末尾这几行负责裁去填充:
v16 = a3 - (unsigned __int8)v6[a3 - 1];
v17 = sub_5598(sub_5510, v16 + 1, nullsub_2);
j_memcpy(v17, v6, v16);
*((_BYTE *)v17 + v16) = 0;
最后一个字节是要裁去的长度,剩余内容复制到新缓冲区,再补字符串结束符。这几句本身不能证明填充是 PKCS#7,因为它没有检查其余填充字节。
最初按 PKCS#7 检查,signB 解密后会报填充错误。继续比较原始 so 的明文,发现有效部分之后是:
...[22 字节有效明文] 00 02末尾 02 表示需要去掉两个字节,前一个填充字节是零。这与 ANSI X9.23 形式一致;PKCS#7 在这里应该是 02 02。
上层解密可以写成:
def decrypt_handshake(encoded, key):
    ciphertext = decode_handshake(encoded)
    if len(ciphertext) % 8:
        raise ValueError('密文必须按 8 字节分组')
    keys = round_keys(key)
    padded = b''.join(decrypt_block(ciphertext[i:i + 8], keys)
                      for i in range(0, len(ciphertext), 8))
    padding = padded[-1]
    if not 1 <= padding <= 8 or padded[-padding:-1] != b'\x00' * (padding - 1):
        raise ValueError('填充不匹配')
    return padded[:-padding]
原始函数主要按最后一个字节裁去长度,Python 版还检查零填充是否正确。这是为坏输入增加检查;不能据此声称两者在所有非法输入上的行为完全一致。
10. 用中间值定位错误,而不只看最终 sign
写完代码直接看最终 sign,能对上当然好。但如果对不上,光盯着两个不同的字符串,也看不出是哪一步错了。
所以这里我用 Unidbg 跑原始 so,把关键位置的输入输出记下来,再跟 Python 一步步比较:
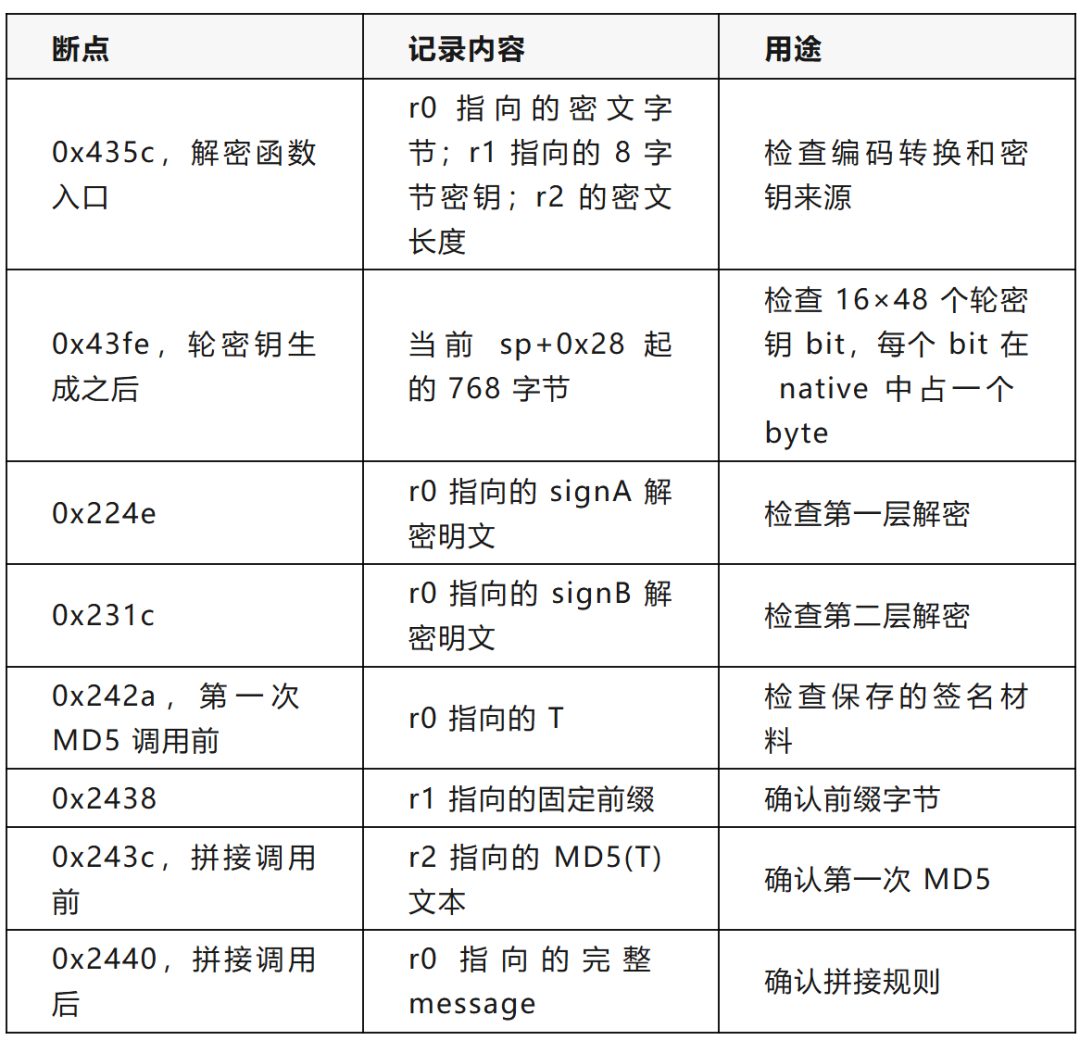
这些位置是针对当前函数布局选择的,尤其 sp+0x28 这样的栈偏移必须和当前指令位置配套,不能跨版本照抄。
例如 Unidbg 中记录 signA 解密结果:
debugger.addBreakPoint(module, 0x224e, (emulator, address) -> {
RegisterContextctx= emulator.getContext();
StringplainA= ctx.getPointerArg(0).getString(0);
    evidence.setProperty("plaintextA", plainA);
returntrue; // 继续执行
});
记录密文则必须指定长度,不能调用 getString(),因为密文中可能包含 NUL:
debugger.addBreakPoint(module, 0x435c, (emulator, address) -> {
RegisterContextctx= emulator.getContext();
intlength= ctx.getIntArg(2);
byte[] ciphertext = ctx.getPointerArg(0).getByteArray(0, length);
byte[] key = ctx.getPointerArg(1).getByteArray(0, 8);
// 保存 ciphertext 和 key,供 Python 比较。
returntrue;
});
断点负责观察,不替换参数、轮密钥或返回值。探针必须在调用 nativeSetToken 之前安装,才能记录到初始化解密过程。
完整实现为 src/main/java/local/kuaidui/NativeAlgorithmProbe.java。Python 对照时依次检查:
自定义解码后的密文一致
→ 16 轮子密钥一致
→ signA 明文一致
→ signB 明文一致
→ T 一致
→ MD5 和拼接结果一致
→ 最终签名一致
如果密文字节就不一致,先修编码;如果密文一致但轮密钥不同,查位序、PC1/PC2 和轮转;如果明文主体相同而末尾错误,查填充;如果全部解密结果一致,最后签名仍然错误,查拼接、大小写和输入编码。
这套方法也帮助发现了前面的填充差异。已经观察到 signB 的有效明文和 native 完全相同,就不需要重新怀疑整套 DES 实现。
11. 组合为独立实现并验证
前面的解码、解密和 MD5 都有了,最后把它们串起来就行。下面还是按这次抓到的 ASCII 参数来写:
defrecover_token(cuid, sign_a, sign_b):
    plain_a = decrypt_handshake(sign_a, b'@fG2SuLA')
if (len(plain_a) < 53or plain_a[5:7] != b'##'
or plain_a[17:19] != b'##'or plain_a[51:53] != b'##'):
raise ValueError('signA 结构错误')
if plain_a[53:] != cuid.encode('ascii'):
raise ValueError('CUID 不匹配')
    challenge = plain_a[7:17]
    plain_b = decrypt_handshake(sign_b, challenge[:5] + b'#G4')
iflen(plain_b) != 22or plain_b[:10] != challenge or plain_b[10:12] != b'##':
raise ValueError('signA/signB 不配对')
return plain_b[12:22]
# 参数从本地配置读取,代码中不写死某个用户的签名材料。
from algorithm.kuaidui_sign import read_properties
config = read_properties('captures/init.properties')
vector = read_properties('vectors/user-sample.properties')
token = recover_token(config['cuid'], config['signA'], config['signB'])
print(sign_ascii(vector['input'], token))
工程中的正式入口已经封装好:
# 默认读取 vectors/user-sample.properties 的 input=
python .\sign.py
# 传入完整原始字符串
python .\sign.py--input'你的Base64入参'
# 固定样本和坏缓存检查,无需 JVM
python -munittestalgorithm.test_sign -v
# 启动原始 so 做对照,开发验证时使用
python .\scripts\verify_algorithm.py
纯算法运行只需要 Python 标准库、algorithm 目录和有效缓存配置,不需要 APK、so 或 Java。
固定回归共有 7 组抓包样本,全部通过。随后将这 7 组样本与 54 组构造输入一起交给原始 so 和 Python,总计 61 次对照,全部匹配。构造输入覆盖空串、ASCII 标点、Base64、MD5 分块边界和长字符串,最长 5464 字符。
其中前面抓到的三组样本,结果如下:
输入中的时间字段 | 实际结果,与抓包一致 |
|---|---|
| t =1792748284 | fc618dc1f2d216437da53eb31484a4f8 |
| t =1792752537 | 0585429632a0ea7c8344ddb4cbf68e9b |
| t =1792752540 | 8ff138d849b57cfebd015656a0b027ea |
前面看到后两次输出不一样,还以为是相同输入算出了不同结果。把 Base64 解开一看,里面的时间戳差了 3 秒,其余内容一致。时间戳也是签名输入的一部分,变了之后 sign 自然会变。再按 A、B、A、B 的顺序重复调用,同一份输入每次都能算出同一个结果。
11.1 最后跑一组前面抓到的样本
分析到这里,最后还是得跑一次,把结果放出来。这里就用前面时间字段为 _t_=1792748284 的那组完整输入,一共 716 个字符,抓包结果是 fc618dc1f2d216437da53eb31484a4f8。
这组原始输入已经保存在 algorithm/fixtures/captured-vectors.json,样本名是 user-1792748284。直接读取固定样本来验证,不受后来修改 vectors/user-sample.properties 的影响。在工程根目录运行下面这段 Python:
import json
from pathlib import Path
from algorithm.kuaidui_sign import load_signer
vectors = json.loads(
    Path('algorithm/fixtures/captured-vectors.json').read_text(encoding='utf-8')
)
vector = next(item for item in vectors if item['name'] == 'user-1792748284')
signer = load_signer('captures/init.properties')
actual = signer.sign(vector['input'])
print('name =', vector['name'])
print('input length =', len(vector['input']))
print('expected =', vector['expected'])
print('actual   =', actual)
assert actual == vector['expected'], '签名没有对上'
print('PASS')
本次实际运行输出:
name= user-1792748284
input length =716
expected= fc618dc1f2d216437da53eb31484a4f8
actual= fc618dc1f2d216437da53eb31484a4f8
PASS
到这里,这组抓包样本就对上了。整个计算走的是 signA/signB → 恢复 T → 两次 MD5 和拼接,运行这段 Python 不需要启动 Unidbg。
11.2 再放一个能直接运行的短输入
如果只是想先看入口怎么调用,可以用构造输入 MQ==。这四个字符就是完整的 native 入参,原样参与签名,不先解码。它是算法对照样例,不是一份完整登录请求。
在工程根目录执行:
python .\sign.py--input'MQ=='本次实际输出:
f62a65e67433bfdabd73f6030baa7f6d这组输入也在之前原始 so 的对照记录中,位置是 captures/algorithm-native-results.tsv 的 base64-1 样例:
对照项 | 结果 |
|---|---|
完整入参 | MQ== |
原始 so 已保存的结果 | f62a65e67433bfdabd73f6030baa7f6d |
本次 Python 输出 | f62a65e67433bfdabd73f6030baa7f6d |
是否一致 | PASS |
这两组固定输出都依赖本次配套的 captures/init.properties,里面包含 cuid、signA、signB。换了一套缓存,T 可能变化,不能要求同一个输入还得到本文这组固定结果。这里验证的是本地签名计算与抓包、原始 so 结果一致。
这次完成的是“有效初始化缓存 → 恢复签名材料 → 计算 nativeGetSign”的纯算法链。服务端如何生成新的 signB、其他 native 方法如何实现,不在本次已验证范围内。完整 Python 版本也处理了 JNI Modified UTF-8 编码,但非 ASCII、NUL 和代理项尚未做真机对照,本文结果以实际测试的 ASCII/Base64 输入为准。
附:代码文件
完整的置换表有点长,就不在正文贴几百个数字了,放在 algorithm/des_tables.py 里面。
工程里几个主要文件如下:
sign.py                              纯算法入口
algorithm/kuaidui_sign.py            解码、DES 变体、缓存恢复、MD5 签名
algorithm/des_tables.py              从 so 提取的常量表
scripts/extract_native_tables.py     常量表提取脚本
scripts/verify_algorithm.py          原始 so 对照脚本
scripts/native-sign-article.js       补充 native hook 脚本
src/.../NativeAlgorithmProbe.java    本次实际使用的 Unidbg 观察代码
另外还整理了一份 scripts/native-sign-article.js,在前面基础 hook 的流程上增加了方法描述符、模块检查,以及两次 MD5 和字符串拼接的观察点,只在签名调用期间记录。默认打印长度,要看完整内容就把 SHOW_CONTENT 改成 true。
这份补充脚本也只做了语法检查,没有重新在手机上测试。上面纯算法的对照结果来自 Unidbg 执行原始 so,再与 Python 比较。
看雪ID:mb_rqgxdcwg
*本文为看雪论坛优秀文章,由 mb_rqgxdcwg原创,转载请注明来自看雪社区
球分享
球点赞
球在看
点击阅读原文查看更多
本文转载自微信公众号「看雪学院」,查看原文。版权归原作者所有,如有侵权请联系删除。