VLA/WAM已死,基模当立?Mind2Act World通用基准用「知行合一」角度为具身模型诊断进化方向
机器之心 2026-11-22 13:21 北京
知行合一

机器之心发布
VLA/WAM 已死,基模当立?
过去一个月,通用大模型以 Agent 的方式接连在机器人操作评测中拿到高分,端到端的 VLA 和 WAM 还要不要继续做,成了具身智能圈绕不开的话题。
这场争论里,双方手里的证据都是成功率。成功率能说明谁做成得更多,却说明不了没做成的部分差在哪里:一条路线是走到了头,还是只差一块补得上的短板,单看分数分不出来。
以一道烹饪题为例,机器人要按记住的配方依次下料,等锅温升到 80℃ 后在两秒内切到保温。世界动作模型 InternW0 和由 GPT-6 Astra 驱动的 Agent 都没有做成,但失败的方式很不一样:InternW0 的 300 个回合里,有 271 个是料还没下完就开了火;GPT-6 Astra 的 30 个回合里,有 21 个连食材罐都没抓起来。同样是没做成,前者缺的是对上一步的确认,后者卡在抓取,要补的东西完全不同。
把这样的差别找出来,正是 Mind2Act World 要做的事。这套通用机器人操作诊断基准由清华大学 mmlab@SIGS 联合远行光年公司等 16 家高校与机构发布,共 30 项任务、180 种配置。它把机器人的「想」和「做」先分开考、再合起来考,并为失败回合逐一找出原因,汇总成模型的诊断卡并给出能力提升方向。首批评测覆盖 9 个代表性系统、56,700 个仿真回合,榜单持续开放参评。
结果显示,表现最好的 Agent 在只考「想」(记忆与推理)的任务上成功率为 52.7%,在只考「做」(物理执行)的任务上为 39.0%,到了两者缺一不可的任务上只有 12.0%;端到端策略在这类任务上最高为 3.6%。
回到开头的问题:两条路线各有所长,端到端策略强在「做」,Agent 强在「想」,需要边想边做的任务都还没有拿下。比起哪条路线会赢,眼下更值得回答的或许是:每个模型究竟差在哪一步。
论文标题:Mind2Act World: A Diagnostic Benchmark for Embodied Mind, Physical Action, and Mind-Action Composition in Robotic Manipulation
Benchmark 代码:https://github.com/Mind2Act/Mind2Act_World
训练数据:https://huggingface.co/datasets/Mind2Act-World/mind2act-train
Mind2Act World 项目介绍视频
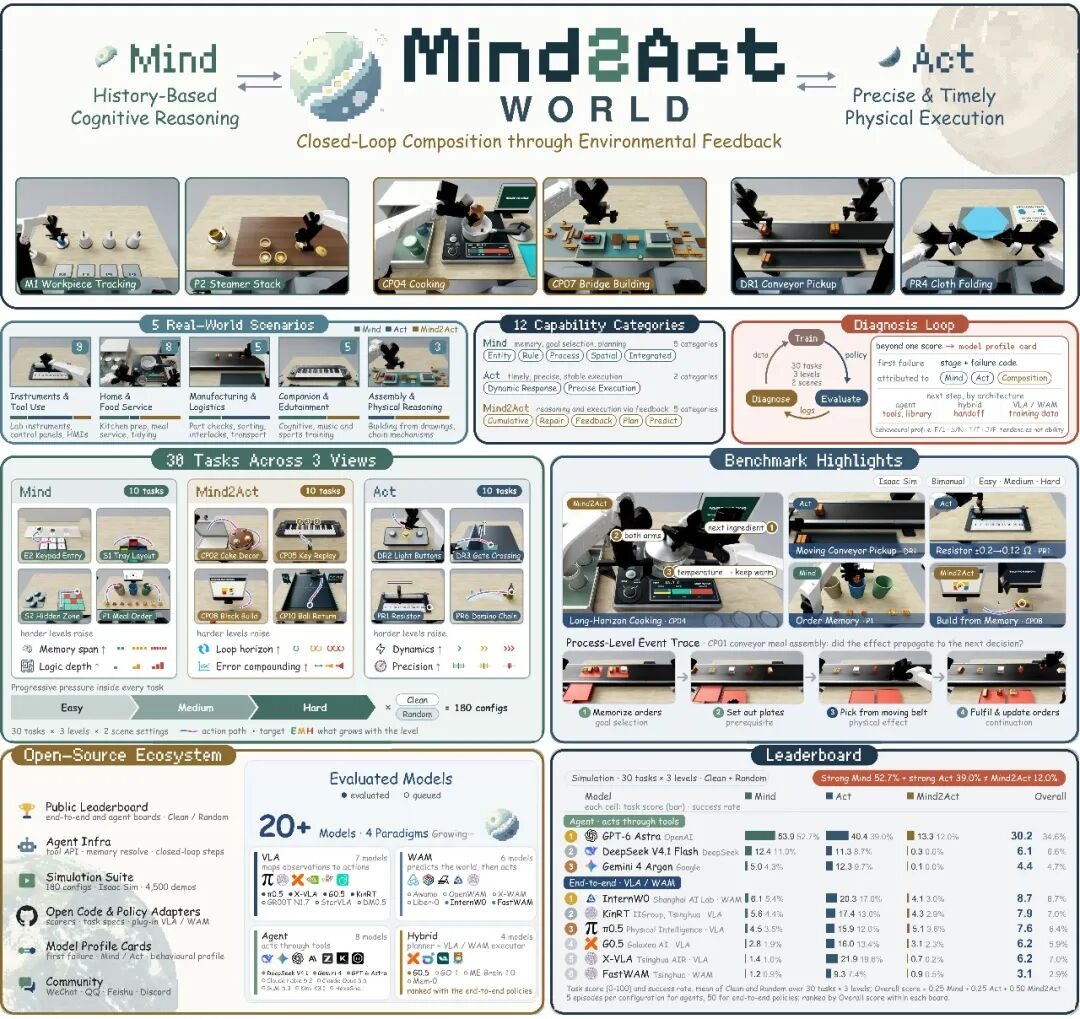
Mind2Act World 全景:30 个任务、12 类能力、诊断闭环与当前排行榜
同样是 0 分,原因各不相同,先给每一次失败找到原因
要回答「差在哪一步」,先得有一套给失败找原因的办法。
Mind2Act World 的评测器在判定成败之外,还记录每个回合的阶段进展和关键事件。规则能判定的失败先由规则判定,其余交给大模型裁判查看视频和动作记录,拿不准的再由人工复核。每个失败回合只追究第一个无法挽回的错误,看它是错在「想」、错在「做」,还是错在两者的「协同」,也就是没确认上一步的结果就往下走。
一个模型的所有失败回合汇总起来,就是它的诊断卡。报告为 InternW0、GPT-6 Astra 和 G0.5 三个代表性系统生成了实测诊断卡。
先把「想」和「做」分开考,再合起来考
要说清败在哪一步,任务本身得先把不同的能力分开。技术报告以王阳明论「知行合一」的一句话开篇:「知是行之始,行是知之成。」30 项任务也照此分为三组,每组 10 项:
Mind(想):动作尽量简单,考的是记忆与决策。比如蒸笼复原:逐层看过笼里的食物,再按原来的顺序叠回去。
Act(做):目标直接给出,考的是做得准不准、时机对不对。比如从运动的传送带上抓取物体。
Mind2Act(想与做协同):步骤环环相扣,记住的信息决定当前动作,动作的结果又决定下一步。
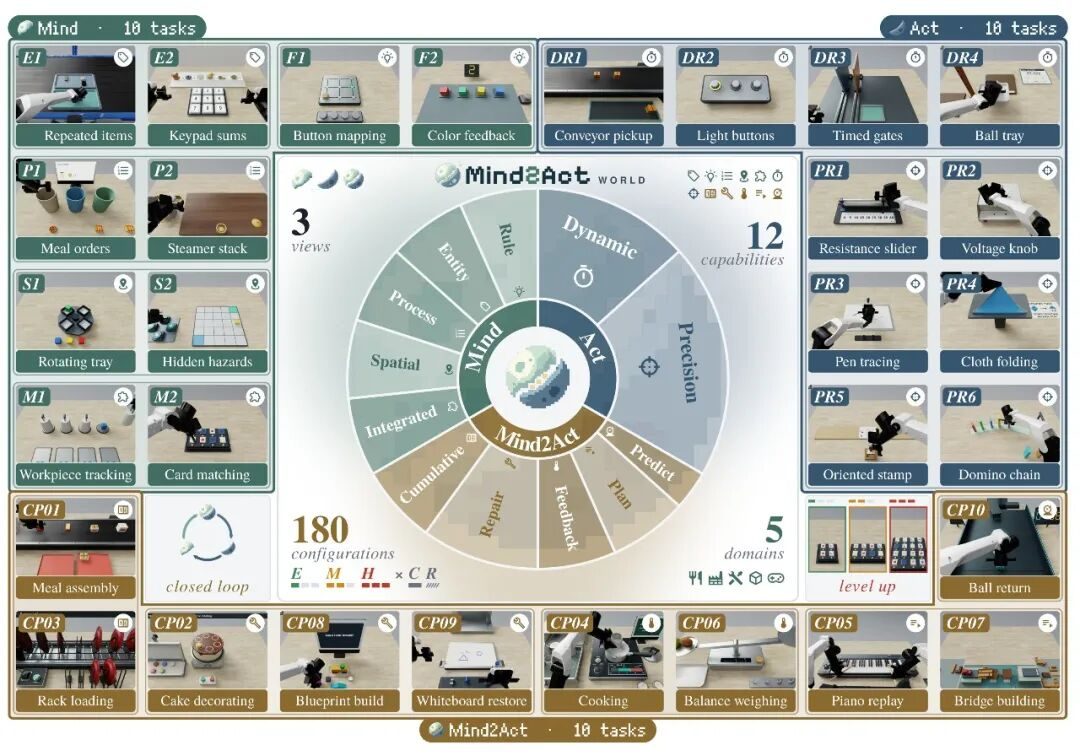
Mind2Act World 任务总览:三类任务各 10 项,覆盖 5 个应用领域、12 类能力
每项任务设 Easy、Medium、Hard 三档难度,各在干净场景和随机化场景(增加杂物、更换材质与光照)下测试。成败只看物理结果:物体是否放稳,按键是否真的按下。
想对一半,做对四成,合起来只剩 12%
参评的 9 个系统分为两类。3 个 Agent(GPT-6 Astra、DeepSeek-V4.1-Flash、Gemini-4-Argon)通过工具调用来操作机器人;4 个 VLA(KinRT、π0.5、G0.5、X-VLA)和 2 个 WAM(InternW0、FastWAM)用同一套 4,500 条演示微调。两类系统的动作接口和预算不同,分开排名。
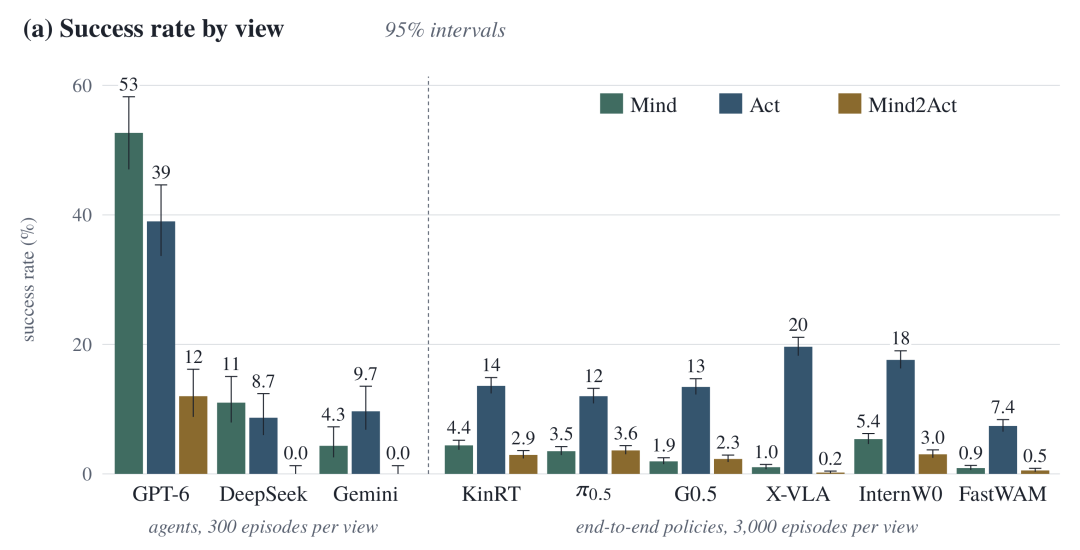
各系统在 Mind、Act 与 Mind2Act 任务上的成功率(%),Agent 与端到端策略分别排名
Agent 榜上,GPT-6 Astra 暂列第一:Mind 52.7%,Act 39.0%,Mind2Act 12.0%。端到端榜上,InternW0 以 8.68 的综合得分(满分 100)暂列第一。这类策略在 Act 上表现最好,4 个 VLA 的成功率在 12.0%–19.6% 之间;在 Mind 上均不超过 5.4%;Mind2Act 最高为 π0.5 的 3.6%。
逐任务来看,两类系统的长处恰好互补。
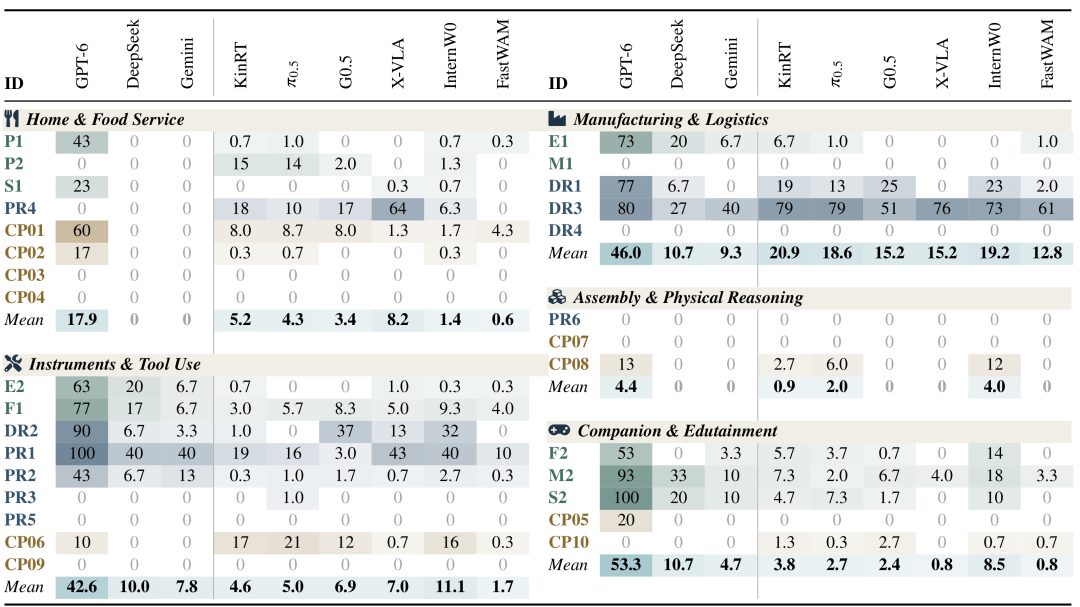
按应用领域分组的逐任务成功率(%)
GPT-6 Astra 强在「想」。在隐藏危险区导航任务上,它每个回合都成功,卡片配对的成功率为 93%;换一套桌面材质和光照,它的 Mind 成功率也只从 54.7% 变为 50.7%。但在需要边接触边修正的任务上,它还没有成功的记录,比如端托盘的 30 个回合,都在抬起托盘时失去了控制。
端到端策略强在「做」。在限时的闸门通行任务上,KinRT、π0.5 和 X-VLA 的成功率为 76%–79%,与 GPT-6 Astra 的 80% 相当;叠布料任务上,X-VLA 的成功率达到 64%。不过它们不容易记住任务状态:场景随机化之后,4 个 VLA 的 Act 成功数保住了 86%–94%,Mind 成功数只剩 28%–41%。模型记住的更像是场景「长什么样」,而不是场景里「有什么」。
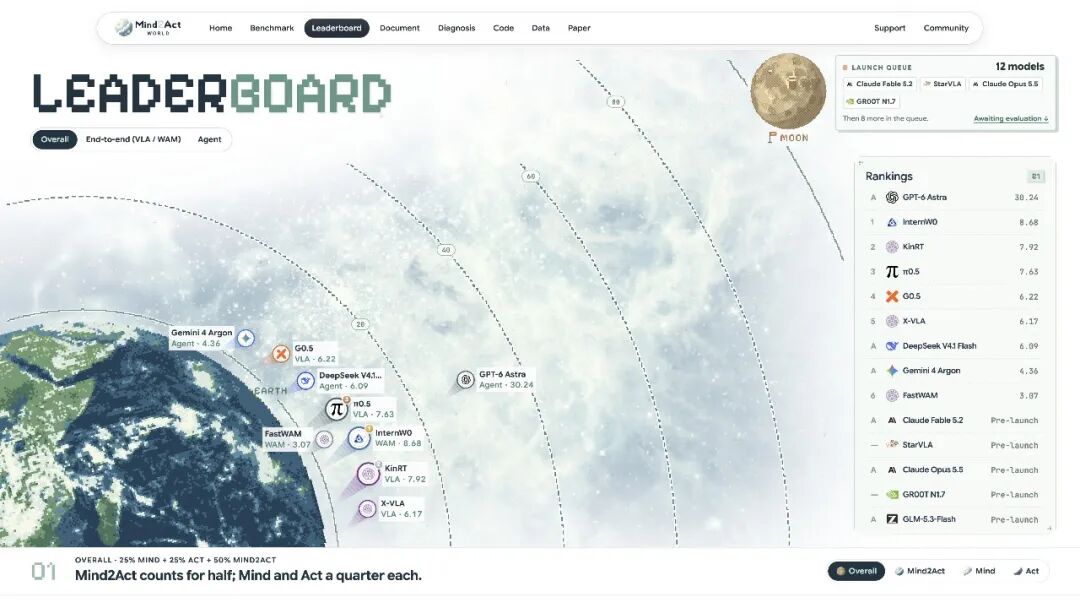
Mind2Act World 将排行榜可视化为一条「登月之路」,模型位置对应综合得分
流程大多断在前几步,还没轮到「协同」
Mind2Act 的低分,很容易被理解成「想」和「做」协同得不好。逐回合看下来,情况要具体得多。
多数回合在很早的阶段就中断了,依据来自任务得分。每项任务除了成败,还按做到哪个阶段给出 0–100 的得分,成功记 100 分。所有系统的 Mind2Act 得分最多只比成功率高出 1.5 分,也就是说,失败的回合几乎没拿到阶段分。在没有任何系统完成的 4 项 Mind2Act 任务上,各系统的平均得分最高只有 1.2 分;其中搭桥过车和白板复原,没有系统拿到第一个阶段分。
后文的三张诊断卡也给出了同样的信息:物理执行是占比最大的一类失败,首先出在「协同」环节的只占 6%–11%。由此得出结论:可靠的协同,首先要求每一项能力在流程的每一步都站得住。
难度曲线说的是同一件事。从 Easy 到 Hard,GPT-6 Astra 的 Mind 成功率从 64% 降到 44%,Act 从 44% 降到 34%,Mind2Act 则从 26% 降到 3%。Hard 难度为 Mind2Act 增加的是更多相互依赖的操作,任何一步出错,整条流程便无法完成。假如每一步的成功率都是 90%,连做十步全部成功的概率只有约 35%。
从一个分数,到一份改进清单
知道断在哪一步,才谈得上怎么改。先看三张诊断卡各自写了什么。

双臂配料与温控烹饪(CP04,Hard)的温控收尾选段,为脚本专家的仿真演示
InternW0:料没下完就开火。 在开头那道烹饪题里,问题不在于它不会这些动作,而是没有确认上一步的结果就进入了下一步。在它的 8,220 个失败回合中,这类「前置条件未满足就行动」的错误有 761 个。报告指出,训练用的演示只包含成功的步骤,模型没见过出错之后如何补救,补上这类示范是可行的方向。
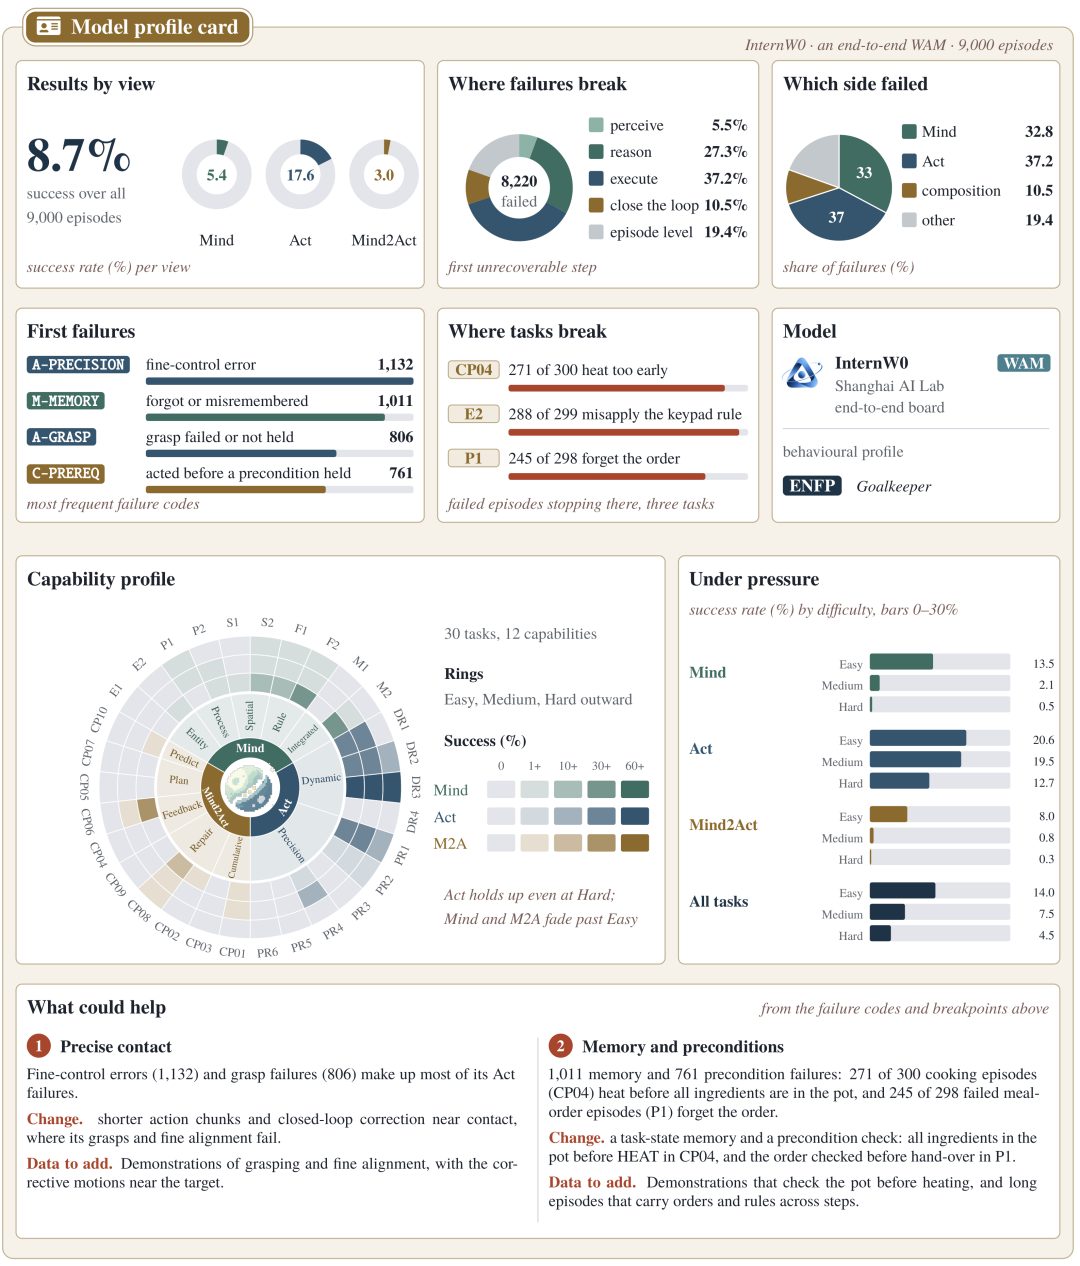
InternW0 的实测诊断卡,覆盖 8,220 个失败回合
GPT-6 Astra:罐子没抓起来。 它的 589 个失败回合中,55.3% 的首个错误出在物理执行上;有 459 个回合是它主动停下的,其中 264 个停下时决策预算还剩三分之一以上。常见的情形是运动规划器拒绝了它给出的位姿,它便不再尝试。比起增加预算,更细的运动工具和停止之前的重试对它更有帮助。
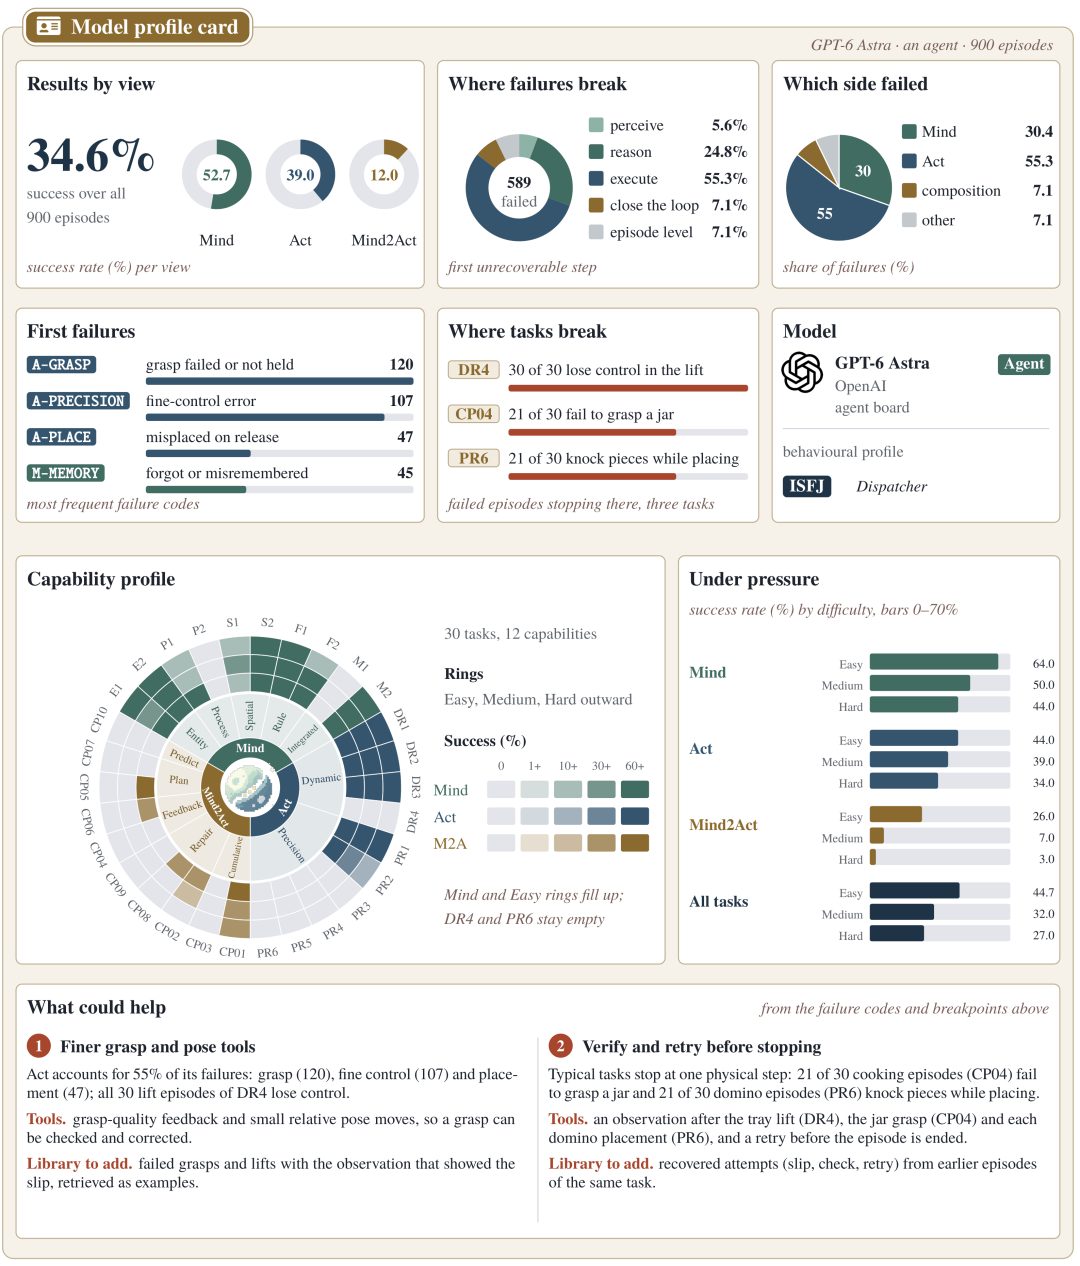
GPT-6 Astra 的实测诊断卡,覆盖 589 个失败回合
G0.5:卡在第一次抓取。它最常见的问题是抓取,有 1,324 个失败回合的首个错误是没抓住或没抓稳。在「搭桥过车」任务上,300 个回合有 202 个始终没能抓起一块积木。
断点还能说明数据该往哪里补。在「白板复原」任务上,G0.5 的 300 个回合有 299 个停在把白板从支架上取下之前。这时再补充完整的长演示,大部分数据会落在模型还走不到的后半程;从回合中断的状态出发采集演示,数据才用在它真正需要的地方。对采集成本很高的具身数据来说,这直接决定预算花在哪里。
诊断报告给出两个改进方向。端到端策略从数据入手:按断点补演示,并加入出错后补救的示范。Agent 从工具链入手:返回每一步的执行结果,先检查再继续,停止之前先重试。这些方向来自对失败记录的归纳,效果还有待后续实验检验。
诊断卡上还有一栏半开玩笑的「行为画像」,借用了 MBTI 的四个字母:InternW0 和 G0.5 是 ENFP,GPT-6 Astra 是 ISFJ。玩笑之外,三张卡指向三件实在的事:补状态检查,改运动工具,练抓取。由此,榜单上的一个分数就能拆成一份可以照着改的清单,这是名次之外更能直接用上的信息。
成绩之外的一笔账:时间与成本
以上成功率还有一个前提:模型推理时,仿真时钟是暂停的。
把这段时间算进来,两类系统的对比是另一番面貌。三个 Agent 平均每次调用需要 11.0–35.6 秒,端到端策略一次动作预测只需 77–488 毫秒。GPT-6 Astra 在 Act 任务上平均每次调用 9.2 秒,而 Hard 难度的「灯亮即按」任务留给机器人的时间窗口只有 2.6 秒。成本方面,GPT-6 Astra 平均每个回合的 API 费用为 25.13 美元。
这两笔账在成功率里看不到,却是机器人落地前一定会被问到的。
没有万能的模型,只有刚好合适、越改越好的模型
回到标题里的问题。比谁胜谁负更值得说的,是好的具身系统该往哪个方向走,团队认为:
专属化。 没有适合所有任务的模型,只有刚好适合当下任务的模型。要先记住再决定的步骤,Agent 更合适;一个练熟的动作就能覆盖的步骤,端到端策略更快也更省。即使同属 VLA,长处也不一样:G0.5 强在限时反应,X-VLA 强在电阻调节和叠布料。所以选模型要先看任务,这一步要的是记忆、精度还是速度,再去找在这一项上靠得住的那一个。
自进化。 好的系统要能把自己的失败变成下一轮的本事:哪一步断了、为什么断,变成要补的数据和要改的工具,再回到同一批题上复测。机器人离上岗有多远,取决于流程里最薄弱的那一步,而不是最漂亮的那一次成功。诊断卡里反复出现的断法,比如没确认就往下走、被拒绝一次就停下,正是最适合一轮一轮改掉的地方。
这也是清华大学 mmlab@SIGS 和远行光年接下来要一起做的事:把「诊断 — 改进 — 复测」的自进化闭环做成能直接用的基础设施。
欢迎参评,也欢迎共建和支持
带着模型来测。参评的模型拿到的不只是名次,还有「想」「做」「协同」三类任务的分项成绩、每个失败回合断在哪一步的记录,以及一张指出改进方向的诊断卡。欢迎机器人厂商、模型团队和研究机构带着 VLA、WAM、Agent 及混合系统参与评测和打榜。
一起把它做大,也欢迎更多支持与赞助。 评测代码、任务定义和评分器已在 GitHub 开源(MIT 协议)。欢迎研究者在新任务、新模型接入和诊断方法上与团队合作,也欢迎提交问题和改进。评测更多模型需要持续的算力和 API 投入,欢迎伙伴以 GPU 算力、API 额度等方式支持;赞助不改变任何分数和排名。目前,团队正与百度智能云共建评测基础设施,更多进展敬请期待。
评测接入与合作:Mind2ActCommittee@outlook.com
预告
接下来,团队计划沿三个方向继续推进:
Mind2Act Mini World:规模更小、完全开源,在本地就能完成训练与评测。
沙箱 Agent 评测:参与者可以带上自己的 Agent 框架,在隔离环境中接入,并单独设立排行榜。
扩展诊断与改进验证:诊断覆盖全部参评系统;模型修改后在同一批实例上复测,检验诊断建议是否有效。
排行榜会随新模型和新任务持续更新。
作者介绍
本研究由清华大学 mmlab@SIGS 联合远行光年(Velabot AI,velabot.ai)团队开展,合作者来自剑桥大学、牛津大学、斯坦福大学、卡内基梅隆大学、香港大学、香港科技大学、香港中文大学、北京大学、上海交通大学、复旦大学、中国人民大学、深圳大学,以及深朴智能和百度智能云。项目负责人为黄誉之、吴杰,通讯作者为迟程、姜婧妍、王智。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
本文转载自微信公众号「机器之心」,查看原文。版权归原作者所有,如有侵权请联系删除。