苹果新开源的Depth Pro 2火了:攻克单目深度锐利度与时序稳定性的双重矛盾
CV君 2026-11-22 12:23 江苏
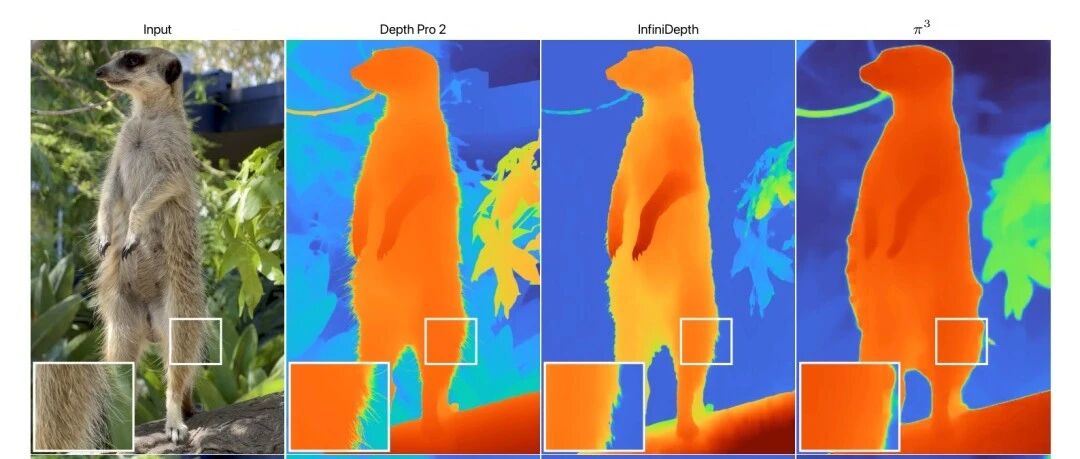
全分辨率单目深度估计
在计算机视觉领域,单目度量深度估计(Metric Monocular Depth Estimation)一直是三维重建、计算摄影以及空间智能等任务的核心基础。然而,现存算法长期受困于一个明显的二元对立:面向单张图像的方法虽然能保留纤细的发丝与物体轮廓,但在视频帧间处理时深度跳变剧烈、闪烁明显;而面向视频的多帧方法借助扩散先验或跨帧注意力增强了时序稳定性,却因计算成本过高被迫降采样处理,导致物体边界严重平滑。
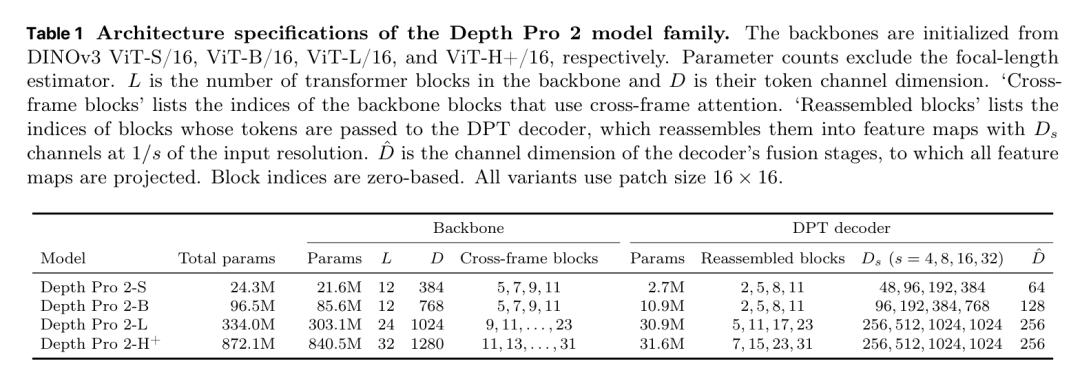
为了打破这种“单帧保锐利、多帧保稳定”的长期妥协,苹果研究团队推出了新一代单目度量深度估计框架 Depth Pro 2。该算法命名承袭自苹果此前的单目深度工作 Depth Pro,版本号“2”标志着其从“单图切块多尺度估计”向“全分辨率联合时序推理”的演进。Depth Pro 2 采用统一架构,无需切块即可在原生分辨率下联合处理单帧或多帧序列,在零样本度量深度准确率、边界锐利度以及跨帧时序稳定性上同步打破了现有的权衡边界。此外,该模型家族覆盖 24.3M 至 872.1M 参数量,配套 23.5M 的超轻量视场角(Field-of-View, FoV)估计器,在 NVIDIA B200 上进行 1080p 视频无缓冲流式推理时帧率可达 53 FPS。

背景与动机:锐利边界与时序稳定性的长期博弈
在视频人像背景虚化、新视角合成等实际应用中,深度图既需要对发丝、栏杆、动物毛发等微细结构有清晰的几何轮廓切分,又需要保证前后帧之间深度数值的一致性。
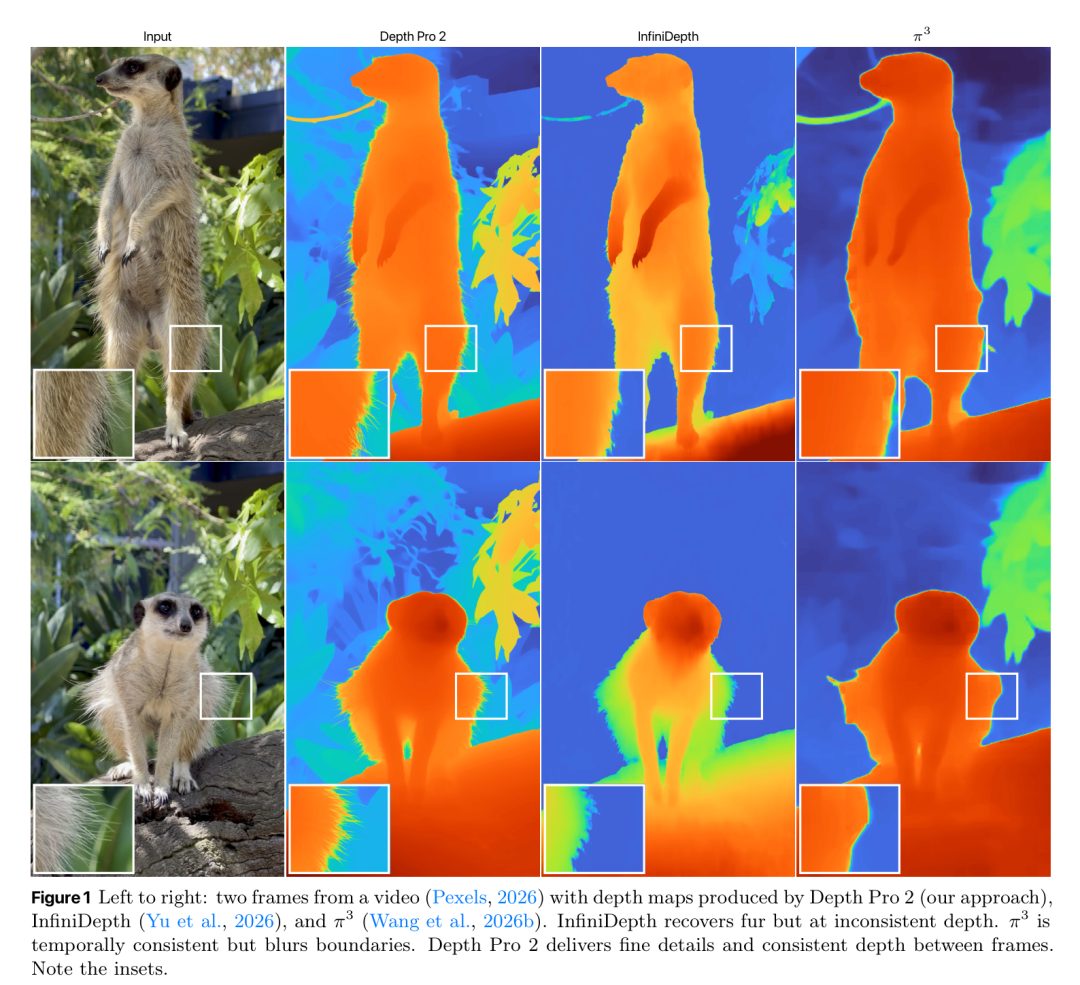
如上图所示,当处理一段猫鼬(Meerkat)视频时,单帧方法 InfiniDepth 能够捕捉毛发细节,但在相邻帧中将猫鼬推算到了截然不同的物理距离;多帧视频模型 虽能保持前后帧深度稳定,但较低的运算分辨率将毛发糊成一片。
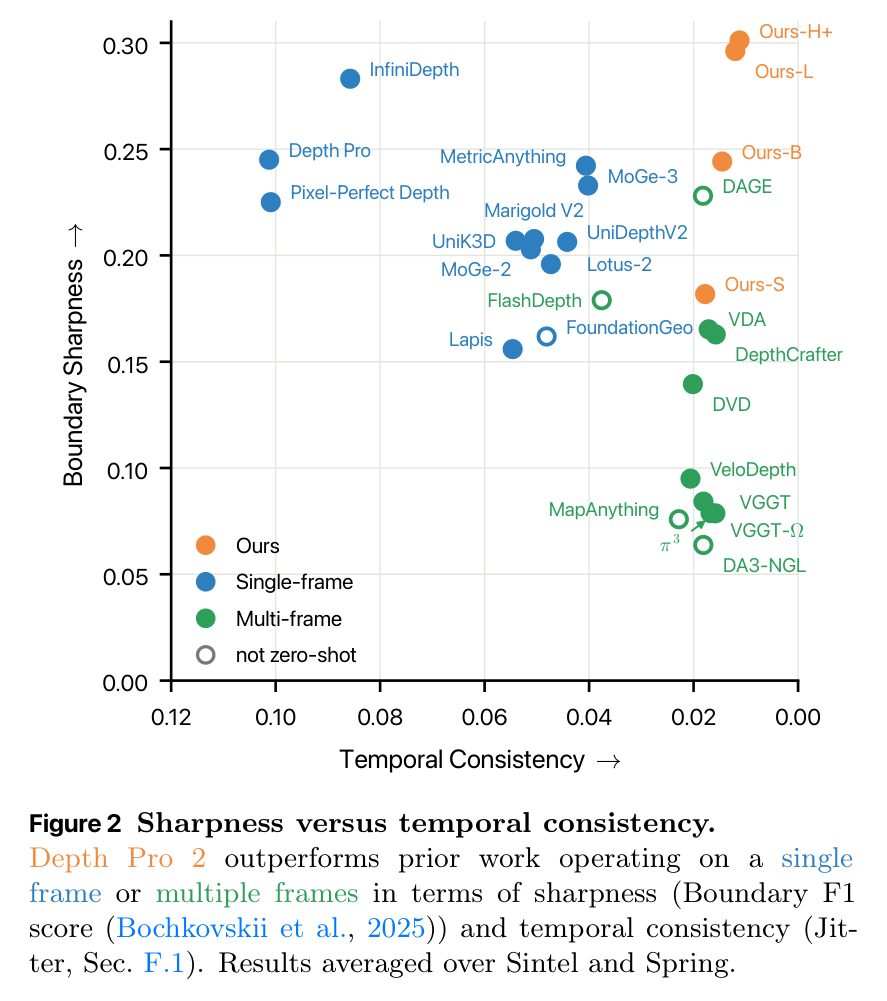
在 Sintel 与 Spring 数据集上的统计表明,现有方法呈现极强的聚类分化:单帧模型聚集在左上区域(锐利但抖动严重),多帧模型聚集在右下区域(稳定但过度平滑)。多帧模型倾向于利用长程时序注意力或扩散先验抑制闪烁,计算与显存开销剧增,只能牺牲分辨率;而单帧模型各帧孤立前向,缺乏关联。研究团队的目标便是构建一个无需重型扩散机制、能够以原生分辨率直接联合处理多帧的单阶网络。
方法详解:原生分辨率多视角 Transformer 与双流式推理
Depth Pro 2 的核心思想是在骨干网络中无缝融合帧内与跨帧信息,同时通过几何保真的位置编码与无重采样训练机制维持细节。
1. 多视角 Transformer 与等变架构设计
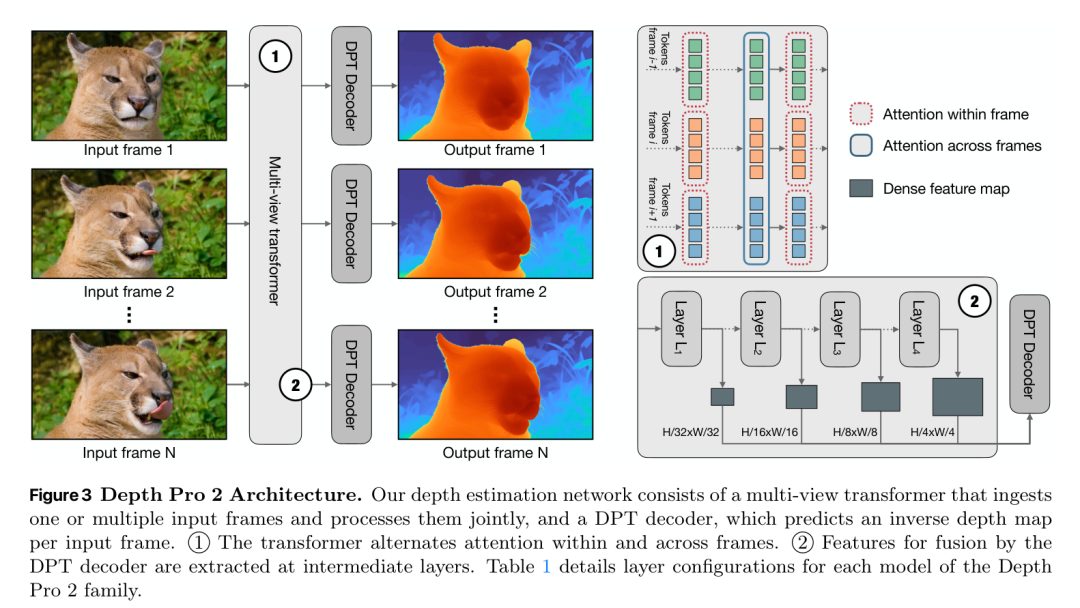
模型将单图或多帧视频作为输入,以切块大小 转化为图像 Token。骨干网络基于 DINOv3 预训练权重初始化:
- 长边归一化二维位置编码:为了保留不同图像的真实宽高比,空间位置编码使用二维旋转位置编码(2D RoPE)。与常规双轴各自归一化的方式不同,算法将横纵坐标统一除以较长边 :
分层交替注意力:深层网络中,前 的 Transformer Block 仅执行帧内自注意力(Intra-frame Self-attention),专注于底层局部特征抽取;后 的 Block 则交替执行帧内自注意力与跨帧注意力(Cross-frame Attention,图 3 标记 ①)。
时间置换等变性:网络内部不注入任何帧序编码(Frame Order Encoding),使模型对帧顺序具有置换等变性(Permutation Equivariance),单图与多图可共享同一套注意力权重,并无缝泛化至不同长度的输入序列。
2. DPT 解码器与轻量焦距估计
特征提取后,DPT(Dense Prediction Transformer)解码器从特定中间层抽取多尺度特征,重组为输入分辨率 、、、 的特征图,并投影到统一通道维度 。解码器阶段全面采用转置卷积(Transposed Convolutions)取代双线性插值,规避插值引起的边界模糊,最终输出归一化逆深度 。
为在缺失 EXIF 信息的野外图像中恢复绝对物理尺度(Metric Depth),研究团队训练了一个独立的轻量视场角估计器。该估计器基于 DINOv3 ViT-S/16,仅含 23.5M 参数,在 9200 万张 Flickr 图像上完成端到端微调。多帧输入时,网络取各帧估计焦距的中位数作为全局焦距。
3. 四项联合损失函数与动态掩码机制
模型在 19 个混合数据集(含合成与真实数据)上联合训练,每张 GPU 维护 73,728 个 Patch Token 的动态预算,总损失函数定义为:
度量对齐损失 :截断 损失,约束度量真值数据上的绝对尺度。
尺度位移不变损失 :消除几何全局漂移,适配非度量标注数据。
多尺度梯度损失 :在 3 层高斯金字塔上匹配深度梯度,专用于稠密合成真值,雕刻锐利轮廓。
- 多视角自监督一致性损失 :借助真值相机位姿将帧 的像素 反投影并重投影至帧 :为避免动态物体与遮挡区域破坏几何约束,算法预先利用真值深度对重投影误差进行校验,剔除深度偏差大于 2% 的动静态干扰像素,从而将静态背景的跨帧一致性无误传递给模型。
4. 任意长视频的两种推理模式
有缓冲流式(Buffered Streaming):将长视频切分为长度为 的 Clip,相邻 Clip 重叠 帧(推荐默认 ),重叠区间按帧位线性权重混合,平滑过渡。
无缓冲流式(Unbuffered Streaming):面向极低延迟推流需求,跨帧注意力采用因果掩码(Causal Mask),当前帧仅与自身及前序保留在 FIFO 缓存中的 帧(推荐默认 )交互,即来即解。
实验结果:多维基准刷新与落地效能
1. 零样本度量深度评估
在涵盖室内、室外及合成环境的 11 个单图测试集与 4 个视频测试集上,Depth Pro 2-H+ 展现出强劲的跨域泛化能力。
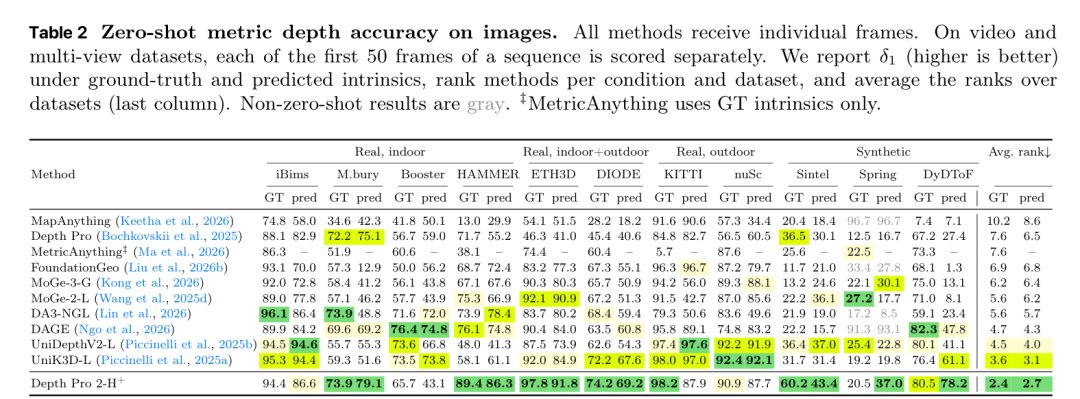
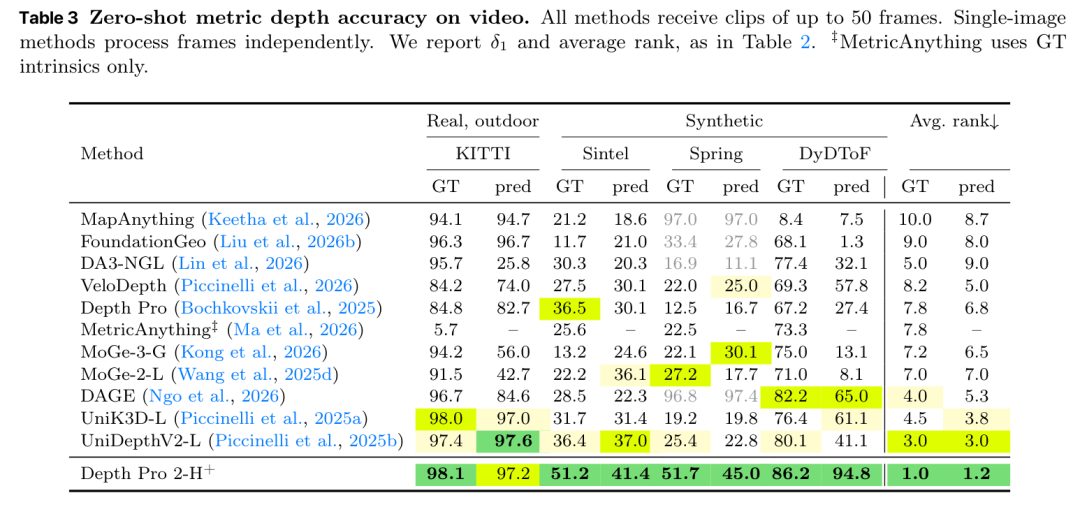
在单图度量深度评测中,无论使用真值内参(GT)还是自预测内参(pred),Depth Pro 2-H+ 的平均排名分别达 2.4 与 2.7,均位居基线榜首;在视频度量深度评测中,Depth Pro 2-H+ 在使用自预测内参下平均排名达到 1.2,全面刷新视频度量深度 SOTA,在 KITTI 数据集上 达 97.2%,在 DyDToF 上达 94.8%。
2. 边界锐利度与时序抖动测试
边缘质量采用基于梯度的 Boundary F1 指标衡量,时序稳定性采用沿光流跟踪轨迹的对数深度抖动指标(Jitter )评估:
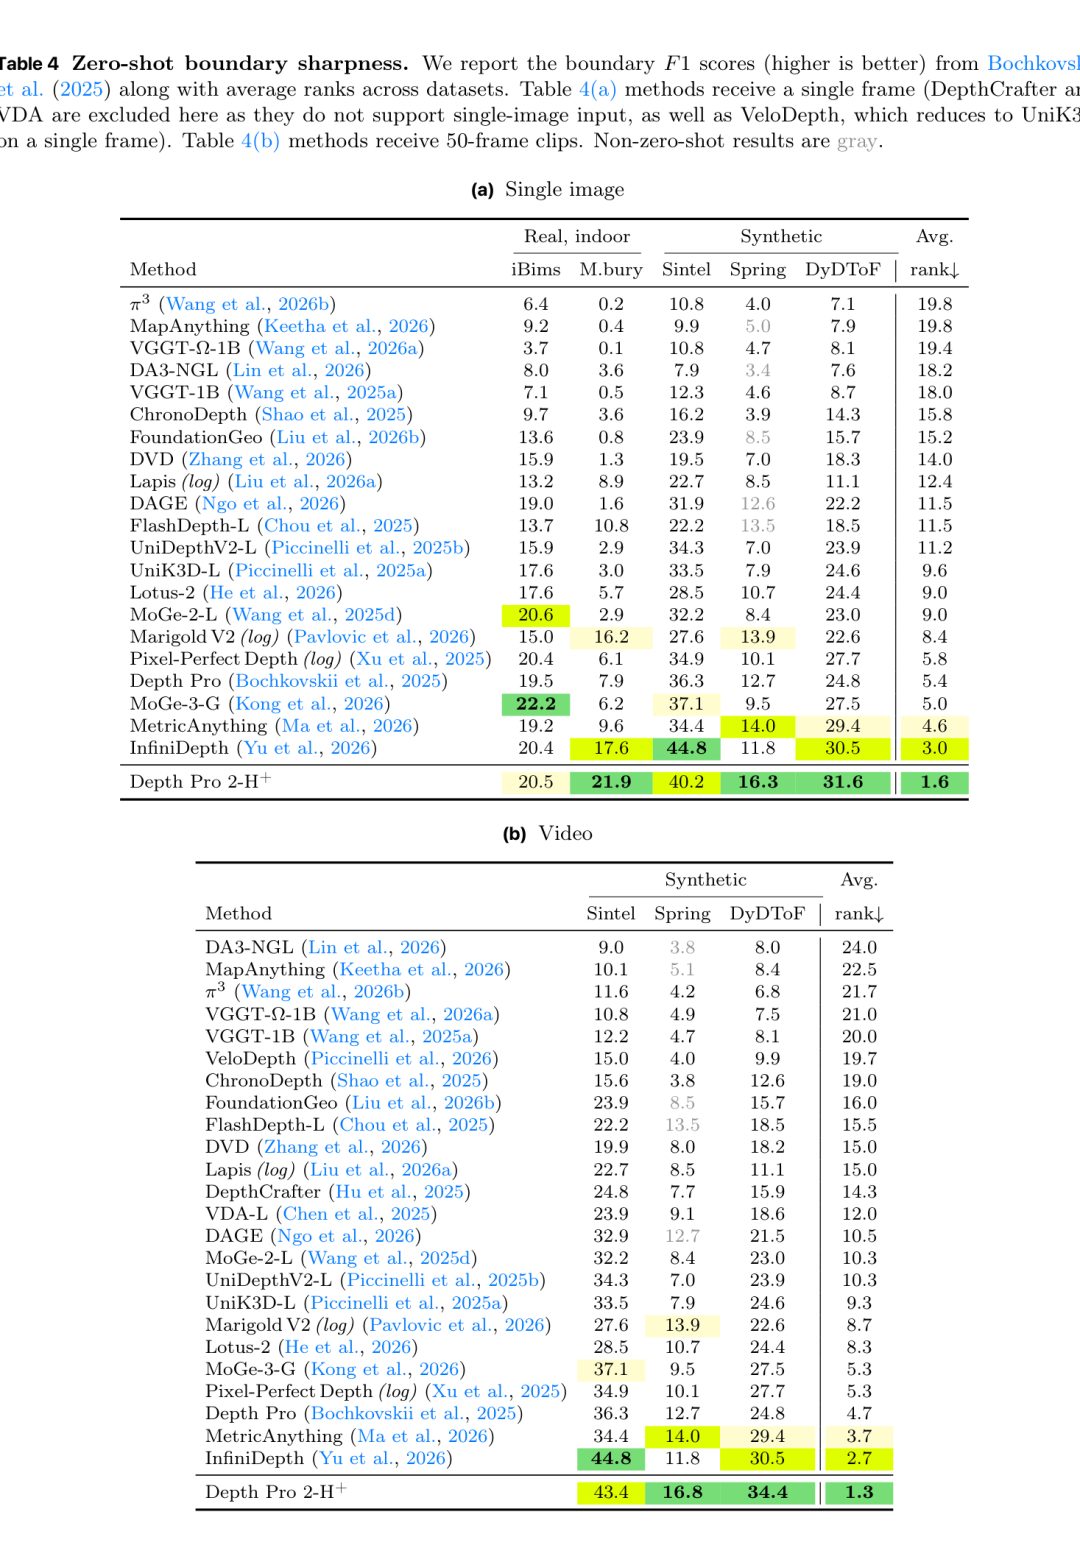
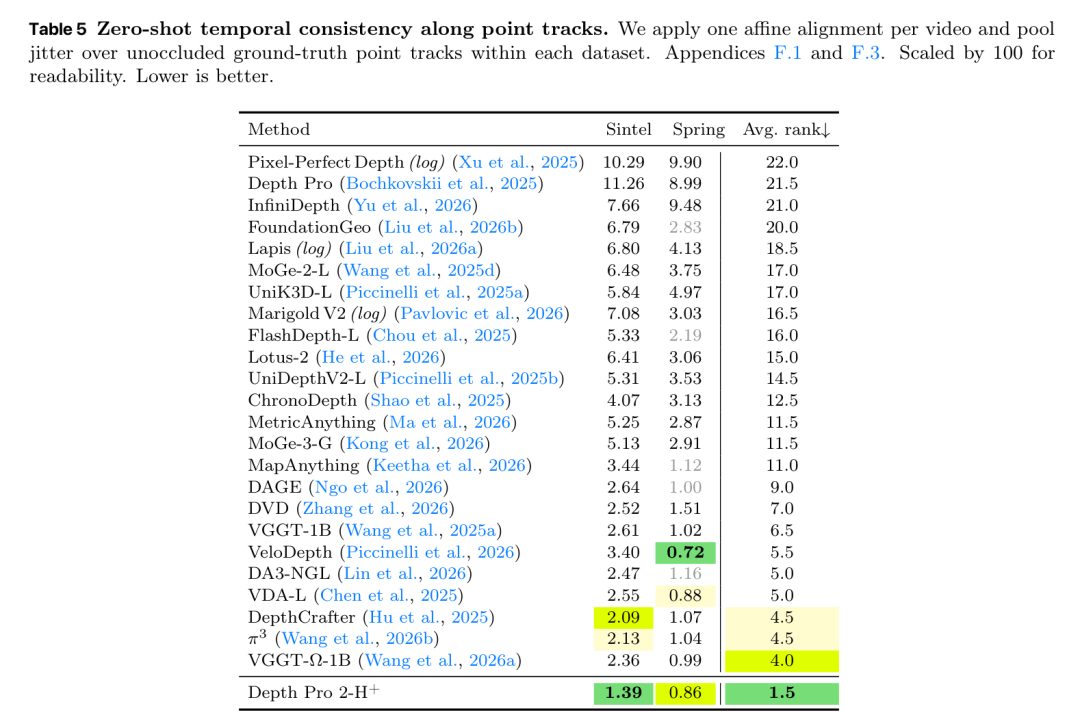
在视频边界锐利度测试中,Depth Pro 2-H+ 取得 1.3 的平均排名第一,显著超越此前锐度突出的 InfiniDepth(排名 2.7)及初代 Depth Pro(排名 4.7)。在时序抖动测试中,Depth Pro 2-H+ 在 Sintel 与 Spring 上仅取得 1.39 与 0.86,大幅低于常规单图方法的 7~11,同时优于多帧视频模型 DepthCrafter(2.09 / 1.07)与 (2.13 / 1.04)。
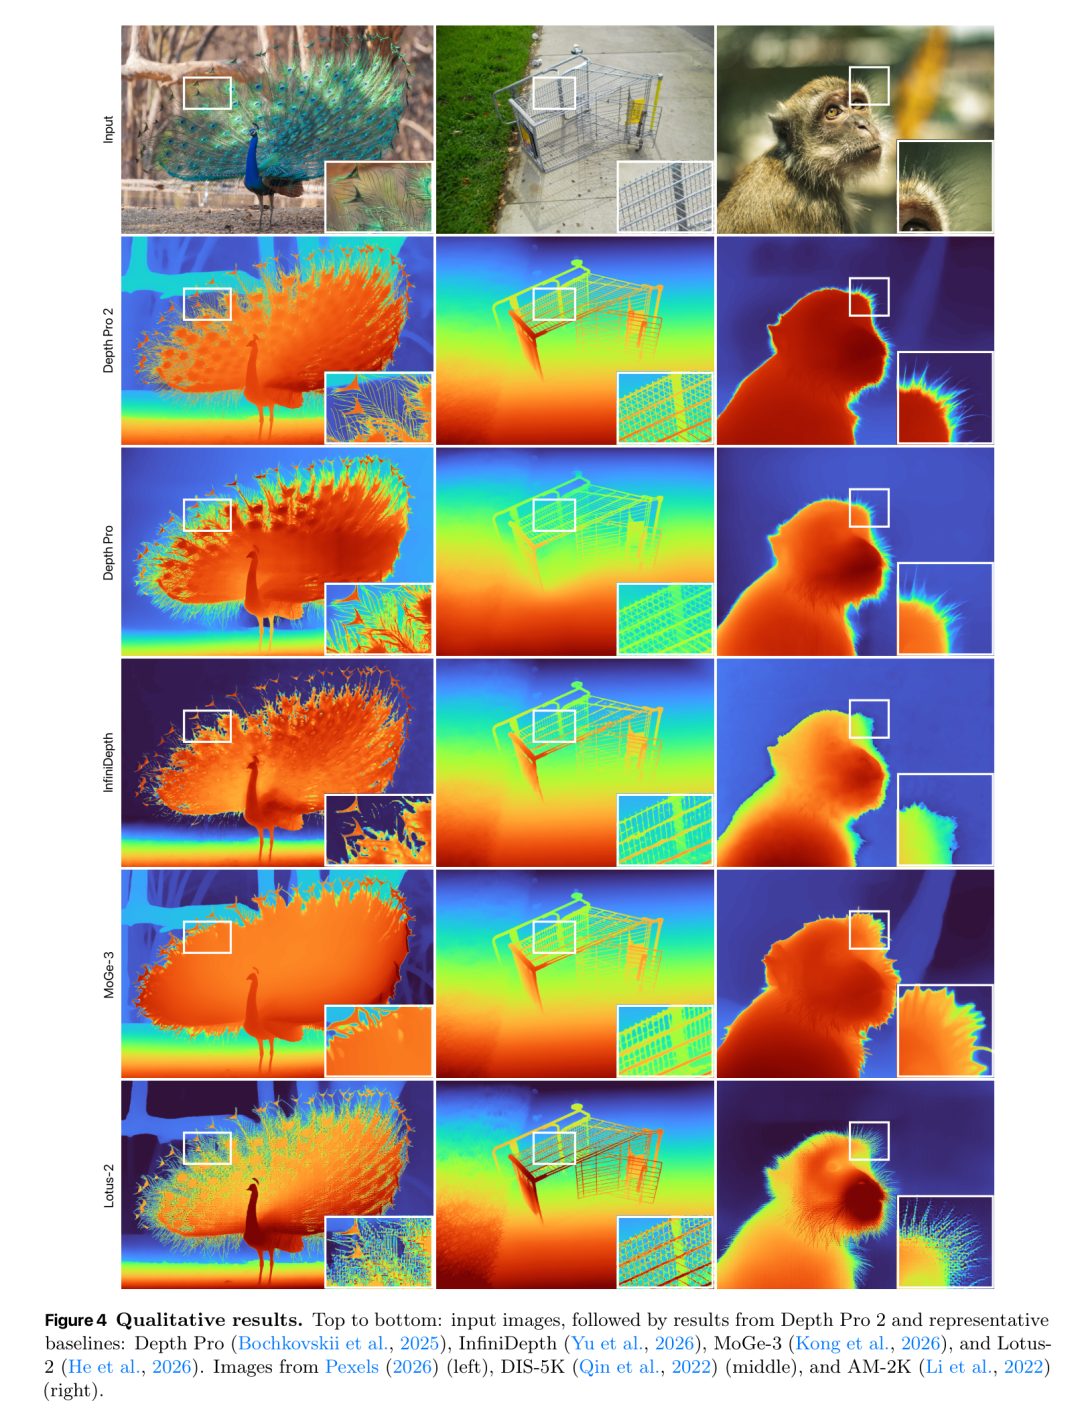
定性对比显示,面对细小树枝、复杂栏杆以及人像边缘,Depth Pro 2 生成的深度图轮廓整洁,无多尺度分块拼接带来的接缝伪影。
3. 下游任务表现:虚化与新视角合成
在基于真实光圈虚化的 RealBokeh 基准测试中,将各模型预测的深度直接送入固定的 BokehMe 渲染器。Depth Pro 2-H+ 在 220 个测试场景中取得了 23.95 dB 的 PSNR 以及 0.476 的边界感知误差(Boundary LPIPS),明显优于对比方案。
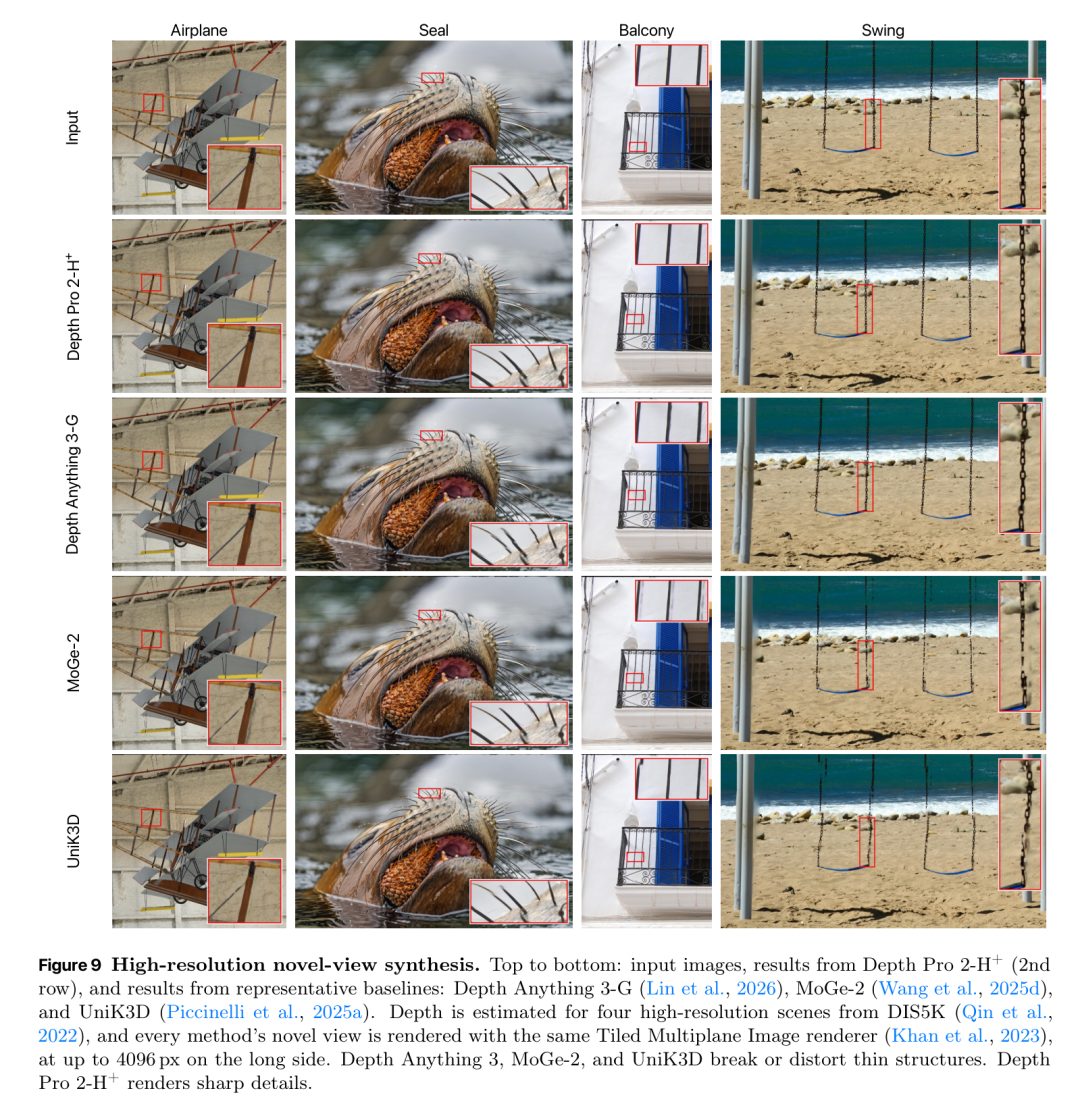
在单图高分辨率新视角合成测试中,当图像长边扩展至 4096 像素时,Depth Pro 2 生成的深度保持了飞机支架、动物胡须等微细结构的连贯性,避免了基线模型常见的结构撕裂与断裂现象。
4. 推理速度与显存开销
在单张 NVIDIA B200 GPU 上的基准测试表明:
Depth Pro 2-S(总参数量 48M):在 1080p 输入下批量处理吞吐达 44.8 FPS,显存占用 8.0 GiB;在无缓冲流式状态下,1080p 帧率可稳定在 53 FPS,具备极佳的实时处理潜力。
Depth Pro 2-H+(总参数量 896M):720p 视频推理吞吐为 20.2 FPS(显存 16.3 GiB),1080p 为 5.3 FPS。
独立 FoV 估计器:在 1080p 分辨率下单帧推断仅耗时数毫秒,运行帧率达 118 FPS,在 DDDP、FiveK 等 6 个真实基准上的平均 达到 88.6%,大幅领先传统几何标定方法。
写在最后
Depth Pro 2 证明了单目深度估计并不必然需要在“边缘锐度”与“时序稳定性”之间做单向抉择。通过原生分辨率单次前向传导、精简的帧间注意力交替机制与动态重投影一致性约束,纯视觉 Transformer 同样可以产出边界分明且时序平稳的高质量物理深度。随着代码与权重的全面开放,这套包含从端侧轻量级到云端高精度的完整模型谱系,将为实时视频虚化、机器人空间感知与三维内容生成提供更具实用价值的几何基座。
论文标题: Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth
机构: 苹果
代码仓库: https://github.com/apple-aiml-research/ml-depth-pro-2
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。