谛听 | FIGAN:面向工业协议格式推理的多样性流量生成
谛听网络安全团队 2026-10-03 09:00 辽宁
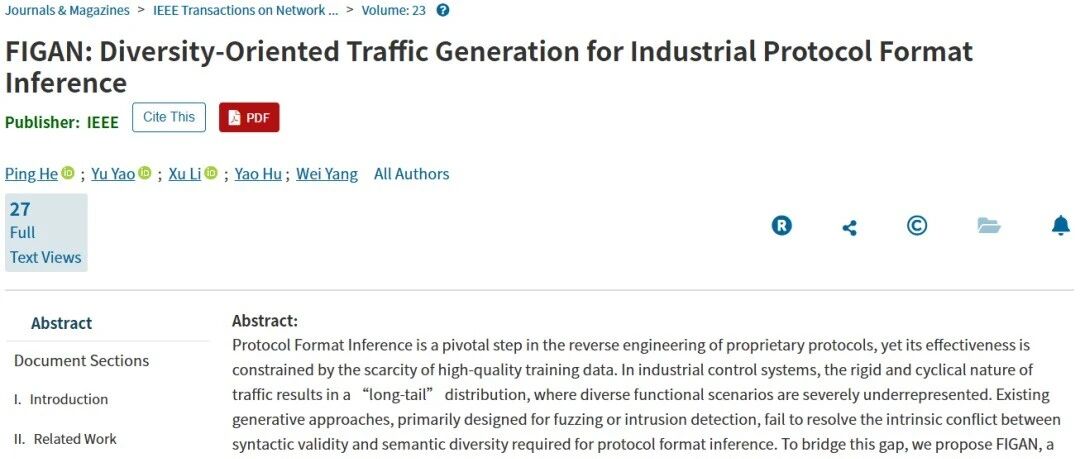
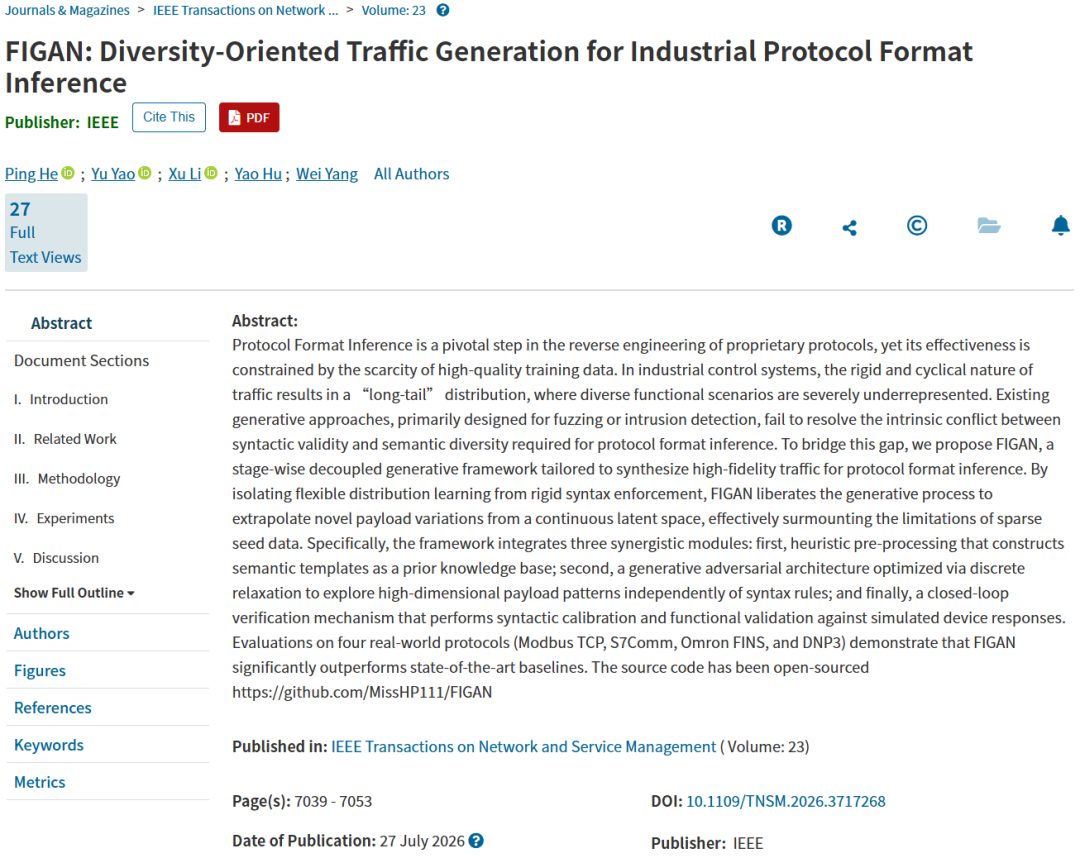
近日,“谛听”团队何萍博士撰写的论文《FIGAN: Diversity-Oriented Traffic Generation for Industrial Protocol Format Inference》发表于国际期刊《IEEE Transactions on Network and Service Management》。(点击文后“阅读原文”可获取论文)
协议格式推断(PFI)是工业控制系统私有协议逆向的第一步,却长期受制于高质量训练数据稀缺。针对工业流量“长尾分布”下有效性与多样性难以兼得的难题,本文提出分阶段解耦框架 FIGAN:以启发式预处理、生成对抗网络与闭环验证三阶段协同,在潜空间外推载荷变体,兼顾语法合规与语义多样。在 Modbus TCP、S7Comm、Omron FINS、DNP3 四个协议上的实验表明,FIGAN 优于现有基线,代码已开源。
《IEEE Transactions on Network and Service Management》是IEEE Communications Society主办的网络与服务管理领域国际期刊,关注网络、系统、服务与安全管理等方向的理论、方法和应用研究。
影响因子:5.3
文章引用方式:
P. He, Y. Yao, X. Li, Y. Hu, and W. Yang, “FIGAN: Diversity-Oriented Traffic Generation for Industrial Protocol Format Inference,” IEEE Transactions on Network and Service Management, 2026, doi: 10.1109/TNSM.2026.3717268.
论文内容介绍
1 研究背景
随着工业控制系统(ICS)与 IP 网络深度融合,深度包检测、入侵检测与模糊测试是保障工业网络安全的关键手段,其有效性建立在完整理解协议规范之上。然而出于商业机密,大量厂商并不公开专有协议规范,协议逆向工程成为必然,协议格式推断(PFI)正是决定后续分析精度与深度的第一步。ICS 以刚性调度保障物理稳定,流量呈现高度确定性与周期性:功能码覆盖不足、动态字段分布稀疏,形成典型“长尾”分布。这种语义多样性的匮乏对依赖统计变异识别字段边界的 PFI 算法是致命的——当会话多样性不足时,事务标识符等多字节字段的高位字节几乎不变,推断工具便误把完整字段切成静态与动态碎片。现有方案中,静态分析、二进制执行追踪等依赖固件或文档的“白盒”手段,对专有 ICS 协议难以落地;而面向模糊测试或入侵检测优化的生成模型,目标与 PFI 所需的“既语法合法又语义多样”相去甚远。在统一框架内调和语法合规与语义多样性,仍是待填补的空白。
2 主要贡献
1、提出分阶段解耦生成框架 FIGAN(Format Inference Generative Adversarial Network):把灵活分布学习与刚性语法约束相分离,从根源化解“语法有效性与语义多样性”的内在冲突,为工业流量增强提供新范式。
2、引入潜空间外推机制:基于生成对抗架构与离散松弛(Gumbel-Softmax),在连续潜空间中合成高熵载荷变体,突破稀疏种子数据的多样性上限,有效缓解 ICS 数据稀缺。
3、构建协议感知的验证流水线:以启发式预处理提取的语义模板为先验,完成精确语法校准与功能一致性校验,确保外推流量严格符合协议规范。
4、定义字节级多样性指标 DGB:量化合成流量质量;在四个真实工业协议上系统评估,FIGAN 全面优于现有基线,并在数据受限场景下有效促进下游 PFI。
3 方法介绍(整体框架)
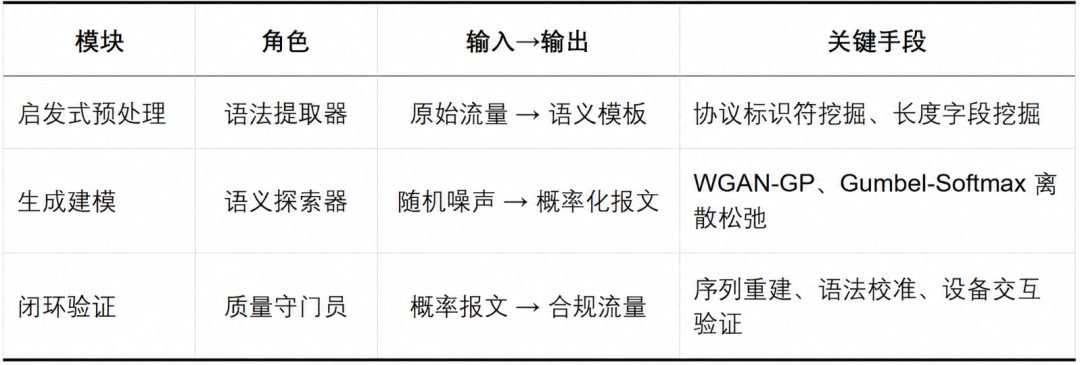
FIGAN 的核心设计理念是“责任解耦”:不强迫单一生成器同时建模可靠规律与灵活变化,而是把“规律保持—变化探索—反馈过滤”拆解为三个阶段协同完成(图 1、表 1)。
阶段一:启发式预处理(语法提取器):从原始流量中挖掘结构不变量。以滑窗加频次分析(P(v|i) ≥ 0.95)定位协议标识符等静态字节;以“长度聚类—候选字段提取—差分相关分析(PCC > 0.95)—线性一致性验证”挖掘长度字段(L_phy = V + O),最终凝练为语义模板,作为后续校准的“地面真值”。
阶段二:生成建模(语义探索器):采用半字节(nibble)分词,把 256 值字节空间压缩为 17 符号词表,定长对齐(L = 256)后做 one-hot 编码;以 WGAN-GP 对抗架构学习载荷语义分布——生成器采用“全局投影 + 局部精化”结构,判别器采用“局部提取 + 全局打分”结构,并通过 Gumbel-Softmax 离散松弛实现可微采样。
阶段三:闭环验证(质量守门员):把概率输出重建为二进制报文,用语义模板覆盖静态字段并做长度对齐校准;随后将报文重放至目标设备或高保真模拟器,仅保留能获得有效响应的样本——相当于“物理拒绝采样”,把生成分布对齐到设备可接受的协议状态空间。
表 1 三个模块的职责分工
FIGAN 整体框架是启发式预处理负责挖掘刚性约束,生成建模负责学习语义分布,语义模板作为校准桥梁,闭环验证负责结构与功能合规。
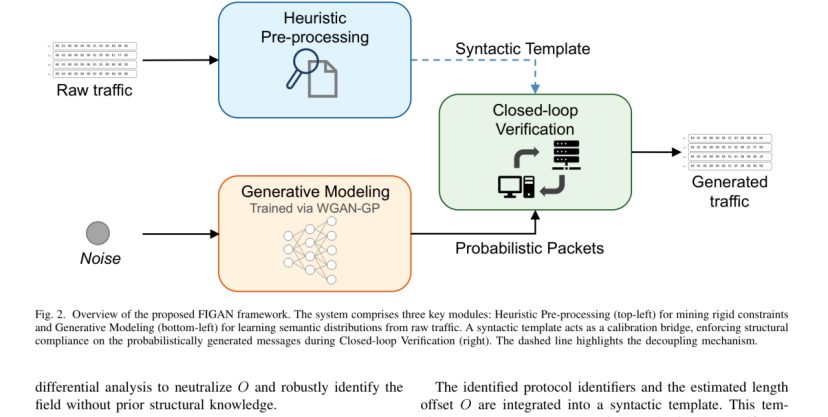
图 1 FIGAN 整体框架:三阶段解耦协同
4 实验评估
4.1. 实验设置
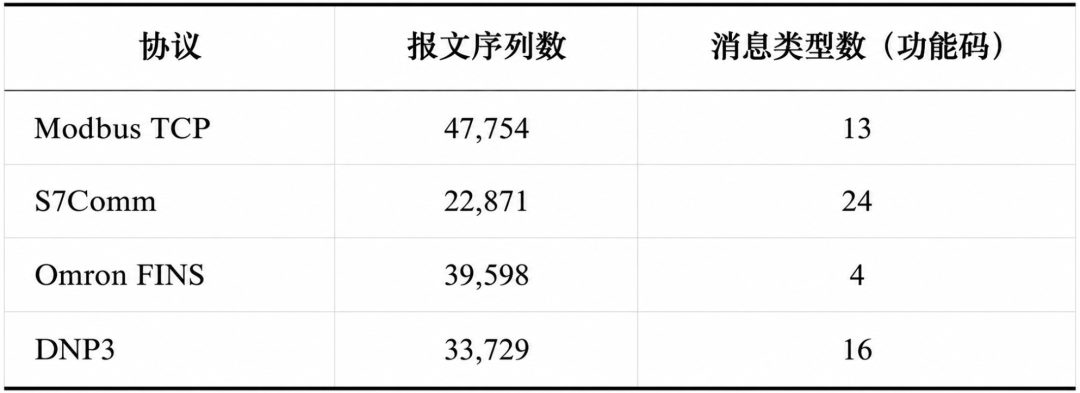
数据集见下表,基于开源流量档案构建四个真实 ICS 协议数据集,并以功能码定义消息类型,覆盖 4 至 24 类功能码。
表 2 数据集统计
基线:GANFuzz、Li-WGAN、WGGFuzz(对抗 / VAE 范式)、NetDiffusion、TabDDPM(扩散范式)、GReaT(Transformer 范式)。
指标:TIAR(有效接受率,度量有效性)、DGD(功能码覆盖率,度量语义覆盖)、DGB(本文提出的字节级多样性指标)。
4.2 主结果
如表 3 与图 2 所示,FIGAN 在四个协议上的 DGD(75.0%–87.5%)与 DGB(75.2%–88.3%)全面领先,TIAR 保持竞争力(51.3%–88.4%)。
横向对比发现 GReaT 的 TIAR 最高(超 96%),但呈“模式寻找”行为——如图 3 所示,其长尾低频功能码生成概率急剧衰减;NetDiffusion 接受率较高但生成高度保守,逐包偏离度集中在低值,难以提供 PFI 所需的统计变异性;GANFuzz 等传统对抗基线在复杂协议上接受率大幅下滑(S7Comm 仅 29.6%)。
表 3 主结果对比(%,加粗为该指标最优值)
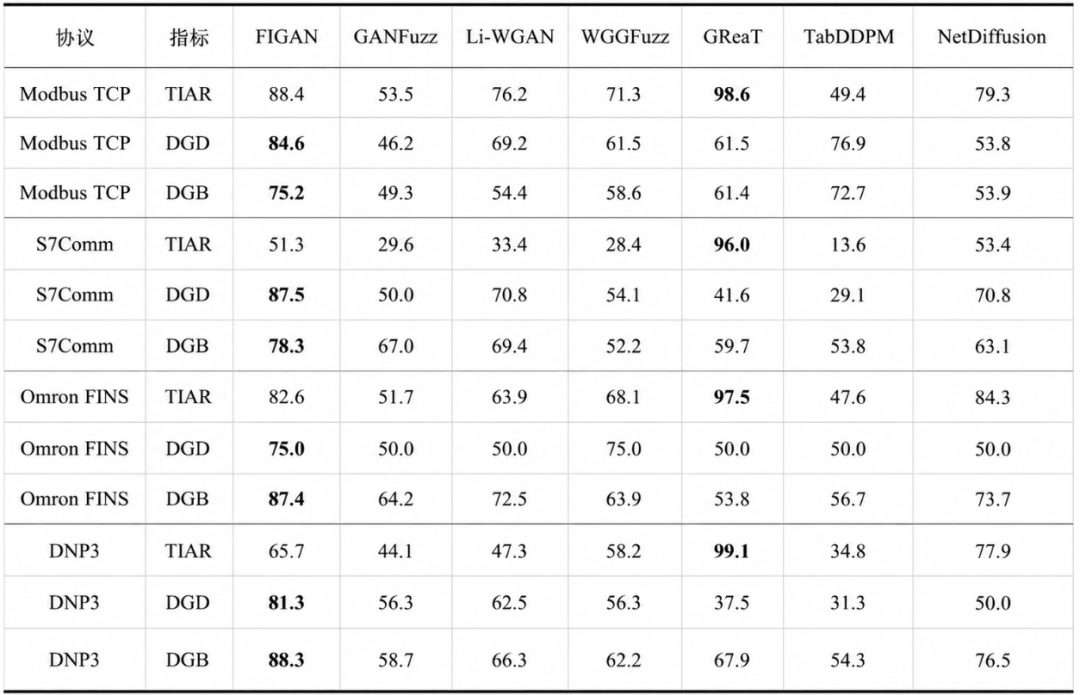
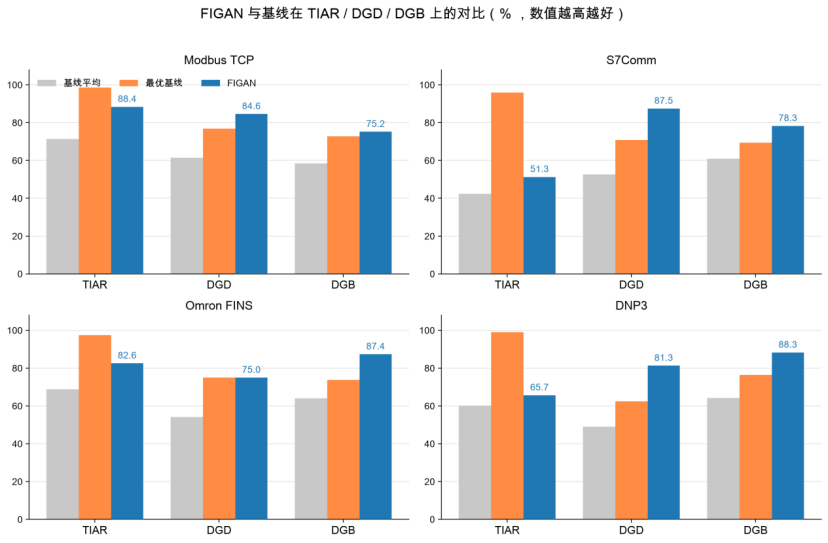
图 2 FIGAN 与基线在 TIAR / DGD / DGB 上的对比:多数场景下 FIGAN 优于最优基线,全部场景优于基线平均。
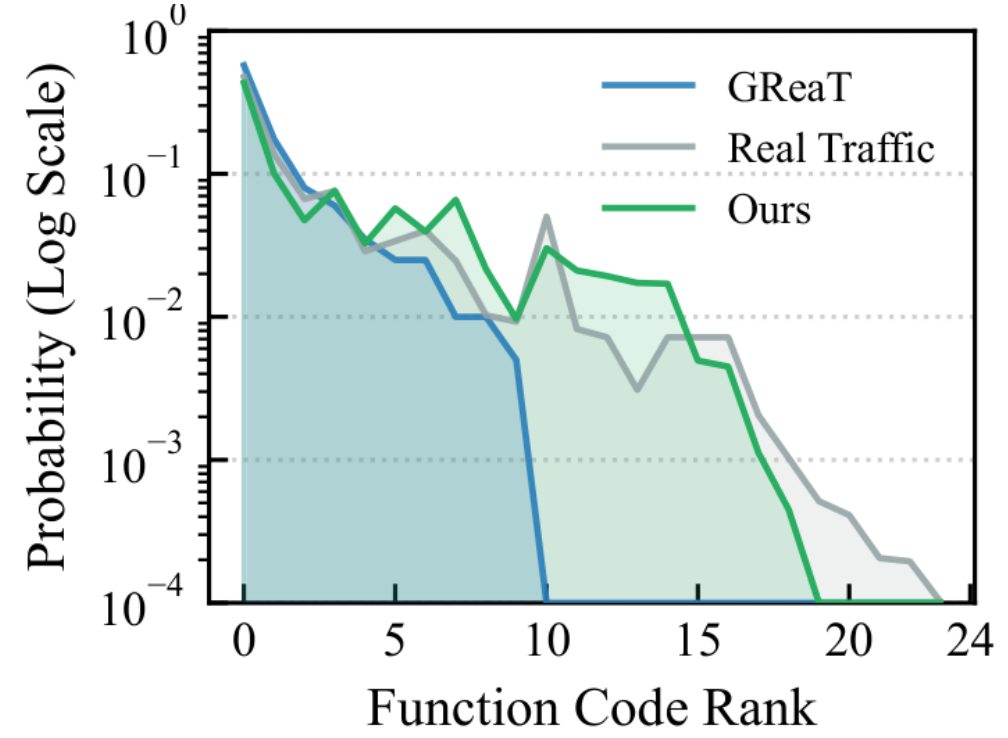
图 3 S7Comm 功能码分布:FIGAN 有效捕捉长尾低频功能码,GReaT 则严重受限。
4.3 分析与验证
公平性分析:为 GANFuzz、Li-WGAN 加上相同的启发式预处理后,其 TIAR 明显提升,但 DGD 在四个协议上均无变化、DGB 仅微增——启发式模块保障一致性,多样性上限仍取决于生成器本身,印证“责任解耦”的必要性。
训练稳定性:训练过程中 GANFuzz 急剧坍缩、Li-WGAN 的 DGD 退化至约 70%,FIGAN 全程维持高多样性;学习率取 1e-5 时收敛平滑(50 轮后 TIAR 超 80%),1e-4 则在 30 轮后出现震荡。
消融实验(图 4):移除启发式预处理后 TIAR 全面下降——Omron FINS +8.9%、DNP3 +8.8%、Modbus +6.1%、S7Comm +2.4%,证明“语法对齐”与“多样性探索”互补而非互斥。
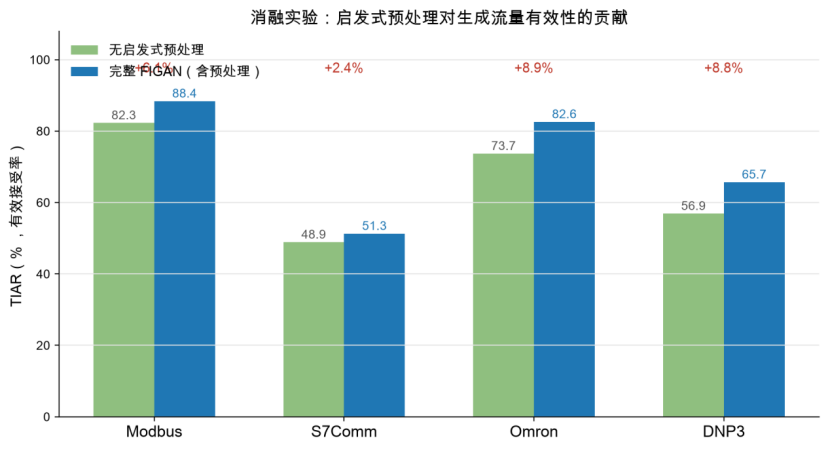
图 4 消融实验:启发式预处理在各协议上带来 2.4%–8.9% 的有效性提升。
下游效用(图 5):在冷启动数据受限场景下,用 FIGAN 生成数据增强(Aug)后,对齐类工具 Netzob 与神经网络类工具 DL-ProS² 在全部 4 个协议上的边界推断 F1 均提升——Netzob 的 S7Comm F1 由 0.316 升至 0.571,DL-ProS² 的 Modbus F1 由 0.800 升至 0.923。FIGAN 分别缓解了对齐方法的“欠切分”与神经方法的“过切分”两类错误。
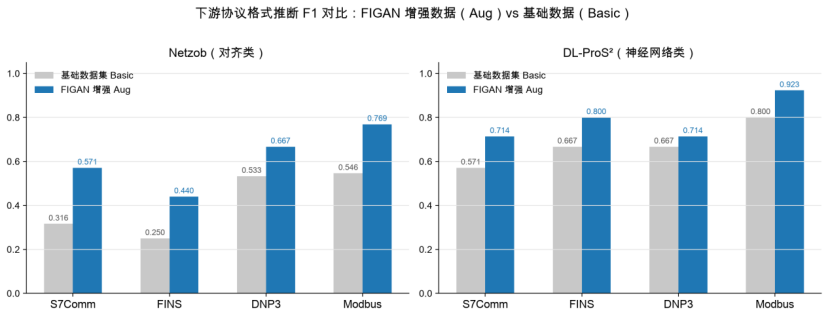
图 5 下游协议格式推断 F1:FIGAN 增强数据在两类推理范式、四个协议上全部提升
5. 总结
本文提出 FIGAN,一种分阶段解耦的工业协议流量生成框架,用以化解流量合成中“语法有效”与“语义多样”的内在冲突。通过将潜空间分布学习与刚性语法约束相分离,FIGAN 得以在连续潜空间外推新颖载荷变体,绕开稀疏且高度确定性种子数据的限制;闭环验证流水线则以语法校准与功能校验保障协议合规。在四个真实工业协议上的系统评估表明,FIGAN 在生成质量与下游协议格式推断两方面均一致优于代表性基线。通过自动化合成高保真、多样化的流量,FIGAN 为协议推断与逆向工程建立了可靠的数据基础。
6. 工业应用价值
工控安全分析:为深度包检测(DPI)与入侵检测系统(IDS)提供覆盖低频功能码与动态字段的高质量流量,缓解检测盲区,提升安全工具在真实工业环境中的泛化能力。
协议逆向工程:在无固件、无文档、无二进制分析的黑盒场景下即可产出高保真样本,支撑私有协议格式还原,显著降低安全研究门槛。
合规与互操作测试:生成合法且多样的报文,可用于协议实现的一致性、互操作性测试与质量验证。
工程落地友好:代码开源(github.com/MissHP111/FIGAN),模块可插拔,可与现有模糊测试、检测工具链组合使用。
7. 局限与后续展望
局限:
1、依赖启发式规则的可提取性:若协议存在复杂且未文档化的约束、难以被启发式捕获,FIGAN 可能合成无效报文,其能力边界受限于底层启发式工具。
2、语义评估仍不充分:现有指标主要度量结构多样性,尚不能显式证明模型已捕获高层协议语义。
后续展望:
1、以 Transformer、扩散模型或大语言模型替换或增强现有 GAN 生成器,提升长程依赖与复杂序列规律的建模能力;同时警惕更大模型的“数据饥渴”与学习虚假关联导致的多样性损失。
2、发展语义感知的评估框架或有状态协议解析器,实现显式语义度量。
3、将“解耦”思想从应用层载荷扩展到网络层行为推断(如结合逆强化学习建模动态路由序列),面向更复杂的工业数据中心场景。
第一作者:何萍
东北大学博士研究生,主要从事基于多模态流量语义理解的工控系统未知威胁检测与溯源研究。
指导教师:姚羽
东北大学教授,“谛听”团队创始人,复杂网络系统安全保障技术教育部工程研究中心主任。
本文转载自微信公众号「谛听ditecting」,查看原文。版权归原作者所有,如有侵权请联系删除。