人工智能适应式治理的风险信息机制与制度构造(学术专论)
原创 洪延青 2026-10-13 07:56 北京
构建学习型的AI立法
编者按
关于我国对人工智能技术和应用的监管发展,本公号发布过以下文章:
本文首发于《东方法学》2026 年第 4期【洪延青|人工智能适应式治理的风险信息机制与制度构造】。感谢编辑部老师的耐心和支持!发表在正式刊物上的是浓缩精炼的版本。公众号在此和大家分享的是底稿,虽然比较“啰嗦”和“重复”,但是相对完整,供各位批评指正。
本文提出:适应式治理的实质是监管学习:人工智能的能力和应用场景持续变化,规则必须随之调整,而调整的依据只能是持续生成、汇聚、核验并反馈的风险信息。现行制度却以分类分级为中心。监测、报告、登记等动态机制都要等系统被归入特定类别后才启动,因能力跃迁或场景迁移而新出现的风险,便难以进入监管视野。要让信息真正驱动调整,就要颠倒二者的次序:先有风险信息,再有分类分级。这条信息链有两端。在输入端,把分散在企业、用户和研究者手中的线索,转化为法律上可用的风险事实。在输出端,由这些事实得出可修正的分类,据此配置部署条件和监管强度,并回流推动规则与标准的复评。学习型治理同样需要边界。调整越灵活,监管裁量越大,因此须以触发条件、理由说明和申诉复核加以约束。标准越精细,越可能暗中替代价值判断,因此须限定它只处理技术问题。归结起来,人工智能法治的重心应从细化分类分级,转向构建以风险信息流动为基础的学习型法律结构,让法律在意外到来时仍能重新学习。
摘要
我国人工智能治理法治化的讨论正由静态风险规制转向适应式治理。适应式治理所需的制度能力,不仅是调整规则的空间,还包括持续获得风险信息,并据此检验和修正规制判断的能力。以分类分级为中心组织信息义务,虽然便于配置合规要求,却可能使类别之外的新风险难以进入常规信息渠道,也限制信息对既有分类和规则的反馈作用。本文从监管学习出发,提出以风险信息的持续生产、汇聚、核验、利用和反馈组织适应式治理。在输入端,应明确模型、部署、治理和事件信息的来源与义务主体,通过持续发现、分层披露和标准化整合形成可供法律程序使用的事实材料;在输出端,应将分类分级作为基于信息和保护目标作出的阶段性判断,衔接附条件部署、梯度干预、动态调级与规则复评。国家法、部门规则与技术标准之间的功能分工,以及受影响主体参与、理由说明和审查程序,则为持续学习确立权力边界。由此,分类分级得以保留其配置义务和监管资源的功能,同时接受新信息的持续检验,形成以风险信息流动为基础的学习型法结构。
关键词
人工智能治理法治化、适应式治理、风险信息机制、监管学习、风险分级
近期,人工智能健康发展综合性立法被明确纳入加快推进的政府立法工作安排[1],我国人工智能治理从专项规则走向综合性法治框架的方向更加清晰。未来立法因而需要回答:应当建立何种治理结构,才能在技术演化和风险外溢的过程中持续调整制度。这里既涉及调整权限如何配置,也涉及调整所依据的知识从何而来。在此背景下,近年来我国人工智能治理法治化讨论正在经历由静态风险规制向适应式治理的转向。一方面,过去数年主流的制度方案大多沿着基于风险的路径(risk-based approach)展开,通过分类分级、差异化义务和重点场景识别来组织治理;另一方面,面对模型能力变化、部署场景迁移、价值链分化和风险后果持续外溢,越来越多新近研究与制度设计开始转向适应式治理(adaptive governance)、动态治理或全生命周期治理,强调规则不能只停留在事前一次性判断,而必须保留持续修正的能力。
[2]
在这一转向中,既有研究已围绕适应式治理提出若干制度化方案。大体而言,相关方案可归入三个层面:在规则文本层面,主张通过弹性框架与原则性条款预留解释空间;在实施机制层面,倡导实验监管与监管沙盒,经由受控试错积累治理经验;在规制手段层面,则主张扩容监管工具箱,以行政指导、标准指引、合规激励、动态评估等柔性工具补充传统命令控制型规制。[3]这些方案共同回应高度不确定的技术治理中规则稳定性与制度适应性之间的张力;它们共享一种基本规范预设,即面对持续演化的人工智能风险,规则体系必须为修正、试验和校准留下空间。就其分工而言,弹性框架和原则条款为解释预留空间,实验监管和监管沙盒为试错提供条件,监管工具的扩展则为选择和调整干预方式提供手段。
但是,上述方案仍未充分回答一个前提问题:调整凭什么发生?弹性条款依据什么获得解释,沙盒中的试错经验如何转化为正式规则,扩容后的监管工具又依据什么被选择、组合与校准?如果缺乏持续生成的实证证据、稳定的风险信息汇聚渠道以及将新知识纳入正式程序的处理机制,所谓适应就可能停留在制度形式层面,而难以转化为可操作、可复评、可问责的法治过程。[4]缺少上述机制,适应式治理可能产生两种相反的偏差:一是监管机关在信息不足时凭主观判断调整规则;二是直到风险暴露,才被动确认既有制度已经失效。
风险信息机制正是在这一意义上成为适应式治理制度化的关键支撑。其核心功能不在于简单增加信息披露义务,而在于将分散在不同主体手中、形式各异且不断变化的风险线索,持续转化为能够进入法律程序、支撑监管判断并触发规则复评的信息流。这要求法律把信息的来源、处理责任和使用程序连接起来,使监管判断可以执行,其事实基础可以复核,作出判断的主体可以被追责。因此,判断一种制度是否具备适应性,不能只看它是否允许变更规则,还要看风险信息能否持续生成、汇聚和核验,以及这些信息能否真正触发监管判断与规则的复评。
围绕上述核心命题,后续论证将分五个部分展开。第一部分进行理念重塑,澄清适应式治理作为监管学习的实质及其经验与反思的双重结构;第二部分展开结构反思,剖析基于风险的规制路径中,动态信息从属于既定分类的制度困境;第三部分聚焦风险信息的输入端重构,探讨如何通过持续发现义务、兼顾商业秘密保护的信息提交以及标准化汇聚,将实证证据转化为法律上可用的风险事实网络,并据此讨论我国现行备案与登记制度的功能拓展;第四部分构建风险信息的输出端闭环,论证分类分级如何作为信息处理的下游输出,并进一步转化为监管干预、动态调级与规则复评;第五部分厘清规范边界,通过重构受影响主体的法律地位、划定国家法、部门规则与技术标准的功能分层,以及引入正当程序约束,防止学习型治理异化为权力恣意。
贯穿这些部分的问题是:如何通过风险信息处理机制组织持续学习,使风险分类、监管行动与规则更新能够相互衔接。
一、理念重塑:作为“监管学习”的适应式治理
近年来的人工智能治理讨论,越来越强调静态规则难以一次性穷尽技术风险。讨论因而不能止于适应式治理是否必要,还须进一步界定其规范内涵。部分论述侧重于规则表述的原则化、条文设计的开放化,抑或向监管机关授予更广泛的裁量空间。这一进路说明了规则如何为调整留下空间,却还需要解释:什么制度条件能够支持监管机关持续作出有根据的调整。就人工智能这类不确定性高、依赖具体场景且持续演化的技术而言,需要的不只是抽象层面上的规则可变(rule mutability),还包括监管机关依据新事实和规范理由,在实施过程中修正、补充和纠偏既有判断的能力。
(一)适应式治理的实质是“监管学习”
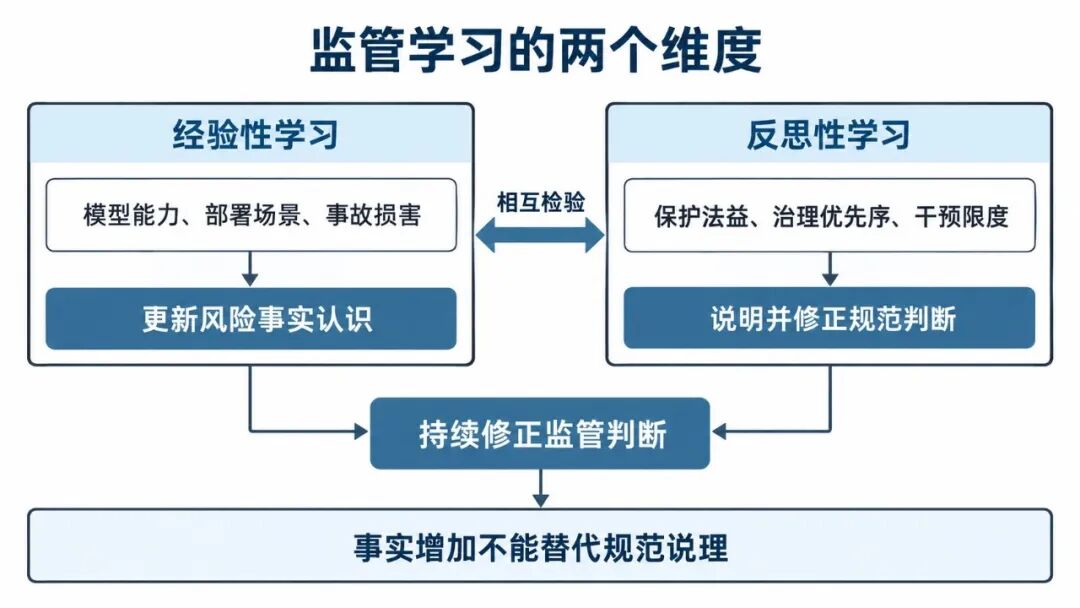
图1|经验性学习与反思性学习相互联系,共同支持可说明、可修正的监管判断。
从政策学习(policy learning)理论看,适应式治理首先是一种“监管学习”(regulatory learning)过程,其要求涉及制度如何运行,而不只是条文如何表述。政策学习意指政策行为者将从经验、分析与社会互动中获得的知识转化为行动的过程;监管学习是其中的一种,关注规制主体如何在具体情境中持续修正认知与判断。监管学习也可能发生“病理”:监管组织在信息吸收、分析、协调和沟通方面的缺陷,既可能使有效信息无法进入决策,也可能使监管者从经验中得出错误教训。[5]其结果可能是规则不断更迭,却没有改善问题识别与处置,甚至因错误教训而偏离治理目标。[6]
据此,有必要区分适应式治理与两种常见的制度安排:其一,认为规则条文应刻意保持模糊以预留解释空间;其二,主张授予监管机关宽泛裁量权以应对个案。上述两种路径固然能在一定程度上提升制度弹性,却不会自动带来持续学习。要形成学习机制,监管体系须在规则实施中持续吸纳新事实、检验既有判断并识别制度偏差,进而调整规则的适用方式,必要时重新审视治理目标。在这个意义上,有学者在分析欧盟《人工智能法》(AI Act)时指出,基于风险的规制路径本身也可以构成一种应对不确定性的适应性机制:事前审查机制旨在处理已知或合理预见的风险,而事后的市场监督机制则在新风险暴露或既有风险缓释措施失效时,促使相关知识得以扩散并触发纠偏程序。
因此,符合性评估、监督与执法等环节,均可以成为监管学习的组成部分。[7]然而,仅凭上述分散的规制活动仍显不足;面对技术演进的快速变化、基本权利保护中的不确定性,以及通用规则与行业执法之间的衔接问题,还需要把这些分散活动组织为范围更广、分工明确的监管学习体系。
从知识来源看,监管学习还需要超出监管者与企业之间的双边互动。研究提出的“监管学习空间”(regulatory learning space)[8]之所以富有启发,恰在于其将学习网络中的主体分为价值链参与者、监督机关与受影响主体三类。人工智能治理法治化的实施效率和正当性,取决于这些主体如何交换信息、获得规范指引并承担相应责任。换言之,监管学习要求多类主体共同参与,围绕不同法益和不同学习活动交换知识。监管机关接收企业报送材料,只是其中一个环节。由此推论,若将适应式治理简单等同于行政裁量权的扩张,不仅存在过度行政化的风险,也会忽略知识分散在不同主体手中的事实。[9]
在确立适应式治理作为监管学习的理论定位后,有必要进一步厘清学习过程中的两个维度。第一是经验性学习(empirical learning),即依据模型能力、部署场景、事故险情和实际损害等材料,更新对风险事实的认识;第二是反思性学习(learning from reflection),即审视何种干预限度适当、哪些风险应优先处理,以及何种法益衡量方案能够获得正当化。在缺乏普遍公认的权威知识源,且不存在可直接回应开放性命题的既定路径时,监管主体必须在有限知识的约束下,借助协商、反思与公共讨论等程序,形成并检验规范判断。
在此进程中,公共咨询程序的制度价值既体现在帮助监管者核对事实基础(ground truth),亦体现在协助其识别不同利益相关方的价值偏好。综上,监管学习兼具事实探知与规范重塑的双重属性:前者查明模型和系统如何运行、造成何种影响,后者讨论这些影响为何需要法律介入、应当如何介入。两类判断相互联系,但不能以事实材料的增加代替对干预理由的说明。
鉴于上述双重属性,人工智能领域的适应式治理需要同时处理事实认识与规范判断。相关理论指出,监管学习可能发生“学习模式错配”(learning mode misfit):将同时涉及经验与规范的议题简化为实证问题,误以为只要汇集足够数据和专业意见,就能得出规制答案。在这种情况下,即便监管主体获得了充分信息,也可能因误判问题性质而继续追求不恰当的治理目标。症结在于,本应通过公共讨论形成的价值判断,被提前交给技术专家或标准制定者处理。因此,动态治理须使监管主体既能识别和吸收新的事实,也能说明并修正规范判断。前者要求信息渠道和核验能力,后者要求参与、说理与审查程序。两者共同构成适应式治理得以实施的条件。[10]
(二)学习的前提:检验法律体系的“风险想象”
前文说明了适应式治理为何应被理解为监管学习,接下来需要考察:监管者在什么前提下开展学习。就此而言,关于“风险想象”(risk imaginaries)与“务实治理”(pragmatic governance)的研究,有助于说明监管者如何界定需要应对的问题。风险讨论既反映客观事实,也受到叙事方式的影响。所谓“社会技术想象”(sociotechnical imaginaries),涉及人们共同持有并通过制度与公共实践表达的技术和社会未来图景。关于风险、责任与技术进步的这些图景,会影响制度议程、资源分配和监管路径的选择。这些图景既描述技术可能怎样发展,也包含对何种未来值得追求的规范判断,因而影响人们对何种治理模式可行、必要和正当的判断。[11]
循此逻辑,部分人工智能治理框架需要面对的问题,并不只是事实基础不足,而是它们往往在一开始就预设了某种静态的“风险想象”。[12]相关研究分析了生存风险叙事(existential risk narrative)、加速主义叙事(accelerationist narrative)和批判性人工智能叙事(critical AI narrative)三类话语,并指出,尽管上述叙事在价值取向与政策处方上大相径庭,却都可能因对未来的特定预设而缩小其他治理方案的空间。
[13]具体而言,这种叙事可能将高度灾难化的图景视为无可避免的趋势,或将技术无序扩张等同于实现繁荣的唯一正当路径,抑或将现实社会的不平等固化为技术发展注定复制的宿命。当未来被描绘为已然确定的单一路径时,公共政策的选择空间也随之缩小。监管者尚未开始制度设计,就可能预先排除其他理解问题和采取行动的方式。
这也解释了为什么适应式治理不能只理解为“多收集一些事实”。在风险想象已被静态叙事固化的前提下,新增信息可能成为强化既有偏见的工具,难以发挥实质性的纠偏功能。对此,务实治理路径提供了关键的理论启迪。[14]该路径要求以经验事实、公众参与和可观察后果持续检验治理判断。据此,本文认为,政策制定者应定期收集、分析并适当公开人工智能运行中的非预期后果、损害与收益,再检验既有治理原则能否解释和处理这些后果。实验与试点的意义也在于此:它们应当提供可用于修正判断的材料,而不能仅被用来证明预设方案正确。把证据的收集、检验和反馈规定为连续程序,才能使政策学习获得稳定的制度形式。
更进一步地说,务实治理不仅强调“以证据为基础”,而且强调“以参与为基础”。在这一路径中,对公共利益的具体理解需要结合可观察的社会后果和集体经验不断检验。因此,广泛参与和包容性讨论,能够帮助识别关键影响、确定治理优先顺序并审视规范边界。这也使得务实治理与单纯技术官僚主义之间形成区别:前者固然要求更多经验材料,但它并不相信事实会自动转化为正当答案,因而要求通过参与程序讨论事实的规范意义,再据此形成和说明规制方案。
当然,强调经验、试验与持续修正,并不意味着务实治理鼓励迟疑不决或价值相对主义。结合上述研究可以认为,务实治理允许在证据支持下及时采取规制行动,并通过试点、效果评估和针对性干预,检验哪些措施有效、哪些需要调整。持续学习的要求,是使行动及其后果能够被再次审查。由此看来,适应式治理的两项任务得以区分:它既要求监管者持续学习事实,也要求其持续修正关于风险本身的想象;前者防止治理脱离现实运行,后者防止治理被未经检验的叙事限定。[15]
综上所述,作为监管学习机制的适应式治理,要求完成两方面相互关联的调整。其一,应将规则弹性和裁量空间与学习机制相连接,使经验证据、数据分析和社会互动所得的知识持续进入监管。其二,应持续检验既有风险叙事,反思哪些事实被纳入风险判断、哪些事实被排除,以及这种取舍是否合理。这两方面调整使适应式治理具有明确的工作内容:组织证据,吸纳争议,并据此修正规制判断。
二、结构反思:“基于风险的路径”的信息从属困境
将适应式治理理解为监管学习之后,需要进一步考察现有制度如何组织学习。“适应式治理”和“全生命周期治理”虽已进入制度讨论,信息能否据此改变监管判断,仍取决于具体的法律结构。本文关注的问题是:现有规制路径虽然设有动态机制,但其启动条件和信息用途在很大程度上仍取决于既定的风险分级。换言之,问题不是“没有风险信息义务”,而是“信息的收集范围和使用方式过度受制于既有分类”。在这种结构下,风险分级容易成为治理的固定起点,而风险信息生成、汇聚与校验反而退居次位,使新发现的风险事实难以反过来改变既有分类。
关于欧盟《人工智能法》监管学习空间的研究,为考察这一问题提供了材料:该法虽然已经规定多种有助于学习的活动,但其学习活动的组织方式仍与人工智能系统的类型划分密切相关;禁止性实践、高风险系统、通用人工智能模型(GPAI)以及特定透明度义务对象等类别,构成理解制度运行的重要坐标。
(一)动态机制受既定分类约束的结构性问题
以欧盟《人工智能法》2024年公布的制度架构为例,多项信息义务的适用仍沿着“先分类、后收集、再调整”的顺序运行。[16]从规范编排看,该法首先区分禁止性实践、高风险系统、特定透明义务对象以及通用人工智能模型等不同类别;其中,高风险系统主要通过两条路径被识别:一是人工智能系统作为附件I所列欧盟协调立法覆盖的产品或其安全部件,且该产品依法须接受第三方符合性评估;二是系统属于附件III所列用途,并结合第6条第3款的例外条件判断。与此同时,委员会可以在第7条规定的条件下,通过授权法案调整附件III中的高风险用例。这说明,欧盟模式具有动态调整能力,但此处的调整以既有类别为对象。新风险能否进入调整程序,因而取决于类别维护之外的信息发现与反馈安排。[17]
更关键的是,多项持续收集信息的义务,其适用范围仍由上述分类结果确定。例如,高风险系统提供者须建立上市后监测体系(post-market monitoring system),履行主动、系统收集并分析全生命周期数据的义务;严重事件报告也设有明确期限:一般应在确认因果联系或其合理可能性后立即报告,且最迟不超过知悉事件后15日;涉及广泛侵权或关键基础设施管理运行发生严重且不可逆中断等特定情形,最迟为知悉后2日;涉及死亡的,确认或怀疑因果关系后应立即报告,且最迟不超过知悉后10日;此外,欧盟层面设立数据库,并依第49条和第71条要求相关提供者及特定部署者履行注册程序。
这些机制能够持续提供信息,但其义务范围主要依据法定类别划定。因而,对已纳入相应类别的系统,法律可以组织较为稳定的持续监测;对于类别之外新出现的风险,则仍需依靠其他发现和纳入渠道。分类的规范作用由此延伸到信息的生产环节:某项义务是否适用,决定了哪些主体须持续记录和报告,进而影响监管者通常能够获得什么信息。[18]
相关研究对这一制度构造的刻画具有启示意义。相关研究指出,欧盟《人工智能法》沿用了新立法框架(New Legislative Framework, NLF)的产品规制思路[19]:针对被归入“高风险”类别的产品实施上市前符合性评估(ex-ante conformity assessment);在产品投入市场后,再通过提供者的持续监测、部署者依照使用说明操作以及市场监督机关的执法活动,构建事后治理闭环。在此架构下,符合性评估材料、技术文档、测试报告与使用说明成为合规审查的核心文本。从信息用途看,这些材料首先服务于判断特定对象是否满足既定义务。要使其进一步支持分类修正,还须明确哪些异常足以触发复评、由谁汇总跨案件的发现,以及复评结果如何回到规则制定过程。
这种“分类前置”的结构性后果,首先表现为出现信息盲区的可能。上市后监测、数据库登记和严重事件报告等特定义务,主要围绕已纳入相应规制类别的对象配置。那些尚未落入高风险类别,但因部署情境、能力跃迁、组合使用或场景迁移而在现实中逐渐显现风险的系统,可能难以及时进入上述常规信息渠道。相关研究提出,应更充分地结合具体场景评估风险,避免过度依赖预先划定的类别[20];若忽略场景差异,原有分类便可能无法反映实际后果,例如原本被视为“低风险”的系统可能因具体部署情境中的误用、漂移或组合效应而产生重大损害。虽然市场监督、投诉等渠道仍可发现此类问题,但零散发现能否形成持续信息,取决于后续记录与反馈机制。分类前置的局限,应当在这一层面上理解。[21]
更深一层地看,问题还不止于“漏掉一些系统”,而在于分类前置会影响监管者认识风险的方式:监管者更倾向于围绕既有类别去配置注意力,而不是围绕现实运行中的新证据去修正问题本身。即便引入实验性治理工具,如果主要任务仍是验证事前确定的风险和缓释措施,实验就可能难以检验风险分类本身。相应地,对已经发生的损害、意外后果和外部性,需要建立能够持续归档、归纳类型并衔接救济的机制,避免这些材料仅被当作既有类别内的个案处理。由此可见,信息收集可以持续进行,但哪些信息被重视、能够产生何种作用,仍受既定类别结构影响。
(二)逻辑起点的倒转:分类分级应作为信息处理的下游输出
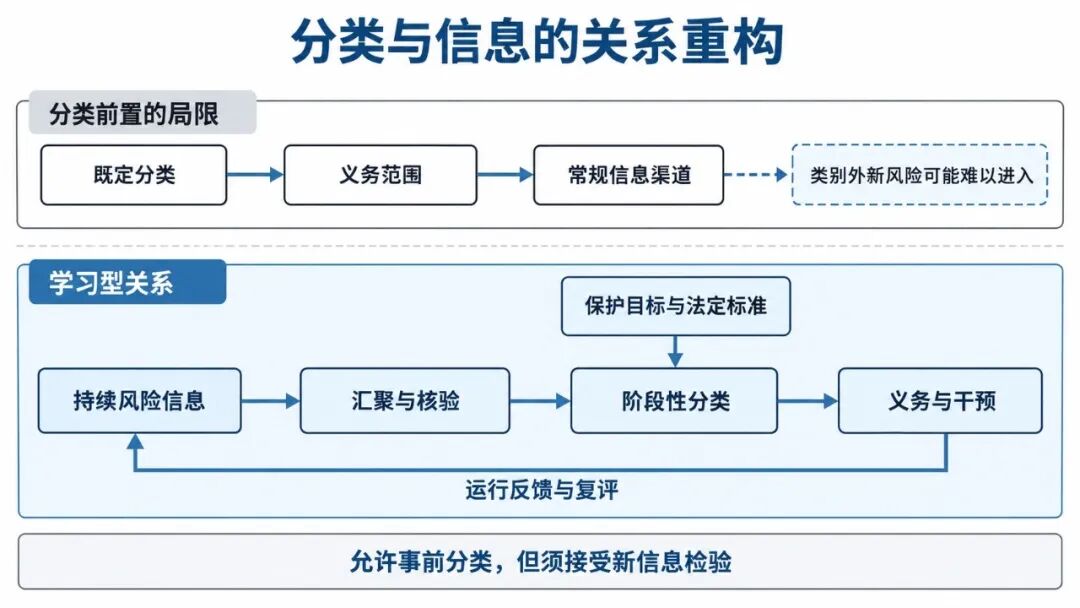
图2|分类是基于证据与保护目标作出的阶段性判断,并接受运行中新信息的持续检验。
据此,有必要重新考察“基于风险的路径”中分类与信息的先后关系。无论是已经确立的“高风险人工智能”、特定透明度义务对象,还是研究中提出的“关键人工智能”(critical AI),都体现了对规制对象的制度性选择。不过,风险高低与重要性并非同一判断尺度:前者侧重危害,后者还涉及功能或地位。它们的共同点在于,均须依据事实材料和保护目标作出判断,不能被视为先验存在的自然类别。换言之,分类分级从来不是治理的“自然起点”,而是依据事实与规范标准作出的制度输出。
之所以在许多制度设计中看起来仿佛分类先于一切,只是因为立法为了获得可操作性,先把复杂、分散且不断变化的风险事实压缩成若干可识别的对象类型,再围绕这些类型配置义务。但一旦承认人工智能风险高度依赖部署情境、能力变化和现实后果,这种压缩就只能是暂时性的,而不应被误认为逻辑上的原点。[22]
现有监管学习研究也为这一判断提供了支持。相关研究将欧盟《人工智能法》理解为一个“监管学习空间”,并说明,该学习空间是按照AI系统类型、受保护法益类型和学习活动类型来加以参数化的;研究进一步指出,组织学习、执法学习与元学习(meta-learning)之间需要建立密切的双向信息联系,尤其执法学习与更高层级的规则修订、分类修正和标准更新之间,存在相互反馈的需要,因此制度上需要系统性支持去“发现、交换并有意义地吸收”这些学习结果。这实际上说明,即便在已经形成较完整制度的风险路径中,分类也只能被理解为学习过程中的暂时节点,而非不容动摇的起点。这里的元学习,正是对分类依据、规则内容和学习安排本身的再检验。[23]
由此,制度调整不能止于替换分类目录,还须使风险线索的持续发现与信息核验能够影响分类的形成与修正。在这一转换中,法律首先要组织的,不是一份更细密的风险名录,而是持续生成、汇聚、校验和更新实证证据的机制。只有当模型信息、部署信息、治理信息和事件信息能够稳定进入规制体系,分类分级才可能成为对这些事实材料的可修正回应,而不是替代事实本身的僵化标签。沿着这一思路,可以通过持续监测、结合情境的适应性分类以及对现实影响的证据归纳,减少对静态类别的过度依赖;良好治理的真正基础,不是事前画出一张自认为完备的风险图谱,而是基于真实后果不断归纳、修正和重构治理原则。
需要强调的是,将分类分级逻辑重定位为下游输出,并不否定分类机制的制度效用。作为分配合规义务、调配监管资源及组织执法活动的关键法律技术,分类分级仍具有制度价值,需要调整的是它与信息机制的关系。分类机制的必要性,根植于法律须将连续演进的风险现实转化为具备可操作性的制度节点;但这些节点需要以持续更新的信息为依据。当新信息改变了原判断的事实基础,分类结果也应能够被变更、复核,必要时被推翻。换言之,本文所说的“下游输出”是对分类依据及其可修正性的要求,并不要求等到损害发生后才能分类。事前分类可以依据已有证据作出,但须接受运行中新信息的检验。只有这样,适应式治理才可能摆脱“分类一旦作出、信息只能附着其后”的倒置逻辑。
综上,以分类组织信息的结构性问题,并非缺少任何动态治理机制,而在于动态机制所收集的信息仍主要用于维持既有分类体系:信息被用来支撑既有分类架构的实施运转,对修正分类标准、调整规则和组织学习的作用仍需加强。
三、风险信息的输入端重构:实证证据的生产与整合
将分类分级定位为阶段性输出之后,下一步就是建立它所依赖的信息条件。仅把风险目录划分得更细,并不能保证新风险得到识别;还需要使支撑监管学习的证据持续产生、稳定汇聚并进入正式程序。换言之,要使适应式治理能够实施,需要先回答两个问题:一是哪些材料能够构成法律上可用的风险事实;二是这些材料如何从分散的私人知识、运行线索和外部发现,转化为足以支撑监管判断的制度性输入。
(一)风险信息的概念界定:从一般披露到法律上可用的风险事实
规范意义上的“风险信息”,并非泛指一切与人工智能有关的数据、文件、披露材料或技术说明,而是指反映模型能力、部署条件、治理状态或实际事件,并能够通过适当的记录、传输、核验、保存和更新程序用于风险判断的事实材料。其制度价值在于,使风险判断有可认定和可复核的材料依据,并可追溯信息提供与处理的责任。法律介入所改变的,是这些材料在监管程序中的可用性和效力,而不是事实本身是否存在。因此,线索进入制度、材料获得核验与事实被用于决定,是三个相互衔接的环节。不能要求信息在提交之前就已经证明全部风险,也不能因为信息已经提交就视其为已查明的事实。
法律之所以必须介入这一转化过程,可以从信息分布、核验条件和时间变化三个方面理解。[24]首先,人工智能风险信息具有显著的分布性。模型能力边界、训练细节、重大更新、部署范围变化和内部治理状态,通常掌握在不同主体手中,监管者与受影响群体无法自然获得这些信息。其次,人工智能风险信息可能被选择性披露,且外部核验存在困难。若制度只要求企业“自行说明”,而不同时配套第三方评估、监管抽测、事故核查和行政复核等外部验证机制,监管者就可能把企业的自我陈述直接当作风险判断的依据。最后,人工智能风险信息具有显著的时变性。模型会更新,部署会扩张,事件会暴露新的问题;若法律仅满足于一次性备案或静态披露,风险判断的事实基础便会迅速衰减。
据此,在组织监管学习方面,未来人工智能法的一项基础任务,是通过制度安排把分散存在的风险线索持续转化为可认定、可复核、可追责的监管事实。只有在这一意义上,风险分类分级才可能获得可检验的事实基础,而不只是停留在法条上的抽象排序。
(二)风险信息的基本类型与信息义务主体
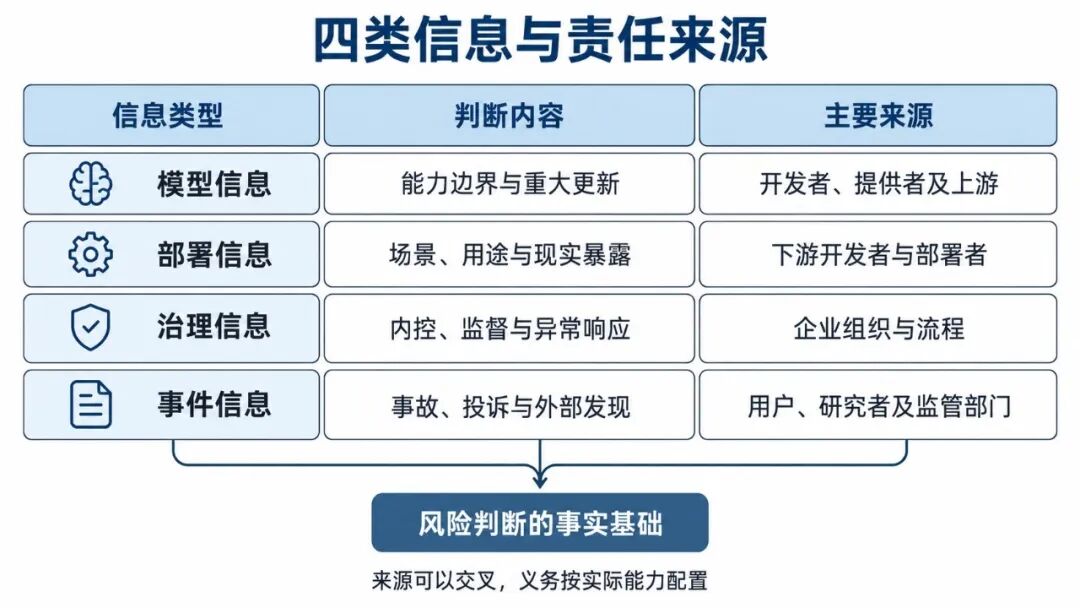
图3|四类风险信息分布在不同主体手中,信息义务应与掌握能力、控制范围和发现机会相称。
按照风险判断所需了解的内容,人工智能领域至少存在四类核心风险信息,即模型信息、部署信息、治理信息与事件信息。模型信息主要涉及训练规模、模态能力、能力边界、测试结果、重大更新、微调情况、插件接入、接口开放程度以及分发方式等内容,用于判断模型“能够做什么”,以及在何种条件下可能产生特定影响;部署信息则说明,即便模型能力本身保持不变,风险后果仍会因用途、行业场景、用户群体、嵌入决策链条的程度、跨场景迁移以及现实暴露面的不同而显著变化;治理信息反映开发者、提供者与部署者是否建立了与风险相匹配的内部控制、测试评估、人工监督、日志留存、异常响应和组织合规安排;事件信息则主要来源于运行过程中的事故、险情、投诉举报、外部研究发现和内部披露,它们的制度价值在于持续修正此前建立在预测与自评基础上的风险认知。
这一划分依据的是各类信息在风险判断中的作用,允许同一材料同时涉及多个方面。例如,一次重大更新既可能改变模型能力,也可能要求部署者调整人工监督措施;分类的意义在于明确这些联系,而不是把材料分装到互不连通的档案中。
这四类信息并不天然汇聚于同一主体之手,而是分散在研发、供应、部署和使用等不同环节。模型信息更多掌握在开发者、提供者及其上游供应者手中,部署信息更多掌握在下游开发者和具体部署者手中,治理信息通常嵌在企业内部组织与流程之中,而事件信息则高度依赖用户、研究者、社会组织、媒体、内部员工和不同监管部门的持续输入。与此相应,关于欧盟《人工智能法》监管学习空间的研究,将参与学习活动的主体概括为三类:价值链主体、监督机关与受影响主体;其中,价值链主体包括提供者、部署者及其上游数据、模型和其他组件供应者,受影响主体则包括自然人、群体和为集体利益发声的非政府组织,而制度实施的效率与正当性,将取决于这些主体之间的信息交换网络、规范指引和问责机制。
因此,所谓“输入端重构”,首先不是要求更多主体笼统地“报材料”,而是承认人工智能风险判断所依赖的事实材料本身具有分布性、异质性与时变性,并据此按照信息掌握能力、控制范围和发现风险的机会配置信息义务。换言之,未来制度不能再把企业视为唯一的信息源,也不能把监管机关视为单向接收材料的终点,而必须把价值链主体、监督机关与受影响主体通过明确的提交、共享和反馈程序连接起来。[25]相应地,义务的范围与频率应与主体的实际能力和风险程度相称。对掌握模型内部信息的提供者与只能观察外部结果的用户,不能提出相同的说明和证明要求。
(三)信息的“生产”机制:从一次性说明到持续发现与披露义务
风险信息机制的第一环,是让风险信息能够稳定生产。为此,需要改变仅以“首次说明”或“一次性备案”组织信息生产的做法。人工智能风险并不会在系统上线前一次性显现,训练规模扩大、微调方向变化、工具接入、插件整合、权重更新、分发方式调整和部署范围扩张,都可能实质性改变系统原有的能力结构和风险特征。若法律只要求在首次上线时提交一份静态材料,原有材料便可能不再反映系统当前的运行状态。
因此,信息生产机制首先应建立在开发者、提供者与部署者的“自反性义务”(reflexive obligations)之上。[26]最接近风险事实的主体,往往也是最早掌握相关信息、最有条件持续记录的主体。模型如何训练、能力边界何在、进行了何种测试、设置了哪些安全阈值、经历了哪些重大更新、部署到了何种场景、面向哪些用户群体、运行中发生过何种异常,这些信息大多首先存在于企业内部。法律因而应要求这些主体持续观察模型能力、治理过程、部署变化和运行状态,并保留可供审查的记录,使原本停留于组织内部的技术知识与治理知识成为可供后续监管使用的材料。持续记录的要求也改变了企业的内部决策方式:能力更新、场景扩展和异常处置需要留下理由与过程,而不能只在事后提交结论。
企业内部留痕还需要外部风险发现机制的补充。人工智能系统的许多真实风险,并不会在设计和上线阶段一次性显现,而是在运行过程中随着用户互动、场景迁移、能力外溢和组织依赖逐步暴露出来。事故、险情、重大异常、用户投诉、独立研究发现和内部举报,能够成为纠正先前风险判断、触发重新评估并推动制度学习的重要来源。因此,风险信息生产机制还必须建立由第三方评估、公众反馈、事件报告和内部举报共同构成的社会风险发现网络。
我国现行制度已经包含持续生产风险信息的若干安排。《互联网信息服务算法推荐管理规定》要求,具有舆论属性或者社会动员能力的算法推荐服务提供者在提供服务之日起十个工作日内履行备案[27];备案信息发生变更的,应在变更之日起十个工作日内办理变更手续,终止服务的,应在终止之日起二十个工作日内办理注销备案。同时,相关服务提供者应依法留存网络日志,配合安全评估和监督检查,并设置投诉、举报处理机制。《互联网信息服务深度合成管理规定》则进一步要求深度合成服务提供者对违法和不良信息采取处置措施、保存记录并及时报告,设置便捷的用户申诉和公众投诉举报入口。
《生成式人工智能服务管理暂行办法》明确提出对生成式人工智能服务实行包容审慎和分类分级监管,并将标识、违法内容处置、安全评估、算法备案和投诉举报等制度连接起来。这些规则已经表明,我国已经具备风险信息生产机制,但这些机制分属不同部门和专项制度,分别依各自条件启动,尚未被统一提升为支撑监管学习的共同制度层。
需要强调的是,人工智能风险信息往往同时涉及商业秘密、网络安全、模型权重安全乃至公共安全问题。若法律将透明度简单理解为无差别公开,不仅会引发企业抵触,还可能削弱企业如实提供信息的意愿。在制度设计上,可按信息用途与敏感程度区分公开披露、限域披露和保密提交三种路径:对公众确需知悉的基础信息予以公开,对需要专业核验的信息在受控条件下向具备相应资质并承担保密义务的第三方开放,对涉及商业秘密和安全风险的敏感信息则允许向主管机关保密提交,并通过分层访问、必要的匿名化处理和汇总披露兼顾监管核验与保密需求。
[28]对善意的公共利益安全研究,可以探索“研究者安全港”(researcher safe harbor)[29],并与内部举报人保护制度相衔接,以保护善意发现和报告风险的主体,维持外部信息来源。
(四)信息的“整合”机制:从信息碎片到可进入程序的风险事实
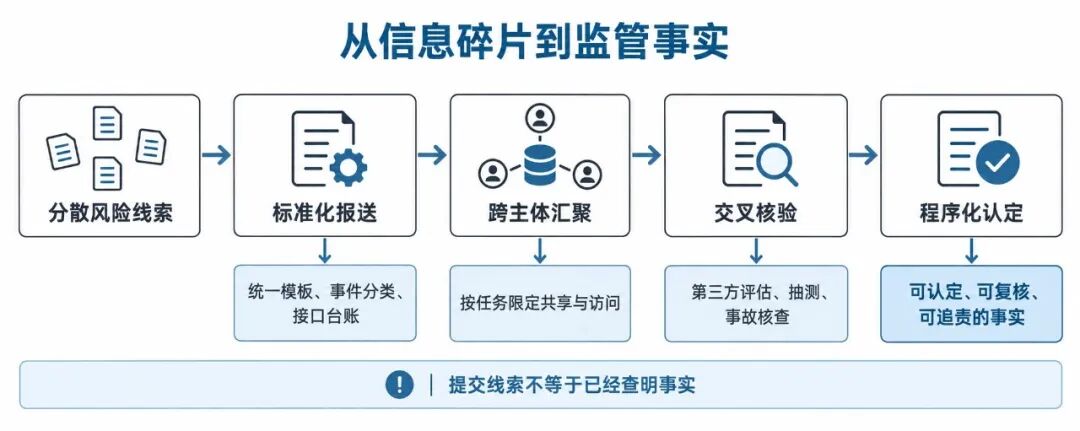
图4|分散材料经标准化、汇聚、交叉核验与程序转化,形成可用于监管判断的事实。
如果说生产机制解决的是“材料从何而来”,那么整合机制解决的就是“这些材料如何被转化为法律上可用的事实”。风险信息天然具有分散性、异质性和时间差:有的形成于模型研发与测试阶段,有的产生于部署与运行中,有的则以事故、投诉、研究报告和吹哨披露的形式零散出现。若无法通过制度设计将这些材料转化为可比较、可验证、可进入程序的规范化对象,已经积累的材料仍可能彼此割裂,难以支持共同判断。正是在这一意义上,风险信息整合连接着材料的生产与监管事实的认定:标准化报送改善可比性,跨主体共享使信息汇聚,交叉验证提高可信度,程序规则则明确材料何时、以何种方式成为监管判断的依据。
因此,未来立法首先需要建立统一而可扩展的报送结构。国家层面的人工智能基本法可以确立三项基础要求,再由配套规则细化[30]:其一,统一报送模板,明确模型能力、部署场景、治理措施、重大更新、事故险情和补救措施等基础字段,使不同主体提交的信息能够围绕同一对象与时间范围进行比较;其二,建立风险事件分类法,将原本零散、口径不一的事故、险情、偏差、滥用和越权访问等异质事件转化为可被识别、检索和统计的制度类别;其三,建立统一的数据接口与基础台账,使模型、系统、部署、治理和事件材料能够在同一框架下被持续留存和动态比对,而不是分散存放在彼此不兼容的部门平台之中。
相关研究提出,可采用以标准为基础、具备机器可读性(machine-readable)的信息模型和共享规程,使不同场景、主体和学习活动中的信息能够对齐(alignment)或映射(mapping)。该研究进一步建议使用开放标准、数据门户(data portals)及具备互操作性(interoperability)的信息框架,在人工智能价值链内部支持从上游到下游的信息交换,使之成为支持监管学习的共同技术基础。同时,采用开放标准和结构化共享方式,不仅能够提高价值链参与者与监管机关之间的信息互换效率,也有助于受影响主体、其代理人和独立研究者在遵守保密要求的前提下,开展服务于公共利益的比较与核验。
由此可见,信息整合需要的不只是一张行政表单,还包括可互操作、可由机器处理并能在不同制度之间使用的信息基础设施。[31]
在中国法的语境下,这种整合机制还意味着跨部门与跨主体的信息流动链条需要被打通。上游模型提供者应向下游开发者和部署者传递能力边界、已知限制、重大更新与安全措施信息;下游部署者则应将场景变化、运行异常、用户投诉和局部事故持续反馈至上游主体及主管机关。这种安排要求明确各主体掌握哪些信息,以及向谁传递、何时传递、反馈什么,使报送监管机关与价值链内部的信息交换能够衔接。同时,还需要明确负责维护和分析这些信息的组织:事故与险情汇总、第三方评估结果、研究者报告、重大更新说明和企业变更备案,都需要有专业团队持续进行技术分析、风险聚类与趋势提炼,才能为后续调级、规则修订和政策更新提供支持。
信息可以技术性汇聚,并不意味着任何机关或参与者都可以无条件获取全部材料。共享对象、用途和访问权限仍须与相应监管任务相联系,避免以互通为名扩大不必要的信息收集。
(五)将备案与登记制度提升为持续学习的信息枢纽
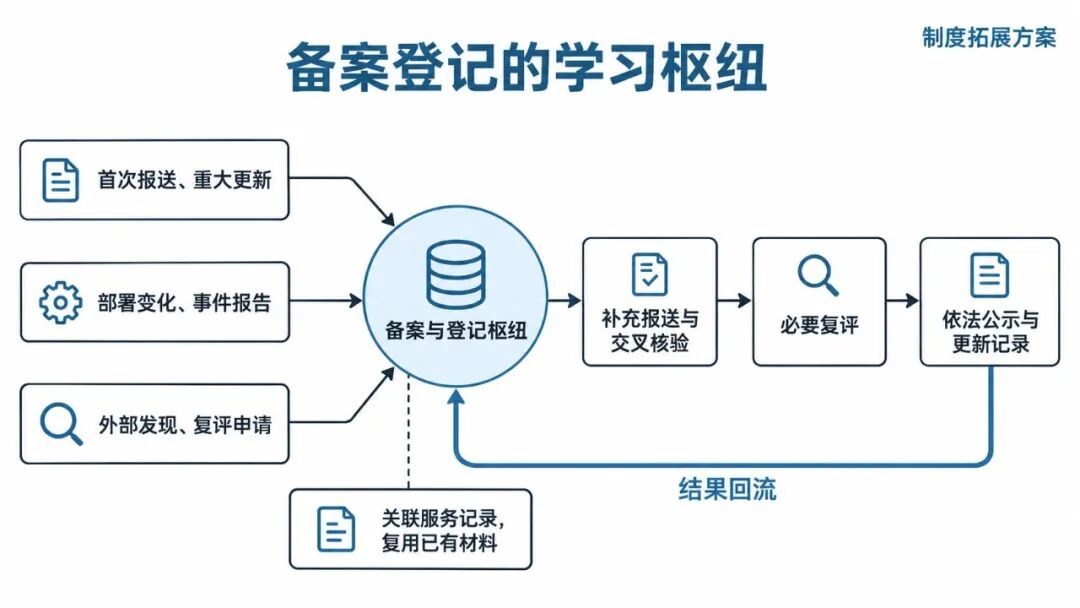
图5|以备案与登记关联首次材料和持续变化,触发核验与复评,并将结果反馈至原记录。
上述讨论意味着我国现行备案、登记、标识、日志留存和投诉举报等安排,可以成为风险信息机制的制度基础。特别是生成式人工智能服务的备案和相关应用登记,已形成全国范围内可查询的信息入口。国家网信办公告显示,截至2026年4月30日,累计已有868款生成式人工智能服务完成备案,530款生成式人工智能应用或功能完成登记;同时,已上线的生成式人工智能应用或功能应在显著位置或产品详情页面公示所使用已备案或登记服务的模型名称、备案号或上线编号。这说明,备案与登记除服务于上线管理外,已经承担模型识别、公示和追溯功能,也为后续信息更新提供了基础。[32]
但若止步于此,备案与登记仍然只是前端识别工具,尚不足以支持持续学习。它们进一步的制度潜力,在于成为连接“首次报送、重大更新、部署变化、事件报告、外部发现、复评申请”的共同入口。[33]换言之,我国未来人工智能法不应再把备案、登记、标识、投诉、日志与安全评估视为彼此分散的专项制度,而应通过统一接口和统一程序,将其改造为一套能够持续吸纳模型信息、部署信息、治理信息与事件信息的基础设施。只有当重大更新、场景迁移、事故险情和外部发现能够持续回流至既有备案与登记体系,并触发补充报送、交叉核验和必要复评,备案与登记才会真正从“准入节点”转化为“学习枢纽”。
这一拓展并不要求另起炉灶建立一套报送制度。可先明确既有材料的复用规则和变更报送范围,再把经核验的外部发现与原有服务记录关联,减少同一主体向多个部门重复提交相同材料的负担。
综上,适应式治理的输入端重构,归根结底并不是对“一般透明度”的再强调,而是对风险信息如何产生、如何进入监管程序的重新设计。其一,风险信息应有明确的事实指向和进入程序的条件,并明确其与一般披露材料的区别。其二,风险信息的来源必须被重构为分布式、多主体的制度网络,而非企业与监管机关之间的单向报送。其三,风险信息的生产不能停留在首次上线或一次性备案时点,而必须通过持续记录、重大更新披露、事件报告、投诉举报、第三方评估和内部披露形成动态发现机制。其四,风险信息的整合不能停留在材料堆积,而必须经由标准化报送、跨主体共享、交叉验证与程序转化,形成可比较、可检索并可供正式程序使用的事实材料。
四、风险信息的输出与反馈:分类分级、监管干预与规则复评
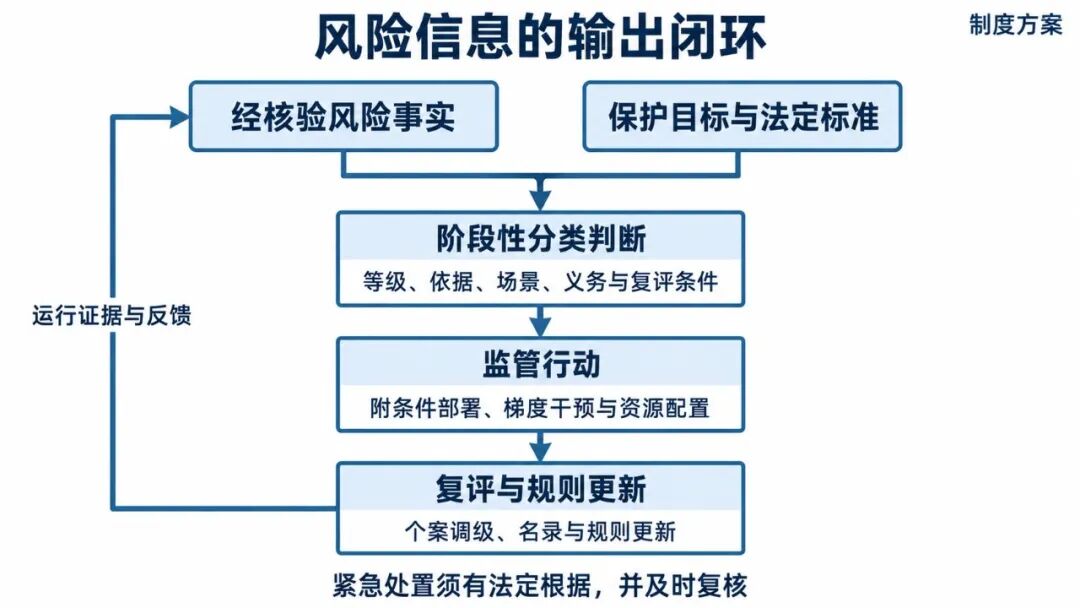
图6|风险事实先形成阶段性分类,再联动适度干预,并通过个案与制度层面的复评持续反馈。
承接前文讨论,接下来需要说明经汇聚和核验的信息如何转化为法律行动。适应式治理的成效,取决于这些信息能够改变哪些制度判断:增量信息不仅要能够推动个案监管判断的校准,还要能够形成阶段性的分类分级结果,并进一步驱动合规义务、监管强度、规则名录和技术标准的持续调整。否则,再完备的信息输入端也只能成为不断积累的档案,其处理结果无法回到后续决策。
(一)分类分级的证据基础:从风险事实到制度类别
前文已经指出,分类分级不应被视为人工智能治理的逻辑起点,而应被理解为依据风险信息和法定判断标准形成的阶段性制度输出。由此,输出端闭环的首要任务,并不是在既有分类表之外再增加若干新的监管工具,而是说明风险信息如何被转化为可操作的分类分级判断。换言之,风险信息机制的下游输出首先表现为一种“从事实到类别”的制度转化过程:模型能力、部署场景、治理状态、事故险情、外部研究发现、投诉举报和第三方评估等材料,经由汇聚、核验和比较后,由有权主体据此确定某一系统、功能、场景或用途的风险等级。
这种分类分级判断具有后验性、情境性和可修正性。所谓后验性,是指初始等级须接受运行证据的持续检验,而非等到风险已经造成损害才开始治理。系统上线前的用途与技术类型可以构成初始判断的依据,但不能排除后续信息对该判断的修正;所谓情境性,是指同一模型或系统在不同部署场景、用户群体、决策链条和暴露范围中可能产生不同风险等级;所谓可修正性,则意味着分类结果应当随着重大更新、场景迁移、事件报告、治理措施变化和外部证据积累而进入复评程序。因此,分类分级不再是对人工智能系统贴附的静态标签,而是法律依据风险信息作出的阶段性判断,其适用范围和根据均可被检验。
在制度设计上,分类分级结果至少应包含五项内容:其一,风险等级本身;其二,作出该等级判断的主要事实依据及其适用的判断标准;其三,该等级适用的具体功能、场景或部署范围;其四,该等级对应的合规义务与监管措施;其五,重新评估的触发条件与周期。只有将这些内容同时纳入分类分级决定,分类才不会退化为抽象标签,而能够成为连接风险事实、监管干预与规则复评的中间制度节点。由此,分类分级既不是被风险信息机制取代,也不应作为固定前提限定所有信息的收集;它的合理位置,是作为风险信息处理链条中的阶段性输出,并作为下一轮信息义务、监管强度和复评程序配置的依据。由此,分类既接受信息检验,也为后续信息收集确定重点。
(二)分类结果的监管效力:附条件部署、梯度干预与义务配置
分类分级作为风险信息处理的下游输出,并不只是对风险事实的认识,还必须具有明确的监管效力。其制度功能在于将已经核验的风险事实转化为差异化的合规义务、部署条件和监管强度。由此,附条件部署、触发式干预和梯度化响应,通常应与分类结果相衔接,并遵循分类所确定的权限、条件和程序。换言之,风险信息先经由制度程序形成阶段性分类判断,再通过分类判断联动不同强度的监管措施,才能使动态调整具有可识别的依据与边界。对于有法定根据的紧急处置,程序可以先行响应,但仍须记录所依据的信息,并在随后及时复核。分类与信息的衔接不能反过来成为延误必要干预的理由。
这首先要求检验一次性准入判断的作用边界。面对高度不确定、持续演化的人工智能系统,若将监管模式理解为“事前审查通过、长期稳定运行”或“事前审查不通过、永久禁止”的二元结构,就会忽略系统投入运行后风险条件的变化。[34]可供考虑的一种制度安排,是以风险证据为基础的“附条件部署”:对需要控制初始部署风险的系统,可限定运行场景、用户范围,或附加监督条件,监管者则根据后续持续回流的风险信息,动态决定是放宽限制、维持条件,还是触发更强干预。初始决定由此成为持续监管的一个节点;运行证据则为后续调整提供依据,使监管条件与风险变化保持联系。[35]
这种附条件部署以实证证据为基础,能够为不确定技术环境中的监管行动保留必要弹性。务实治理研究强调以可观察后果、经验证据和参与机制支持治理。将这一思路用于部署管理,试点和渐进部署便可以为评估措施效果、及时修正判断提供条件。落实到法律制度中,就是根据持续回流的信息调整运行条件,并明确每次调整的依据、范围和期限。
在具体实施中,分类结果还可以通过触发式、梯度化响应产生监管效力。并非所有进入制度的信息都应直接导向最高强度的行政介入,也并非只有在重大损害已经发生之后监管才可以行动。制度可以根据风险信息的类型、所反映风险的严重程度、持续性和可信度,形成一条由轻到重的响应链。例如,当持续监测显示某类场景中误用风险上升时,可以先以行政指导、要求补充说明、加强人工审核等方式介入;当事件报告和第三方评估表明已出现较高概率的系统性失灵时,则可以要求限域部署、暂停特定功能、增加测试与复测;当事故、险情和外部证据共同指向重大风险时,则可进一步触发临时熔断、强制整改、限制特定接口调用甚至暂停上线。
适应式治理的关键,在于监管强度是否真正随证据流动而相应调整。这些措施的列举说明的是干预强度如何随风险判断变化,具体适用仍须有相应权限依据,并履行必要的程序;证据强度本身不能创设监管权力。
在这个意义上,风险信息的利用机制同时也是监管资源配置机制。高频异常、集中投诉、场景快速扩张、重大更新密集和外部研究不断发现问题的系统,应进入更高密度的监督轨道;相反,长期稳定、持续符合要求且经核验未发现重大负面事件的系统,则可以在核对使用规模和信息完整性、不降低保护要求的前提下,适当简化重复性程序。由此,监管资源可以更多投向已有证据表明需要关注的对象。只有这样,适应式治理才构成一种以风险信息调整监管频率和强度的制度方法。
(三)分类与规则的复评机制:从个案信息到名录、规则与标准更新
如果说分类结果的监管效力解决的是风险信息如何产生即时法律效果,那么复评机制解决的则是这些法律效果如何反过来持续修正既有判断。没有复评,风险信息即使被生产、整合并进入具体干预程序,也往往只用于当次处置;动态治理便仍会退化为先定级、后执行的线性结构。真正的适应式治理,需要使新信息既能改变个案处置,也能推动分类、义务和规则的调整。在学习型治理中,分类并不是静态终点,而是一个随证据不断被复核和修正的暂时节点。也正因如此,风险信息处理还应设置通向分类与规则调整的反馈环节。
基于这一思路,未来人工智能治理法治化应明确建立动态调级与规则复评程序。就个案层面而言,当持续汇聚的风险信息表明某一系统的能力结构、部署方式、现实后果或治理状态已经发生实质变化时,原有等级判断就应依照法定触发条件进入复评程序。若长期运行证据显示某类高风险系统在特定场景下风险降低、治理措施成熟,制度应允许申请降级。但审查应结合使用规模、风险暴露程度和报告完整性,不能仅凭事故少或社会争议减弱作出判断;反之,若原本未被视为高风险的系统因部署迁移、组合使用或外部发现而暴露出较严重危害,则应及时启动提级审查。
就程序而言,复评既可由监管机关依职权启动,也应允许义务主体依申请请求降级审查、受影响主体依线索申请专项核查;复评应设定明确的期限与审查范围,并最终以附理由的书面决定明确复评结果。调级亦不意味着义务的简单清零:降级后可设置一定期限的观察期,保留必要的持续监测与报告义务,以防范风险判断的过快松动。这样,分类分级才会真正成为信息处理的下游输出,而不是难以调整的前置标签。这也顺应了全球人工智能立法日益强化的敏捷响应趋向。[36]上述调级与复评程序,可依托第三部分所述的备案与登记枢纽作为共同的信息基础和程序入口:重大更新披露、事件报告与外部发现经由该枢纽归集并触发复评,调级结果也可经由该枢纽依法公示,从而使风险信息的输入端与输出端在同一基础设施上闭合。
更进一步,复评机制还应承担规则自我学习的功能。务实治理研究重视可观察后果、经验检验和多方参与。沿着这一思路,制度不仅应依据现实后果处理个案,还应记录、比较和归纳风险,使治理原则接受持续检验。对公共利益的具体理解,也需要在事实材料与集体讨论中得到说明和修正。转化为法律设计,这意味着事故汇总、险情报告、重大更新说明、复评决定、第三方审计和研究者发现,都不应停留在单个案件或单个部门的档案中,而应进入更高层级的规则评估、名录修订、标准调整和解释更新程序。只有当个案层面的监管利用不断反馈到制度层面的复评,适应式治理才能检验自身规则是否仍然适当。[37]
风险信息的下游处理并不止于监管机关对个案系统作出提级、降级、限域部署或暂停上线决定。更重要的是,经过持续汇聚和类型化处理的风险信息,应当进入国家立法、部门规则和行业技术标准的更新过程。否则,个案中的风险事实即便能够触发一次性干预,也难以形成可供其他案件使用、推广和审查的制度经验。
具体而言,国家立法机关及依法承担统筹职责的监管机关,应当承担风险分类框架、基础信息字段、复评程序和规则更新机制的统合功能。当跨行业、跨场景的风险信息持续显示某类人工智能功能、用途或部署方式具有共同风险特征时,有关机关应在法定权限内,通过名录调整、解释规则、年度风险报告或规范性文件更新,将分散个案经验转化为一般性制度判断。其任务不是替代所有场景中的具体监管,而是形成风险信息向统一分类框架回流的制度入口。
部门监管机关则应承担将一般要求转化为具体场景规则的职责。医疗、金融、教育、劳动用工、公共服务、平台治理等领域的风险信息,在法益结构、证据形态、损害后果和责任链条上并不相同。部门机关应依据上位法,根据本领域持续积累的事故报告、投诉举报、第三方评估、监管抽测和执法经验,对具体场景中的风险阈值、合规义务、人工监督要求、专项报告事项和紧急处置措施进行细化。由此,风险信息才能从抽象等级判断进一步转化为具有场景适配性的监管规则。
行业组织和标准制定主体则主要负责将制度要求转化为技术规范。风险信息一旦被反复验证为具有共性,就需要通过日志字段、事件分类法、测试基准、评估方法、接口规范、报告模板和审计流程等形式转化为可执行、可验证、可互操作的标准。标准制定主体在此意义上并不是替代法律作出价值判断,而是将法律和部门规则已经确立的保护要求与风险判断转化为技术上可运行的实现方式。也正是在国家统合、部门细化和行业标准支撑之间形成连续链条后,风险信息的输出端闭环才不只是个案干预机制,而成为持续更新规则的制度过程。
在这一过程中,受影响主体也应有明确的参与位置。受影响主体能够提供权利受损的经验,也有助于检验制度的正当性。但就欧盟《人工智能法》规定的正式角色而言,其参与仍相对有限,主要集中在投诉、请求解释和吹哨人保护等环节。这提示我们,未来复评机制不应仅仅依赖开发者、提供者和监管机关之间的材料流转,而应允许用户、研究者、社会组织和其他受影响主体在符合相应条件时提出复评线索、触发专项核查并进入相关程序。否则,所谓“闭环”仍然只是企业与行政机关之间的内部循环,而不是开放的、可纠偏的社会学习过程。
最后,复评机制还必须回应一个实际难题:持续修正是否会导致政策瘫痪或规则不稳定。从务实治理的思路看,持续修正与及时决断并不矛盾。通过试点、效果评估和依证据重新判断的程序,制度可以识别值得推广的措施,也能够纠正未取得预期效果的做法。因此,动态调级与规则复评的任务,是把修正的条件、程序和后果规定清楚。只有变更的依据、权限和时限可以预期,持续调整才可能与法律的确定性相容。
综上,风险信息的输出端闭环至少包含三个相互衔接的层次。第一,风险信息应当被转化为依据法定标准作出的阶段性分类分级判断,使分类分级真正成为信息处理的下游输出,而不是先验固定的监管前提。第二,分类分级结果应当联动附条件部署、差异化义务配置、梯度化干预和监管资源分配,使风险事实能够产生即时而适度的法律效果。第三,经过持续积累和类型化处理的风险信息,还应进入国家、部门和行业标准制定主体的规则更新过程,推动风险名录、部门规则、技术标准和复评程序的持续调整。由此,适应式治理才不只是个案层面的灵活处置,而是一套能够将风险信息持续转化为分类更新、监管干预和规则更新的学习型法结构。
五、规范边界:学习型治理的权力配置与程序约束
前文已经说明,风险信息的输出端闭环不仅包括个案层面的监管干预,也包括分类分级、部门规则和技术标准的持续更新。由此便产生一个问题:这些机制由谁运行、权力边界在哪里,以及如何防止技术判断取代公共决策或动态调整变成恣意裁量?换言之,动态调整、附条件部署和持续复评,会改变企业、监管机关与受影响主体之间的关系,因此需要同时明确权限分工、参与渠道和审查程序。学习型治理从一开始就不是单纯的信息工程,而是一个关于权力配置与制度正当性的法结构问题。
(一)受影响主体的法律地位重构:从“被保护对象”到“正式信息源”
现有人工智能规制对受影响主体的规定,较多集中在权利保护和事后救济环节:他们是制度所欲保护的对象,作为持续信息来源的作用却未得到同等充分的制度安排。对以监管学习为核心的适应式治理而言,仅把他们放在事后救济环节,无法充分利用其掌握的风险信息。原因在于,人工智能风险不仅涵盖模型能力指标、企业内部合规记录或监管抽测结论,还表现为用户遭遇的自动化决策错误、被忽视的情境偏差、研究者识别出的越权行为、劳动者或内部员工观察到的组织性合规规避,以及社会组织在集体层面归纳出的权利受损模式。若这些经验始终只能作为事后救济的背景事实,而不能进入风险信息机制的正式输入链条,所谓“监管学习”就会退化为企业报送材料与监管机关内部判断之间的封闭循环。
因此,在我国未来的人工智能治理法治化进程中,应当赋予受影响主体稳定的信息参与权。在“被保护者”和“事后申诉者”之外,还应明确其作为风险信息机制中“正式信息源”的地位。这至少意味着三层制度变化:其一,投诉、举报、申诉和集体反映不应只是权利救济程序,而应被制度化地接入风险事件识别、同类风险归纳与复评触发程序;其二,对研究者、媒体、社会组织和行业观察者所形成的外部评估与公共利益研究,应建立稳定的受理和转化通道,使其能够进入正式的信息整合与核验链条;其三,内部举报人不应只被当作例外性揭弊者,而应在吹哨保护、匿名提交和后续跟踪机制中被视为组织性风险信息的重要来源。只有在这一重构完成之后,风险信息机制才可能吸纳社会经验,而不是过度依赖企业对自身情况的描述。
同时,受影响主体成为“正式信息源”并不意味着其所提交的所有材料都当然具有决定性证据地位。法治化的做法是为其进入制度建立明确的门槛与程序:一方面,应当承认其提交线索、触发核查、请求复评和要求说明理由的程序地位;另一方面,又应通过交叉验证、第三方核验、监管抽测和书面反馈,确保这些信息从经验陈述转化为可审查、可认定、可复核的风险事实。通过这些安排,受影响主体能够稳定地提供信息,其材料也须接受与其他来源相应的核验。参与权与证据判断由此各有规则,而不相互替代。[38]相应的门槛应围绕线索是否具体、是否与系统运行或权益影响相关来设定。要求提交者先完成只有企业或监管机关才有能力开展的技术证明,可能使正式参与渠道在实践中难以使用。
(二)国家法、部门规则与技术标准的功能分层
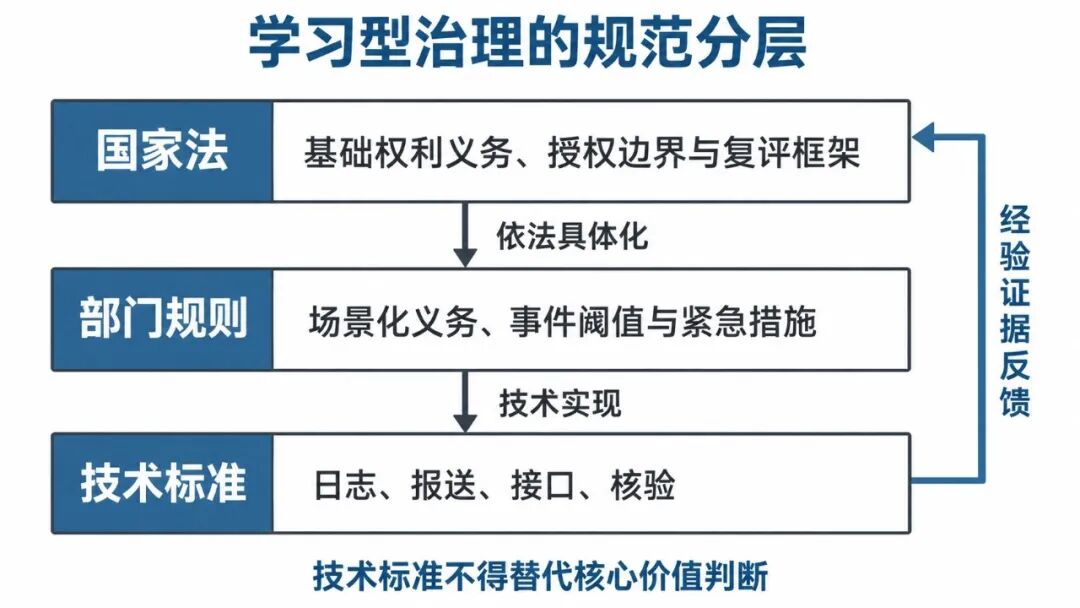
图7|国家法确立基础框架,部门规则结合场景细化,技术标准提供实施支持。
适应式治理要真正运转,还必须回答不同规范之间的分工问题:风险信息机制的不同事项应由哪一层规范组织。若这一问题处理不当,学习型治理就很容易陷入两种相反的失衡状态:要么国家法试图包揽全部场景,以统一条文规定过多技术细节,难以适应实际差异;要么将核心问题过度下放给部门规则、技术标准甚至企业内部合规模型,从而使法律本应承担的统合功能被稀释。正因如此,未来人工智能法制构造必须在国家法、部门规则与技术标准之间形成清晰的功能分层。这里的功能分层须以各类规范的法定权限为前提。国家层面的法律确定基本权利义务与授权边界,部门规则和技术标准在此范围内分别承担具体化和技术支持任务,不能因更新频率较高就获得超出其效力层级的决定权。
首先,国家法应当承担“统合性”任务,而不是“穷尽性”任务。其核心不在于事无巨细地为每一种人工智能场景预制义务,而在于确定风险信息机制的基础框架,例如风险信息的类型划分、信息义务主体、重大更新与事件报告的触发条件、跨主体报送与共享的基本规则、复评程序以及调级与规则更新的基本原则。国家法应为各类学习活动确立共同的权限和程序基础,同时为具体场景中的监管判断保留必要空间。只有先在上位法层面明确这些基础事项,风险信息机制才不会沦为部门规则相互分割、难以衔接的结果。
其次,部门规则应当依据上位法,结合具体场景细化信息义务和监管要求。医疗、金融、教育、平台治理、公共服务等不同领域在风险外溢路径、受保护法益、证据形态和责任结构上差异极大,因此确有必要由部门规则围绕具体应用场景配置更细密的持续评估、专项报告、事件阈值和紧急措施。但这种细化应建立在国家法统一的风险信息骨架之上,在保留场景差异的同时,维持基础术语、信息接口和程序衔接的一致性。如果各部门采用互不兼容的字段、接口和程序,个别领域虽能积累经验,这些经验却难以进入跨部门的风险判断与规则更新。
最后,技术标准应当承担“支撑性”任务。既有研究建议,为确保监管学习及时、有效且正当,应发展开放的、基于标准的、机器可读的信息模型,并尽可能按照可发现、可访问、可互操作与可重用原则(FAIR principles)共享学习成果[39];在保密限制下,则可通过数据空间等方式进行受控共享。这意味着,标准可以重点处理日志字段、事件分类法、元数据结构、机器可读模板、接口兼容性和验证方法等技术化问题,而不应越位承担对核心治理目标和价值排序的裁断。
由此,学习型治理的法源结构应当是“国家法确定基础框架、部门规则结合场景细化、技术标准提供实施支持”。国家法提供统一的制度语言,部门规则回应不同场景的高影响风险,技术标准则负责把制度要求转化为可互操作、可验证、可持续运行的实现形式。只有在这三者之间形成明确的分工与衔接,风险信息机制才不会在上位法中过于抽象,也不会在标准化过程中失去法的统合性。
(三)技术标准的边界:支持信息处理并受规范判断约束
在适应式治理中,技术标准的地位尤其需要谨慎处理。原因在于,学习型治理天然需要大量结构化信息、统一字段、持续记录和跨主体共享,这些需求容易使制度设计过度依赖标准化。一旦如此,风险判断就可能逐渐由技术接口、评测方法和行业内部共识主导,而法律本应承担的价值判断与公共责任则被当作技术实现问题处理。
所谓技术中立规制在实践中往往意味着权力的再分配:立法者为了避免直接处理技术差异,可能倾向于将如何把一般性法律要求适用于具体技术的决定,留给执法机关、标准制定机构甚至受规制者自己。这种分工有其专业性理由,但若缺乏明确边界,也可能限制学习过程,因为事实认识和规范反思相互交织的问题,可能因此被当作纯技术问题处理,从而在看似“中立”的外观下冻结了某些本应进入公共讨论的价值判断。[40]
这一批评对于人工智能治理法治化尤其重要。因为在风险信息机制中,标准具有重要作用:没有标准化的日志字段、事件分类法、报送模板和接口规范,信息的比较、共享与复用就会遇到较高成本;但如果标准进一步决定哪些风险值得优先治理、什么才算足够的基本权利保护、哪些场景应被视为可接受,那么技术标准就不再只是支撑学习,而是替代了法律本身的判断。在这种情况下,风险信息机制表面上更精细、更可计算,实质上却可能把社会争议和政治冲突在未经充分讨论时固定在技术参数中,使反思性学习空间被压缩。
因此,技术标准的边界必须被明确划定。它可以解决“如何记录、如何报送、如何核验、如何互操作”的问题,但不应替代法律去决定“应记录什么样的风险、为何要优先保护何种法益、何种损害阈值应触发更强干预”。前者以技术实现为主要任务,后者包含需要公开说明的规范判断。两者在实际工作中往往交织,例如测试指标的选择会影响哪些损害能够被看见。因此,划定边界并不是假定标准完全不含价值选择,而是要求其中影响保护范围和干预强度的选择,回到有权主体的决定与审查程序。明确上述责任后,风险信息机制才能在提高处理效率的同时,保留公众参与和依法审查的空间。
(四)防止适应式治理异化为恣意裁量:学习型治理的程序约束
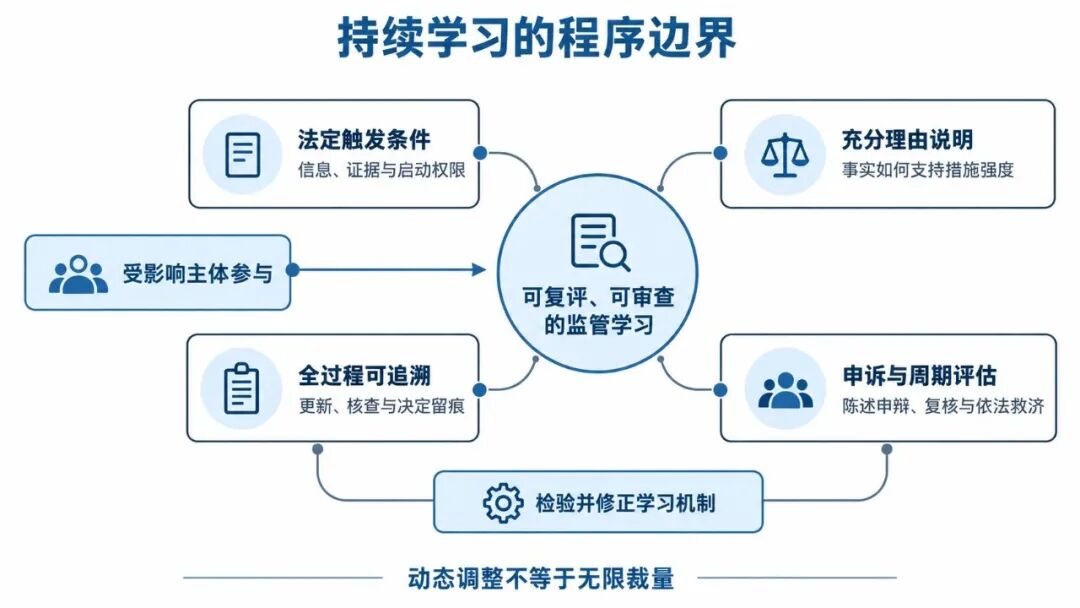
图8|动态治理以法定触发、理由说明、信息留痕和救济复评约束权力,并检验学习机制本身。
适应式治理强调动态调整、附条件部署与持续复评,这些安排有助于回应技术演进,但也会引发另一种典型担忧:当监管不再只依赖一次性判断,而转向持续修正和个案化响应时,是否会给监管机关留下过大的裁量空间。这一问题需要通过制度安排回应。若风险信息机制只强调流动性和灵活性,而缺乏必要的程序边界,那么监管学习就确实可能滑向不透明的自由裁量、不断移动的合规门槛以及难以预测的行政干预。
因此,学习型治理必须同时是一种程序化治理。首先,动态干预必须建立在明确的触发条件之上。无论是补充报送、专项核查、附条件部署、临时限制还是启动复评,都不能仅凭抽象的“风险疑虑”随意展开,而应由法律规定程序启动的基本条件,并由有权机关在授权范围内细化:哪些信息、达到何种证据要求、在何种时间条件下,能够触发何种程序。这样,动态性才不会侵蚀可预期性。
其次,监管机关必须负有充分的理由说明义务。既然适应式治理的核心在于基于新证据修正既有判断,那么凡是提高监管强度、延长限制条件、拒绝降级、启动提级或作出不利复评的决定,都应明确说明其依据了哪些信息、这些信息如何被核验、为何足以支持该项判断,以及为何选择相应强度的措施。理由说明使外部主体能够检验监管机关如何从信息得出结论。缺少理由,公众和法院只能看到决定结果,难以审查其是否依据证据、是否超出必要限度。
再次,风险信息及其处理过程应具有可追溯性。相关研究之所以强调开放标准、机器可读信息模型和结构化共享,不仅是为了效率,也与学习活动的可追踪、可复用和可审计有关。在法治化语境中,这意味着每一次重大更新说明、事件报告、第三方评估、投诉核查和复评决定,都应留下结构化记录,以便后续的行政复核、行政复议、司法审查、规则评估和社会监督。没有留痕,学习过程就无法被检验;没有检验,适应式治理就难以排除选择性使用经验和信息的风险。
最后,适应式治理应内置申诉与周期性评估机制。对被附条件部署、被提高监管强度、被拒绝降级或被要求追加治理义务的主体,应当提供明确的陈述、申辩、复核以及依法申请行政复议、提起行政诉讼的救济路径;对已经运行的风险信息机制本身,则应通过定期汇总、年度报告、公开说明和规则评估,持续审查其是否真正提升了风险识别能力,是否在不同主体之间造成了不合理负担,是否因标准、接口或程序设计而系统性排斥了某些类型的信息。对治理机制本身的再评估,使监管者的学习方式也成为可以检验和修正的对象。
综上,适应式治理要形成能够持续运行的法治结构,最终仍必须回到规范边界的划定上来。其一,受影响主体应有稳定的提交、反馈和参与渠道,其信息须经适当核验后进入监管判断。其二,国家法、部门规则与技术标准之间必须形成清晰分层:国家法确定基础框架和授权边界,部门规则结合场景细化要求,技术标准提供实施支持。其三,技术标准中的规范选择应受有权主体的决定和审查程序约束。其四,动态治理只有在触发条件、理由说明、信息留痕、复评、救济和周期评估等程序约束之下,才能避免滑向恣意。
在这一意义上,未来人工智能治理法治化需要以协调的信息机制,把分散的学习活动连接为可复评、可审查的法律过程。风险分级规则的完善,因而需要与风险信息协调机制的建设同步推进。只有完成这一转向,适应式治理才不会停留在弹性话语层面,而会成为一套既能持续学习、又能受法治约束的法律基础设施。
六、结语:为人工智能治理法治化保留学习能力
面向未来,中国人工智能治理法治化需要把适应式治理落实到具体制度中:风险由谁发现,材料由谁核验,何种信息能够改变判断,改变之后又如何接受复评。随着人工智能不断嵌入基础设施、公共服务、产业组织与日常生活,法律所面对的风险来自技术与具体组织、场景的相互作用。人工智能持续演化并进入不同场景,还可能反过来改变社会行为,使风险边界难以一次划定。在这样的条件下,适应式治理的价值并不在于抽象宣示规则弹性,而在于使制度能够在新的能力形态、新的部署场景和新的损害经验出现时,持续生成、吸纳、核验并反馈风险信息。
这意味着,评价制度是否成熟,除了规则数量和分类精度,还应考察制度能否在新的能力形态、新的部署场景和新的损害经验出现时,迅速将其转化为可讨论、可判断、可修正的法律问题。下一阶段的制度建设,应把风险目录与持续接收、处理新信息的程序连接起来。相应程序应能接收来自企业内部、运行现场、研究社群、社会组织和普通用户的异质信号,并把这些信号整理为可供后续监管和规则评估使用的记录。只有当法律具备这种将意外转化为可治理对象的能力,适应式治理才会从原则性口号转化为现实中的制度秩序。
对于我国而言,现有制度基础提供了进一步整合的机会。可以借助现有备案、登记、标识、日志、投诉、评估等制度基础,进一步发展出一种相互衔接的学习型治理安排。其重点在于通过法规范将备案、登记、标识、日志、投诉、评估、事件报告和标准更新等分散制度资源组织起来,形成一套能够持续运转的风险信息机制。只有当风险信息能够稳定进入制度、触发监管判断、推动分类复评并接受程序审查,适应式治理才不会停留在理念层面,而能够成为中国人工智能治理法治化中的现实制度能力。
归根到底,未来人工智能治理法治化的价值,在于使制度有能力处理未曾预见的变化:新的风险能够被发现和记录,失效的判断能够被复核和修正,新的利益关系能够进入公共决策程序。为上述环节配置明确的主体责任、调整权限和程序保障,才能使持续学习成为我国人工智能治理法治化的一项制度能力。
Risk Information Mechanisms and Institutional Architecture for Adaptive AI Governance
Hong Yanqing, Beijing Institute of Technology
Abstract: Debates on the legal framework for AI governance in China are moving from static risk regulation toward adaptive governance. Adaptive governance requires both the authority to adjust rules and the capacity to obtain risk information continuously, test existing judgments, and revise them when warranted. Organizing information duties around risk categories helps allocate compliance obligations, but may leave emerging risks outside routine reporting channels and limit the feedback of new evidence into classification and rule revision. This article examines adaptive governance through regulatory learning and proposes an institutional mechanism for the continuous production, aggregation, verification, use, and feedback of risk information. On the input side, it distinguishes information about models, deployment, governance, and incidents, and identifies the actors responsible for providing it. Continuous discovery, differentiated disclosure, and standardized integration can turn dispersed materials into facts usable in legal procedures. On the output side, risk classification should remain a provisional judgment based on evidence and legally defined protection goals, linked to conditional deployment, graduated intervention, dynamic reclassification, and review of rules. The division of functions among national law, sectoral rules, and technical standards must be accompanied by stakeholder participation, reason-giving, and procedures for review. These arrangements define the limits of regulatory power while enabling institutions to learn. Risk classification can thus retain its role in allocating obligations and regulatory resources while remaining open to challenge and revision in light of new information, forming a learning-oriented legal structure grounded in the continuous flow of risk information.
Keywords: Legal Institutionalization of AI Governance; Adaptive Governance; Risk Information Mechanism; Regulatory Learning; Risk Classification
尾注
[*] 北京理工大学法学院教授、博士生导师。本文系国家社会科学基金一般项目“国际数据跨境流动的政治化和阵营化对立以及中国的法律应对研究”(项目批准号:23BFX151)的阶段性研究成果。
[1] 参见国务院办公厅:《国务院2026年度立法工作计划》,2026年5月8日,载中国政府网,https://www.gov.cn/zhengce/content/202605/content_7068345.htm。
[2] 参见马长山:《数字治理的法治考量》,载《数字法学评论》2025年第1期;周辉:《人工智能综合性立法及其实现》,载《法学研究》2025年第6期;张凌寒:《人工智能法律治理的路径拓展》,载《中国社会科学》2025年第1期;申卫星:《面向未来的中国人工智能立法:思路与重点》,载《探索与争鸣》2024年第10期;季卫东、赵泽睿:《法律如何实现动态治理——人工智能不确定性的立法应对》,载《学术月刊》2025年第3期;See Regine Paul, “European Artificial Intelligence ‘Trusted Throughout the World’: Risk-Based Regulation and the Fashioning of a Competitive Common AI Market,” Regulation & Governance, Vol. 18, No. 4, 2024, pp. 1065-1082;Marijn Janssen & Haiko van der Voort, “Adaptive Governance: Towards a Stable, Accountable and Responsive Government,” Government Information Quarterly, Vol. 33, No. 1, 2016, pp. 1-5.
[3] 关于原则性监管与弹性规制,参见 Julia Black, “Forms and Paradoxes of Principles-Based Regulation,” Capital Markets Law Journal, Vol. 3, No. 4, 2008, pp. 425-457;Cristie Ford, “New Governance, Compliance, and Principles-Based Securities Regulation,” American Business Law Journal, Vol. 45, No. 1, 2008, pp. 1-60。关于实验主义治理,参见 Charles F. Sabel & Jonathan Zeitlin, “Learning from Difference: The New Architecture of Experimentalist Governance in the EU,” European Law Journal, Vol. 14, No. 3, 2008, pp. 271-327。关于监管沙盒,参见 Armando Guio Español & Pascal D. Koenig, “Regulatory Sandboxes for AI in the Majority World: A Learning-Centric Approach to Legal Adaptation,” Cambridge Forum on AI: Law and Governance, Vol. 1, 2025, Art. e42, pp. 1-20, https://doi.org/10.1017/cfl.2025.10015。关于回应型监管与工具箱思维,参见 Ian Ayres & John Braithwaite, Responsive Regulation: Transcending the Deregulation Debate, Oxford University Press, 1992。
[4] See Araz Taeihagh, “Governance of Artificial Intelligence,” Policy and Society, Vol. 40, No. 2, 2021, pp. 137-157;Araz Taeihagh, “Governance of Generative AI,” Policy and Society, Vol. 44, No. 1, 2025, pp. 1-22;Marijn Janssen, “Responsible Governance of Generative AI: Conceptualizing GenAI as Complex Adaptive Systems,” Policy and Society, Vol. 44, No. 1, 2025, pp. 38-51.
[5] See Claire A. Dunlop, “Implementation Failures as Learning Pathologies,” in Helen Sullivan, Helen Dickinson & Hayley Henderson (eds.), The Palgrave Handbook of the Public Servant, Palgrave Macmillan, 2021, pp. 615-629.
[6] See Colin J. Bennett & Michael Howlett, “The Lessons of Learning: Reconciling Theories of Policy Learning and Policy Change,” Policy Sciences, Vol. 25, No. 3, 1992, pp. 275-294, https://doi.org/10.1007/BF00138786;Claire A. Dunlop, “Pathologies of Policy Learning: What Are They and How Do They Contribute to Policy Failure?” Policy & Politics, Vol. 45, No. 1, 2017, pp. 19-37, https://doi.org/10.1332/030557316X14780920269183。
[7] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787.
[8] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787;另参见 Tom Deckenbrunnen, Alessio Buscemi, Marco Almada, Alfredo Capozucca & German Castignani, “Bathtubs, Boundaries, and Sandboxes: AI Regulatory Learning under Legal Uncertainty,” arXiv:2601.04094v3, June 8, 2026, https://doi.org/10.48550/arXiv.2601.04094。
[9] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787.
[10] See Claire A. Dunlop & Claudio M. Radaelli, “Systematising Policy Learning: From Monolith to Dimensions,” Political Studies, Vol. 61, No. 3, 2013, pp. 599-619, https://doi.org/10.1111/j.1467-9248.2012.00982.x;Malte Möck & Peter H. Feindt, “Learning Mode Misfits in Policy Learning: Typology, Case Study and Lessons Learnt,” Journal of European Public Policy, Vol. 31, No. 7, 2024, pp. 2050-2075, https://doi.org/10.1080/13501763.2023.2280678。
[11] See Sheila Jasanoff & Sang-Hyun Kim (eds.), Dreamscapes of Modernity: Sociotechnical Imaginaries and the Fabrication of Power, University of Chicago Press, 2015.
[12] 参见戴昕:《人工智能治理的两种安全思维:批判与超越》,载《环球法律评论》2025年第6期;See Christophe Lazaro & Marco Rizzi, “Predictive Analytics and Governance: A New Sociotechnical Imaginary for Uncertain Futures,” International Journal of Law in Context, Vol. 19, No. 1, 2023, pp. 70-90, https://doi.org/10.1017/S1744552322000477;Onur Bakiner, “Pluralistic Sociotechnical Imaginaries in Artificial Intelligence (AI) Law: The Case of the European Union's AI Act,” Law, Innovation and Technology, Vol. 15, No. 2, 2023, pp. 558-582, https://doi.org/10.1080/17579961.2023.2245675.
[13] See Ninell Oldenburg & Gleb Papyshev, “The Stories We Govern By: AI, Risk, and the Power of Imaginaries,” Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society, Vol. 8, No. 2, 2025, pp. 1939-1950, https://doi.org/10.1609/aies.v8i2.36686.
[14] See Katarzyna Borkowska & David Jackson, “From Moral Panic to Pragmatic Governance: Reframing AI’s Societal Impacts in Employment, Education, and Ethics,” AI & Society, Vol. 41, 2026, pp. 5371-5383, https://doi.org/10.1007/s00146-026-02921-1.
[15] See Katarzyna Borkowska & David Jackson, “From Moral Panic to Pragmatic Governance: Reframing AI’s Societal Impacts in Employment, Education, and Ethics,” AI & Society, Vol. 41, 2026, pp. 5371-5383, https://doi.org/10.1007/s00146-026-02921-1.
[16] 参见郑戈:《人工智能立法的价值取向与模式比较》,载《交大法学》2025年第6期。
[17] See Regulation (EU) 2024/1689, Arts. 5-7, 50-56 & Annexes I and III;Nathalie A. Smuha & Karen Yeung, “The European Union’s AI Act: Beyond Motherhood and Apple Pie?” in Nathalie A. Smuha (ed.), The Cambridge Handbook of the Law, Ethics and Policy of Artificial Intelligence, Cambridge University Press, 2025;参见丁晓东:《人工智能风险的法律规制——以欧盟〈人工智能法〉为例》,载《法律科学(西北政法大学学报)》2024年第5期。
[18] See Regulation (EU) 2024/1689, Arts. 49, 71, 72 & 73(1)-(5). 本文相关制度分析以该条例2024年公布文本为依据。
[19] See Mélanie Gornet & Winston Maxwell, “The European Approach to Regulating AI Through Technical Standards,” Internet Policy Review, Vol. 13, No. 3, 2024, pp. 1-27.
[20] See Martin Ebers, “Truly Risk-Based Regulation of Artificial Intelligence: How to Implement the EU's AI Act,” European Journal of Risk Regulation, Vol. 16, No. 2, 2025, pp. 684-703.
[21] See Regulation (EU) 2024/1689, Arts. 49, 71-73;Johanna Chamberlain, “The Risk-Based Approach of the European Union’s Proposed Artificial Intelligence Regulation: Some Comments from a Tort Law Perspective,” European Journal of Risk Regulation, Vol. 14, No. 1, 2023, pp. 1-13.
[22] 参见苏宇:《人工智能法律治理的框架选择:从“分类分级”到“模块组合”》,载《中国法律评论》2025年第1期;许建峰、吕昭诗:《人工智能分类分级监管研究——从风险基准到重要性导向的逻辑转变》,载《济南大学学报(社会科学版)》2025年第5期;孙那、屈直:《我国人工智能风险分级分类监管制度研究——域外比较与本土构建》,载《科技进步与对策》2026年第1期,第114-123页,https://doi.org/10.6049/kjjbydc.D9N202507023。
[23] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787;Regulation (EU) 2024/1689, Arts. 7 & 112。
[24] See Cary Coglianese & David Lehr, “Transparency and Algorithmic Governance,” Administrative Law Review, Vol. 71, No. 1, 2019, pp. 1-56;Jakob Mökander, Maria Axente, Federico Casolari & Luciano Floridi, “Conformity Assessments and Post-market Monitoring: A Guide to the Role of Auditing in the Proposed European AI Regulation,” Minds and Machines, Vol. 32, No. 2, 2022, pp. 241-268.
[25] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787;Margot E. Kaminski, “Voices In, Voices Out: Impacted Stakeholders and the Governance of AI,” UCLA Law Review Discourse, Vol. 71, 2024, p. 176.
[26] See Gunther Teubner, “Substantive and Reflexive Elements in Modern Law,” Law & Society Review, Vol. 17, No. 2, 1983, pp. 239-285;Karen Yeung, “Algorithmic Regulation: A Critical Interrogation,” Regulation & Governance, Vol. 12, No. 4, 2018, pp. 505-523;Jia Qing Yap & Ernest Lim, “A Legal Framework for Artificial Intelligence Fairness Reporting,” The Cambridge Law Journal, Vol. 81, No. 3, 2022, pp. 610-644.
[27] 参见《互联网信息服务算法推荐管理规定》第22、24—30条;《互联网信息服务深度合成管理规定》第10—17条、第19—20条;《生成式人工智能服务管理暂行办法》第3、12、14—19条。
[28] 参见崔星璐、姚长青:《我国人工智能系统分级透明制度的构建路径——基于欧盟〈人工智能法案〉风险评估模式的研究》,载《情报杂志》2025年第11期。
[29] See Shayne Longpre et al., “Position: A Safe Harbor for AI Evaluation and Red Teaming,” Proceedings of Machine Learning Research, Vol. 235, 2024, pp. 32691-32710, https://proceedings.mlr.press/v235/longpre24a.html.
[30] See Delaram Golpayegani, Isabelle Hupont, Cecilia Panigutti, Harshvardhan J. Pandit, Sven Schade, Declan O'Sullivan & Dave Lewis, “AI Cards: Towards an Applied Framework for Machine-Readable AI and Risk Documentation Inspired by the EU AI Act,” in Privacy Technologies and Policy, Springer, 2024, pp. 48-72;参见张新宝、魏艳伟:《我国人工智能立法基本问题研究》,载《法制与社会发展》2024年第6期。
[31] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787.
[32] 参见国家互联网信息办公室:《关于发布生成式人工智能服务已备案信息的公告(2026年3月至4月)》,2026年5月13日,载中国网信网,https://www.cac.gov.cn/2026-05/13/c_1780413225190669.htm。
[33] 参见郭雨婷:《构建风险分级导向的人工智能系统备案制度》,载《东方法学》2025年第6期。
[34] 关于务实治理对经验证据和参与机制的强调,参见 Katarzyna Borkowska & David Jackson, “From Moral Panic to Pragmatic Governance: Reframing AI’s Societal Impacts in Employment, Education, and Ethics,” AI & Society, Vol. 41, 2026, pp. 5371-5383, https://doi.org/10.1007/s00146-026-02921-1.
[35] See Charles F. Sabel & Jonathan Zeitlin, “Experimentalist Governance,” in David Levi-Faur (ed.), The Oxford Handbook of Governance, Oxford University Press, 2012, pp. 169-183.
[36] 参见支振锋:《全球人工智能立法的重要关切与未来趋向》,载《比较法研究》2025年第6期。
[37] See Katarzyna Borkowska & David Jackson, “From Moral Panic to Pragmatic Governance: Reframing AI’s Societal Impacts in Employment, Education, and Ethics,” AI & Society, Vol. 41, 2026, pp. 5371-5383, https://doi.org/10.1007/s00146-026-02921-1.
[38] See Margot Kaminski & Gianclaudio Malgieri, “Impacted Stakeholder Participation in AI and Data Governance,” Yale Journal of Law & Technology, Vol. 27, 2025, pp. 247-326;Regulation (EU) 2024/1689, Arts. 27, 77 & 85-87.
[39] See Dave Lewis, Marta Lasek-Markey, Delaram Golpayegani & Harshvardhan J. Pandit, “Mapping the Regulatory Learning Space for the EU AI Act,” arXiv:2503.05787v2, May 28, 2025, https://doi.org/10.48550/arXiv.2503.05787;Susanna-Assunta Sansone, Philippe Rocca-Serra, Mark D. Wilkinson & Lee Harland, “FAIR: Making Data AI-Ready,” in Alok Choudhary, Geoffrey Fox & Tony Hey (eds.), Artificial Intelligence for Science: A Deep Learning Revolution, World Scientific, 2023, pp. 627-640, https://doi.org/10.1142/9789811265679_0033;Mark D. Wilkinson et al., “The FAIR Guiding Principles for Scientific Data Management and Stewardship,” Scientific Data, Vol. 3, 2016, Art. 160018, https://doi.org/10.1038/sdata.2016.18。
[40] See Johann Laux, Sandra Wachter & Brent Mittelstadt, “Three Pathways for Standardisation and Ethical Disclosure by Default under the European Union Artificial Intelligence Act,” Computer Law & Security Review, Vol. 53, 2024, Art. 105957;Marta Cantero Gamito & Christopher T. Marsden, “Artificial Intelligence Co-Regulation? The Role of Standards in the EU AI Act,” International Journal of Law and Information Technology, Vol. 32, No. 1, 2024, Art. eaae011, https://doi.org/10.1093/ijlit/eaae011;Regulation (EU) 2024/1689, Arts. 40-41.
本文转载自微信公众号「网安寻路人」,查看原文。版权归原作者所有,如有侵权请联系删除。