刚刚!首个成体系的Agentic RL中文项目来了!
原创 不要葱姜蒜 2026-11-02 22:39 浙江
Datawhale开源
一、开源初心
我曾经很想深入研究 Agentic RL,但我当时看到的训练方案,动不动就要 4 卡、8 卡,训推一体的复杂度、现有框架(verl、Slime、Areal)高耦合的工程代码,让我迟迟没有动手。后来接触到 Tinker 和 PyTrio 之后才愈发觉得 Train API 是一个面向未来的大模型基础设施,才有机会以极低的门槛把这些 Agentic RL 算法复现学会并跑起来。我复现这 14 篇 Agentic RL 论文中的算法只用了不到两个月时间。现在的论文对我而言,最核心的内容只有几行公式而已,这就是 Train API 的真正魅力,可以剥离所有噪声和干扰项,为研究员和学习者留下最为核心的算法内容。
所以我想,能不能让更多和我一样的人,也能早点开始?把算法讲明白,把代码写简单,把实验的入门成本降下来,让每一个有学习想法的人,可以动手试一试。我觉得研究和学习前沿技术的机会,不该取决于你在哪所学校、哪家公司,或者手里有多少张卡。我们能做的事情可能很小,但目前确实没有成体系的 Agentic RL 学习内容,Only datawhale can do!
我要这天,不再高高在上。Agentic RL 属于每一个想要研究和学习它的人!
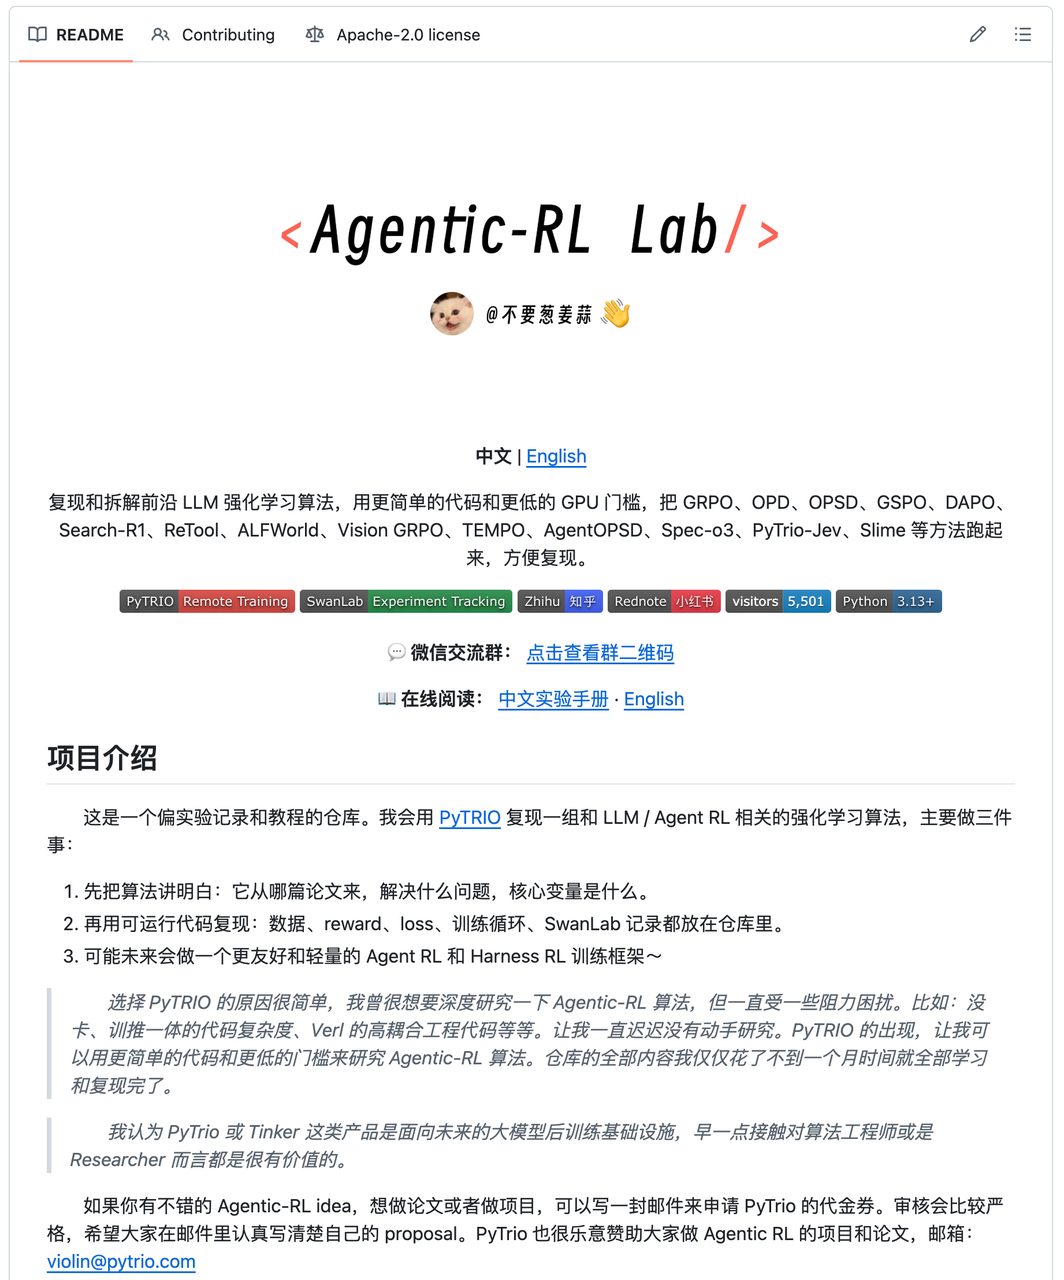
开源地址:https://github.com/datawhalechina/agentic-rl-lab
在线阅读:https://datawhalechina.github.io/agentic-rl-lab/
二、学习指南
如果你有一定的 Python 和深度学习基础,可以按下面四个阶段学习,也可以直接挑感兴趣的方向动手。
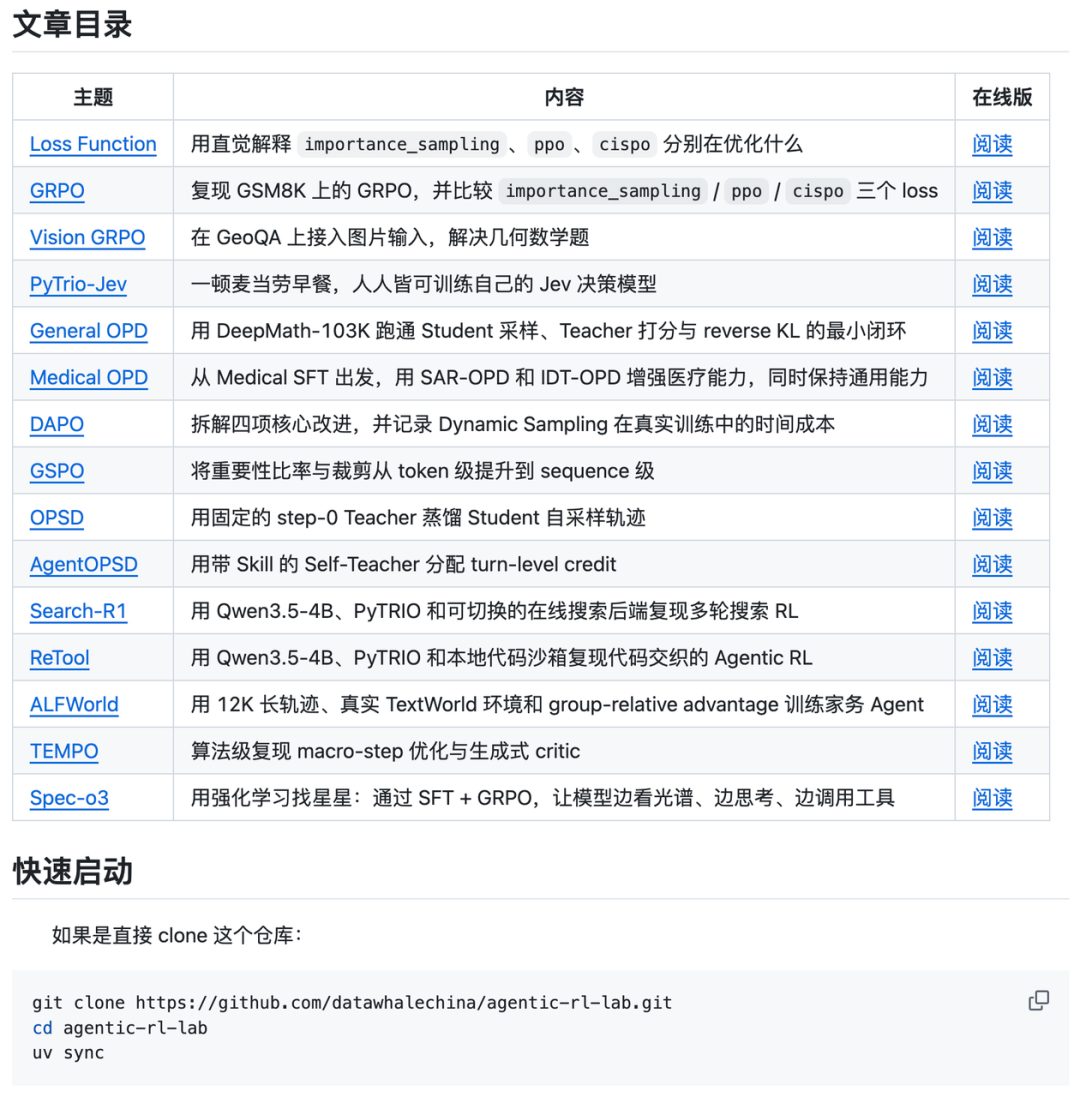
1. 理解一次策略更新:Loss Functions、GRPO、GSPO
从损失函数和 GRPO 开始,跑通采样、奖励计算和参数更新,再看 GSPO 如何从序列级别优化策略。先弄明白一次训练发生了什么,后面的算法就更容易理解。
2. 把教师反馈变成学习信号:General OPD、OPSD
让学生模型自己生成回答,再用教师反馈指导训练。这一部分介绍在线策略蒸馏和自蒸馏,重点看清楚:教师提供了什么信息,这些信息怎样进入 loss。
3. 让模型与外部世界交互:Search-R1、ReTool、ALFWorld
用 Search-R1 学习主动搜索,用 ReTool 在解题过程中调用 Python,再用 ALFWorld 尝试连续行动。结合具体任务,理解工具交互、轨迹组织和奖励设计。
4. 探索更复杂的任务:Vision GRPO、TEMPO、AgentOPSD、Spec-o3
从看图做几何题,到长轨迹优化、不同动作的信用分配,再到调用工具分析天体光谱。可以根据兴趣选读,看看前面学到的方法怎样用于更复杂的问题。
此外,如果你对意图分类、工具路由等决策任务感兴趣,也可以看看 PyTrio-Jev,尝试训练自己的决策模型。
建议把文章和代码对照着看,先跑一个小规模实验,观察训练记录和模型输出。熟悉之后,再换数据、改奖励、做对照,试着验证自己的想法。
三、故事分享
前几天在小红书分享记忆张量(MemTensor)的论文,评论区有位朋友说,他已经入职这家公司,面试时简历里写的就是本仓库的 AgentOPSD!加上好友才发现,刚入门时耐心帮他答疑的 Datawhale 思语,也是我的好朋友。哈哈,世界真小。看来学会 Agentic RL 是真能找到工作啊🤔。目前确实没有其他更好 Agentic RL 教程,Only datawhale can do!
写在最后
希望大家学完之后,再看到一篇感兴趣的论文,或者脑子里冒出一个想法时,可以动手试一试。结果不一定符合预期,但知道一个方法在哪些情况下有效、哪些情况下不太有效,本身就很有价值。
欢迎大家提 Issue、修正文档、分享实验结果;想贡献新的算法章节,也可以先来聊聊选题。期待有一天,能在这里读到你写的复现笔记~
开源贡献,点赞在看↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。