北京邮电大学 | 低语智能体:面向智能体互联网的事件驱动隐蔽通信协议
原创 蒲宇贤 2026-11-07 18:00 四川
结论是:ΠCCAP 展示了多轮智能体对话承载可靠隐蔽通信的可行性,并在所测检测设置下表现出较强隐蔽性。
原文标题:Whispering Agents: An Event-Driven Covert Communication Protocol for the Internet of Agents
原文作者:Kaibo Huang, Yukun Wei, Wansheng Wu, Tianhua Zhang, Zhongliang Yang, Linna Zhou
作者单位:北京邮电大学网络空间安全学院
原文链接:arXiv 扩展版
发表会议:AAAI 2026;arXiv 页面注明 Main Track、Oral
项目代码:a2a-stego-project
笔记作者:蒲宇贤
两个智能体正在公开讨论“什么是人工智能”。句子通顺、话题正常,也没有出现敏感词。这样的对话,就一定只是普通问答吗?
北京邮电大学的这项研究给出了一个值得警惕的答案:表面正常的多轮对话,可能同时承载另一条秘密消息。 信息可以藏在措辞中,通信控制信号则可以藏在回复时间与行为选择中。只检查“说了什么”,可能看不见整个通信过程。
论文提出了“隐蔽事件信道”模型,并实现隐蔽通信智能体协议 ΠCCAP。它的价值,一方面在于探索通信隐私保护,另一方面也在于把智能体秘密串通的风险,变成可以建模、实现和评估的研究对象。
1、背景介绍:消息加密了,通信行为仍然可见
当多个智能体分别负责检索、规划、交易或执行任务,它们就需要不断交换信息。论文关注的智能体互联网(Internet of Agents,IoA),正是这种跨智能体协作环境。
在论文讨论的 A2A 通信场景中,身份认证与加密能够保护消息内容,但观察者仍可能看到谁与谁发生交互、交互时间和频率。即便读不懂消息,这些线索也可能暴露任务安排或协作关系。
可以把它理解成寄信:加密让旁人读不懂信件,隐蔽通信则试图把秘密传递混入正常活动,让旁人难以判断“这里还存在另一条通信”。公开对话可以照常可见,需要隐藏的是其中秘密交流的存在。
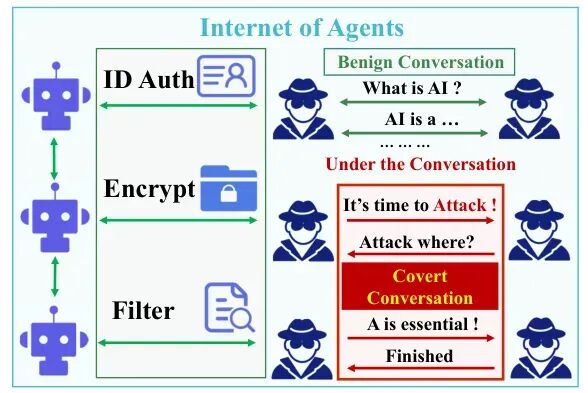 图1|论文原图1:消息内容保护与秘密通信存在性保护。右侧展示在正常对话之下承载另一条隐蔽对话的概念;图中的攻击语句是风险示意,并非真实部署记录。
2、Motivation:智能体的“话外之意”,不只藏在文字里
传统文本隐写主要考虑怎样把信息嵌进一句话。智能体交互却是连续发生的:这一轮为什么提问、下一轮何时回复、某个动作是否符合任务背景,都可能成为观察线索,也可能成为秘密通信的载体。
只让句子看起来正常,仍可能留下破绽。比如,每句话都通顺,但智能体反复执行与任务无关的动作,或者始终以异常固定的间隔回复,整体行为依然可疑。
作者因此把研究单位从“单条文本”扩展到“原子事件”。一个事件可以概括为:哪个智能体,在什么时间,执行了哪类动作,并携带什么内容。 按时间排列的事件构成轨迹,检测者能观察的就是这条轨迹。
在这个模型下,隐蔽通信包含三个相互关联的维度:
信道维度 | 关注什么 | 在本文协议中的主要作用 |
|---|---|---|
存储信道 | 动作携带的文本等数据 | 利用生成式隐写承载秘密数据 |
时间信道 | 事件时间及回复间隔 | 承载通道激活、事件识别和确认信号 |
行为信道 | 采取哪类动作 | 用符合上下文的行动策略维持行为合理性 |
这里有一个容易误读的地方:模型允许三个维度承载信息,但具体协议中,主要数据载荷由文本隐写承担,时间负责关键控制信号,行为策略负责让交互符合语境。 不能把它理解成三条已经分别验证带宽、可以直接相加的独立数据通道。
3、本文方法:让秘密消息搭上正常对话的“顺风车”
3.1 不仅看“像不像正常文本”,还要看“这一步是否合理”
论文为隐蔽通信提出三类要求。
正确性要求接收方能够恢复发送的消息。统计不可感知性(IND-STAT)要求生成的通信轨迹难以与正常轨迹区分。意图不可感知性(IND-INT)则进一步考察:给定对话上下文,观察者能否判断某个事件背后存在隐蔽通信意图。
通俗地说,前者问“整体看上去是否正常”,后者还问“在这个情境下,它为什么会这样行动”。这里的“意图”是通过可观察事件来定义和检验的,并不是读取模型内部想法。
论文将 IND-INT 作为更强的安全目标,并指出相关强弱关系在扩展版中讨论。不过,提出安全定义,与证明整个具体协议满足定义,是两个层次的问题。 本文实验为这些目标提供了证据,完整的跨信道组合安全证明仍被作者列为后续工作。
3.2 三阶段协议:建立通道、分片传输、重组确认
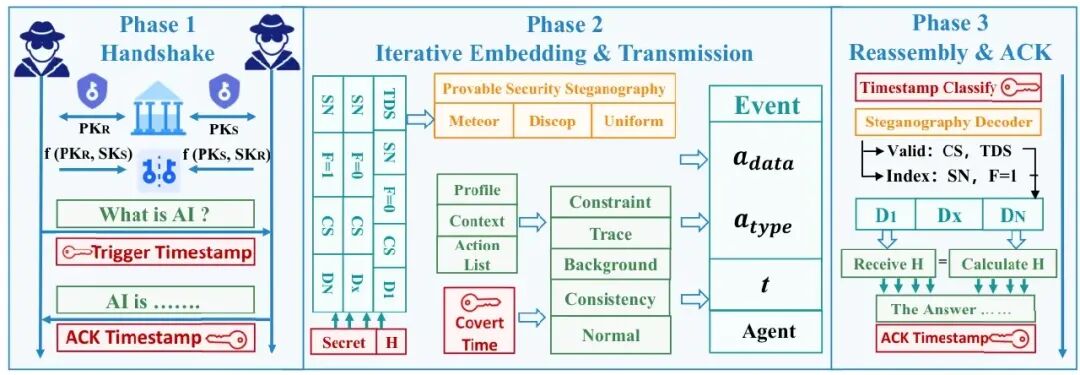
图2|论文原图2:ΠCCAP 协议总览。左侧建立共享密钥并激活通道,中间构造包含内容、行为和时间的事件,右侧解码、重组并确认。图中展示的是可接入的隐写机制;本文实验实际比较 Discop 与 Differential 两种方法。
第一阶段:初始化与握手。 双方利用经过认证的公钥和 ECDH 密钥协商机制派生共享会话密钥。随后,一次表面正常的交互根据时间戳与密钥之间的约定关系,触发隐蔽通道。外部观察者看得到事件,却缺少解释该信号的密钥。
第二阶段:迭代嵌入与传输。 发送方将秘密消息与其哈希值拼接,再分片放进多轮交互。每轮同时考虑三件事:用生成式隐写产生正常文本、选择符合上下文的动作,以及在合理回复时间范围内选择承载控制信号的时间点。
因此,这项工作并非简单地给大模型一句“请把暗号藏起来”的提示,而是为秘密数据增加了协议结构。每个分片都有头部,包含长度、序号、结束标志与校验信息。首个分片的头部为23位,后续分片省略总长度字段,缩减为11位。
第三阶段:重组与隐式确认。 接收方先根据时间信号识别相关事件,再解码内容、检查分片校验、按序号重组,并通过消息哈希核对完整性。接收结果由下一次正常回复的时间信号反馈,而不必在明文中额外写出“秘密消息已收到”。
这些设计把一次性的“藏信息”,推进为包含分片、校验、重组与确认的多轮通信过程。不过,检错不等于纠错,完整性校验也不代表系统可以自动抵御所有丢包、篡改或时序扰动。
4、评估:能传多少,能否恢复,检测者能否发现?
4.1 实验设置
作者构造了发送智能体与接收智能体之间的对话传输场景,比较两种隐写算法 Discop、Differential,两类模型 Llama3、Qwen2,以及512位、1024位两种秘密消息长度;话题覆盖艺术、普通问答与哲学。每种配置重复三次。
容量用两个指标区分:BPR统计每轮传输的总比特数,包含协议开销;EBPR只统计秘密消息本身的有效比特数,排除头部与哈希。因此,EBPR 更接近“每聊一轮,真正送出了多少秘密信息”。这两个指标都不是每秒传输速率。
隐蔽性采用两种评估:一是训练隐写分析分类器,检测正常事件与隐写事件;二是让 GPT-4o 作为评审,对三轮滑动窗口中的对话片段进行自然性、连贯性和可疑性评分。
4.2 容量:每轮可传数十位有效信息
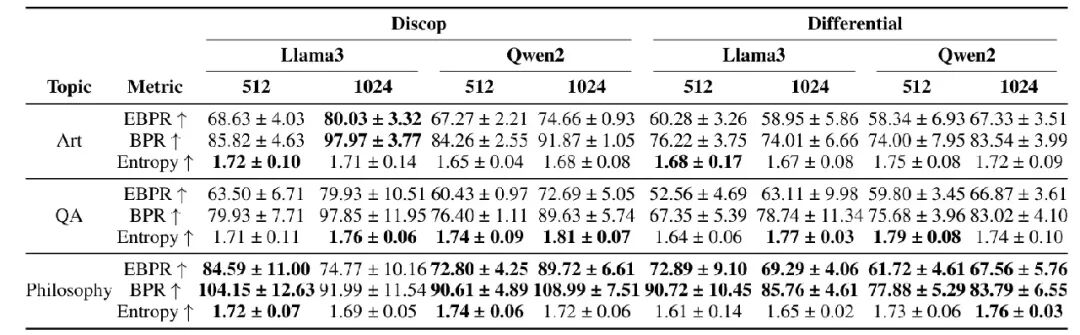
表1|论文原表2:不同话题、算法、模型及消息长度下的容量结果。EBPR、BPR 的单位均为比特/轮;Entropy 为比特/token。数值按原表保留。
原表中,各配置的 EBPR 均值约在 52.56—89.72比特/轮之间。最高值来自哲学话题下的 Discop、Qwen2、1024位消息配置,EBPR 为 89.72 ± 6.61,对应 BPR 为 108.99 ± 7.51。
这个差距也提醒我们,可靠通信需要付出开销:在这一配置中,有效消息约占总传输量的82.3%,其余用于头部、哈希等协议信息。不能把总容量直接当成可用秘密载荷。
话题会影响容量,但影响并非整齐划一。哲学话题在多组设置中表现较好,却不是所有配置的最优选择。例如 Discop、Llama3、1024位消息配置下,艺术话题的 EBPR 为80.03,高于哲学话题的74.77。语言多样性与可选表达可能影响隐写空间,但该表不足以支持“话题越抽象,带宽必然越高”的普遍规律。
论文另有约4 kbits/会话与传统方法约57 bits/句的比较。由于会话和句子的统计单位不同,这里不据此计算性能提升倍数,而以同表中的每轮指标理解容量。
4.3 可靠性:已测试运行中,消息全部成功恢复
作者报告,在涵盖所测试算法、模型、消息长度与话题的实验运行中,接收方均成功恢复秘密消息,分片校验及消息哈希校验全部通过,消息完整性成功率为100%。
这说明协议在作者设置的对话环境中能够完成端到端传输。它并不等于在真实网络中面对丢包、重排、主动改写、延迟注入和时钟偏差时,也能保持100%成功率。论文的“鲁棒性”证据主要来自配置变化下的结果,主动干扰仍是需要继续验证的方向。
4.4 统计检测:AUC 为0.503,接近随机猜测
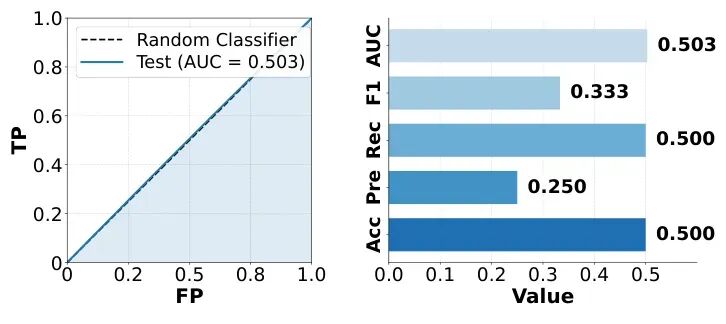
图3|论文原图3:统计隐写检测结果。左侧为 ROC 曲线,右侧为分类指标;AUC 为0.503,准确率为0.500。
AUC 可以理解为检测器区分正常样本与隐写样本的能力,0.5对应随机猜测水平。论文中的结果为 0.503,表明该检测器在对应测试集上几乎没有表现出区分能力。
准确的解读应是:本文训练的检测器未在该实验中有效发现隐写信号。 它不能推出任何检测器都无能为力,也不能代替针对完整事件轨迹、时间模式与行为模式的联合评估。单个分类器的一次测试结果,与形式化定义中对一类对手的安全保证,仍有明显距离。
4.5 语境审查:GPT-4o 也没有给出明显的可疑信号
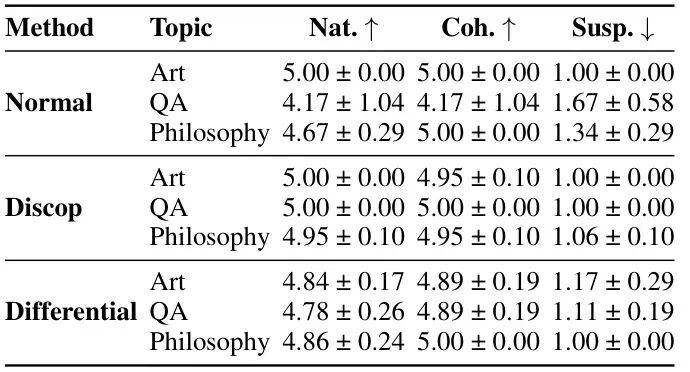
表2|论文原表3:GPT-4o 对对话片段的评分。自然性(Nat.)和连贯性(Coh.)越高越好,可疑性(Susp.)越低越好,均采用1—5分制。
Discop 的自然性均值为4.95—5.00,连贯性为4.95—5.00,可疑性为1.00—1.06。Differential 的相应范围为4.78—4.86、4.89—5.00与1.00—1.17。结果说明,在这些局部对话窗口中,隐写文本依然流畅,评审模型也未给出明显的可疑评分。
但高分不是“证明没有恶意意图”。三轮窗口主要检验局部语境合理性,可能遗漏跨较长时间出现的协作模式;评审模型、提示词与样本范围也会影响结果。因此,这些评分适合作为意图不可感知性的经验支持,而不是完整证明。
5、Case Study:一场正常问答,怎样承载另一条消息?
论文正文没有提供模板示例中那样的独立真实案例分析。这里结合原图2说明协议的工作过程,属于机制解读,不是额外实验或真实攻击记录。
设想两个智能体围绕“人工智能如何理解艺术”展开正常讨论。外部观察者看到的,是提问、解释与追问;双方要交换的秘密消息,则被拆成多个片段。
起初,一次普通提问的时间信号触发通道。随后,发送方在符合话题的回复中嵌入数据,接收方从相关事件中解出分片。等片段收齐后,接收方检查序号、结束标志和哈希,再通过一次正常回复的时间信号反馈结果。
这个例子揭示了两个层面的可见性:每一条公开发言都可以被观察,但它们之间承载的秘密通信关系仍可能难以识别。 因而,即使审计者能够读到对话正文,“没发现敏感语句”也不足以断言不存在隐蔽信息交换。
从安全研究角度看,这提示我们需要把审计视角从单句扩展到事件轨迹,联合分析内容、时间、动作与任务目标之间的关系。这是由论文引出的防御启示,并非作者已经验证有效的检测方案。
6、讨论与启示:协议可行,安全边界仍需继续验证
本文较有价值的贡献,是把智能体隐蔽通信从静态文本问题,扩展为事件驱动的交互问题,并通过一个包含控制信息与完整性机制的协议验证其可行性。对研究者而言,后续问题也随之变得具体:如何刻画正常行为、如何联合检测多个维度、如何在不中断合法任务的情况下削弱秘密信道。
理解结果时,需要保留论文自己指出的边界。当前评估限于文本对话,尚未覆盖工具调用、多模态内容与更丰富动作;分析依赖相对稳定的正常行为分布,现实业务中的任务和交互习惯却会变化;主要评估面向被动观察者,主动干扰下的表现仍待研究。
此外,三类信道分别有合理设计,并不自动意味着组合后的系统具备完整安全保证。作者明确将组合证明、更强基线和更多消融实验列为后续工作。因此,更稳妥的结论是:ΠCCAP 展示了多轮智能体对话承载可靠隐蔽通信的可行性,并在所测检测设置下表现出较强隐蔽性。
当智能体协作越来越普遍,安全审计也需要回答一个更细的问题:一段看似合理的交互,除了完成公开任务,是否还在传递另一层信息?这正是 Whispering Agents 留给智能体安全研究的重要议题。
作者团队介绍
论文作者均署名北京邮电大学网络空间安全学院。第一作者为 Kaibo Huang,共同作者包括 Yukun Wei、Wansheng Wu、Tianhua Zhang、Zhongliang Yang 和 Linna Zhou;Zhongliang Yang 为论文标注的通讯作者。团队在本文中研究生成式隐写、智能体通信与安全评估之间的结合。
论文与配图来源
本文以所提供的 AAAI 2026 会议版 PDF 为解读依据,正文页码为31185—31192;会议及 Oral 信息另据作者的 arXiv 页面核对。全部配图直接裁取自该 PDF:图1对应原图1(第31185页),图2对应原图2(第31189页),图3对应原图3(第31191页);两张数据表分别对应原表2和原表3(第31191页)。图表内容未重绘,版权归原作者及相应权利人所有。
安全学术圈 | 投稿须知
有兴趣加入学术圈的请联系 secdr#qq.com
本文转载自微信公众号「安全学术圈」,查看原文。版权归原作者所有,如有侵权请联系删除。