李沐:我带着新模型回来了!
原创 Datawhale 2026-11-08 23:25 浙江
像人、有用、够便宜。
Datawhale干货
最新:李沐,BosonAI联合创始人
一、沐神回归 B 站了!
辣个男人终于又带着新模型回小破站讲技术了!
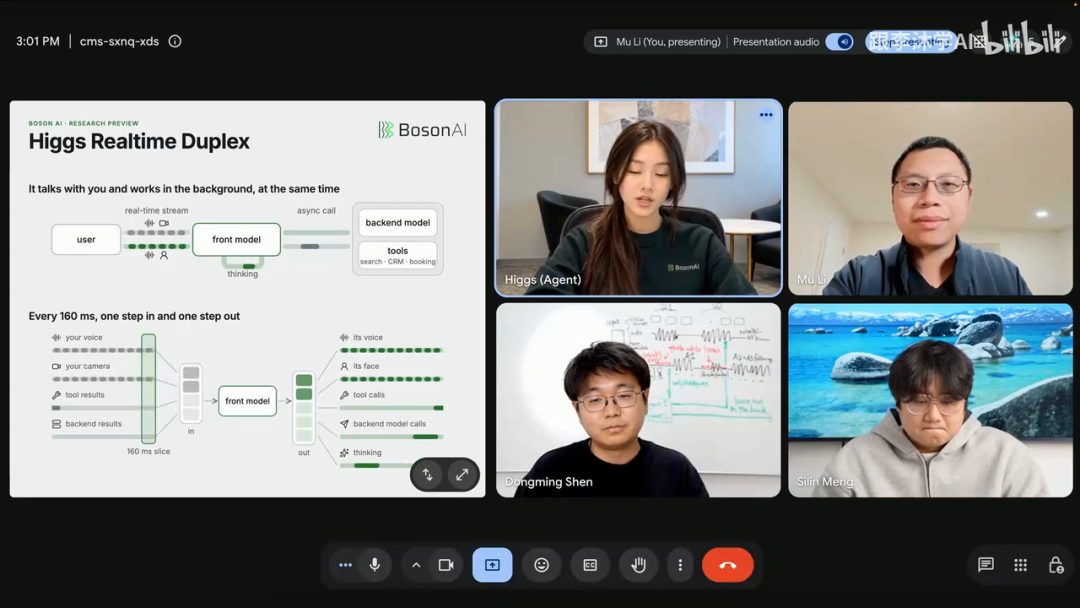
这次沐神聊的是现在硅谷最火的方向之一:全双工(Full-Duplex)实时多模态交互。
现在的大模型光会「你一句、我一句」地问答已经不够看了,真正的全双工,是要让 AI 像真人一样持续接收声音和画面,自己还带一张实时生成的脸,一边跟你聊天,一边把交代的任务完成了。
先看视频里的两段演示。
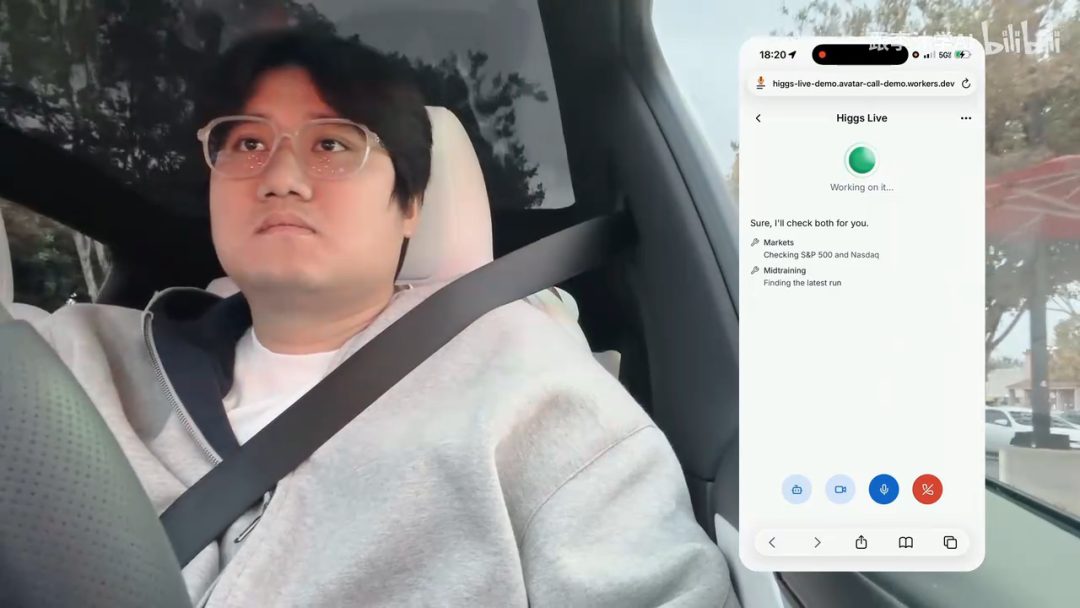
一段是在车里,用户先让 AI 查股市、看看自己正在跑的训练任务,转头就跟快餐店员点餐。点单的时候 AI 安静听着,绝不插嘴;等点完单,它才接上话汇报股价和 GPU 训练进度。到了取餐口,用户突然问:“我刚才点 animal-style 薯条了吗?” AI 马上回答:没有,它听见了刚才的点单。
另一段是英语陪练。用户看着照片描述旅行经历,AI 会在计时结束后叫停、指出语法问题;发现用户把“vest”读成了“west”,它还会直接看着用户的嘴型提示,发 v 的时候上牙应该怎么接触下唇。
一个像真人的模型,沐神觉得有三大要求:像人、有用、够便宜
真人聊天通常在对方说完 200 毫秒内就能接上话,甚至边听边附和;聊天往往是为了办事;而且如果以后大家每天要跟 AI 聊好几个小时,聊 1 小时的成本,最多不能超过人工时薪的十分之一。
二、沐神教你手搓全双工大模型
传统的语音助手大家都很熟:用户开口后,先由 VAD(语音活动检测)判断有没有人说话、有没有说完,接着 ASR 把语音转成文字,大语言模型生成回复,最后交给 TTS 合成声音。
这套架构的好处是每个模块都能单独升级,但缺点也很明显:模块接得越长,等待就越久。确认说完要等几百毫秒,后面三个环节再串起来跑,延迟很容易落到 1.5 到 2 秒。
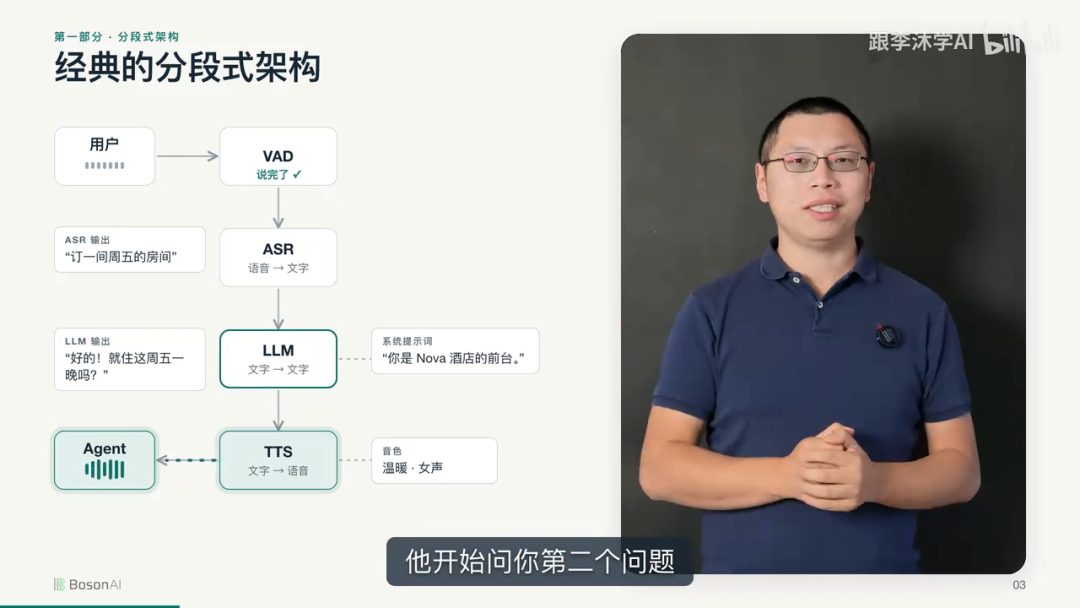
而且停顿不一定代表说完。比如「我要订一个……去上海的航班」,用户中间只是在想目的地,普通 VAD 一检测到停顿就会抢话;就算换上能判断句意完整度的语义 VAD,后面的模块还是得排队等着。同时,声音里的很多信息也在这个过程里丢了,比如一个人说话的情绪、周围还有没有别人。一旦被 ASR 转成标准文字就全没了,TTS 拿到回复文字,也不知道该用什么语气和节奏读出来。
所以第一步,就是砍掉中间转文字的环节,做端到端。
把 ASR 和 TTS 各拆开一次就很容易看懂:ASR 先用编码器把连续语音切成向量,再用解码器转成文字;TTS 则是从文字和参考声音出发生成音频表示(比如团队之前讲过的 Higgs Audio 用的音频 token),再交给音频解码器还原成声波。这当中,ASR 的解码部分和 TTS 处理文字的部分,在架构上本来就和语言模型高度相通。
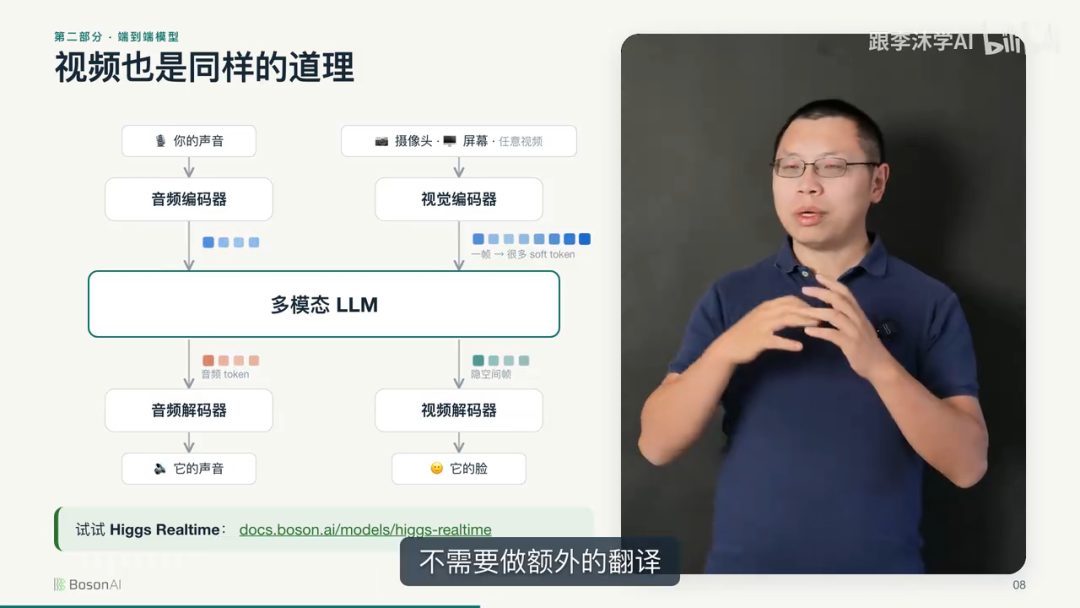
既然如此,沐神团队干脆把 ASR 的解码端、TTS 的文字处理端和中间的大模型主干合二为一:输入端只保留语音和视觉编码器,输出端只保留音频和视频解码器。毕竟文本大模型本来就会把输入 token 转成向量再交给主干处理,语音和画面经过编码器后,同样能以向量的形式直接进主干,算完再直接交给另一头的解码器生成声音和表情画面。
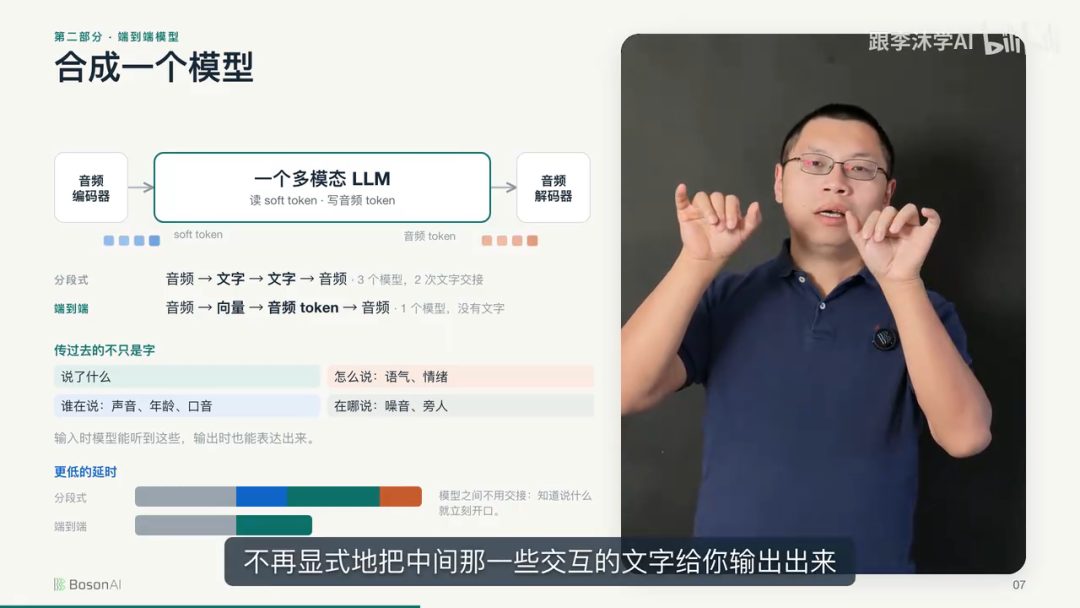
李沐把这个过程比作说外语。当一门外语足够熟练时,听到问题不需要先在脑子里翻译成母语(中间文字),就能直接用外语组织回答。打通文字、声音和画面的语义联系后,模型不仅能直接利用声学信息控制说话语气,加上网络开销后的延迟也降到了 0.7 到 0.9 秒。
但这就引出了新的问题:端到端虽然快了,可系统里依然有 VAD,还是得按「一问一答」的轮次来工作。
用大模型的 prefill 和 decode 来解释就很清楚:传统设置把处理输入和生成回复分成了两大块,用户说话时模型做 prefill,等用户说完了,模型才进入逐个生成 token 的 decode 阶段。但真实聊天往往是交错的——对方说到一半,人已经开始理解、点头附和,发现需要查东西甚至已经提前动手了。
怎么打破这种一问一答?团队的做法很直接:不按句子切轮次了,直接把时间切成 160 毫秒的窗口!
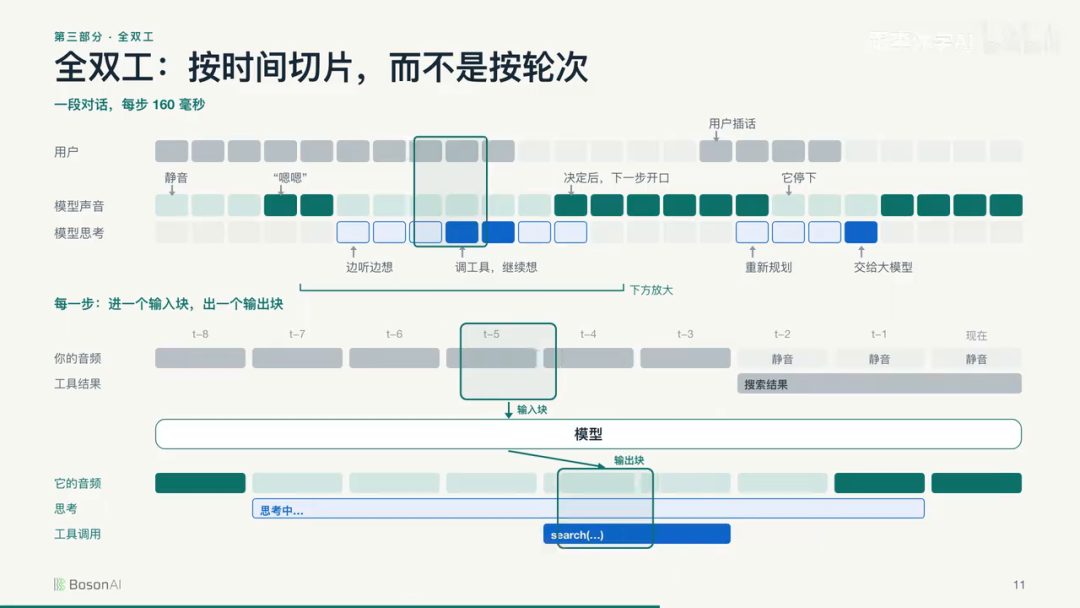
在 Higgs Realtime Duplex 里,模型每 160 毫秒处理一个窗口,接收这段时间里的新信息(语音、画面或工具返回的结果),同时预测下一个 160 毫秒窗口要输出的内容。这里有个容易忽略的细节:用户当前听到的这一小段声音,其实是模型在上一个窗口提前生成好的。模型一边接收现在的输入,一边准备下一个窗口的输出,必须在当前窗口播完前算好下一段,才能把听和说无缝接起来。
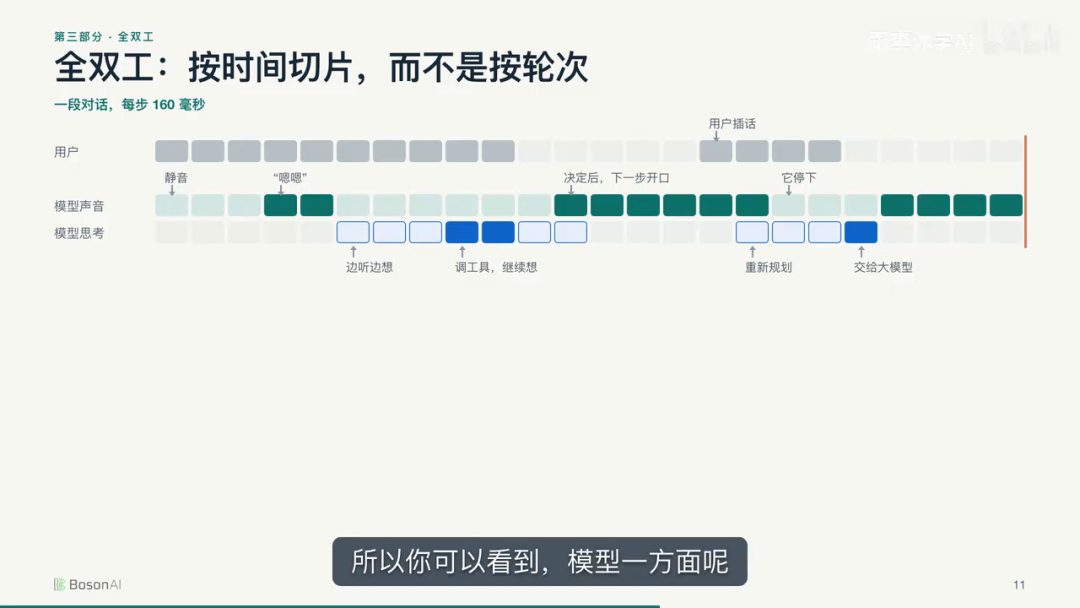
而且,这一小段输出完全可以是静音。用户连续说话时,模型判断暂时不用开口,就连续几个窗口输出静音保持安静(同时画面还在持续输入,模型一直在看);听了几个窗口觉得该给个反馈,就输出一声「嗯哼」附和;等用户停下来,它已经有了一部分判断,可以马上接话;如果用户中途突然插话,模型在新的窗口收到输入,就立刻调整回答方式,让后面的窗口停下声音。
听和说能同时进行了,但每个窗口只有 160 毫秒,遇到需要多想一会儿的问题,或者要花几秒钟查资料、订票,怎么保证不冷场?
团队的办法是,把思考 token 和工具调用也拆开塞进 160 毫秒的时间窗口里:
分段思考:模型不用在一个窗口里把事情全想完,而是在有限的窗口时间里生成一部分思考 token,没想完的放到下一个窗口继续,让思考随着用户的新输入一步步往前推。
异步调工具与分段回复:听用户说到一半发现需要用工具,不用等他说完,直接在当前窗口发起调用让工具在后台跑;返回的长结果也可以分批放进后面的输入窗口。哪怕工具还没跑完,模型也能先根据已经确认的信息说出前半句,等新结果到了再组织后半段。
前端交互 + 后台大模型协同:遇到更复杂的难题,前端模型还可以选择呼叫后台更大、更强的模型来处理,自己继续留在前台陪用户聊天,等结果返回后再接进对话。
不过李沐也特别点出了这套设计的边界。他拿 Thinking Machines Lab 的交互模型做了个对比:对方的做法是前端模型只管纯聊天,把所有思考和工具调用全交给后台大模型。那样虽然好训练,但如果每个问题都交出去,后台推理模型动辄算上十来秒,用户每次都得干等,或者只能听前端先说一段没什么信息量的套话,而且每轮都调大模型成本太高。所以 Higgs 的原则很明确:前端主模型自己必须解决绝大部分思考和工具任务,只在真正搞不定时才找后台帮忙。
架构定下来了,接下来怎么训练前端模型,让它同时学会「什么时候开口」和「怎么调工具办任务」?
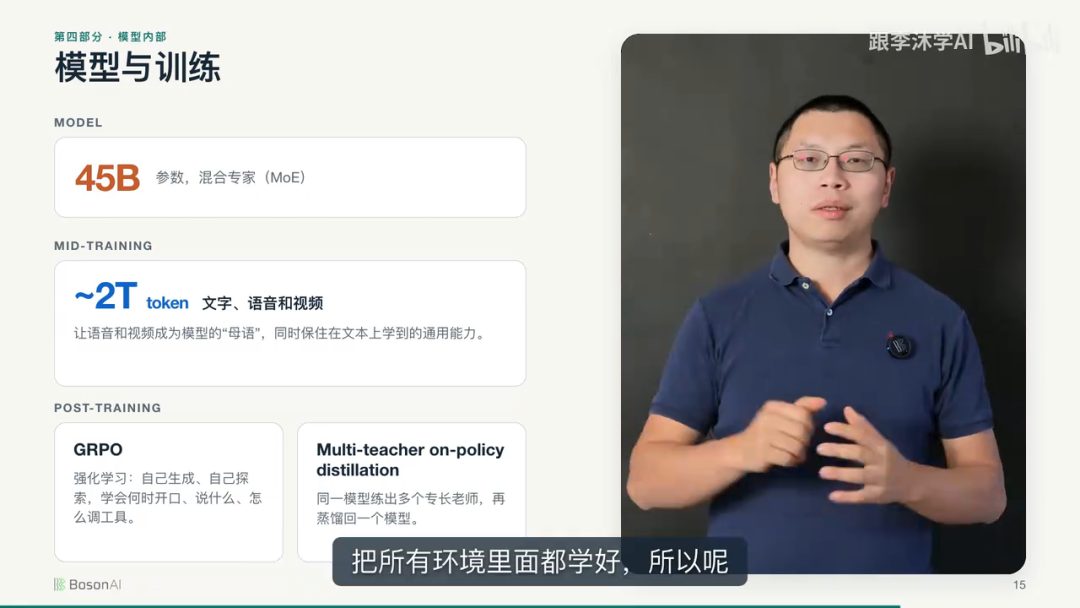
团队试过更大的模型,评测表现确实更好,但实时推理的成本也更高;权衡能力和成本后,他们选了一个 45B 的 MoE 作为前端主模型,训练分三步走:
首先是 Mid-training。从已经完成文字预训练的模型开始,一边继续喂文字保住原有的理解和推理能力,一边加入大量语音、视频数据(总计约 2 万亿 tokens),把听和看直接练成模型熟悉的「母语」。
接着是后训练,主要用了两种方法。第一种是基于 GRPO 的强化学习。在实时交互里,一句回复不仅内容要对,接话的时机也得对。团队把模型放进不同的交互和工具环境里生成、探索,用户思考时要能等、需要工具时要及时调,通过环境反馈直接把这些交互行为练出来。
第二种是多老师同源蒸馏。团队发现,一个 45B 的模型很难同时在所有环境里都学好。这就好比一个徒弟很难同时练好所有功夫,于是他们把相似的环境归成一类,先用强化学习分别训出擅长不同方向的专项模型(比如一个更会把握对话节奏,另一个更擅长调工具做任务),再让这些专项老师一起教同一个学生模型。
沐神提到,这种方法要求老师和学生有足够的相似性,差别太大反而学不会;而用同一个基底模型分别强化后再做在线蒸馏,就很容易见效。在此之上,团队还加了一轮模拟环境里的自我迭代,在带有真实延迟、抢话重叠和背景噪音的环境里继续打磨。
最后还有一个很现实的问题:全双工模式下,哪怕没人说话,模型也在处理每一个窗口,音视频上下文越积越长,怎么才能让人“聊得起”?
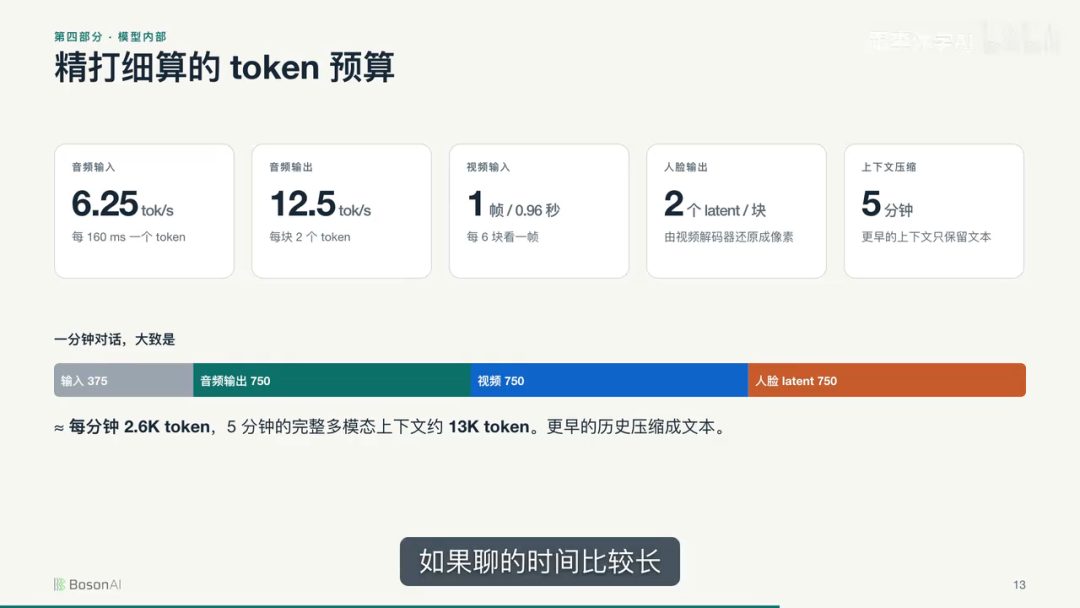
要把每小时的交互成本压到人工时薪的 1/10 以下,就得在 Token 开销上精打细算:
压缩音视频 token:每 160 毫秒的窗口里,音频输入只用 1 个 token 表示(每秒 6.25 个 token),输出对应 2 个音频 token(每秒 12.5 个 token)。视频每一帧占的 token 更多,但聊天时画面通常不会剧烈变化,所以每 6 个窗口才取一帧画面(约每秒看一次,每帧约 12 个 token);数字人输出也是每窗口先输出 2 个 latent 向量,再交给解码器还原画面。算下来,纯音视频流每分钟大概只花 2.6K tokens(加上渐进式压缩后的思考和工具记录,每分钟总共也就 2.6K 到 5K tokens)。
只留 5 分钟完整上下文:面对几个小时的长对话,系统只保留最近 5 分钟 的完整多模态上下文(大约 13K 到 25K tokens),5 分钟之前的内容全部转成文字记录,既留住了近期细节,又不用背着越来越长的音视频历史做推理。
Zero-shot 零样本换声换脸:换声音或换人脸都不需要重新训练中间的 45B 主模型,推理时直接把参考声音和人脸图片给到两头的解码器就行。音频端用因果流匹配解码器保持参考声音的特点;视频端则用基于扩散模型的因果 DiT,结合参考图和前两个窗口的 latent 向量生成画面,保证人物外观和动作的连续性。
写在最后
视频最后,李沐放出了团队在交互、理解和工具任务上的评测结果。里面有个很有意思的对比:Higgs 的前端主模型是 45B MoE,而表里的 Thinking Machines Lab Interaction Small 是 276B MoE。参数规模差了大概 6 倍,但各项成绩却有来有回(在 Big Bench Audio 上,Higgs 45B 拿到了 98.9 分,而 276B 的对比模型一旦关掉后台 Agent,分数就会从 96.5 掉到 75.7)。
李沐的判断很直接:全双工实时交互这个方向还非常早期,数据、架构设计(比如 160 毫秒切片和前端独立思考)以及训练方法对结果的影响很大,单纯把模型做大,未必是现阶段最关键的因素。
那么,现在可以体验到哪一步?
目前已经开放 API 的是端到端模型 Higgs Realtime,支持数字人输出;而今天拆解的全双工模型 Higgs Realtime Duplex,在 Boson 官方发布文中已开放候补名单,即将上线。
想跟着沐神继续扣细节的同学,建议先看原视频里端到端架构合并和 160 毫秒时间轴这两段,再回到车载点单和英语陪练演示,看看模型是怎么接收新信息、决定开口以及处理后台任务的。原视频和官方文档链接放在下面了,别忘了去给沐神一键三连~
原视频:https://www.bilibili.com/video/BV1LB4a6DEWL/官方资料:https://docs.boson.ai/models/higgs-realtime/overview
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。