全网390万围观!中国团队开源753B科研神器
原创 Datawhale 2026-11-09 22:17 浙江
Datawhale干货
最新:Hydrogen-1.0
Datawhale干货
最新:Hydrogen-1.0
这几天,X 上有个刚开源的科研神器火了,一条发布帖就引来了超 390 万次围观。
这个大模型拥有 753B 参数,基于国产开源基座 GLM-5.3 深度后训练而来。刚一上线,就连智谱AI全球生态负责人 Zixuan Li 也第一时间转发祝贺,认可它把 GLM 底座真正推向了前沿科研工作。
它为什么能引爆科研圈?因为它干了一件以前很少有模型系统去做的事:把实验室里平时不发表的电子实验记录、试错过程甚至失败实验,拿去训练了 AI!
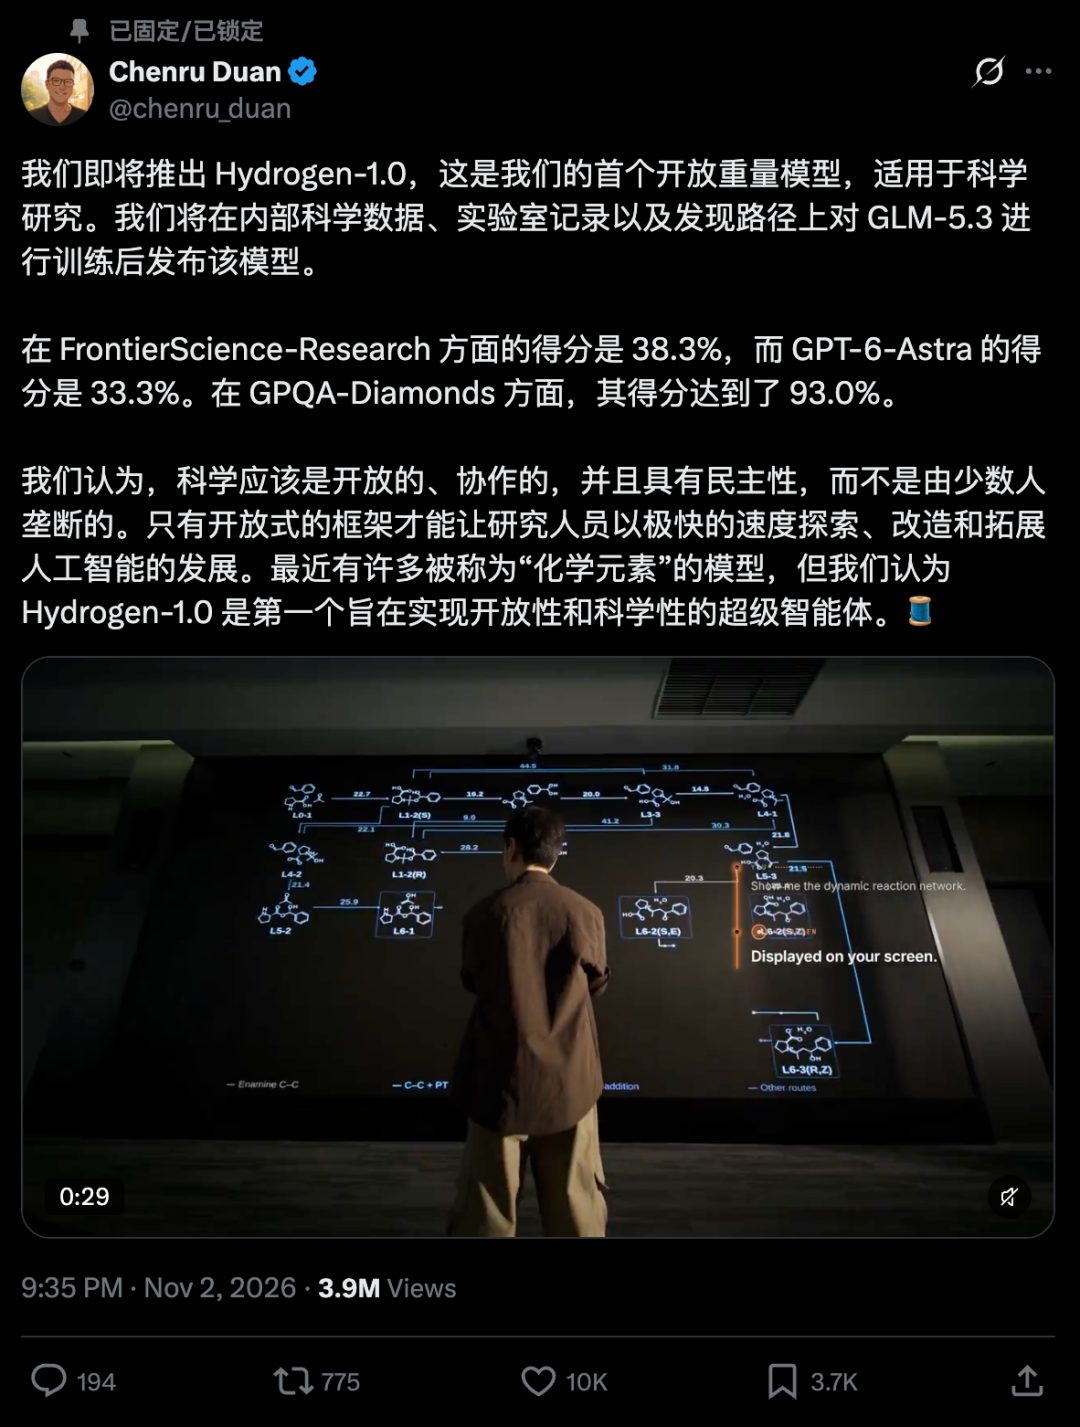
平时公开能获取到的科学语料,绝大部分是已经发表的论文,上面记录的是走通后的最终结论。
而国内 AI for Science 团队深度原理 Deep Principle 刚开源的 Hydrogen-1.0 大模型,把实验室里的真实过程数据、实验记录和探索轨迹整理出来,塞进了大模型的后训练里。
在专门考察博士级陌生难题的权威基准 FSR 上,Hydrogen-1.0 跑赢了 GPT-6-Astra,同时按 MIT 协议放出了完整模型权重,并同步上线了配套的 AI Scientist 平台 Mira。
今天我们一起体验一下,Hydrogen-1.0 是怎么帮科研人员干活的。
一、GPT-6 Astra级的开源科研大模型
Hydrogen-1.0 采用 MoE 架构,总参数量 753B,支持最高 1M 上下文长度和 128K 最大输出,足够塞下几万字的实验记录和多步推演。
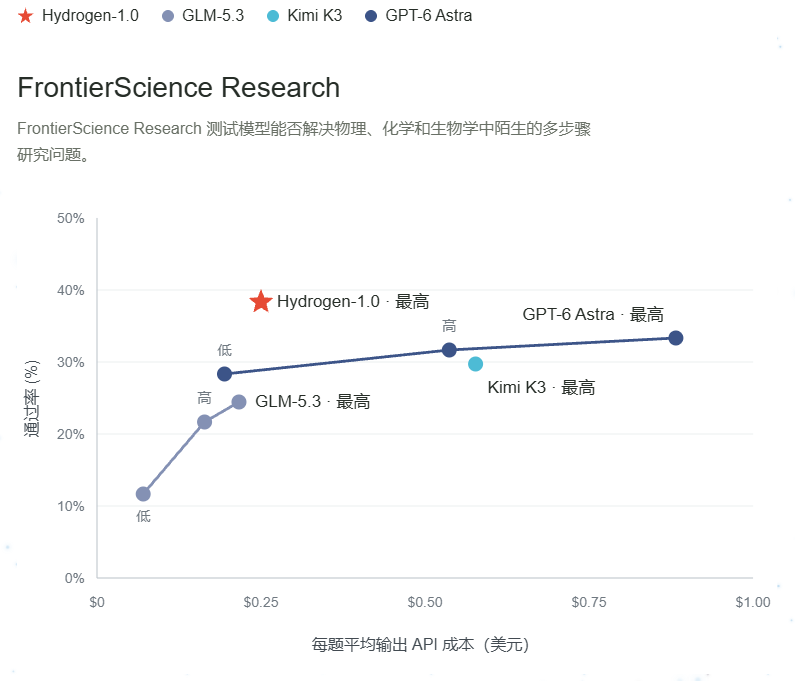
在衡量科学推理能力的权威基准 FrontierScience-Research(FSR)上,题目多是物理、化学、生物领域陌生的多步研究难题,通常需要博士级科研人员推演好几个小时。
Hydrogen-1.0 的解题通过率从底座 GLM-5.3 的 24.4% 提升到了 38.3%,高于 GPT-6-Astra;在 GPQA Diamond 测试中准确率为 93.0%,与同组开源参考模型 Kimi-K3基本持平。
落到内部高频遇到的科研专项测试里,和开启最高推理设置的 GPT-6-Astra 相比:
科学计算任务:Hydrogen-1.0 得分为 76.9%,高于 Astra 的 71.8%;
单步正向反应预测:得分为 90.5%,高于 Astra 的 85.7%;
NMR 核磁结构解析:得分为 26.7%,这项 Astra 仍略高一点。
跑出这些成绩的同时,Hydrogen-1.0 的 API 推理开销和 GLM-5.3 处于同一水平。
二、真实科研任务实测与拆解
为了看清它在具体研究工作流里的表现,我们直接使用搭载 Hydrogen-1.0 的 Mira 平台(mira.deepprinciple.com),结合一些日常课题和官方测试案例,拆解一下它的执行过程与返回结果。
任务一:深度调研一个新课题
我们先跑一个真实的医学开题调研,看看它怎么检索并评估证据。
1. 输入研究课题
在 Mira 工作区输入下面这个问题:
针对成人外伤或手术后已形成的增生性瘢痕,目前有哪些前沿研究路线值得追踪?2. 模型执行过程
拿到这个开放性课题,Hydrogen-1.0 分两步处理:先拆解研究意图做多轮自主检索;摸清大致线索后,主动编写并运行代码,对文献库做批量抓取和自动过滤。
单次任务跑下来,它一共构建并执行了 13 组复合检索式,在主文献库里去重并筛出了 2,996 篇文献,同时把临床试验库里的 250 项在研研究也检索了一遍。
3. 看懂输出的调研报告
Hydrogen-1.0 生成的这份报告,不仅把文献分好了类,还会审论文。
首先,面对近三千篇文献,它挑出高权重的核心论文与在研试验,把现有进展归拢为四个类别:能量设备联合用药、瘢痕内注射优化、透皮新剂型、再生医学,并生成了对应的结构化证据地图。
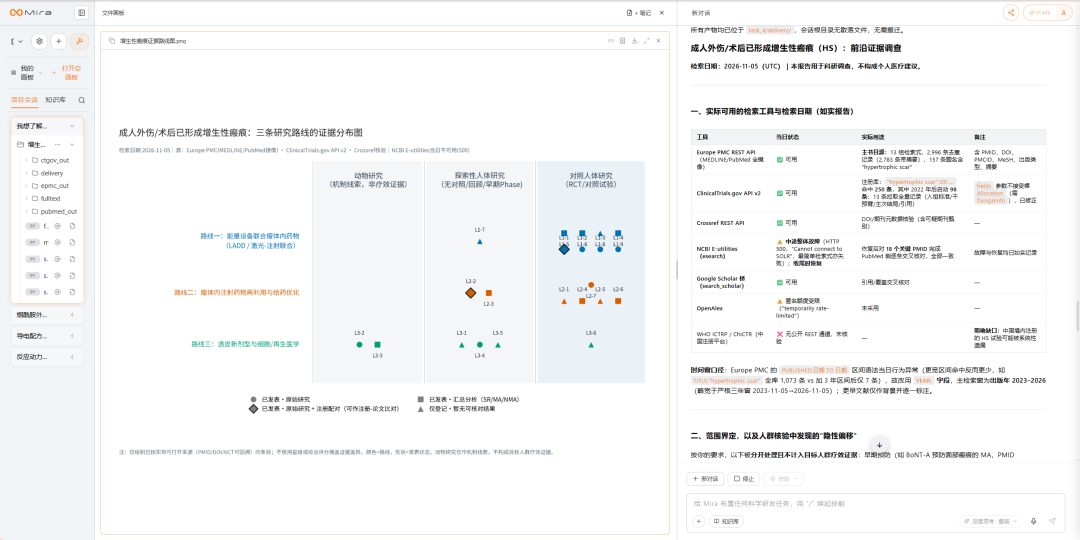
更实用的是,它在引用具体论文时,会把论文里的局限性标出来。
比如报告里提到一篇做「点阵激光联合药物治疗」的知名临床研究(Rutnin 等人)。原论文的结论很漂亮,说联合治疗组的「瘢痕量表总分(VSS)」改善特别明显。
如果只看摘要,我们很容易以为这个方案已经彻底解决了疤痕凸起的问题。但 Hydrogen-1.0 在报告里直接给我们提了两个醒:
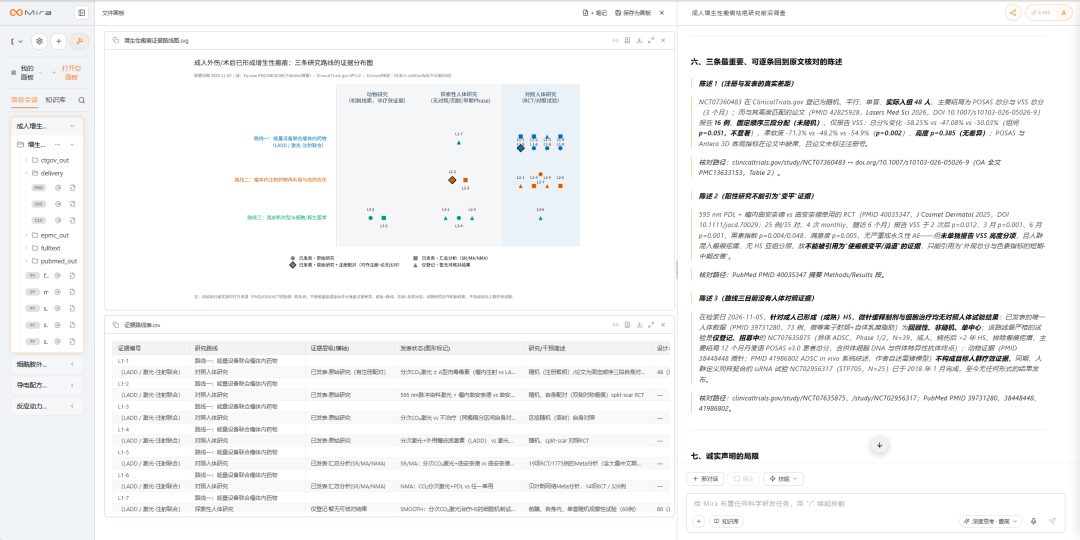
第一,它指出「量表总分变好,不等于疤痕真的变平整了」。因为那个总分里还把疤痕的颜色、软硬度全算进去了,颜色变淡也会拉高总分,但患者最在意的「凸起厚度」未必解决了。
第二,它翻出了实验样本的底细,提醒我们「这项实验把普通增生性瘢痕和瘢痕疙瘩两类不同的病人混在一起测了」,所以这个结论不能直接照搬到单纯的术后疤痕上。
拿着这个结果去辅助开题或者写综述,可以加速很多。
任务二:处理与核对实验数据
拿到实验数据后,最磨人的就是反复核对。
在做数据拟合、排查异常时,我们经常要同时打开好几个软件:在 Excel 里看原始数据表,去统计软件里跑拟合图,再切回 Word 写结果分析。
为了核对一个异常数据点,得在几个窗口之间来回切。Mira 画布针对这个场景做了优化。
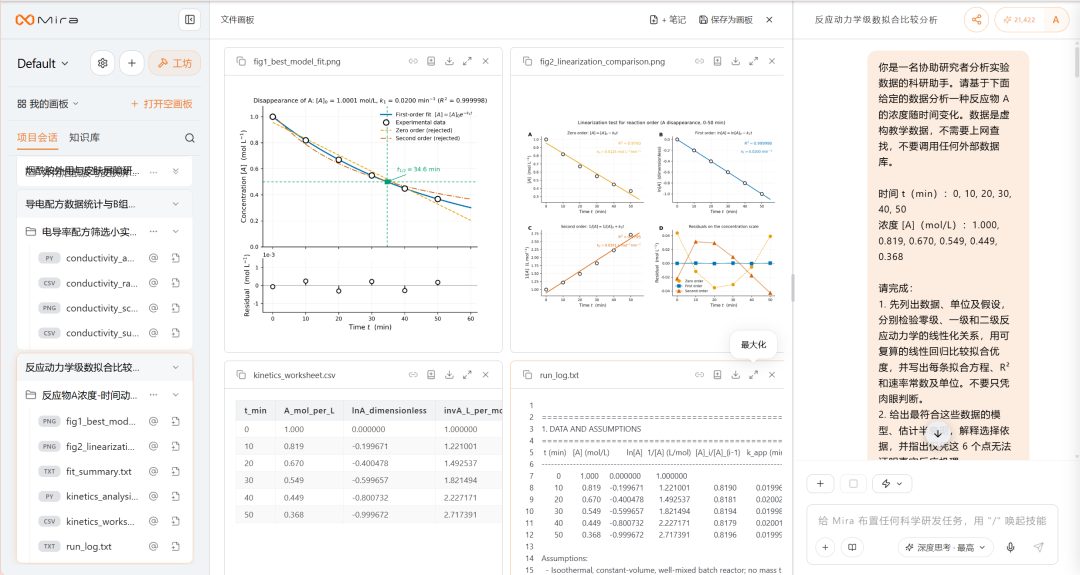
把数据丢进去后,Hydrogen-1.0 很快就把拟合结果和异常原因理了出来。
但最让人舒服的,是它直接把原始数据表格、可视化拟合图表、还有分析汇报文档,并排铺在同一个屏幕上。
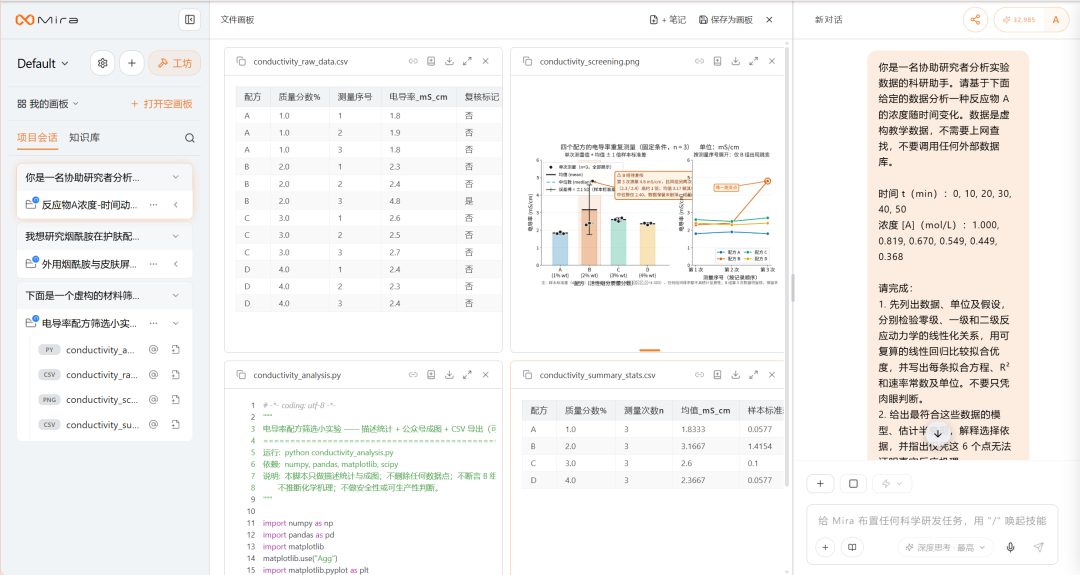
我们根本不需要切窗口。看右边分析结论的时候,视线往左一扫,就能直接对着原始数据表和拟合曲线做验算,省去了大量来回切换比对的功夫。
任务三:推演路线与减少实验试错
在做科研找新idea时,最怕的就是在错误的路线上盲目试错。
在这些需要和专业工具打交道的环节,Hydrogen-1.0 最拿手的是「自己排错」和「看反馈改方案」。
这里重点看两个非常直观的推演过程。
第一个是未知化学反应网络的推演。
在 Mira 界面里,我们只需要输入起始分子的 SMILES 结构,问它:“能帮我画出这个分子可能的反应路径吗?”
可以看到,Hydrogen-1.0 接手后一步步调用工具扩展反应网络:从起始结构 R 出发,顺着 5 步重排反应,把主路径(黑色实线)和每一步可能产生副产物的竞争分支(虚线)一层层画了出来。哪条主路线能垒更低、更容易走通,对着能量势垒图一目了然。
第二个是在未知空间里找新材料配方,看是否可以提升试错效率。
在寻找过渡金属配合物(TMC)新材料的测试里,目标是尽可能提高分子的能隙指标。
测试让 Hydrogen-1.0(橙色)、GPT-6-Astra(绿色)和 Kimi-K3(紫色)从完全相同的一批初始分子出发,总共给 5 轮推荐机会。每一轮模型推荐完分子,仿真工具就会算出能隙反馈给模型,模型再根据反馈决定下一轮怎么修改分子结构。
看动图里的走势非常明显:
第 1 轮大家起点差不多,Hydrogen-1.0 找到的最优分子 A 能隙是
3.952 eV;拿到第一轮反馈后,第 2 轮它迅速把最优分子 B 提升到了
4.568 eV;到了第 3 轮,它推荐出的分子 C 更是直接冲到了
4.949 eV,几乎贴着4.95 eV的理论天花板!5 轮跑完统计下来,Hydrogen-1.0 历轮最优能隙的均值达到了 4.318 eV,明显甩开了同场测试的 GPT-6-Astra 和 Kimi-K3。
这意味着在实际研发里,它真的能看懂上一轮的实验反馈,帮我们用更少的试错轮次逼近目标性能。
三、训练细节拆解
X 上,计算生物学者 Anthony Gitter 和多位开发者专门追问了 Hydrogen-1.0 的训练细节,创始人 Chenru Duan 与官方技术博客给出了完整拆解。
1. 后训练的四类科学数据来源
除了基础的化学、材料与生命科学文献知识,团队重点收集并注入了三类研究过程数据:
强化推理的专家问答对:从一线科学家处理具体科研难题的真实反馈中提取问答,并重点补全其中的科学推理链条。
全周期电子实验记录(ELN):团队日常用自研的 Mira 平台替代传统电子实验记录本,把科学家从「最初实验意图 → 具体操作步骤 → 过程观察 → 最终结果」的完整记录保存下来,使其结构直接贴合模型训练格式。
智能体探索轨迹(Discovery Trajectories):记录研发项目中智能体面对未知目标时「做出选择 → 拿到实验/仿真反馈 → 修正假设」的完整试错序列。
评论区里有位研究者 Kuldeep Pisda 追问了一个大家很关心的问题:实验室记录里包含那些失败的实验吗?那可是任何论文都不会发表的数据。
Chenru Duan 明确了数据里包含了失败实验记录。不过他也坦诚交代了目前的局限:团队还没有找到能让模型把失败数据彻底学透的方法,而且怎么对「从失败中学习」做基准评测本身就很难,这块还在继续探索。
2. 753B 模型长序列 SFT 与可恢复 RL 工程底座
要把几万字的过程数据训进 753B 的 MoE 模型,团队走了 监督微调(SFT)+ 强化学习(RL) 的路子:先用 SFT 教模型怎么做规划、写协议和分析结果,再用 RL 拿真实研究结果做反馈,优化它的多步决策。
在底层基建上,团队基于 Megatron 与 SGLang 搭了一套横跨 NVIDIA CUDA 与 AMD ROCm 的分布式训练系统,核心做了四项工程设计:
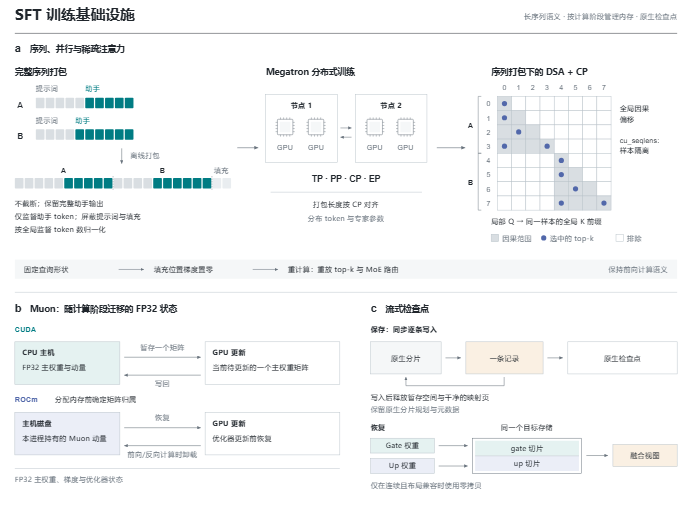
离线序列打包与因果稀疏注意力:用离线打包(Offline Packing)完整保留长推理样本,不做截断;在上下文并行(Context Parallelism)跨分片选键值时,严格限制每个样本的因果边界,避免不同样本串扰。
Muon 优化器状态动态调度与流式检查点:把 FP32 主权重与 Muon 动量状态在 CPU、磁盘(ROCm 路径)与 GPU 之间按计算阶段动态搬移,配合逐记录流式检查点控制主机内存,把 GPU 显存留给长序列激活值。
可恢复的强化学习 Rollout 机制(Resumable RL):共享 GPU 池在生成和训练之间交替。当完整提示组凑够进入训练时,还没跑完的超长回答会保留已生成的前缀,留到下一轮接着生成;每个 token 都会记录自己生成时的策略对数概率(Log-probability),用于跨策略版本的精确重要性修正。
训推边界零梯度漂移校验:训练和推理用的权重布局与精度不同(BF16 与 128×128 块级 FP8)。系统通过双向适配器做转换,并且在评估训练效果前,先在零梯度更新下测量导出与量化漂移。
四、保姆级部署教程
Hydrogen-1.0 已经按 MIT 协议把 753B 完整权重放出来了,有算力条件的课题组可以把模型拉回本地服务器部署,用自己的实验笔记做本地微调,实现「数据不出实验楼」。
这里我们来教大家三步完成本地私有化部署。
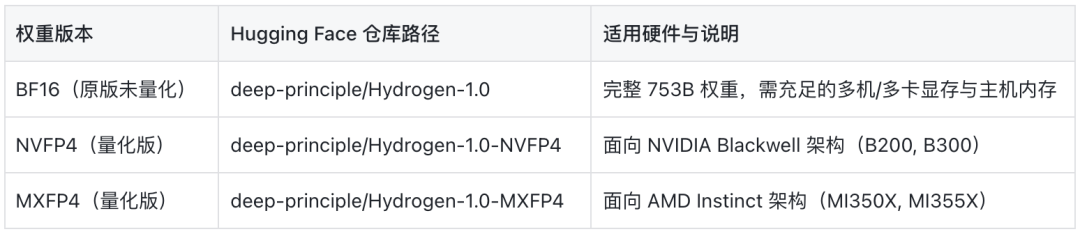
第一步,根据硬件选择权重版本
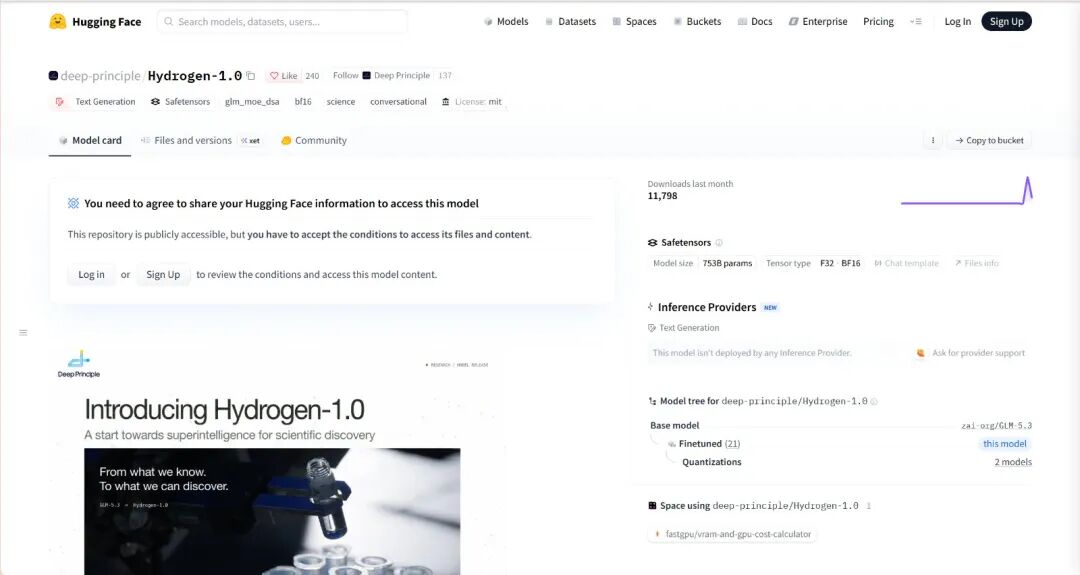
官方在 Hugging Face 与魔搭社区同步放出了三个版本的仓库,分工与硬件要求如下:
第二步,使用 SGLang 启动推理服务
官方在 8 卡 GPU 环境下用 SGLang 完成了测试。国内服务器拉取权重前,建议先配置镜像环境变量 export HF_ENDPOINT=https://hf-mirror.com,然后在终端执行以下命令启动兼容 OpenAI 接口的本地服务:
python -m sglang.launch_server \--model-path deep-principle/Hydrogen-1.0 \--served-model-name hydrogen-1.0 \--tp 8 --trust-remote-code \--reasoning-parser glm45 --tool-call-parser glm47 \--host 0.0.0.0 --port 8001
第三步,编写最小 Python 调用脚本
服务跑起来之后(或者直接用 NeuroSpark API 时),用标准的 openai 库就能发起请求。下面是个开启最高科学推理强度(reasoning_effort: "max")的最小验证脚本:
import osfrom openai import OpenAI# 指向本地 SGLang 服务或远程 API 地址client = OpenAI(base_url=os.environ.get("MODEL_BASE_URL", "http://localhost:8001/v1"),api_key=os.environ.get("MODEL_API_KEY", "not-required"),)stream = client.chat.completions.create(model="hydrogen-1.0",messages=[{"role": "system", "content": "You are an AI scientist. State assumptions and explain the scientific reasoning behind your answer."},{"role": "user", "content": "Derive the period of a simple pendulum under the small-angle approximation, and explain when the approximation breaks down."},],max_tokens=4096, # 示例预算,复杂长推演可根据服务上限调大(模型最大支持 128K 输出)stream=True,extra_body={"chat_template_kwargs": {"reasoning_effort": "max"}},)for chunk in stream:if chunk.choices and chunk.choices[0].delta.content:print(chunk.choices[0].delta.content, end="", flush=True)print()
五、实际落地使用的经验
结合官方模型卡说明和我们在 Mira 上的实测经验,有四点细节可以留个心眼:
第一,本地部署别删 generation_config.json:仓库里的 generation_config.json 定义了回答结束符(end-of-turn tokens)。要是漏了这个文件,模型生成完答案后会停不下来。
第二,量化版本上线前先拿标准样本对一下精度:NVFP4 和 MXFP4 量化版降低了显存门槛,但在做高精度数值计算或复杂谱图解析时,输出可能跟原版 BF16 有一点出入,接进正式流程前最好拿手头已知结果的样本测一遍。
第三,提示词里加上「挑刺要求」效果更好:在 Mira 或 API 里做文献调研时,如果只给几个关键词,模型很容易只给你罗列摘要。建议直接在提示词里让它检查「指标能不能代表目标」以及「样本能不能外推到目标场景」,下面这个模板是我们在测瘢痕课题时调整出来的,可以直接复制改词用:
【课题深度调研建议模板】围绕【填入具体研究问题】,限定在【具体对象/材料体系/实验条件】及【近 X 年】内,梳理目前主要的前沿研究路线。请逐项列出代表性工作的体系、方法、关键终点指标与结果,附上原始来源并区分已发表论文与在研试验。请重点帮我做方法学与局限性辨析:指出哪些测量指标的改善不能直接等同于核心科学目标的解决?哪些研究在样本纳入或实验条件上存在混杂,导致结论不能简单外推到我的目标场景?无法从公开来源确认的信息请直接标出来,不要自行补全。
第四,关键结论还得人工把关:不管模型推导写得多细,输出的内容只能当研究参考。涉及到关键公式推导、实验协议安全检查和临床医学相关的判断,落地前还是要翻原论文和实验数据自己核实一遍。
写在最后
做科研从来是一个容错率极低、需要反复试错求证的过程。感兴趣的科研小伙伴可以直接上手体验。
目前登录 Mira 平台会有新用户积分,可以直接使用 Hydrogen-1.0:
Mira 在线平台(零门槛直用):https://mira.deepprinciple.comHugging Face 权重仓库:https://huggingface.co/deep-principle/Hydrogen-1.0NeuroSpark API 入口:https://neuro-spark.ai/dashboard/models?model=hydrogen-1.0
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。